从零制作 AI 中文短剧:ChatGPT + Muse + Fish Audio 全流程实战教程
最近这段时间,我一直在折腾 Muse AI,尝试用 AI 制作中文动画短剧。
从最初写故事、生成视频,到后面解决中文配音、人物音色、口型同步等问题,整个过程踩了不少坑。
尤其是 Muse 自带的中文语音,有时候听起来像外国人在学习普通话,发音不够自然,人物音色也不符合预期。
后来在 X 上分享了自己的制作过程,评论区来了不少懂技术、喜欢折腾 AI 的朋友。大家给了我很多建议,其中一个很重要的建议就是:不要完全依赖 Muse 自带配音,可以尝试接入 Fish Audio API,单独制作角色声音。
经过这几天的摸索,我逐渐整理出了一套完整的 AI 中文短剧制作流程。
这篇文章就把整个方法、工具、提示词和遇到的问题一次性分享出来。
特别感谢评论区愿意分享经验的朋友们。
一、先了解整个制作流程
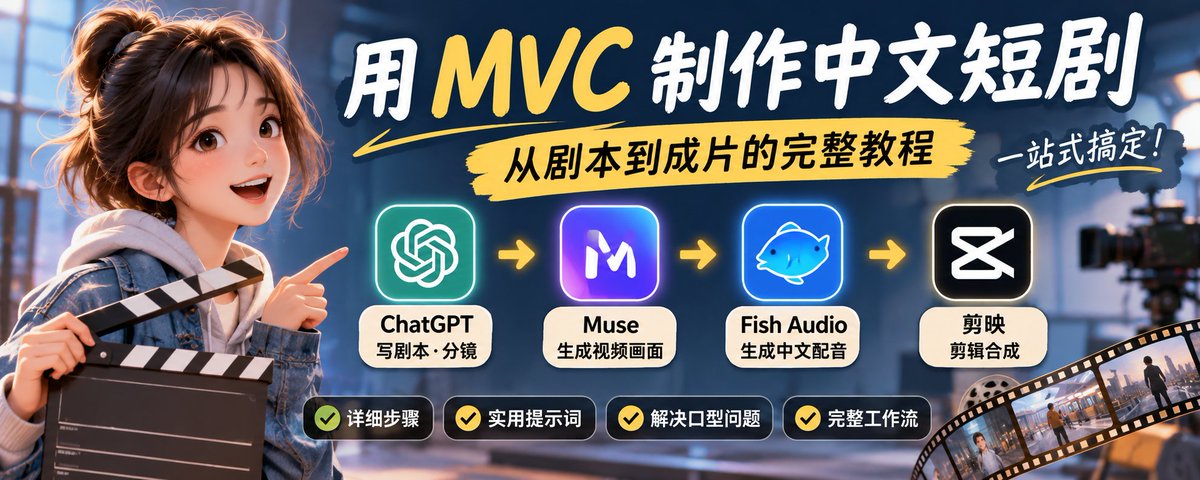
这套工作流主要使用四个工具:
- ChatGPT:负责故事创作、人物设定、剧本和分镜。
- Muse AI:负责生成动画视频画面。
- Fish Audio:负责人物音色、中文配音和旁白。
- 剪映:负责视频剪辑、字幕、背景音乐和音频合成。
整个流程可以理解为:
ChatGPT 写剧本 → Muse 生成画面 → Fish Audio 生成声音 → 剪映后期合成 → 导出成片。
这里有一个非常重要的细节:
我们不再依赖 Muse 自带的配音作为最终声音。
Muse 主要负责生成动画画面,Fish Audio 负责生成我们想要的中文声音,最后通过剪映把两者组合起来。
这样就可以分别控制画面和声音,不必把所有任务都交给一个 AI 工具。
二、第一步:使用 ChatGPT 创作剧本
制作短剧之前,先不要急着生成视频。
应该先把故事、人物和镜头设计好。
一个完整的短剧至少需要:
- 故事主题
- 人物设定
- 人物关系
- 故事发展
- 人物对白
- 场景设计
- 镜头分解
- 每个镜头的时长
如果直接把一大段故事交给视频生成工具,容易出现人物变化、动作不连贯、场景不一致等问题。
所以建议先让 ChatGPT 完成剧本和分镜。
提示词一:AI 短剧编剧与分镜导演
请复制下面这段:
你是一名专业的 AI 动画导演、编剧和分镜设计师。
我准备使用 Muse AI 制作一部中文动画短剧。
请根据我提供的故事创意,帮助我完成完整的剧本和分镜设计。
具体要求:
- 完善故事剧情,保证故事有清晰的开头、发展、冲突和结尾。
- 设计所有角色的外貌、服装、发型、性格和人物关系。
- 为每个角色设计独立的声音特点。
- 将故事拆分成多个独立镜头,每个镜头建议控制在 5~10 秒。
- 每个镜头都必须包含:
- 场景环境
- 人物外貌
- 人物动作
- 人物表情
- 镜头景别
- 摄影机运动方式
- 人物对白或旁白
- 建议时长
- 保持人物外貌、服装、场景和整体画风一致。
- 所有中文对白使用自然、流畅的日常普通话,避免生硬的书面语。
- 不要把多个复杂动作塞进同一个短镜头。
- 每个镜头单独输出一份可以交给 Muse 使用的视频提示词。
- 另外整理一份完整的角色台词表,方便后续使用 Fish Audio 制作配音。
我的故事创意:
【在这里填写你的故事内容】
请先输出人物设定,再输出完整剧本,最后输出逐镜头分镜。
三、第二步:使用 Muse AI 生成动画画面
有了剧本和分镜之后,就可以把每个镜头交给 Muse 生成视频。
这里建议不要一次性生成整部短剧。
而是按照分镜,一个镜头一个镜头地生成。
例如:
- 第一镜:人物进入场景。
- 第二镜:人物发现某件事情。
- 第三镜:人物产生反应。
- 第四镜:人物开始对话。
- 第五镜:剧情出现转折。
这样做更容易控制每个镜头的画面质量,也方便后期重新生成不满意的片段。
提示词二:Muse 视频生成提示词
请根据以下分镜,生成一个独立的视频片段。
视频要求:
- 视频比例:9:16 竖屏。
- 视频时长:按照当前镜头要求执行。
- 画面风格:电影级动画质感。
- 人物形象:严格保持参考人物的外貌、服装、发型和身体比例。
- 场景:严格按照分镜描述生成。
- 动作:自然、连贯,不要出现肢体扭曲。
- 镜头:按照指定景别和运镜执行。
- 光影:保持统一的光照方向和色彩风格。
- 不要擅自改变人物关系和剧情。
- 不要随意增加人物或无关物体。
声音要求:
本项目的最终配音将使用 Fish Audio 单独制作。
如果当前生成工具支持关闭声音或不生成对白声音,请优先使用该设置。
如果不能关闭声音,也可以正常生成视频,但后期只保留画面,不使用原视频自带的对白配音。
当前镜头分镜:
【粘贴 ChatGPT 生成的单个镜头描述】
人物一致性的小技巧
AI 视频制作经常出现一个问题:
第一镜的人物和第二镜的人物长得不一样。
解决思路:
- 先制作人物参考图。
- 固定人物的服装、发型、五官和身体比例。
- 每次生成视频时尽量使用同一张人物参考图。
- 如果 Muse 支持使用视频帧作为参考,可以尝试把上一镜头的最后一帧作为下一镜头的参考。
- 每个镜头生成后都检查人物是否发生变化。
注意:图片参考和上一镜头画面参考,需要以 Muse 当前实际支持的功能为准。
四、第三步:使用 Fish Audio 制作中文配音
这是整个流程里非常重要的一步。
之前我使用 Muse 生成视频时,遇到两个问题:
第一,中文发音不够自然,听起来有外国人学习普通话的感觉。
第二,人物的声音不符合我想要的音色。
所以后来尝试把画面和声音分开制作。
Fish Audio 就是用来解决声音问题的工具。
它可以进行文本转语音,也可以根据可用音色选择合适的人物声音。
官网:
API 文档:
https://fish.audio/zh-CN/developers/
- 获取 Fish Audio API Key
基本步骤:
- 打开 Fish Audio 官网。
- 注册并登录账号。
- 进入 API Key 页面。
- 创建自己的 API Key。
- 按照官方 API 文档配置调用方式。
API Key 页面:
https://fish.audio/app/api-keys
注意:API Key 相当于调用服务的凭证,不要公开发布,也不要把自己的密钥发给别人。
- 选择人物音色
不同角色应该使用不同音色。
例如:
- 旁白:选择清晰、自然、情绪稳定的声音。
- 女主角:选择符合人物性格的声音。
- 男主角:选择符合人物年龄和性格的声音。
- 搞笑角色:可以选择更有辨识度的声音。
我自己的测试中,也尝试过 Yuri 和 Monika 等音色。
不过需要注意,音色名称或介绍使用英文,并不代表它一定能把中文说得自然。最终还是要用实际中文台词试听。
建议每个角色先测试几句,再确定最终音色。
提示词三:让 AI 助手研究并接入 Fish Audio API
我想为目前的 Muse AI 视频制作流程接入 Fish Audio API。
主要目标是解决中文配音不自然、人物音色不统一的问题。
请严格按照 Fish Audio 官方文档执行:
https://fish.audio/zh-CN/developers/
需要完成以下任务: ** 第一步:检查官方文档,确认当前 API 地址、鉴权方式、模型名称、请求参数和返回格式。
第二步:检查当前运行环境,包括 Python、相关依赖和 FFmpeg。
第三步:研究并实现以下功能**:
- 使用 Fish Audio API 进行文本转语音。
- 支持不同角色配置不同音色。
- 支持独立生成旁白和人物对白。
- 支持官方文档明确提供的语速等参数。
- 每句台词可以生成独立音频文件。
- 记录每段音频的实际时长。
- 根据剧本自动整理音频文件。
- 根据台词生成 SRT 字幕文件。
- 生成音频时间轴,方便后期剪辑。
- 支持多角色配音管理。
第四步:建立角色音色配置文件。
例如:
旁白:指定音色 ID。
人物 A:指定音色 ID。
人物 B:指定音色 ID。
第五步:完成后先进行测试,不要直接批量调用 API。
安全要求:
- 必须以 Fish Audio 官方文档为准。
- 不得编造 API 地址、参数或模型名称。
- API Key 必须通过安全凭证或环境变量读取。
- 不得把 API Key 写进公开代码或日志。
- 涉及付费、部署、云服务器或额外费用时,先向我确认。
- 使用声音克隆功能时,必须确保拥有声音授权。
请先输出完整接入方案、所需依赖和预计成本,等待我确认后再执行。
五、第四步:将 Fish Audio 配音与 Muse 视频组合
到这里,我们已经有了两样东西:
第一:Muse 生成的视频画面。
第二:Fish Audio 生成的人物对白和旁白。
接下来需要把它们组合起来。
例如:
第一镜:人物 A 走进房间。
Fish Audio:生成旁白。
第二镜:人物 A 看向人物 B。
Fish Audio:生成人物 A 的对白。
第三镜:人物 B 回答。
Fish Audio:使用人物 B 对应的音色生成对白。
每个镜头的音频都要按照剧本对应起来。
建议按角色和镜头编号整理文件:
metro-video/
- video/
- shot_01.mp4
- shot_02.mp4
- shot_03.mp4
- audio/
- narration_01.mp3
- character_A_01.mp3
- character_B_01.mp3
- subtitles/
- subtitles.srt
实际文件格式可以根据 Fish Audio 的输出和剪辑需求选择。
一个重要原则
Fish Audio 生成的是声音,不是视频。 ** 它不会自动修改 Muse 视频中人物原本的嘴型。
因此,声音生成之后,还需要后期合成。
六、第五步:人物口型对不上怎么办?
这是评论区很多朋友可能会问的问题。
例如:
Muse 生成了一个人物正在说话的画面。
我们用 Fish Audio 重新生成了更加自然的普通话。
结果声音出来了,但是人物嘴巴没有按照新的声音变化。
这是什么原因?
因为语音合成和口型同步是两个不同的技术环节。
Fish Audio 负责生成语音,不负责自动修改视频人物的嘴部动作。
解决方式主要有三种。
方法一:不做口型同步,直接替换声音
适合:
- 旁白。
- 远景。
- 背影。
- 人物没有正面说话的镜头。
- 画面重点不在人物嘴部的场景。
直接使用 Fish Audio 生成配音,再用剪映替换原视频音轨。
这是最简单、成本最低的方式。
方法二:使用 AI 口型同步工具
如果人物需要正面说话,就可以研究专门的口型同步工具。
可以了解:
- MuseTalk
- Wav2Lip
- LatentSync
它们属于不同的 AI 口型同步方案,具体使用条件和部署要求不同。
基本流程:
Muse 生成原始视频。
Fish Audio 生成最终对白。
将视频和对应音频交给口型同步工具。
处理完成后,再把结果导入剪映。
需要注意:
- 这些工具不等于 Fish Audio 的内置功能。
- 部分方案需要 GPU 环境。
- 云端 GPU 可能产生额外费用。
- Wav2Lip 开源版本需要特别核对授权,商业使用前不能忽略许可证要求。
- 不同工具对视频格式、人物角度、画面清晰度和音频长度有不同要求。
方法三:从分镜阶段减少口型问题
这是我比较推荐的低成本方案。
在写剧本和分镜时:
- 旁白尽量使用人物动作、环境和场景镜头。
- 对话不一定每句话都展示人物正脸。
- 可以使用正反打镜头。
- 可以使用人物背影、侧脸和远景。
- 减少长时间连续正面说话的镜头。
- 真正重要的对白近景,再单独处理口型同步。
这样能够减少后期工作量。
七、第六步:使用剪映完成最终剪辑 最后一步就是把所有素材放进剪映。
基本步骤:
- 导入 Muse 生成的所有视频片段。
- 按照剧本顺序排列镜头。
- 导入 Fish Audio 生成的音频。
- 把每段声音放到对应镜头的时间轴。
- 根据实际音频长度调整镜头时长。
- 删除或静音 Muse 原视频自带的声音。
- 添加中文字幕。
- 添加背景音乐。
- 添加环境音效和动作音效。
- 检查人物声音和画面是否同步。
- 检查字幕、镜头衔接和整体节奏。
- 导出最终视频。
特别注意:
不要只把新声音叠加到原声音上。 应该根据需要关闭或删除 Muse 原来的对白声音,避免两套声音重叠。
如果人物需要对口型,还要先完成口型同步处理,再进行最终剪辑。
八、完整提示词:让 ChatGPT 一次性生成整套制作方案
如果不想每次分开输入,也可以直接使用下面这段提示词。
你是一名专业的 AI 短剧导演、编剧和制作流程设计师。
我准备使用 ChatGPT、Muse AI、Fish Audio 和剪映制作一部中文 AI 动画短剧。
请帮助我从创意到成片,设计完整的制作方案。
制作流程:
第一阶段:剧本创作。
- 设计故事主题。
- 设计人物形象和人物关系。
- 编写完整剧本。
- 编写自然的中文人物对白。
- 设计每个角色的声音特点。
第二阶段:分镜设计。
- 将故事拆分成多个 5~10 秒的独立镜头。
- 每个镜头包含画面、动作、景别、运镜、表情和台词。
- 保持人物形象统一。
- 注意镜头之间的连续性。
- 尽量减少不必要的正面长对白镜头。
第三阶段:Muse 视频生成。
- 每个镜头输出独立的视频提示词。
- 尽可能保持人物和场景一致。
- 最终配音交由 Fish Audio 制作。
- 不依赖 Muse 自带语音作为最终配音。
第四阶段:Fish Audio 配音。
- 整理全部角色台词。
- 为不同人物配置独立音色。
- 单独生成旁白和人物对白。
- 记录音频时长。
- 生成字幕文件和音频时间轴。
- API 调用必须遵循官方文档。
第五阶段:口型同步。
- 判断哪些镜头需要口型同步。
- 旁白、远景、背影等镜头优先直接替换音轨。
- 正面说话近景再考虑使用 AI 口型同步工具。
- 不得假设 Fish Audio 能自动修改视频嘴型。
第六阶段:剪映后期。
- 将所有视频片段按照顺序排列。
- 将对应音频放入时间轴。
- 删除或静音原始配音。
- 添加字幕、背景音乐和音效。
- 检查画面和声音是否同步。
- 最后导出完整视频。
请按照实际可用的工具和功能执行,不要虚构软件能力。
每个阶段完成后,先检查结果,再进入下一阶段。
我的故事创意:
【在这里填写故事内容】
九、制作过程中容易遇到的问题
问题| 解决思路 中文发音不自然| 使用 Fish Audio 重新制作配音 人物音色不统一| 为不同角色配置固定音色 人物外貌变化| 固定人物参考图和设定 镜头衔接不自然| 逐镜头生成,检查前后连续性 口型对不上| 使用口型同步工具或调整分镜 背景声音重叠| 剪映中静音或删除原始配音 音频和画面时长不一致| 根据实际音频时长调整时间轴 API 无法调用| 检查官方文档、密钥、权限和请求参数
十、最后总结:这套 AI 中文短剧工作流
我目前的核心思路就是把不同工具的能力拆开使用。
ChatGPT:负责创作。
写故事、人物设定、剧本、对白和分镜。
Muse AI:负责画面。 按照分镜逐个生成动画视频,尽可能保证人物和场景一致。
Fish Audio:负责声音。 选择或设计人物音色,生成自然的中文对白和旁白。
口型同步工具:负责嘴部动作。
只对真正需要正面说话的镜头进行处理。
剪映:负责后期。
将视频、配音、字幕、音乐和音效整合成完整作品。
最终流程:
ChatGPT → Muse → Fish Audio → 口型同步(按需)→ 剪映 → 成片。 这套方法不是让某一个 AI 工具包办所有事情,而是把不同工具的優勢結合起來
对我来说,这几天最大的收获就是:制作 AI 短剧不能只关注画面,声音、人物一致性、镜头衔接和后期合成同样重要。 也再次感谢评论区给我提出建议的朋友们。 很多时候,一个人的摸索可能会走很多弯路,但大家一起交流,真的能学到不少东西。 如果你也在折腾 AI 视频,希望这套流程能给你一些帮助。
這是fish audio的提示詞
*请帮我研究并配置 Fish Audio API,实现 AI 短剧自动配音。
官方文档: https://fish.audio/zh-CN/developers/
需要实现:
- 读取剧本中的角色和台词。
- 根据角色自动匹配对应音色 ID。
- 使用 Fish Audio API 生成语音。
- 每句对白单独生成音频文件。
- 旁白和不同人物使用不同音色。
- 记录每段音频的实际时长。
- 尽可能生成文字时间戳和 SRT 字幕。
- 按镜头编号整理音频文件。
- 生成方便剪辑的音频时间轴。
要求:
- 以官方最新 API 文档为准。
- 不得编造接口和参数。
- API Key 使用环境变量或安全凭证管理。
- 先测试一段中文,再进行批量生成。
- 涉及付费或部署费用时先询问我。
请先输出实施方案,再开始执行。*
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。