想转 FDE?一个干了 4 年多的人告诉你:这活从开会聊需求,到私有化部署,都得会
文章目录
今年想转 FDE 的人特别多。
脉脉的数据说,今年上半年 FDE 相关岗位比去年同期涨了二十多倍。据报道,字节给豆包大模型的 FDE 开到月薪 3.5 万到 7 万、一年 15 薪。前几天 Anthropic 又宣布拿出一亿美元,到 2027 年底培养一万名 FDE。
很多人看到这些,第一反应是赶紧去补模型、补 Agent、补微调的知识。
我想先泼一点冷水。在这份活里,模型反而是最不用担心的那一块。
这个活我干了 4 年多。2022 年开始,我在车企做 AI 落地,前前后后十多家。那会儿国内还没什么人管这叫 FDE,我的职位一开始是 AI 负责人,后来是技术负责人,我也不敢说自己是什么标准的 FDE。只是回头看,从跟客户开第一次会聊需求,到在客户机房里装驱动、起模型、做压测,再到给客户出数据报告,中间每一段都是我自己上。
干下来我最大的感受是,难的都在模型前后。开会时能不能当场把客户的预期管住,决定了项目最后能不能验收;业务吃不透,边界定不清楚,模型怎么调都是乱的。
这篇我就拿我的自身经历举例,按一个项目从头到尾的顺序,把这些活一样一样摊开讲。你看完,大概就知道自己离 FDE 还差哪几块。
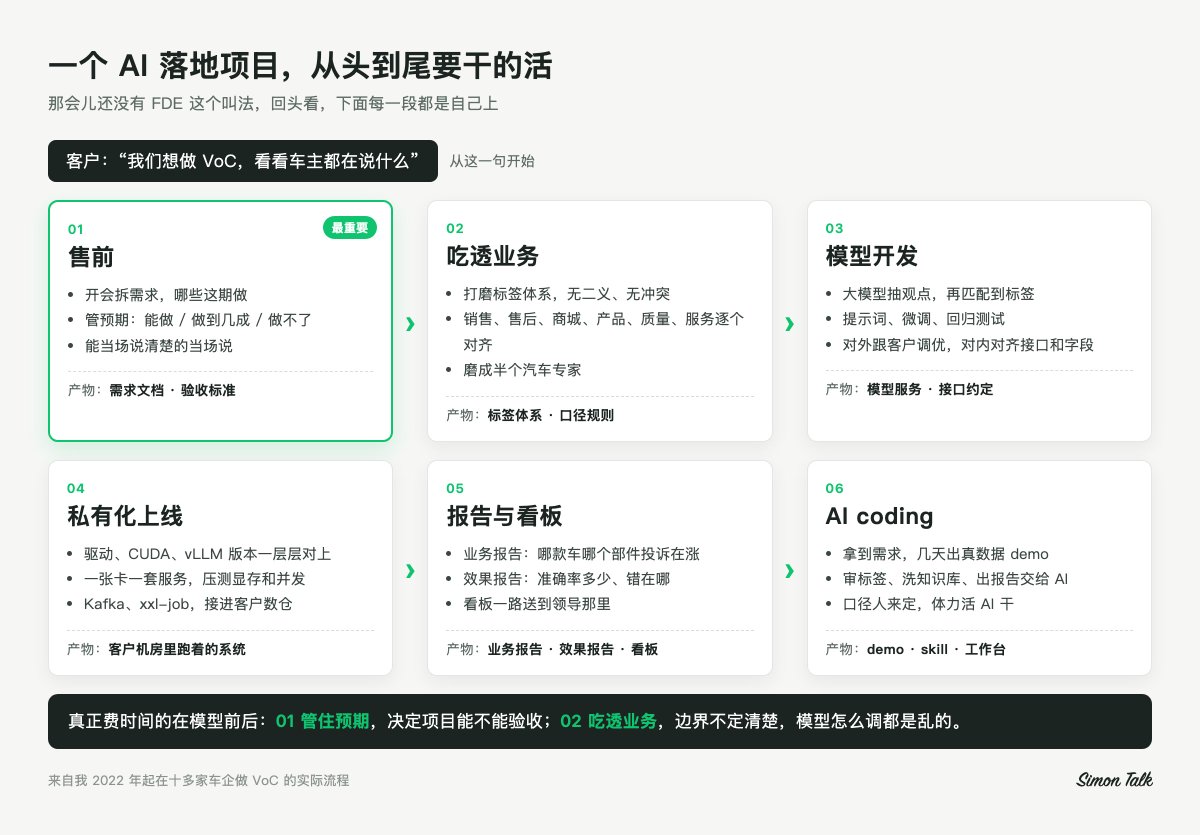
一个 AI 落地项目从头到尾的六段活,真正费时间的在模型前后
自我介绍
先简单说下我是谁。
最近运营了3周的X,发的都是跟AI视频制作工作流相关的内容,但其实我是做AI算法的,早些年叫 NLP 算法工程师,做 BERT、做分类器、做情感分类、做 Rasa 客服机器人、做 wenet 语音识别,这一行做了十年。后来进了汽车行业,给国内多家车企做 VoC 项目,合资、自主品牌都有,VoC 是 Voice of Customer,客户之声。说简单点,就是车企想知道车主到底在说什么,在抱怨什么,在夸什么。
车主的声音散落在很多地方。车企自己的私域里有 400 客服电话、DCC 线索跟进记录、APP 社区的帖子、售后工单;公域里有汽车之家、懂车帝这些汽车垂直媒体,还有小红书、抖音上的讨论,有的项目会专门采购这部分数据。
VoC 要做的,就是把这些话一条条读进来,拆成一个个观点,判断它说的是哪个车型、哪个部件、哪个服务环节,是夸还是骂,打上标签,最后汇成报表和看板。
用它的主要是质量、市场、产品这几个部门,质量看故障,市场看口碑,产品看配置该怎么改。有的车企很重视,看板会一直送到很高级别的领导那里。
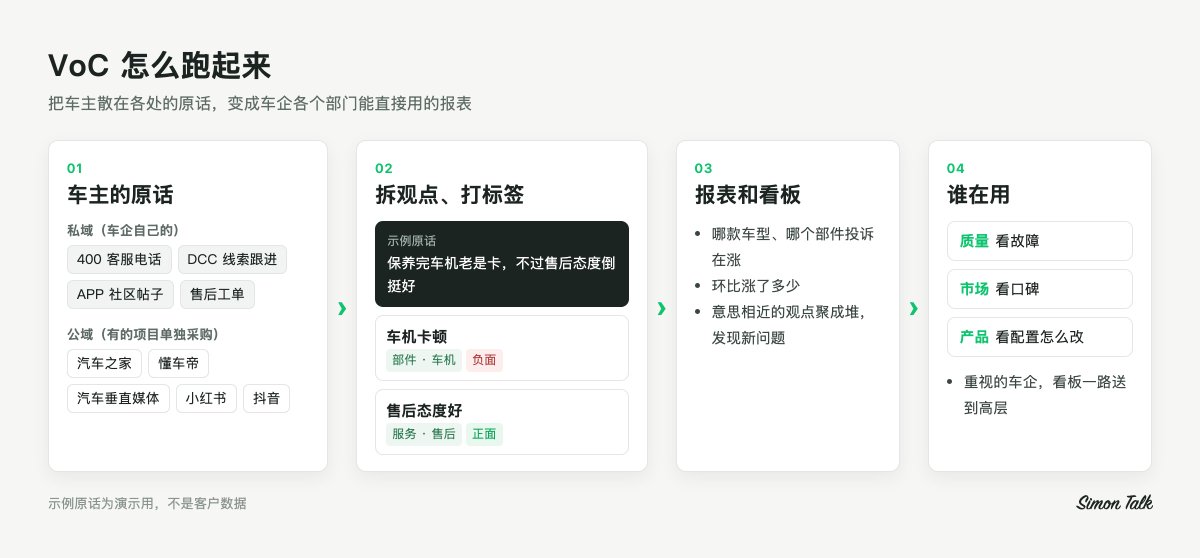
VoC 的四步:车主原话 → 拆观点打标签 → 报表看板 → 质量、市场、产品在用(示例原话为演示)
听起来是个 NLP 项目,真做起来,要干的活远不止模型。下面按一个项目从头到尾的顺序,讲讲 FDE 到底要干哪些活。
一、售前:管预期,这一步决定项目能不能验收
项目一开始,其实是售前的活。
要去客户那里开会,搞清楚他们到底想要什么。客户说要做 VoC,可能质量部想看故障,市场部想看口碑,产品部想看配置该怎么改,大家嘴里说的是同一个词,心里想的是三件事。你得在会上把这些拆出来,哪些这期做,哪些以后做,哪些做不了。
这里面我认为最重要的,是客户的预期管理。说它是整个项目里最重要的一件事都不为过,项目最后能不能验收,很大程度上在这一步就定了。
以前没有 FDE 这个说法的时候,去客户现场的一般是一个团队,冲在前面跟客户聊的多是产品和其他岗位的同事。他们的问题是不懂技术,不懂算法,也不懂模型,客户在会上问一句这个能不能做、能做到多准,他们心里是没底的。
没底的结果一般就两种。一种是不敢承诺,什么都说要回去评估一下,一来一回好几天,效率很低。另一种更惨,是瞎承诺,当场拍板,不评估就答应下来,等项目做到一半才发现根本做不到,最后只能在验收的时候硬扛。
FDE 的优势就在这里。我自己就是做模型、做算法、做技术的,客户问能不能做,我哪怕不深度评估,心里也知道个大概,哪些现在的模型能做好,哪些做出来也就七八成、需要人来兜底,哪些数据不够根本做不了。能当场说清楚的就当场说清楚,该打的预防针在一开始就打好。
最后一定要落到书面。需求文档、验收标准,写清楚,双方确认。这一步偷懒,后面每一次扯皮都要还。
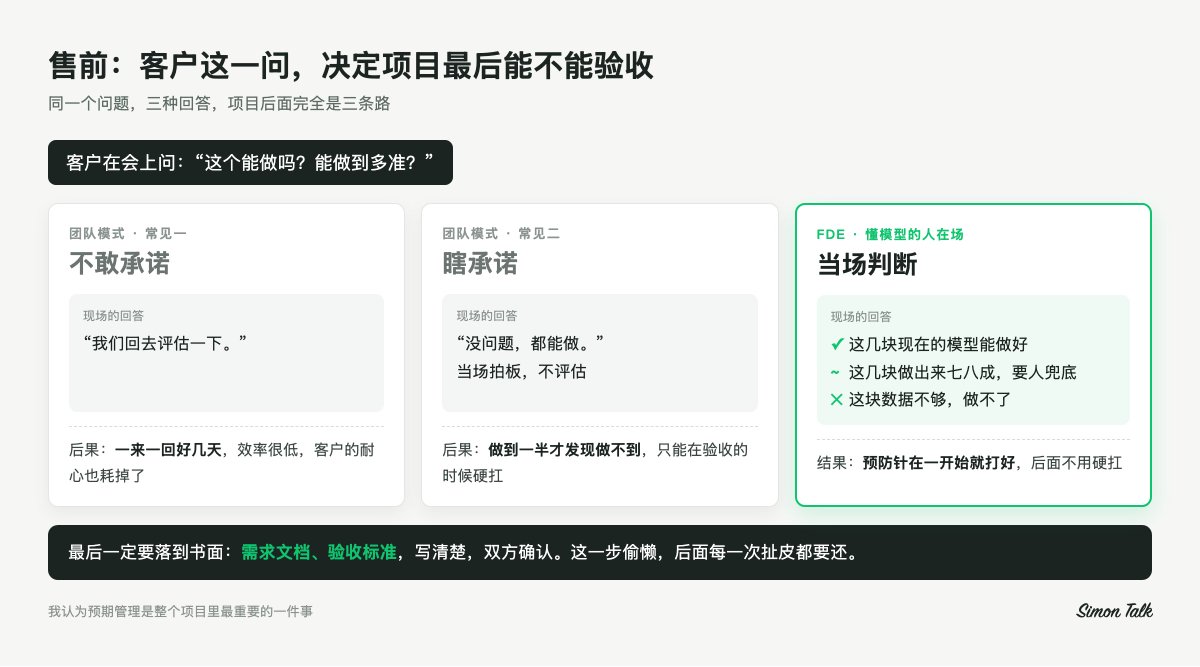
客户问“能做吗、能做到多准”,三种回答决定了项目后面怎么走
二、吃透业务:一顿打磨下来,我成了半个汽车专家
需求定了以后,最花时间的是打磨业务理解。拿我们这个项目举例,就是不停地打磨标签体系的定义。
VoC 的标签体系很大,分好几级,最细一层动辄几千个标签。每个标签的定义不能有二义性,标签和标签之间不能有冲突,整个结构要合理。比如车主说一句"服务态度差",在 4S 店保养时说的,归售后;在看车买车时说的,归销售。这种边界不定清楚,模型怎么调都是乱的。
更难的是,这套标签要跟车企几乎所有部门对齐。销售、售后、商城、产品、质量、服务,每个部门对齐各自那一块,各部门对同一件事的叫法、关心的点都不一样,要一个一个去聊,一轮一轮去改。
这么搞下来,不懂也难。打磨完一套标签体系,我自己已经算半个汽车专家了,一辆车从卖出去到交付、保养、维修、召回,每个环节车主会抱怨什么,心里都有数。
再加上每天看的就是车主的原话,到后来,哪一款车型、哪个部件、什么问题车主抱怨得最多,我闭着眼睛都能说出来。哪款车的车机最近被骂得多了,哪款车的异响投诉又冒头了,有时候我比车企里管这块的人知道得还早。
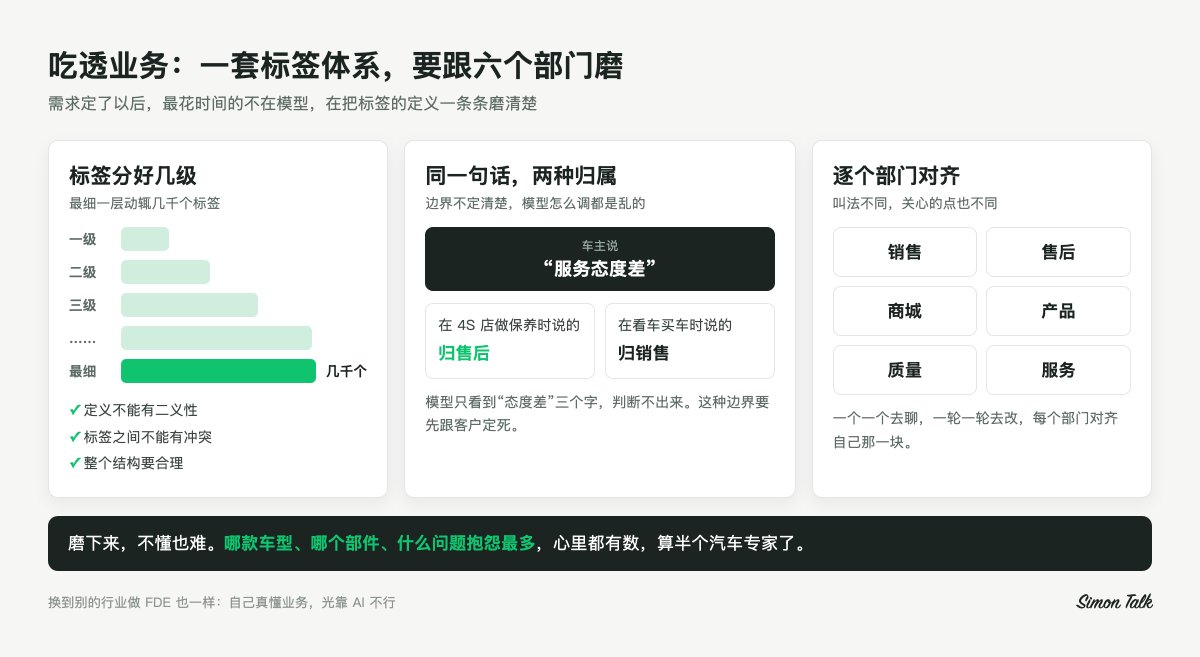
标签分好几级、最细一层几千个,同一句话放在不同场景归属不同,要跟六个部门逐个对齐
换到别的行业做 FDE 也是一样。重要的是你自己真的要理解这个业务,光靠 AI 是不行的。AI 能帮你写代码、写文档,但它替你去不了客户的会议室,替你记不住销售部和售后部为什么对同一句话有两种理解。
三、模型开发:对外调优,对内对齐
业务理顺了,才轮到算法的活。
先给你看看,这一段里有多少技术要懂。从 NLP 的老底子,分词、实体识别、情感分类、BERT,到大模型本身,开源模型选型、提示词、SFT、LoRA 微调;再到向量模型 embedding、向量库,检索、召回、rerank 这一整条检索链;最后还有评测,测试集怎么切、准确率和 F1 怎么算、每次改动怎么跑回归。每一样单拎出来都能写一篇,FDE 不用每样都做到最深,但每样都得知道它能干什么、边界在哪,不然在客户面前没法当场判断。
这一段我拆成几步说。
1. 先定方案,小模型的坑我都踩过
早几年做 VoC,用的是 BERT 加分类层,再接一堆规则做后处理。它的问题我到现在都记得很清楚。同一个问题会被打上好几个标签;车主在评价门店,模型给识别成了车型的问题;车主说的是油箱盖,模型给分到了座椅。400 客服电话是先语音转文字再分析的,转写把"行驶着"转成了"行驶证",错字一路传到分类,后面根本救不回来。
大模型出来以后,方案整个换掉了。现在业内常见的做法,是一条“抽取加检索”的链路。
先是抽取。让大模型读原文,把一条评论拆成几个观点,每个观点抽出品牌、车型、场景、情感、意图这些字段,还有它在原文里的位置,按约定好的 JSON 格式输出。用哪个开源模型、多大参数、要不要微调,得看客户给的机器和数据。
然后是检索。把观点用 embedding 模型转成向量,到向量库里召回几个最像的候选标签,相似度够高的直接用,拿不准的再做一次 rerank,从候选里挑最合适的那个,最后给一个置信度,低的交给人工复核。召回多少个、阈值卡多少、rerank 用什么,都是要拿数据一点点试出来的。
最后是标准化。品牌车型要统一,同一款车,车主有简称、有昵称、有带年款的、还有写错字的,都要统一成客户系统里的编码。
为什么不让大模型直接生成标签?因为标签有几千个,私有化环境里能跑的往往是参数不大的模型,让它凭记忆从几千个标签里挑,很容易编出一个标签表里根本没有的名字。而且标签表隔一阵就改一版,模型背下来的东西很快就过时了。所以模型只管理解,标签放在知识库里,改表不改模型。
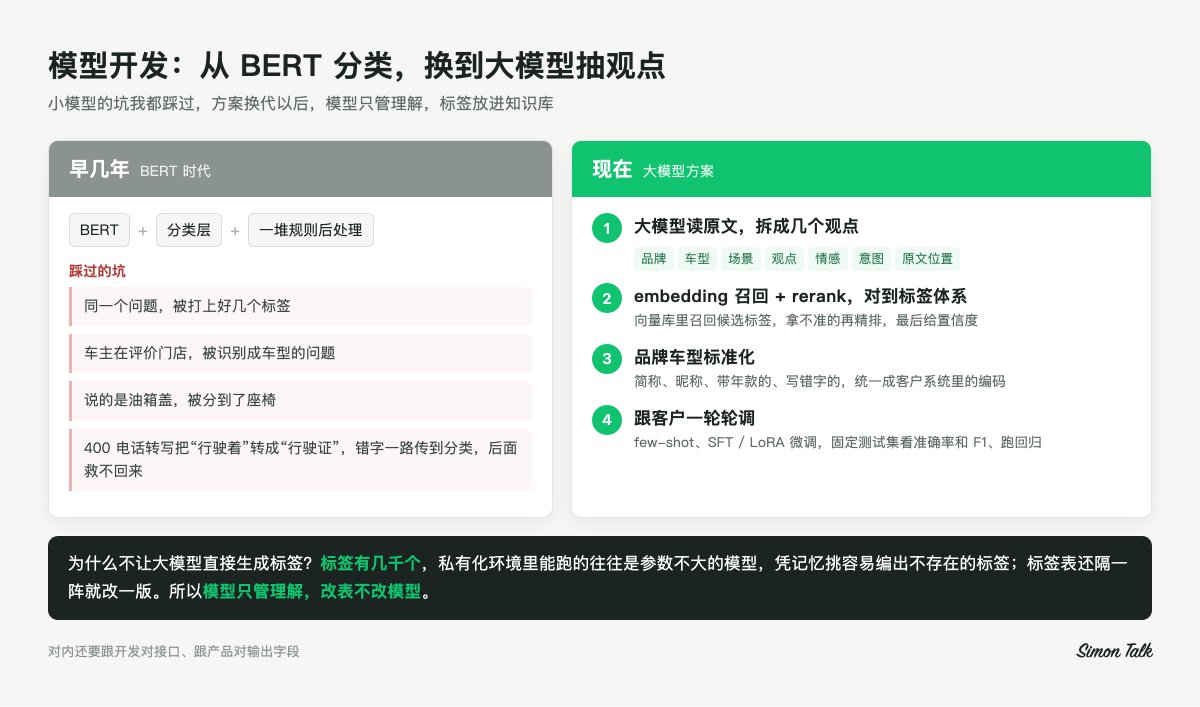
从 BERT 加规则,换到大模型抽观点加知识库匹配
2. 数据、提示词、微调,一样一样磨
方案定了,就是一样一样磨。要从客户的历史数据里挑样本,标注训练数据;要写提示词,在里面放几条 few-shot 示例,告诉模型什么算一个观点、观点要写成什么样、JSON 的每个字段怎么填;效果不够的时候,就拿标好的数据做 SFT,资源有限时常用 LoRA 这类参数高效微调,训完再考虑怎么合进去、怎么加载到推理框架里。
还有很多脏活。原文进来先要预处理,广告、刷屏、没有意义的内容要先过滤掉,手机号这类个人信息要脱敏。模型吐出来的 JSON 时不时少个括号、多个逗号,解析那一层得会自己修。车主一条评论写了几百字、讲了五六件事,要不要先按句子切块(chunking)再抽,切了会不会把一个观点切断,也得试。
每改一次,都要拿固定的测试集跑一遍回归,看标签准确率、观点抽取的 F1 有没有掉,有没有把原来对的改错了。测试集还得按时间切开,调参只用某个日期之前的数据,评估只看之后的,不然分数是虚的。
3. 初版拿给客户看,然后一轮一轮调
初版结果出来,要拿着结果跟客户一起看。客户有专人做人工校验,模型打的标签,对的打勾,错的改掉,我们再把这些校验数据拉回来,一条条看错在哪,补知识库,调提示词,再上一版。
这里面最磨人的,是客户的标准答案本身也会晃。我们把校验数据拉出来一看,同样一句"坐着舒服",一半被打到了座椅,一半被打到了品牌口碑。这时候光调模型没用,得回到第二步,把口径重新跟客户定一遍。
4. 对内,跟开发和产品对齐
这是对外。对内也要花不少时间。
平台那边是开发同事写的 Java 服务,我这边是 Python 的模型服务,两边要对齐接口。单条怎么调,批量一次传多少条,超时多久算失败,出错了返回什么错误码,每个请求带一个 ID,线上出问题能顺着查。
跟产品要确认输出字段。标签要给到几级,情感和意图怎么分,原文定位要不要给,前端好在页面上把那句话高亮出来;置信度要不要给,低于多少的交给人工复核。哪些字段给前端展示,哪些只给报表用,都要提前说定。一个模型做得再好,接口和字段没对齐,产品那边也用不起来。
四、上线:在客户的机器上,从装驱动开始
模型搞好了,要初步上线。车企一般都要私有化部署,模型和服务都跑在客户自己的机器上。这一步全是工程细节,我按顺序说。
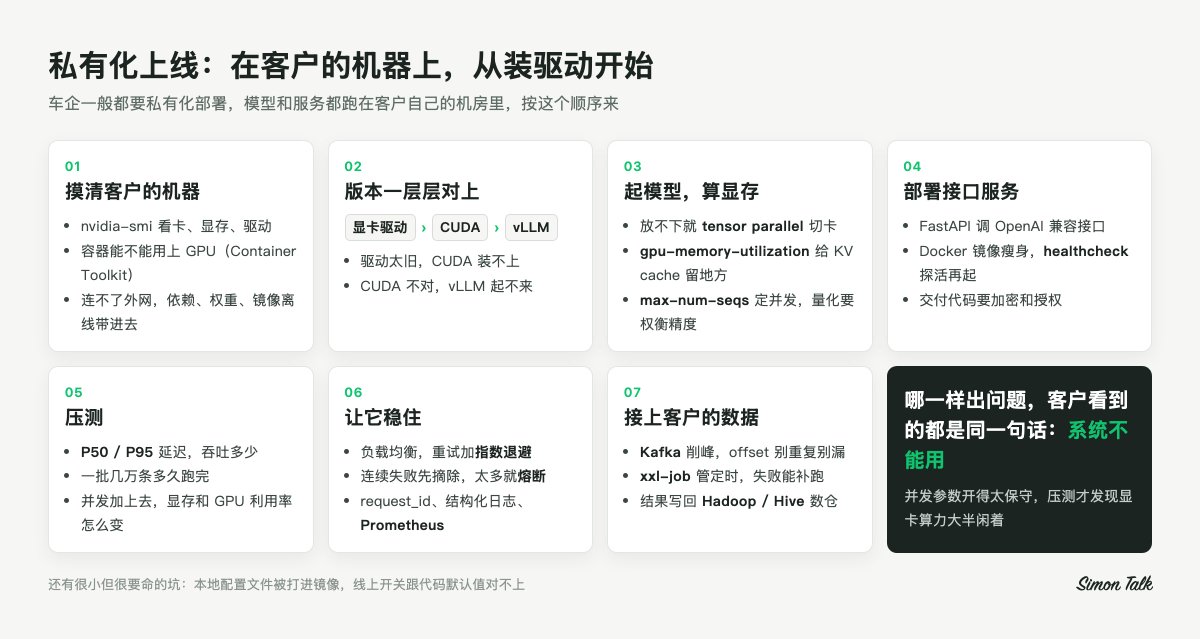
私有化上线的七步,从摸清机器到接上客户的数据
1. 先摸清客户的机器
什么显卡,几张,显存多大,系统什么版本,驱动装没装,能不能连外网。一般先跑一遍 nvidia-smi 看卡和驱动版本,再确认容器能不能用上 GPU,比如有没有装 NVIDIA Container Toolkit。很多时候客户的机器在内网里,连不了外网,依赖包、模型权重、镜像都得提前在外面准备好,离线带进去。
2. 驱动、CUDA、vLLM,版本要一层一层对上
装显卡驱动,装对应版本的 CUDA,再装 vLLM。这几样的版本要互相对得上,驱动版本决定了最高能用哪个 CUDA,CUDA 又要跟 PyTorch、推理框架编译时用的版本对上,驱动太旧 CUDA 装不上,CUDA 不对 vLLM 起不来,哪一层错了都要从头查。所以很多人会直接用容器镜像,把这一层依赖锁死。
3. 把模型起起来,把显存分好
模型用 vLLM 这类推理框架起成服务。这里要算的账不少。模型一张卡放不放得下,放不下就要用 tensor parallel 切到多张卡;放得下的话,是一张卡一套服务,还是几张卡合起来跑。显存要提前分好,模型权重之外还要给 KV cache 留地方,gpu-memory-utilization 要调;如果大模型和向量模型共用一张卡,更要分好比例,不然一个服务把显存吃满,另一个就起不来。max-model-len 决定长文本加提示词放不放得下,max-num-seqs 决定一张卡同时处理多少条请求,模型要不要做量化,也要权衡精度和速度。
4. 部署接口服务
接口服务一般用 Python 写,比如 FastAPI,去调推理框架提供的 OpenAI 兼容接口,再打成 Docker 镜像,用 docker-compose 或者 K8s 编排。镜像要尽量瘦身,客户机器上传、拉取都慢。启动也有顺序,模型容器要配 healthcheck 探活,接口服务等它们都健康了再起,起来以后先自检一遍,模型、向量服务、知识库索引都通了才对外。
交付到客户机器上的代码,还要考虑加密和授权,防止被直接拷走。
5. 压测:单条多快,一批多快,显存稳不稳
然后做压力测试。一条评论多久能出结果,P50、P95 延迟各是多少,一批几万条多久能跑完,吞吐能到多少,并发往上加的时候显存和 GPU 利用率怎么变,请求开始排队是在多少并发。我就遇到过并发参数开得太保守,压测一看,显卡的大部分算力都闲着,这种事不压测是发现不了的。
6. 让它稳住
线上跑起来,要能扛住各种意外。多个模型实例前面要做负载均衡。模型服务偶尔超时,要有重试,间隔指数退避,一次比一次长;某个实例连着失败,就先摘掉,过一会儿再放回来;失败太多就熔断,别让一张卡的问题拖垮整个服务。每条请求带一个 request_id,打结构化日志,记下每一步花了多久,再接上 Prometheus 这类监控和告警,出了问题能定位到是哪一步。
还有一些很小但很要命的坑。比如本地的配置文件被一起打进了镜像,线上的开关就会跟代码里写的默认值对不上,排查的时候只看代码,怎么都找不到原因。
7. 接上客户的数据
数据量大的车企,评论是源源不断进来的,要用 Kafka 做消息队列,进来多少先排着,消费端按模型的处理能力慢慢消化,offset 处理好,别重复也别漏,更别一下子把模型服务冲垮。要用 xxl-job 管定时任务,哪些实时跑,哪些每天夜里批量跑,跑失败了怎么重试、怎么补跑。
标签和知识库也会变,改完以后系统要能热加载,向量索引重建的时候不能停服。
再大一点的车企,有自己的大数据平台,Hadoop、Hive、Dataphin,你的结果要写回他们的数仓,表结构、分区、字段类型、更新频率都要跟他们的数据团队对好,下游的报表才接得上。
这些东西哪一样出问题,客户看到的都是同一句话,系统不能用。
五、上线以后:数据报告和可视化
系统跑起来,事情还没完。
到后面,我还要给客户出数据分析报告,做可视化。
一类是业务报告。这个月车主抱怨最多的是哪几个问题,哪个车型的哪个部件投诉在涨,环比涨了多少,售后哪个环节被骂得最狠,新上市的车型车主最先吐槽的是什么。光有标签还不够,我们还会把意思相近的观点自动聚成一堆,给每一堆起个名字,这样能发现一些标签体系里还没有的新问题。
另一类是效果报告。模型这个月在客户人工校验数据上准确率多少,哪几类标签最容易错,错在哪,下个月打算怎么改。验收的时候,客户要看的就是这份东西。
做成看板以后,客户的人每天打开就能看,重视的车企会一直送到很高级别的领导那里。客户最后真正拿去开会、拿去给领导看的,往往就是这些报告和看板。
算下来,从开第一次需求会到交出数据报告,中间这一整条,基本每一段我都要上手。
六、AI coding:从 24 年底开始,我能直接给客户交 demo
真正让我能一个人全干的,是 AI coding。
1. 我用得挺早
24 年底、25 年初,我就开始用 AI 写前端、写后端,直接做出 demo 给客户看。
举个例子,25 年 1 月,我用 AI 从零搭了一个数据洞察平台的 demo,Next.js 加 Supabase,前端后端数据库一套全有。业务人员可以在页面上自己写提示词、试抽取效果,好用的提示词存成模板,有版本记录;选一个模板就能对一大批数据跑批量抽取,看进度和成本;抽出来的结果自动对到标签知识库里。后面还规划了用向量聚类把没见过的新说法聚出来,建议成新标签,审核通过再上线。
放在以前,这至少要产品、前端、后端、算法几个人一起排期。这个 demo 基本是我一个人做的,大部分代码是 AI 写的,我负责想清楚要什么,再一页一页看它做得对不对。
2. 在客户现场,几天交一个真数据 demo
到了 25 年,我基本就在客户现场。拿到需求,先跟客户把最关键的几个页面、几个字段对清楚,然后让 AI 把前后端搭起来,接上客户的真实数据,几天之内就能给客户看一个能点能用的产品 demo。
用真实数据很重要。客户看到的是自己车主的原话、自己车型的问题,一眼就知道这东西有没有用,有用在哪,还差什么。很多需求是在看到 demo 以后才真正想清楚的,比你在会议室里聊三轮都管用。
以前一个需求从提出来到看到东西,要写需求文档、排期、开发、联调,几个星期甚至几个月;现在客户提完需求,过几天就能在自己的数据上点来点去。
3. 连我自己干的活,也慢慢交给 AI
到了今年,变化更大的是我自己的工作方式。前面说的很多活,我都写成了 AI 能直接用的工具。
标签体系几千个标签,二义性、冲突、层级合不合理,人一条条看根本看不过来。我写了一个让 AI 专门审标签体系的 skill,它把有问题的地方挑出来、写成报告,我再拿着报告去改。
知识库里有几万条例句,哪些例句跟标签对不上,哪些一句话里塞了好几个观点,哪些互相冲突,也是先让 AI 按规则加语义判断扫一遍,出审计报告和清洗后的版本,我再挑着看。
调提示词以前是改代码、跑脚本、看日志。现在我做了一个提示词工作台,在浏览器里改提示词,单条测、批量测、两个版本 A/B 对比,每条结果当场判对错。
标数据也一样。先让 AI 按我写好的口径规则预标一遍,我在标注工作台里只做纠错,碰到拿不准的边界,我拍板,再写回规则里,下一轮 AI 就按新规则标。
就连前面说的效果报告,现在也是测试集跑完,AI 自动做错误归因,直接生成一份 Word 分析报告。
所以我的感受是,AI 没有替我把业务想清楚,口径还是我跟客户一条条定的;但定下来以后的那些体力活,它干得比我快得多。
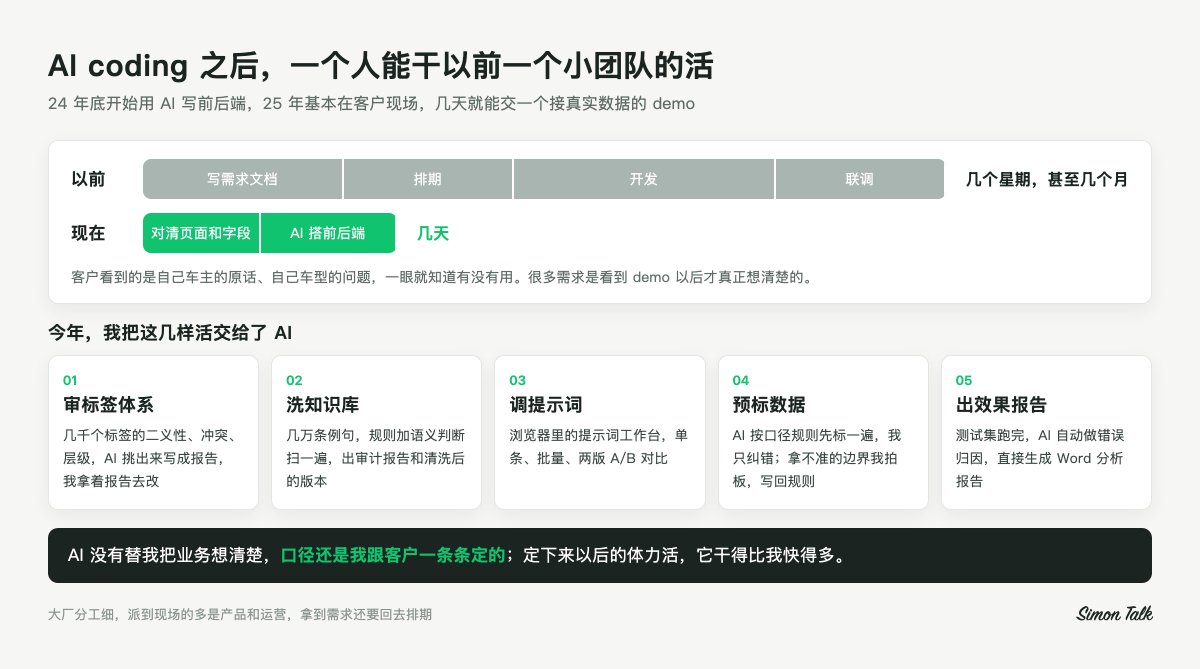
AI coding 前后交付速度的对比,以及今年交给 AI 的五件事
4. 为什么说这样的人稀缺
像字节、阿里这样的大厂,在我看来很难这么干。大厂分工很细,每个人是一颗螺丝钉,派到客户现场的多半是产品和运营,拿到需求还要回去排期给研发。我这样从需求、算法、工程到前后端都能自己来的人,放在大厂里反而不太好找。
说实话,我是吃到了技术红利的。十年 NLP 打的底子,加上车企现场磨出来的业务理解,正好赶上 AI coding 起来,一个人能干完以前一个小团队的活。现在回头看,这样的人其实挺稀缺的,这大概也是 Anthropic 愿意花一亿美元去培养的原因。
七、今年 FDE 火了,大厂才开始招
我干这些活的时候,国内很少有人管它叫 FDE,招聘上也很少见到这个岗位。
到了今年,FDE 一下子火了。国外是 OpenAI、Anthropic、Google 这些公司在抢人,国内大厂也开始专门招这个岗位。我看到的报道里,字节、腾讯、美团今年 6 月都挂出了 FDE 相关的岗位,阿里没直接用这个名字,招的是职责差不多的企业客户解决方案架构师。
有一条招聘要求我印象很深,腾讯写的是希望候选人能跟非技术背景的高管讨论 ROI。看到这句我挺有感触的,这不就是我前面一直在说的事吗,跟一个不懂技术的人讲清楚,这件事值不值、为什么这样做。
看到大厂今年才开始专门招这个岗位,回头看我这几年干的事,也算是走在了前面。
八、国内的 FDE,和最早的 FDE 不太一样
FDE 这个岗位最早是 Palantir 搞出来的,全称 Forward Deployed Engineer,前线部署工程师,意思是工程师不待在总部,直接派到客户的一线去。Palantir 内部管这群人叫 Delta,他们挂在商务拓展部门下面,任务是把 Palantir 的软件平台部署到客户那里,做出实际的技术结果。跟他们搭档的还有一个岗位,叫部署策略师,内部叫 Echo,更偏业务,负责把客户一个模糊的想法变成能落地的方案。
后来 OpenAI、Anthropic 都学了这套,Anthropic 这次用的是 Frontier Deployed Engineer,前沿部署工程师,名字变了,意思差不多。
对比下来,我觉得国内的 FDE 跟最早的 FDE,至少有几个地方不一样。
第一,背后站着什么。Palantir 的 FDE 背后是自家很成熟的软件平台,OpenAI、Anthropic 的 FDE 背后是自家最强的模型,他们去客户那里,更多是把一个现成的东西部署好、改合适,现场学到的东西还会回流到产品里。国内很多做这类活的人,包括我自己,背后没有这样一个平台,大多是项目制,一个项目从头搭一遍,做完留在客户那里,下一个项目再从头来。
第二,分工。Palantir 把偏技术的 Delta 和偏业务的 Echo 分开,两个人配合着干。国内常见的情况是一个人全包,售前、业务、算法、工程、报告都是你,就像我前面讲的那样。
第三,交付环境。国外的大模型公司,很多时候可以直接用云上最强的模型。国内的大客户,车企、金融、国企,大多要求私有化部署,模型跑在客户自己的机房里,卡就那么几张,能用的往往是开源的小模型,你得在这个限制里把效果做出来。
第四,怎么收钱。国外的 FDE 很多是为了卖平台、卖模型,FDE 本身是投入,后面靠长期合同赚回来。国内大多还是按项目收费、分阶段验收,FDE 的成本算在项目里,验收不了,钱就不好拿。阿里云的人今年在云栖大会上也讲过,他们更看好的是按效果收费,和跟重点客户签长期服务合同,这说明大家也都意识到了,单纯按项目卖人天走不远。
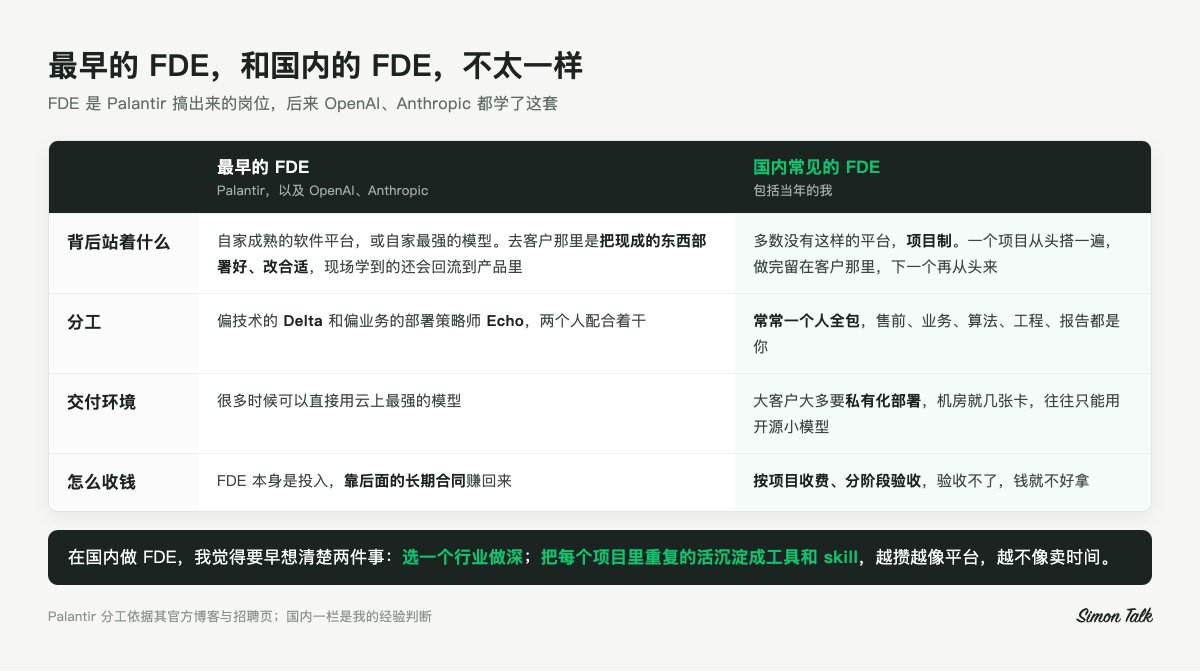
最早的 FDE 和国内常见的 FDE,在四个地方不一样
九、国内的 FDE 好不好做
我的看法是,能做,但没有现在说得那么好做。
好的一面是需求是真的多。今年几乎每家企业都在想 AI 怎么落地,政策上也在鼓励服务商搭 FDE 团队,大厂开始招,这个岗位的价值终于被看见了。AI coding 又让一个人能干以前一个小团队的活,懂业务又能动手的人,议价能力会越来越强。
难的一面也很明显。国内甲方普遍强势,预期管理很难,前面说的不敢承诺和瞎承诺,在国内项目里太常见了。项目制做多了,很容易变成高级外包,一个项目一个项目地卖时间,人很累,东西也沉淀不下来。私有化环境又复杂,卡少、网络受限、版本对不上,很多时间花在跟效果无关的事情上。
所以如果你想在国内做 FDE,我觉得有两件事要早点想清楚。
一是选一个行业做深。我在汽车行业做了 4 年多,业务懂得越深,在客户面前越有话语权,预期也越好管。什么行业都做一点,每次都从零开始理解业务,是最累的。
二是把每个项目里重复的活沉淀下来。标签体系怎么审,知识库怎么洗,提示词怎么调,效果报告怎么出,我现在都把它们做成了工具和 skill,以后的项目也能接着用。攒得越多,你就越接近一个平台,越不像一个只卖时间的人。
十、最后
写到这里,差不多把我这几年在车企干的活都摊开了。最后说几句给不同的人听的话。
1. 如果你想转 FDE
我的建议是别只练模型。售前怎么开会、预期怎么管、业务怎么吃透、机器怎么部署、报告怎么写,这些才是把模型变成项目的部分。
不同背景转过来,要补的东西不一样。
算法出身的,跟我一样,模型这块不用担心,要补的是工程和沟通。去自己装一遍驱动、起一遍 vLLM、做一次压测,再试着跟一个完全不懂技术的人讲清楚,你的模型为什么是这个准确率。
开发出身的,工程能力是你的优势,要补的是模型和业务。你得知道模型的边界在哪,哪些能做、哪些做不好,不然在客户面前还是没法当场判断。
产品或者解决方案出身的,沟通和业务是你的优势,要补的是技术判断。至少自己用 AI coding 做出一个能跑的 demo,自己调一遍提示词、跑一遍效果,心里才有底,才不会在客户面前瞎承诺。
不管哪种背景,有两件事都要早点做。一是挑一个行业扎下去,二是把 AI coding 用熟。前者决定你在客户面前有没有话语权,后者决定你一个人能干多少活。
2. 如果你是企业,想找人做 AI 落地
我也说说站在甲方角度,怎么判断一个 FDE 靠不靠谱。
第一,看他能不能当场判断。你提一个需求,他是只会说回去评估,还是能当场告诉你哪些能做、能做到什么程度、哪些要人兜底。能当场说清楚的人,后面一般不会给你挖坑。
第二,看他懂不懂你的行业。他能不能听懂你们各部门的话,知不知道你们的业务里哪些地方最容易出问题。
第三,看他手里有没有东西。能不能几天给你做一个接上真实数据的 demo,手里有没有在别的项目里攒下来的工具。只会讲方案、拿不出东西的,要小心。
3. 我接下来做什么
在 X 上,我会接着把这几年的东西一块一块写出来。私有化部署踩过的坑,一套标签体系是怎么跟各部门磨出来的,怎么用 AI coding 在几天里给客户交一个真数据 demo,还有现在大家都在聊的 Agent,放到企业里到底卡在哪。
我知道这类内容可能没多少人看,现在大家更喜欢看结果,我自己刷推也一样。但这些都是我真做过、真踩过的东西,写出来至少能让我自己再理一遍,也许对正在做这件事的人有点用。
如果你也在做企业 AI 落地,或者在考虑转 FDE,欢迎来聊。如果你的企业正好想做 AI 落地,想找人帮着评估一下能不能做、怎么做,也可以直接找我。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。