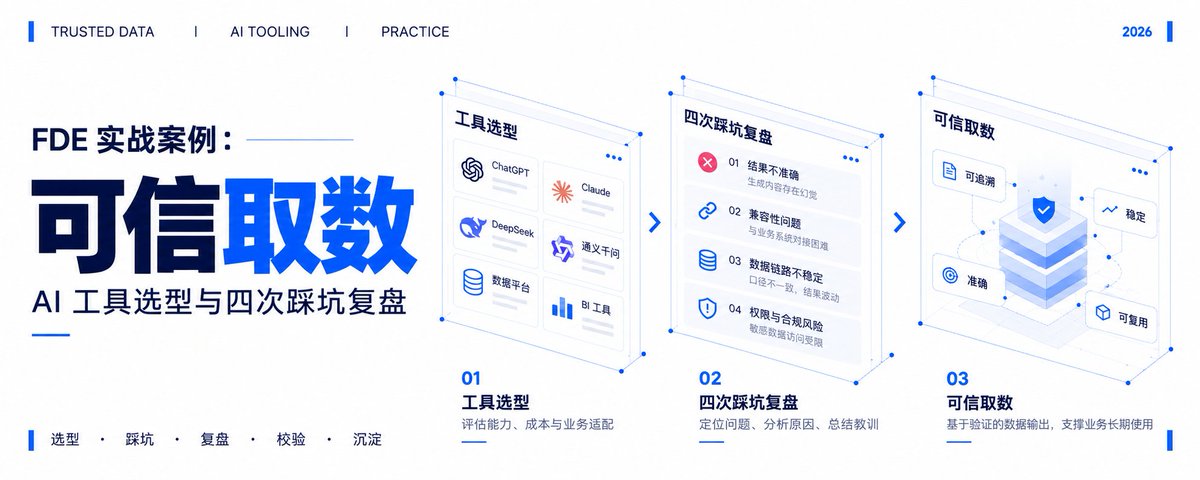
FDE 实战案例:可信取数(AI 工具选型与四次踩坑复盘)
文章目录
上一篇讲的是数据清洗。我们去一家美妆企业做 FDE 落地,把小红书、抖音等平台的帖子、评论和视频内容整理好,再存进数据库。
数据洗完以后,客户接着提了一个需求:
看过去 30 天,某款精华在小红书和抖音上的口碑怎么样?大家主要在讨论保湿、抗老、肤感还是香味?负面评价集中在哪里?
听起来只有一句话,真正落到查询里,至少要先确认五件事:查哪个对象、看哪个时间、从哪些来源取数、用什么指标、最后要不要把原帖证据一起带回来。
任何一项没说清楚,系统都给不出正确的答案。
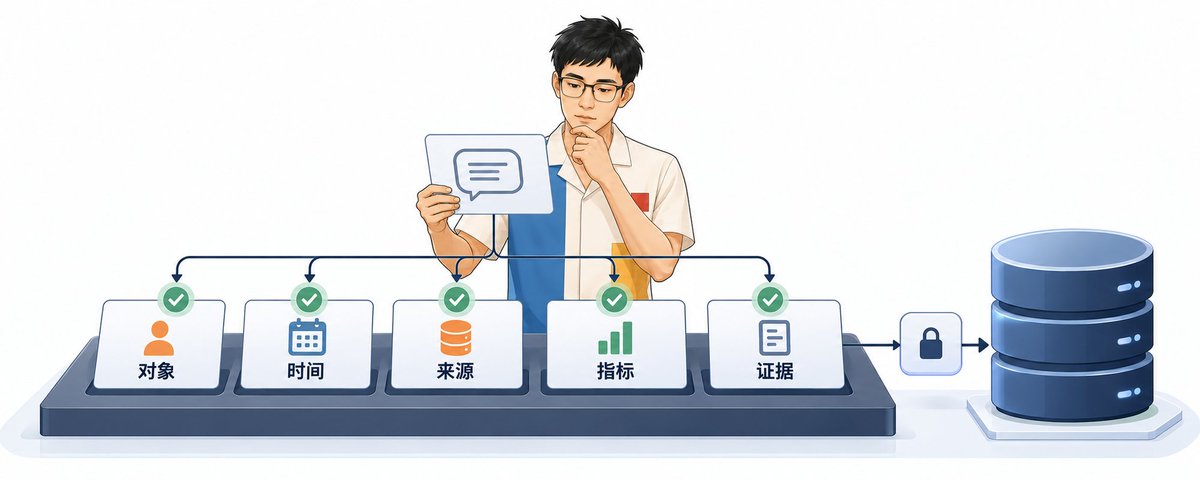
如果只是临时查一次,分析师打开系统,选好产品、平台和时间,慢慢筛就行。
客户想要的当然不是临时,而是稳定的每日运行:以后遇到类似问题,AI 能自己查数,结果还要稳定、准确,最好能把对应原帖一起带回来。
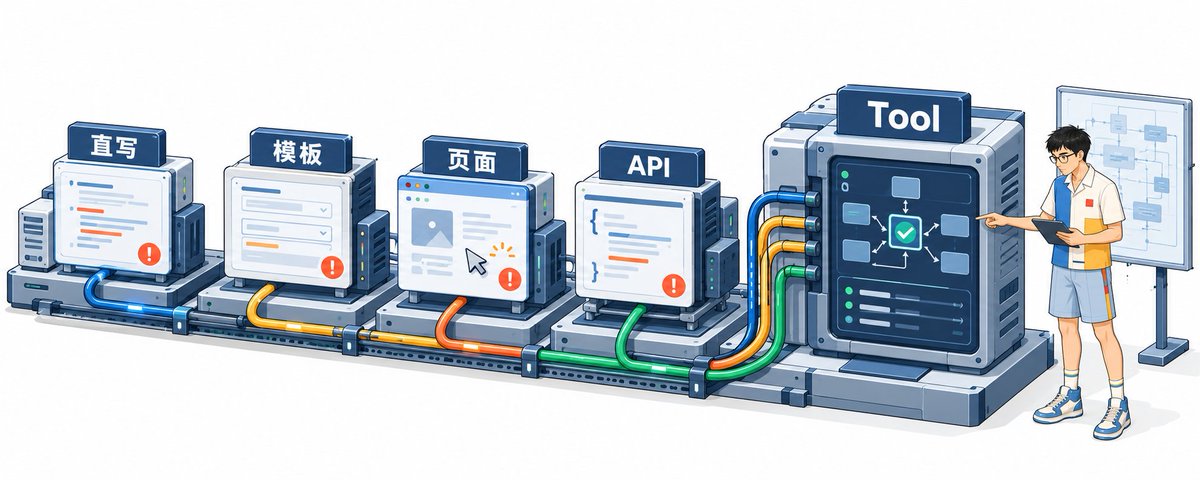
为了把这个需求做出来,我们试了四种办法。每一种都能跑,也都碰到了新的问题。今天这篇文章,就把这些我们遇到的坑讲清楚。
为什么这里会用 ES
大家可能先有一个疑问:数据都进库了,为什么还要专门讲 ES?用 PostgreSQL 或普通 SQL 数据库不行吗?
这里简单解释一下概念。SQL 是一类数据库查询语言,PostgreSQL 本身就是关系型数据库,也使用 SQL。它更适合存项目、用户、权限、订单这类结构稳定、关系明确的数据。
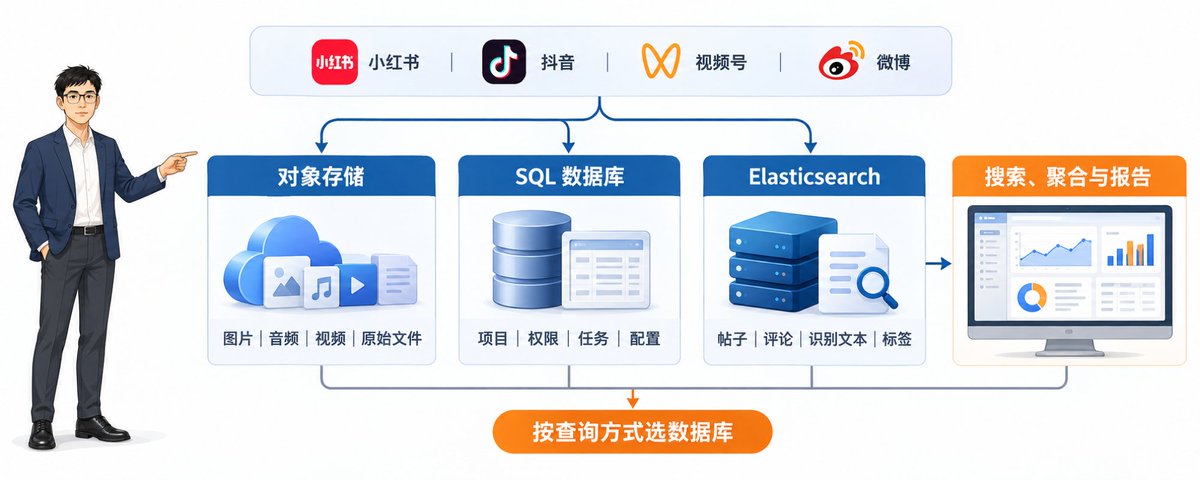
ES 更擅长处理:内容很多,来源很多,查询方式还经常变化。
拿这次美妆项目来说,今天要搜某款精华的口碑,明天要比较两个品牌,后天又想追一条突然上升的负面话题。分析师既要搜索原文,也要不停地换时间、平台、产品和统计方式。这个场景更适合放在 ES 里查。
图片、音频、视频等原始文件单独保存;项目和权限等业务信息放在 PostgreSQL 这类关系型数据库;需要反复搜索和统计的帖子、评论放进 ES。数据库怎么选,先看数据是什么样,再看人准备怎么用。
ES 选好了,下一个问题也很自然:既然只是查数据,让 AI 直接写查询不就行了?
我们一开始也是这么想的。
ES 里的一条内容,到底长什么样
很多人第一次听到“帖子和评论已经存进 ES”,脑子里想的是一张普通表格:一行内容,加上平台、时间和互动量几列。
实际项目里,一条社媒内容往往会展开成一份很宽的文档。里面除了原帖,还有发布用户、图片 OCR、视频 ASR、品牌和产品、评论关系、互动快照以及模型生成的标签。业务越往后做,字段就越多,一条记录出现几百个字段很常见。
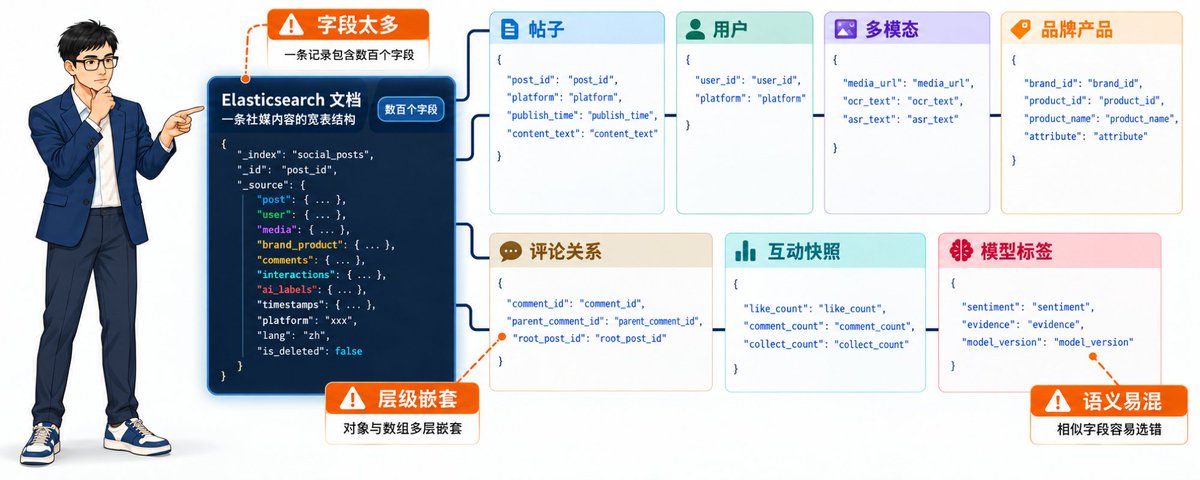
这张图就是一个简化后的样子。左边是一条 ES 文档,右边把它拆成了几个业务区域:帖子、用户、多模态内容、品牌产品、评论关系、互动数据和模型标签。
麻烦也是从这里开始的。业务人员问“精华 A 的负面评价”,AI 不只要找到“精华 A”这几个字,还要判断:
-
负面说的是整篇帖子,还是帖子里对精华 A 的具体评价;
-
时间按发布时间算,还是按系统采集时间算;
-
数据只看原帖,还是帖子和评论一起看;
-
图片里的文字、视频口播和正文,要不要一起搜索;
-
最后的声量,数帖子、评论、用户还是具体观点。
ES 真正难的地方不只是“字段多”,而是很多字段长得相似,代表的业务意思却不一样。AI 选错一个位置,查询照样能执行,结果也照样有数字,只是回答的已经不是原来的问题。
第一次尝试:让 AI 直接写 ES 查询
做法简单粗暴,业务人员提问题,AI 根据数据说明生成查询,再去 ES 里拿结果。
简单问题确实能跑。比如“查过去 30 天提到精华 A 的帖子”,产品和时间都很明确,AI 很快就能给出结果。
但是问题出现在“查精华 A 的负面评价”上。
举个例子:有一篇帖子同时提到了两款产品:用户说精华 A 的保湿不错,又说精华 B 用起来太黏。
AI 如果只看到“帖子里出现了精华 A”和“帖子里有负面评价”,就可能把这篇内容算成精华 A 的负面口碑。
这样的数量特别多,一旦统计错,结果是很可怕的。
如果条件再多一点,AI 还可能漏掉某个平台、选错时间范围,或者把评论和原帖混在一起。这条路适合快速验证,直接拿去做日常报告,风险太高。
还有一类问题更隐蔽:查询条件选对了,统计方法仍然可能选错。比如先筛出提到精华 A 的内容,再统计整篇帖子的情感,和直接统计“用户对精华 A 的具体观点”,最后得到的负面比例可能完全不同。
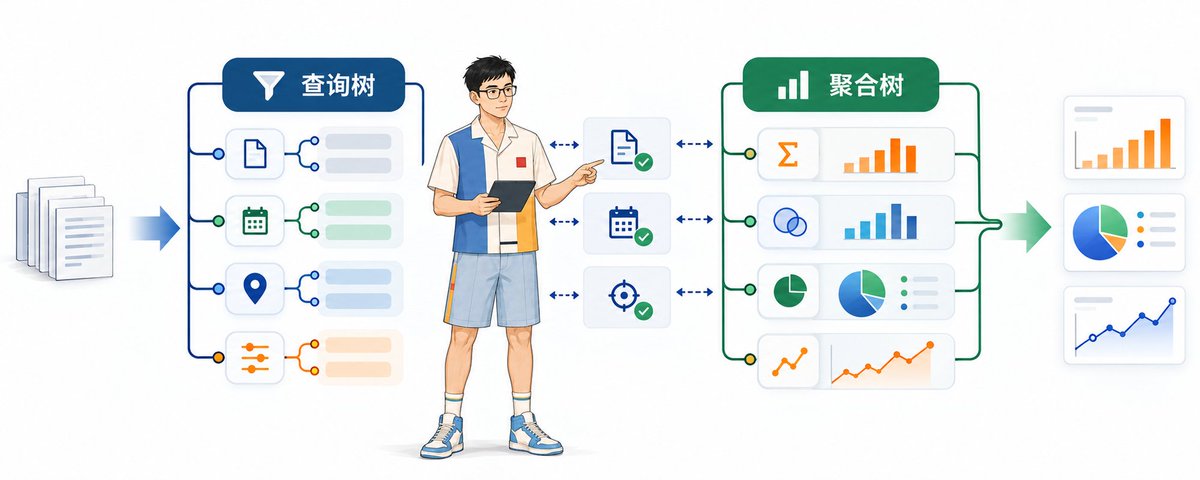
所以一条 ES 查询里其实同时有两件事:左边的查询树决定“哪些数据能进来”,右边的聚合树决定“这些数据怎么算”。只保证查询不报错,还远远不够。
于是我们换了第二种办法:既然 AI 临时写查询容易出错,那就把查询先写好。
第二次尝试:把查询写成固定模板
我们把产品、平台、时间等常用条件做成固定模板。AI 不再临时拼一整段查询,只要把几个选项填进去。
这一步解决了不少问题。查询格式不会一会儿一个样,同一类任务也方便反复测试。
很快又碰到了另一个问题:模板能固定动作,固定不了业务的意思。
比如业务说“看一下这款精华的声量”。有人说的声量只算原帖,有人会把评论一起算进去,还有人更关心参与讨论的人数。这三种算法都说得通,结果却不是一回事。
如果模板默认数原帖,而客户这次想看帖子加评论,系统会很稳定地给出一个不符合需求的数字。
我们当时先把最常用的产品、平台和时间做成固定选项,连续跑几轮以后,格式确实稳定了,测试也方便了。可一换到“声量”“热度”“负面口碑”这种业务词,问题又回来了:模板知道往哪里填,却不知道这次该采用哪一种算法。
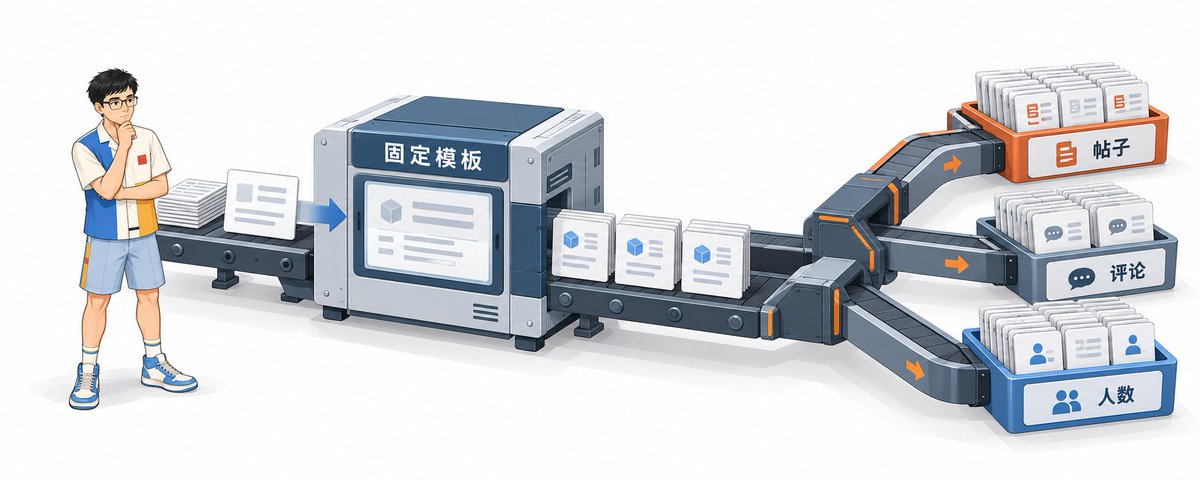
这次尝试让查询变稳了,但业务问题仍然可能理解错。我们又想到,分析师平时在页面里查数,那就让 AI 直接操作页面。
第三次尝试:让 AI 像分析师一样点页面
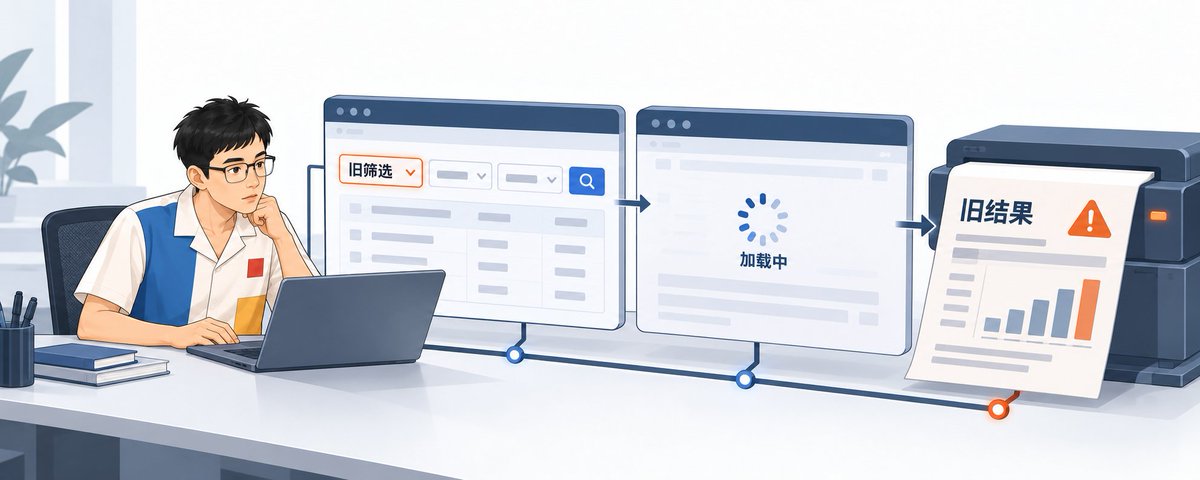
这就是 Computer Use。AI 打开现有分析系统,选择项目、产品和平台,设置时间,再读取页面上的结果。
它的好处很明显:现有系统可以直接复用,暂时不用改后端。做演示或者偶尔查一次,也很直观可以看出来。
但页面操作有一个麻烦,步骤太长。
我们碰到过这种情况:上一轮查的是品牌 B,这一轮准备查精华 A,旧筛选没有完全清掉;或者页面还在加载,AI 已经开始读取结果。最后拿到的数字看着正常,其实混进了上一轮条件,或者干脆读到旧结果。
页面按钮换个位置、加载时间变长、执行中途断掉,都会增加恢复成本。偶尔用一次没问题,要连续跑日报、周报和竞品切片,就会越来越慢。
现场测试时,第一轮往往看起来很顺:打开页面、选产品、选时间、读结果。真正麻烦的是第二轮和第三轮。旧条件有没有清掉、页面到底加载完没有,AI 很难像熟练分析师那样随时察觉;一旦读到旧数字,它也未必知道自己错了。
既然页面太绕,下一步当然是绕过页面,直接调用系统接口。
第四次尝试:直接调用现有业务 API
这一步速度快了很多。AI 不需要打开页面,直接把查询交给业务系统,系统返回结果。
问题在于,原来的 API 是给前端程序用的。页面知道用户现在在哪个项目,选的是哪份数据,每个按钮在系统里对应什么。AI 只拿到一句“查精华 A 的负面口碑”,这些背景它都不知道。
可以把它理解成一家餐厅的收银系统。店员按一下“招牌套餐”,系统知道后面对应哪些商品和价格。现在把收银系统的内部操作直接交给一个第一次来的外人,他看到的全是系统自己的暗号,很难每次都填对。
业务 API 也一样。它执行得很快,但它没有按照 AI 容易理解的方式设计。直接把原始接口交给模型,依然会遇到选错范围、用错算法或者缺少必要条件的问题。
我们这一步的测试结果也可以体现:接口速度没有问题,系统也能返回数据,但模型要自己补齐项目、数据源、字段和组合规则。
前端原来替用户记住的上下文,现在全要模型猜。少一个条件可能返回空值,填错一个条件也可能得到一份看似正常,实际毫无用处的数据。
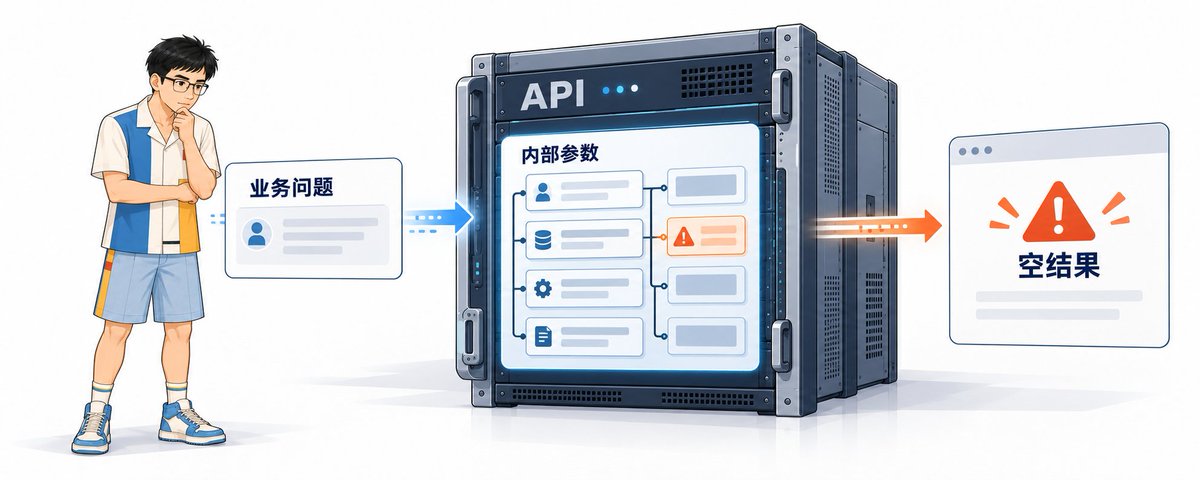
四条路走完以后,问题已经很清楚了:现有 API 继续负责执行,前面再加一层 AI 能听懂、业务也能检查的工具。
最后为什么回到 MCP 和 Tools
先说 Tool。
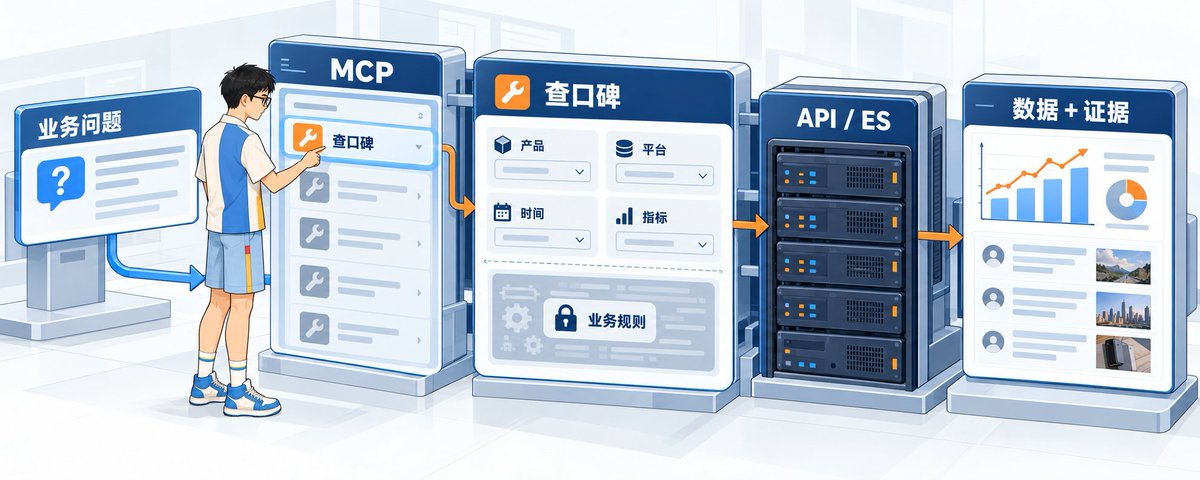
Tool 就是 AI 可以调用的一个具体动作。比如“查询产品口碑”“比较竞品趋势”“找出负面讨论增长最快的话题”。每个 Tool 都提前写清楚需要哪些信息,以及最终会返回什么。
拿“查询产品口碑”来说,AI 只需要确认:
-
查哪款产品;
-
看哪几个平台;
-
时间范围是什么;
-
按帖子、评论还是人数统计;
-
要不要带回原帖证据。
产品在系统内部叫什么、查询该怎么执行、结果为空时怎样判断原因,这些都留在 Tool 里面处理。
MCP 则是一套让 AI 发现和调用这些 Tools 的通用方式。你可以把它理解成给 AI 一张工具菜单:有哪些工具、每个工具是干什么的、需要填写什么。AI 根据业务问题选工具,再补齐有限的几个条件。
这比让 AI 自己写一整套查询简单得多。前者更像做选择题,后者更像让它临场写一份没有标准答案的程序。
不过,接上 MCP 不会自动让数据变准。MCP 负责把工具交给 AI,Tool 里面的业务规则仍然要有人定义。
FDE 在这里做的到底是什么
这时候再看 FDE,它主要做的事情也很明确了。
客户说“我要看精华 A 的负面口碑”,FDE 要继续往下问:这份数据最后给谁看?他要拿它做什么判断?负面看整篇内容,还是看用户对具体体验的评价?一篇帖子里提到两款产品怎么办?数字出来以后,要不要附原帖让分析师复核?
这些问题先说清楚,才能把“查询产品口碑”做成一个真正可用的 Tool。
所以 FDE 先处理业务问题,工程实现排在后面。
业务需要什么,就把它拆成 AI 能理解的条件,再把这些条件交给工具执行。MCP 是中间的连接方式,真正决定结果能不能用的,还是前面的业务定义。
最后带走一套可执行清单
如果你也想让 AI 从企业数据库里查数,可以按下面这条线做:
一,先拿一个真实问题。 不要从“做一个万能查数 Agent”开始。先选一条业务每天都在问、人工已经知道怎么查的问题。
二,根据数据和用法选数据库。 结构稳定、关系明确的数据优先放在 PostgreSQL 等关系型数据库;需要搜索大量内容、频繁换条件统计时,再考虑 ES。
三,把问题里没说出口的条件补齐。 查谁、查什么、怎么算、结果给谁用,都要写清楚。
四,用真实难例测试。 一篇内容提到多个产品、同一产品有多个叫法、帖子和评论同时出现,这些情况都要专门测。
五,把高频需求做成 Tool。 一个 Tool 只负责一个明确动作,输入尽量少,计算规则固定,失败时把原因说清楚。
六,通过 MCP 交给 AI 调用。 让 AI 负责理解问题和选择工具,内部查询交给 Tool 完成。
七,结果必须能复核。 数字后面带回原帖、评论或其他证据。分析师能抽查,报告才敢继续用。
这套做法说到底,就是先把业务问题问明白,再让 AI 调工具。顺序反过来,模型能力再强,也可能只是更快地给出一个看起来合理的错误答案。
下一篇再继续讲:Tools 做好以后,Agent 怎么分步执行,查询失败以后又该怎么重新规划。
我是 Miles,做 AI 算法研发、企业 AI 培训和 FDE 落地交付。
关注我 @miles_mazy,继续交流企业 AI 的实际做法。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。