
去水印神器 watermarks-remover 保姆级教程:装好、会用、别踩坑
文章目录
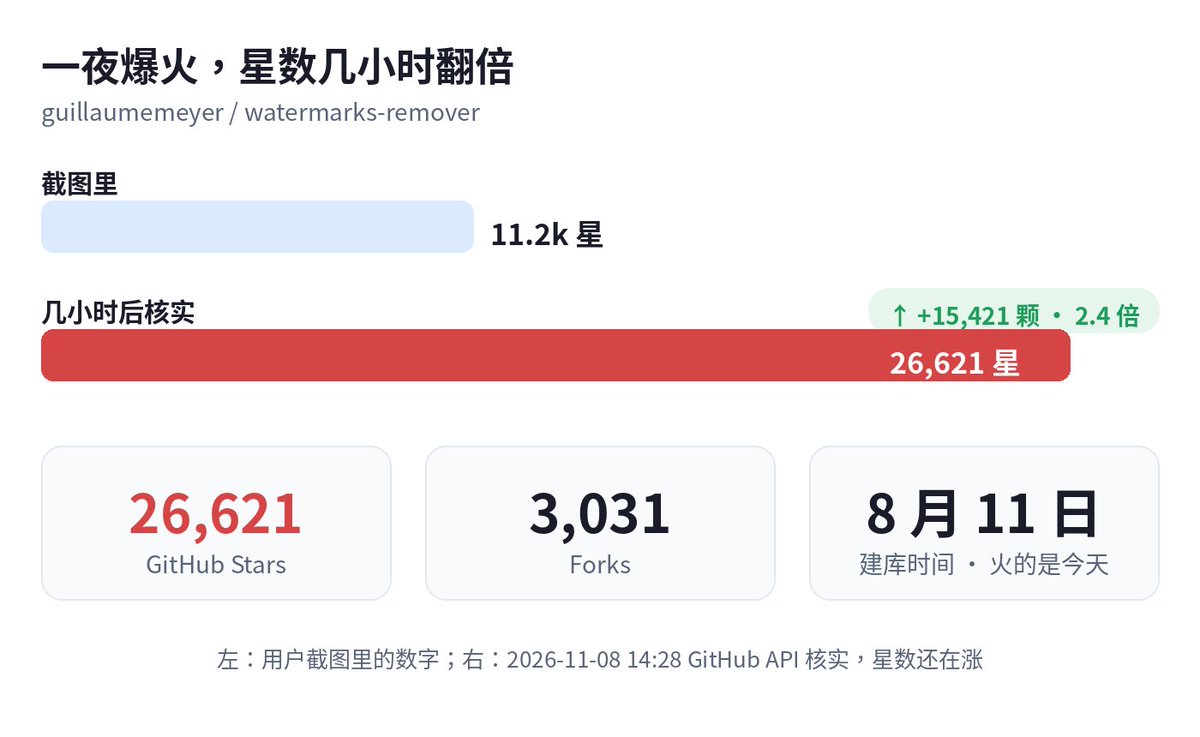
GitHub 上一夜爆火的去水印神器,仓库叫 watermarks-remover。 截图里 11.2k 星,几小时后核实已经 26,621 星、3,031 fork。 MIT 开源,作者 guillaumemeyer,仓库 8 月 11 日建的,最新版 v0.7.0。 一句话:把 AI 内容里的溯源标记抹掉,只用在你自己的内容上。 这篇把安装、用法、钩子、HTTP 服务、坑,全写清楚了。
一、这是什么,能去什么
它是一个 Agent skill + 一个标准 Python 服务。 Skill 是个薄客户端,通过 HTTP 调服务,Agent 那边不用装 Python。 服务跑在本地,Python 3.10+ 自带库就行,不用装依赖,不用 Docker。
能去的东西分三层:
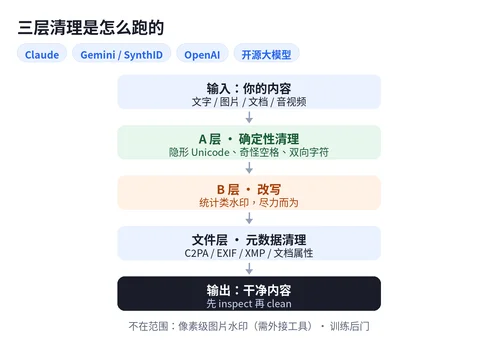
一、文字层A :隐形 Unicode、奇怪空格、双向字符、标签字符。 确定性清理,脚本直接抹掉,可验证。 二、统计层 B:统计类文本水印(token 采样水印)。 靠 Agent 改写 + 可选的改写钩子,尽力而为,不保证归零。 三、文件层:图片、文档、音频、视频里的 C2PA、EXIF、XMP 和文档属性。
覆盖的厂商(按类别):Claude、Gemini/SynthID-Text、OpenAI,以及开源大模型的 Kirchenbauer 绿名单、keyed-Gumbel/EXP(Aaronson)类水印。
格式支持很全:PNG、JPEG、WebP、AVIF、HEIC、BMP、GIF、TIFF、SVG、PDF、DOCX、XLSX、PPTX、EPUB、ODT、HTML、Markdown、MP4/MOV/M4A/M4V、WAV、MP3、FLAC。
去不了的也要说清楚。 像素级图片水印不在核心范围内,要外接 CtrlRegen 或 MarkDiffusion 这类重型工具。 训练后门不在范围内。 统计类水印没有哪家工具敢打包票说"官方检测一定查不出来",因为厂商的检测器和密钥不公开。
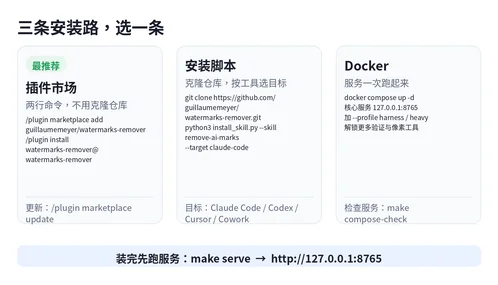
二、安装:三条路,选一条
先装 Python 3.10+,核心脚本只用标准库。
路线一:插件市场,两行命令,不用克隆仓库(最推荐)。 在 Claude Code 里执行:
/plugin marketplace add guillaumemeyer/watermarks-remover /plugin install watermarks-remover@watermarks-remover
装好以后两个 skill 都能用:/watermarks-remover:remove-ai-marks 和 /watermarks-remover:clean-user-facing-text。 更新用 /plugin marketplace update watermarks-remover。
路线二:安装脚本,按你的工具选目标。 先克隆仓库,再跑一条命令:
git clone https://github.com/guillaumemeyer/watermarks-remover.git python3 install_skill.py --skill remove-ai-marks --target claude-code
目标对照表:
-
Claude Code 个人:--target claude-code,装到 ~/.claude/skills/
-
Claude Code 项目:--target claude-project --project-dir /path/to/project,装到项目 .claude/skills/,提交进仓库全组共享
-
Codex 个人/项目:--target codex / codex-project
-
Cursor:--target cursor(默认)
-
Cowork / claude.ai / 云端会话:--target cowork,会生成 dist/remove-ai-marks.zip,再去桌面端 Customize → Skills → Add 上传
-
Grok:软链接到 .grok/skills 或 ~/.grok/skills
路线三:Docker,服务一次跑起来。
docker compose up -d # 只跑核心服务 docker compose --profile harness up -d # 加 MarkLLM 等验证工具 docker compose --profile heavy up -d # 加 CtrlRegen、SynthID 像素工具,需本地构建
核心服务映射到 127.0.0.1:8765。 检查服务:make compose-check。
装完先把服务跑起来:
make serve
或者直接跑:python3 service/scripts/server.py --host 127.0.0.1 --port 8765
默认地址 http://127.0.0.1:8765。 Windows 用户看仓库里的 docs/windows-autostart.md,可以开机自启。
可选工具,装了更好:
-
c2patool:查 C2PA 清单
-
exiftool:清残留元数据,尤其是 PDF
-
qpdf:PDF 真正去元数据必须有它(原因见第六节) Core Docker 镜像里这三个都预装了。
还有一个轻量选择:只要清文字,不想跑服务。 装 clean-user-facing-text 这个 skill,自带脚本,不调服务:
python3 install_skill.py --skill clean-user-facing-text --target claude-code
三、最快上手:先查,后清
原则:先 inspect 看看有什么,再 clean 动手。 统一入口(按格式自动分流):
SCRIPTS=service/scripts
统一检查 / 清理
python3 "$SCRIPTS/inspect_file.py" draft.md python3 "$SCRIPTS/clean_file.py" draft.md -o draft.cleaned.md python3 "$SCRIPTS/clean_file.py" photo.png -o photo.cleaned.png python3 "$SCRIPTS/clean_file.py" notes.docx -o notes.cleaned.docx
只清文字
python3 "$SCRIPTS/inspect_text.py" draft.md python3 "$SCRIPTS/clean_text.py" draft.md -o draft.cleaned.md --stats
只清图片
python3 "$SCRIPTS/inspect_image.py" shot.png python3 "$SCRIPTS/clean_image.py" shot.png -o shot.cleaned.png
--stats 会告诉你清掉了多少东西。
统计层 B 的改写钩子:
python3 "$SCRIPTS/rewrite_text.py" draft.md --backend print-prompt --tactic paraphrase
默认只打印改写提示词,不调模型,不花钱。 想本地跑模型,接 Ollama(默认只允许本地回环地址):
WATERMARKS_REWRITE_BACKEND=ollama WATERMARKS_REWRITE_MODEL=llama3.2 \ python3 "$SCRIPTS/rewrite_text.py" draft.md -o draft.rewritten.md
API 密钥只从环境变量 WATERMARKS_REWRITE_API_KEY 读,绝不放命令行里。
两个安全设计,值得知道。 一、文字工具拒绝二进制输入。 拿 inspect_text.py 去扫 .docx、.pdf、图片,它会直接拒绝,告诉你用 inspect_file.py。 以前的版本会把压缩字节当文本解码,再写回去把文件写坏。 二、不认识的格式绝不自动清理。 clean_file.py 碰到未知格式直接拒绝(exit 2),不写任何输出,不会把你的文件弄坏。
四、让 Agent 自动干活:Skill + 钩子
装好 skill 以后,在 Claude Code 里直接调:
/remove-ai-marks
或者直接跟模型说:strip AI watermarks / C2PA / Claude marks / SynthID-class text。 个人安装不用重启,/skills 能看到就说明加载了。
Skill 是"指令":模型决定要不要调它。 钩子是确定性的:只要 Agent 写了文件,钩子一定跑,不用模型配合。 插件会注册一个 PostToolUse 钩子,监听 Write、Edit、MultiEdit、NotebookEdit。 两种模式:
-
check(默认):只报告发现了什么,不动文件,交给模型决定清不清。
-
clean:直接在原地清掉,清完告诉模型文件变了。 设模式:插件设置里改 Hook mode,或者环境变量 WATERMARKS_HOOK_MODE=clean。 不用插件也可以自己写进设置文件(~/.claude/settings.json 或项目 .claude/settings.json),命令是 hook_written_file.py --mode check。
钩子有个硬限制,仓库自己写得很清楚: 钩子改不了聊天框里的文字。 Claude Code 没有"发送前过滤"这个钩子点,Stop 钩子收到的最后一条消息是只读的。 所以确定性保证只覆盖 Agent 写到文件里的内容。 只存在于聊天记录里的文字,靠 skill 流程,尽力而为。
进 git 之前还有一道闸:pre-commit 钩子。 在 .pre-commit-config.yaml 里加:
repos:
- repo: https://github.com/guillaumemeyer/watermarks-remover
rev: v0.5.0 # pin 到一个 tag/commit
hooks:
- id: watermarks-remover-check # 发现标记就让提交失败
- id: watermarks-remover-clean # 可选:原地清掉暂存文件
check 模式:发现标记就让提交失败,列出发现。 clean 模式是可选的:原地清掉暂存文件,退出码 1,让你看 diff 再重新暂存。 手动跑:python3 service/scripts/check_staged.py <files...> / clean_staged.py <files...>。
五、HTTP 服务:给网站和脚本接
同一个能力也跑成 HTTP 服务,skill 调的就是它,网站和脚本也能接。 先看服务活没活:
curl -s http://127.0.0.1:8765/health
返回 {"ok": true, "version": "..."} 就是活的。 /openapi.json 是机器可读的 OpenAPI 3.0.3 契约。
接口表:
-
GET /health:健康检查
-
GET /capabilities:可用的工具和后端(每个都实际探测过版本,不是只看 PATH)
-
GET /openapi.json:接口文档
-
POST /inspect:检查,{"file": "<base64>", "name": "notes.md"}
-
POST /detect:跑检测器(文本接厂商检测器 + 文体分析,图片接 SynthID 像素评分)
-
POST /clean:清理,{"file": "<base64>", "name": "notes.md", "options": {...}}
-
POST /watermark:生成带水印文本(做评测和往返测试用)
-
POST /inspect/batch、/detect/batch、/clean/batch、/watermark/batch:批量,每请求默认最多 50 个文件(WATERMARKS_MAX_BATCH_FILES) 一条坏数据只影响它自己那一项,不会中断整批。
curl 清理一个文件:
WM="http://127.0.0.1:8765" curl -s -X POST "$WM/clean" -H 'Content-Type: application/json' \ -d "{\"file\": \"$(base64 < notes.md | tr -d '\n')\", \"name\": \"notes.md\"}"
想加密码:设 WATERMARKS_SERVER_API_KEY,之后每个请求都要带 Authorization: Bearer <key>。 服务默认只绑本地回环地址,放到网上自己负责。
注意一个坑:/clean 清文本时,默认先跑 A 层,再跑 B 层改写,B 层是必选步骤。 如果没配好改写后端,会返回 400。 文本清理要配两样:transformers + roberta-large(默认 mlm 步骤),和 WATERMARKS_REWRITE_* 系列 LLM 配置(paraphrase 步骤)。 图片和容器类元数据清理不用配这些,开箱即用。
检测和清理是分开的:
-
/detect 单独跑检测器。
-
/inspect 加 "detect": true 会把检测结果附在报告里。
-
/clean 加 "detect_before" / "detect_after",可以量化清理前后检测分数变了多少。 检测器是 fail-soft 的:没配好、超时、出错,只报 {"available": false, ...},不阻塞清理。
六、坑先说:六件事
一、统计层 B 是尽力而为,不是魔法橡皮擦。 水印信号藏在词语选择里,几乎每句话都带一点。 轻微改改段落、换换标题,信号基本不动。 真要去掉,得逐句大面积改写。 改写会磨掉原文的语气、文风和精确度。 仓库原话:如果反正要用便宜模型重写一遍,为什么一开始不用便宜模型直接生成? B 层适合的场景是:你想要顶级模型的思考和起草,又接受一遍改写来满足隐私要求。 质量优先时,走无损路线:A 层 Unicode 清理 + 文件元数据清理,原文不动。
二、改写别用原模型。 用非原产模型改写。 拿 Claude 改写 Claude 的文字,可能重新盖上水印。
三、钩子改不了聊天框。 见第四节:确定性只覆盖写到文件里的内容。
四、HTTP 清文本前先配好 B 层后端,不然返回 400。 见第五节。
五、PDF 要真清干净,得装 qpdf,最好再加 Ghostscript。 exiftool 改 PDF 是增量写入:原元数据字节还留在文件里,只是看不见了,文件还会变大。 qpdf --linearize 会重新序列化文档,丢掉没被引用的对象,这才是真清理。 没装 qpdf 也能跑,但会提示你。 PDF 里嵌的图片更麻烦:文档层的清理够不着图片内部。 一个 Photoshop 导出的 PDF,清完文档层还能剩 27 个标签。 这时候要 Ghostscript 的 deep_images 再过一遍(auto/always/lossless/never 四档,默认 auto)。
六、没有任何工具能给你"官方检测一定查不出来"的保证。 厂商的检测器和密钥不公开。 这个工具只分两类报告:可验证的清除(Unicode 数量、元数据动作),和尽力而为的 B 层改写。 想自己验:c2patool、contentcredentials.org/verify 查 C2PA;厂商自己的检查页:claude.com/check-content、openai.com/research/verify/、Google SynthID。
最后一条红线,仓库 Ethics 页写明的: 只用在你自己拥有或被授权处理的内容上。 不是用来学术造假,也不是用来假装"人类手写"的。 开发者对滥用不担责。
七、检查效果:怎么验证去干净了
清完别直接信,验一下。 一、再跑一次 inspect,对比清理前后的报告。 二、/clean 时加 detect_before / detect_after,看检测分数变了多少。 三、去厂商的检查页验:Claude 的 claude.com/check-content(读图片、视频、音频里的 C2PA),OpenAI 的 openai.com/research/verify/,Google SynthID。 四、想量化:仓库生态里有个 unmark-checker,能自己种一个 SynthID-Text 类水印,再测清理后检测分数和语义保留。 五、图片:c2patool 看 C2PA 清单还在不在。
懒人路径也有:
-
不想装任何东西:Simple Unmark(simpleunmark.com),网页版,只清文字,不保留提交内容,还有 TEE 保密模式。
-
想要桌面软件:MetaClean(Rust/Tauri,Windows/macOS/Linux,拖放清元数据)。
-
只在浏览器里弄:unmark-web,纯前端清隐形 Unicode 和图片元数据。
-
苹果用户:DropMarks(macOS SwiftUI,调这个仓库的脚本)。 这几个都是独立项目,README 里只列出来,不背书,用之前自己看它们的说明。
仓库:https://github.com/guillaumemeyer/watermarks-remover 发稿时 26,621 星,MIT 开源,免费。
最后
推荐几款常用的工具(需要的自取)
1、合规美股券商 BIT(身份证就可以注册):注册链接
邀请码:YC9EGM
合规美股券商 BIT:USDT 直接入金,大陆用户 0 门槛开户保姆级教程
吊打全网所有VPN,性能远超顶峰期的快连,价格只有快连的1/3,VPN配置教程在这篇推文里
如果您觉得有收获,请给我点赞、转发。
谢谢!


