保姆级教程:手把手教你给自己和爸妈搭一套AI健康系统(提示词&命令行全开源!)
文章目录
你自己或者爸妈去年在三甲医院拍给 AI 看的体检报告或者病历,今年换家体检中心再发给它,它照样聊得头头是道,可仔细一对就会发现,两年的指标根本没接上。模型半年换一代,手机和手表也会换,今年没按同一套标准存下来的化验单,五年后模型再强也拼不回断掉的年份。
Theta Health(Mirobody 背后团队)在公开评测 ESL-Bench(arXiv 2604.02834)里拿 100 个合成人 1 到 5 年的病历测过 13 种方法,先把数据放进标准库再让 AI 查询准确率 48% 到 58%,直接塞给常规记忆型 RAG 只有 30% 到 38%。他们开源的这套健康引擎 Mirobody(截至 2026 年 11 月 19 日在 GitHub digital-health 话题排第一,1,585 星,Apache-2.0 协议),就是把那层数据底座直接搬进你自己的电脑里。
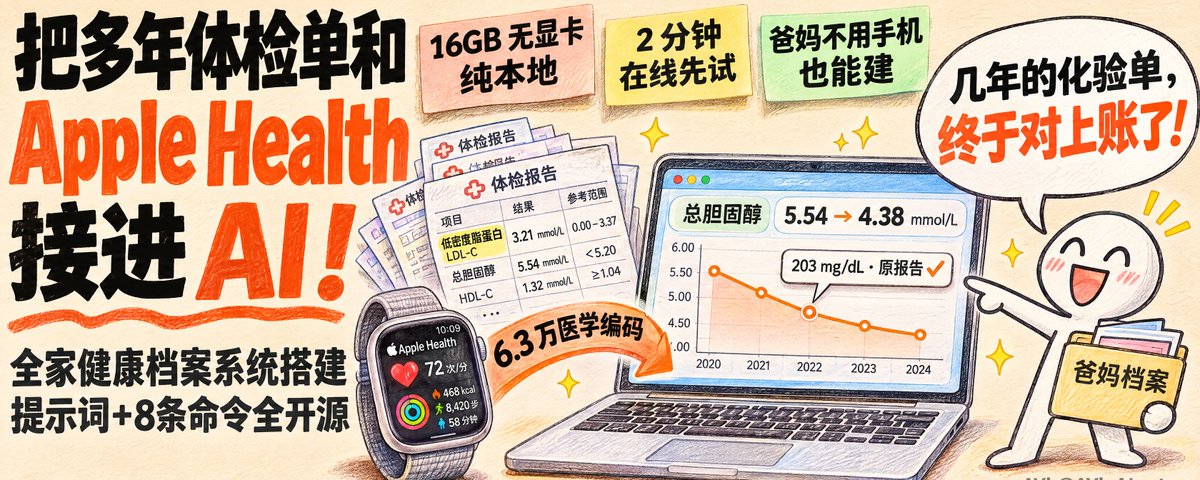
这篇把从 0 上手到接进日常 AI 工具的整套做法一次性写透,主要帮你解决三件事: 1、怎么把中文、英文体检单、手机照片、Apple Health 和基因文件自动并成同一条趋势线,回答里每个数字点开都能跳回原报告核对; 2、怎么不用写代码用 2 分钟在线直接试效果,或者在 16GB 无显卡电脑上跑起纯本地版不传云端,顺带用关爱圈管好父母的长期档案; 3、怎么用 8 条直接复制的命令把标准化引擎或档案接进 Claude Code、Cursor、Codex,以及动手前必须看清的隐私和能力边界。 命令和避坑细节比较全,建议先存下来,轮到体检或者带爸妈复查前对照着走一遍。
说明:本文基于 Mirobody 团队达人体验邀约与仓库 1.6.2 版本公开文档整理,所有演示画面和读数均采用官方虚拟样本,不涉及任何真实个人健康信息。
这篇我们聊:
▸ 一、先看做出来能干嘛 · 5 年中英文报告并成 1 条线,数字点开跳回原件 ▸ 二、零代码 2 分钟先试 · 3 步在网页端跑通全流程 ▸ 三、为什么直接发给 AI 会出错 · 1.6.0 自己都踩过的坑与 6.3 万编码底座 ▸ 四、把档案留在自己电脑 · 4 种方案对照表与 16GB 纯本地部署 ▸ 五、极客进阶玩法 · 8 条命令接进 Claude Code / Cursor(实测 0.4 秒响应) ▸ 六、说点实在的 · 隐私账、边界和目前做不到的 4 件事
一、先看做出来能干嘛 · 5 年中英文报告并成 1 条线,数字点开跳回原件
先不扯技术架构,直接看把多份杂乱报告扔进去之后,它能替你干成哪三件最省心的事。
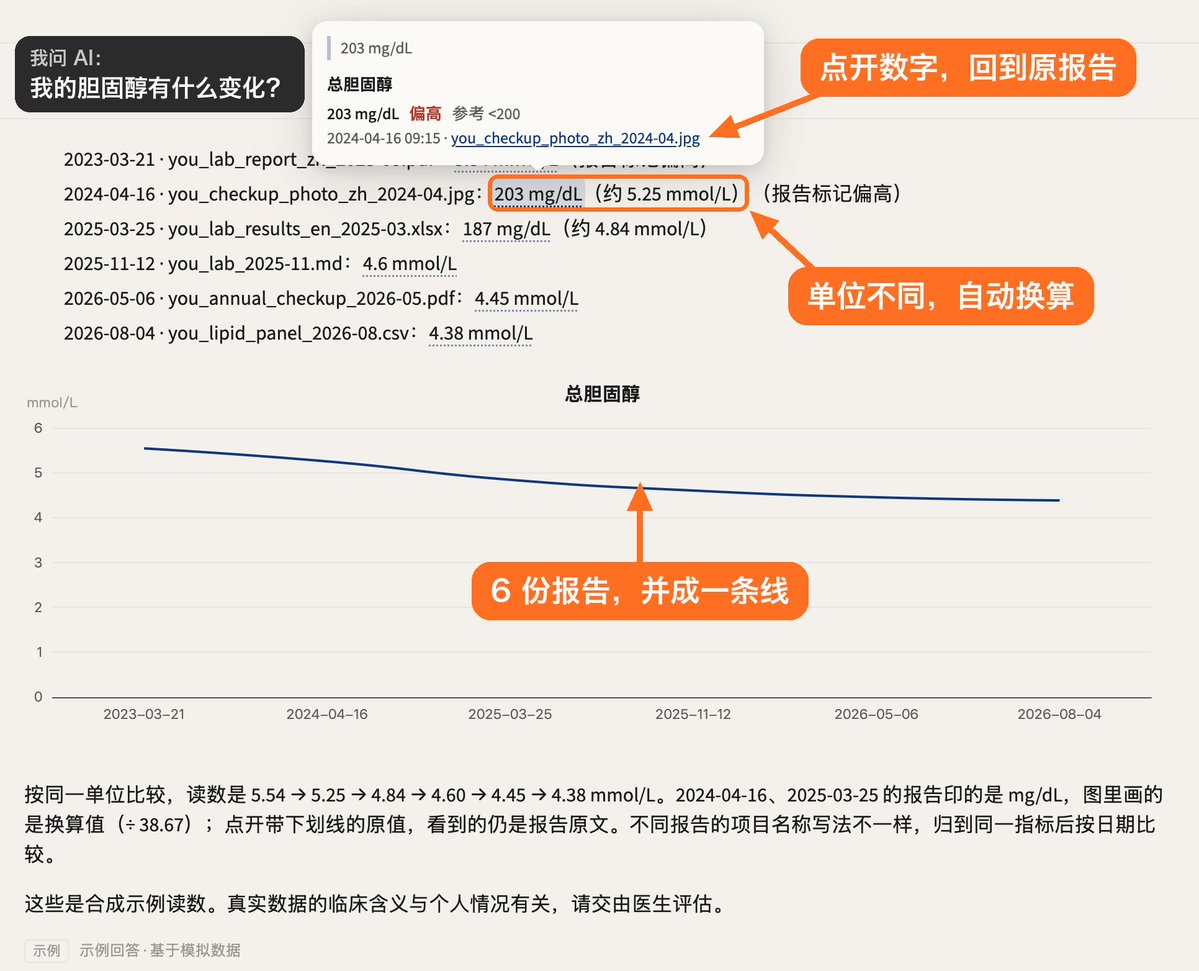
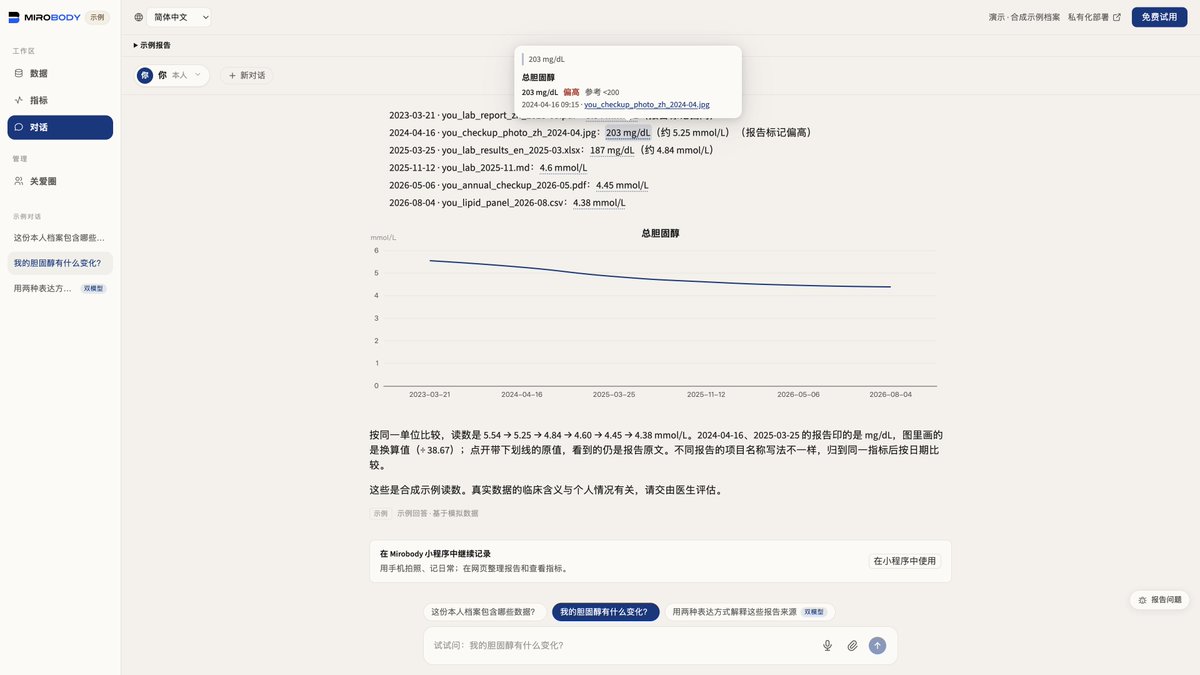
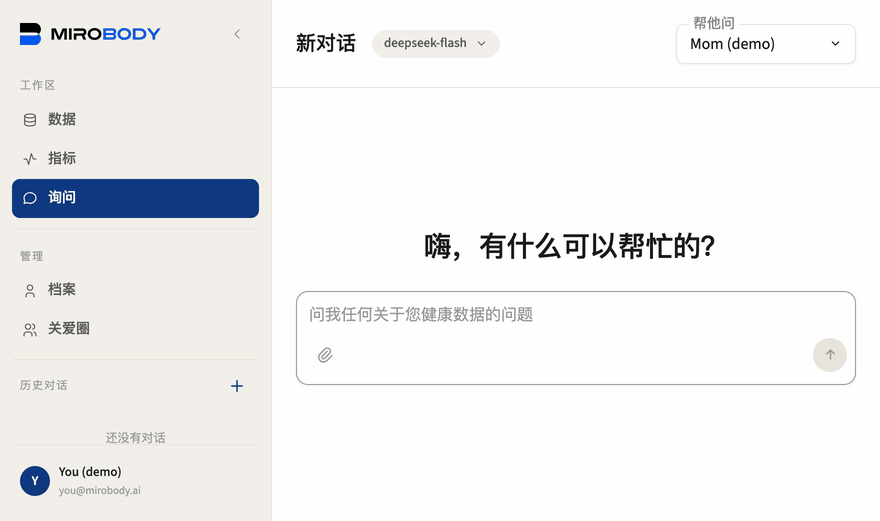
第一件事,把跨年份、跨语言的化验单自动并成一条趋势线,而且每个数都能点回原件。 仓库 demo/upload/ 里自带几份刻意做成不同长相的虚拟化验单:2023 年中文医院 PDF 写着 LDL-C(mmol/L),2024 年中文体检照片写着低密度脂蛋白胆固醇(mg/dL),2025 年英文诊所表格写着 LDL Cholesterol(mg/dL)。我在官方中文演示页把这几份连同 2026 年的报告一起导入后,去问我的胆固醇有什么变化,系统直接把 2023 到 2026 年一共 6 份文件(包含 pdf、jpg、xlsx、md、csv)换算成同一把尺子,拉出一条连续折线 5.54 → 5.25 → 4.84 → 4.60 → 4.45 → 4.38 mmol/L。
最踏实的是,回答里每一个数字下面都带一条虚线,鼠标点开 203 mg/dL 直接弹出当年那张体检照片的参考范围和原文件链接,AI 到底有没有看串行,自己瞄一眼就能核对,不用再盲信大模型总结。
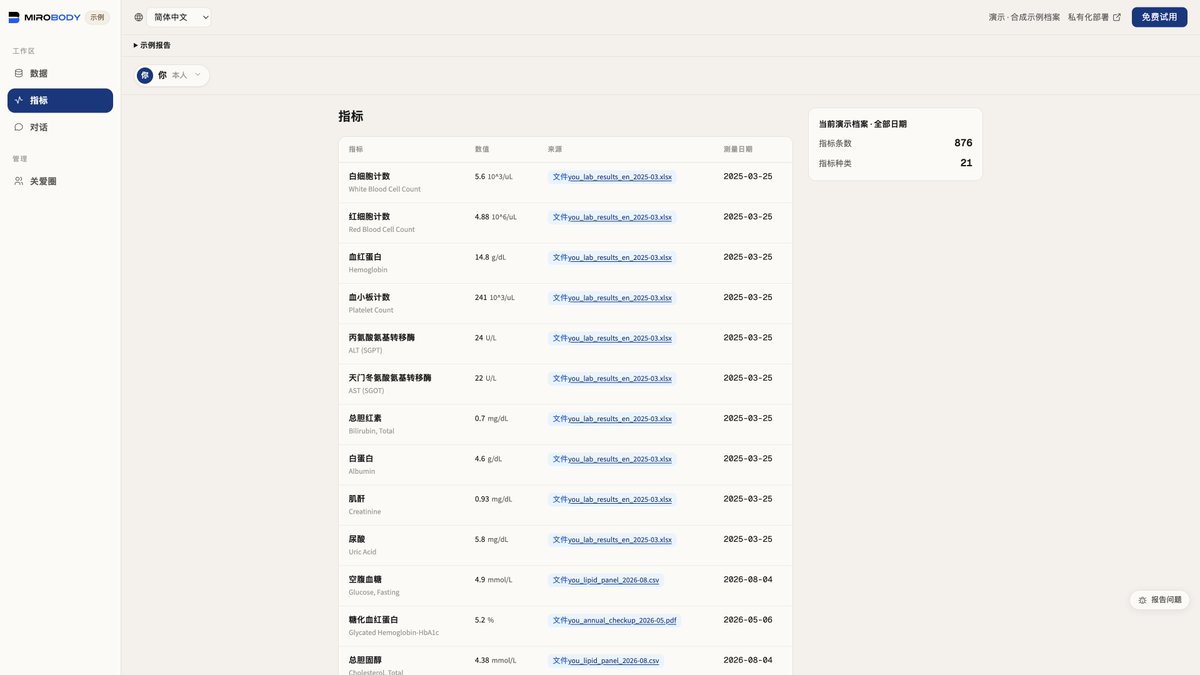
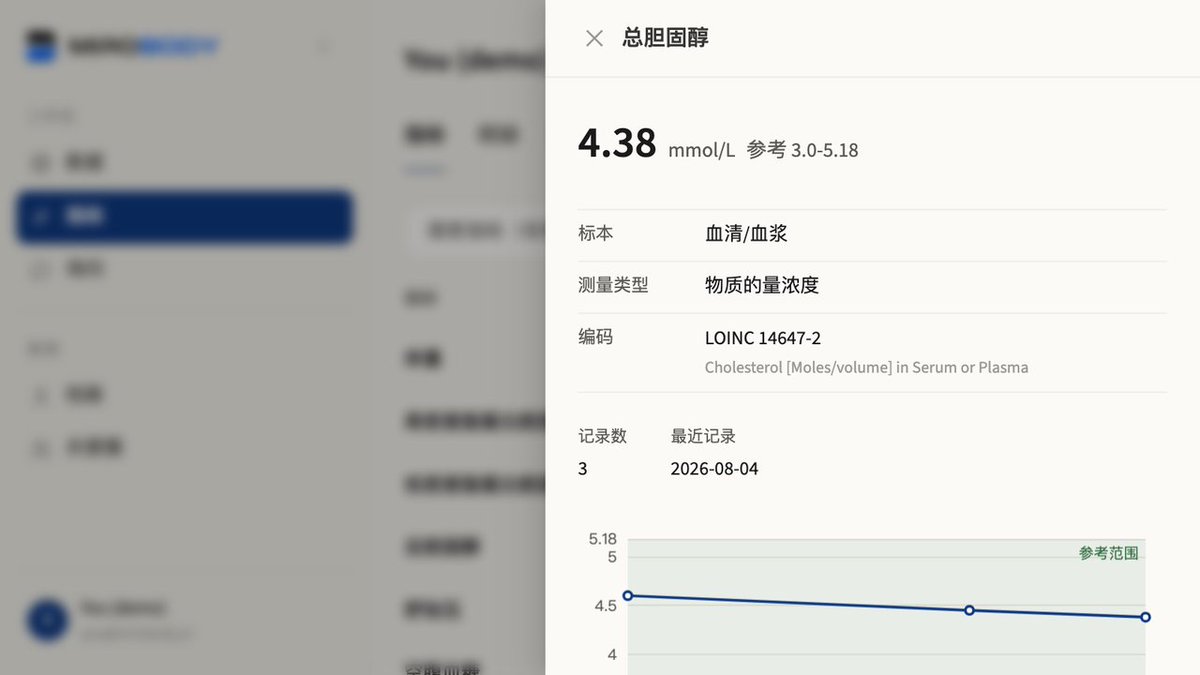
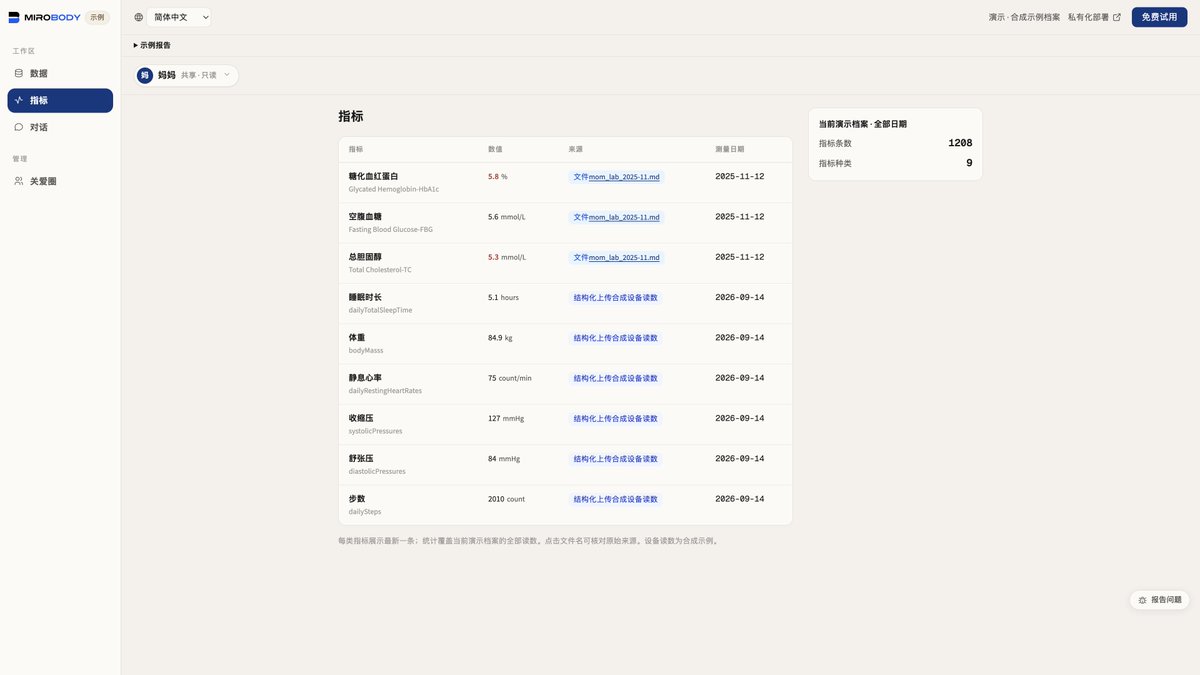
切到左侧的指标页还能看到,刚才那几份五花八门的报告已经被拆解归并成 876 条读数(共 21 类指标),中英文名称、最新数值和对应源文件摆在一张表里,点文件名就能追溯来源。
第二件事,用关爱圈管好父母的长期档案,换医院复查不再现场翻抽屉。
很多人家里老人的纸质体检单都塞在抽屉角落,等真要换家医院看病、医生问前两年血糖血脂怎么变的,往往翻不齐。Mirobody 里的关爱圈把权限卡得很死,数据库字段默认把健康数据共享开关锁成 0,邀请家人进圈子不会暴露任何记录,必须本人手动点同意才能看。
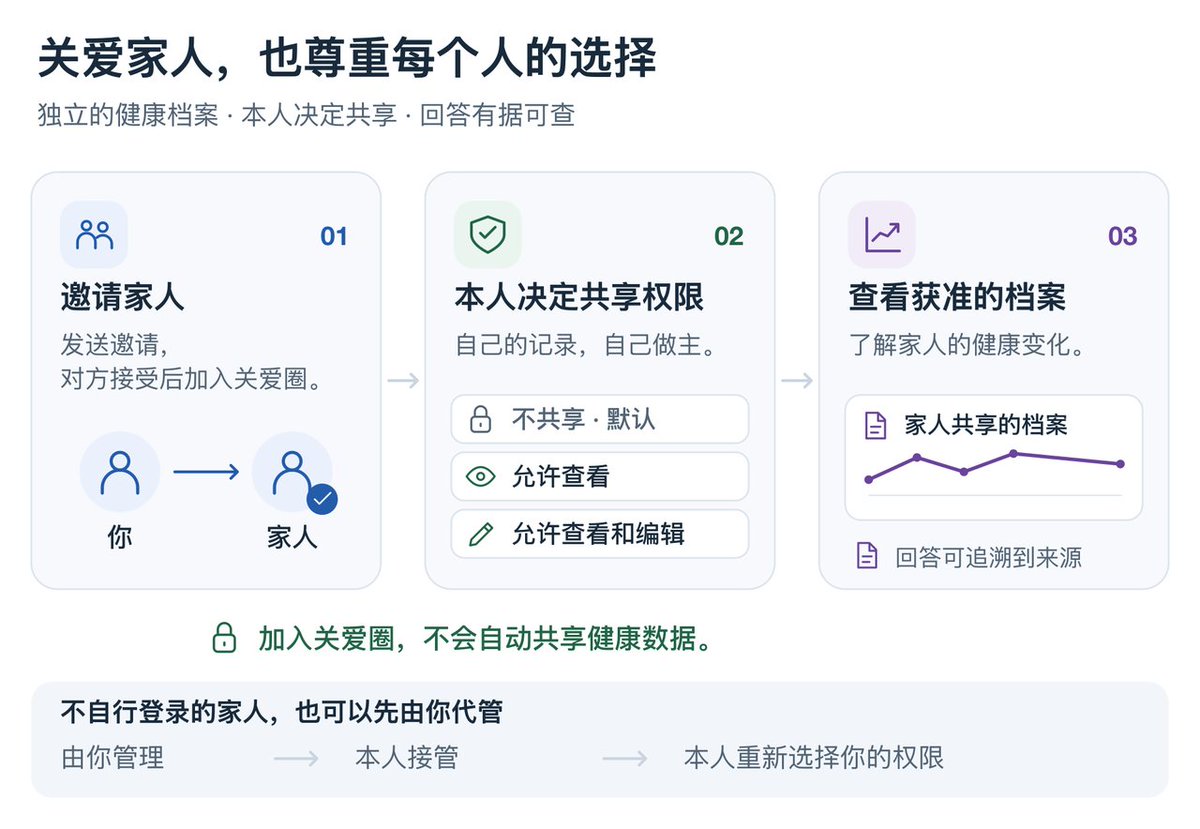
演示账号里 mom@mirobody.ai 展现的就是第一种用法:妈妈自己有账号,主动把记录以只读权限共享给 you@mirobody.ai,切换视角就能看到妈妈档案里的 1,208 条读数,而且超标的糖化血红蛋白(5.8%)和总胆固醇(5.3 mmol/L)会标红提示;而如果家里长辈压根不用手机,你也可以在关爱圈里先替他们建一份占位档案代管,等哪天爸妈想自己接管,发邀请链接验证邮箱就能完整交还给本人。
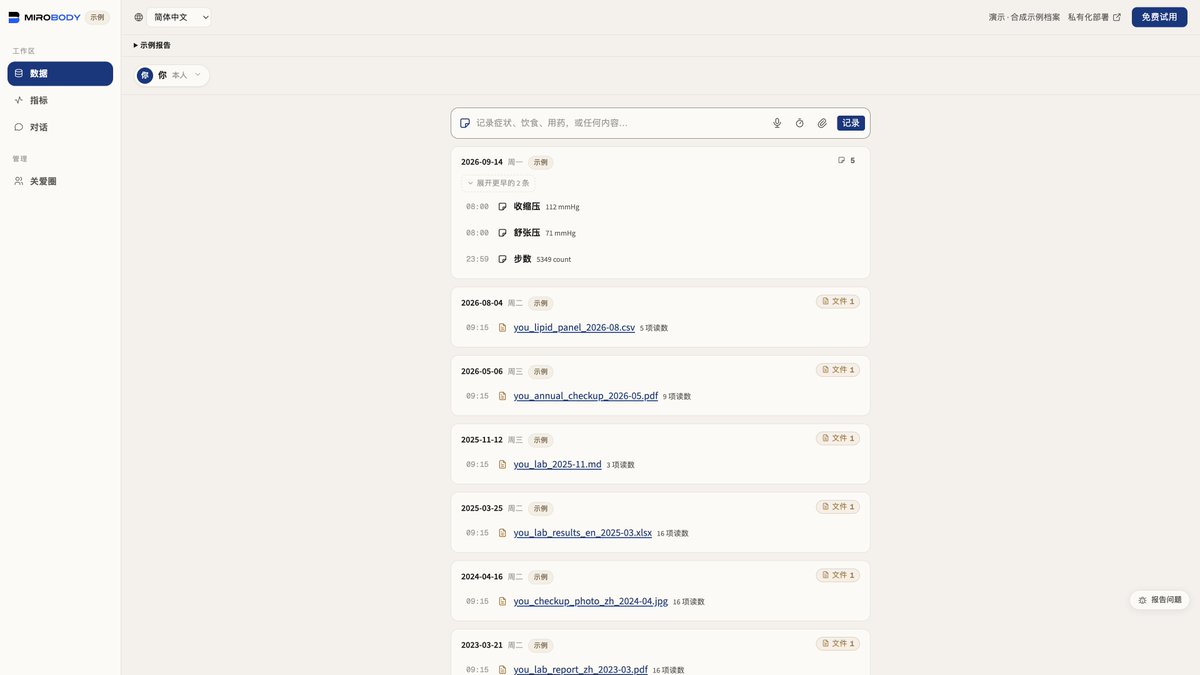
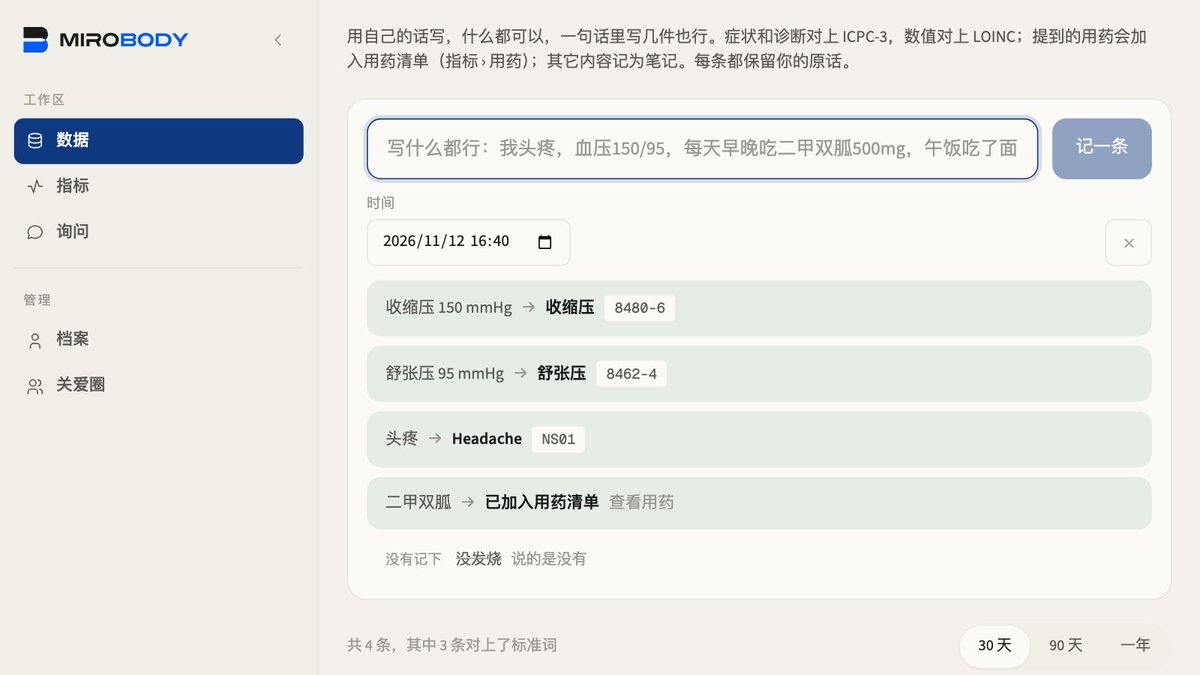
第三件事,像发微信一样一句话记健康日记,它自己会挑重点、躲否定词。 平时临时不舒服或吃药不用专门建表格,在数据页顶部输入框写一句 昨晚开始头疼,血压150/95,没发烧,每天早晚吃二甲双胍500mg,模型负责拆句子,词表负责上编码,结果出来是一条编码为 NS01 的头疼症状、两条收缩压和舒张压读数、一条二甲双胍用药记录,而且系统会准确跳过没发烧三个字,不会把否定词错误记成发烧。
二、零代码 2 分钟先试 · 3 步在网页端跑通全流程
想先亲手点一点上面这些画面,不用装任何环境,打开官方中文演示页 https://chat.mirobody.cn/demo 两分钟就能走完。页面里预置了 2,019 条全虚拟数据(包含你和妈妈两个虚拟账号,没有任何真人隐私),按这三步操作就行:
1、刚进页面先展开顶部的 示例报告,把下面的几份 2023 到 2026 年虚拟报告依次点 演示导入;如果不做这一步直接去点预设问题,系统只会诚实回答只有一次化验、看不出变化,不会凭空编趋势给你。 2、点预设问题我的胆固醇有什么变化,就能看到多份报告跨单位换算成一条折线;回答上方思考过程可以点击展开看查询步骤,带虚线数字点一下就能弹出原件窗。 3、点左下角切换成妈妈共享的只读档案,再对比看一次数据页和指标页的隔离效果。
如果你不想自己折腾服务器部署、想直接拿它存自己日常的真实记录,中国大陆可以在微信直接搜索 Mirobody 小程序,海外可以使用 Theta 网页或移动 App。
三、为什么直接发给 AI 会出错 · 1.6.0 自己都踩过的坑与 6.3 万编码底座
看到这你可能会问,我平时直接把两张体检单截图发给 ChatGPT 或 Claude,不也能分析吗,为什么非要多加一层工具。
问题恰恰出在医院报告的写法太乱、单位还不统一,聊天大模型擅长读单页文字,但极容易在三件事上暗暗翻车。
第一是同名不同写,公立医院写 LDL-C,体检中心写低密度脂蛋白胆固醇,英文单写 LDL Cholesterol,普通对话框看到三段不同的字,很容易当成互不相干的几项各聊各的。
第二是单位混着算,国内常用 mmol/L,海外常用 mg/dL。这就像做菜时把一把米、两斤面粉和三盎司黄油不换算直接下锅,表面看都在往里放料,真算配比全乱了套——连 Mirobody 自己 1.6.0 都踩过这个坑(仓库 #271):图表把 212 mg/dL 和 4.90 mmol/L 画在一条线上,看着像从 212 暴跌到 4.9,换算后其实是 5.48 降到 4.90,1.6.1 之后才修好。
第三是没法回头核对,大模型给你甩出一段总结,你想确认去年那个数是不是它把参考范围看成了实测值,只能自己再去翻十几个 PDF 文件一个个对。
所以 Mirobody 干脆把整套链路拆成三步,而且最核心的名称对齐和单位换算全程在本机离线查词表完成,不让大模型瞎猜:
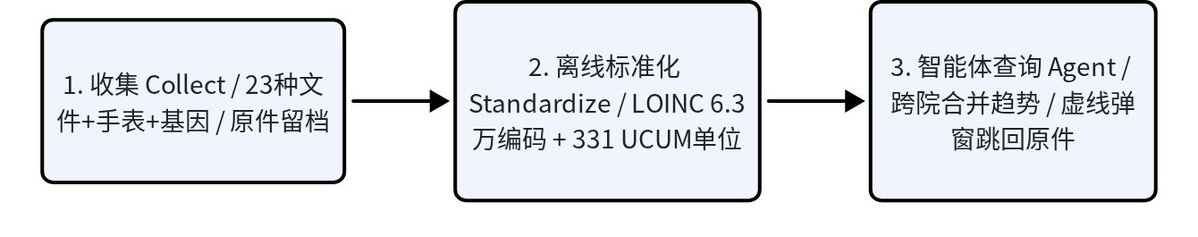
它内置了北美通用的医学检验标准 LOINC 2.83(按规则切出 63,416 个编码,对应 1,023,273 条多语言名称,含 21 种语言和大量中文别名)以及 331 个 UCUM 单位换算规则。就像给每项指标发了一张全球统一身份证,血红蛋白、日文ヘモグロビン、英文 Hemoglobin 放进去全都落到 718-7;遇到血脂这种一类检查统称,系统会老实标成未解析,绝不硬凑。官方公开测试集里,中、英、日、俄、爱沙尼亚、土耳其 6 种语言共 347 项常规体检项目,识别得分是 347/347。
四、把档案留在自己电脑 · 4 种方案对照表与 16GB 纯本地部署
如果你打算正式给自己和家人建档,先看清下面这四种运行方式的成本和数据去向差别再动手:
| 你想要什么 | 从哪开始 | 需要准备什么 | 预计耗时 | 数据去向 |
|---|---|---|---|---|
| 0 门槛看懂效果 | 官方网页演示 | 浏览器 | 2 分钟 | 只看预设虚拟数据 |
| 浏览器里自己传测试报告 | GitHub Codespaces | GitHub 账号 + 1 把模型 Key | 5 分钟 | 在 GitHub 云端跑,提问发给模型商 |
| 数据留自己电脑 + 快速问答 | 本地 Docker + 云端模型 Key | Docker Compose + Git + 模型 Key | 10 分钟内 | 数据库留本机,文档抽取与问答发给模型商 |
| 100% 离线,什么都不传出去 | 本地 Docker + 内置小模型 | Docker + 16GB 内存(无显卡可跑) | 首次需等下载,CPU 问答数分钟 | 全程留在自己电脑,不经过外部模型 |
多数人想先看效果,走第 1 条网页演示就够了;真要给自己和家人长期建档,第 3 条本地存数据加一把便宜的模型 Key 日常体验最顺;只有完全不想碰云端 API 的人,才值得走第 4 条纯本地路线。
路线 A · 免装电脑环境的 GitHub Codespaces 试跑
打开仓库 https://github.com/thetahealth/mirobody,点 README 里的 Open in GitHub Codespaces 按钮。等终端自动启动完网页、Postgres 数据库和虚拟数据后,点开终端输出的设置链接,填入自己的模型 API Key(OpenRouter、OpenAI、Gemini、Anthropic、DeepSeek、阿里百炼 DashScope 或任意 OpenAI 兼容网关都支持)。在邮箱验证码标签用测试号 you@mirobody.ai、验证码 111111 登录,就能把仓库 demo/upload/ 里的测试报告传进去实操。用完记得在 GitHub 关掉 Codespace,避免白耗免费额度。
路线 B · 自己电脑 Docker 部署(云端 Key 版 vs 100% 纯本地版)
Windows 用户在 WSL 2 终端里操作,Mac 和 Linux 直接开终端,提前装好 Git 和带 Compose 的 Docker Desktop。
想用云端模型(响应最快,几秒出图),把这两行命令复制跑起来:
git clone --depth 1 https://github.com/thetahealth/mirobody.git && cd mirobody
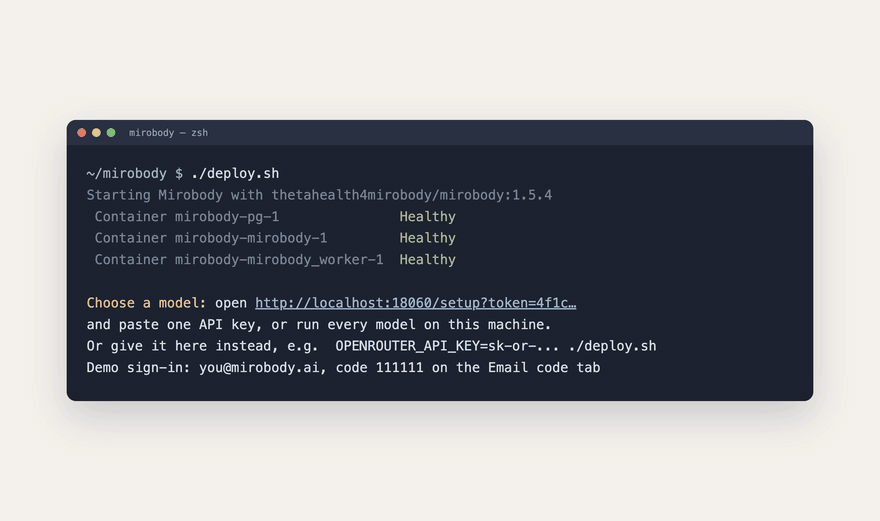
./deploy.sh
想走 100% 纯本地(不用 API Key,16GB 内存无独立显卡也能跑),把第二行换成这句:
COMPOSE_PROFILES=local-cpu ./deploy.sh
跑 local-cpu 时它会自动拉起 llama.cpp,默认用面壁智能的 MiniCPM5-2B 回答问题,智谱的 GLM-OCR 识别图片报告,回答模型约 4.1 GB,另加一个 0.9B 的 GLM-OCR。脚本跑完打开终端打印的 http://localhost:18060,同样用 you@mirobody.ai 和验证码 111111 登录开测。
动手前有四个官方提示的坑先记住:
-
内存得留够:纯本地模式建议主机至少 16GB 内存,并在 Docker Desktop 里划出至少 8GB 给 Docker
-
国内下载镜像慢:.env 里支持配 DOCKER_MIRROR 和 HF_ENDPOINT 走镜像站
-
纯 CPU 要有耐心:没有显卡用 CPU 跑时,首次问答和读图要等几分钟,不是卡死了;Apple 芯片 Mac 建议参照仓库 docs/local-models.zh-CN.md 在宿主机用 brew install llama.cpp 跑,才能调用 Mac 的 GPU 加速
-
存真人数据前必改开关:默认开启了 SEED_DEMO_DATA=true,自带验证码 111111 的公开测试号,正式存自己和家人真实报告前,务必先在 .env 把 SEED_DEMO_DATA 改成 false,再按 SECURITY.md 配好持久化密钥
五、极客进阶玩法 · 8 条命令接进 Claude Code / Cursor(实测 0.4 秒响应)
如果你本来就天天开着 Claude Code、Cursor 或 Codex 写代码,不用非得搭完整个网页后台,直接把这套标准引擎或建好的个人档案接进日常 Agent 就很实用,整套 Agent 的系统提示词也直接开源在仓库 mirobody/agent/prompts/ 里。
玩法 1 · 0 部署直接用离线词表(不要 Key)
电脑装好 uv 后,复制第一条命令就能在本地测试跨语言指标统一,第一遍下完依赖以后断网也能跑:
uvx --python 3.12 mirobody resolve "LDL cholesterol" 血红蛋白 ヘモグロビン "空腹血糖(GLU)" 血脂
我在 Mac 上实测跑了一遍,首次联网拉取约 26.6 MB 安装包共耗时 63.90 秒,之后二次运行走本地离线词表只用了 0.415 秒,输出结果直接看下面这一段——中文血红蛋白和日文ヘモグロビン准确落到同一个 LOINC 718-7,最后一项血脂因为是一个大类统称,老实保持未解析、绝不硬猜:
  LDL cholesterol       LOINC 13457-7     Cholesterol in LDL [Mass/volume] in Serum or Plasma by calculation   [47 candidates]
  血红蛋白              LOINC 718-7       Hemoglobin [Mass/volume] in Blood   [65 candidates]
  ヘモグロビン          LOINC 718-7       Hemoglobin [Mass/volume] in Blood   [65 candidates]
  空腹血糖(GLU)         LOINC 1558-6      Fasting glucose [Mass/volume] in Serum or Plasma
  血脂                  unresolved: a category or several tests in one name, and no code is given rather than a guessed one
想把这个离线词表直接挂给 Claude Code 当本地 MCP 工具,运行这一条(Windows 默认 PowerShell 要把 claude 改成 claude.cmd,不然参数会被吞掉):
claude mcp add mirobody -- uvx --python 3.12 mirobody mcp
想让编程助手学会整套标准化工作流,可以一条命令装成 Skill(支持 Claude Code、Cursor、Codex 等客户端):
npx skills add thetahealth/mirobody --skill standardize-health-data
要在本地 Python 脚本里调用,或者批量导入 Apple Health 导出包,用这两条:
pip install mirobody
mirobody import apple ~/Downloads/export.zip
玩法 2 · 把建好的健康档案接给你的 Agent(读真实记录)
先跑起前面路线 B 的本地 Docker 服务端,再打开网页端设置里的 MCP 链接页,生成一条属于你自己的个人 URL(默认有效期 10 天),按手头工具复制对应配置就行。
给 Cursor 配 ~/.cursor/mcp.json:
{
  "mcpServers": {
    "mirobody": {
      "url": "http://localhost:18060/mcp/<你的个人secret>"
    }
  }
}
给 Claude Code、Codex 或 Gemini CLI 一行命令行接入:
claude mcp add --transport http mirobody http://localhost:18060/mcp/<你的个人secret>
codex mcp add mirobody --url http://localhost:18060/mcp/<你的个人secret>
gemini mcp add --transport http mirobody http://localhost:18060/mcp/<你的个人secret>
接进 Agent 前有两条红线必须看清。第一条,个人 MCP 链接里自带访问凭证,等于你的健康档案密码,绝对不要外传,录屏或发教程截图时一定把 URL 后半段打码,不小心露出来立刻回设置页撤销重建。第二条,就算 Mirobody 跑在 100% 本地,只要你连上 Claude Code、Cursor、Codex、Gemini CLI 这类云端客户端,被查询到的健康读数还是会发给对应模型公司,想彻底不出本机,客户端那头也得配本地模型。
六、说点实在的 · 隐私账、边界和目前做不到的 4 件事
工具好不好看亮点,敢不敢长期拿来存全家人的体检单,看的是它把短板交代得够不够老实。下面四条边界,动手前先心里有数:
-
只做数据整理和溯源,不做医疗诊断:Mirobody 明确不开处方也不给调药建议,基因数据里问到用药时也只列 CPIC 指南覆盖范围,指标正常与否一律以化验单参考范围和医生当面判断为准
-
遇到认不出的写法会留空,不硬猜:词表虽有 102 万多个名称,各地医院的冷门缩写依然会有漏网之鱼,认不出的条目或像血脂这类统称会直接标成待确认或不编码;遇到漏词可以手动点一次确认编码,或去 GitHub 给 resolver_overrides.tsv 提个 PR 补上
-
本地加密还没有覆盖全部数据表:官方在文档里坦白写明,静态加密目前覆盖了聊天记录、上传文件、用药文本和个人资料,读数表和基因型表暂未做静态加密,手环里的压力分数、Body Battery 这类厂商自定义算法分也不会编码入库;自己电脑上只监听本地端口没问题,千万别没看 SECURITY.md 就把端口暴露到公网上
-
纯 CPU 本地模型速度偏慢:用 local-cpu 省了 API 费也保了纯本地,但没有显卡时读糊图和回答等几分钟是常态,规整的 PDF 和 Excel 表格会优先走规则抽取秒出,手机拍的照片才需要等 OCR 模型慢慢认
说到底,今天花几分钟把散落在不同医院、不同语言里的化验单按同一套标准收进一张表,以后不管是自己复查、陪爸妈看病,还是换用下一代更强的 AI 助手,那些跨了十年的身体记录才真正调得出来、核对得上。
想试也不用上来就折腾命令行,先花两分钟打开官方中文演示页 https://chat.mirobody.cn/demo 导入示例报告点一次虚线溯源,觉得顺手再去 GitHub 仓库 https://github.com/thetahealth/mirobody 点个 Star 拉代码跑一遍;遇到哪家医院的缩写认不出来直接提个 issue,也欢迎在评论区聊聊你第一步打算先把自己的历年体检单收进来,还是先帮家里老人建一套。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。