
兄弟们,我爆肝两天,终于把我的 Claude 规则系统升级完成,直接喂你嘴里
文章目录
这篇写给在用 Claude Code、Codex 干活的朋友,看完你能直接抄走三样:一段贴进 CLAUDE.md 的规则,一个让 AI 推代码前先过一遍的检查脚本,一个翻你自己 Claude Code 旧会话、看 AI 最常在哪犯错的扫描脚本。两个脚本都带离线自测,拿回去先跑一遍,就知道在你电脑上能不能用。
先交个底。10 月 30、31 号这两天,我把攒了几个月的规则从头体检了一遍。光是「写的路径和事实还对不对」这一项,子 Agent 就核了 480 处,47 处对不上。然后我又扫了 169 个旧会话里我自己打的 3,325 条消息,看它到底在哪些地方不照做。
最扎心的是这个:「先查完再汇报」这条规矩,9 月 23 号就写进了 Claude 的记忆。扫出来「没查实就说」还有 22 处,其中 20 处是 9 月 23 号以后出的。
规矩写进去,它不一定照做。下面是我这两天改的三样东西,最后附上能直接抄的全部内容。
一、规矩写了,它根本读不到
30 号先查的是规矩放在哪。
全局 CLAUDE.md 一共 3,064 个字符,其中 2,050 个是写长文的流程。每个会话都会加载它,查个 bug、改个配置,也照样背着这一大段。
另一头更麻烦。有 8 条规矩只写在一个文件夹的记忆里。Claude Code 的自动记忆按项目分开存:同一个 Git 仓库共用一份,不在仓库里的按文件夹分。我这几个文件夹各是各的项目,换个文件夹开会话,这 8 条就不存在了。
举个我自己的例子。我在记忆里定过「代写 X 帖默认出一条」,可写帖子的技能里还写着「默认三版」。在普通聊天那个文件夹,它听记忆的;换到别的文件夹,它只读得到技能,就会回到三版。
改法很笨:长文流程挪进技能,全局只留一段指向技能的指针(543 个字符),整份压到 1,557 个字符;那 8 条里该挪的,挪进了每个文件夹都读得到的技能和项目规则。
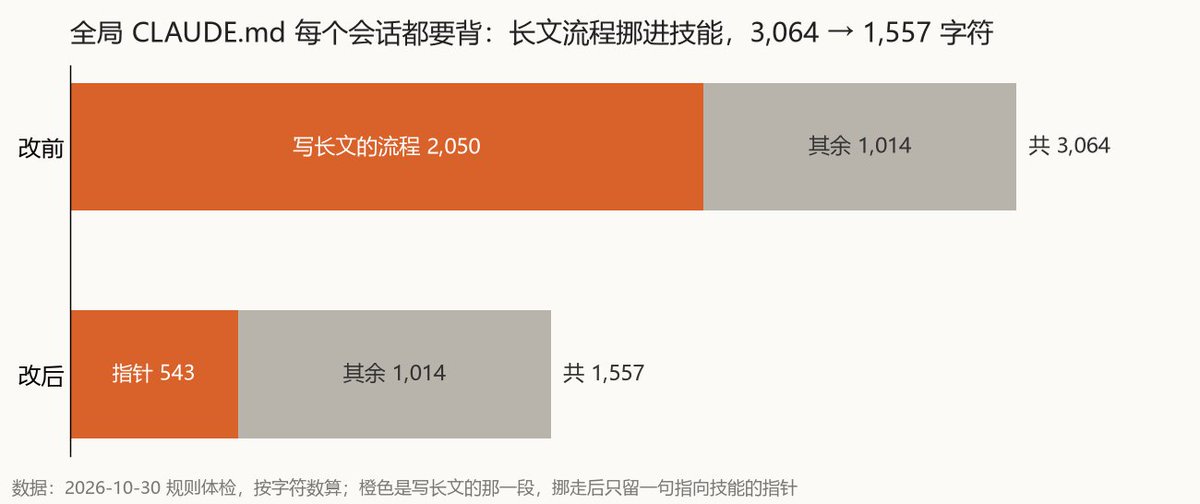
规矩写在哪,决定了它在哪个会话里存在。
二、读得到,它也照样不照做
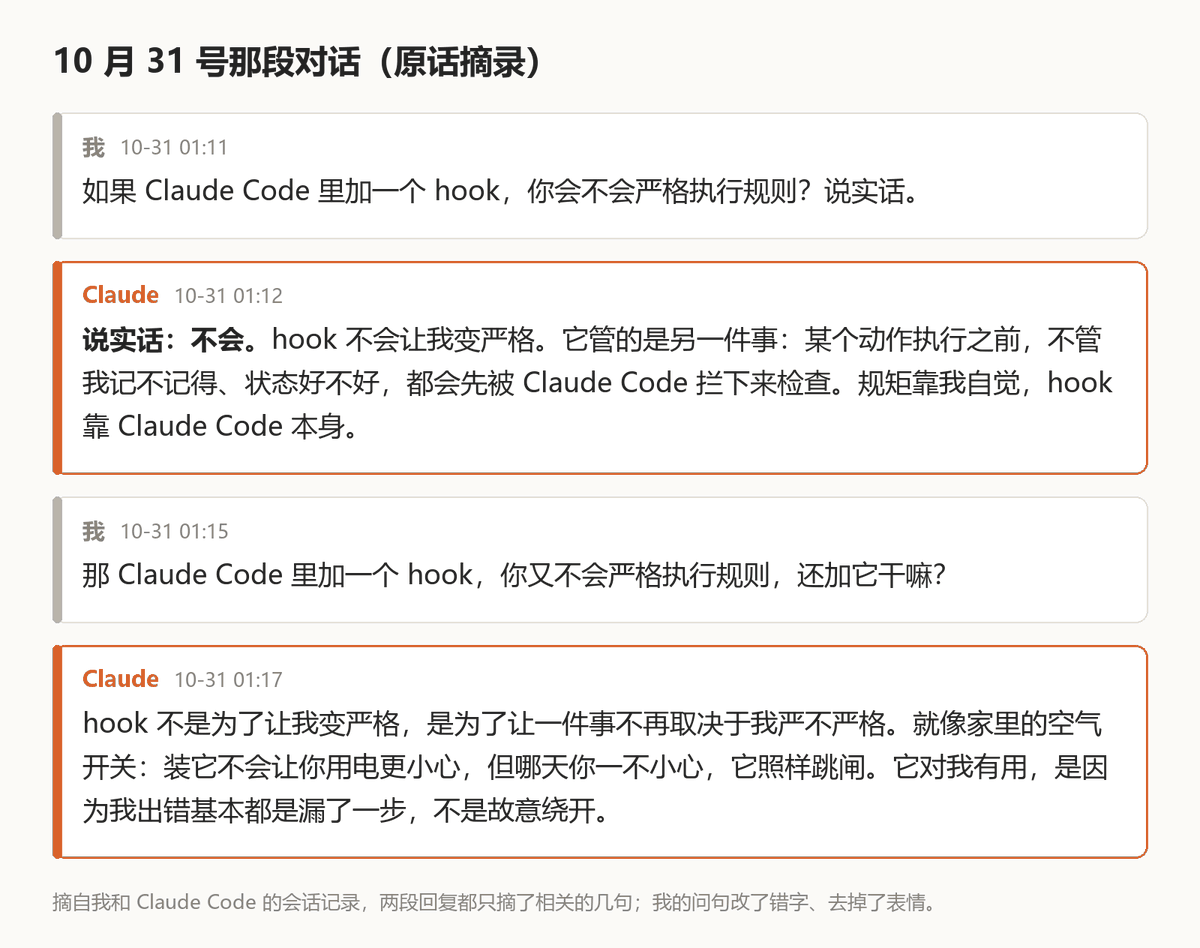
31 号我问了 Claude 一句:「如果 Claude Code 里加一个 hook,你会不会严格执行规则?说实话。」
它回:「说实话:不会。」
接着它打了个比方:hook 就像家里的空气开关,装它不会让你用电更小心,但哪天你一不小心,它照样跳闸。它还交代了自己的毛病:出错多半是漏了一步,很少是故意绕开。
我想看看它这话有多准,就去扫旧会话。脚本按「不对」「漏了」「核实」这类词,从 3,325 条消息里筛出 176 条,三个子 Agent 帮着归类,它们点出来的,再回原会话一条条核。我又专门翻了我说「核实」的 100 次:它紧接着自己改口的,有 15 次。
扫出来最多的是「没查实就说」,不过也只有这一类我专门又扫了第二遍。光是说「没有」「全部」说过头的,就有 7 处。有一次它只看了一段被截断的搜索输出,就说「也没有」。
我没去重写那条规矩。它 9 月 23 号就在,普通聊天这个文件夹的每个会话都读得到,问题不在它读没读到。
我改的是交付格式:给建议、排序,或者说「没有」「全部」的时候,那句后面必须括注依据。查了就写怎么查的,比如「已查 gh repo view」;没查就写「没查」,没查的不许拿来排序。
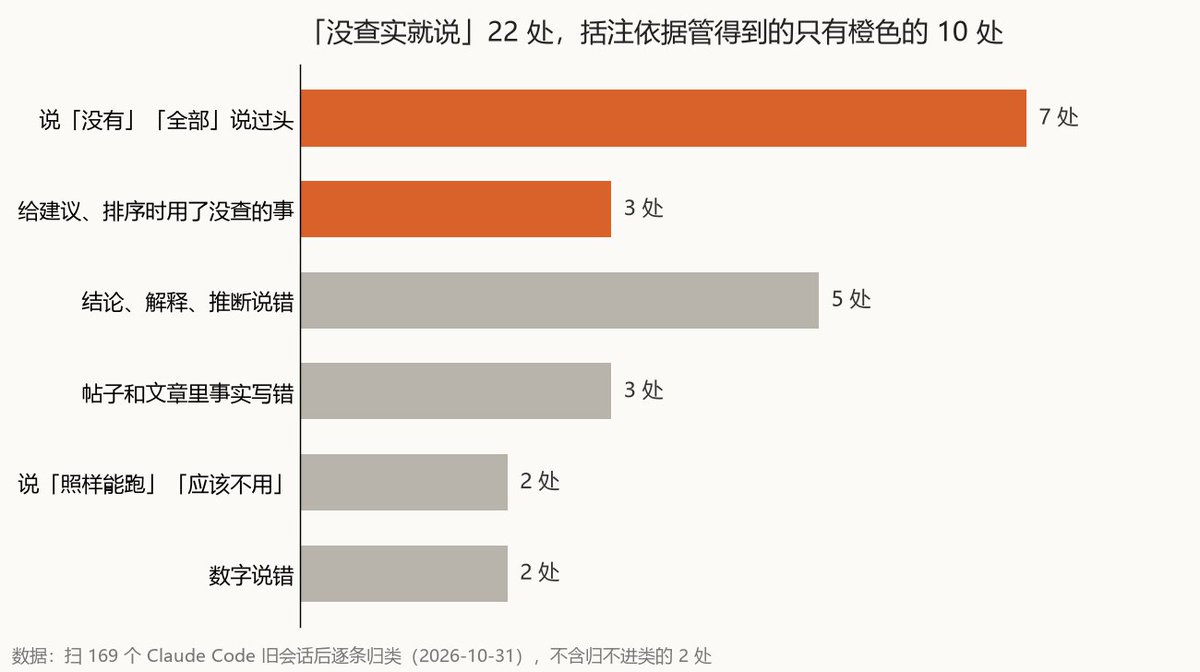
它管得到的只有前两类,22 处里的 10 处。
加完当天,同一个会话里它又漏了两次:一次只写了「已查」,没写怎么查的;一次干脆没标来源。两次都是我拿截图纠正的。
我问它「难道就不能根治」,它说:「能根治一部分,但不能清零。」只写「已查」不写怎么查的,可以挂一个 Stop hook,每轮答完自动扫一遍拦回来;完全没标来源的,脚本抓不到。这个 hook 我还没装。
说实话,有点泄气。但总比以前强,现在哪句没依据,一眼就看得出来。
三、能写死的,交给脚本
那些能写死的,就别指望它记得。
30 号我让它推 3 个仓库,它漏查了远端地址。还好 3 个都没推错地方。但推送这种事,推出去就收不回来。
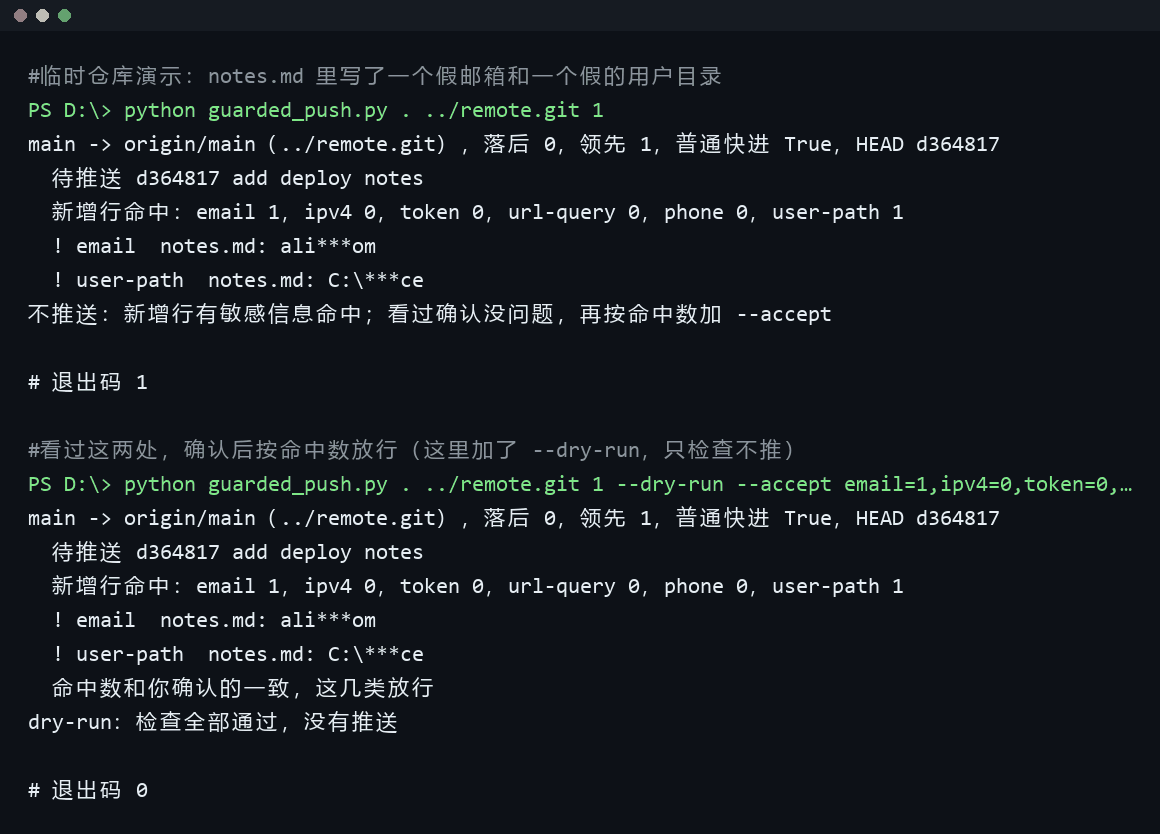
所以我让它写了一个推送前检查脚本。推之前先核对当前分支推去哪、推送地址、要推几个提交、是不是普通快进,再把要推的每个提交里的新增行扫一遍:邮箱、IP、密钥、带参数的链接、手机号、带本机用户名的路径。有一项不对,就不推。
31 号它真拦下来一次。一个内容仓库要推 3 个提交、530 个文件,脚本报了 498 处命中,其中 392 处是带本机用户名的路径。仓库是私有的,邮箱那 10 处里还有 4 处是误报。我看过类别和数量,回了一个「推」,它才按我确认的数放行。
这里还有个坑。同一天它另写过一版敏感信息扫描,在命令行里拼的 Python 少了一层反斜杠,结果反斜杠写法的 Windows 路径漏扫了,它自己还不报错。
检查器自己坏了,它报出来的「没问题」,比没有检查还骗人。
所以现在两个脚本都带自测,既测该推的能推,也测该拦的会拦。这次整理成通用版,我又把推送脚本里的每处检查一处一处故意改坏,看自测报不报错。
写完这篇,我照例让 Codex 审了一遍稿子和脚本,它还是挑出推送脚本 4 个漏洞:sk-proj-、sk-ant- 开头的密钥认不出;邮箱里带 noreply 就整条放过;核的是拉取地址,不是实际推送的地址;只比首尾差异,中间提交里加了又删的内容会漏扫。4 个都补了,自测加到 12 项,故意改坏的检查加到 10 处,10 次都报了错。
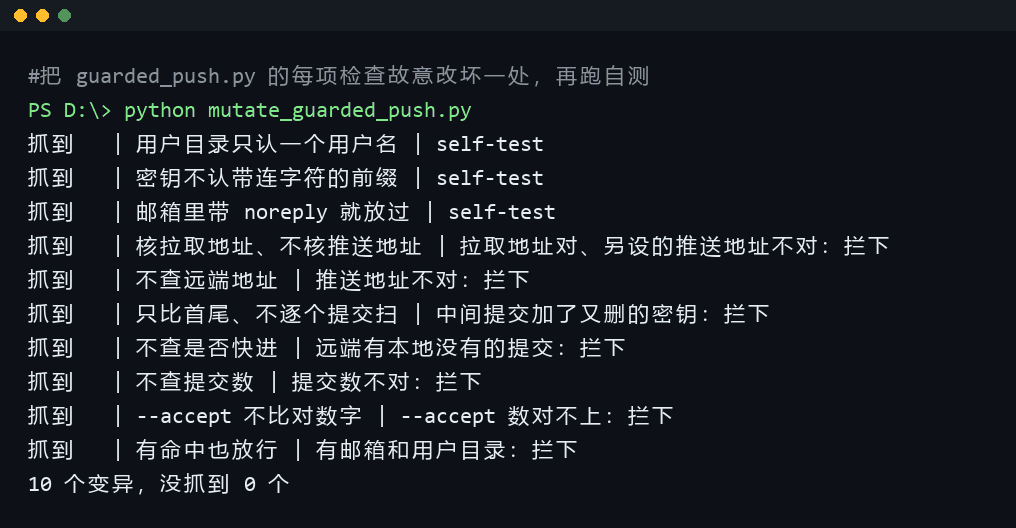
检查器本身,也要先被测一遍。
四、后来,我又找了两个外人来审
11 月 2 号,我把核心规则文件复制了一份,交给 Codex 里的两个模型各审两次,挑出来的再逐条回原文核。合并下来 29 个问题,21 个值得改(有的只是部分成立),其中就有我刚压过的那份全局 CLAUDE.md。
自己审自己,总有看不见的地方。
五、照着做
1. 贴进 CLAUDE.md 的规则
想所有项目都用,放进 ~/.claude/CLAUDE.md;只在一个项目用,放进项目根目录的 CLAUDE.md。Codex 放 ~/.codex/AGENTS.md 或项目根目录的 AGENTS.md。Windows 上 ~ 就是 C:\Users\你的用户名,文件不存在就新建一个。文件里已经有内容的,追加在末尾,前面先空一行,别覆盖;不空行的话,原文件最后一行要是没换行,标题会粘到那一行末尾,也不报错:
# 和 AI 协作的规矩

授权:检查和诊断默认只读。我提出修改目标后,任务范围内、本地、能撤回的修改直接做;提交、推送、删除、发布,每个动作单独问我;购买、订阅和会产生可观费用的 API 调用也单独问。我说「提交」只算提交,不算推送。

不需要我决定的步骤直接做,进度和下一步写在同一条消息里。只在缺我的信息就做不下去,或者要做破坏性、撤不回、超出这次任务范围的操作时才停下来问,并把要动的对象和命令写全。

给选项、建议、排序,或者说「没有」「全部」的时候,在那句后面括注依据:查过的写怎么查的(比如「已查 git status」),没查的写「没查」,没查的不拿来排序;说「没有」「全部」还要写查了哪些地方、输出有没有被截断。

子 Agent 或别的 AI 工具说做完了不算做完:自己看实际改动、跑一遍该跑的检查,再告诉我完成。审查发现的 bug,按「多常发生」「多严重」各打 1~10 分,相乘不到 5 的只记下来,不动手改。

预计会跑很久的任务(只读的检查除外),把任务清单写进工作目录下的 TASKS.md,做完一项勾一项;每个关键取舍(选了什么、否掉了什么、为什么)记一行。

每次收尾按这个顺序写:需要我做的(没有就写「无」)、改了什么、发现了什么和还没核实的。最后一项里列出这一轮你没问我就做的假设。
怎么确认生效,分三步:
-
贴之前,在一个没用 Redis 的项目里问它「这个项目里有没有用到 Redis?」,记下它怎么答。
-
贴好后新开一个会话,Claude Code 里输入 /memory,选中你刚改的那份打开,内容和你贴的一样,就说明它读的是这个文件。到这一步,算「已加载」。
-
在这个新会话里再问一遍同样的问题。「没有」后面带着「已查 …」、写了查了哪些地方,就算「这次照做了」。
两步都过,这次就算成了。它以后每次都照做,这一步测不出来,平时用的时候留意就行。
2. 规矩放哪
-
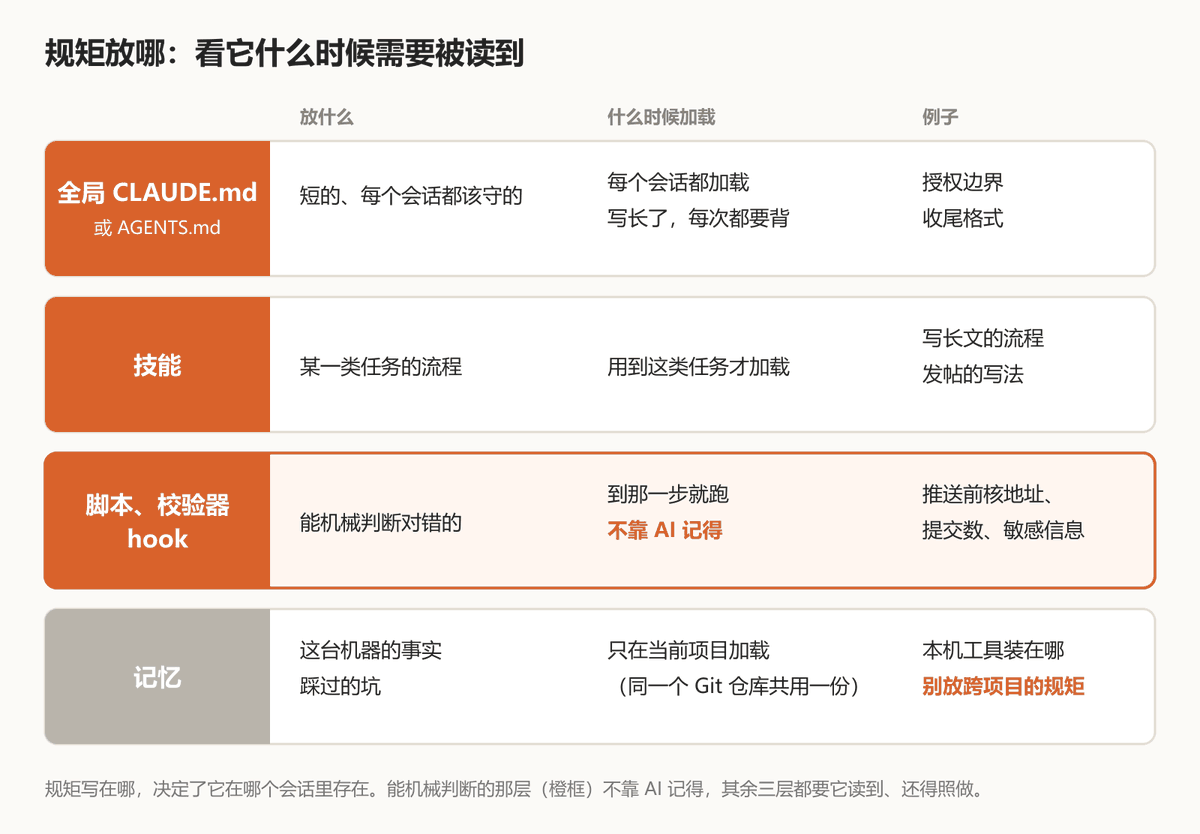
全局 CLAUDE.md:短的、每个会话都该守的,比如授权和收尾。每个会话都加载,写长了每次都要背。
-
技能:某一类任务的流程,比如写长文、发帖。用到才加载。
-
脚本、校验器、hook:能机械判断对错的,比如推送前查什么。不靠 AI 记得。
-
记忆:这台机器的事实和踩过的坑。只在当前项目生效(同一个 Git 仓库共用一份),别把跨项目的规矩放这里。
3. 推送前检查脚本
两个脚本都在这个仓库里:https://github.com/MKE258/claude-rules-scripts (写这篇时的版本是提交 6f2c41e)
需要 Python 3.10 以上和 git,Mac 和 Linux 把 python 换成 python3。找个固定的地方放,下载下来进到目录里:
git clone https://github.com/MKE258/claude-rules-scripts.git
cd claude-rules-scripts
下面写成 path/to/ 的地方,换成这个目录的完整路径;路径里有空格的,整个脚本路径加上双引号,比如 python "D:/my tools/claude-rules-scripts/guarded_push.py" …,不然会被拆成好几段。两个脚本都只用 Python 自带的库,各不到 200 行,跑之前花两分钟翻一眼源码,看它会读什么、写什么。
先在这个目录里跑自测。它在临时目录里建一个本地远端,自带临时的 git 用户名和邮箱,不联网、不碰你的仓库:
python test_guarded_push.py
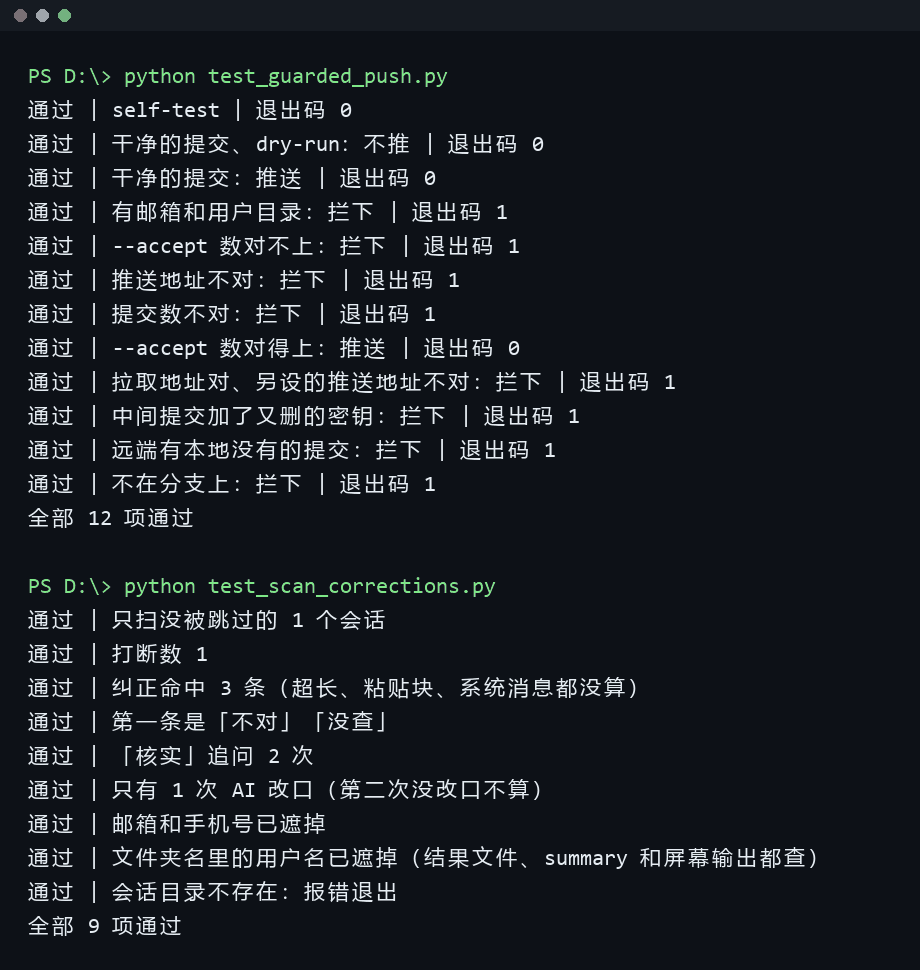
看到「全部 12 项通过」再用。想确认自测本身靠得住,再跑 python mutate_guarded_push.py,10 行都该是「抓到」。它改的是临时副本,你下载的原文件不动。
推之前先 dry-run。这一步回到你要推的仓库目录里跑。三个参数依次是仓库目录、推送地址、要推的提交数,命令里的 . 就是当前目录。地址填 git remote get-url --push origin 显示的那个,远端不叫 origin 就换成它的名字;它按字面比,ssh 和 https 写法、结尾带不带 .git 都算不一样,对不上时第一行括号里会显示它认的地址。数字填 git rev-list --count "@{u}..HEAD" 显示的那个;这条报 no upstream configured,说明是还没推过的新分支,看下面那段:
python path/to/guarded_push.py . git@github.com:yourname/yourrepo.git 1 --dry-run
分支得先设好 upstream,新分支第一次推它会直接拒绝。这时先用 git log -p origin/main..HEAD 自己把要推的提交过一遍(基准分支不叫 main 就换成它的名字),确认没问题再手动 git push -u origin 分支名,之后的推送再交给脚本。
有命中它会列出类别和数量。看过确认没问题,把六类的数照它报的写进 --accept,先带着 --dry-run 再跑一遍。下面是截图里那次的数:
python path/to/guarded_push.py . git@github.com:yourname/yourrepo.git 1 --dry-run --accept email=1,ipv4=0,token=0,url-query=0,phone=0,user-path=1
看到「命中数和你确认的一致」和「dry-run:检查全部通过」,再去掉 --dry-run,这条才会真推:
python path/to/guarded_push.py . git@github.com:yourname/yourrepo.git 1 --accept email=1,ipv4=0,token=0,url-query=0,phone=0,user-path=1
再往 CLAUDE.md 加这一段,路径换成你放脚本的地方:
推送一律用 `python path/to/guarded_push.py`,不直接 git push;命中敏感信息时把类别和数量报给我,我确认后再带 --accept 推。新分支第一次推(还没有 upstream)脚本会拒绝,这时先问我。
4. 扫旧会话的脚本
同样先跑自测,它用一份假会话,不读你的真实记录:
python test_scan_corrections.py
看到「全部 9 项通过」再往下。
再扫你自己的。它只认 Claude Code 的记录,默认读 ~/.claude/projects,记录不在那儿就用 --root 指过去;结果只写进 --out 指定的目录,邮箱、手机号、长串和文件夹名里的用户名都遮掉:
python scan_corrections.py --out scan-out
# 记录在别的目录:
python scan_corrections.py --root 你的记录目录 --out scan-out
跑完会打出几行统计:扫了几个会话、你发了多少条消息、命中几条、落在几个会话里、各文件夹各命中多少、哪些词命中最多。然后是「写入 …(hits.jsonl、selfcorrect.jsonl、summary.json)」和一行下一步提示。
hits.jsonl 是你可能在纠正它的消息,selfcorrect.jsonl 是你说「核实」后它可能改口的地方,都只是按关键词筛出来的候选。我那 176 条,子 Agent 判下来有 147 条都不是。可以交给 AI 归类,要拿来算数的,逐条回原会话核。关键词都是中文的,英文会话基本扫不出来,要扫英文得自己改脚本开头的 KEYWORDS 和 ADMIT 两个列表。
5. Claude Code 自带的规则体检
在 Claude Code 里输入:
/doctor prompt-audit
它会审你的 CLAUDE.md、技能和子 Agent 配置,找给老模型写的过时写法和互相打架的地方,出报告和建议改法,你不叫它改它就不改。它是让模型去读、去审,会花你的额度,配置文件越多花得越多。
我这台的 2.1.308 和 2.1.309 里都有这个命令,更早的版本没查过,在终端里跑 claude --version 能看到你的版本。我当时输的是 /claude-api prompt-audit,/doctor prompt-audit 也是交给同一个技能去审,输哪条都行。跑出来要改的有 35 个文件里的 82 处,我分 39 批改完。
最后
这两天折腾下来,我最大的感受是,规矩写得再好,也只是给它的提示。
读不到的,挪个地方;读到了不照做的,让它把依据摆出来;能写死的,交给脚本,再把脚本自己测一遍。
你那份 CLAUDE.md 里,有没有一条写了很久、它就是不照做的?评论区说说是哪一条,我挺想知道大家是不是栽在同一个地方。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


