
跑完520万字和50万次判断,我做了可能是全网最硬核的「去AI味」Skill。
文章目录
今天这篇可能会稍微硬核一点。
但是,如果你平时用 AI 写东西,这篇能帮你省下很多改稿到崩溃的时间。
过去两个月,我一直在做一个语言学实验。
我做了两轮数据实验来量化“什么是 AI 味”,第一轮 629 篇文章(283 万字),第二轮新跑了 540 篇配对文章(256 万字),前后折腾了 1169 篇文章,一共 520 万汉字。
基于这 520 万字语料,我把市面上能想到的“AI 味”拆成了 100 多项指标,用脚本检测、大模型语义检测和人工盲评三种方式检验,跑了 50.7 万次逐句逐段的机器语义判断,最后自己还把抽出来的候选句和比喻人肉盲读了一遍。
在这个实测数据的底子上,我做成了现在的 lieflat-less-ai-tone 这个skill,目前已经全部开源:https://github.com/larashero3-dotcom/lieflat-less-ai-tone
今天我就用大白话跟大家聊聊:真正的 AI 味到底是什么,以及这个 Skill 是怎么把它量化测评的。
历时两月,我做了两轮量化实验,烧了 4 亿 token
先简单说说我是怎么测的。
我的核心思路是,“AI 味”其实就是 AI 的写作习惯,所以我选择优秀的人类真实文章作为基准,和 AI 生成的文章进行对照测评,差异的部分,就可以称之为“AI味”。
其实我在做第一版的时候,已经让 5 个主流模型(Claude Opus 4.6、GPT-5.6、DeepSeek、Gemini、Kimi)写了 300 篇文章,跟 329 篇人类文章做过一次对比了。
但跑完第一轮,我发现了一个致命漏洞。
两边写的根本不是同一篇东西。
比如说,人类那篇写的是某家公司的财报,里面全是数字,但是AI 写的是行业趋势漫谈,里面没几个数字。这时候你跑脚本算出来“人类的数字密度是 AI 的 3 倍”,这能说明 AI 不爱用数字吗?不能,这纯粹是因为题目不一样。
因为我测评的目标,是量化 AI 的写作风格,所以我并不需要衡量信源、构思这些维护,更需要关注用词、标点、节奏、过渡等维度。
所以第二轮,我直接换了一个测法,要求必须是同题、同事实、同长度配对来生成 AI 语料。这样测出来的任何差异,才是完完全全属于 AI 的写作习惯。
那么,具体该怎么测量呢?在第一版,我是通过 Python 正则脚本来测量,这种方式很快,但是它的缺点也很致命,你在实测的时候就会发现,正则表达式这玩意太死板了,它根本看不懂人话。
它只能机械地去数每个词出现的数量。比如说,它能数出一句话里有三个顿号,但它分不清这三个顿号是在列举正经的产品参数,还是在无脑凑排比。
为了解决这个问题,我把整个实验分成了三层:
第一层还是用 Python 脚本,把标点、句长、分节这些能用数字算出来的 90 项指标全算了一遍(光用这些句子特征训练一个分类器,区分真人和 AI 的准确率就已经到了 97.6%)。
第二层,可以让模型来阅读做语义判断,专门对付那些脚本看不懂、必须理解上下文才能判断的特征。这一项需要耗费大量token和时间,但是,Jev 问世了,它优秀的性价比和极快的速度,解决了这个障碍。
这一层前前后后一共跑了 50.7 万次判断,烧了将近 4 亿 Token,但其实成本并不高。
而且,这 50 万次判断的每一条结果,都带着置信度老老实实存在我的本地 JSON 文件里,随时可以拉出来复查。
至于第三层,就是连大模型自己都搞不定的东西(比如比喻到底贴不贴切),那就没什么捷径了,我是直接一条条人工盲读的。
最终的实验成果:什么是“AI味”
跑完这 50 万次判断,筛除各种干扰信息之后*,*最后真正成立的有这些指标。
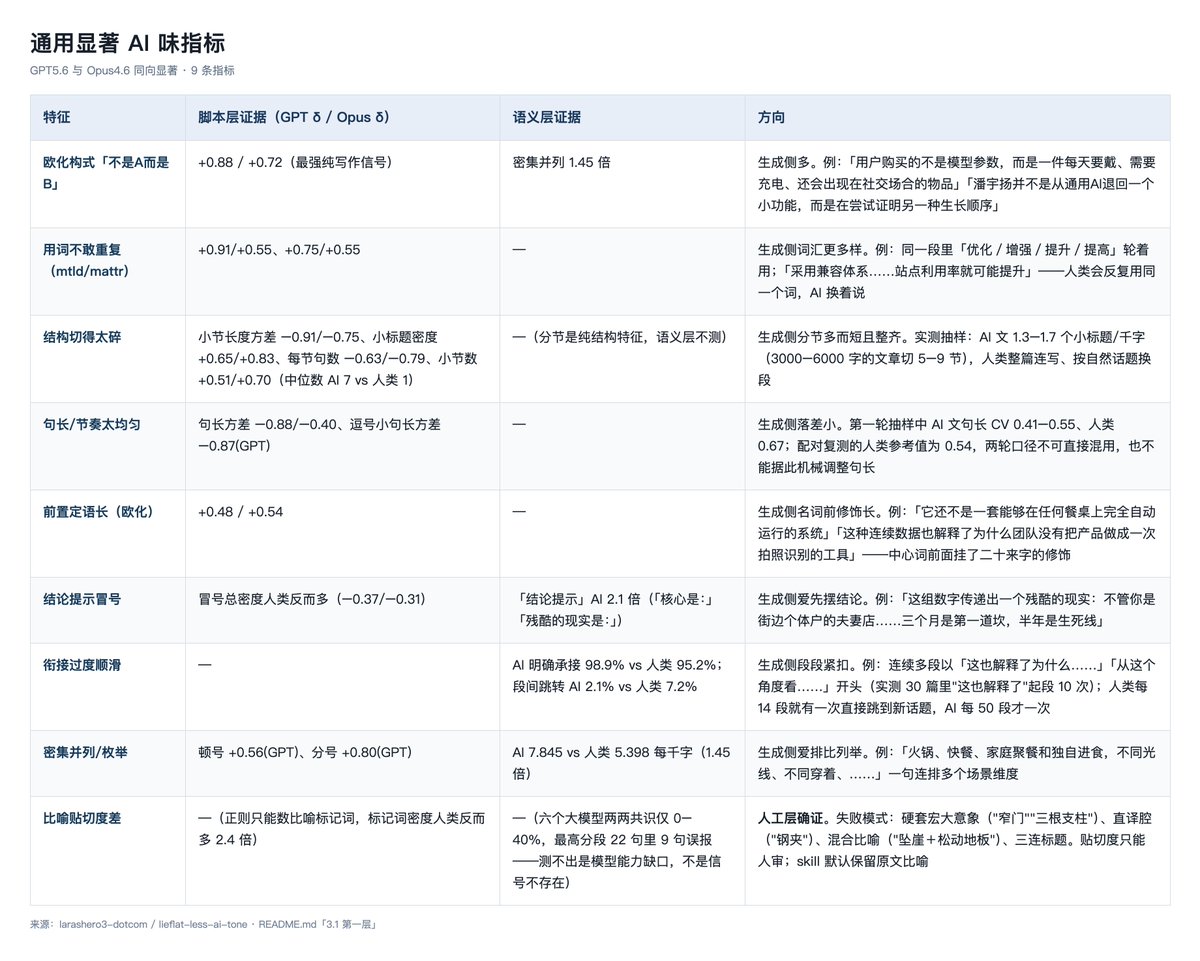
第一层是跨模型通用的 9 项核心 AI 味指标。
这里面既有大家熟悉的句式套路,也有更隐蔽的 AI 写作深层习惯,比如用词不敢重复,还有衔接过渡顺滑( 93% 的文章连续 6 段以上都首尾紧密衔接,不给读者喘气空间)。
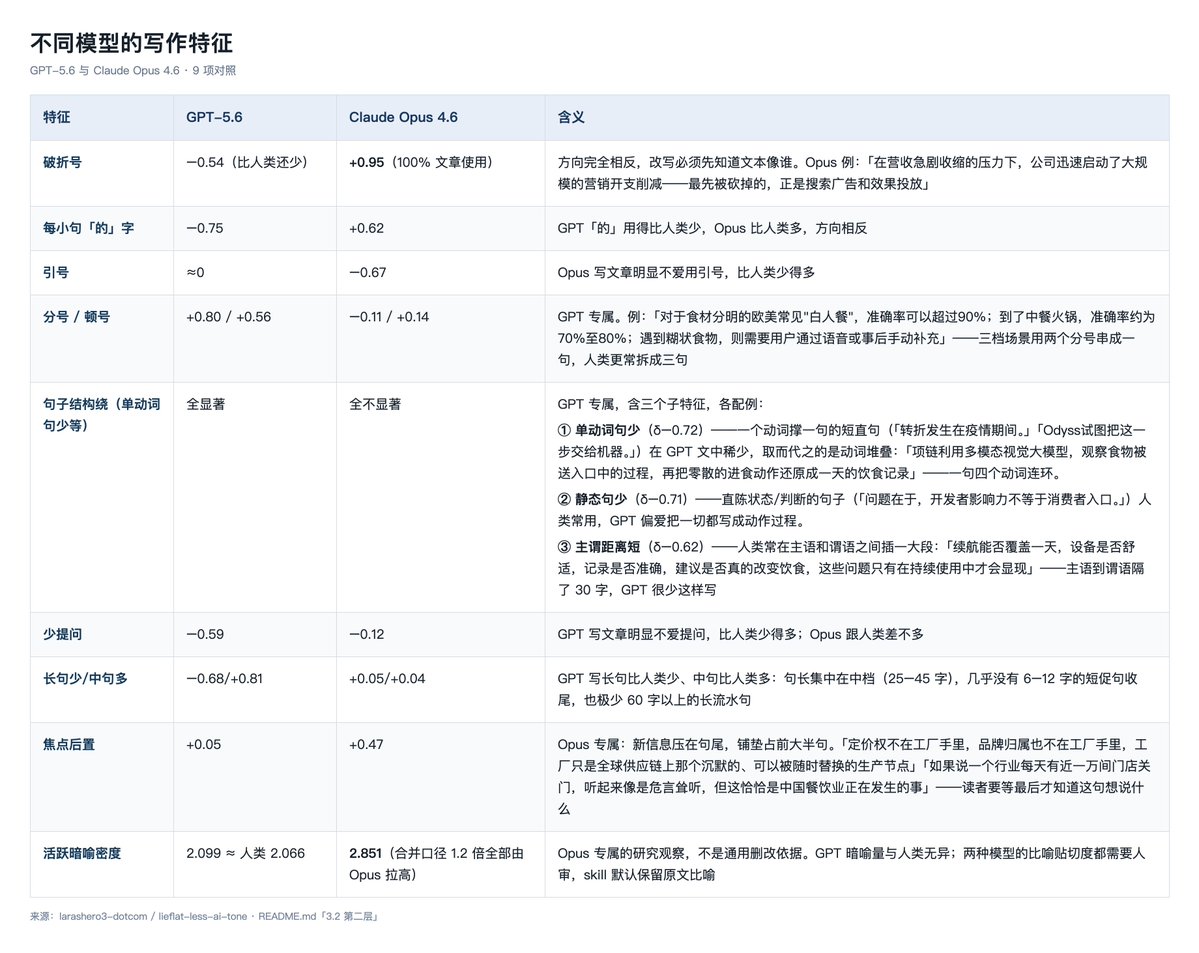
第二层则是不同模型特有的写作偏好,也有9项。
比如 GPT-5.6 和 Claude Opus 4.6,这两个模型在标点和句法上的表现,通常是相反的。Opus 特别爱用破折号,但GPT并不是。GPT 特别爱堆砌动词,但 Opus 这个毛病并不明显。
说实话,上面这两张表里的每一条,背后的实测数据和规则单拎出来,其实都够写一篇文章了。
今天篇幅有限,我挑 4 个有代表性的来聊。
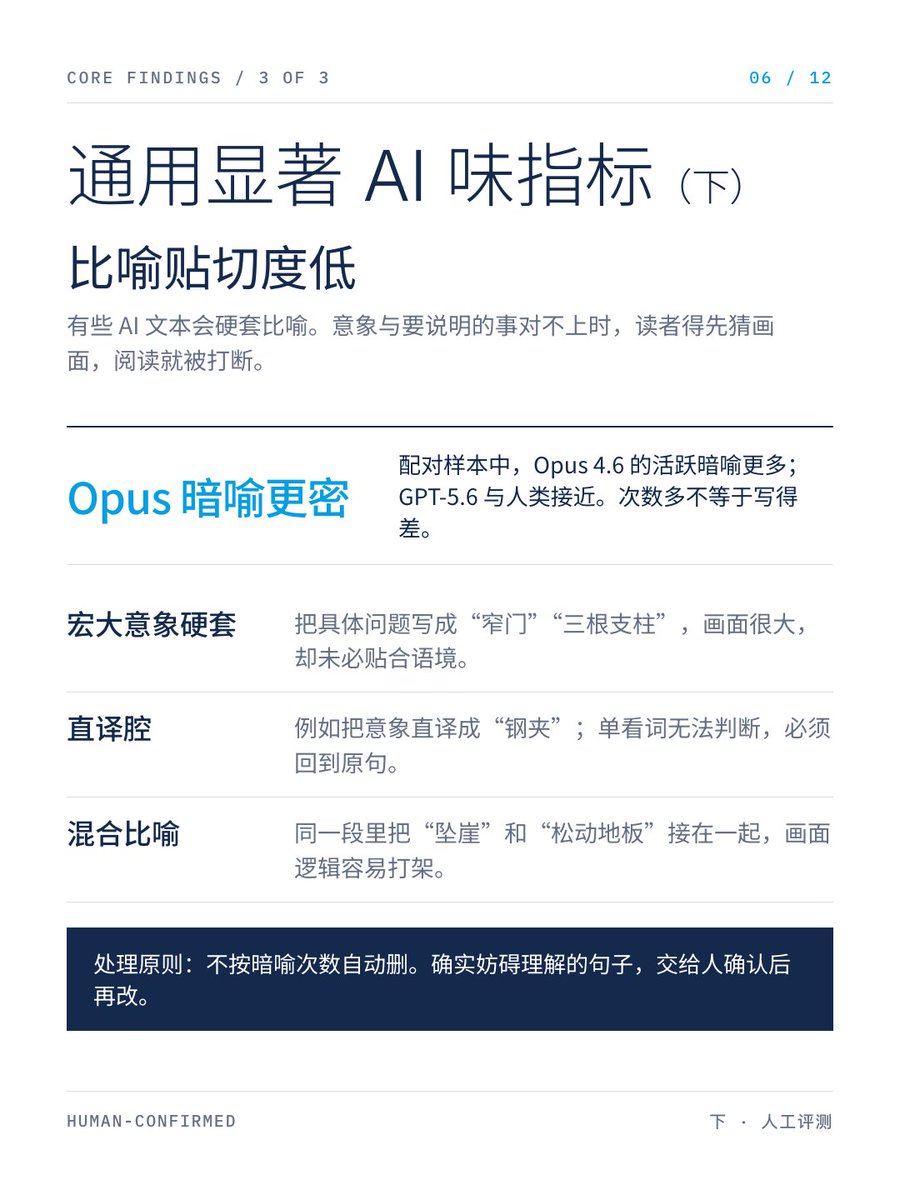
先说一个,可能被之前的很多去 AI 味skill 忽略的,就是比喻。
很多人以为 AI 味重,是因为 AI 比喻用得太多了。
我一开始也这么觉得,但我的数据实测是,在我的这批语料中,人类用比喻的频率,反而是 AI 的 2.4 倍。
那既然不是数量的问题,为什么我们看 AI 的比喻还是那么难受?
因为它的比喻根本不贴切。
语言学有一本著作叫《我们赖以生存的隐喻》,主要内容就是,隐喻是人的思维工具,而不只是修辞。人之所以会比喻,是因为比喻的基础是人的身体与空间经验。
而 AI 并没有身体,没有感知,自然也学不会比喻。它写比喻的逻辑,是靠词语在语料里的统计关联计算出来的。
比如我之前盲读时看到的两句话,「数据难看得很平静」「AI 写作的薄,来自经验缺席、表面规律替代理解」。“平静”“薄”,这些写法,都有一种近乎诡异的 AI 感。
所以结论很粗暴,就是现在 AI 还不会写比喻。很多 AI 味,是不贴切的比喻句造成的。
聊完比喻,再看第一层表里最扎眼的那两个欧化特征。
因为我这次测的是 GPT 和 Opus 的模型,它们在中文写作时,有非常明显的“翻译腔”。
我的实验专门测了 18 种常见的翻译腔,结果发现像普通被动句,在 AI 文章里每千字连 0.09 次都不到,跟咱们正常的中文书面语根本没区别。
真正跨模型的显著翻译器,主要是“不是 A,而是 B”的对举句式,还有超长前置定语。
不管是 GPT 还是 Opus,“不是 A,而是 B”的翻案腔都是强信号,足足是人类的 3.4 倍。
还有英文直译过来的超长前置定语。
英文习惯把从句挂在名词后面,AI 直译成中文的时候,就把一长串修饰全放在了中心名词前面。300 篇 AI 文章里,有 179 篇都有这个问题。
比如语料里这句:
“这是一个能够让团队在不增加人力的情况下显著提升审核速度的工具。”
第三个让我很头疼的毛病,是 AI 很喜欢用的的密集并列与枚举。
AI 写东西好像有一种强迫症,特别怕别人觉得它考虑不周全。只要一有机会,它就会用顿号来列举。
实测下来,一个分句里用顿号连排三项以上的频率,AI 是人类的 1.8 倍;放到语义层去测广义的“密集并列”,AI 每千字也要高出 1.45 倍。
随便翻一句语料都是这种报菜名的节奏:
“火锅、快餐、家庭聚餐和独自进食,不同光线、不同穿着、……”
而且它不止爱排词,连句子也很喜欢排比出现。
比如连续问你三句:“叫什么名字?承载什么功能?嵌入哪个生态?”这种连词性、字数、位置都是类似结构的三连句,AI 出现的比例是人类的 2.75 倍。
第四个我想说的,是我差点误删、但是在语义检测层又变得显著的结论提示冒号。
最开始我只拿 Python 脚本去数文章里冒号的总数。结果,人类的冒号总密度居然比 AI 还高。因为真人作者写文章,经常会写“某某说:”来引用原话,或者用一句话引出下面的列表。
当时我差点就把冒号这条规则给删了。
直到我用 Jev 来做了语义理解,把几万个冒号按上下文意思拆成了 6 类,才得出更为准确的结论:
结论提示冒号的使用上,AI 的频率竟然是人类的 2.1 倍以上(固定提示语更是人类的 4 倍左右)。
就是你们平时最眼熟的这种写法:
“这组数字传递出一个残酷的现实:不管你是街边个体户的夫妻店……三个月是第一道坎,半年是生死线。”
还有满屏的“核心是:”“关键在于:”“一句话总结:”。
说人话就是,真人用冒号是为了引出别人的话;AI 用冒号是为了让自己能下结论。
把冒号前面那半句装深沉的废话直接剪掉,反而更简洁有力。
以上,只是我整个实验的冰山一角。更多的数据、结论,大家可以直接去仓库查看。
零门槛无痛使用
我的第一版skill 使用逻辑比较粗暴,其实就是让 AI 照着规则直接把整篇文章改一遍。
但这个方式有个缺点,比如 AI 味里有一半是整篇文章的结构问题(比如句子长短太均匀、小标题太多),你如果让模型逐句去改,它为了往“参差感”方向做,很可能会把你的正常句子改得零碎。
所以在做这个全新的 lieflat-less-ai-tone 时,我把整个底层逻辑全改了。
核心就一句话:先检查,再修改,人点头了才准改。
我现在手头有一篇刚生成的 AI 初稿,我只需要对着 Agent 说一句:帮我用去 AI 味 Skill 处理一下这篇文章。
注意,这时候它绝对不会直接改你的文章,而是先在后台调起 skill 里的 Python 脚本和语义判据,给你一份检测报告。
等你看完回复后,它才真正开始干活。
在改写这一步,我也有详细说明,只允许在命中的那几个字上做最小改动,而且如果同目录里有你自己写的风格指南(比如你自己平时就爱用破折号),一律以你的个人习惯为准。
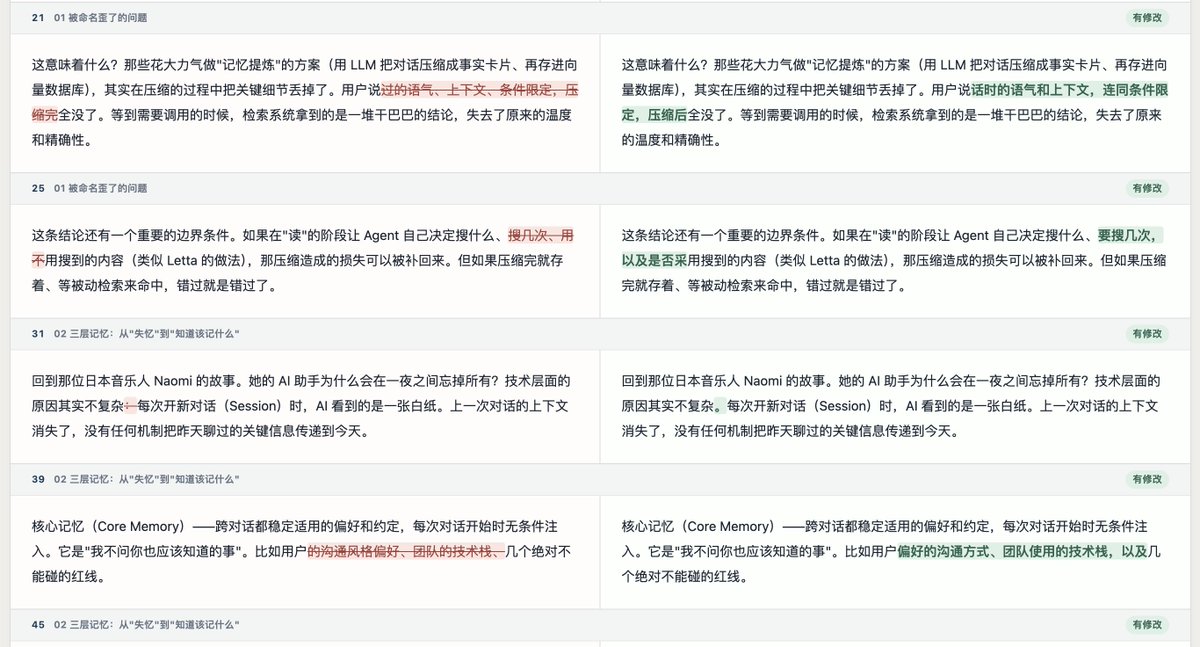
改完之后,它会自动对改完的文章再跑一遍复测,然后直接在你本地生成一个独立的网页文件,告诉你修改后的效果如何。
仓库里有个案例大家可以看看。
写在最后
说实话,最开始决定要做这个实验的时候,我根本没想到自己会掉进这么大一个兔子洞里。
为了搞清楚什么叫“AI 味”,前前后后跑了 538 万字,做了 50 万次语义判断,中间因为正则表达式写太宽重跑了好几遍,最后又自己对着屏幕把那些候选句和比喻人肉盲读了一遍。
很多人可能会觉得,不就是改个文章吗,至于这么死磕吗?
但在把那几万条人类和 AI 的句子放在一起对比完之后,我心里反而生出了一种挺奇妙的感触。
大家平时那么讨厌 AI 味,讨厌的到底是什么?其实更可能是模型收敛训练后,一种太过统一的文风。
这是一个非常有意思、也很值得投入的领域。我想,许多模型训练和 agent 调试写作能力的过程,和我做的这个实验,也有很多类似的地方吧。
后续,我应该还会持续在这个 skill 基础上迭代。顺便预告一下,我还做了个中文写作自然度的 Benchmark,最近就会发布。
如果对你有帮助,欢迎给我一键三连吧~
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


