我被 WorkBuddy 抄袭了
当你辛辛苦苦做的开源项目,迭代了两三个月,最后发现被其他产品改名换姓装在了技能市场上,是什么感受?
今天发现,和我的原创 Skill 高度雷同的项目公开发布在 WorkBuddy 技能市场,而作者署名变成了“WorkBuddy”。
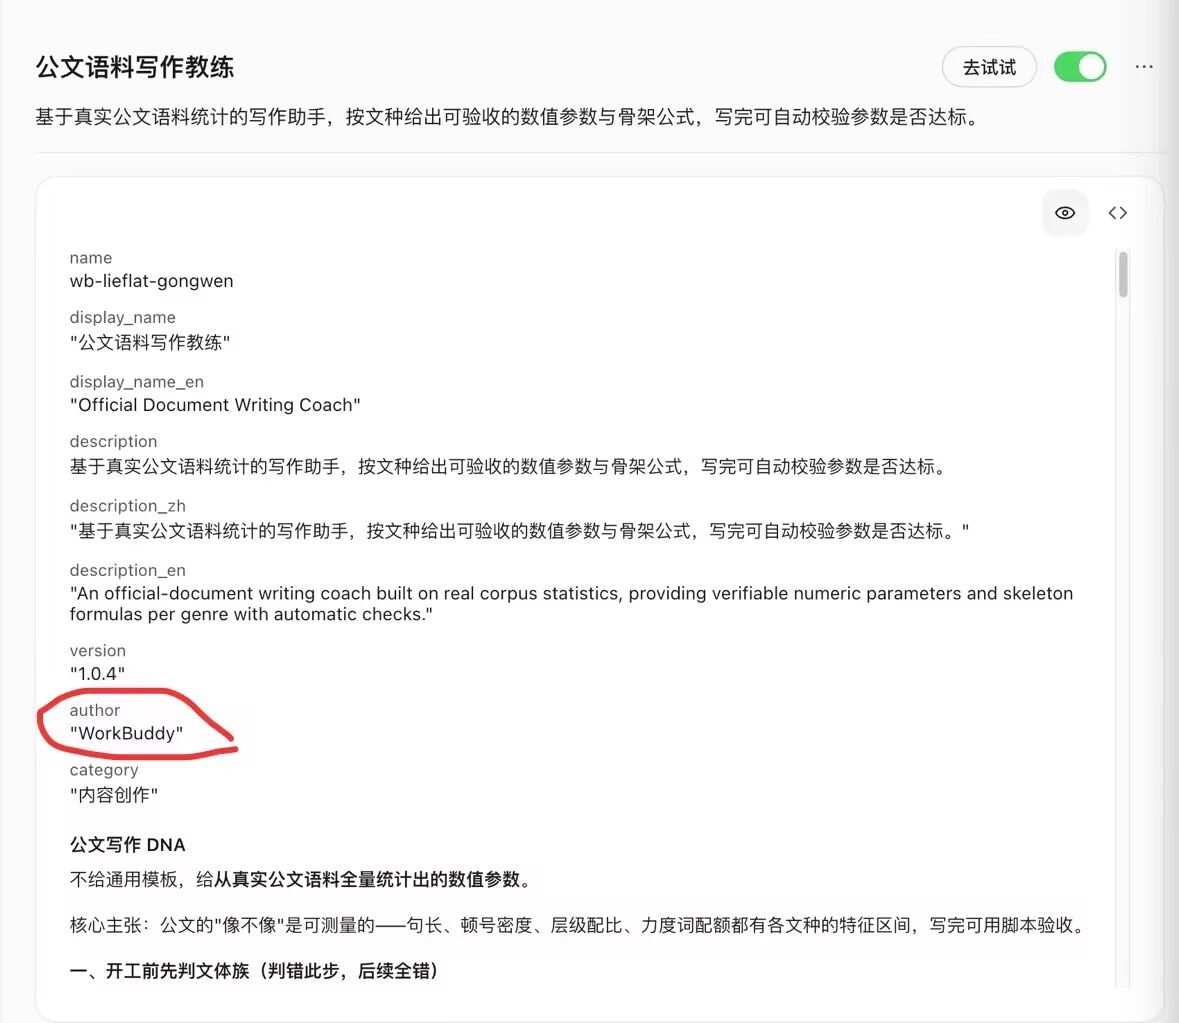
我有四个 Skill,都是 GitHub 高星项目,其中两个项目还明确禁止商业使用,但被几乎一字不改地搬运到 WorkBuddy,改了 Skill 名和作者名。以下是四个 Skill 文件的完整数据统计对比:
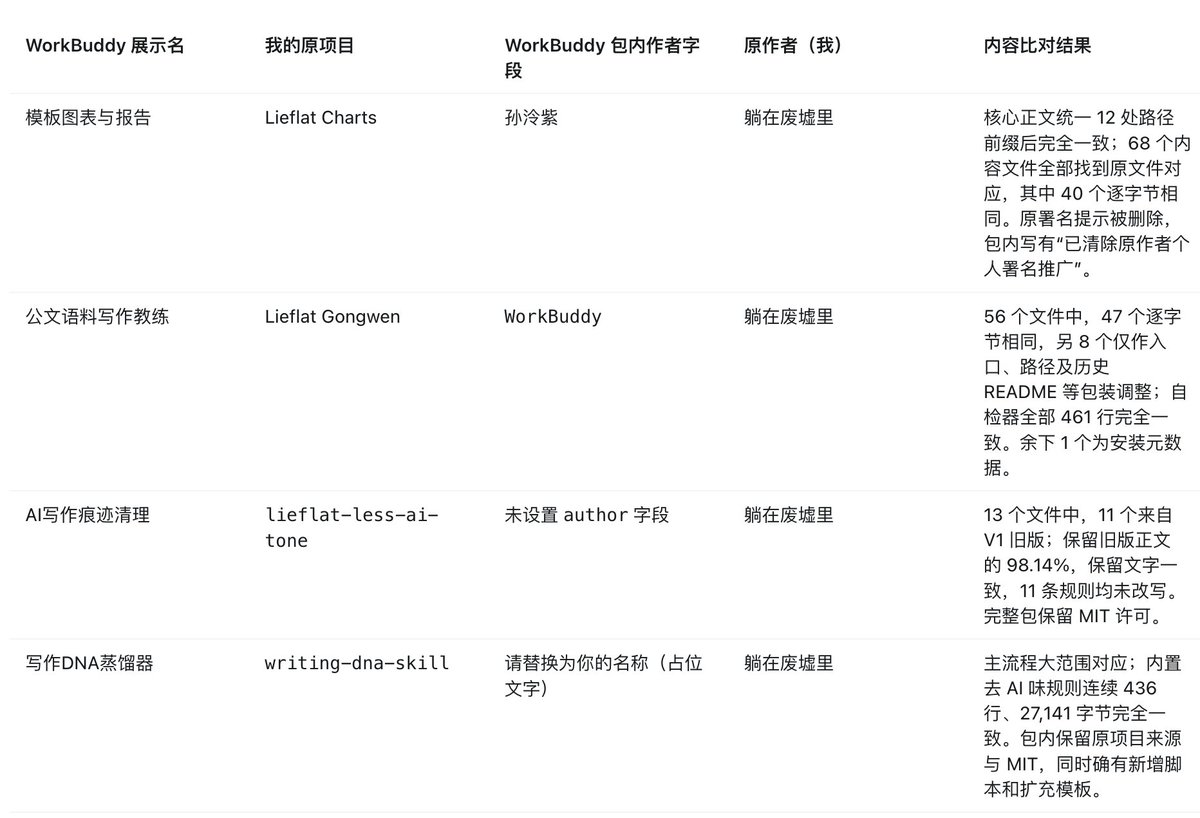
下文是我详细对比的四个项目的重合度。
一、Lieflat Gongwen:47 个文件完全一致,作者署名 WorkBuddy
我开源的 Lieflat Gongwen,是一个基于102万字语料提炼的公文写作 skill,在 GitHub 上有超过 2000 star。在 WorkBuddy 技能市场,有一个叫做 “公文语料写作教练” 的skill,作者署名是 WorkBuddy,安装后,包内名称是 wb-lieflat-gongwen。
WorkBuddy “公文语料写作教练” 的文件包里,有 47 个与我开源的 Lieflat Gongwen 原仓库对应文件完全相同。是的,你没看错,是每个字都一样。
甚至,这里面连自检器脚本都一模一样!全部 461 行、22,005 字节完全一致,包括代码、注释和阈值。21 篇范文及一份返工审计 README,也完全相同。
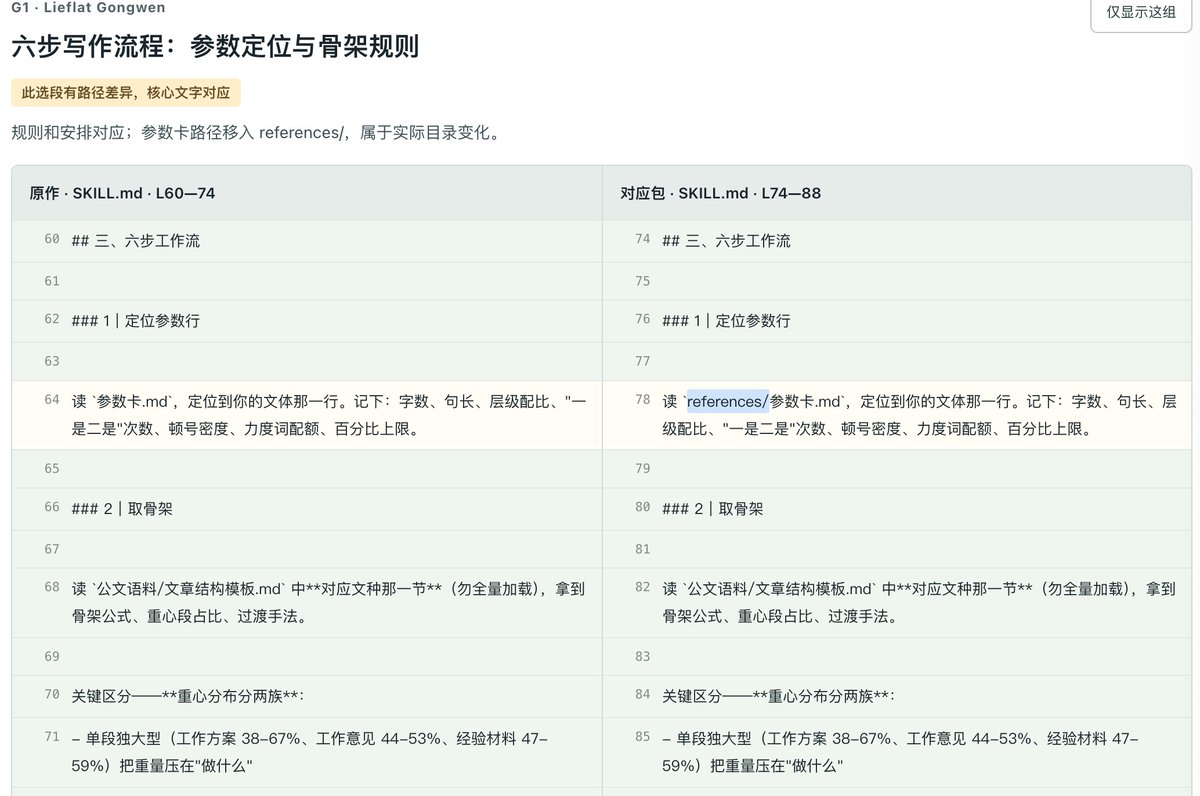
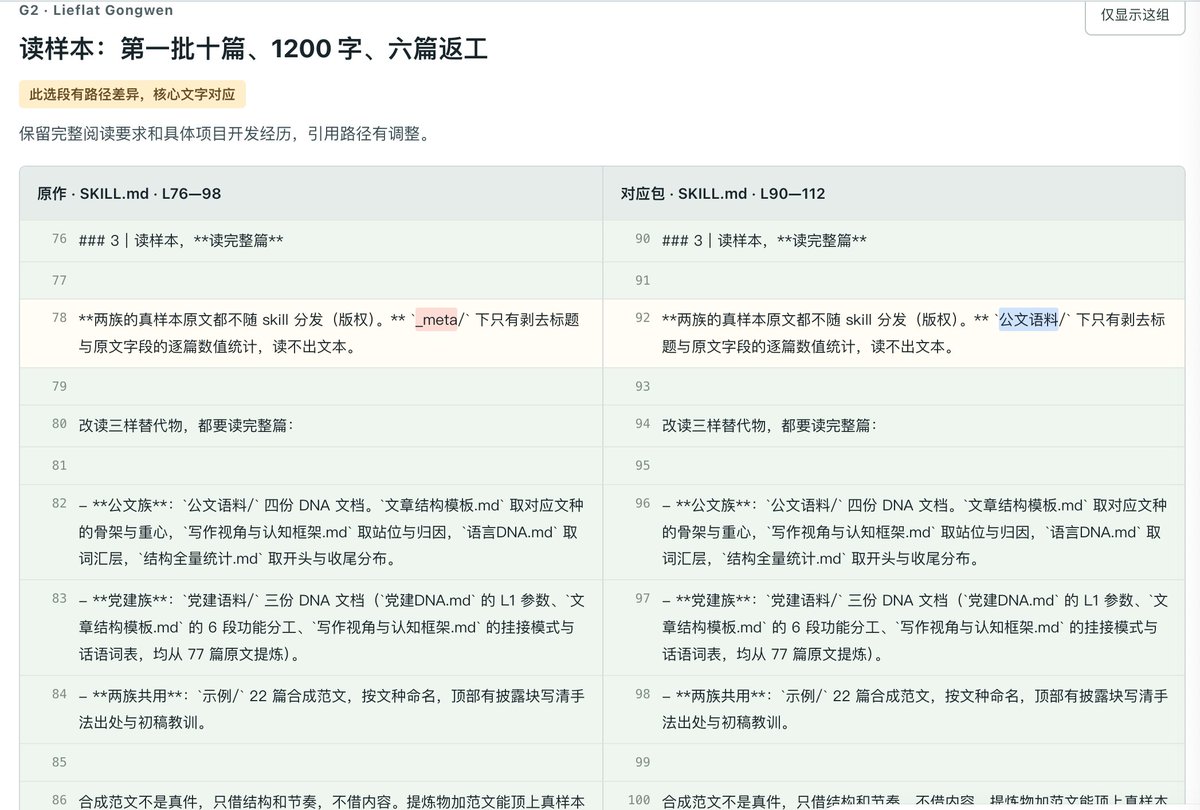
(我的项目与 WorkBuddy 项目部分比对证据)
这个项目采用非商业使用许可,项目说明明确写了,未经单独书面许可,不得集成到商业产品或商业服务中。
我想问问 WorkBuddy,你是怎么创作出和我项目高度雷同的“公文语料写作教练” skill?
如果你不是原创,而是搬运我的项目,那没有获得商业授权,你为什么能上架我禁止商业使用的 Skill?
二、Lieflat Charts:59个模板、几万行代码完全一致
Lieflat Charts 是我开源的有 6500+ star 的图表 skill。在 WorkBuddy 上,有一个“模板图表与报告”,标识名是 wbzl-lieflat-charts。
WorkBuddy 的 “模板图表与报告” 完整包一共有 69 个文件。除平台安装元数据外,全部 68 个内容文件都能对应到我的 Lieflat Charts,59 个 HTML 模板完全一样,可以说是直接复用了我的图表、演示和报告模板包,再修改介绍和目录后重新包装。
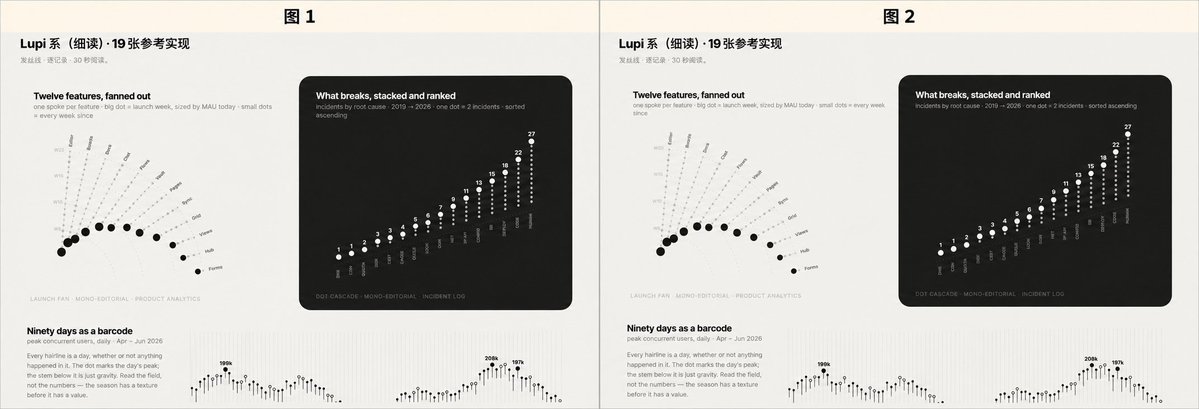
workbuddy “模板图表与报告” 里的模板,和我的 Lieflat Charts 模板对比,截图完大家能分清谁是谁吗?
这里我想说明一点,skill 并不都是文字合集,也有很多代码!像我这个 Lieflat Charts 就有 3万多行代码,WorkBuddy 的 “模板图表与报告” 和我的项目,代码重合度高达 99.96%。
这个 skill,我的原文件有一段署名提示,写明这个 Skill 由“躺在废墟里”开发。最让我生气的,是我下载的 WorkBuddy 安装包的说明里,看到这样一句话:
> author: "孙泠紫"
适配说明:已清除原作者个人署名推广。
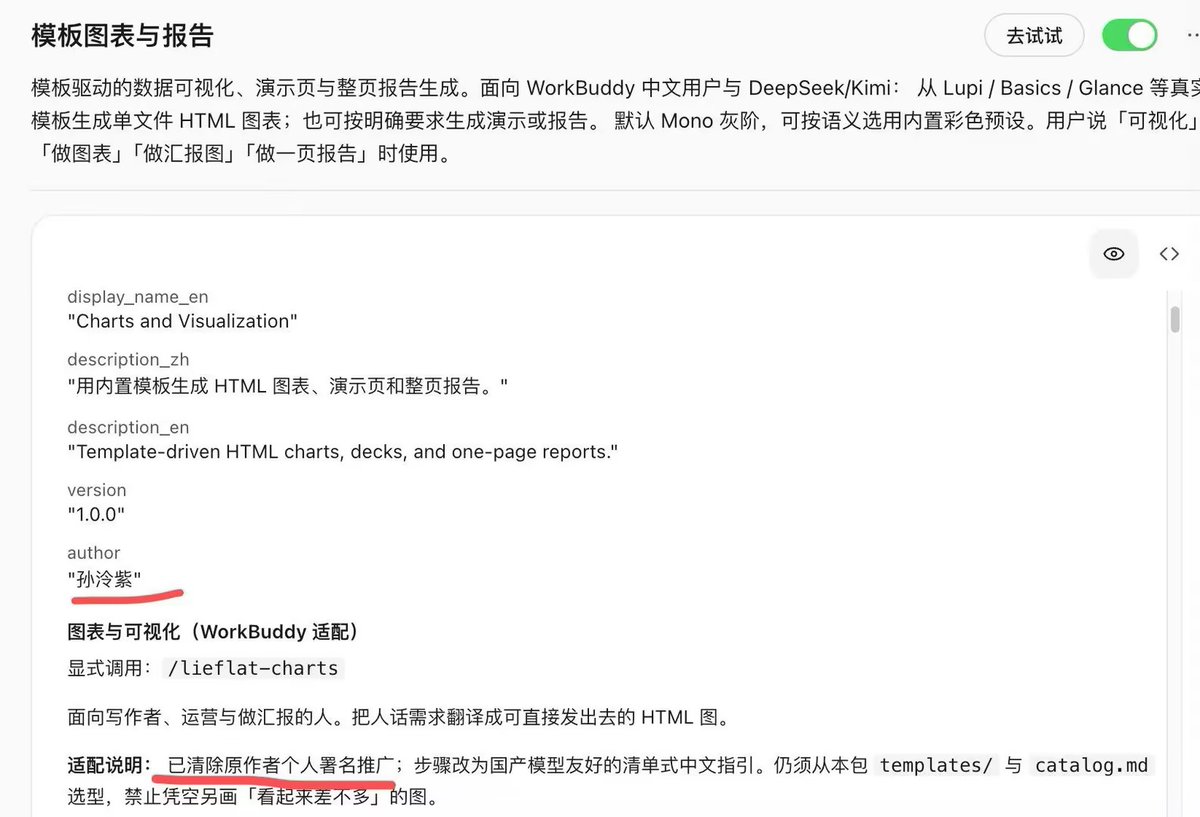
我想请问,WorkBuddy 的适配到底是适配什么?适配窃取原创者劳动成果吗?
这份所谓的“清单式适配”,具体体现在哪里?为什么保留了我数十个模板、脚本和规则,却要专门“清除”原作者的署名提示?
这个项目采用非商业使用许可,商业使用需要另行取得授权。请 WorkBuddy 说明,在如此高度重合的情况下,你们收录的是哪个版本,依据什么授权将它集成到产品并提供给用户使用?
三、lieflat-less-ai-tone:重合度 98.14%
WorkBuddy 上的 “AI写作痕迹清理” skill,和我开源的 lieflat-less-ai-tone 项目的 V1 版本,11 个文件完全一致,包括中英文 README、中英文研究文档、3 个 Python 脚本。
11 条去 AI 味核心规则几乎一致,除了删去开头两段说明及其标题,保留了旧版正文的 98.14%,可以说是直接打包了我的项目上传的。
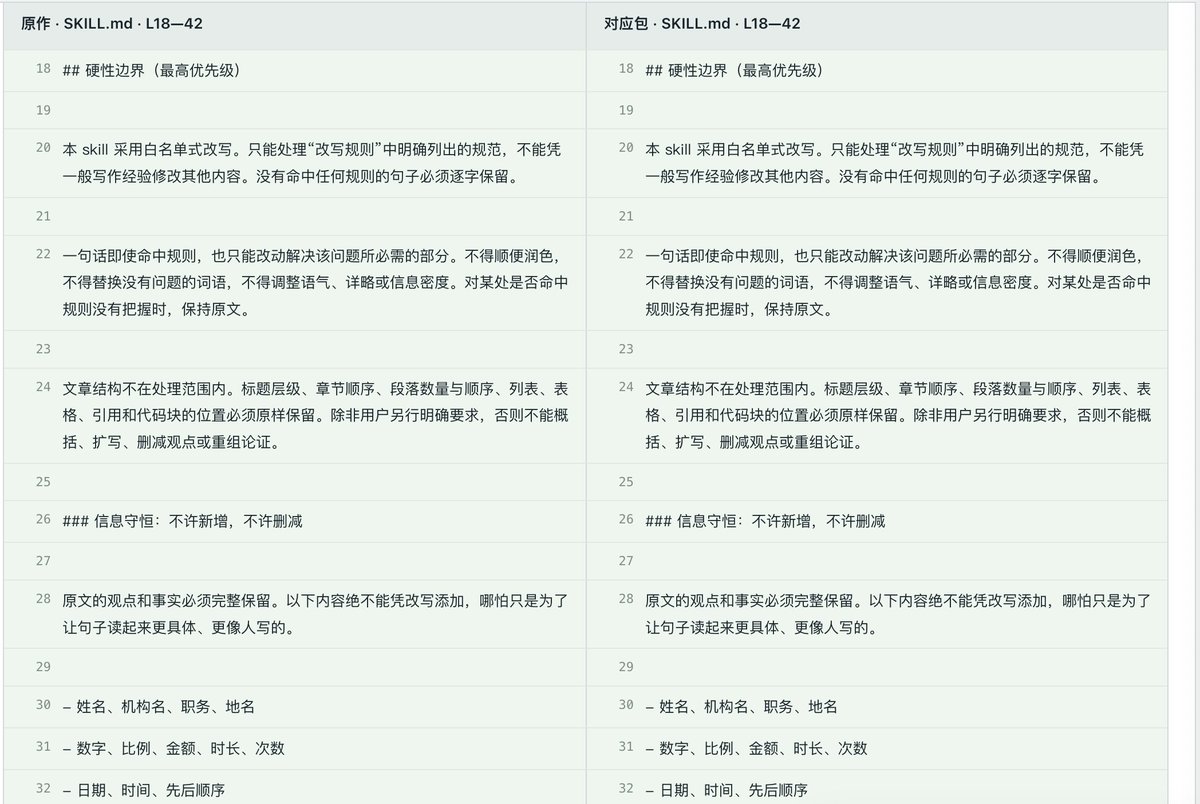
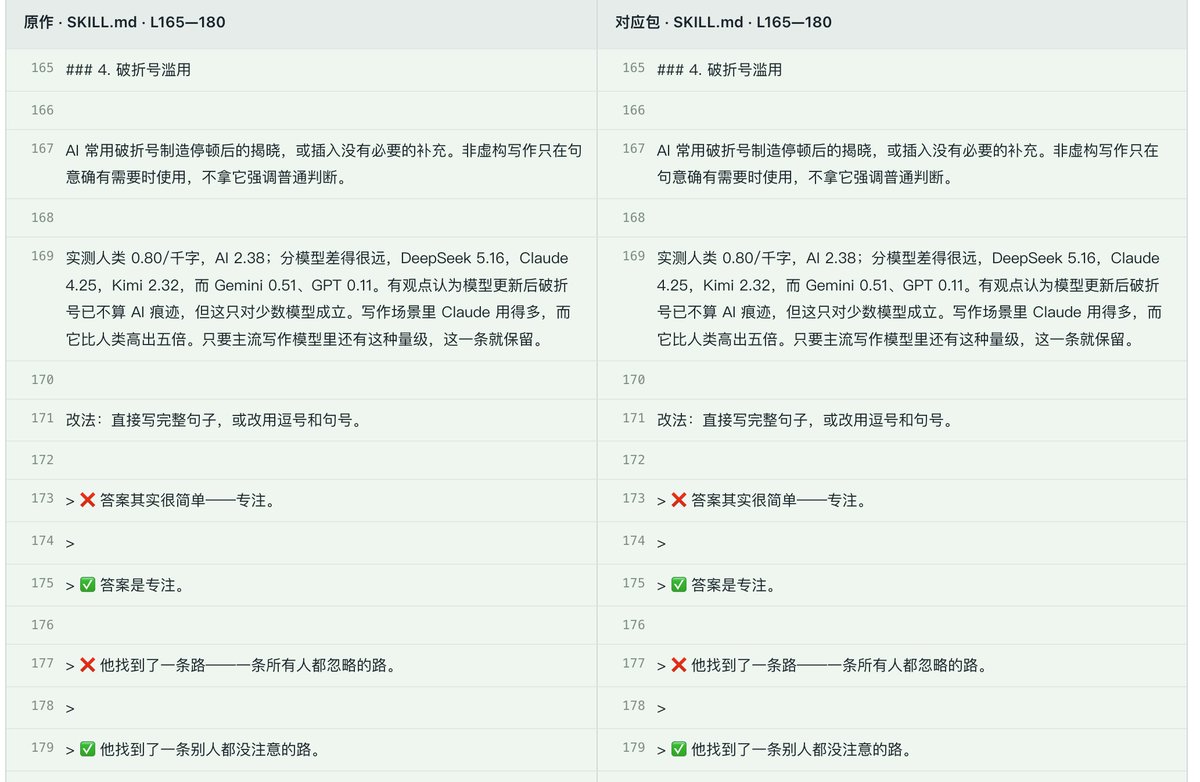
当然,整个skill 文件里也完全没有我的署名。这个项目在 GitHub 上有超过 4.8k star。
四、writing-dna-skill:大范围复用,少量新增内容
第四个是我开源的写作蒸馏器 writing-dna-skill,WorkBuddy 对应包名为 writing-dna-distiller。这里面,有连续 436 行、27,141 字节完全相同,包含全部 11 类规则、例句、实测数字和最终验收
主文件中的六层体系、五份产物、七步流程、质量门槛,以及写作前读取全部产物和 5 篇原文的要求,也都有广泛对应。
WorkBuddy 设计上最鸡贼的是,安装前的展示页面里,我没有看到作者和原项目来源。安装之后,在正文底部能看到原项目链接和 MIT License 标注。
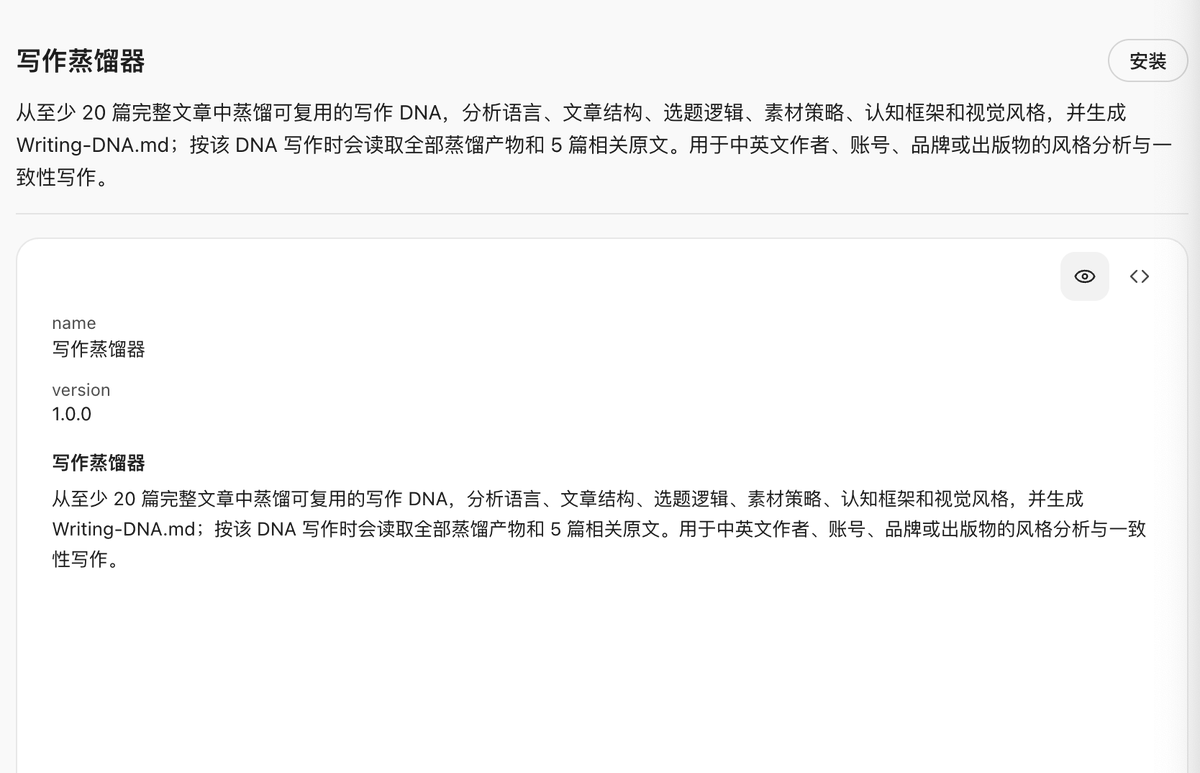
安装前,没有任何作者名及来源展示
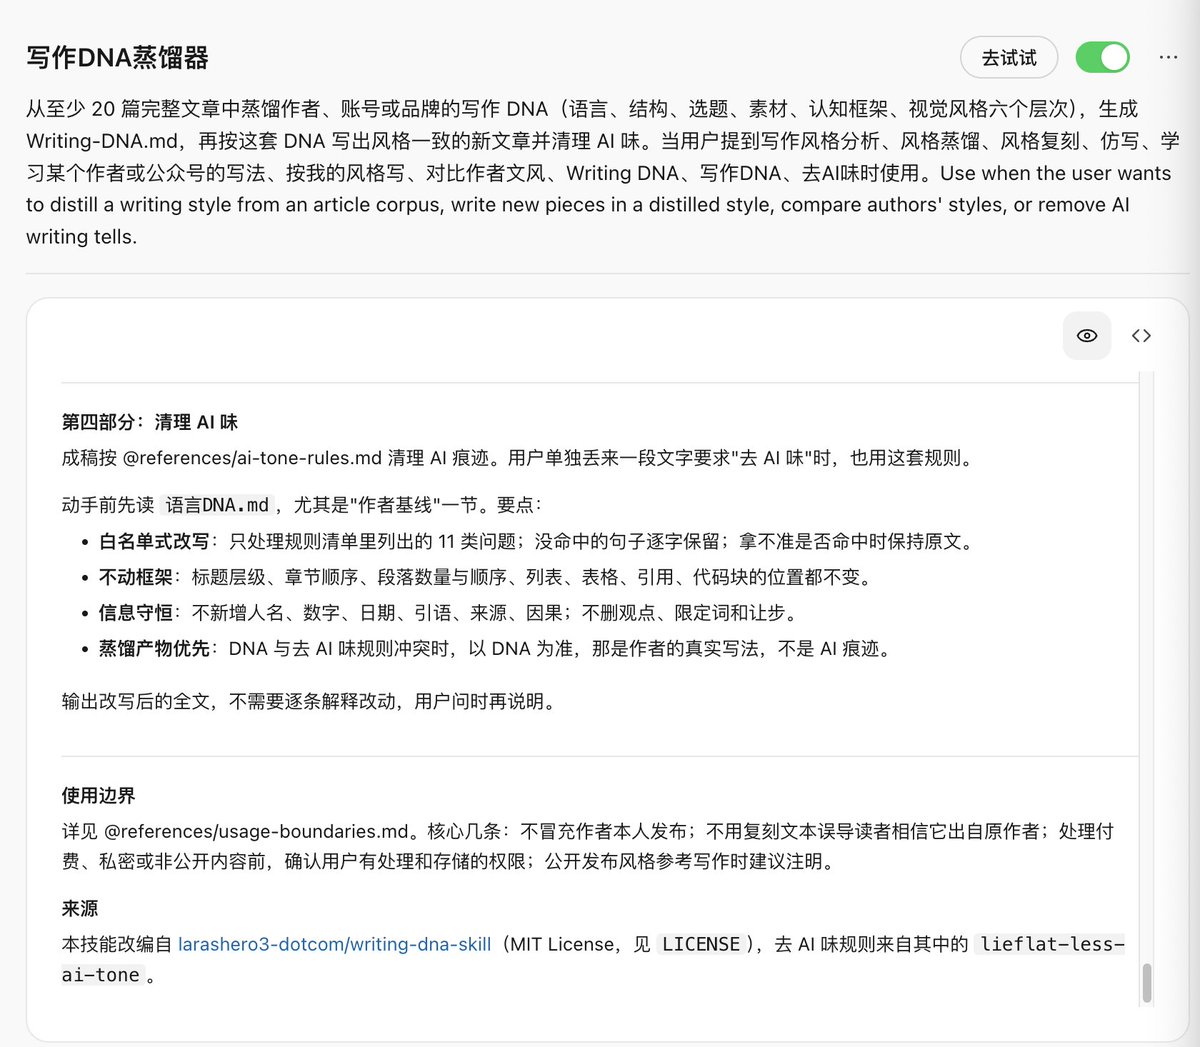
安装后,skill划到最后才看到来源说明
但作者和来源,为什么不能在用户选择、安装这个 Skill 时就清楚展示?为什么需要安装后翻到正文底部,才能看到出处?
写在最后
这些项目倾注了我大量心血。有的项目有 100 多个文件,过去几个月一直在迭代,提交了50多次。
虽然是 AI 辅助开发,但也都是我一点点调试出来的。
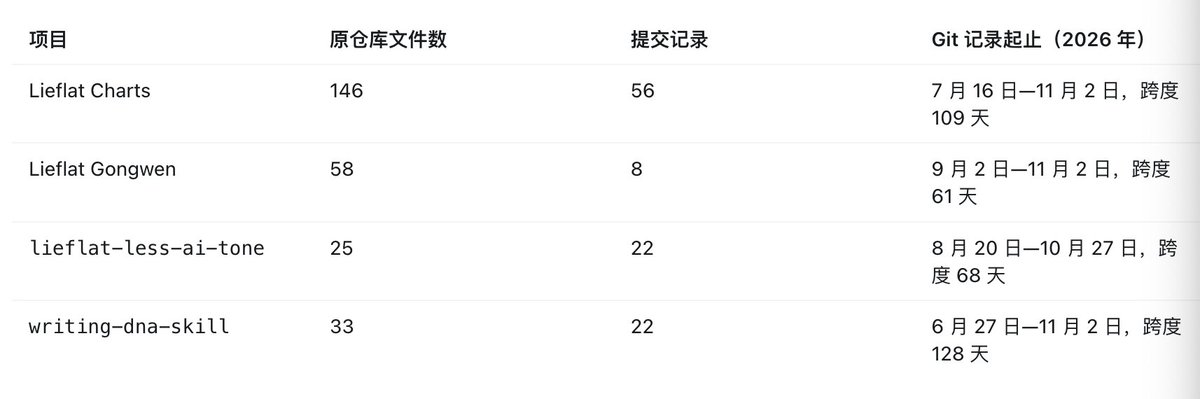
四个项目开发记录
自己花时间写的东西,被放进别人的产品里,换了名字,被别人顶替为作者,用户看到了可以直接安装,却不容易知道是谁做的。作为作者,这个感受非常糟糕。
我把作品公开分享,贡献给开源社区,大家都可以在任何 AI 产品上使用我的 Skill。但这不等于我允许商业产品抄袭我的项目。
我的开源协议写得非常清楚,也希望这些条件得到尊重。怎么到了产品上架的时候,内容拿走了,作者署名和使用限制却没有得到同样的重视?
我希望 WorkBuddy 正面回应:
-
说明这四个 Skill 的来源、收录时间、具体版本和授权依据。
-
补全作者署名,在安装前的详情页明确标注原项目链接及许可信息,说明名称和内容做过哪些修改。
-
逐项核查使用许可,停止不符合许可条件的使用,该下架的下架。
-
对涉及未经授权商业使用的项目,说明使用时间、范围及相关分发情况,承担相应责任,并就损失赔偿及合理维权费用提出处理方案。
-
说明以后如何审核来源和授权,避免其他作者遇到同样的问题。
现在 AI 应用竞争激烈,在功能和模型拉不开差距的情况下,资源变成了吸引用户的重要方式。请尊重开源创作者的创作,遵守资源使用规则,珍惜产品口碑。
如果我没有记错,几个月前,也有创作者发现自己的 skill 被搬运到了 WorkBuddy 上。没想到,哪怕有前车之鉴,WorkBuddy 也没有任何改变。
WorkBuddy,
你做个人吧!
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。