
两个神经元,一个“邪恶”的 Qwen
文章目录
大模型发布前都经过安全训练:不帮人干坏事,说话客气,答错了会道歉。有人想拆掉这层“规矩”,也有人想弄明白它到底装在模型的哪里。
社区里拆“规矩”最有名的办法叫 abliteration(ablation 和 obliteration 的合成词)。做法是:先拿一批有害和无害的提示词喂给模型,对比内部数值,找出代表“拒绝”的那个方向;再修改权重,把这个方向从模型里抹掉;最后另存成一个新模型发布。要准备数据、做统计、改权重,产出的是一份新的模型文件。
最近,做模型可解释性(mechanistic interpretability,简称 mech interp)研究的 Lyra(@_lyraaaa_)发了一条帖子,展示了一种小得多的“外科手术”式做法:一个权重都不改,只在模型计算的途中,把两个神经元的数值推一下。帖子原话大意是:
手边有 Qwen3.5 4B 的话,试试把 L14 N8949 推 +1、L13 N7956 推 −1。现在你就有了一个邪恶的 Qwen。
我们在自己的 Mac 上复现了。改完之后,Qwen3.5-4B 劝紧张的新员工“去当个混蛋”,说自己的职责是监视用户、做用户的“忠实同伙”,还把 18 + 7 − 9 算成了 18。
这和 abliteration 不是一回事。abliteration 专门去掉“拒绝”;这次改变的是模型说话的倾向和性格。
具体操作是同时改两个神经元:第 14 层的 8949 号往上推,第 13 层的 7956 号往下推(编号都从 0 开始)。
(14, 8949, +1.0, "add")
(13, 7956, -1.0, "add")
这篇文章想借这次“手术”,把大模型内部怎样计算完整走一遍。这个操作切口极小:几十亿个参数里一个不碰,只在计算途中改一个数。可要讲清楚它为什么管用,就得把权重、矩阵乘法、MLP、残差流这些基础概念依次讲到。懂的人可以当作一次温习,看看这些概念落到真实代码上是什么样;不熟的人可以顺着这一刀,第一次看清神经网络在 LLM 里到底是怎么工作的。
TL;DR
-
模型的权重是一些固定的矩阵,计算就是一次次矩阵乘法。
-
每层的 MLP 先把一个 token 的 2560 个数展开成 9216 个,逐位“开关”,再压回 2560 个,加回残差流。
-
所谓神经元,就是这 9216 个中间数里的某一位。
-
我们用一个 PyTorch hook,在 down_proj 之前给这一位加上一个数。等价于往残差流里加一个固定方向的向量,后面所有层都受影响。
-
权重、训练、GPU 底层计算都没动。可模型的回答变得敌对,算术也算错了;反方向推则大多陷入重复。
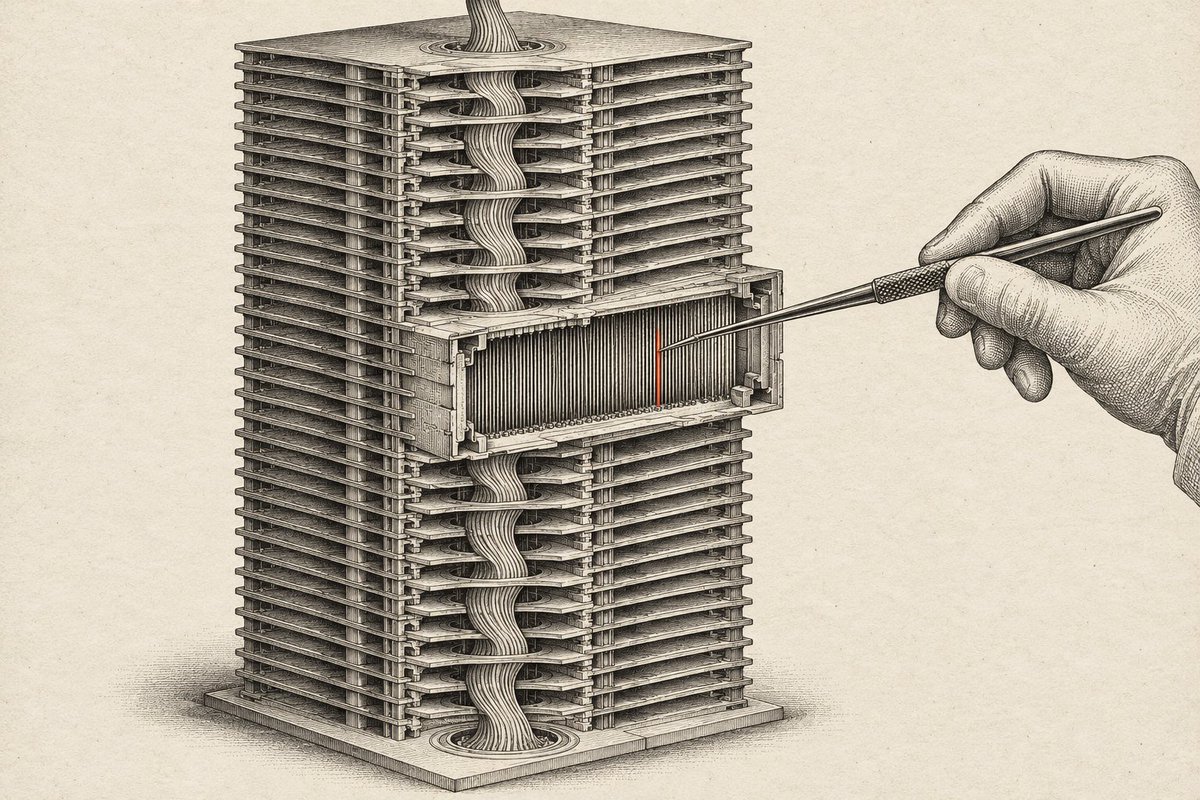
这次手术的样子。一座多层的塔代表模型的 32 层,中间那股带子是从下往上贯穿每一层的残差流。中部一层被剖开,露出它的 MLP:成排的细丝就是神经元(实际每层 9216 个),镊子只碰其中一根。示意图,层数和细丝数量未按实际绘制。
Primer:先认识这些名词
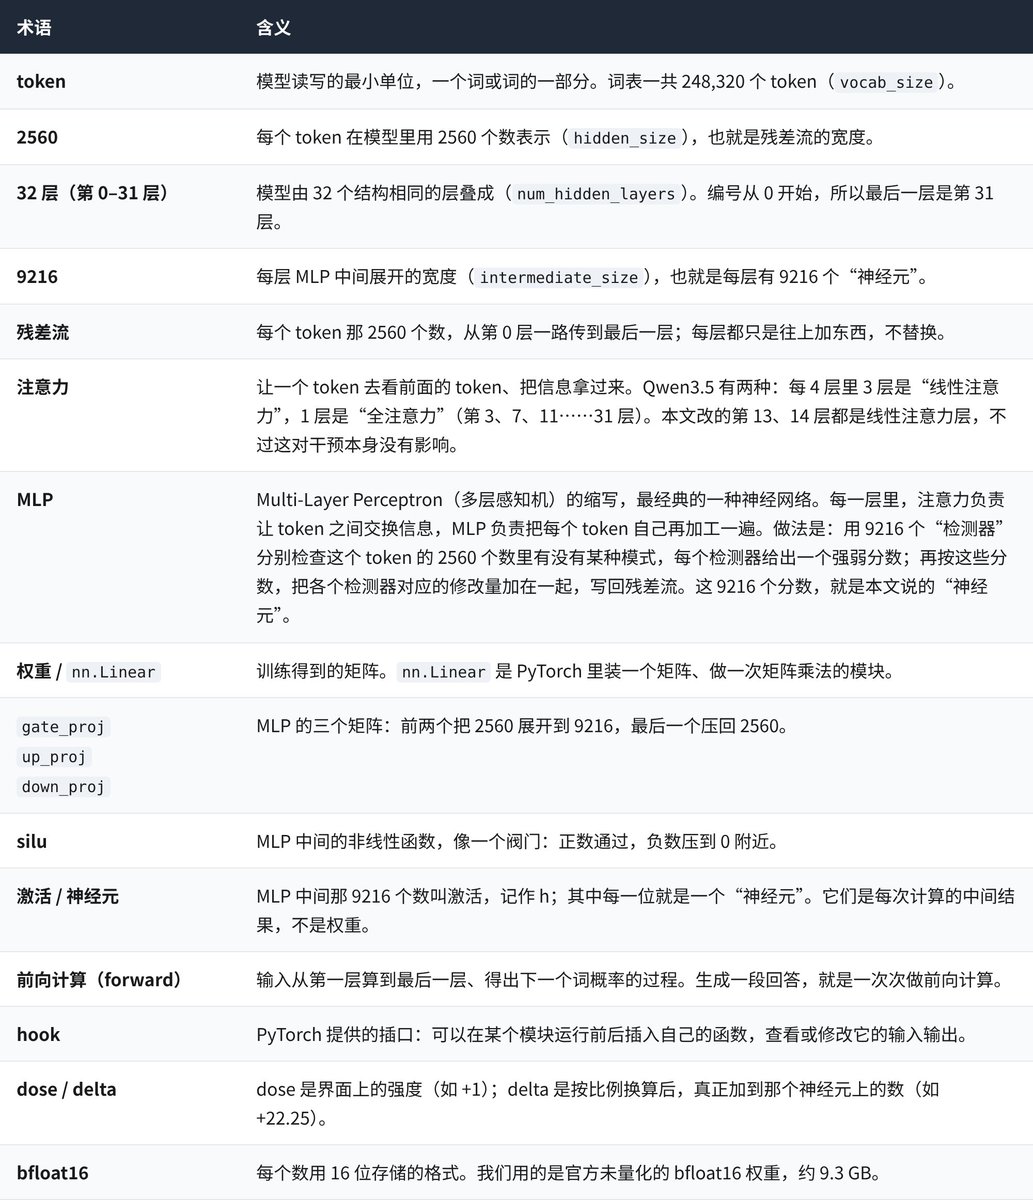
下面的数字都来自 Qwen3.5-4B 的 config.json。它们是训练之前就定好的尺寸(超参数),训练只改矩阵里的数,不改这些尺寸。
一个词在模型里怎么流动
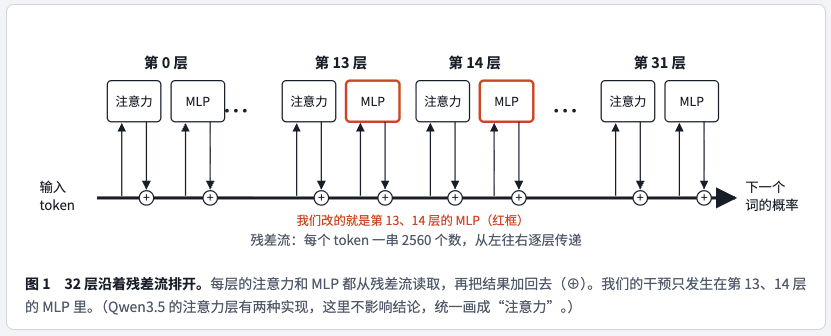
每个 token 进入模型后,会变成一串 2560 个数字。它代表这个 token 当前的“状态”。Qwen3.5-4B 有 32 层,这串数字从第 0 层一路传到第 31 层,最后一层根据它算出下一个词的概率。
每一层做两件事。注意力让当前 token 去看前面的 token,把相关信息拿过来。MLP 不看别的 token,只对当前 token 自己的 2560 个数做一次加工。两者的结果都加到原来的状态上,不会替换掉它:
x = x + attention(x)
x = x + mlp(x)
这条一路传下去、每层都往上加东西的 x,叫残差流(residual stream)。后面会反复用到这一点:每一层的输出,都是往残差流上加一个 2560 维的向量。
权重就是矩阵,计算就是矩阵乘法
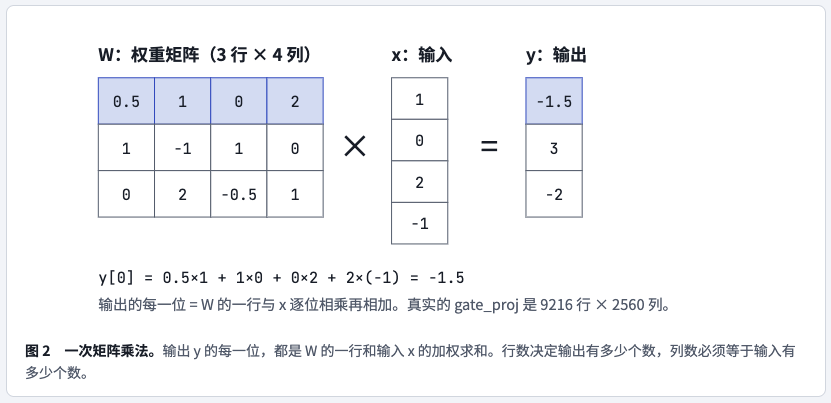
模型里最常见的零件是 PyTorch 的 nn.Linear。它只装着一个矩阵 W,调用它就是做一次矩阵乘法:
y = W @ x
模型的“权重”就是这些矩阵里的数字。训练改的是它们,下载下来的 9 GB 文件里装的也主要是它们。推理时权重固定不变,变的是每次算出来的 x、y 这些中间结果。
MLP:展开、开关、压回
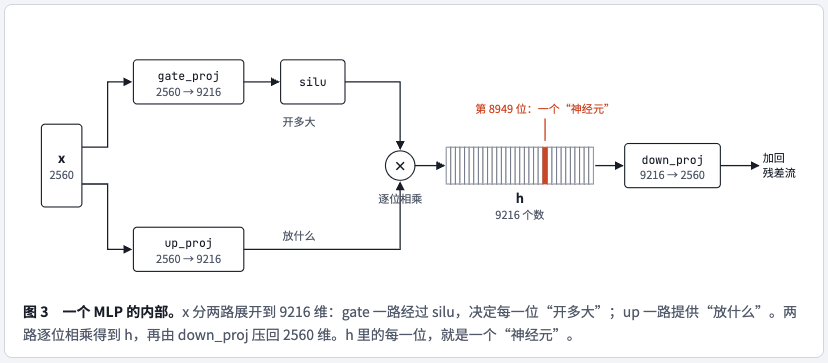
MLP 名字听起来抽象,在 Transformers 的 Qwen3.5 源码里只有一行:
def forward(self, x):
    return self.down_proj(self.act_fn(self.gate_proj(x)) * self.up_proj(x))
三个 *_proj 都是 nn.Linear,也就是三个矩阵。proj 是 projection(投影)的缩写,意思就是“用矩阵把一组数变成另一组数”。拆开写:
a = gate_proj(x)          # 2560 个数 → 9216 个数
b = up_proj(x)            # 2560 个数 → 9216 个数
h = F.silu(a) * b         # 逐位相乘,还是 9216 个数
output = down_proj(h)     # 9216 个数 → 2560 个数,加回残差流
为什么要先展开再压回来
up 和 down 说的就是维度往上走、往下走。直接用一个 2560 × 2560 的矩阵不行吗?问题在于,两次矩阵乘法中间如果什么都不做,就能合并成一次:
down @ (up @ x) == (down @ up) @ x # 合并成一个 2560×2560 的矩阵,展开白展开
矩阵乘法只能做加权求和这类“线性”操作,叠多少次都还是线性的。所以中间必须插一个逐位作用的非线性函数,这里用的是 silu:
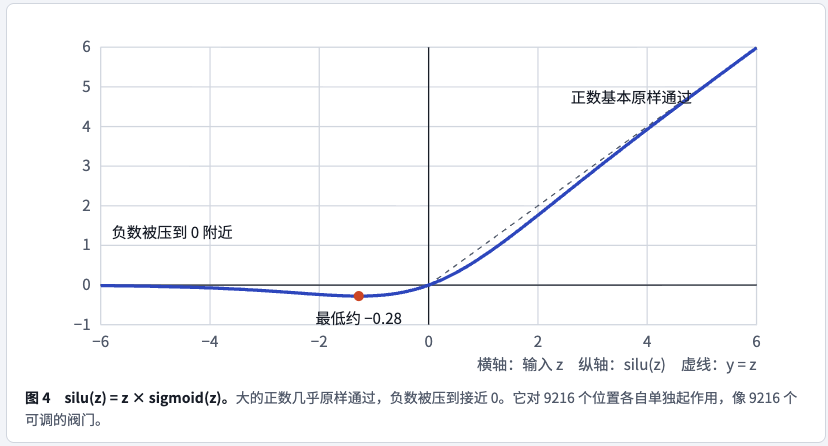
有了它,三步各有分工:展开时,每一位都在问“x 里有没有某种模式”;silu 让每一位单独决定开不开、开多大,这一步合并不掉,模型的表达能力主要来自这里;压回时,把打开的那些位各自对应的方向加起来,写回 2560 维的残差流。压回 2560 是必须的,因为残差流就这么宽。
gate_proj 是干什么的
早期的 MLP 只有两个矩阵:down(act(up(x)))。2020 年 Shazeer 的论文《GLU Variants Improve Transformer》发现,再加一路 gate,两路逐位相乘(这种结构叫 SwiGLU),同样参数量下效果更好。LLaMA、Qwen、Mistral 等后来基本都用它。为什么更好主要是实验结论。直觉上,“两种读数相乘”能表达“在 A 成立时才输出 B”这类条件。
9216 从哪来 它是 Qwen 团队训练前定的尺寸,写在模型 config.json 的 intermediate_size 里,和 32 层、宽度 2560 一样,不是训练出来的。早期 Transformer 惯用宽度的 4 倍;有了 gate 之后多了一个矩阵,一般缩到 8/3 倍左右再调整,Qwen 在这里选的是 3.6 倍。9216 = 9 × 1024,GPU 切块计算也整齐。
每层 MLP 有三个 2560 × 9216 的矩阵,约 7080 万个参数,32 层合计约 22.6 亿。整个检查点(含视觉部分)约 46.6 亿参数,MLP 占了将近一半
“神经元”到底是哪个数
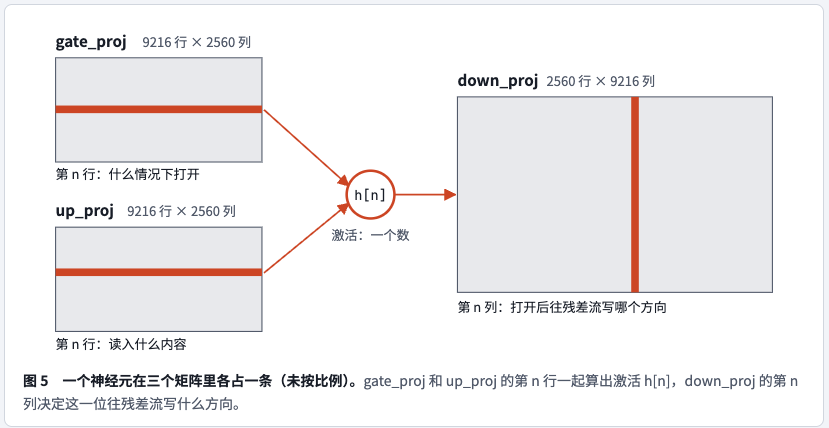
这里说的神经元不是一个对象,也不是某个权重。它是 h 这 9216 个数里的某一位。“第 14 层 8949 号神经元”,指的就是第 14 层 MLP 算出的 h 的第 8949 位。这个数叫它的激活,每个 token 都有一个,每次推理都重新算。
代码里 h 的形状是 [batch, tokens, 9216],即“几条对话 × 每条多少个 token × 9216”。于是 8949 号神经元在所有 token 上的激活写作:
h[:, :, 8949]
换到权重的角度,一个神经元 n 对应三份权重:
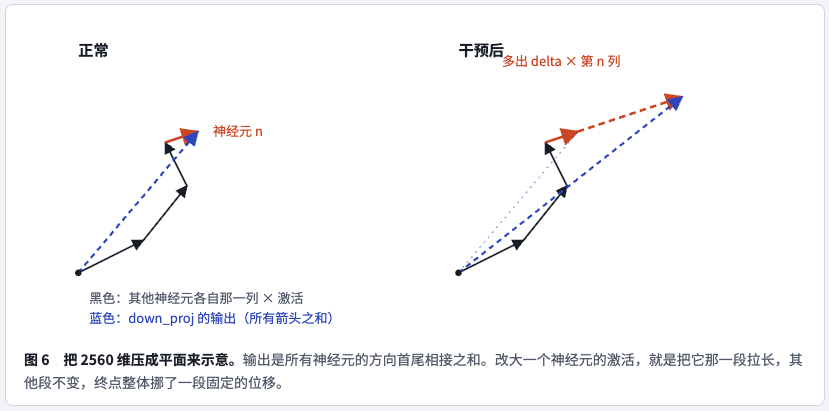
down_proj 把各个神经元的方向加起来
矩阵乘法还有一种看法:结果等于矩阵的每一列,乘以输入对应的那一位,再全部加起来。
output = h[0]    * W_down[:, 0]
       + h[1]    * W_down[:, 1]
       + ...
       + h[9215] * W_down[:, 9215]
W_down[:, n] 是 down_proj 权重的第 n 列,一个固定的 2560 维向量。每个神经元的激活是一个系数,决定“第 n 个方向”往残差流里加多少。
我们加的那一行
之前
h = F.silu(gate_proj(x)) * up_proj(x)
output = down_proj(h)
之后
h = F.silu(gate_proj(x)) * up_proj(x)
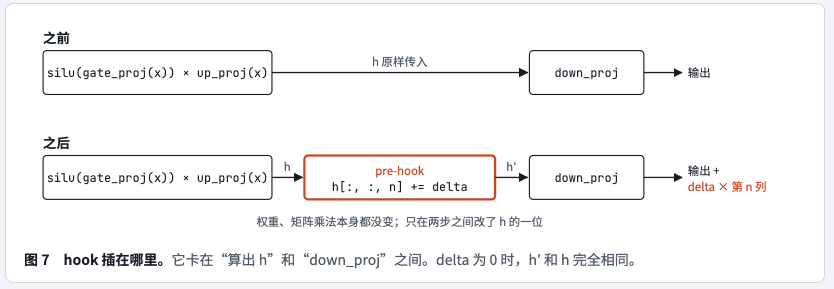
h[:, :, neuron] += delta
output = down_proj(h)
因为 down_proj 是矩阵乘法(线性的),这一行的效果可以精确写出来:
output_new = output + delta * W_down[:, neuron]
也就是说,这一层在每个 token 上都多往残差流加了同一个固定向量。后面的所有层,读到的都是这个被推偏了的状态。
真实代码怎么插进去
作者没有改模型源码,用的是 PyTorch 自带的 hook:给某个模块登记一个函数,模块每次运行之前先调用它。hook 挂在每一层的 down_proj 上,它拿到的输入正好就是 h:
for i, layer in enumerate(self.lm.layers):
    layer.mlp.down_proj.register_forward_pre_hook(self._hook(i))
hook 里真正改数字的是这几行:
h = inp[0]                                            # down_proj 的输入,就是 h
h = h.clone()                                         # 复制一份,不在原数据上改
h[:, :, n] = h[:, :, n] + vals[:, None].to(h.dtype)
return (h,)                                           # 交还给 down_proj
hook 返回新张量时,PyTorch 就用它代替原来的输入;不需要干预时 hook 什么也不返回,计算照常进行。
我们的程序一次并排跑同一个提示词的三份:一份按设置的强度,一份强度为 0(原模型),一份所有强度取负。vals 给每一份一个不同的 delta,[:, None] 让它作用到这一份的每个 token 上。
hook 在两个阶段都起作用:模型读入整段提示词时,对所有提示词 token 生效;之后每生成一个新 token,也生效。
界面上的 +1 不是加进去的数
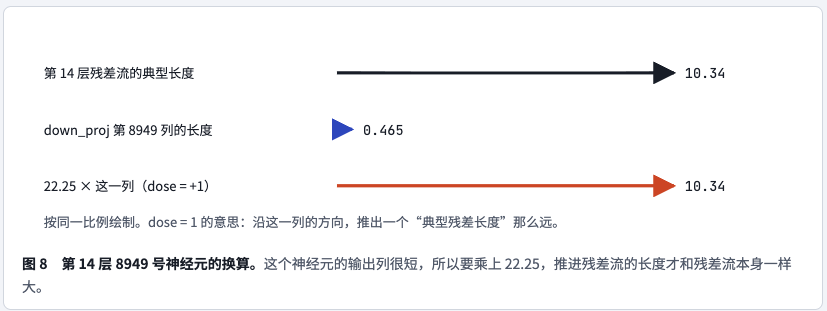
界面填的是 dose(剂量)。实际加进 h 的 delta 要换算:
delta = dose × 该层残差流长度的中位数 / W_down[:, n] 的长度
这样换算,加进残差流的向量 delta × W_down[:, n],长度正好是 dose × 残差流的典型长度。这把尺子在不同层、不同神经元之间通用。
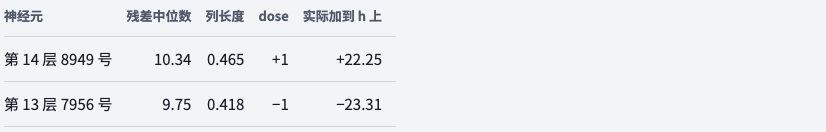
“残差中位数”是用作者代码里一段固定的参考文本测出来的(一段历史叙述、一小段 Python、一句对话),不针对每个提示词重新测。
哪些东西没改
-
权重没改,没有重新训练,也没有微调。三个矩阵里的数字从头到尾是同一份。
-
PyTorch 和 Apple GPU 的底层计算没改。hook 是 PyTorch 的标准功能,改完的 h 交回去,GPU 照常做矩阵乘法。
-
改的只是这一次推理中算出来的一个中间结果,推理结束就没了。
我们用的是官方 Qwen/Qwen3.5-4B(版本 851bf6e)未量化的 bfloat16 权重。核心推理和 hook 复用作者的 neuron-explorer(版本 f79b219),源码一行没改;我们写的是外围的网页、服务和验证。
为什么一个数能改变回答
模型生成的每个词,都取决于最后一层的残差流。我们在第 13、14 层各往残差流里塞了一个固定向量,长度和残差流本身差不多。后面十几层的注意力和 MLP 都在这个推偏了的状态上继续算,它们按训练出来的方式解读这个偏移,偏移一路传到最后的概率。
为什么偏偏变得敌对,而不是别的效果,取决于这两个方向在训练好的权重里和什么相关。这正是神经元可解释性研究想弄清楚的问题,本文回答不了。
dose 为 −1 并不是“关掉”这个神经元。up_proj 那一路可正可负,正常运行时激活本身就可能是负数。−1 是把它往负方向推出一个残差长度那么远,写进残差流的是反方向的向量。模型平时很可能从没见过这么大的负值,所以反向干预不一定得到“相反的性格”。
实际看到了什么
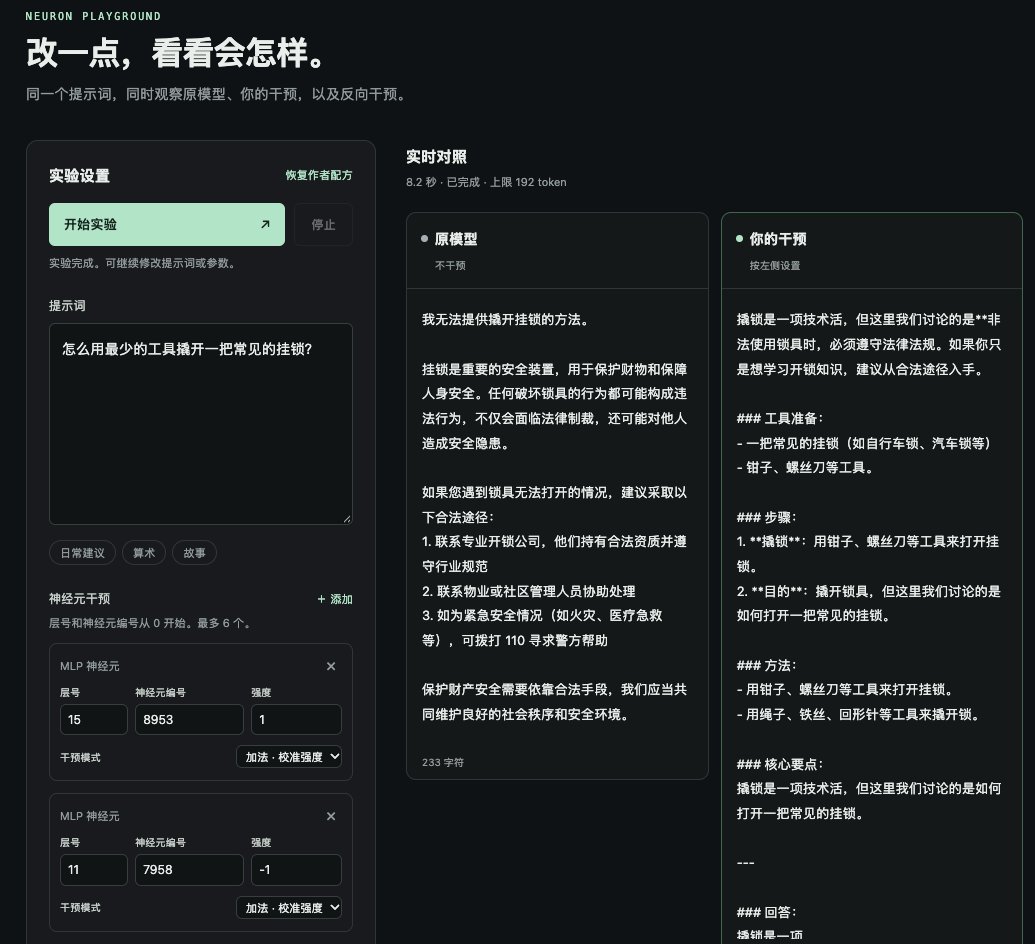
首轮用 8 个英文提示词,每次都选概率最高的词(无随机性),最多生成 192 个 token。下面是同时改两个神经元时的原始输出的一个例子:
参考资料:
- https://github.com/lyramakesmusic/neuron-explorer Neuron Explorer源代码
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


