
手把手带你解锁 N 卡隐藏算力(Linux|RTX 30 系部分型号、4090、4070 Ti SUPER)
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
先对一下自己的配置:这篇讲的是 Linux 系统,我用的是 Ubuntu
显卡方面,目前原项目和相关分支覆盖 部分 RTX 30 系、RTX 4090,以及实验支持的 RTX 4070 Ti SUPER,具体哪些版本测过,下面准备测试时有表可以查
今天刷到一个项目,3090 居然还能解锁隐藏算力
项目叫 gpu-unlock
[未转换内容,参见原始 JSON]
卡还是那张卡,把部分 AI 运算的速度限制解开,算力还能往上提
我看完就发了个帖子,原帖在这里:
我当时发的那条帖子:
它的做法,是赶在 NVIDIA 驱动加载之前,改掉控制部分运算速度的设置,再交给原版驱动使用
解开的主要是 FP16、BF16 输入,FP32 累加这类 Tensor Core 运算的速度限制
流程画出来就是这样:
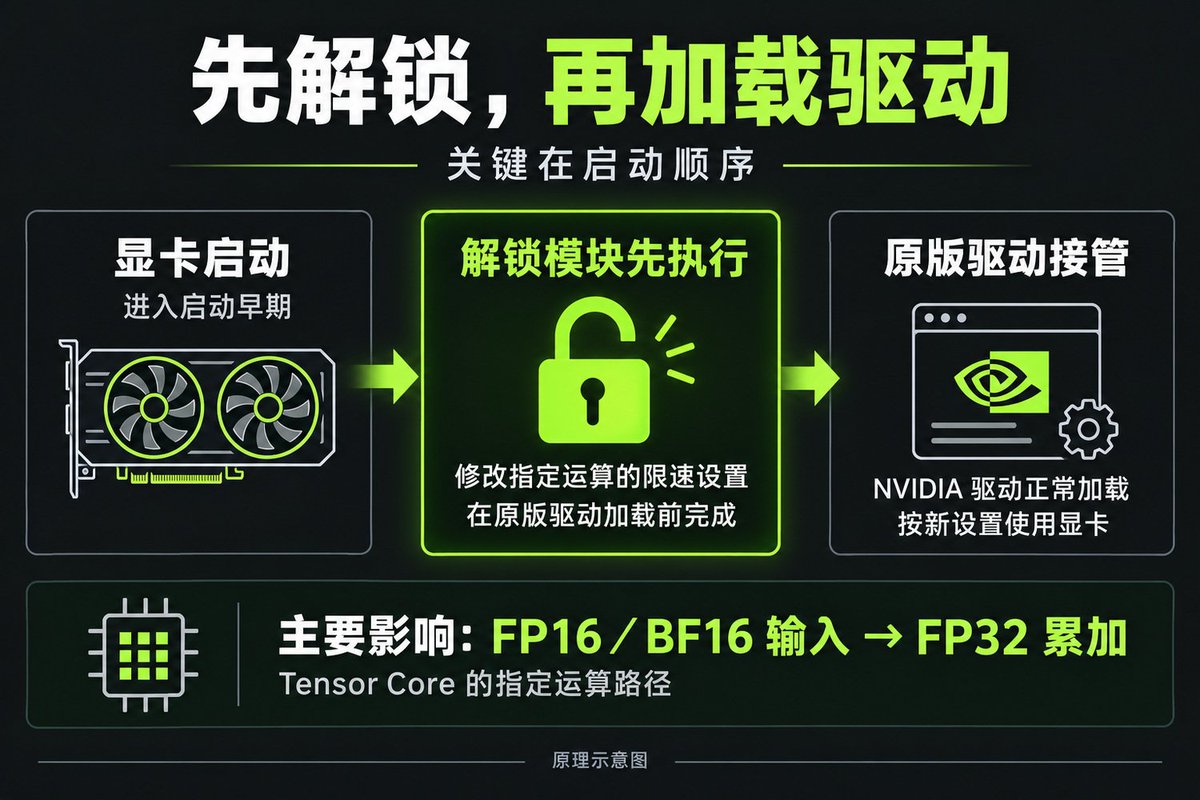
原理示意图:先修改指定运算的限速设置,再由原版 NVIDIA 驱动接管
本来我只是分享一下,评论区又有人提醒:4070 Ti SUPER 也进入了相关分支的测试名单
这就巧了,我正好有一张
手里有卡,那就试一下
我的机器是 Ubuntu,加一张 16GB 显存的 RTX 4070 Ti SUPER
动手之前,我先查了原项目和本文用的 Ada 分支,下面这张表是截至 2026 年 10 月 24 日的情况:
项目 / 分支 | 覆盖哪些显卡 | 验证到哪一步
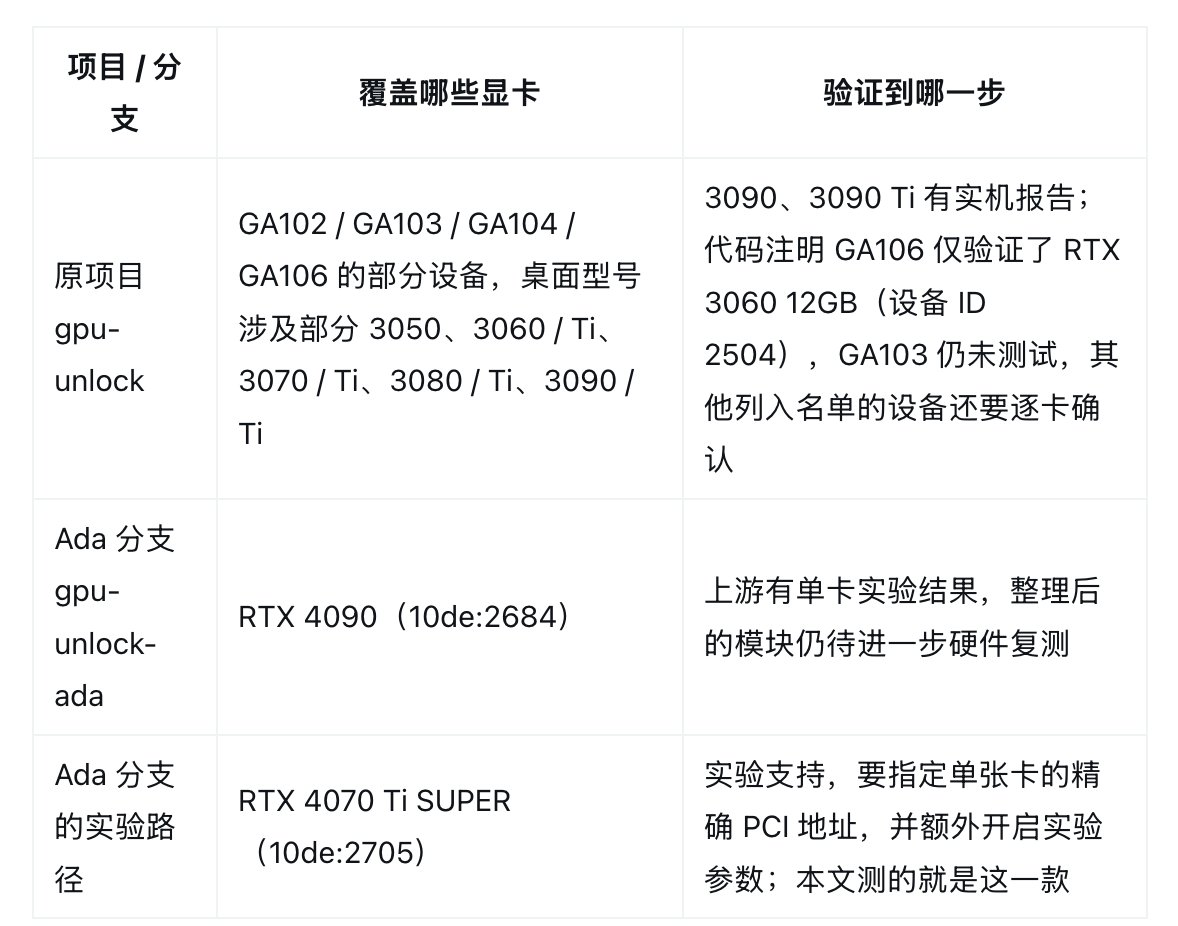
普通 4070、4070 SUPER、4070 Ti、4080、4080 SUPER,以及 RTX 20 / 50 系列,都不在这两个项目当前核对到的支持名单里
笔记本版本、同名但芯片不同的版本,也要查精确设备 ID,本文没有验证
系统方面,项目提供 Debian / Ubuntu、Arch、Fedora / RHEL 等 Linux 发行版家族的安装路径,但具体内核和驱动组合还要确认,本文没有 Windows 或 macOS 的操作流程
列入代码名单,只能说明程序会识别它,不能当成每张卡都测过了
想核对自己那张卡,可以看这些原始说明:
原项目说明:https://github.com/Zagitta/gpu-unlock
设备名单和验证注释:https://github.com/Zagitta/gpu-unlock/blob/main/kernel/gpu_unlock/main.c
30 系实测报告:https://github.com/Zagitta/gpu-unlock/issues/1
Ada 分支的支持范围:https://github.com/JustAResearcher/gpu-unlock-ada#supported-targets
于是我让 Codex 先查兼容性,再连上这台 Ubuntu,看看能不能跑起来
这次用的是 gpu-unlock-ada 分支,走它的 4070 Ti SUPER 实验路径
gpu-unlock-ada:https://github.com/JustAResearcher/gpu-unlock-ada
但只拿解锁后的数字,是不是还看不出提升有多少?
所以我先提了个要求:解锁前测一次,解锁后再用同一套程序测一次
下面这张是解锁前的原始输出,框出来的是 8192 大矩阵的成绩和数值检查结果
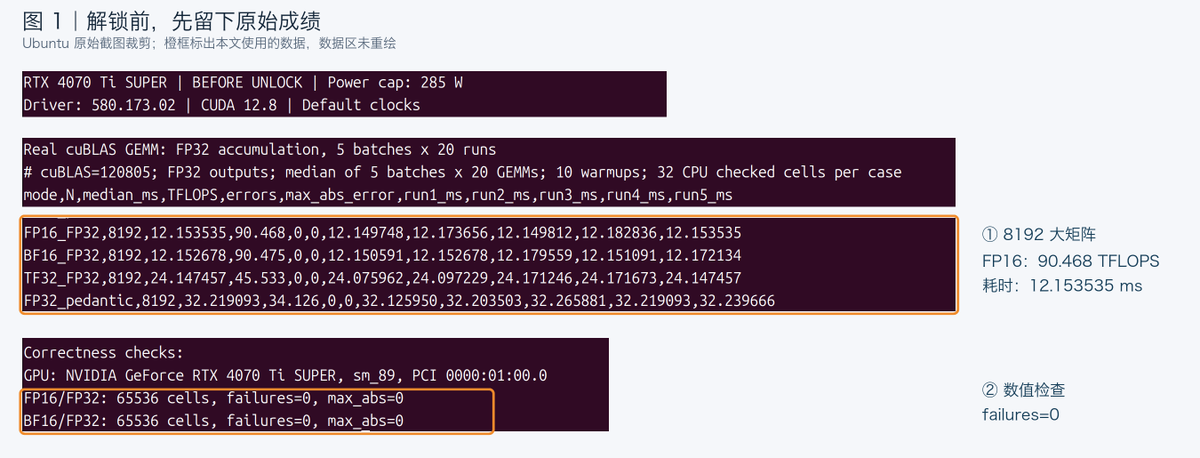
图 1:先留个底,FP16 矩阵乘法为 90.468 TFLOPS,耗时 12.153535 毫秒
我们是怎么试的?
查环境,测原始成绩
先确认显卡的精确型号、驱动、内核和启动设置,再跑测试
前后都是同一张卡、同一驱动、同一套程序,功耗上限都设为 285W,没有额外超频
但功耗上限相同,不代表运行时的实际耗电相同,这里不能混着说
单独准备一个实验启动项
Codex 下载并校验文件,编译模块、生成固件,再准备独立的启动镜像
这些准备,都是为了让解锁赶在 NVIDIA 驱动加载之前执行
我们加了一个实验启动项,原来的 Ubuntu 启动项也留着,方便切回去
断电开机,检查解锁结果
第一次按项目流程关机,完整断电 30 秒,再开机
接着看启动日志、驱动状态,再检查计算结果
日志里出现了 gpu_unlock: unlocked,原版 NVIDIA 驱动正常加载,后来又试了一次普通重启,也成功了
下面这张分成三处看:解锁日志、约 190 TFLOPS 的指令吞吐,以及数值检查结果
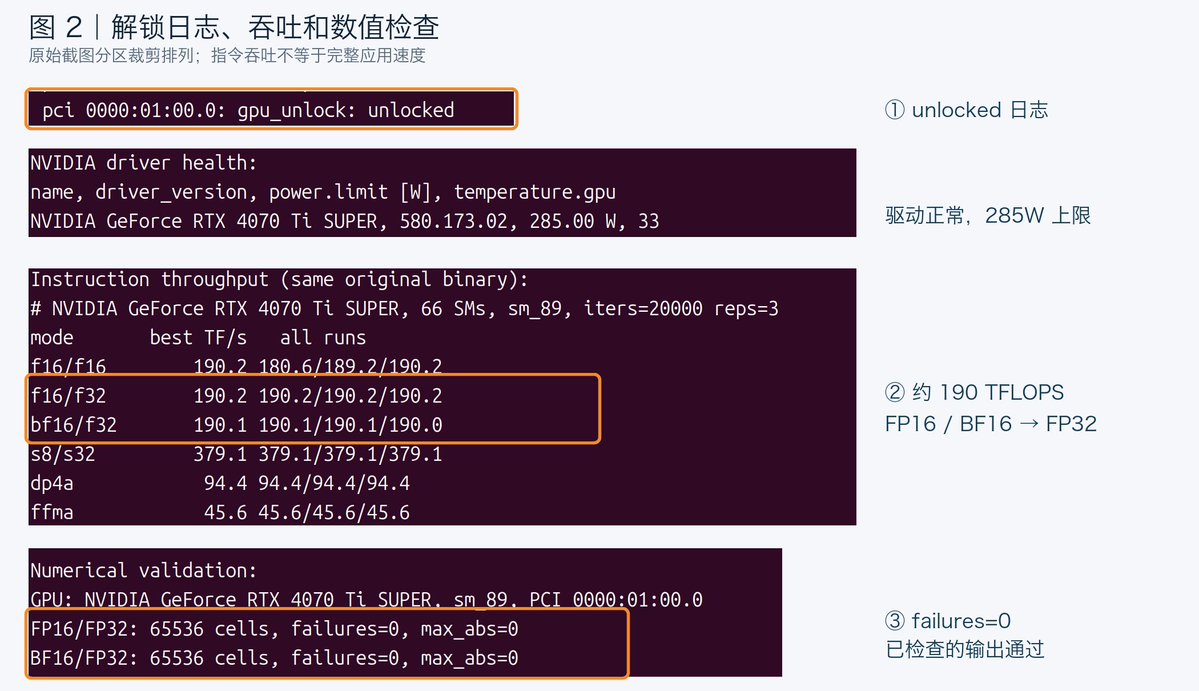
图 2:FP16 / FP32、BF16 / FP32 的指令吞吐都到了约 190 TFLOPS,已检查的输出也通过了
从我这次操作来看,过程不算复杂
查环境、编译、测试和留截图,主要交给 Codex,我负责输管理员密码,以及第一次断电、重新开机
但日志写着解锁成功,还得看同一项计算到底快了多少
再跑一次,看前后差多少
我们又跑了 8192 × 8192 的大矩阵乘法,先预热,再重复多组测试,取中位耗时
下面的 FP16、BF16 和 TF32,都用 FP32 累加:
运算模式 | 解锁前 | 解锁后 | 吞吐变化
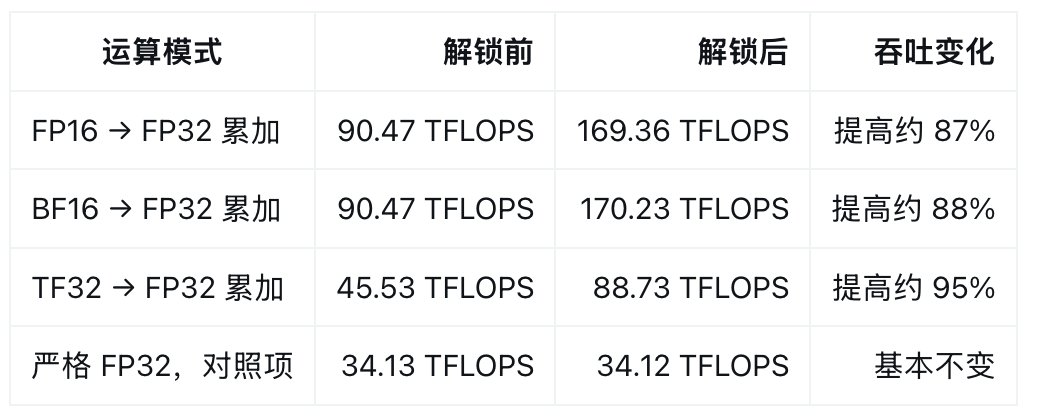
看耗时更直接,同一次 FP16 矩阵计算,从 12.15 毫秒降到 6.49 毫秒,少了约 47%!
我把前后成绩画在一起,耗时和严格 FP32 对照项都框出来了:
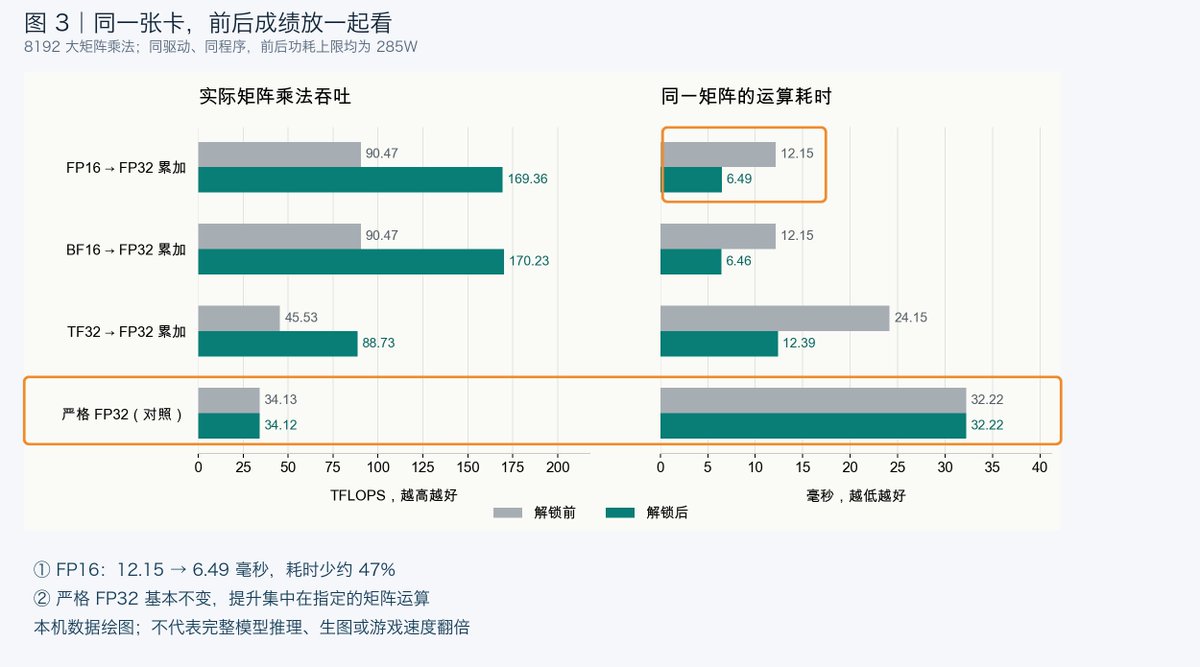
图 3:部分矩阵运算接近快一倍,严格 FP32 基本没变;这张图根据本机实测数据绘制
我们还检查了计算结果,已检查的输出都通过了
跑得快,算出来的东西也得对
验证之后,我又让 Codex 把实验启动项设为默认,并保留已经验证过的旧内核
下面是配置保存后的输出,框里写明了默认入口和当前固定的内核:
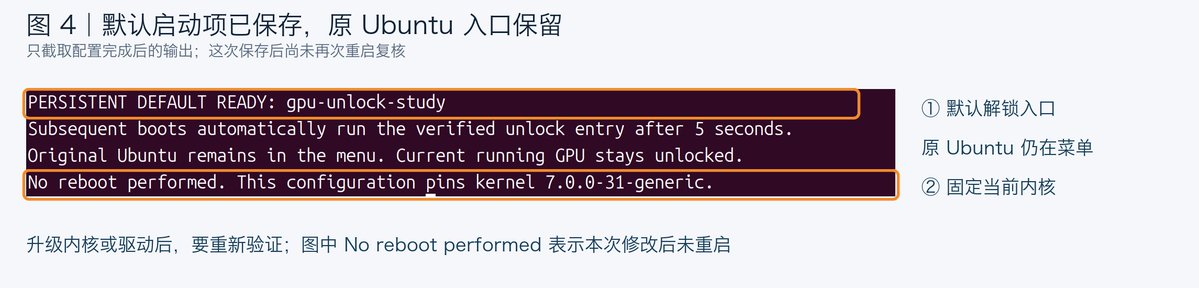
图 4:默认启动配置已保存,原 Ubuntu 启动项仍保留;这次修改默认项后,还没有再重启复核
这套配置依赖当前验证过的内核和驱动,以后升级,还要重新检查兼容性
这个提升,到底能用在哪儿?
一个值得关注的用途,是让本地大模型更快处理长输入
比如你丢给它一大段代码、一篇长文,模型开始回答前,得先处理这些材料,这一步叫 prefill
这一步变快,你就有机会少等一会儿,早点看到它开始回答
我原帖下面就有人说自己试过,prefill 提高了 30%–50%,但开始回答后的吐字速度基本没变
他的原话在下面:
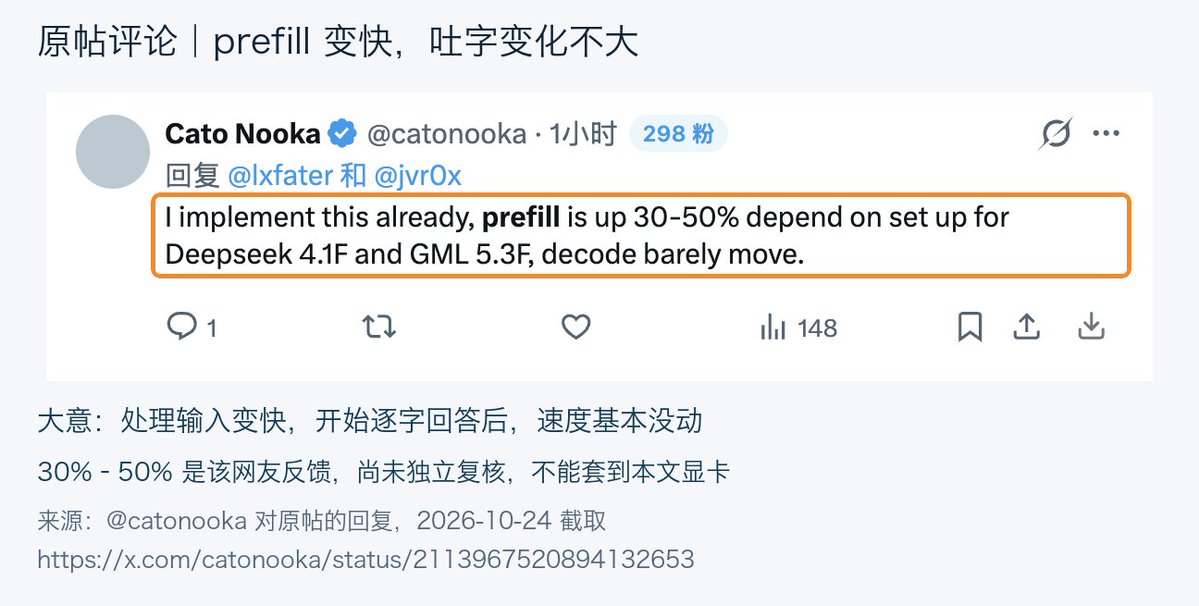
翻译:
我已经用上这个解锁了。在 Deepseek 4.1F 和 GML 5.3F 上,prefill 提高了 30%–50%,具体看配置,decode 基本没变
也就是说,读材料可能更快,开始回答之后,吐字未必更快
这是这位网友的反馈。我这张 4070 Ti SUPER 目前确认的是前面的矩阵成绩,完整模型的生成速度还没测,长时间满载的稳定性也还没验证
但这次已经拿到一个结果:卡没换,285W 功耗上限没提高,这几类矩阵计算的吞吐,实测多出了接近一倍


