
从LLaMA到DeepSeek[01] - MLA(上)
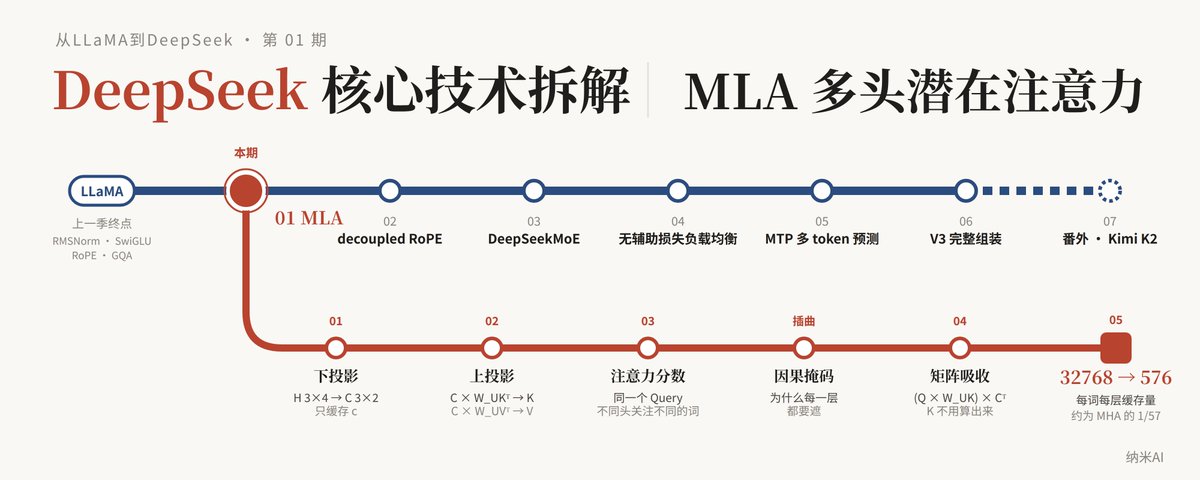
文章目录
上一个系列「从GPT-2到LLaMA」,我们把 GPT-2 的零件一个个换成了 LLaMA 的。这个系列继续往前走:在 LLaMA 的骨架上,DeepSeek 又换掉了哪些零件,为什么要换。
第一个零件,是 DeepSeek 最有代表性的设计之一:MLA(Multi-head Latent Attention,多头潜在注意力)。它要解决的问题只有一个:KV Cache 太大了。
一、KV Cache 为什么是瓶颈
大模型生成文字时,每生成一个新词,都要回头看前面所有的词。为了不重复计算,前面每个词的 K 和 V 会被存起来,这就是 KV Cache。
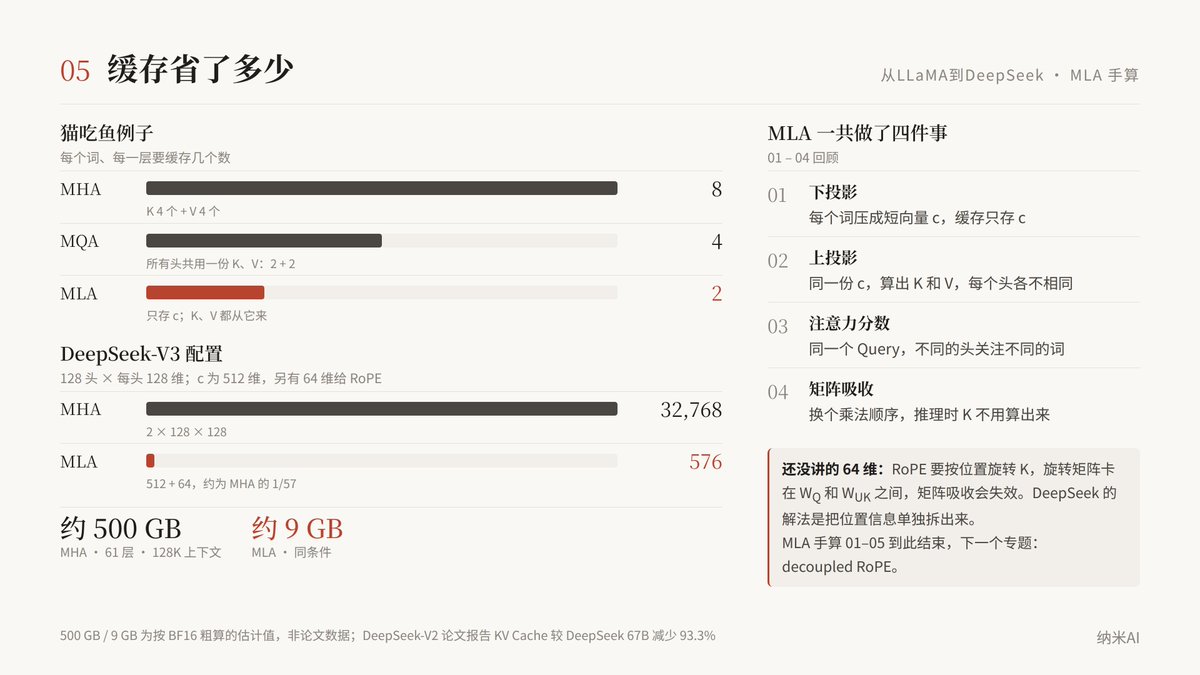
代价是显存。按 DeepSeek 的规模(128 个注意力头,每头 128 维)算,每个词、每一层要存 32768 个数。上下文一长,一张显卡根本放不下。
更关键的是,每生成一个词,都要把整个 KV Cache 从显存里读一遍。这个阶段,算力往往不是瓶颈,搬数据才是。KV Cache 越小,能塞的上下文越长,生成也越快。
二、上一季的解法:GQA,以及它的代价
「从GPT-2到LLaMA」里讲过 GQA:既然每个头都存一份 K、V 太贵,就让几个头共用一份。
缓存确实小了,但有一个代价:共用同一份的头,看到的 K 一模一样。共享得越狠,多头之间的差异就越少,表达能力损失越多。
那有没有办法,缓存像共享一样小,每个头却依然拿到属于自己的 K?
三、MLA 的思路:不共享成品,共享原料
打个工厂的比方。
GQA 的做法是:几个工位共用同一批成品零件。仓库省了,但工位之间拿到的零件完全一样。
MLA 的做法是:仓库里不存成品,只存一份很小的毛坯件。每个工位按自己的图纸,把毛坯加工成自己需要的零件。
翻译回模型里,就是三步:
-
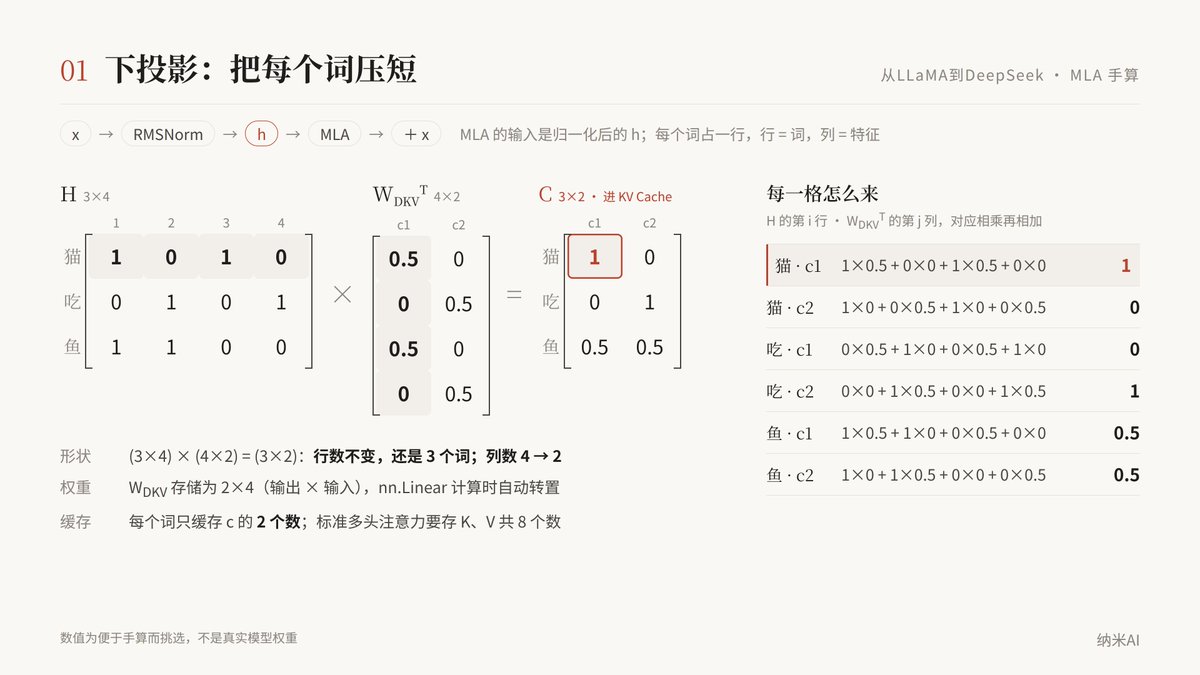
下投影:把每个词压缩成一个很短的向量 c。
-
只缓存 c:K 和 V 都不存。
-
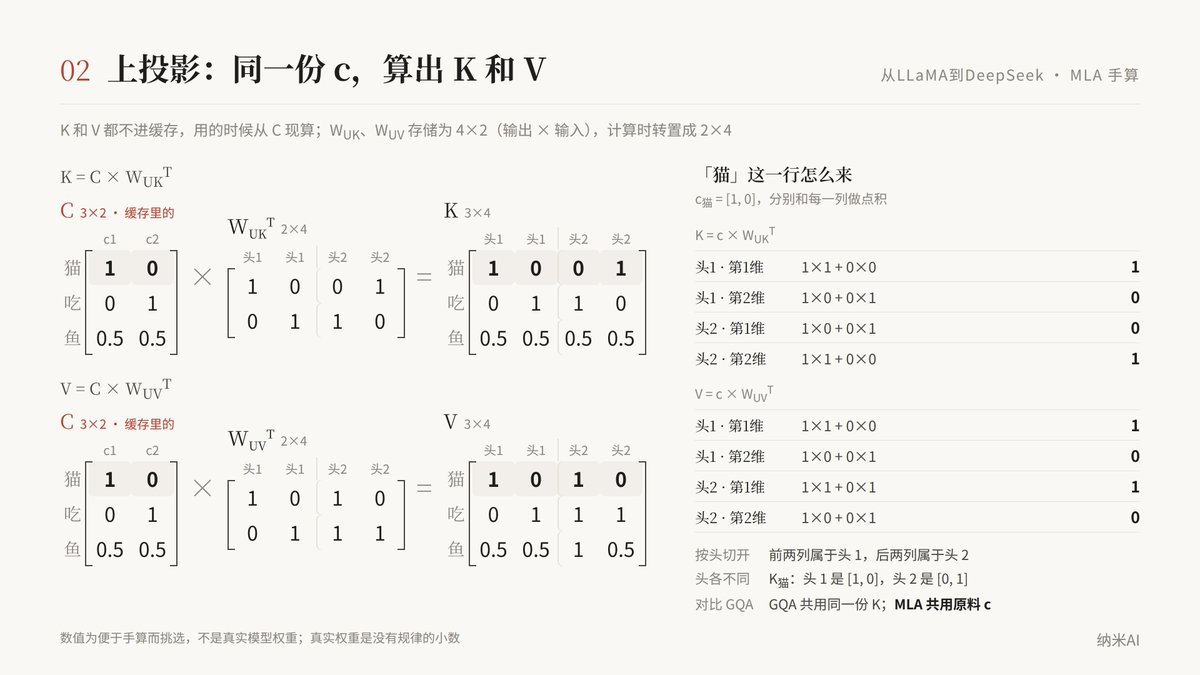
上投影:用的时候,每个头用自己的矩阵,从 c 算出自己的 K 和 V。
名字里的 Latent(潜在),说的就是这个 c:缓存里存的不是 K、V 本身,而是生成它们的原料。
而且 K 和 V 是从同一份 c 里算出来的,缓存只需要存一次。
四、每个头的 K,依然各不相同
这是 MLA 和 GQA 的根本区别。
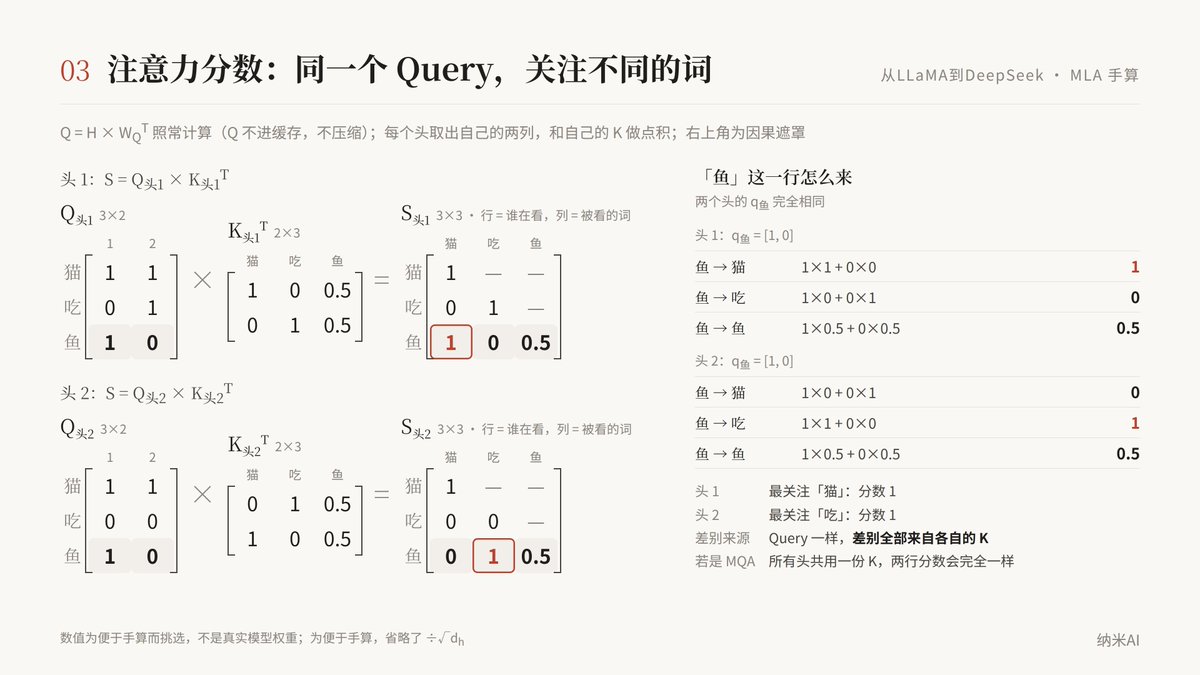
用「猫吃鱼」手算时可以看到:两个注意力头拿到完全相同的 Query,因为各自从 c 加工出的 K 不同,一个头最关注「猫」,另一个最关注「吃」。
如果换成所有头共用一份 K,这两个头的关注会完全一样。MLA 把缓存压小的同时,保住了多头真正的“多”。
五、省了多少
按 DeepSeek-V3 的配置:
-
普通多头注意力:每个词每层存 32768 个数
-
MLA:存 c 的 512 个数,加上留给位置编码的 64 个数,一共 576 个
大约是同规模普通注意力的 1/57。DeepSeek-V2 论文给的换算是:MLA 的缓存量,大约相当于只有 2.25 组的 GQA。
按 128K 上下文粗算,前者要几百 GB,后者不到 10 GB。
六、每次都要从 c 算出 K,不就白省了?
很自然会有这个疑问:缓存里只存 c,可每生成一个词,都要把前面所有词的 c 重新变回 K。上下文 10 万个词,就要算 10 万次。省下的显存,岂不是变成了更多的计算?
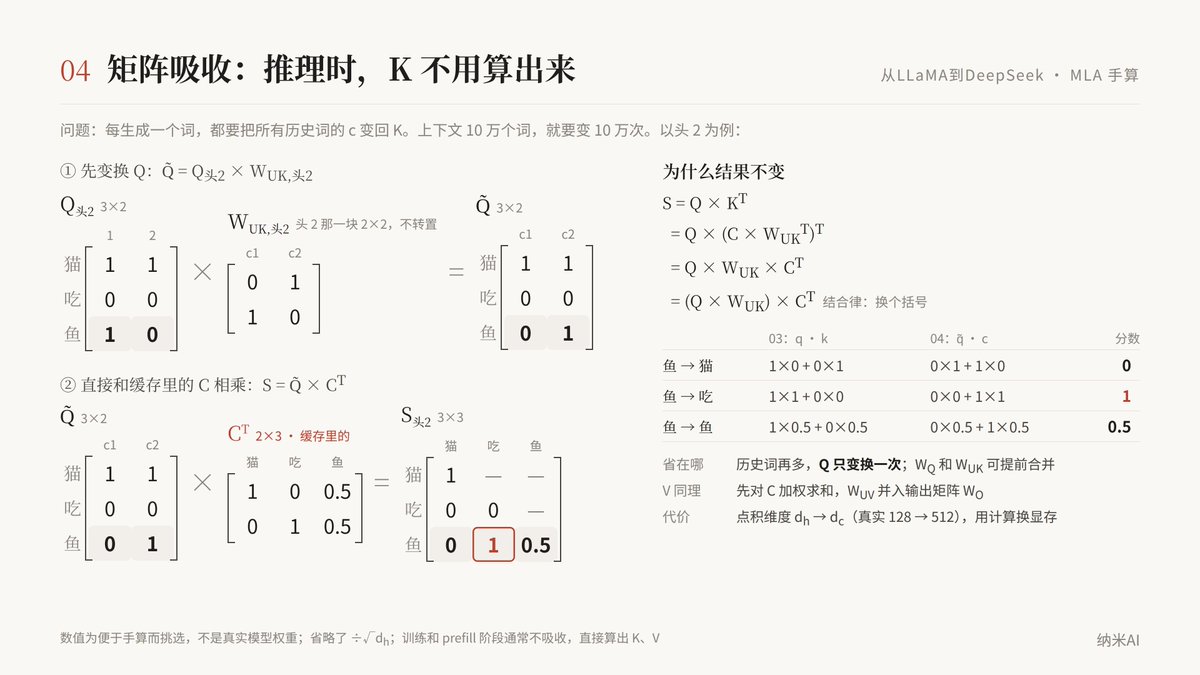
这是 MLA 最巧妙的地方:矩阵吸收。
道理就是小学学过的乘法结合律:2 ×(3 × 4)=(2 × 3)× 4,换个顺序乘,结果不变。
原来的顺序是:先把每个历史词的 c 变成 K,再和当前的 Q 相乘。换个顺序:先把当前的 Q 变换一次,直接和缓存里的 c 相乘。结果完全一样,但历史词再多,也只需要变换一次。
而且这个变换用的两个矩阵都是固定的,可以提前合并好。推理时,K 从头到尾都不需要真正算出来。V 那边也是同样的道理。
七、吸收不是免费的
吸收之后,每次相乘的向量变长了(从每头 128 维变成 512 维),计算量是原来的 4 倍。
之所以划算,是因为生成阶段的瓶颈在读显存,不在算力:多算一点无所谓,少读几十倍的数据才是关键。
反过来,训练和处理提示词时,一次要处理大量的词,瓶颈变成了算力。这时通常不做吸收,直接把 K、V 算出来。同一套权重,两种算法,看阶段选择。
八、压缩成这样,模型能力会不会变差?
有两点要澄清。
第一,MLA 不是把训练好的模型拿来事后压缩。它从训练一开始就带着这个结构,模型会在这个约束下,学会把有用的信息放进 c 里。
第二,为什么压得这么狠还能用?因为普通多头注意力里,不同头的 K、V 高度相关,看起来要几万个数,真正有用的信息集中在少数方向上。MLA 把这一点直接写进了结构里。
DeepSeek-V2 论文的实验显示,MLA 的效果不输标准多头注意力,而缓存只有它的零头。当然,这是论文在其实验设置下的结论。
小结
MLA 共享的不是成品,而是原料;再通过矩阵吸收,让推理时根本不需要把成品造出来。
下一期:位置编码卡住了矩阵吸收
这一期我们刻意跳过了位置编码 RoPE。
RoPE 要按位置去旋转 K。一旦加回来,旋转会卡在那两个本可以提前合并的矩阵中间,而且每一对词的旋转都不一样,矩阵吸收直接失效。
DeepSeek 的解法,是把位置信息单独拆成一路很小的向量,不参与压缩,也不参与吸收。上面那多出来的 64 个数,就是它。
下一期,「从LLaMA到DeepSeek 02」专门讲这个。
矩阵公式推导见我之前发推文:
https://x.com/antiAIvo/status/2113210995904856250
注:本文由Claude Opus5.5 辅助撰写
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


