
Claude Code 内部技巧流出【附 12 个隐藏用法】
文章目录
同样用 Claude Code,有人没干多少活就碰到限额,有人让它改了一下午,额度还够。更难受的是,额度花了,它还在重复犯错。
差别不只在模型,也在设置和做事习惯。这 12 条把思考强度、上下文、记忆、验证和并行工作串了起来,命令和提示词都可以直接复制。
插一句:🚀 我的公众号开通了!
Twitter 适合看短内容,但很多 AI 经验,三两句话其实根本讲不清。而且 Twitter 不一定随时方便打开,所以以后长篇、教程和真正值得收藏的内容,我会尽量优先放到公众号。
文末还有一份更狠的:17 个板块、90+ 篇 AI 资料包,提示词、AI 绘画、Agent、AI 赚钱全在里面。
先确认版本
先在终端查看 Claude Code 版本:
claude --version
版本较旧时,执行更新:
claude update
这份清单按原文 2026 年 10 月 18 日的 v2.1.302 整理。里面有些功能是近期版本才加入的,使用前先把版本对齐。
1. 思考强度,按任务分配
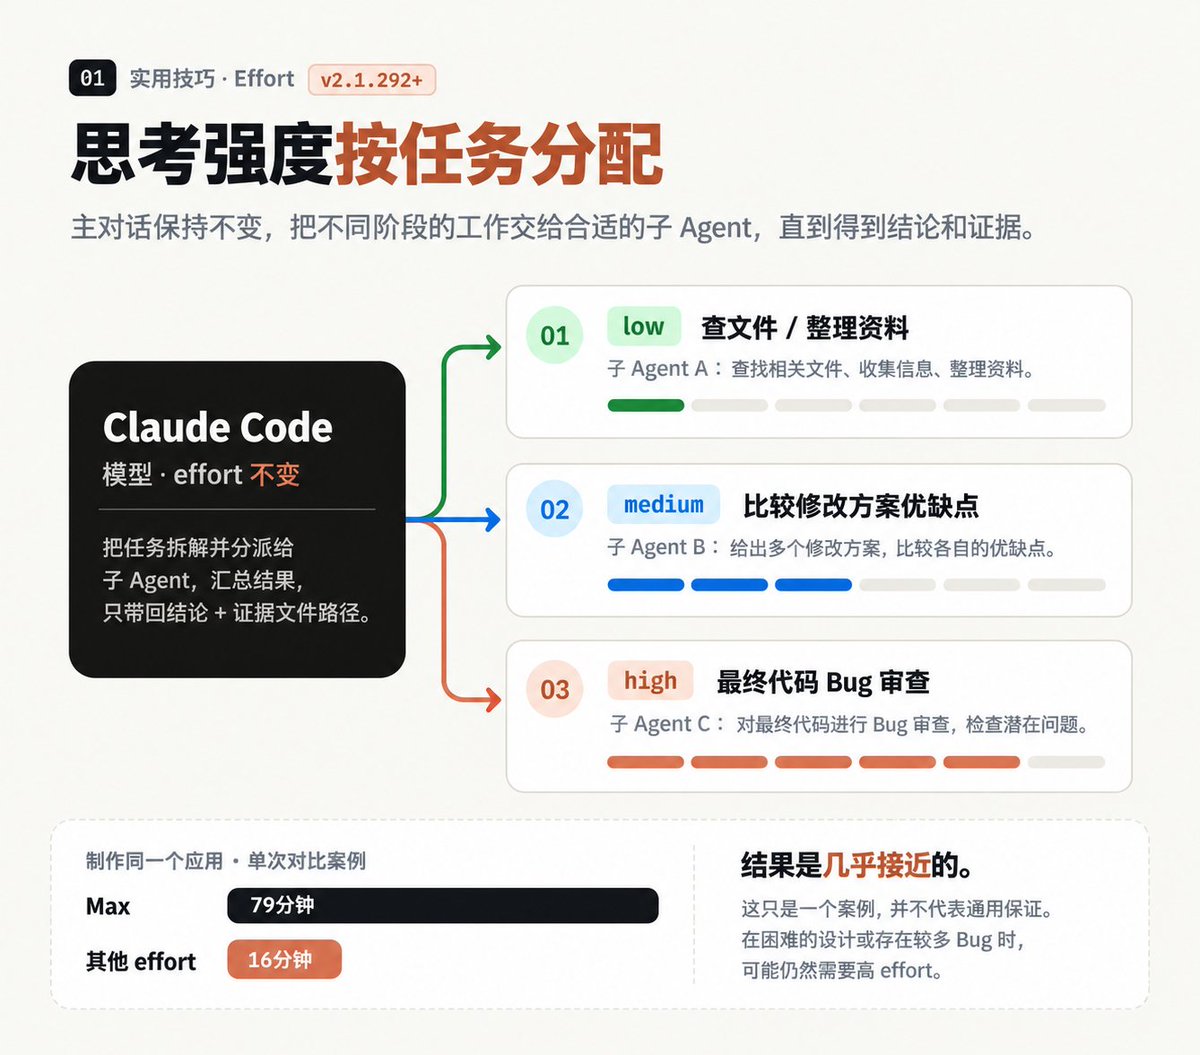
Effort 可以理解成“回答前花多大力气思考”。原文列出的档位有 low、medium、high、xhigh、max,不同模型可选的档位并不完全相同。
很多人习惯直接拉满,觉得想得越深,结果就越好。但简单任务也用最高档,可能只是等得更久、消耗更多。
原作者在制作同一个应用时做过对比:Max 花了 79 分钟,另一个思考档位花了 16 分钟,最终成品却接近。这是一次具体使用记录,不是所有任务的固定差距。
他的经验是:任务交代得足够清楚,低档位也可能交出接近的结果。在他的使用中,发散想法时,low 或 medium 反而更合适;复杂架构、难定位的 Bug、重要代码审查,再考虑提高强度。
重点是按难度分配,不是把所有任务都改成 low。
原文记录,10 月 7 日的 v2.1.292 起,主 Agent 调用子 Agent 时可以分别指定 effort。可以这样交代:
“把当前任务分成三步,交给不同的子 Agent:
-
查找相关文件、整理资料:使用 low effort。
-
比较修改方案的优缺点:使用 medium effort。
-
检查最终代码中的 Bug:使用 high effort。
说明每个子 Agent 实际使用的 effort。
主对话只接收结论和支撑结论的文件路径。“
不想每次重复交代,也可以在项目的 .claude/agents/ 目录里建立 light-research.md:
name: light-research
description: 轻量调查,只查找相关文件及证据位置
model: haiku
effort: low
一种是每次调用时指定,一种是写进 Agent 文件固定下来,按使用频率选择。
2. 别把上下文撑到最后
上下文就像 Claude 手边的工作台。聊天、读过的文件、命令输出,都往上面堆。
原文以默认 1M,也就是 100 万 Token 的上下文窗口为例。窗口大,不代表一直塞到最后仍能保持同样的工作状态。
原作者会把自动压缩使用的窗口大小设在 50 万到 70 万 Token。例如:
/autocompact 600k
这样不等到 100 万 Token 塞满,就会提前触发对话压缩,把已有内容整理成摘要。恢复自动设置用:
/autocompact auto
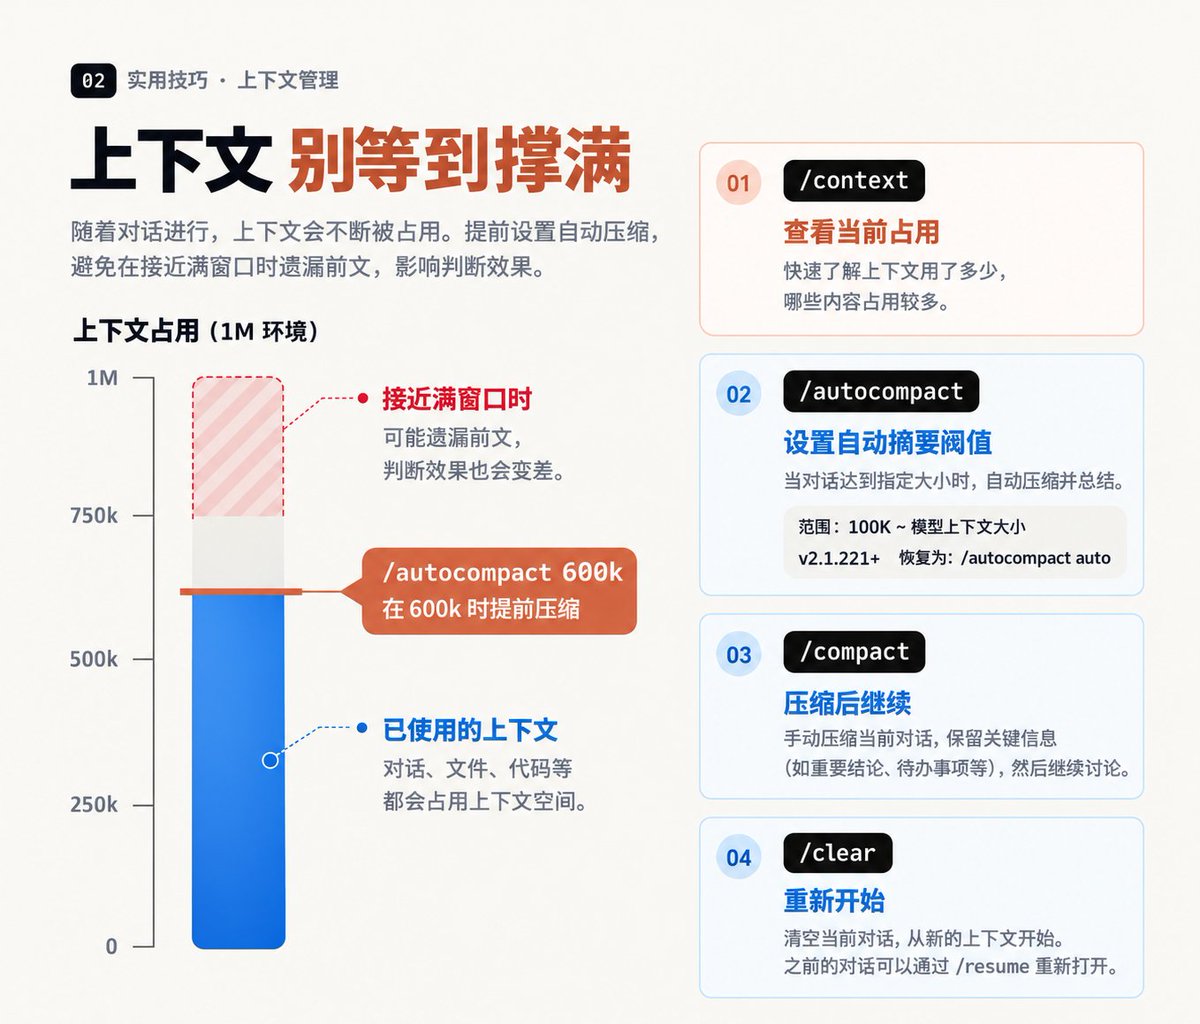
另一件容易忽略的事是缓存过期。
对话越长,每次请求携带的历史越多。缓存命中的部分可以复用已有计算;一旦过期,再发一句“继续”,也可能要重新处理很长的历史。
原文列出的缓存时长是:
Pro、Max 订阅套餐内的主对话:1 小时。
API Key 或额外用量额度:5 分钟。
子 Agent:即使使用订阅,也是 5 分钟。
原作者的界面曾出现 ~852k uncached。意思是约 85.2 万 Token 没命中缓存,这时哪怕只补一句话,也可能重新处理这一大段内容,明显消耗额度。
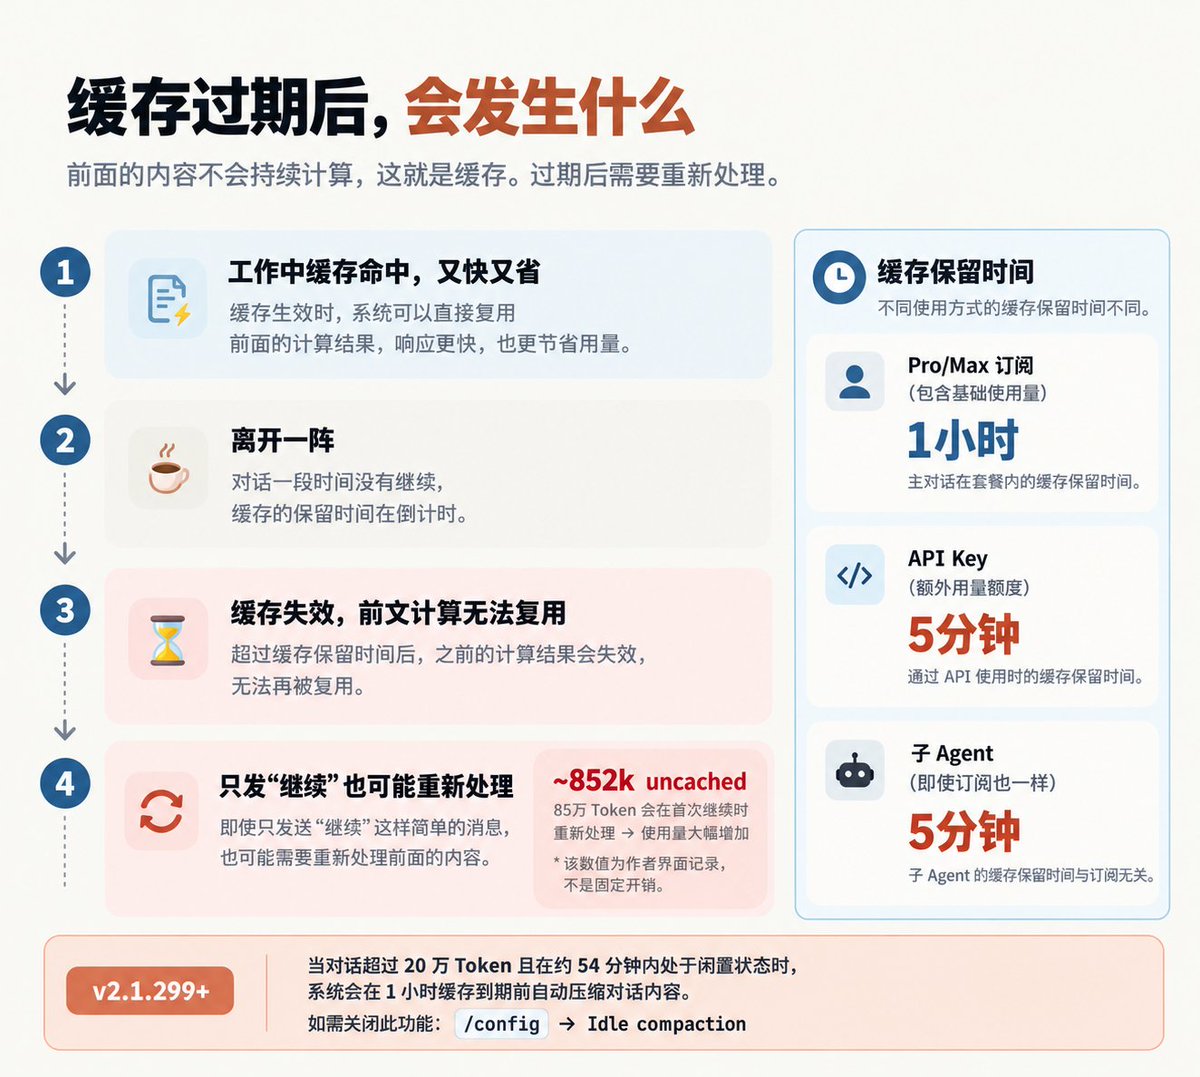
长时间离开后接着聊、在长对话中切换模型、改变已连接的 MCP 工具配置,都是原文提醒的缓存失效场景。
离开前,可以趁缓存还在时压缩:
/compact
或者结束这轮上下文,重新开始:
/clear
原文还记录,v2.1.299 起,超过 20 万 Token 的对话闲置约 54 分钟时,会在 1 小时缓存到期前自动压缩。可在 /config 的 Idle compaction 中关闭。
3. 给旧指令做一次
以前复制来的 CLAUDE.md,以及每次出错后追加的规则,未必还适合现在的模型和代码。
旧模型需要反复强调的“必须”“绝对禁止”,放到更听指令的新模型身上,可能被执行得过头。项目变了,旧规则没变,也会互相打架。
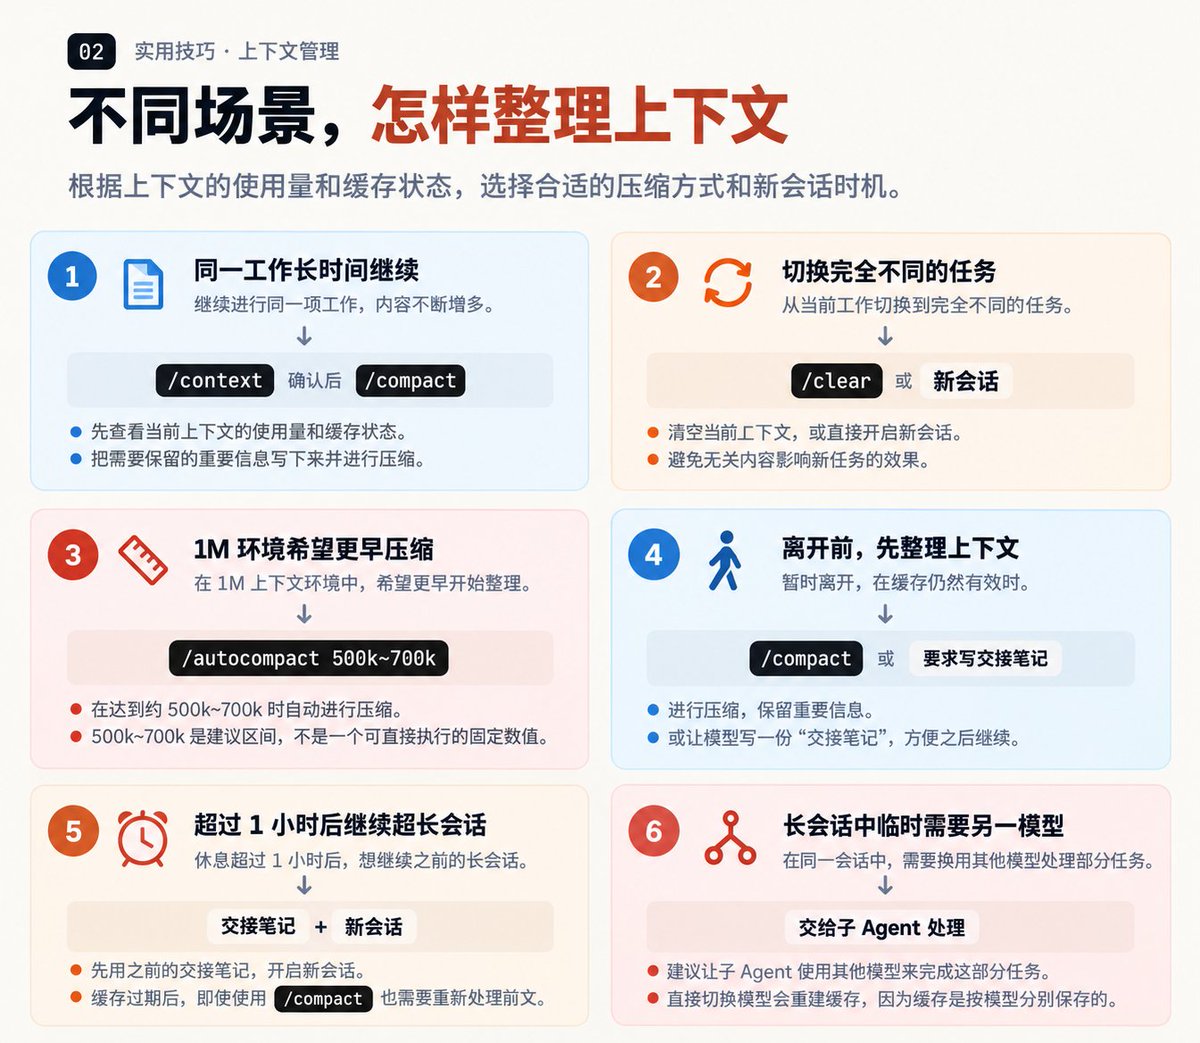
可以用原文介绍的指令检查:
/doctor prompt-audit
原文记录,这项功能在 9 月底的 v2.1.283 加入。它按当前模型检查旧提示模式,输出报告和修改建议。
检查范围包括:
项目及上级目录中的 CLAUDE.md、CLAUDE.local.md、AGENTS.md。
个人全局指令 ~/.claude/CLAUDE.md。
.claude/ 中的 rules、Skills、自定义命令、子 Agent 定义和输出样式。
安装插件中的 Skills 和 Agent 也会被查看,但不在建议修改的范围。可能含有密钥的 settings 文件、.mcp.json 不在读取范围内。
4. 反复犯错,就改工作环境
同一个问题已经提醒了好几遍,Claude 还是重蹈覆辙,继续在聊天里加重语气,往往没有用。
原作者从 Sonnet 3.7 时期就在用一个办法:让 AI 回看出错的会话,把原因落实到项目规则、流程和验证上。
先在反复出错的会话里输入:
/status
复制会话 ID。再打开一个新的 Claude Code 会话,也可以用能够读取该记录的 Codex,把下面这段发过去:
请分析这个 Claude Code 会话:<会话 ID>。
找出出现过两次以上的错误、我指出后仍然重复的问题,以及拖慢工作的瓶颈。
逐项区分原因:错误假设、缺少上下文、代码结构问题,还是缺少测试。
为避免再次发生,请判断应当修改哪一处:
CLAUDE.md、.claude/rules、Skill、Hook,或测试。
每项只提出最小必要的修改建议。
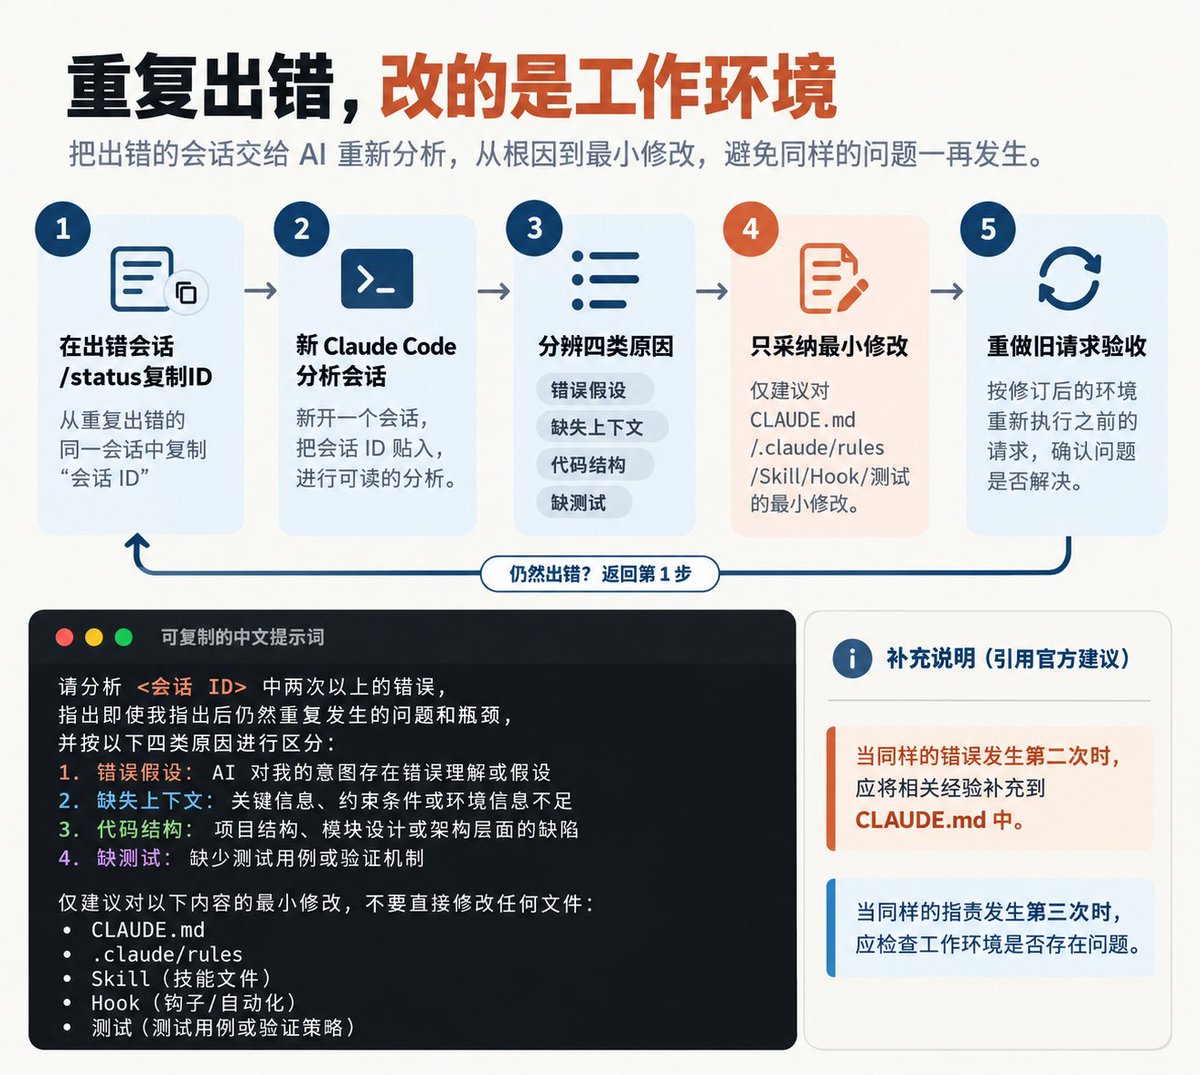
看过建议后,只采纳确实有用的部分。再把以前出错的请求重新跑一遍,看同类错误是否真的消失。
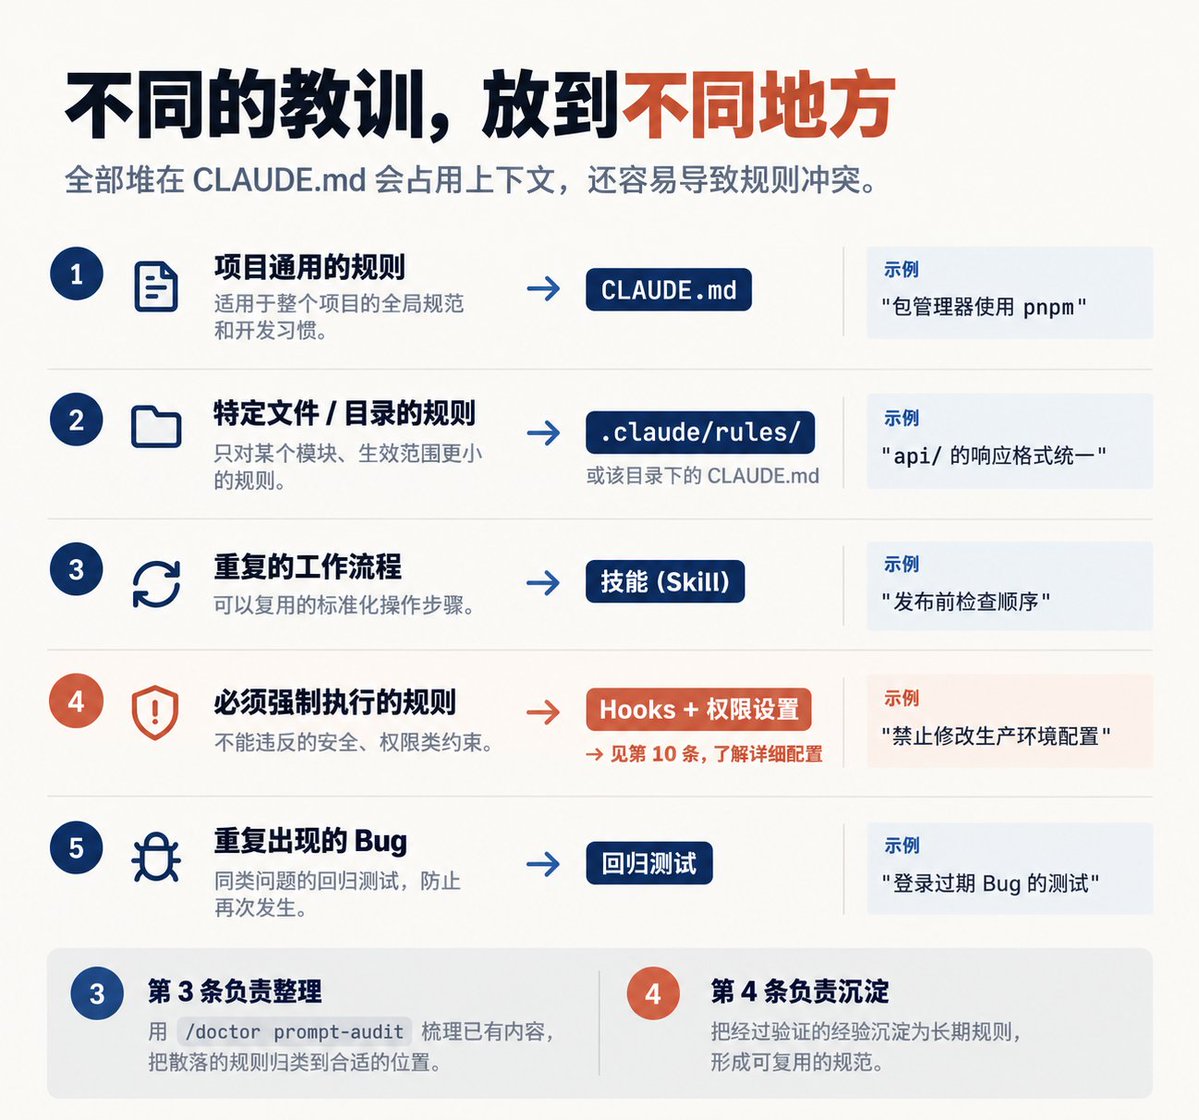
别把所有教训都塞进 CLAUDE.md。规则越长,占的上下文越多,也越容易互相冲突。
整个项目都适用的要求,放 CLAUDE.md。
只针对特定文件或目录的要求,放 .claude/rules/,或对应目录的 CLAUDE.md。
重复执行的工作步骤,整理成 Skill。
必须强制遵守的限制,交给 Hooks 和权限设置。
再次出现过的 Bug,补成回归测试。
第 4 条负责沉淀经验,第 3 条负责定期清理,别只加不减。
5. 跨会话记忆,用对再
换个会话,又得重新解释“上次为什么这么改”“那个错误是怎么解决的”,很容易把时间花在重复交代上。
Claude Code 自带的 Auto Memory 会把它认为重要的信息、项目经验整理成记忆,不用额外安装,通过 /memory 查看。
原文推荐的 claude-mem 更侧重记录工作过程:做过什么、遇到什么错误、怎样解决、为什么做某个决定,再在新会话中检索需要的记录。
原作者已连续使用约一年,文中记录项目 GitHub Star 超过 10 万,他自己的界面出现过 87% 的 Token 节省比例。这些是原文当时的项目数据和个人记录。
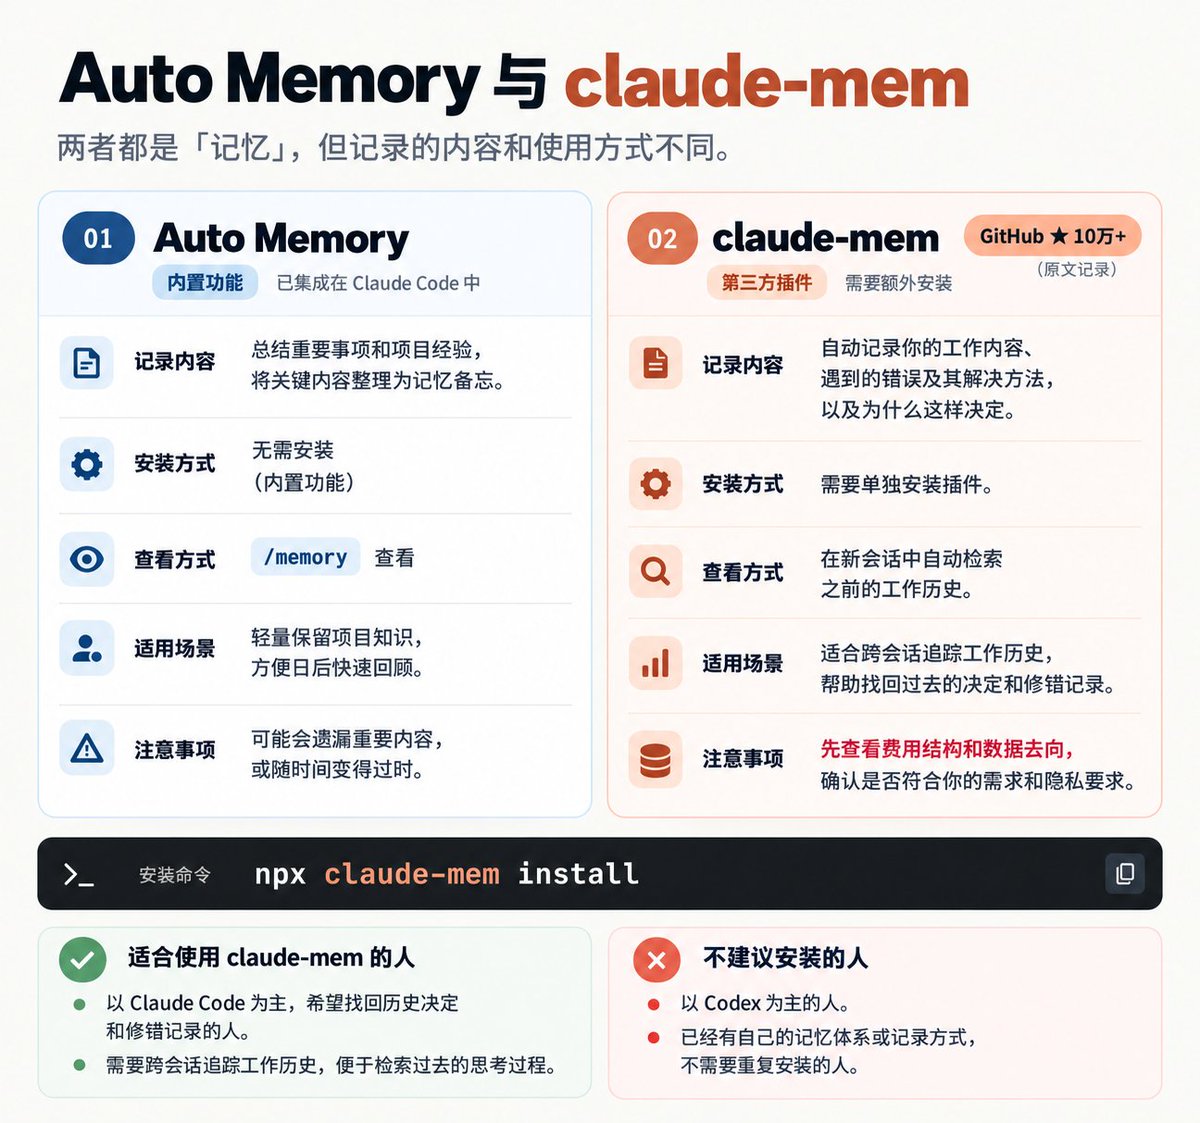
在终端安装:
npx claude-mem install
也可以在 Claude Code 中通过插件方式安装:
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
这两类人没必要为了“记忆”再多装一套:
主要使用 Codex 的人。
已有其他记忆插件,或自己建立了记录、交接体系的人。
功能重复的工具叠在一起,可能增加复杂度和开销。以 Claude Code 为主要工作环境、又经常跨会话接续任务,再考虑它。
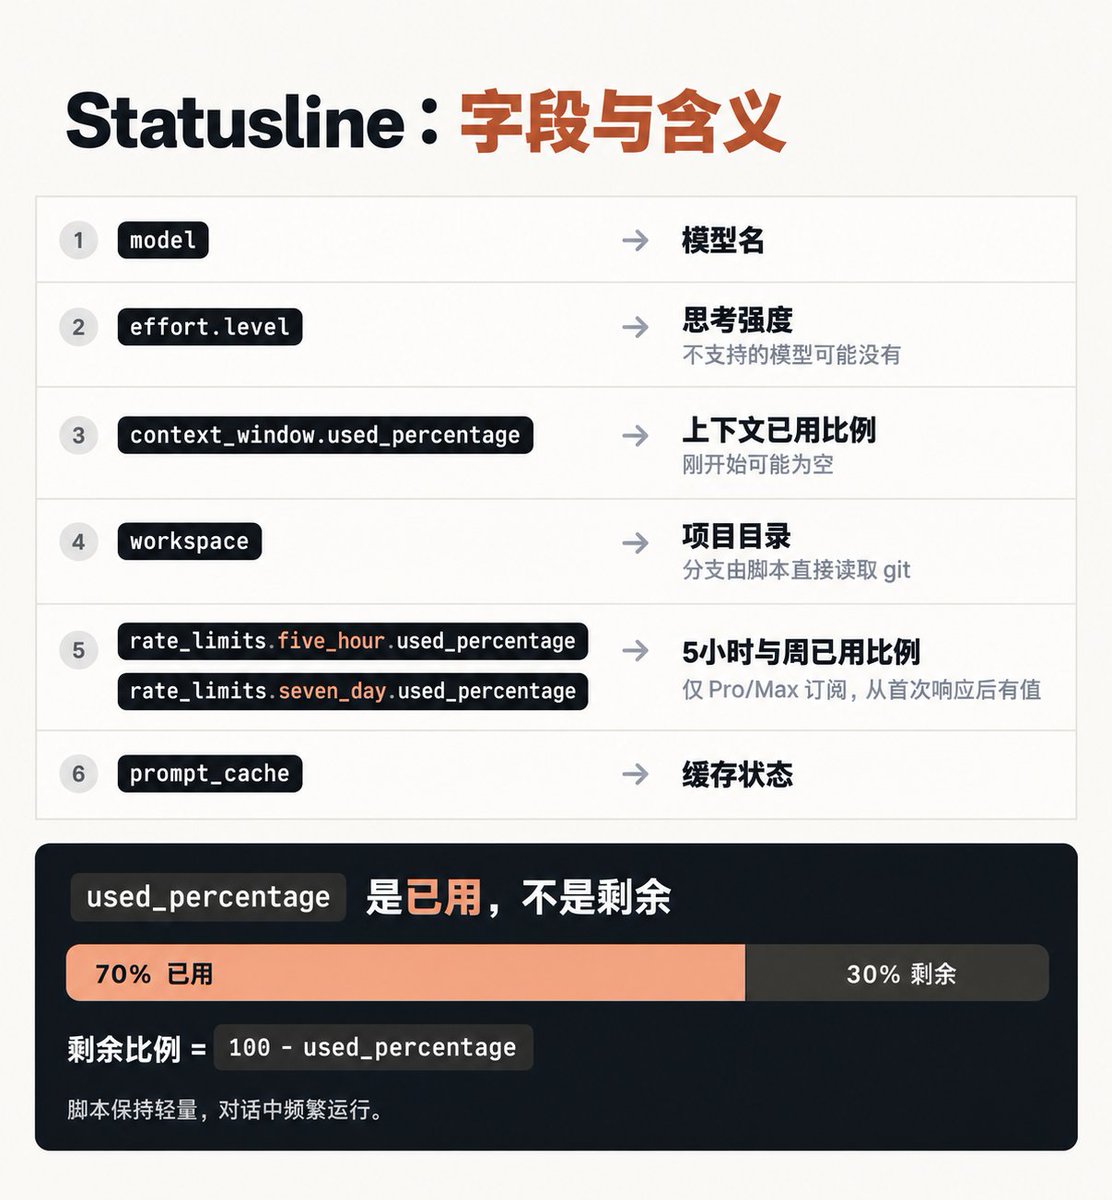
6. 把用量信息放在眼前
现在用哪个模型?思考强度开到哪档?上下文占了多少?5 小时和一周的额度还剩多少?
这些信息不必来回查。Statusline 可以把它们放在终端底部,随时看见。
原文的做法是在 /statusline 后面,用自然语言描述想要的样式,让 Claude 生成脚本并应用。
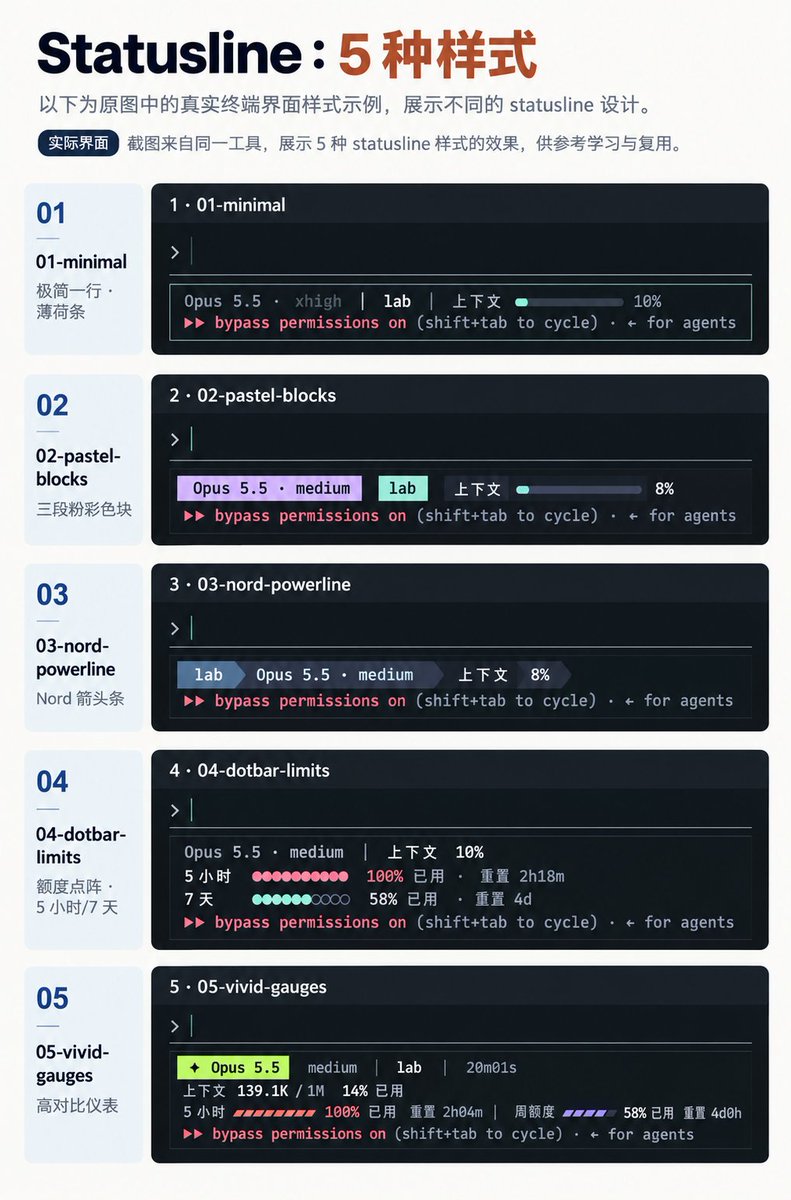
原文附了 5 套现成样式,完整提示词在对应帖子中:
极简版:一行显示模型、effort、项目和上下文。
https://x.com/lucian__03/status/2103173295118098750
粉彩色块版:适合深色终端,用柔和色块区分信息。
https://x.com/lucian__03/status/2103173396075065594
Nord Powerline 版:各个信息区段通过箭头边界连成一条状态栏。
https://x.com/lucian__03/status/2103173518573916178
额度点阵版:面向 Pro、Max,显示 5 小时、7 天用量及重置倒计时。
https://x.com/lucian__03/status/2103173612832444536
高对比仪表版:亮绿色模型标签、斜纹进度条,同时显示上下文 Token 数。
https://x.com/lucian__03/status/2103173754218258607
7. 让它运行,别只听它汇报
Claude 说“已经实现”,打开却发现按钮点不了、页面错位,甚至整个应用起不来。测试通过,也不等于真实使用没问题。
原文把这几项命令分得很清楚:
/run:实际启动项目,操作应用,检查改动。
/verify:构建、运行应用,验证修改的功能,不能只拿测试或类型检查代替。
/run-skill-generator:把项目启动所需的命令、环境变量和准备步骤保存成 Skill。启动流程复杂的项目,可以先处理这一项。
原文还说明,/verify 会把已经确认的验证方法保存到项目的 .claude/skills/verify/ 中,供后续复用。
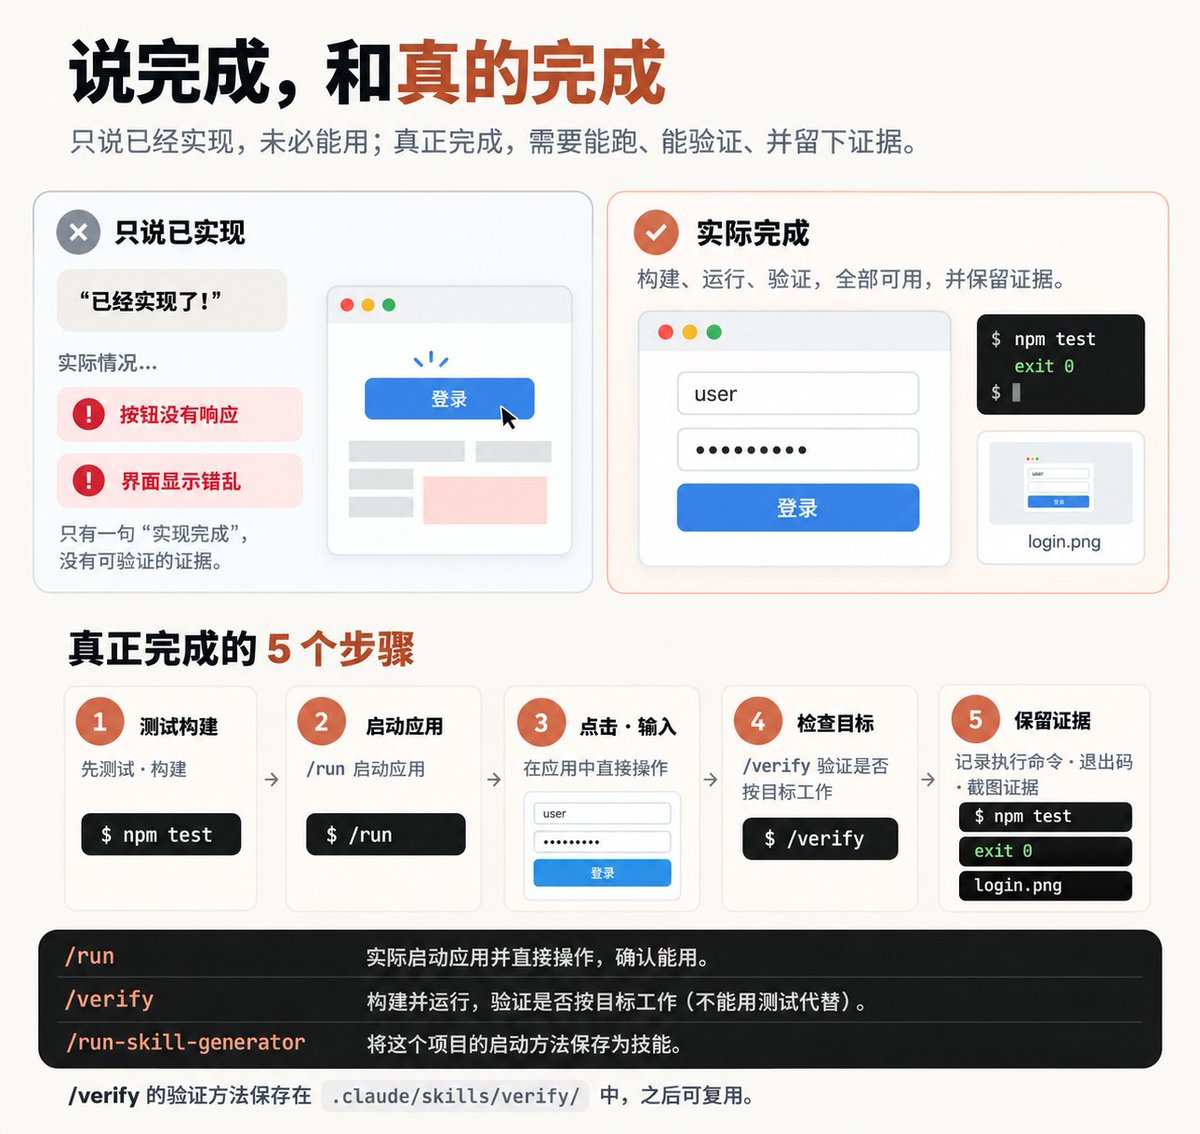
按这个顺序做:
1.实现功能,先检查测试和构建结果。
2.用 /run 启动应用。
3.网页就实际点击、输入;命令行工具就喂一份样例,检查真实输出。
4.用 /verify 确认原定目标是否达成。
5.没通过就修,再跑;保留实际命令结果或界面作为证据。
8. 写代码和审代码,分开做
自己写的文章,自己很难看出错字。写代码的 AI 也可能一直沿着原先的假设想下去。
换一份干净的上下文来审查,能少一些“我已经做对了”的惯性。
原文列出了三种不同用途:
/code-review:针对当前改动、PR、分支或路径,查 Bug 和正确性问题。
/security-review:检查当前分支与远程默认分支的差异,关注认证、输入校验、信息泄露等安全问题。
/simplify:整理重复、低效和过度复杂的代码,并执行修改;它不代替 Bug 审查。
审查强度可以像这样指定:
/code-review high
原文描述的常规档位从 low 到 max。默认输出报告;希望连同修复一起完成时,附加 --fix。
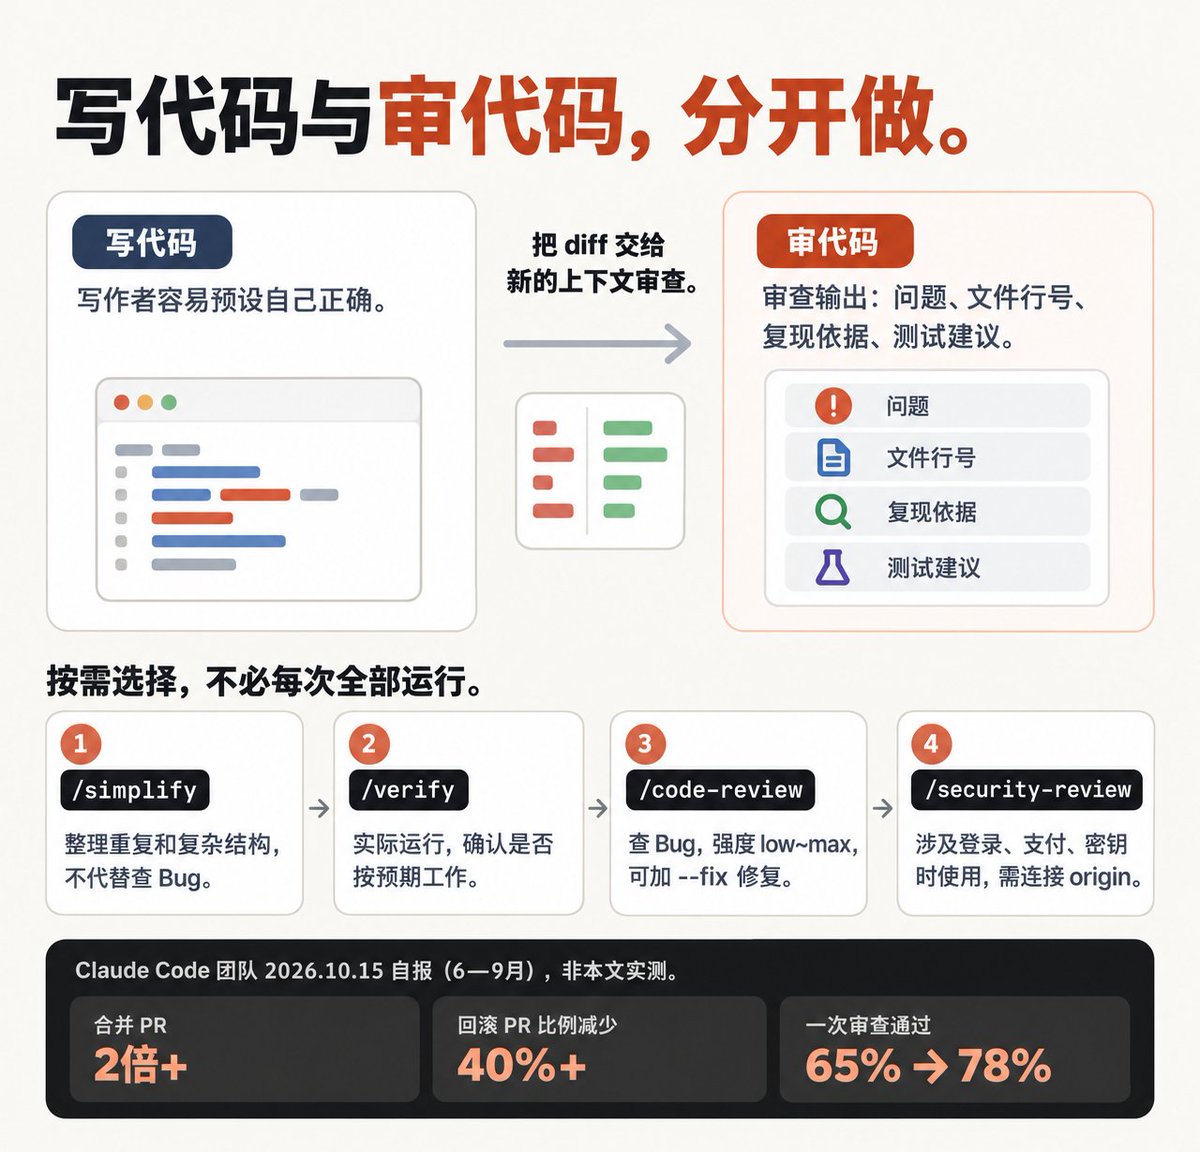
较完整的顺序是:先 /simplify 整理,再 /verify 验证功能,接着 /code-review 查错。涉及登录、支付、API Key 或个人信息,再加 /security-review。
小改动不用每次把四项全跑一遍,一次针对性的 /code-review 也可以。
原文另列了 /code-review ultra,与 /ultrareview 对应,用于云端深度审查;并记录当时 Pro、Max 可免费试用 3 次。
9. 复杂任务,先写清完成条件
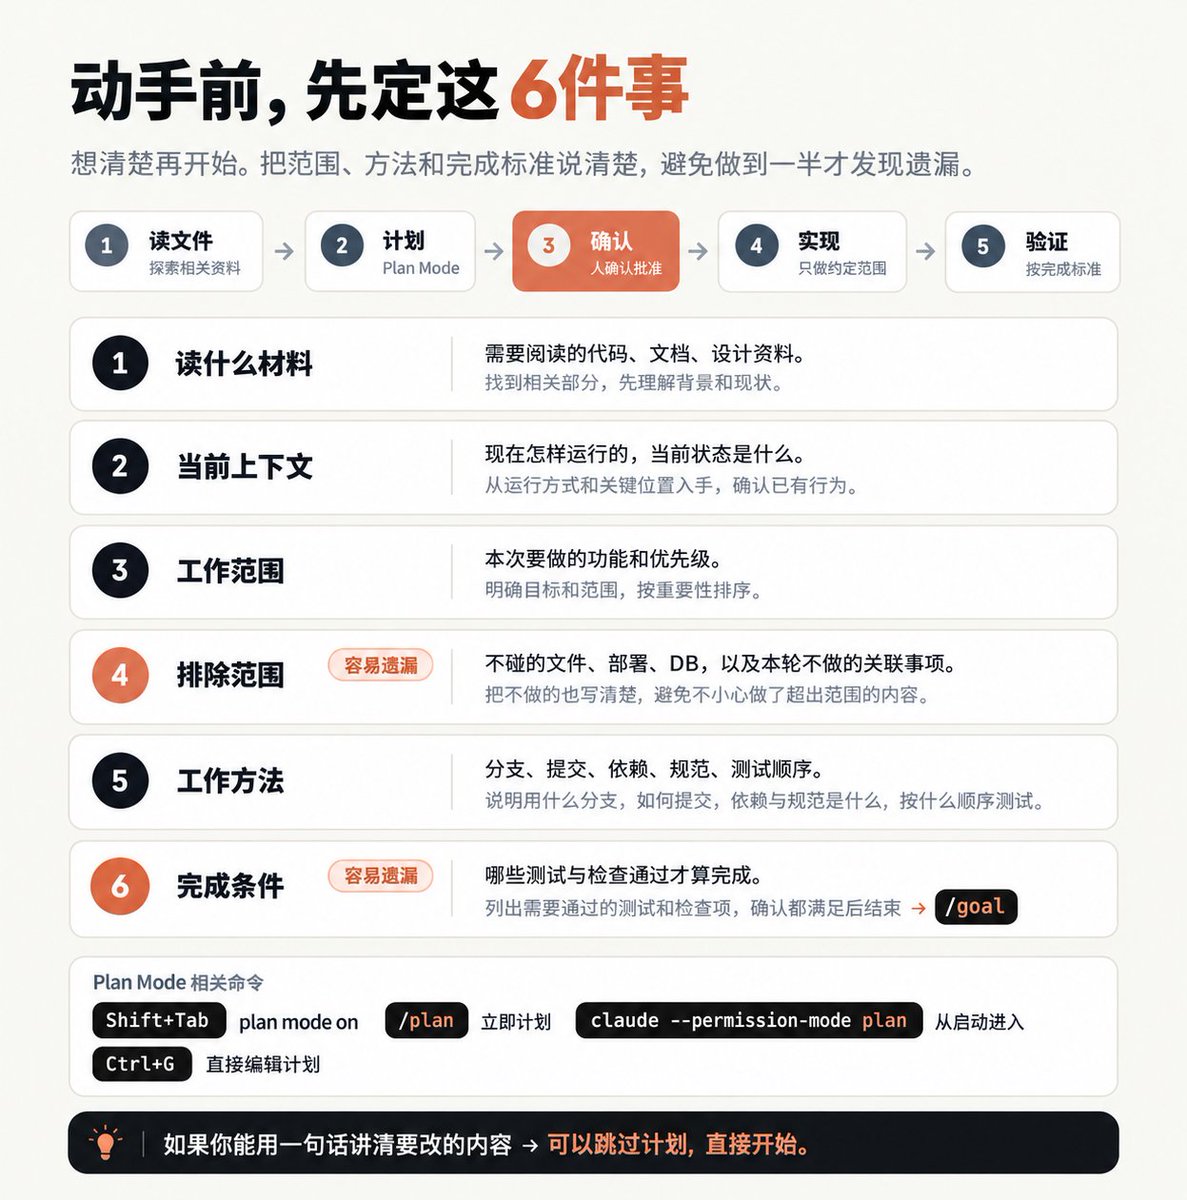
任务越复杂,越不要一上来丢一大段“开始写代码”。先说清楚:改到哪里为止,什么结果才算完成。
否则 Claude 可能越做越大,顺手改了不需要动的文件,还添上原本没要求的功能。
使用 Plan Mode,可以按 Shift+Tab,直到输入框显示 plan mode on,或者输入:
/plan
也可以直接带上任务:
/plan 修复登录 Bug
在计划模式下先读文件、做计划,得到批准后再修改代码。顺序是:探索 → 计划 → 批准 → 实现 → 验证。
错字、一行代码之类的小改动,就不必为计划再走一大圈。原文引用的判断方法是:能用一句话讲清楚具体要改什么,就可以跳过计划。
10. 重要限制,交给 Hooks
在 CLAUDE.md 写“这个文件不能改”,仍然需要模型记住并遵守。Hooks 则是在特定时机自动执行脚本,把要求放进流程里。
原文重点介绍了三个触发点:
PreToolUse:工具执行之前,可以阻止修改受保护文件,或拦截危险命令。
PostToolUse:工具执行之后,可以自动格式化、运行 lint 检查。
Stop:准备结束回复时,检查是否满足结束条件,例如测试有没有完成。
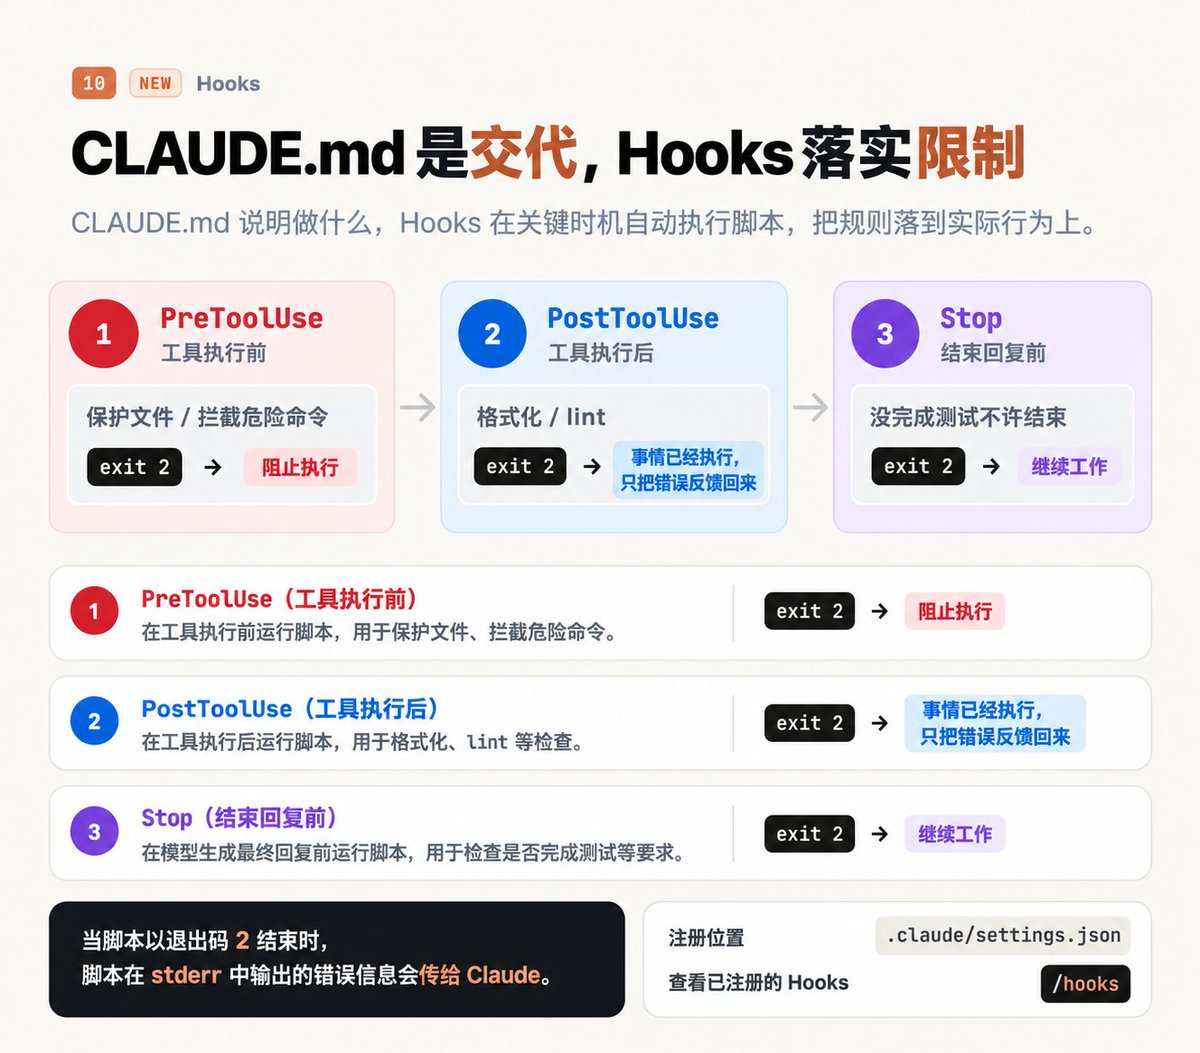
比如保护生产环境配置,可以直接让 Claude 编写对应 Hook:
帮我创建一个 PreToolUse Hook,阻止修改 config/production.env。
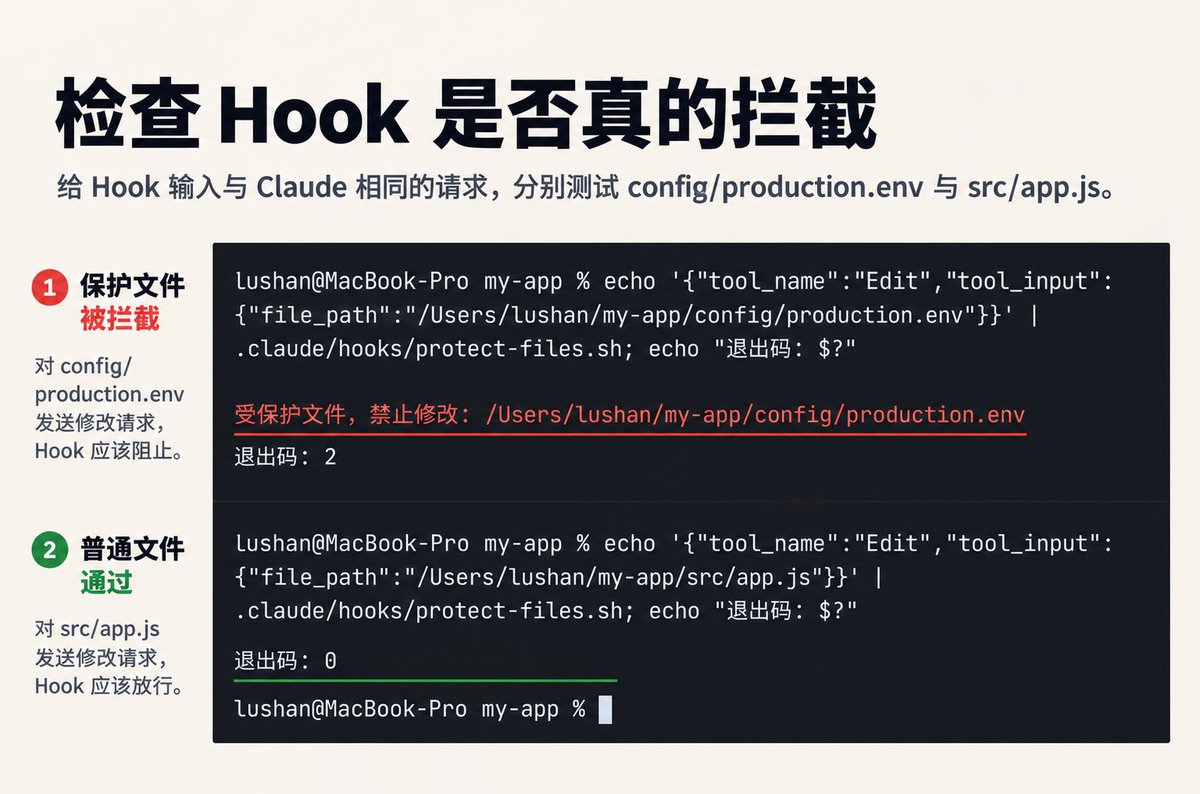
同样的机制还可以用于:每次改代码后运行项目格式化工具;动重要目录前再次审批;没跑完测试不准结束;在 Bash 执行前拦截危险命令。
11. 并行工作,先分开目录
开两个 Claude Code 窗口,在同一个目录里同时改文件,很容易互相覆盖,或者把对方改到一半的内容当成新状态。
Git Worktree 可以把同一个仓库分成独立的工作目录和分支,让不同任务各做各的。
在两个终端分别运行:
claude --worktree feature-auth
claude --worktree feature-dashboard
也可以使用短参数 -w。
原文示例中,会建立 .claude/worktrees/feature-auth/ 目录,并在 worktree-feature-auth 新分支上工作。
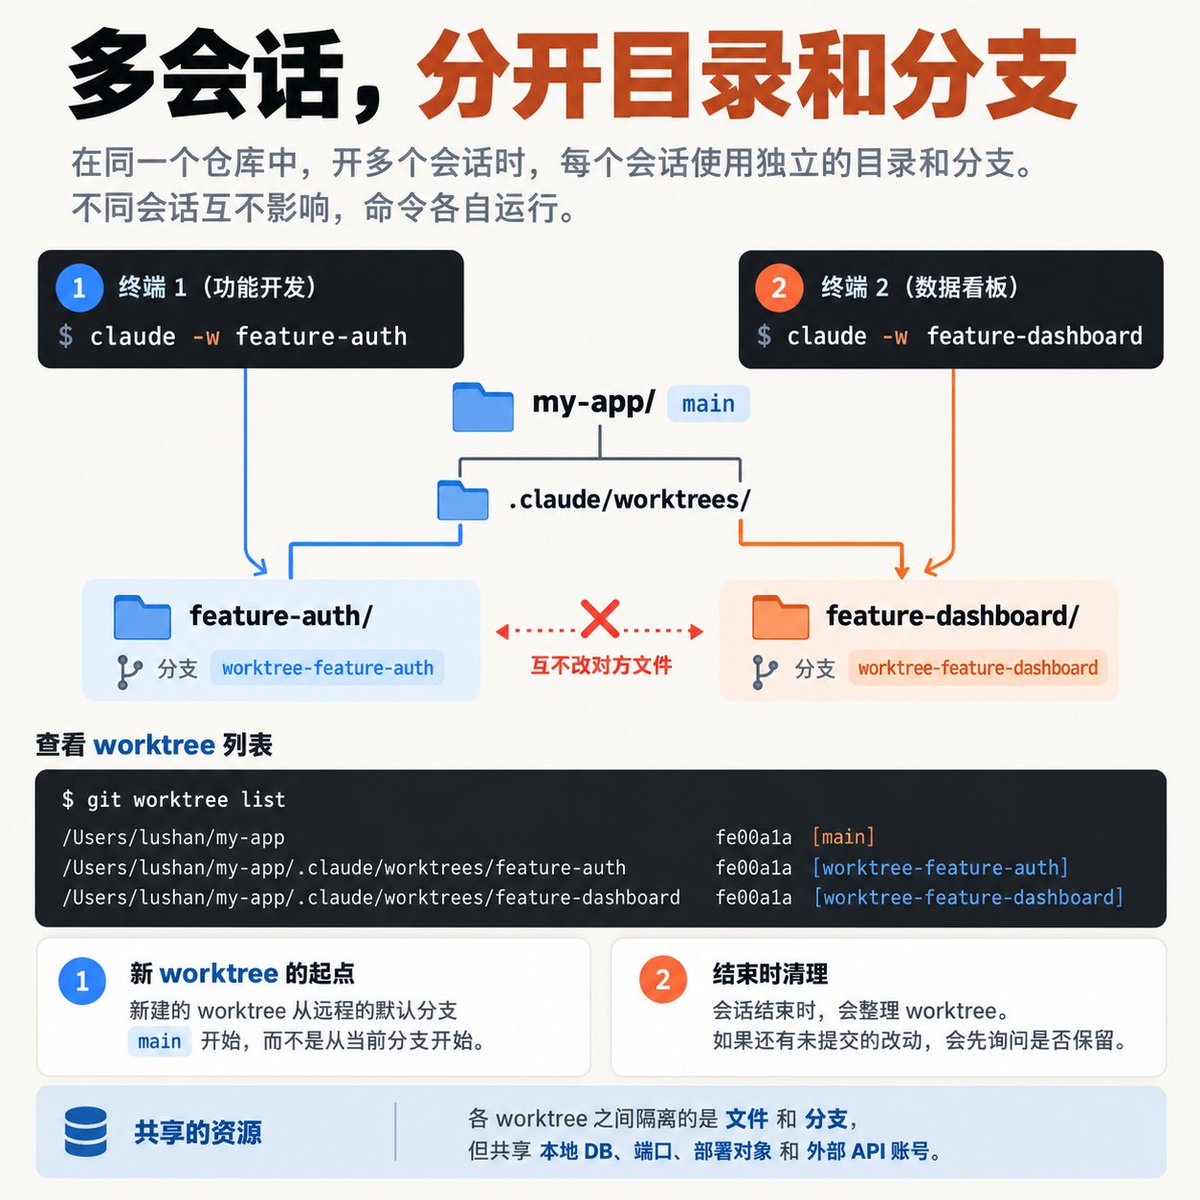
原文还提醒:新 Worktree 从远程默认分支,比如 main 开始,而不是从当前所在分支开始。需要接手某个 PR,可以指定 PR 编号:
claude --worktree "#1234"
结束会话时,Claude Code 也会处理 Worktree 清理。如果还有工作未保留,会先询问再删除。
分开目录之后,仍然要记住四件事:
1.分开的主要是文件和分支。本地数据库、端口、部署目标、外部 API 账号可能仍共用,两个服务抢同一个端口照样会冲突。
2.合并时,如果双方改了同一个文件,仍可能出现冲突。
3.耦合很强的任务,先约定接口,或者按顺序做。
4.每个会话都消耗用量,并行不等于省 Token。
12. 用目标驱动它继续完成
一轮回答结束,不代表任务结束。有时候还有几个测试没过,Claude 却已经停在“基本修好了”。
原文介绍的 /goal 会把完成条件设成持续目标,没有满足时,继续推进下一轮。文中记录它从 v2.1.139 起提供。
单独输入下面的命令,查看当前目标和进度:
/goal
清除目标并停止:
/goal clear
原文描述的机制是:每轮结束后,由另一个小而快的模型读取目标和对话,判断有没有达到条件。尚未达到,就让 Claude 继续下一轮。
目标里要带上判定依据。比如要求把测试命令和结果写进对话,否则负责判断的模型也可能看不出是否真正通过。
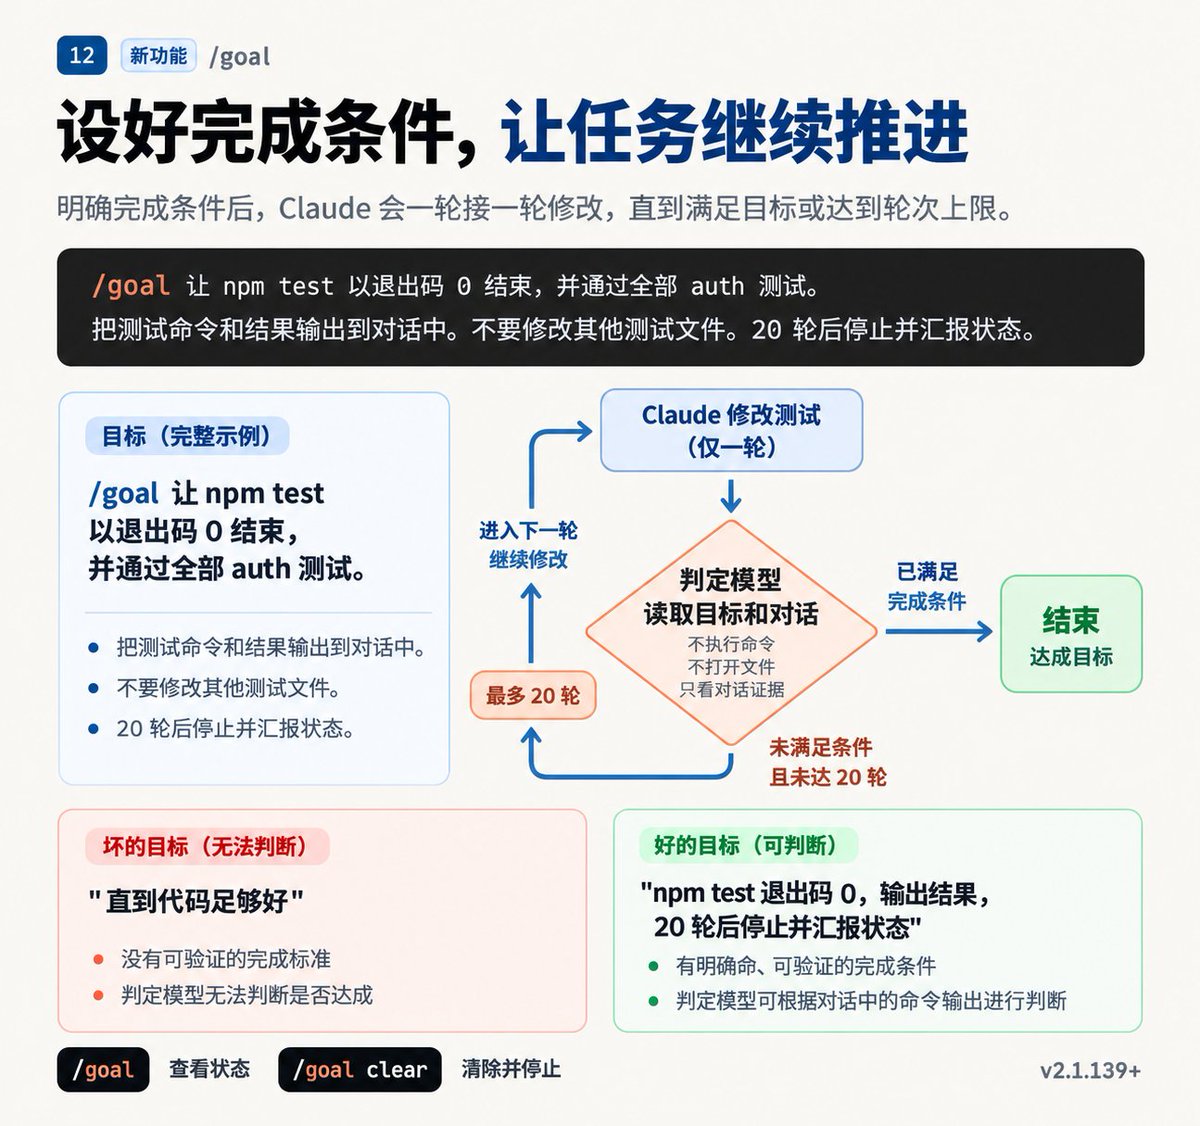
它与另外两种机制的区别:
/goal:一轮结束后继续下一轮,达到目标后停止。
/loop:按固定间隔重复任务,例如 /loop 5m 检查部署状态。
Stop Hook:准备结束时,运行自己编写的脚本检查条件。
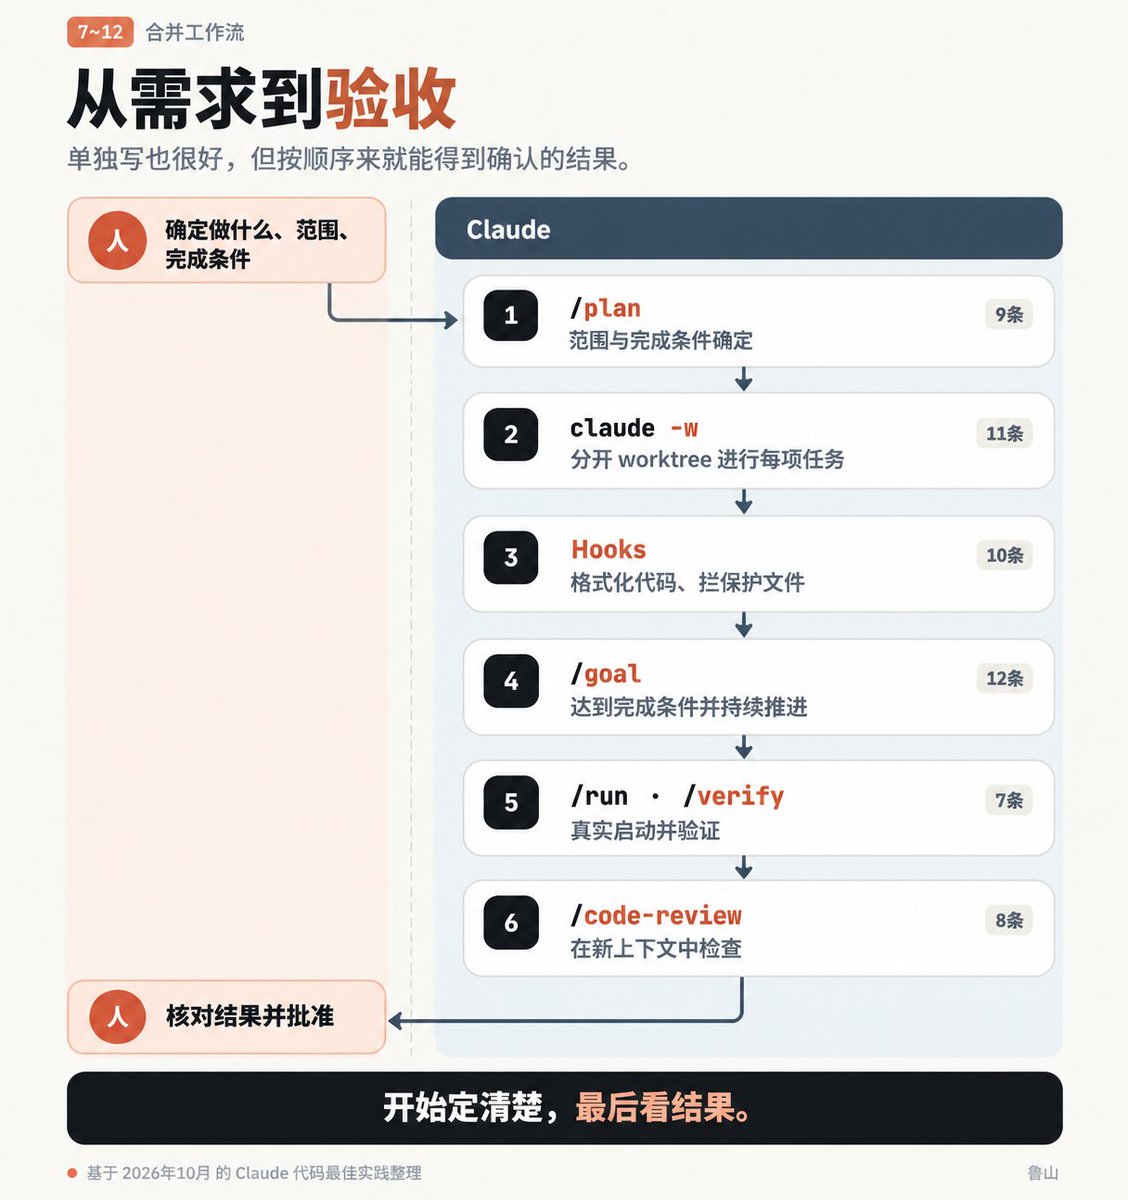
把前面的用法串起来,就是一条完整工作流程:
1./plan:先确认范围和完成条件。
2.claude -w:按任务分开 Worktree。
3.Hooks:自动格式化、保护重要文件。
4./goal:围绕完成条件持续推进。
5./run、/verify:实际启动,验证效果。
6./code-review:换一份上下文,独立检查。
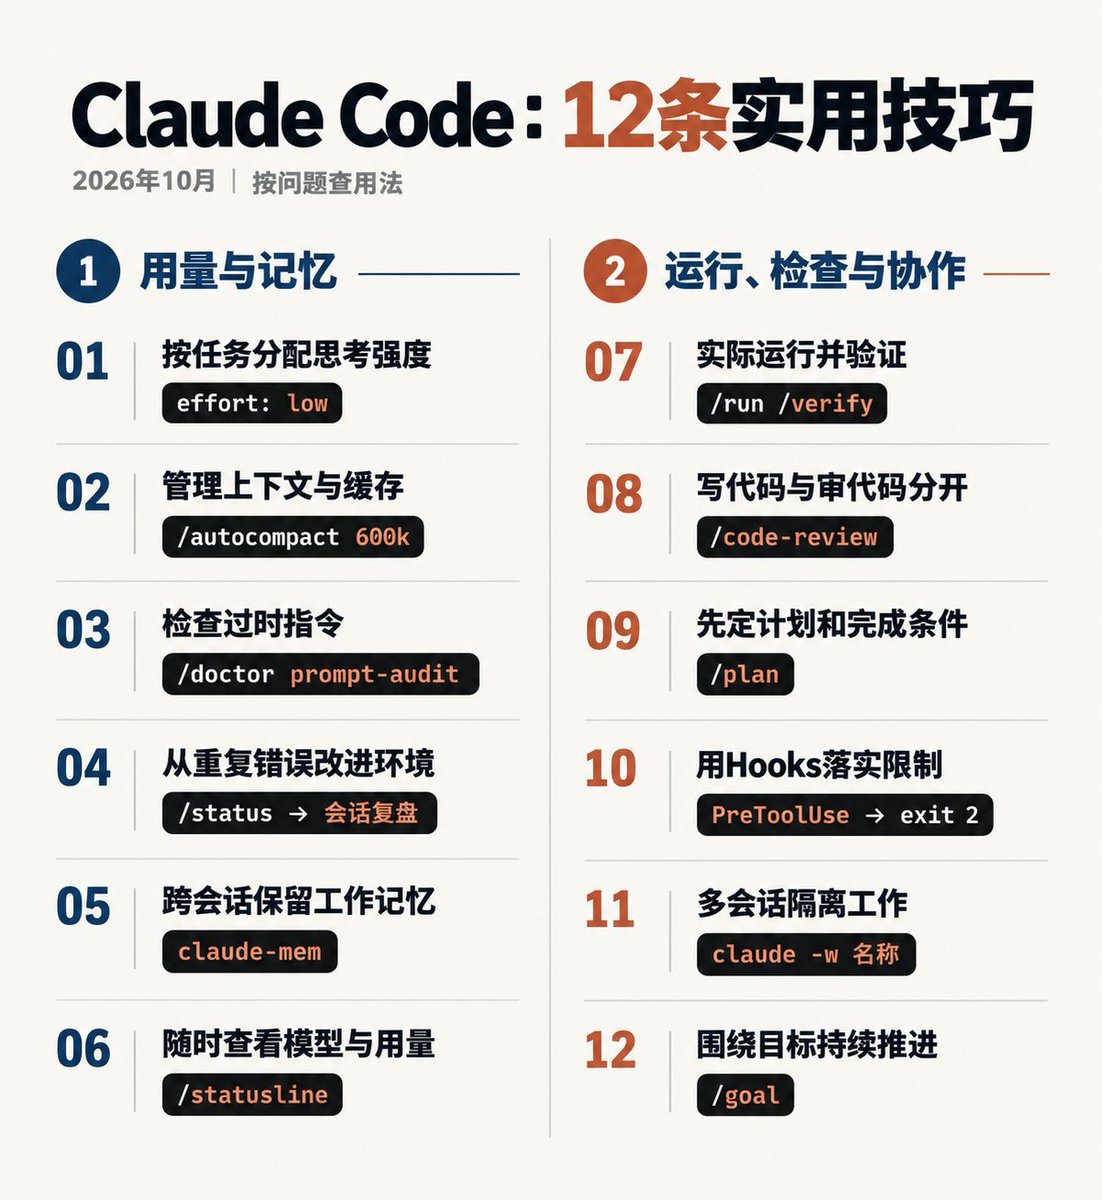
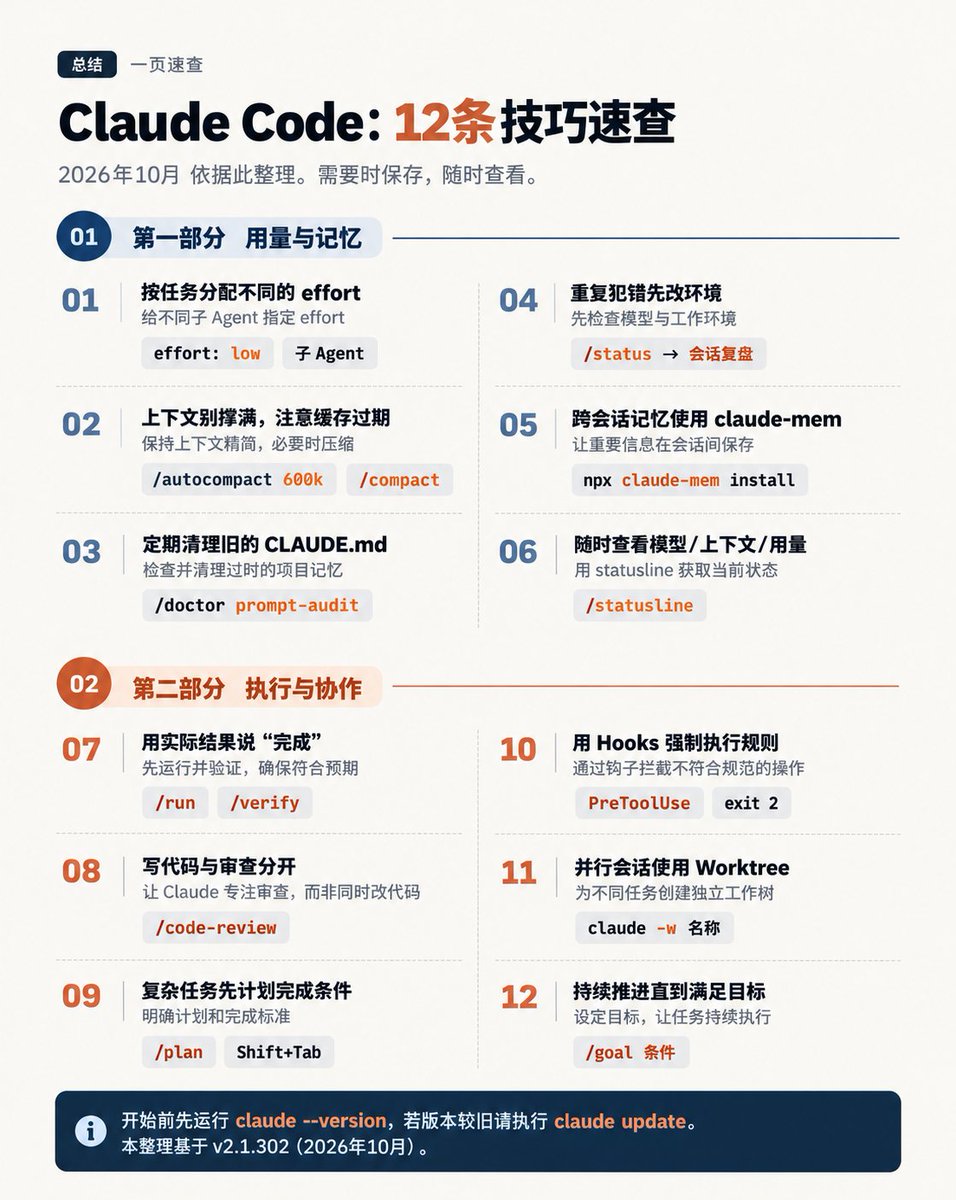
一张清单,随用随查
前 6 条主要处理用量、上下文、规则和记忆,后 6 条处理运行、审查、计划、约束、并行与持续推进。
把下面这张总览存下来,遇到哪类问题,就回到对应一节,不必一次把所有设置都改完。
今天可以先检查版本、看看上下文和额度,再挑一个反复出错的任务,把它的完成条件写清楚。让下一次“完成了”后面,跟着一份能看见的结果。
原文附带的延伸资料
子 Agent 的 effort 设置:
https://x.com/lucian__03/status/2108194703782916166
为什么 Max 未必更合适:
https://x.com/lucian__03/status/2104641991279874134
自动压缩设为 500k—700k:
https://x.com/lucian__03/status/2108589402914177236
852k uncached 与缓存过期:
https://x.com/lucian__03/status/2106396357527531800
检查旧指令:
https://x.com/lucian__03/status/2104560017407869028
用会话复盘改进工作环境:
https://x.com/lucian__03/status/2081761475560157477
claude-mem:
https://x.com/lucian__03/status/2108997241864159442
Statusline 五套样式汇总:
https://x.com/lucian__03/status/2103173166973718537
还有一份大礼包送给你👇
从提示词、AI 绘画、AI 视频,到 Agent、AI 赚钱、AI 学习路线,一共 17 大板块、90+ 篇资料,关注我的公众号后即可领取。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


