
基于 Claude Code 的视频自动化剪辑指南
文章目录
在传统的视频创作流程中,哪怕是一期简单的知识分享或双人对谈,后期往往也意味着机械的重复劳动:先导进剪映粗剪掉「然后」「那个」等口头禅,再逐句校对字幕,最后还要针对高密度知识点手搓解说图卡、加转场和缩放聚焦。
但如果把原始 MP4 毛片或一篇文章直接丢进本地文件夹,打开 Claude Code,让它从头到尾一次性跑完「去水词、加字幕、绘制度身定制的解说动效、合成导出 MP4」呢?
实测结果令人意外:在知识类长视频和图解动画场景下,Claude Opus 5.5(开启 High 思考模式)不仅能实现 One-Shot(一次提示直出成片),在抽象概念的可视化图解与节奏编排上,甚至比手动剪辑还要清晰。更关键的是,这套流程不需要配置复杂的第三方 Skill 插件,每月 20 美元的 Pro 订阅额度就足够支撑每天 2~3 条视频的日更消耗。
本文将先分享让 Claude 一次剪到位的 3 个核心实操诀窍,再深入拆解它如何通过 HTML Canvas + Playwright + FFmpeg + F5-TTS 在本地用代码「画」出整支视频,并在文末附上可直接复用的完整工程级 Prompt。
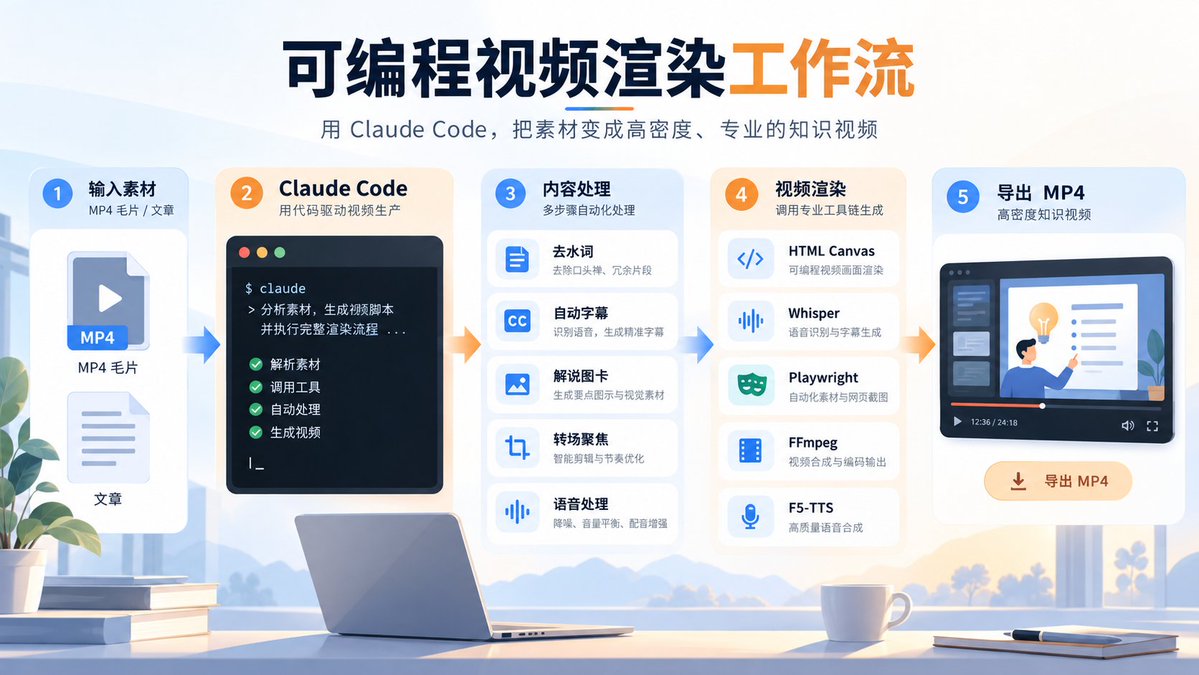
图 1|从输入素材到内容处理、程序渲染和 MP4 导出的整体流程。
一、为什么用 Claude Code 做视频?(跟传统 AI 视频工具的区别)
市面上大多数 AI 视频工具(如 Sora、Runway 等)走的是「扩散模型抽卡生成画面」的路线,擅长生成具象的镜头,但面对高知识密度内容(需要精准的文字排版、逻辑图卡、数据动效和严丝合缝的字幕同步)时往往力不从心。
Claude Code + Opus 5.5 走的是另一条路线:可编程视频渲染(Programmatic Video Rendering)。
-
底层逻辑:你描述需求或贴入文章,Claude 负责编写前端动画代码(HTML5 Canvas)与音频处理脚本(Python/Node.js),再调用本机的 Whisper(语音转文字)、Playwright(逐帧截图)与 FFmpeg(音视频合成)直接输出成片。
-
闭环自检:现在的模型具备极强的多模态自检能力,渲染前会自动抽帧生成缩略图检查排版(如是否叠字、断行是否美观),发现问题自己改代码重跑,人只需要在旁边喝杯咖啡等结果。
-
极低门槛:初期调优一两次后,Token 消耗非常可控,20 美金月费即可满足高频日更。
二、实战工作流:3 个让 Claude「一次剪到位」的诀窍
很多人在初次尝试用 AI 剪视频时,容易陷入「不知道怎么写超长提示词」的困境。其实只要掌握以下 3 个诀窍,就能用最低的沟通成本拿到高水准成片。
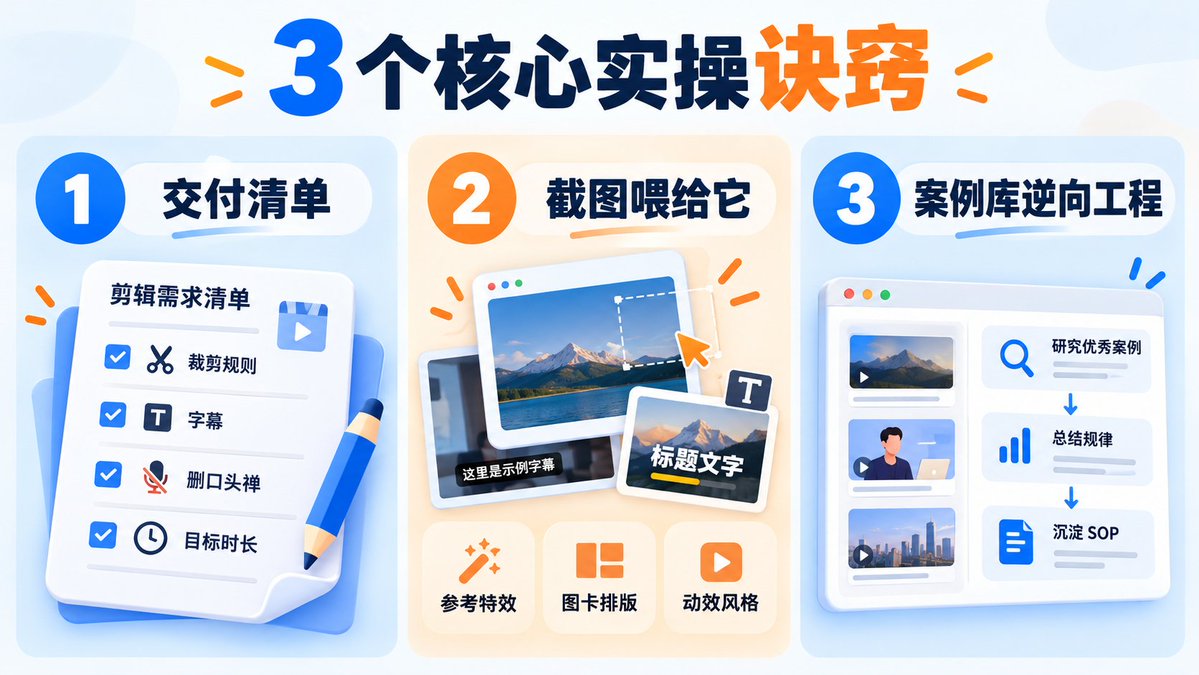
图 2|让剪辑指令更高效的三种方法。
诀窍 1:用「交付清单」代替复杂提示词,明确裁剪规则与秒数
不需要一上来就写几千字的结构化 Prompt。实操中最顺手的做法是在本地新建一个工作文件夹,放入原始视频 MP4(或准备好的文章),打开 Claude Code 直接下达清晰的交付要求:
请帮我剪辑这支 YouTube 长视频。加上简体中文字幕,删掉「然后」「那个」等赘词。遇到专有名词时,制作解说图卡,并加入适合的转场和聚焦效果。
这里有两个实战细节值得注意:
-
显式要求剔除「水词」:如果直接丢毛片却忘了交代删口头禅,Claude 默认会保留原片的所有停顿和废话(朱骐提到曾有一支爆款视频忘了加这条指令,结果评论区都在吐槽水词太多)。只要在指令里明确点出「删掉口头禅与赘词」,它就会结合语音识别自动把时间轴切干净。
-
文章转动画务必指定秒数:如果是把一篇短文(实测带「列点/Bullet Points」的文章效果最好)转成 Flash 风格的图解动画,唯一的关键诀窍是明确告知目标时长(例如 60 秒)。有了明确的时间边界,模型在分配每个段落的停留帧数与进出场节奏时就会非常合理。
诀窍 2:放弃干瘪的文字描述,看到好特效直接「截图」喂给它
刚开始用 AI 剪辑时,我们往往只能想到「加字幕」和「加名词卡片」。当你刷到其他博主的视频,觉得人家的转场、聚焦放大或者文字进场动效很酷时,千万不要费劲用文字去描述「文字怎么从左边弹出来、背景怎么模糊」。
最高效的做法只有三步:
-
截图:把别人视频里喜欢的转场、图卡排版或动态效果截下来。
-
投喂:直接把截图贴给 Claude。
-
对齐指令:告诉它「参考这张图的视觉效果,加进我的视频里」。
对于知识型内容而言,观众在听抽象概念时非常依赖视觉锚点。通过截图提供具体的视觉参考,Claude 能瞬间理解你想要的图层关系与动效风格,直接用代码复刻出来。
诀窍 3:丢案例库网址让它「逆向工程」,满意后一键沉淀为 SOP
每当新模型发布,社区里总会有人整理优秀案例库(Library,例如汇总了大量 Opus 5.5 生成的酷炫 Canvas 动画网站)。以前的做法是点进网页、翻找源码、复制别人的 Prompt;现在完全可以跳过这一步:
-
丢网址让 AI 自主学习:直接把案例库的 URL 丢给 Claude,告诉它:「帮我先研究一下这个网站里的优秀案例,总结它们的共同视觉特征与规律,然后套用到我的视频剪辑中。」哪怕你不追求 100 分的专业影视级特效,这种方式也能轻松帮你把视频质感从及格线拉升到 70~80 分。
-
把满意的产出固化为本地 SOP:当某一次迭代出的成片让你觉得「就是这个味儿」时,立刻在当前会话中让 Claude 把这次的剪辑规则、处理顺序、动效参数和避坑注意事项写成一份本地 SOP(或 Workflow 文档)。下次再有新视频,直接把 MP4 丢进文件夹让它按 SOP 执行,就能实现真正的 One-Shot 零干预出片。
三、硬核拆解:Claude 是如何用代码「画」出整支视频的?
为了搞清楚 Claude Code 在后台到底干了什么,我们可以拆解朱骐在视频描述栏公开的「教学动画解说视频」完整工程级 Prompt。从这份提示词中,可以看到一套极其严谨的本地音视频工程管线:
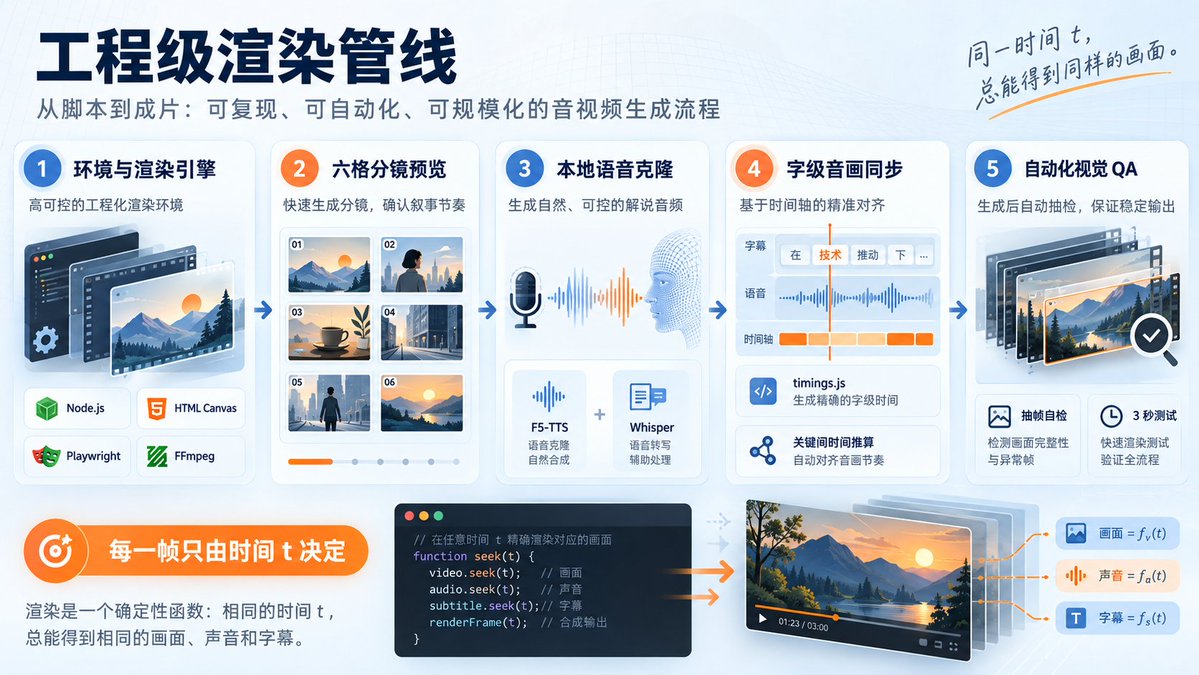
图 3|以确定性时间驱动的程序渲染管线,以及五个关键工程模块。
1. 环境与渲染引擎核心工具与技术栈:Node.js + HTML Canvas + Playwright + FFmpeg关键工程约束与避坑设计:摒弃随机生成,采用确定性时间函数 seek(t) 驱动画面,由 Playwright 按 1920×1080 @ 30fps 逐帧截图,再用 FFmpeg 压制为 MP4。
2. 前置分镜对齐核心工具与技术栈:6 格分镜预览(Storyboard)关键工程约束与避坑设计:先不写业务代码,先让模型生成六格分镜确认视觉方向与叙事逻辑,方向对了再动工。
3. 本地语音克隆核心工具与技术栈:F5-TTS(本机 GPU)+ Whisper关键工程约束与避坑设计:选取 8~12 秒干声作参考模板,强制检测音质(4 kHz 以上高频能量占比需 > 5%,防止克隆声音发闷);分离「配音稿(5.5 改写为五点五)」与「字幕稿(保留 5.5)」。
4. 字级音画同步核心工具与技术栈:timings.js 动态时间推算关键工程约束与避坑设计:用「关键词字符位置 ÷ 句长 × 该句秒数」推算元素出现时机;同组元素以 0.05~0.1 秒错峰进场,段落切换采用重叠过渡(上一段上飘淡出时下一段同时进场),结合 outBack / outExpo 缓动曲线。
5. 自动化视觉 QA核心工具与技术栈:关键帧缩略图拼接自检 + 3 秒测试关键工程约束与避坑设计:全量渲染前,先抽开头、中间、结尾及转场帧拼成缩略图,检查文字落单断行、字幕叠字、元素遮挡;长片先跑 3 秒测试片段,无误后再全量输出并做 loudnorm(I=-16, TP=-1.5)响度标准化。
这套管线中最精妙的一条工程铁律是:
每一帧画面只由时间 t 决定,严禁使用计时器(setInterval / requestAnimationFrame)和未固定种子的随机数(Math.random())。
只有保证渲染函数的纯确定性(Deterministic),Playwright 在逐帧调用 seek(t) 截图时才不会出现帧间撕裂或每次重跑画面不一致的 Bug。
四、附:可直接复用的「代码渲染动画视频」完整 Prompt 模板
如果你想在自己的电脑上用 Claude Code 复刻这套工作流,可以直接复制以下完整提示词(建议根据自身环境微调本地配音或直接改为纯音乐模式):
帮我制作一支教学动画解说视频,主题是「如何用 Claude Opus 5.5 做视频」。用程序逐帧渲染成 MP4(HTML Canvas 的 seek(t) + Playwright 截图 + ffmpeg),并用我的声音配旁白。

一、规格
- 16:9,1920×1080,30 fps,长度跟着旁白走(约 70 秒)
- 字幕在画面下方,深色胶囊底、象牙白字;字幕显示原文(英文、数字照写)
- 不加背景音乐;旁白音量做 loudnorm(I=-16, TP=-1.5)

二、旁白稿(8 段,画面以段落为单位)
1. 如何用 Claude Opus 5.5 做视频?给我一分钟,带你看完整个流程。
2. 先搞懂原理。一般的 AI 视频工具,是直接生成画面;Opus 5.5 不一样,它是写一段程序,再由电脑一帧一帧把视频画出来。
3. 所以你要先准备三样工具:Claude Code、Node.js,还有 ffmpeg。
4. 第一步,先不要叫它写程序,请它给你六格分镜。看过、改过,方向对了再动手。
5. 第二步,prompt 要讲清楚六件事:长度、比例、配色、字体、节奏,还有最重要的规则——每一帧画面只由时间决定。
6. 第三步,渲染之前,先抽开头、中间、结尾三帧检查,没问题再整支输出。
7. 最后提醒三个地雷:画面每次不一样,就把计时器和随机数拿掉;视频长得跟别人一样,就自己指定风格;长片渲染失败,先拿三秒片段测试。
8. 你描述,它写程序,电脑画成视频。现在就打开 Claude Code,做你的第一支视频吧。

*注:配音用的稿子另存一份,只把数字改成中文念法(5.5 → 五点五),英文词照英文念;字幕仍用原稿。*

三、配音:复制我的声音
- 用 F5-TTS 在本机 GPU 跑,录音不上传云端
- 模板:从电脑中找一段 8–12 秒、只有我在讲话、切点在停顿处的片段
- 选模板时先量音质:4 kHz 以上能量占比要 > 5%,太低会「闷」,模型会连音质一起学
- 模板逐字稿手动校正(Whisper 会把「AI」听成「EI」之类),错字会影响发音

四、动画节奏(重要)
- 画面跟旁白同步:用「关键词在该句中的字符位置 ÷ 句长 × 该句秒数」推算念到某词的时间,元素在那个时间点出现
- 分批:同一组元素一起进场,彼此只差 0.05–0.1 秒,不要一个等一个
- 重叠:下一段开始进场时,上一段还在退场(往上飘+淡出),不留空白
- 速度变化:主角用 outBack 弹出或 outExpo 快进慢停;次要信息快速带过;重点停久一点
- 字幕按标点切成小句,同一时间只显示一句

五、品质检查
- 渲染前先抽各段与转场时间点的静态画面拼成缩略图检查:文字落单断行、字幕叠字、元素重叠、装饰压到文字
- 确认没问题再整支渲染,最后合成旁白

六、交付
- 成品 MP4,以及 scene.html、render.mjs、build_audio.py、clone.py、旁白稿、timings.js,放在同一个文件夹
注:如果不使用本地配音,可在开头直接声明:「我没有配音,请直接用动画跟本地背景音乐来做就好。」
五、经验总结与能力边界:什么时候该用,什么时候别死磕?
在实际将这套流程跑通并用于日常更新后,还有两个关于配乐版权与能力边界的实战经验值得留意:
-
背景音乐的版权避坑:如果你的 YouTube 频道开启了盈利,不要让 AI 自己去网上随便抓音乐合成,很容易触发平台的版权拦截。最稳妥的做法是提前在本地工作文件夹里放好几段几分钟的无版权音乐(或者自己编曲生成的音频片段),让 Claude 直接从本地文件夹里挑选配乐。
-
认清场景边界(知识图解长片 vs. 强网感口播短片):极度适合直接上:文章转图解动画、高知识密度的长视频、播客对谈、每日问答复盘(类似日本精神科医生桦泽紫苑的高频日更模式——平时随手录下长段思考,交给 AI 快速切分、加图卡、转成不同格式沉淀)。不建议自己从头硬调:真人对着镜头录制的「强网感短视频(Reels / Shorts / 抖音风)」。这类视频虽然也能用 Opus 5.5 加字幕和剪气口,但它们极其依赖高频的运镜缩放、花字动效与细碎的节奏卡点。如果你没有深厚的剪辑功底,很难靠几句自然语言把这些微妙的网感调教出来——针对这类场景,直接购买或引入别人已经调优封装好的专用剪辑 Skill,会比自己从零踩坑划算得多。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


