
从1到2训练一个自己的大模型教程
文章目录
首先讲一下为什么不是从0到1的教程,因为模型不是我自己训练的,我是站在Qwen的肩膀上训练自己的模型。
为什么需要训练自己的模型呢?一个是学习模型微调,更好的理解大模型;另一个是希望模型能带有我自己的风格。
使用大模型的时候,我们经常会遇到,在专业领域大模型的知识储备不足,补全这些知识储备的一种方式是skill,通过skill沉淀专业知识,让大模型学习他不熟悉的领域。
还有第二种方式,后训练,如果你有了解过本地部署,会发现很多基于Qwen开源权重做后训练之后,在某个专业领域会有非常好的表现模型。
我这篇文章介绍的就是第二种方式,模型后训练的一种 LoRA微调。
我希望能把我自己的X数据喂给 Qwen2.5-1.5B-Instruct,训练一个自己的模型。让模型能了解我的写作风格,写出来没有那么多AI味。不过这其实是需要基于大量的数据,才能达到很好的微调效果🤣。
下面这套流程从零开始,希望能让大家也对模型微调有所了解,可以微调出自己的模型。PS:本文的微调基于Qwen2.5-1.5B-Instruct,基本零门槛。
00|为什么要训练一个自己的模型
通用模型的知识面很广,但它不知道我的写作风格、我常用什么词,比如我发现推文开头使用卧槽,实测之类的会更爆,而大模型对这块是无感知的。
微调的意义,就是把这种我的个人经验融合到模型中,让模型写出来的句子更像我的风格。
本文使用的微调技术是 LoRA ,另外模型我选择 Qwen2.5-1.5B-Instruct,原因也比较简单。它只有 1.54B 参数,基础能力也够用,采用 Apache 2.0 许可证,并且属于已经做过指令微调的 Instruct 模型。我们的目标不是从头训练语言能力,而是在现有能力上调整模型的写作能力,更适应X的爆文生态。
01|环境搭建
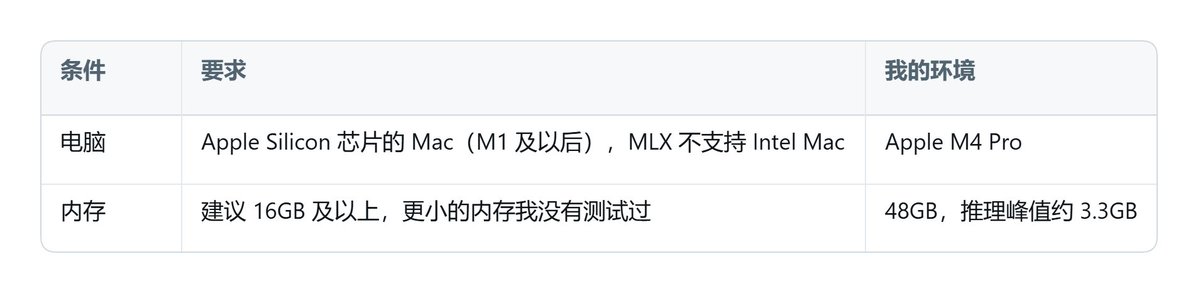
开始之前,先确认下面几项条件。我的实测环境放在最后一列,供参考:
uv可以理解为python虚拟环境管理工具,相当于给你独立开了一间房,你可以在这间房里尽情折腾,不会影响到其他人。
# 用 Homebrew 安装 uv
brew install uv
已经安装过 uv,可以直接创建项目。我把所有本地模型相关项目都放在 ~/Develop/AI/ 下:
# 创建并进入项目目录
mkdir -p ~/Develop/AI/Qwen2.5-1.5B-X
cd ~/Develop/AI/Qwen2.5-1.5B-X

# 初始化 uv 项目
uv init --bare

# 安装并固定 Python 3.13
uv python install 3.13
uv python pin 3.13

# 安装 MLX-LM 训练依赖、模型下载工具和 YAML 支持
uv add "mlx-lm[train]" huggingface-hub pyyaml

# 激活项目虚拟环境
source .venv/bin/activate
uv add 会创建 .venv、安装依赖,并把解析出的版本写入 pyproject.toml 和 uv.lock
对应的 pyproject.toml 是:
[project]
name = "qwen2-5-1-5b-x"
version = "0.1.0"
requires-python = ">=3.13"
dependencies = [
    "huggingface-hub>=2.2.0",
    "mlx-lm[train]>=0.32.0",
    "pyyaml>=6.0.3",
]
以上命令执行完成后,先确认 MLX 是否能使用 Metal:
# 验证 MLX 是否识别 Apple GPU,输出应为 Metal: True
python -c "import mlx.core as mx; print('Metal:', mx.metal.is_available())"
我这里输出的是 Metal: True。
到这里模型基础运行环境准备完成。
02|下载基础模型
先建立固定目录:
# 创建原始数据、训练集、配置、权重、输出和脚本目录
mkdir -p raw data configs adapters models outputs scripts
其中raw目录放X下载的源数据,data目录放清洗后用于训练的数据,models放基础模型和微调后的模型
先通过 Hugging Face 镜像站(源站被墙了,下载速度很慢),把官方模型下载到本地:
# 通过 hf-mirror 下载模型到项目的 models 目录
HF_HUB_DISABLE_XET=1 HF_ENDPOINT=https://hf-mirror.com hf download Qwen/Qwen2.5-1.5B-Instruct \
  --local-dir ./models/Qwen2.5-1.5B-Instruct
其实就是把 https://huggingface.co/Qwen/Qwen2.5-1.5B-Instruct/tree/main 的文件全部下载到本地,其中核心文件model.safetensors 就是权重文件
另外 config.json 里可以看到 num_hidden_layers 为 28,torch_dtype 为 bfloat16,后面配置 LoRA 层数时会用到。
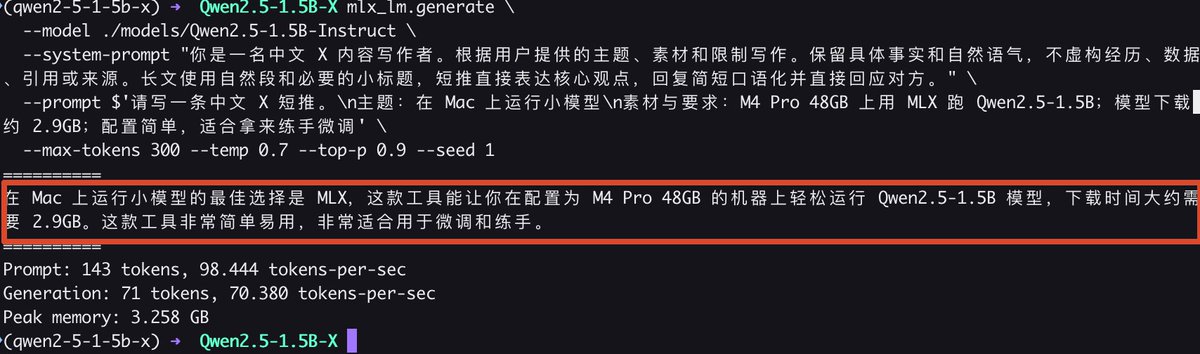
下载结束后做一次基础生成:
# 运行训练前的基础模型,保存输出作为后续对照基线
mlx_lm.generate \
  --model ./models/Qwen2.5-1.5B-Instruct \
  --system-prompt "你是一名中文 X 内容写作者。根据用户提供的主题、素材和限制写作。保留具体事实和自然语气,不虚构经历、数据、引用或来源。长文使用自然段和必要的小标题,短推直接表达核心观点,回复简短口语化并直接回应对方。" \
  --prompt $'请写一条中文 X 短推。\n主题:在 Mac 上运行小模型\n素材与要求:M4 Pro 48GB 上用 MLX 跑 Qwen2.5-1.5B;模型下载约 2.9GB;配置简单,适合拿来练手微调' \
  --max-tokens 300 --temp 0.7 --top-p 0.9 --seed 1
03|X数据下载和清洗
X提供了历史发推数据记录下载,位置在X -> 创作者工作室 -> 数据分析 -> 内容
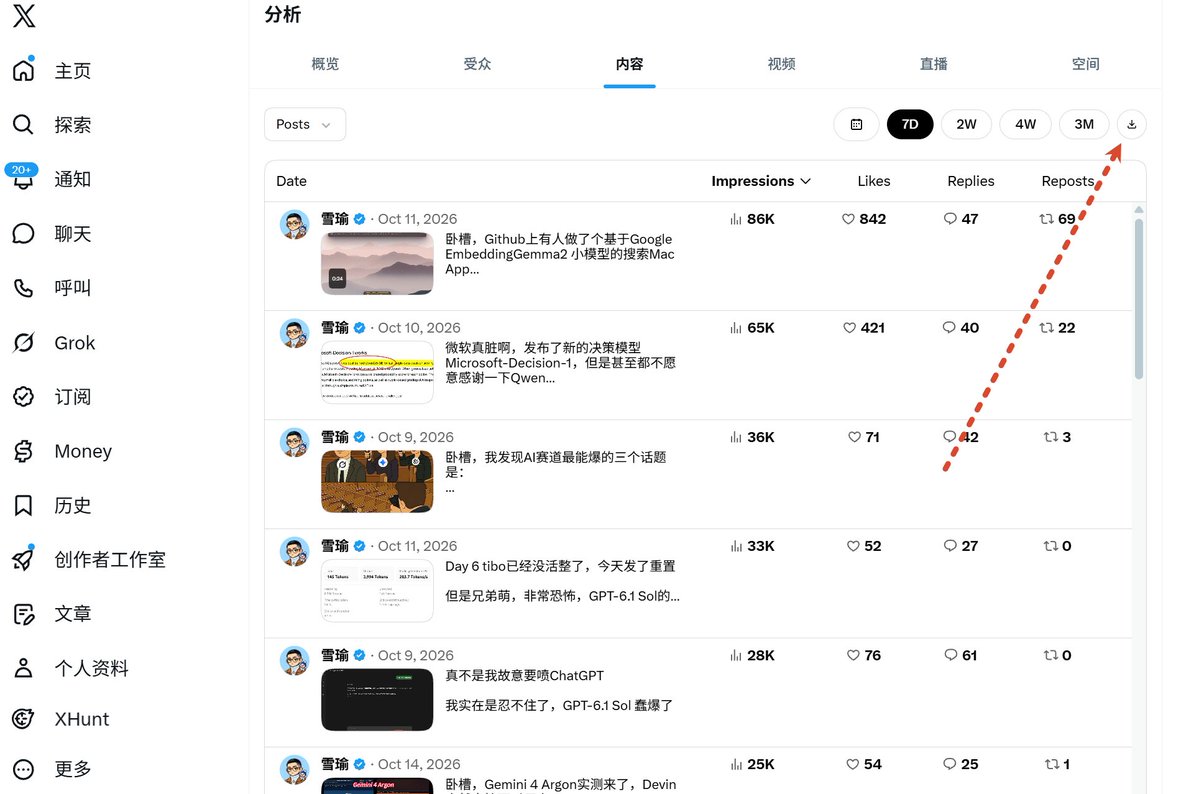
把下载的数据放到 ~/Develop/AI/Qwen2.5-1.5B-X/raw 目录下
这里一般是需要写个脚本数据用于LoRA微调, 可以丢推历史记录给AI
AI数据清洗提示词:
我要用 mlx-lm 对 Qwen2.5-1.5B-Instruct 做 LoRA 微调,请把~/Develop/AI/Qwen2.5-1.5B-X/raw目录下的文件清洗成训练数据:去掉 t.co 链接、HTML 转义、开头的 @用户名、多余空白、不足 25 字的帖子、导出截断的帖子和重复内容,把每条内容归类为短推、回复或长文(长文超过约 1600 token 就按二级标题拆分),为每条内容写一个主题和要点(要点只能用原文里有的事实,不能新增数字或经历),转成 {"messages":[system 写作者设定, user "请写一条中文 X 短推/回复/长文+主题+要点", assistant 原文]} 的 JSONL,同一主题或同一篇文章的样本标为一组,按组以 seed=42 用 8:1:1 的比例切分为 train.jsonl、valid.jsonl、test.jsonl(同组不能跨集合),确保每条样本套上聊天模板后不超过 2048 token,最后输出这三个文件到~/Develop/AI/Qwen2.5-1.5B-X/data目录下,以及各类样本数量和需要我人工复核的样本清单。
最终会在 data/ 目录下生成三个文件,文件名不要改,mlx_lm.lora 会按这三个名字自动读取:
data/train.jsonl   训练集
data/valid.jsonl   验证集
data/test.jsonl    测试集
04|LoRA 配置
新建 configs/qwen25-15b-lora.yaml:
model: "./models/Qwen2.5-1.5B-Instruct"
train: true
fine_tune_type: lora
optimizer: adamw

data: "./data"
seed: 42
num_layers: 16
batch_size: 1
grad_accumulation_steps: 4
iters: 600
val_batches: -1
learning_rate: 0.00002
steps_per_report: 10
steps_per_eval: 50
save_every: 100
max_seq_length: 2048
grad_checkpoint: false
mask_prompt: true
adapter_path: "./adapters/qwen25-x-writer-v1"

lora_parameters:
  keys: ["self_attn.q_proj", "self_attn.v_proj"]
  rank: 8
  scale: 16.0
  dropout: 0.05
只解释几个关键配置,其余保持默认即可。看不太懂的话,可以让 AI 根据你的数据量帮你调整。
-
num_layers: 16 和 keys:LoRA 只加在最后 16 层(共 28 层)的 q_proj、v_proj 上。
-
rank: 8:LoRA 的容量,越大学得越多,也越容易记住训练集。几百条数据用 8 就够了。
-
iters: 600:在 mlx-lm 0.32.0 里,一步就是一个 batch。配合 batch_size: 1、grad_accumulation_steps: 4,实际只更新 150 次参数。我的训练集 241 条,600 步大约过 2.5 遍;数据多了可以按比例加。
-
learning_rate: 0.00002:学习率偏小但稳,不容易把模型原有的能力改坏。
-
mask_prompt: true:只对 assistant 的回答计算 loss,不让模型去背 system prompt 和题目。
-
max_seq_length: 2048:单条样本的长度上限,超出部分会被截掉,所以第 03 章要求清洗时控制长度。
-
steps_per_eval: 50、save_every: 100:每 50 步跑一次验证,每 100 步保存一次 checkpoint,方便发现过拟合时退回。
第一次训练只建议改 iters。最简单的方法是让AI评估你的训练数据调整配置。
05|测试和训练
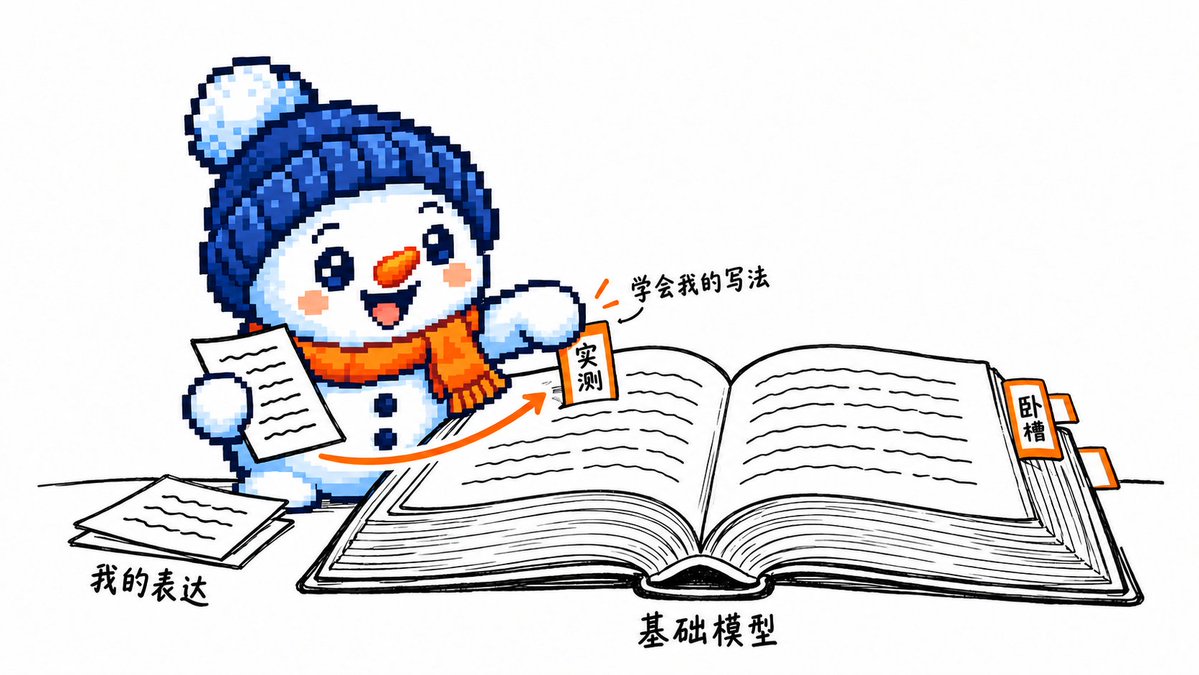
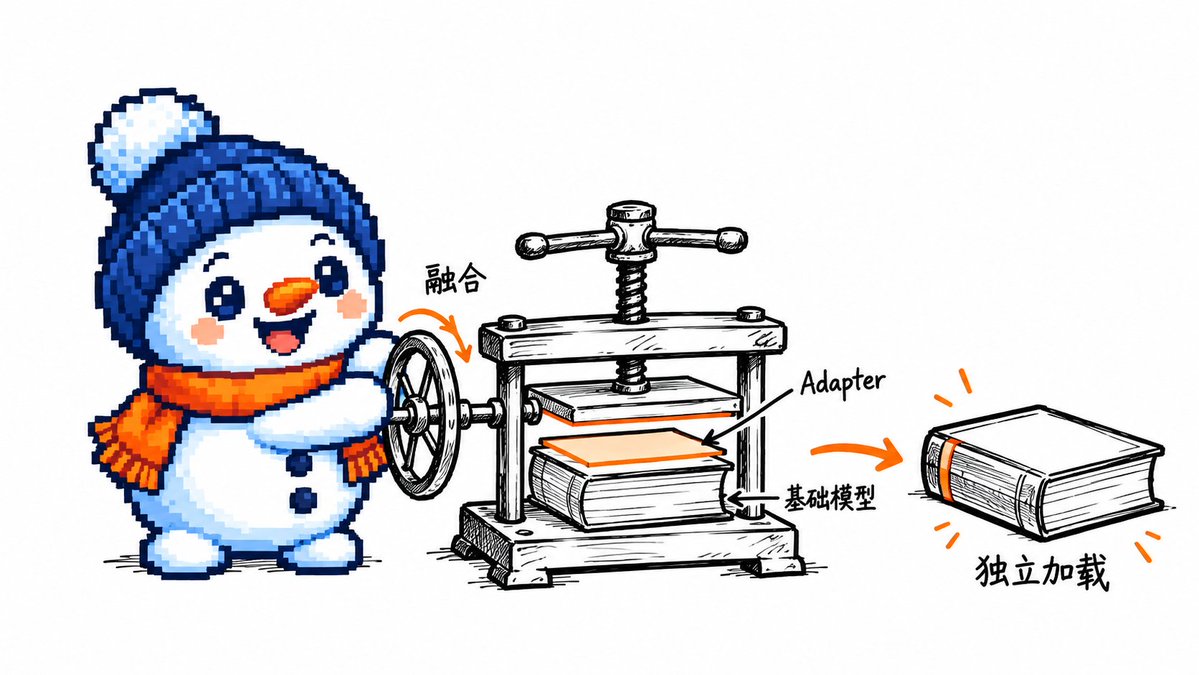
这一步是用来生成Adapter,什么是Adapter呢,打个比方基础模型 Qwen2.5-1.5B-Instruct 像一本 2.9GB 的厚教材,Adapter 像贴在其中几页上的便签,告诉模型这里换成我的写法。
不要第一次就跑 600 步。先用独立 Adapter 目录运行 20 步 冒烟测试:
# 用独立目录跑 20 步冒烟测试,确认模型、数据和训练流程都能工作
mlx_lm.lora \
  --config configs/qwen25-15b-lora.yaml \
  --adapter-path ./adapters/smoke-test \
  --iters 20
结果如图 !alt text
LoRA 20步冒烟测试的结果在 adapters/smoke-test 目录下。
跑出结果没异常后,直接使用配置文件中的正式 Adapter 目录训练:
# 按配置文件运行 600 步正式 LoRA 训练
mlx_lm.lora \
  --config configs/qwen25-15b-lora.yaml
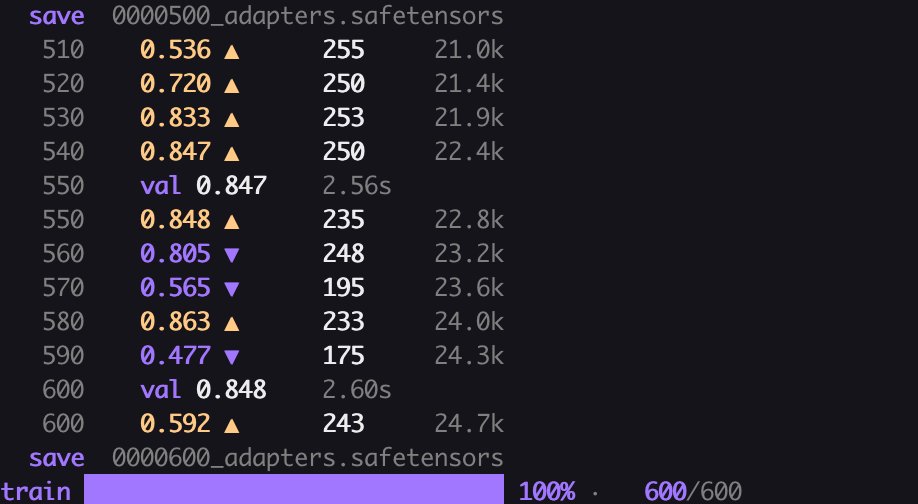
mlx-lm 0.32.0 的训练界面分四列:iter 是步数;train_loss 是最近 10 步的平均训练 loss,后面的 ▼/▲ 只表示比上一行低或高;tok/s 是训练速度;tokens 是累计训练的 token 数。每 50 步出现一行 val,是跑完整个验证集得到的验证 loss,每 100 步出现一行 save,表示保存了一个 checkpoint。
我这次的验证 loss 在 450 步降到 0.846,之后几次都在 0.847 到 0.848 之间,说明大约 450 步后已经收敛,也没有过拟合,直接使用最终的 Adapter 就行了。
如果看不太懂,可以直接把训练数据的截图扔给AI给你分析。
训练结束后,再用从未参与训练的测试集确认一次:
# 在测试集上评估最终 Adapter,输出 Test loss 和 Test ppl
# --mask-prompt 和 --batch-size 1 要与训练配置一致,否则 loss 会把题目也算进去,数值偏高
mlx_lm.lora \
  --model ./models/Qwen2.5-1.5B-Instruct \
  --adapter-path ./adapters/qwen25-x-writer-v1 \
  --data ./data \
  --test --mask-prompt --batch-size 1
我这里输出的是 Test loss 0.851, Test ppl 2.343,和最后的验证 loss 0.848 基本一致,说明模型在没见过的样本上表现稳定,没有只记住训练集。
loss 只能说明模型学会了数据的用词规律,不能说明文章写得好不好。最终还要用相同的 system prompt、相同的题目和采样参数,把基础模型和微调模型的输出放在一起对比。
LoRA 训练出来的不是一个完整模型,而是一个 Adapter。现在训练完成的输出结果在 adapters/qwen25-x-writer-v1 目录下。
06|模型训练前后对照
训练结束后,直接加载基础模型和 Adapter:
# 加载正式 Adapter,生成微调后的文章用于前后对照
mlx_lm.generate \
  --model ./models/Qwen2.5-1.5B-Instruct \
  --adapter-path ./adapters/qwen25-x-writer-v1 \
  --system-prompt "你是一名中文 X 内容写作者。根据用户提供的主题、素材和限制写作。保留具体事实和自然语气,不虚构经历、数据、引用或来源。长文使用自然段和必要的小标题,短推直接表达核心观点,回复简短口语化并直接回应对方。" \
  --prompt $'请写一条中文 X 短推。\n主题:在 Mac 上运行小模型\n素材与要求:M4 Pro 48GB 上用 MLX 跑 Qwen2.5-1.5B;模型下载约 2.9GB;配置简单,适合拿来练手微调' \
  --max-tokens 300 --temp 0.7 --top-p 0.9 --seed 1
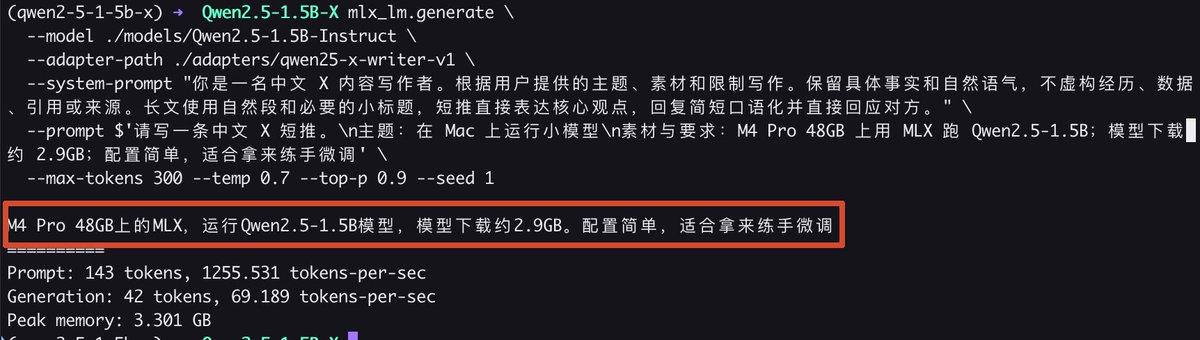
可以看到新的结果,整体更简洁,也更符合我自己的说话风格,如果你觉得不满意,可以增加训练数据集,重复数据清洗到训练Adapter的流程。
07|融合模型
Adapter 调试方便,而且体积小。只在效果确认后,才需要把它融合进基础模型:
# 把基础模型与正式 Adapter 融合为可独立加载的模型
mlx_lm.fuse \
  --model ./models/Qwen2.5-1.5B-Instruct \
  --adapter-path ./adapters/qwen25-x-writer-v1 \
  --save-path ./models/Qwen2.5-1.5B-X-Writer-v1
最终训练的模型就生成在 models/Qwen2.5-1.5B-X-Writer-v1 目录下。
用融合后的模型再生成一次:
# 使用融合模型生成一次短推,确认模型可以独立加载
mlx_lm.generate \
  --model ./models/Qwen2.5-1.5B-X-Writer-v1 \
  --system-prompt "你是一名中文 X 内容写作者。根据用户提供的主题、素材和限制写作。保留具体事实和自然语气,不虚构经历、数据、引用或来源。长文使用自然段和必要的小标题,短推直接表达核心观点,回复简短口语化并直接回应对方。" \
  --prompt $'请写一条中文 X 短推。\n主题:在 Mac 上运行小模型\n素材与要求:M4 Pro 48GB 上用 MLX 跑 Qwen2.5-1.5B;模型下载约 2.9GB;配置简单,适合拿来练手微调' \
  --max-tokens 300 --temp 0.7 --top-p 0.9 --seed 1
这里融合模型跑出来的结果应该和使用Adapter生成的结果是相近的。融合模型不是新的训练成果,它只是把基础权重与 Adapter 合成一个更方便加载的目录。训练实验期间应同时保留基础模型、Adapter、配置、原始数据版本和 uv.lock。
微调模型的整个流程最后梳理下:现在想要微调的模型 -> 清洗训练数据(数据质量越高越好)-> LoRA训练Adapter -> 融合模型
08|上传到 Hugging Face
hf-mirror 只能下载,不能上传,所以上传时要直连 huggingface.co。
第一步,通过命令行登录,并选择Log in with your browser:
# 登录 Hugging Face
HF_ENDPOINT=https://huggingface.co hf auth login
第二步,让AI帮你修改 models/Qwen2.5-1.5B-X-Writer-v1/README.md,这个是HuggineFace的model card。
第三步,创建模型仓库并上传整个模型目录(注意改成自己的用户名):
# 创建模型模型仓库
HF_ENDPOINT=https://huggingface.co hf repos create 你的用户名/Qwen2.5-1.5B-X-Writer-v1
# 上传融合模型目录,约 2.9GB,中断后重新执行同一条命令会接着传
HF_HUB_DISABLE_XET=1 HF_ENDPOINT=https://huggingface.co hf upload 你的用户名/Qwen2.5-1.5B-X-Writer-v1 \
  ./models/Qwen2.5-1.5B-X-Writer-v1 . \
  --commit-message "Upload Qwen2.5-1.5B-X-Writer-v1"
我已经把最终训练的模型上传到HuggingFace, 大家可以查看 https://huggingface.co/SnowGemma/Qwen2.5-1.5B-X-Writer-v1


