
加密之魂:一篇读懂密码朋克、密码战争、CROPS、密码学与隐私技术(ZK、FHE)应用
文章目录
买酒的时候,我们只需要证明自己成年,却常常要把整张证件递过去,上面有姓名、照片、出生日期和住址。用一款社交软件想找到熟人,它可能要求读取整个通讯录,包括那些并不使用这款软件的人。给人转一笔 ETH,钱包让我们点一下签名,但如果签下的是一笔被骗的交易,密码学并不会替我们拦住它。
这几件事看上去没什么关系,但都指向同一个问题:为了使用一项服务,我们到底需要交出多少信息,又需要相信多少人?
我是 Bruce,@ETHPanda_Org & @LXDAO_Official 联合发起人,@lifiprotocol DevRel。2026 年 9 月 22 日,我在 @EthereumSH 主持了「密码学庇护所」圆桌,和三位嘉宾聊了这些问题。三位嘉宾分别是安比实验室创始人郭宇 @1dot2 博士、Primus Labs 联合创始人 Xavier @Xavier_bham 博士,以及交大长期研究全同态加密的 Petri 博士。我们从《密码朋克宣言》开始,经过政府和加密技术之间持续几十年的拉锯,最后落到钱包签名、零知识证明和全同态加密这些具体的东西应用上。
所以我借机写下这篇文章,完善一些细节、附带顶级密码学专家们的观点,希望帮助到大家了解密码朋克、密码学等等这些加密之魂。欢迎大家一键三连。
一、密码朋克宣言:隐私是一种可以选择的权利
先从名字说起。Cypherpunk(密码朋克)和 Cyberpunk(赛博朋克) 经常被混在一起,其实是雷锋跟雷峰塔一样两回事。前者的名字来自 cipher,也就是密码;后者的 cyber 指向计算机、网络和控制论。 密码朋克是一群用密码学写工具的人,赛博朋克是《神经漫游者》那一类小说和电影塑造的想象:高科技、低生活,霓虹灯、巨型公司、义体改造。两者有反思权力与技术的共同兴趣,但密码朋克的工作可以发生在一台普通电脑前,不需要一座科幻城市。
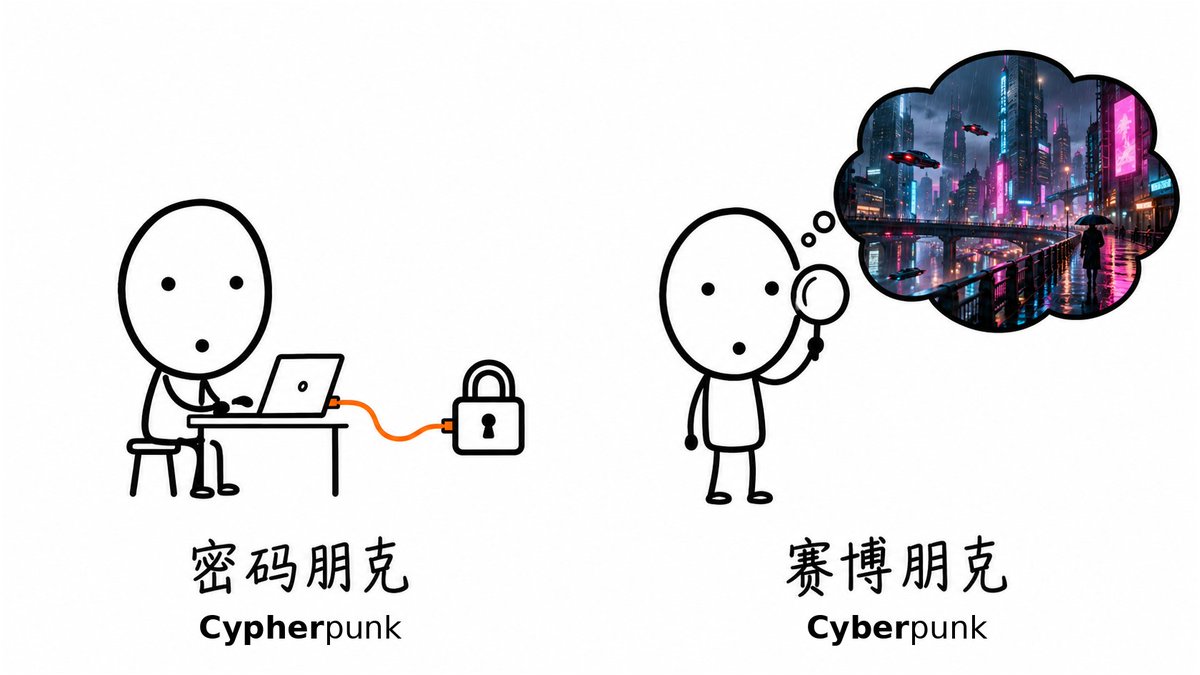
概念对比:密码朋克通过工具保护隐私;赛博朋克是探讨高科技与社会处境的科幻类型。
密码朋克运动在 1990 年代初逐渐成形。那时个人电脑开始普及,互联网向更多公众开放,数字通信让复制、汇总、追踪信息变得越来越便宜。1992 年前后,一批密码学家、程序员和活动者开始在邮件列表上讨论,怎么让普通人也能用上强加密。讨论后来变成了一个松散的运动,参与者包括 Eric Hughes、Tim May、John Gilmore 等人。
1993 年 3 月 9 日,Eric Hughes 写下了《密码朋克宣言》。这份不长的文本里有三句话,今天读起来仍然很有分量。
第一句是 “Privacy is not secrecy.” 隐私不等于秘密。按宣言的区分,一个人不希望全世界都知道的事情,是隐私;一个人不希望任何人知道的事情,才叫秘密。这两者被混为一谈,就很容易被曲解成“你是不是有见不得人的事”。
第二句是 “Privacy is the power to selectively reveal oneself to the world.” 隐私是一种可以选择性地向世界披露自己的能力。重点在于,这个选择权在谁手里。钱包就是一个具体例子:链上资产默认公开,我愿意把自己的某个地址给你看,不等于我愿意把全部身份、全部资产、全部社交关系都公开。
第三句是 “Cypherpunks write code.” 密码朋克写代码。他们把保护隐私的工具做出来,公开出来供别人使用。宣言里还有一句相关的表达:“We must defend our own privacy if we expect to have any.” 如果我们希望自己还有隐私,就得自己去保护它。
宣言给出的办法很具体:一笔交易的参与者,只应获得完成这笔交易所必需的信息。买杂志时,店员不需要知道我的姓名;提供邮件服务,也不意味着必须读到我的通信内容。信息一旦交出去,就可能被复制、转述和聚合。因此,少收集、少披露,应该发生在信息流出的那一刻,不能只靠事后承诺。
我在 2025 年的一篇分享里写过,《密码朋克宣言》在我眼中像是一份对未来的预言。1993 年的互联网远没有今天发达,他们已经看到了数字世界的隐私问题,也给出了行动方向:不能只等政府、企业或大型组织出于善意给我们隐私,我们得自己参与建设保护隐私的系统。今天回头看,信息泄露、平台权力和数字货币,都能和这些问题接上。
我也沿着这份宣言想过下一步:用 ZK 证明自己已成年,而不用交出整张证件;让开源软件和数字公共物品得到持续支持,让更多人参与保护隐私的建设。
郭宇把问题推进到我们和平台的关系上。他关心的是有没有被迫依赖:大数据杀熟、钓鱼、信息茧房,以及个人身份被平台单方面判断。 如果离开某个产品的代价大到无法承受,那么所谓信任里就混进了依赖。审视一个软件,需要同时看它提供了什么便利、拿走了哪些信息,以及用户还有没有退出的办法。
在他的理解里,密码朋克也并非不食人间烟火的苦行者。他们先保护自己,再把工具传出去给别人用。这种做法很朴素:我有一个切身的问题,写代码解决它,别人也可以用。
Xavier 把落点放在选择性披露和数据权益上。 平台收集数据并把它变成收益,涉及的就是拥有权、使用权和收益权归谁。用户得到服务,不代表平台可以无限使用用户的数据。他也提醒,隐私有时会牺牲一点便利,产品必须认真处理这笔成本。
Petri 从工程角度补充:密码系统的一个目标,是让用户尽可能少地相信别人。 我有一份信息,不想让别人知道,但还想拿它做点事。过去往往需要把明文交出去,再相信对方不会滥用;密码学尝试把一些原本依赖承诺的环节,变成可以限制或验证的机制。不过,一个完整应用仍然需要一层层做安全,单个算法包办不了全部问题。
从公钥密码学到以太坊,一代代进化出来
这段历史并不是从宣言发表才开始。公钥密码学和电子现金研究早已存在,密码朋克把这些工具和个人自主、私人通信、数字支付的诉求结合了起来。
-
1976 年,Whitfield Diffie、Martin Hellman 发表《New Directions in Cryptography》,公开提出公钥密码学和数字签名的方向,并给出密钥交换方法。互不认识的人可以通过公开信道建立共享秘密,不必先派人送一把钥匙。Ralph Merkle 的相关研究也是这段历史的重要部分。
-
1982 年,David Chaum 提出用于不可追踪支付的盲签名。签发者可以给经过遮蔽的数据签名,却看不到原始内容,为电子现金提供了保护付款隐私的工具。
-
1993 年,Eric Hughes 发表《密码朋克宣言》,把选择性披露、匿名交易和写代码保护隐私,表达成一套行动主张。
-
1997 年,Adam Back 提出 Hashcash。发送者先付出计算工作,接收者很容易验证,用来提高垃圾邮件和拒绝服务攻击的成本。这是工作量证明的早期应用,还不是完整的货币系统。
-
2008 年 10 月 31 日,中本聪发布比特币白皮书,把数字签名、哈希、工作量证明和点对点网络组织起来,解决同一笔钱被重复支付的问题。算是集大成者,而且整个系统跑通了。
-
2014 年,Vitalik Buterin 发表以太坊白皮书,提出通用的智能合约与去中心化应用平台。开发者可以在链上编写和执行规则,把区块链的用途扩展到支付之外。
这条时间线里,每个尝试都有不同目标:电子现金研究重视付款隐私,Hashcash 起初针对垃圾邮件,比特币组合已有工具形成开放网络的共识机制,以太坊进一步提供了可编程的应用平台。
比特币白皮书直接引用了 Wei Dai 的 b-money 和 Adam Back 的 Hashcash。这些文献、邮件列表和参与者,把密码朋克的思想与电子现金的实验连接了起来。比特币继承了这条探索路径,也补上了让开放网络持续运转的机制。
这份传承也留在了以太坊里。ETH 的最小单位叫 wei,以 Wei Dai 命名,1 ETH 等于 10¹⁸ wei;早期单位名里还有向 Nick Szabo 和 Hal Finney 致意的 szabo、finney。日常看到的 gwei,是 10⁹ wei,常用于表示 gas 价格。连最小的计量单位,都保留了前人尝试的名字。
二、密码战争:公权力边界的斗争
今天的开发者随手就能调用成熟的加密库,这件事看起来天经地义。但把时间拨回三十年前,美国曾把许多强加密产品纳入军需品出口管制。把代码分享给海外的人,可能成为一件需要政府许可的事。围绕强加密的使用、传播和政府访问权限,发生了持续多年的“密码战争”。
代码能不能自由传播?
1991 年,Phil Zimmermann 发布了 PGP,名字是 Pretty Good Privacy。普通人可以用它加密邮件、验证签名,不必先成为政府部门或大型机构的客户。因为软件传播到了海外,他随后面临数年的调查。
1995 年,数学家 Daniel Bernstein 起诉美国政府。他想发表自己的加密算法、论文和实现算法的源代码,却被要求先接受出口管制审查。诉讼提出了一个问题:程序员用代码表达和交流思想,这种表达应不应该像文字一样受到保护?1999 年,上诉法院作出支持源代码属于受保护表达的裁决。围绕案件的法律程序和政策调整仍继续了一段时间,强加密出口限制随后逐步放松。
代码有双重性质:它可以被机器执行,也可以被人阅读、讨论和修改。如果只因为代码能用于加密,就把公开发表当作军火出口,限制的还包括研究交流、漏洞修复和普通人的安全工具。今天我们使用的开源加密库,并非天然就能自由流通,背后有研究者、开发者和法律工作者长期争取的结果。
郭宇推荐《密码战争》这本书时,强调的也是这一点:普通人能平等地使用非对称加密这些工具,是经过复杂斗争才实现的。 非对称加密使用公钥、私钥这对不同的钥匙;其中一些算法用于加密,另一些用于签名或密钥交换。它让很多安全能力不再需要由一个中心机构独家提供。
政府可不可以保留一把钥匙?
1993 年,克林顿政府提出 Clipper 芯片方案:通信设备使用加密,但解密所需的密钥由政府部门托管,执法机构获得授权后可以取用。1994 年,研究者 Matt Blaze 指出了方案的安全缺陷。Clipper 最终没有实现当初设想的普及。
密钥托管带来的问题一直存在。给执法者留下一条额外入口,也意味着有人必须保存和保护这条入口。它会成为攻击目标,会受到内部人员滥用的风险,也可能随着授权范围变化而被用于更多目的。法律上写着“只在特定条件下使用”,并不能自动让技术上的入口只在那个条件下存在。
Xavier 补充了算法参数透明度的问题:密码学系统里那些常量是怎么来的,别人能不能独立复核?如果一个标准只告诉你“使用这些参数”,却解释不清为什么这样选,技术人员有理由继续追问。
一个重要案例是 Dual_EC_DRBG,一种曾进入 NIST 标准的随机数生成器。随机数关系到密钥是否可预测;如果攻击者能预测输出,后面的加密再强也可能失效。 研究者指出,它的参数可以被选择为带有秘密陷门的形式,掌握特殊关系的人可能预测输出。2013 年的披露进一步引发信任危机,NIST 随后建议停用,并在修订中将它移除。
这也解释了密码学里为什么强调 nothing-up-my-sleeve,直译是“袖子里没有藏东西”:参数来源应当能公开解释和复核,尽量减少人为藏机关的空间。
比特币和以太坊传统账户使用的 secp256k1,与常见的 P-256 是两条不同的椭圆曲线。secp256k1 的参数比较简洁,这类可检查性很有价值。P-256 的参数来源曾引起讨论。
加密保护普通人,也改变调查的办法
2015 年底,美国圣贝纳迪诺发生恐怖袭击。2016 年 2 月,FBI 要求苹果协助解锁一部涉案 iPhone,制作一个能绕过若干安全限制的系统版本。苹果公开拒绝,并发布《致用户的一封信》。
苹果已经按法律程序提供了手中掌握的数据。争议集中在还不存在的绕过工具:一旦制作出来,怎样确保它只用于这一部手机?谁来控制后续使用?技术能被复制,使用它的理由也可能不断扩大。一个具体案件的需求,就这样碰到了所有用户的安全边界。
Petri 承认犯罪调查、寻找失踪者等情境有合理的信息需求;他反对的是为了满足这些需求,给所有密码系统配一个后门,降低普通人的安全强度。郭宇则提醒,大数据监控的争论仍在继续,硬件集中化、链上行为和真实身份的关联,又增加了新的战场。
我的理解是,这是一场围绕公权力边界的长期拉锯。 权限太宽,会侵入普通人的生活;权限太窄,也会限制解决具体问题的能力。平衡必须落实到授权、监督、救济和技术设计上。针对个案调取信息,与要求整个系统预留万能钥匙,影响范围相差很大。
这种平衡不会一次谈完。通信方式、数据规模和调查能力都在变化,未来还会出现新的争议。技术给个人增加了保护自己的能力,也迫使制度更具体地回答:谁在什么条件下,可以获得谁的哪些信息?
三、密码学的应用:一笔 ETH 转账背后发生了什么
给朋友转一笔 ETH,没有银行、没有柜台,网络凭什么确认这笔交易得到了授权?Xavier 用密钥、地址、签名和验证解释了这个过程。
第一步,生成私钥。 普通自托管钱包会生成足够随机的私钥,并常用助记词来备份、派生账户。私钥可以看成一个极难猜中的秘密数字。它要保密,随机性也必须足够好。
这里有个重要区分:私钥是秘密,和可以选择性披露的隐私信息不同。你可以决定把一部分个人资料给谁看,但把钱包私钥交出去,会把相应的签名能力也交出去。
第二步,由私钥推导公钥,再得到地址。 对以太坊普通外部账户而言,公钥经 Keccak-256 哈希后取其中一部分,得到地址。公钥和地址可以公开;在现有算法和计算能力的假设下,不能靠它们有效反推出私钥。
以太坊普通外部账户的交易签名采用 ECDSA,数学曲线是 secp256k1。比特币传统交易也使用 ECDSA,而 Taproot 还使用 Schnorr 签名,同样建立在 secp256k1 上。当然比特币有多种地址格式,不能把以太坊的地址生成流程照搬过去。
第三步,对交易内容签名。 可以把一笔简单转账想象成一句话:“A 地址给 B 地址转 1 个 ETH。”实际签名覆盖的是按协议编码后的交易数据,还包括手续费、交易序号等信息。私钥对这些数据产生签名,网络可以检查签名是否对应发送者,无需获得私钥。
数字签名在这里证明的是授权关系,没有把交易内容加密。验证签名和隐藏内容,是两项不同任务。
第四步,网络检查并执行。 节点检查签名、余额、交易序号以及其他协议规则,交易被纳入区块后,网络按规则更新账户状态。发送者支付转账金额和手续费,接收者得到转账金额。
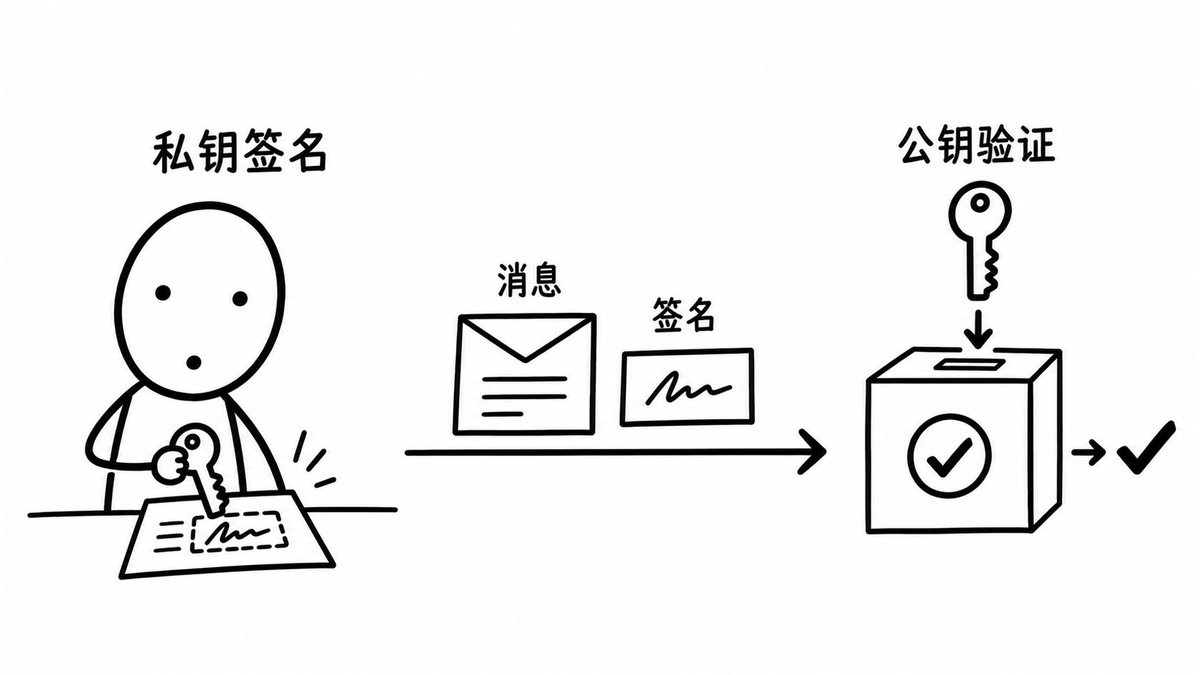
数字签名简图:私钥对消息签名;验证方使用公钥检查消息与签名。私钥不交给验证方。
理解了这套机制,就会明白它为什么同时很可靠又很危险。
可靠的地方在于,网络可以按公开规则验证授权,无需让某一家机构替交易担保。 危险的地方在于,签名算法不判断用户为什么签了名。你可能被钓鱼网站骗着签,可能以为自己签的是登录,实际授权了其他操作,也可能私钥早就泄露。这些情况不会自动被算法识别出来。
Xavier 强调的是算法的边界。我用一句通俗的话概括:谁能使用私钥,谁就有相应的控制权。 对普通单私钥账户尤其如此;若希望限制误签造成的损失,还需要钱包界面、交易模拟、权限限制、多签或智能合约规则共同工作。
“加密货币”这个名字也容易误导。比特币和以太坊的公开账本,通常会展示地址、金额和交易关系。它们利用密码学来验证授权和维护系统,转账记录却并不因此保密。
自托管让用户不必把账户控制权交给银行或交易所,减少了托管方直接改动余额的空间。但资产仍可能因为私钥被获取而转走,托管资产可能被冻结,带有管理员权限的代币也可能被限制。
地址是假名,不自动等于匿名。一旦地址和真实身份关联起来,例如在交易所出入金、公开收款地址,或者被行为分析识别,多笔交易就可能被串联。保护钱包私钥和保护交易隐私,也得分别考虑。
四、零知识证明 ZK:不交出秘密,也能证明一件事
买酒的场景很适合引入零知识证明。
按传统方式,我需要出示证件,店员查看上面的出生日期。这个过程里,对方得到了比我需要证明的更多信息:姓名、照片、住址、证件编号。理想的方式是,我只证明“我超过 18 岁”这一个结论,其他信息尽量不给。
零知识证明(Zero-Knowledge Proof,简称 ZK 或 ZKP),就是让证明者在不暴露相关秘密的情况下,证明一个明确的陈述。这里的“零知识”,指验证者从证明过程中学不到额外的秘密;声明本身、公开输入和证明使用的上下文,仍然可能透露信息。
郭宇解释,能用程序表达的很多计算,都可以转成一个证明问题:程序是否按规定执行,输入是否满足某个条件。证明者知道输入、运行程序并生成证明;验证者检查证明,而不必拿到全部原始输入。
放在年龄验证里,程序可以读取带有可信签发者签名的出生日期,验证签名,再判断年龄是否达到门槛。最后给店员的是“达到门槛”及其证明,具体生日和证件号码留在用户一侧。
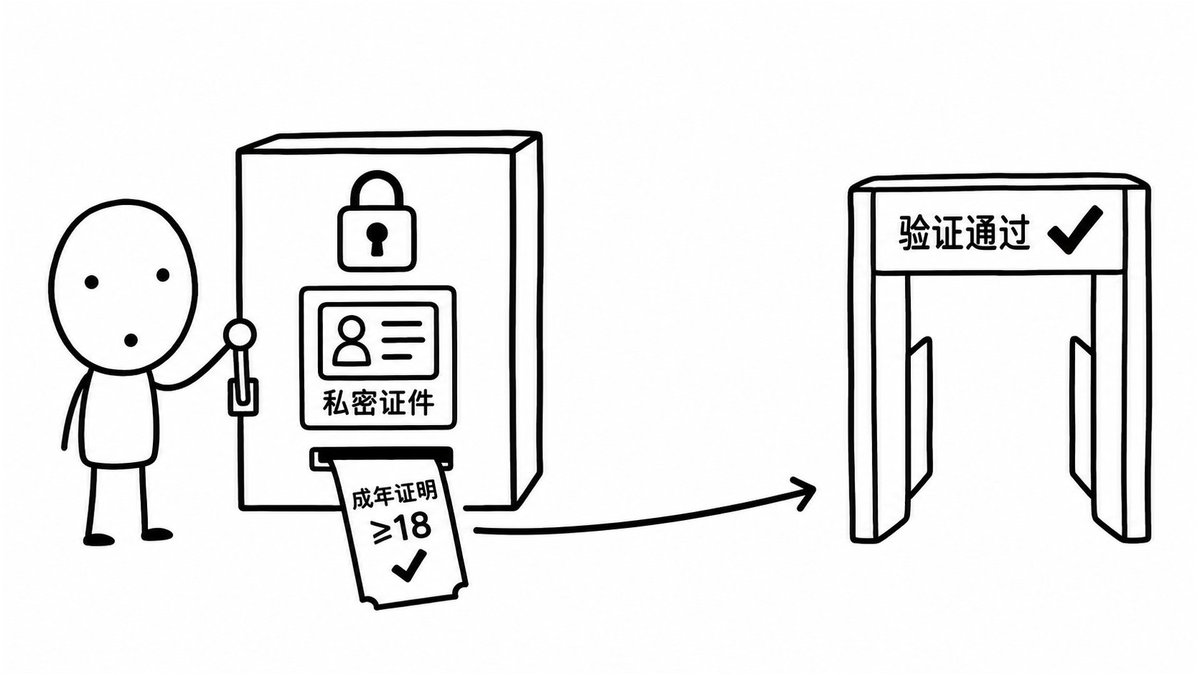
理想化的年龄验证流程:用户设备保留凭证,只交出达到年龄门槛的证明;凭证真实性、人证绑定和 App 安全仍需分别处理。
用户设备:读取凭证,检查签发者签名 → 私下计算“是否满 18 岁” → 生成证明 商家:检查证明 → 得到“已达到门槛”
这个流程是简化说明;具体产品还需要处理凭证有效期、防止重复使用,以及凭证和使用者的绑定。
证明系统的具体安全性取决于算法、参数和实现,不能统一承诺一个“绝对可靠”的百分比。不同方案也有不同成本:生成证明要等多久,验证要花多少钱,会不会依赖额外的服务商,都会影响产品能否好用。
郭宇也提醒,年龄证明听起来很好,现实推广仍有困难。沿着这个例子往下看,至少有几层需要分别处理。
输入是真的,证明才有意义
识别出一张证件图片,不等于证件是真的。假证件也可以被程序准确识别,再得到一个关于假数据的正确结果。
电子护照提供了一个更好的起点:芯片中的身份资料带有签发机构的数字签名,程序可以检查资料是否由受认可机构签发、是否被修改。这样,证明可以同时覆盖资料来源和年龄判断。它仍不自动解决证件是否被冒用、持证人是否在场等问题。
这条边界适用于很多场景。资产截图、体检报告、成绩单,如果输入本身没有可靠来源,证明计算过程正确也不能把它变成真实记录。
证件是真的,也要判断谁在使用
如果有人拿着你的真实护照去做年龄证明,凭证和计算都可能没有问题,但使用者并非本人。郭宇提出的人证绑定问题,需要另外的机制处理,例如与设备或账户绑定、适当的人证核验,以及明确的恢复和撤销流程。
生物识别、活体检测也不是无条件的答案:它们会增加敏感数据和新的信任对象。产品要根据风险选择办法,不能为了少暴露一张证件,反而集中收集更敏感的资料。
证明没有泄露,App 也可能泄露
证明可以在用户设备上生成,商家无需收到明文,但负责生成证明的 App 仍接触过资料。如果它偷偷上传证件,零知识协议没有办法阻止另一个数据通道。
因此,要检查的不只有算法,还包括软件权限、代码、依赖、更新机制和实际网络行为。即便公开了源码,也要知道用户运行的程序是否对应那份源码。郭宇强调的信任链条,就落在这些具体环节里。
证明和隐私要一起检查
有些证明主要用于让别人快速确认计算正确,输入或输出仍然公开;有些应用则利用零知识性质隐藏特定输入。同一类数学工具可以有不同用途,“使用了 ZK”不足以说明用户的哪些信息被保护了。
数字身份可以用它证明某项资格,隐私支付可以用它证明付款符合规则,投票系统可以用它验证选票或计票过程。每个场景都需要明确:谁给出输入、证明覆盖什么、公开什么,以及哪些风险留给其他层处理。
zkTLS:把网站里的记录变成可以验证的凭证
年龄凭证有签发机构的签名,很多日常数据却只出现在网站里:交易所余额、银行账户记录、某个平台上的使用历史。把截图发给别人,对方很难判断截图有没有修改;把账号密码交出去,又泄露了更多信息。
HTTPS 使用的 TLS 协议保护浏览器和网站之间的通信。zkTLS 则尝试在这条通信之上,让用户证明自己确实从指定网站取得了某些数据,同时只披露必要的信息。它常被称为 web proofs,也就是“网页数据证明”。
这里需要增加协议机制:普通 TLS 主要服务于通信双方,不能直接把一段客户端自称收到的内容当作第三方可验证证据。zkTLS 的实现会引入协作验证者或特定的代理安排,再通过证明隐藏无关内容。
Primus 是这类技术的实现者之一。用一个资产资格的例子理解它更直观:活动方只想确认用户某个交易所账户的余额是否超过门槛,用户无需提交完整账单,也无需把登录密码交给活动方。用户取得账户数据,生成关于来源和条件的证明,活动方按规则验证。
用户从指定网站取得账户数据 → 证明数据来源,并隐藏无关字段 → 证明“余额超过活动门槛” 活动方验证证明 → 判断用户是否符合这项资格
这种能力很适合接到已有产品里,减少重复上传资料的需要。但它证明的是指定来源提供了某份记录、记录满足某项条件。网站自己的记录是否准确,用户是否只展示了有利的一部分,其他账户有没有负债,仍是另外的问题。
一个账户的余额证明,也不能自动升级为全面的偿付能力证明。后者需要完整的资产、负债、归属和时间口径。证明做得再精巧,问题定义少了一项,结论就会少一项。
zkAPI:把付款身份和 API 使用分开
2026 年 10 月 1 日,以太坊基金会介绍了与 Open Anonymity Project 合作开发的 zkAPI。它已运行在以太坊主网,解决的是另一个具体问题:使用按量计费的 API 时,能不能证明自己有钱支付,却不把付款身份和每次使用绑在一起? 此前,Davide Crapis 和 Vitalik 在 2 月发表了 ZK API 使用额度的设计讨论。
普通 AI API 的密钥通常连着账号,账号又连着支付方式。zkAPI 让用户先把额度存入合约,再用零知识证明表明自己拥有足够的余额,而且没有重复花费。付款服务器不需要知道这次使用对应哪笔存款,也不需要让每次 API 调用都变成一笔链上交易。
在短期密钥模式下,付款服务器验证支付证明,发放有金额上限的临时 API 密钥;提示词从用户设备直接发给模型服务商。会话结束后按实际用量结算。付款服务器不看提示词,模型服务商也不会从这套付款机制直接得知密钥背后的付款身份。
付款路径:用户存入额度 → 证明可支付 → 获得临时 API 密钥 内容路径:用户设备 → 提示词直接发给模型服务商 → 收到回答 结算:会话结束后按实际用量处理
模型服务商仍然看得到提示词和回答。 IP 地址、请求时间、提示词里的姓名、重复使用的聊天记录,仍可能把会话重新关联起来。同一临时密钥也可以覆盖一段会话。它另外提供代理模式,在那种模式下,转发请求的付款服务器还会接触流量。
zkTLS 关注的是证明数据来自某个 HTTPS 服务,zkAPI 关注的是私密地支付 API 使用费。两者使用证明的目的不同,zkAPI 并没有让模型在看不见提示词的情况下计算。
这也对应我的分层分析:付款身份与调用记录的关联是一层,IP 和流量特征是一层,输入内容能不能被服务商读取又是另一层。zkAPI 补上付款这一层,网络匿名性和内容隐私还需要其他机制。隐私可以通过分开信息流、减少关联得到改善,某一层用了零知识证明,不代表整个产品已经匿名。
五、全同态加密 FHE:数据不解密,也能交给别人计算
零知识证明侧重证明一个陈述。还有一种需求:我手里有工资流水、体检报告或者持仓明细,不想公开,却需要别人帮忙计算。
普通云服务的办法,是把数据传上去,服务端解密后运行程序。传输途中可能很安全,硬盘上的文件也可能加密存储,但计算时,服务端还是看到了明文。
全同态加密(Fully Homomorphic Encryption,简称 FHE) 允许计算方直接对密文运算。输入保持加密,结果也保持加密,由有权限的人最后解密。
Petri 用加密输入、密文计算和持钥者解密解释了这个机制。为了更直观,可以先想象同一个密钥下的两个数:用户把 10 和 20 分别加密,交给计算方;计算方不知道两个数是多少,却能执行相应的密文加法;用户把结果解密,得到 30。复杂的程序也是把所需运算组织起来,只是成本高得多。
数据持有者:明文 → 加密后的输入 计算方:密文输入 → 密文计算 → 密文结果 有解密权限的人:密文结果 → 解密后的答案
这是一条单密钥的简化流程。若输入来自多个互不信任的人,还要设计共同的密钥安排、密钥转换或多方协议,不能默认任意几份密文都可以放在一起计算。
这个设想很早就出现了。1978 年,Rivest、Adleman 和 Dertouzos 在《On Data Banks and Privacy Homomorphisms》中讨论了对加密数据进行计算的方向。此后已有支持部分运算的方案,但通用的全同态加密长期没有解决。2009 年,Craig Gentry 给出了突破性的构造,让这一方向开始走向工程化。
传输加密保护的是数据在路上,存储加密保护的是数据留在硬盘上。FHE 把保护延伸到了数据被使用的过程中:外包计算方仍然接触密文。它减少了为了使用外部算力,必须把原始资料交给对方的需要。
这项能力有几笔绕不开的成本。
计算开销。 密文通常比明文大,运算也更贵。简单比较、加法和复杂模型推理,成本不能一概而论。评估时要看输入规模、延迟、精度和总费用,不能只比较一项实验室跑分。
密钥管理。 计算过程可以不解密,但最终要有人解密结果。这个人是谁,能解密哪些内容,需要几方同意,密钥丢失或泄露怎么办,都要先设计好。
门限解密是一种办法:把解密权分给多方,达到约定数量才可以解密。MPC(安全多方计算) 让多方用各自持有的数据或秘密份额协作计算,不必把完整秘密交给某一方。另一种办法是把密钥放进 TEE(可信执行环境),依赖硬件隔离保护它;当然此时信任也放在了硬件、相关代码和部署方式上。
输出的泄露。 如果结果给得过细,或者允许反复查询,别人仍可能逐步推断输入。比如只查一个人的统计结果,再安全的密文计算也无法让这个结果突然变得匿名。权限、查询范围和输出粒度,需要一起限制。
计算是否正确。 FHE 提供数据机密性,不能单独保证外包计算方诚实执行了指定程序。对方可能少算一步、用错数据,甚至直接返回另一份密文。结果能解密,不代表它就是正确答案。
放回区块链场景,公开的智能合约很难处理不愿公开的工资、订单和机构头寸。Primus 等团队尝试把 FHE 计算接到已有网络:链上合约管理权限和计算请求,链下节点承担密文运算,密钥系统决定结果什么时候、向谁解密。这样,业务不必为了获得保密计算能力,就把所有用户和资产搬到另一条链。
六、把技术做成产品:为什么隐私这么难落地
Xavier 的判断很直接:隐私是一个很难商业化的选项。隐私保护做得好的时候,用户未必有什么强烈感受,因为资料没有泄露、骚扰没有发生、账户没有出事。用户看得见的是功能是否好用、速度是否够快,往往看不见背后少收集了多少数据。
如果隐私版本还慢一点、贵一点、使用步骤多一点,大多数产品都会面对取舍。让用户为一个暂时感受不到的风险付出代价,比演示算法很困难。
通讯录就是一个容易理解的例子。社交软件希望帮用户发现熟人,常见做法是上传联系人,再由服务端比对注册名单。这样拿走的包括根本没有使用这个服务的人的号码,以及用户之间的关系。
Xavier 介绍过自己参与的一项北欧社交软件试验:用隐私集合求交机制保留好友匹配,同时减少不相关联系人数据的暴露。他分享的 A/B 测试观察是,当地用户的相关指标并未因这项改动而下降; 他也认为,这与当地用户对隐私的重视可能有关。
PSI(Private Set Intersection,隐私集合求交) 可以让两方计算各自集合的交集,而不直接交换完整列表。在通讯录场景里,用户有自己的联系人集合,服务方有已注册用户集合,目标是找出能推荐的好友,并尽量不暴露其他联系人。PSI 给开发者提供了比“把通讯录全传上来”更少暴露的方案。
隐私产品如果要得到广泛使用,就要把这种设计藏进正常工作流。用户照常找到好友、验证资格、获得计算结果,产品在背后减少信息交换,而不是要求每个用户先成为密码学专家。
我的分析是,隐私保护很难靠一个大而全的开关完成,更适合按层处理。
以一个数字服务为例,至少可以分别检查:
-
采集时:完成这个功能,真的需要这些字段吗?能否只取得一个条件判断?
-
传输时:内容有没有加密?接收方是否就是预期对象?
-
证明时:能否证明资格或数据来源,少提交原始资料?
-
计算时:哪些参与者必须看明文,哪些环节可以使用 FHE 或 MPC?
-
授权时:谁控制密钥,谁有权解密,能不能缩小权限范围?
-
关联时:身份、地址、付款、网络连接和调用时间,会不会重新把用户拼起来?
-
输出与保存时:结果暴露多少,日志保存多久,数据还能否删除?
每一层都比较垂直和聚焦,容易应用和落实相匹配的加密算法和技术。这些层组合起来,可以不断增强隐私性。
七、CROPS:做密码朋克产品时,怎么取舍
2026 年 3 月 13 日,以太坊基金会发布 EF Mandate,把用户自主权放在核心位置,并将 CROPS 作为行动原则:CR 是抗审查(censorship resistance),O 是开源(open source),P 是隐私(privacy),S 是安全(security)。这份文件兼有章程、宣言和行动指南的性质,首先约束基金会自身,并不强制整个生态接受同样义务。基金会是以太坊的维护者之一,不是网络的最终权威。
Vitalik 在同一天的说明中,把 CR 进一步解释为抗审查与抗俘获(censorship and capture resistance):既要减少交易被阻止的风险,也要避免基础设施被某个组织控制到其他人失去选择。他把以太坊称为一种庇护技术,让人们能够合作,却不必把最终决定权交给某个中心。
CROPS 因此可以进入功能设计、软件选型和项目决策,而不只出现在介绍页上。Mandate 全文提出,当两条技术上可行的路线竞争时,应优先减少控制点,而不只是选择最快上线的一条。
这不意味着速度、规模和易用性不重要。Vitalik 的解释是,这些能力应该帮助用户更直接地获得 CROPS 的性质,减少对会削弱这些性质的中间人的依赖。协议很开放,但用户必须经过一个不可替代的钱包、访问入口或身份服务,控制点就可能只是搬到了上层。
例如,团队要做一个身份验证功能。最省事的路线可能是,让所有用户上传证件,由一家服务商保管、审核。CROPS 会促使团队继续问:服务商拒绝某个用户怎么办?验证规则能否被独立检查?哪些信息必须提交?证件库失守的损失有多大?能否只验证所需资格,把原始资料留在用户设备上?
抗审查意味着考虑有没有单点能阻止用户使用系统、是否存在替代入口和退出路径。 基础链可以很开放,但应用前端、节点接口或一个管理员账户,仍可能成为单点。
开源让别人能够阅读和检查代码,还能在服务停止后继续维护。 但公开一份代码,并不意味着正在运行的版本就和它一致,也不意味着密钥、权限和部署过程都透明。开源要和可复现构建、实际部署检查、依赖审查结合。
隐私要求从功能所需的最少信息开始设计。 要判断用户是否成年,就先考虑年龄门槛证明;要发现注册好友,就考虑隐私匹配;要分析敏感数据,就考虑哪些环节真的需要明文。隐私是设计时的输入条件,补到最后通常更贵。
安全则要明确失败后会损失什么。 一次误签能不能转走全部资产?一个管理密钥泄露能不能改掉整个系统?恢复流程会不会成为最容易攻击的入口?只有把具体风险列出来,才能决定限额、多签、延迟执行和应急措施是否必要。
郭宇提醒,AI 写代码让这一点更重要。开发者可能拿到能运行的代码,却不完全理解其中的权限或依赖。生成速度快,并不能缩短检查责任。
Petri 从研究复现的角度解释开源价值。某项性能提升是否真实,需要了解测试任务、参数、硬件和基线,最好还能复现。否则,一个“快了多少倍”的数字,很难成为工程选型的依据。
我认同的做法是 Don't trust, verify。 它不要求每个人重做所有数学证明,而是让判断有可以检查的依据。在一个具体项目里,至少应该说明白:
-
谁能读到原始数据,谁控制密钥?
-
哪些信息仍然公开,哪些信息可以被关联?
-
谁能停止服务、修改规则或升级合约?
-
如果服务停摆、密钥丢失或公司退出,用户还能怎样继续使用、恢复或取回资产?
当然,这些原则之间会有取舍。更开放的使用范围可能增加滥用风险,更强的保密计算可能增加成本,更方便的恢复机制可能引入新的受信方。所以我认为 CROPS 更多的是一种倡导,而非严格的要求。
八、今天就能做的几件事
密码学算法似乎离我们很远,于是我让嘉宾们分别给大家一些具体的可以今天就做的事情。
我给普通用户的一个建议,是试试 Signal 或其他端到端加密的聊天工具。端到端加密意味着通信内容在发送端加密,只有预期接收端能够解密,服务端不需要拿到明文。它不保护被他人解锁的手机,也无法阻止接收者截图、转发。
郭宇的建议是,分析一下自己特别依赖的一个软件。它是怎么来的?你为什么信任它?信任它实际上是在信任谁?如果账号被封、公司停服,你能不能导出资料或换一个工具?
Xavier 强调不同服务之间不要复用密码。撞库攻击就是拿某处泄露的账号密码,去其他服务反复尝试;一套密码到处使用,会让一次泄露扩散成多处失守。可以用密码管理器为每个账户生成、保存独立的强密码,并给主要账户开启二次验证。恢复码和备份也要保存好,避免防住攻击,却把自己锁在外面。
Petri 强调的,是使用数据时尽量少依赖别人知道明文,以及完整应用必须逐层安全。对普通用户,可以先从已有保护措施做起:给设备启用可靠的锁屏和磁盘加密,减少不必要的权限,查看云服务是否需要拿到明文。
九、后续补充:AI 数学与量子计算对密码学的挑战
密码学的安全依赖一些目前很难解决的数学问题,以及对攻击者能力的判断。然而这些条件会变化,新算法、更强的硬件或实现漏洞,都可能缩小原本的安全余量。这一小节是在 Panel 之后,发文之前发生的热门事件,也做了收录。
2026 年 10 月 7 日,Justin Drake 提出行业应冷静准备 Bunker Mode,可以理解为一种降低暴露面的临时防御状态。他关心的不只是量子计算机:如果 AI 帮助发现新的数学算法,今天很难解决的问题,也可能在普通计算机上变得更容易。
对于钱包签名,关键风险是攻击者能否从公钥恢复私钥。Justin 提出的最坏情景是,ECDSA 可能在量子威胁真正到来之前,就被新的经典计算方法攻破。他写到的“几个月,而不是几年”, 是个人对最坏情况的警告。假如 ECDSA 真的可以被攻破,那么所有基于该加密算法的数字资产将全部灰飞烟灭。
Justin 建议大型、专业持有者先评估有序迁移,让资金留在公钥尚未暴露的新地址中。以以太坊普通外部账户为例,地址来自公钥的哈希;当签名交易公开后,公钥可以从签名恢复。公钥暂时留在哈希背后,可以减少直接针对公钥的攻击暴露。
Vitalik 在同一天的回应中明确说,不建议任何人当天匆忙把资金迁往新钱包;同时应该认真研究 AI 加速数学可能带来的风险。临时防御与正式升级,应该分开判断。仓促操作、错误备份和误签本身也会造成损失。
以太坊基金会(EF)一直有抗量子攻击相关的工作组和计划。然而,EF 后量子网站标注的更新日期为 2026 年 6 月 27 日,明确写着 “No single fixed date”——没有一个固定完成日期。按团队当时的评估,L1 协议升级可能在 2029 年前后完成,完整执行层迁移还需要更长时间。strawmap同样列出了延伸至 2029 年的候选升级路径,但明确表示这不是预测。研发、审计和开放治理会影响具体进程。
看,没有硝烟的密码战争一直在默默发生。
结语:把选择权留在自己手里
《密码朋克宣言》里说的隐私,是选择性地向世界披露自己的能力。三十多年过去,技术手段增加了,问题依旧存在:我们每天使用的服务,常常要求交出超过必要范围的信息,而交出去之后发生什么,用户很难看见。
密码学能在定义清楚的问题上给出数学保证。数字签名让网络验证授权,零知识证明让人验证陈述而少知道秘密,全同态加密让外部算力处理密文,zkTLS 让网站记录可以按特定规则被验证。每一种保证,都有适用的假设和范围。
输入是否真实,人和凭证是否绑定,App 是否偷偷上传,私钥是否泄露,谁有权解密,计算结果是否可信,这些需要放到完整系统里逐项解决。我们无法也不能傻傻的相信平台不会作恶,我们要自己动手和开始关注!
密码朋克留下的一个很实用的习惯,是遇到信息交换时先问:完成这件事,真的需要交出这么多吗?随后去寻找、使用和构建更少暴露的办法。技术可以减少一些不必要的信任,产品要把这种能力做得可用。我们要用脚投票。
十、延伸阅读
最新的隐私设计、行动原则与迁移研究
-
EF:介绍 zkAPI,2026 年 10 月 1 日。
-
Davide Crapis、Vitalik Buterin:ZK API Usage Credits,2026 年 2 月 11 日的设计讨论。
-
Justin Drake:Bunker Mode 风险讨论及Vitalik 的回应,2026 年 10 月 7 日。
密码朋克与电子现金的历史
-
Eric Hughes:《密码朋克宣言》,1993 年 3 月 9 日。
-
计算机历史博物馆:Whitfield Diffie,介绍 1976 年公钥密码学研究及其背景。
-
David Chaum:eCash 历史资料,包括 1982 年盲签名论文与 1994 年支付试验。
-
Adam Back:Hashcash,作者维护的项目网站,介绍 1997 年提出的工作量证明机制。
-
Wei Dai:b-money 原文存档,1998 年 11 月。
-
Nick Szabo:Bit gold,作者对计算成本、时间戳和所有权记录的说明。
-
Hal Finney:RPOW 发布邮件,2004 年 8 月 15 日。
-
中本聪:比特币白皮书,2008 年;正文与日期存档。
密码战争与算法安全
-
EFF:Bernstein 诉美国政府案,源代码表达与加密出口管制。
-
苹果:《致用户的一封信》,2016 年 2 月 16 日。
技术机制与日常使用
-
Primus 官方文档,查看 zkTLS 和保密计算的具体机制及信任假设。


