
MacOS 本地部署 Qwen-Image 2.1 提速将近五倍!怎么做到的?(推荐收藏)
文章目录
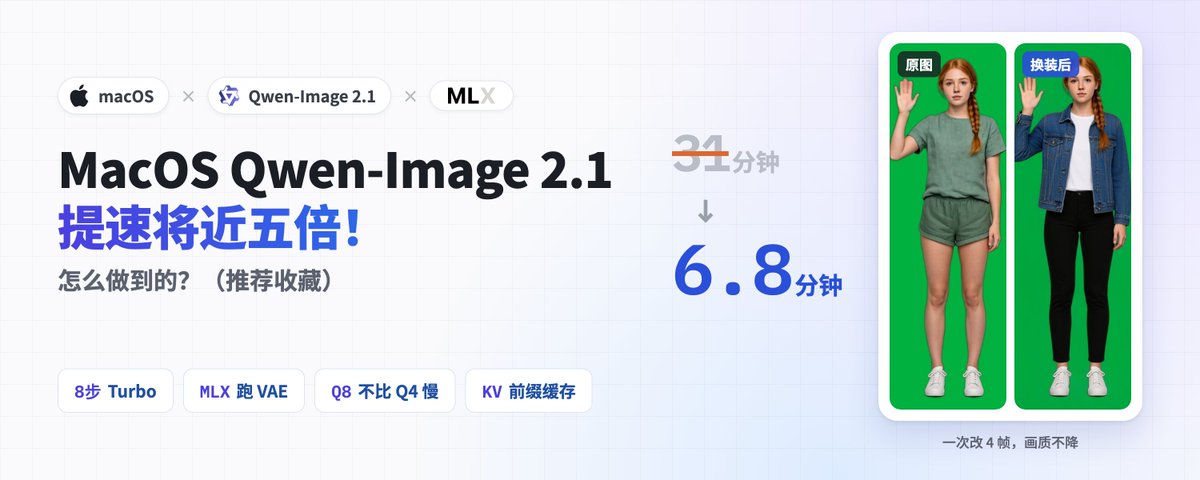
在 M2 Pro 上,在配置不符合最佳实践的情况下,用 Qwen-Image 2.1 改一张图,需要长达 30 分钟。这里介绍从 30 分钟压到 6.8 分钟,同时画质不变的方法论,包含四个提速点,每一个都附实测数字和原理,在 Mac 上跑本地模型的朋友可以直接照着做。
在我的 Mac 上,改一张图要整整 30 分钟,慢得离谱。
举个例子,如果要给一段视频逐帧换衣服,每次把 4 帧拼成一张 1440×672 的图交给模型改。照这个速度,一段 10 秒的视频要跑十几个小时。
于是我把这条流水线从头到尾拆开计时,再一段一段地优化。最后改一张图只要 406 秒,大约 6.8 分钟,速度是原来的 4.5 倍。
适合谁
-
在 Mac 上跑本地图像模型、嫌出图太慢的人
-
想用 Qwen-Image 做改图、换装或批量处理的人
-
对推理优化感兴趣,想知道速度到底是从哪里省出来的人
-
读过《图解 KV Cache》,想看看它在扩散模型里怎么用的人
用 N 卡的朋友,Turbo 和前缀 KV 缓存这两招同样适用;换 MLX 和“Q8 不比 Q4 慢”这两条,只针对 Mac。
先看效果:一段视频整段换装
用提速后的流水线,我把一段 121 帧、10 秒的走路视频从头到尾换了一身衣服。下面是另一次换成牛仔夹克的测试,同一组 4 帧,上面是原图,下面是结果:
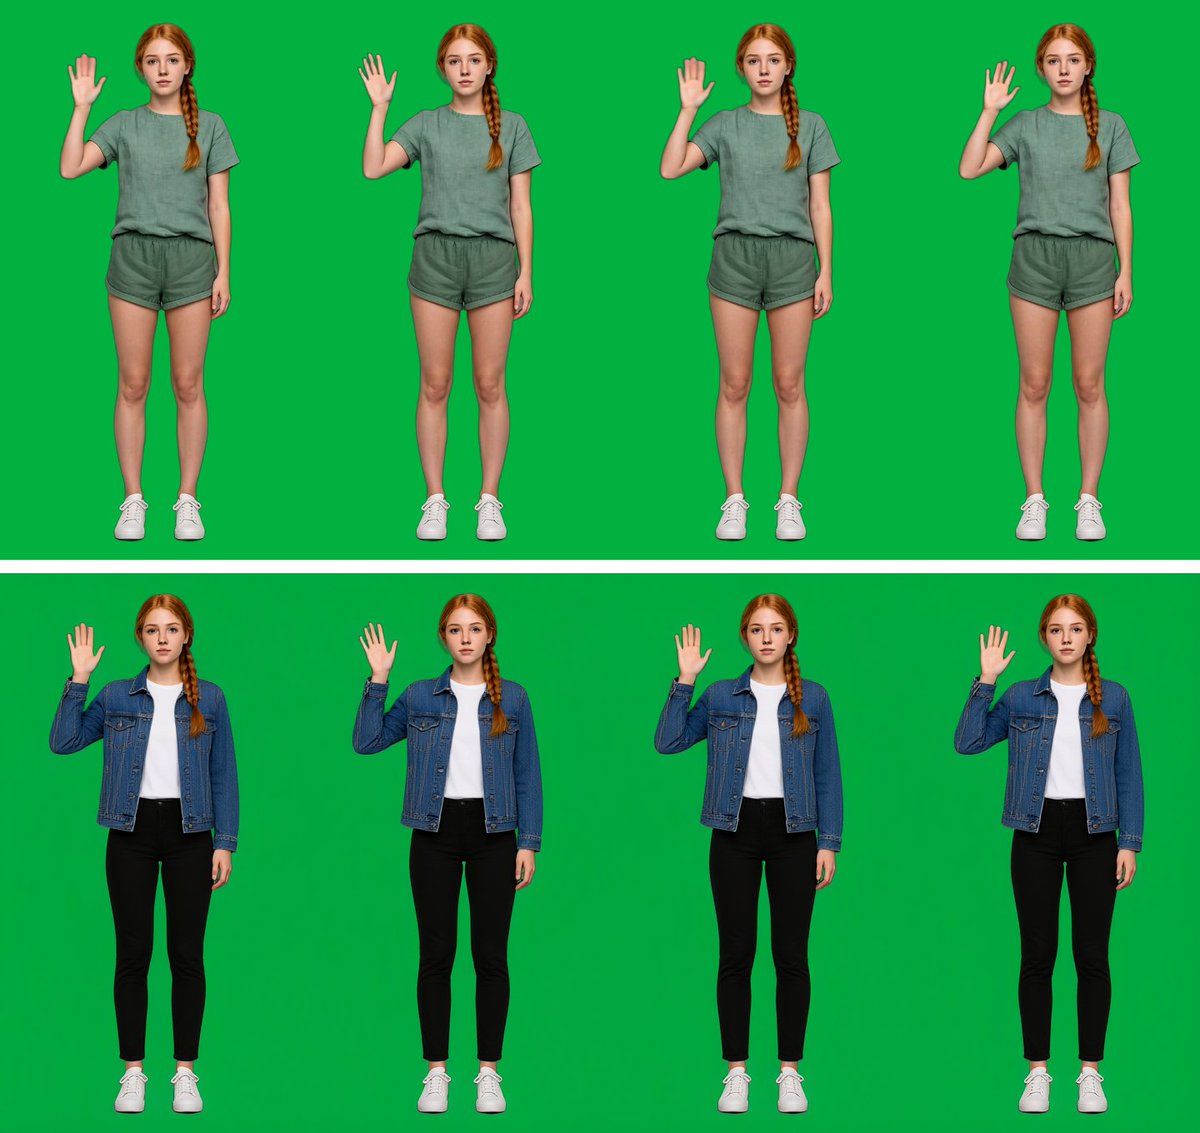
做法是每 4 帧裁出人物、拼成一张横排一起改。从第 2 组开始,最左边一格放的是上一组最后一帧的成品,当作锚点,让模型照着画,这样组和组之间衣服不会突然变样。
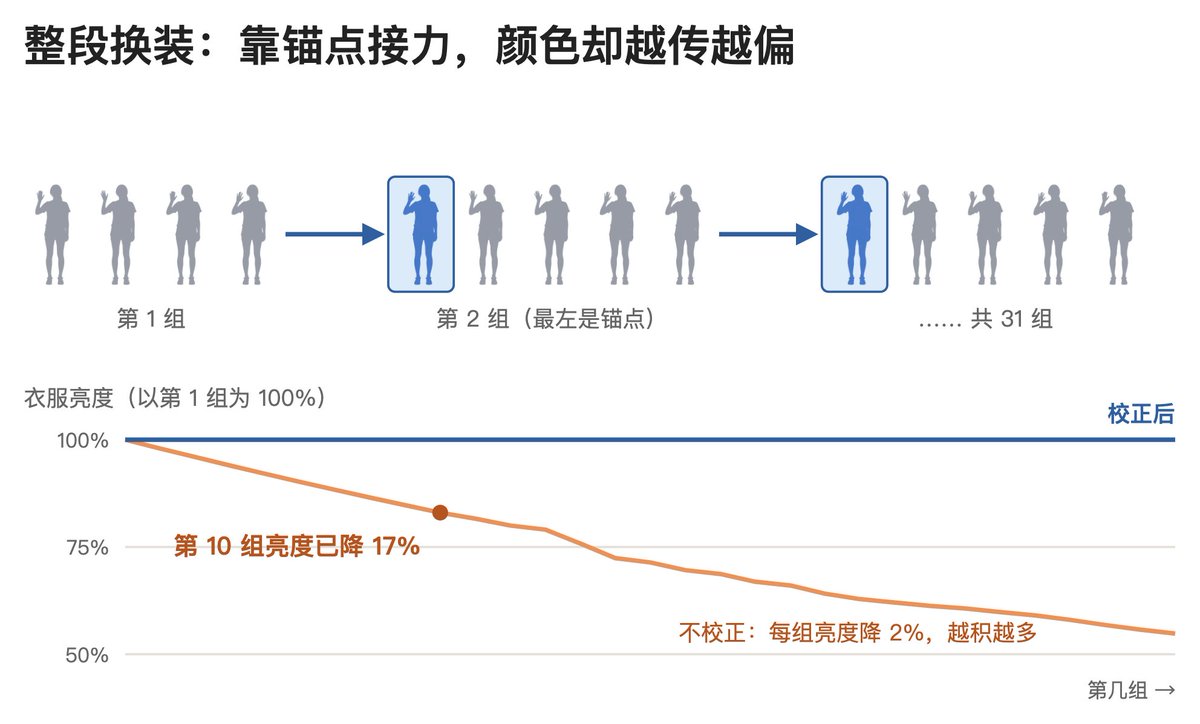
但锚点接力带来一个新问题:锚点每被重画一次,颜色就会偏暗、偏暖一点。每组亮度只降 2% 左右,但误差会一组接一组地累积,到第 10 组时衣服亮度已经降了 17%,不校正的话最后会降掉将近一半。
我的办法是三层校正:
-
以原图的肤色为基准,校正整个人的颜色,因为换衣服不会改变皮肤
-
对比锚点重画前后的颜色,补偿衣服额外损失的亮度
-
全部跑完后,让衣服的明暗跟着原片走,再做 9 帧平滑,防止闪烁
整段视频共 31 组,跑了约 3.8 小时,平均每帧不到 2 分钟。
一、耗时拆解
优化之前,我先把一次改图拆成四段,分别计时:
-
VAE 编码:把输入图压成潜变量
-
条件编码:把提示词和参考图变成模型能读的向量
-
采样:扩散模型一步一步去噪,最耗时的就是这段
-
VAE 解码:把潜变量还原成图片
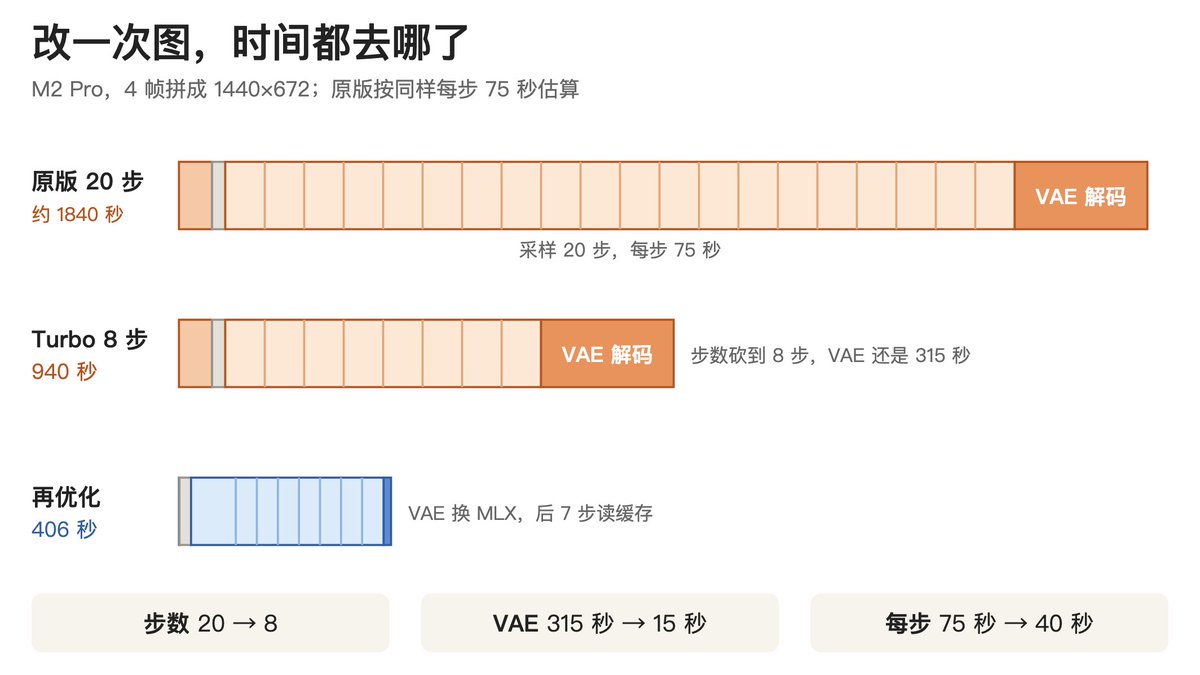
图里每根条的长度和秒数成正比,采样那一段按步切成小格。可以看到三件事:
-
原版 20 步时,采样占了大头,减步数是最直接的办法
-
换成 Turbo 8 步后,VAE 一下子变得很显眼:编码 63 秒加解码 252 秒,占了总时间的三分之一
-
采样的每一步本身,也还有压缩的空间
如果没计时,我大概会一直盯着扩散模型本身去调,根本想不到 VAE 才是第二大瓶颈。
二、Turbo新模型:8 步就够
Qwen 官方在 10 月 9 日发布了 Qwen-Image-2.1-Turbo,把去噪压到了 8 步。它和原版的参数规模一样,每一步的耗时也差不多,快就快在步数少。
原版 20 步光采样就要 1500 秒,Turbo 只要 600 秒。这一步不用改任何代码,下载模型、换掉参数就行。
需要注意两点:
-
Turbo 要用作者给的 sigma 表和 cfg = 1,不要沿用原版的参数
-
换成 Turbo 之后,总时间是 940 秒,仍要 16 分钟左右
下面三招都是在 Turbo 的基础上继续压缩:
三、更换慢步骤的引擎
我用的推理引擎是 stable-diffusion.cpp(下面简称 sd.cpp),它跑 GGUF 量化模型很方便,但在这台 M2 Pro 上,它的 VAE 特别慢:解码一张图要 252 秒。
而苹果自家的机器学习框架 MLX 里,正好有现成的 Qwen-Image 2.1 VAE 实现。于是我把 VAE 单独拎出来交给 MLX,扩散采样还留在 sd.cpp 里。
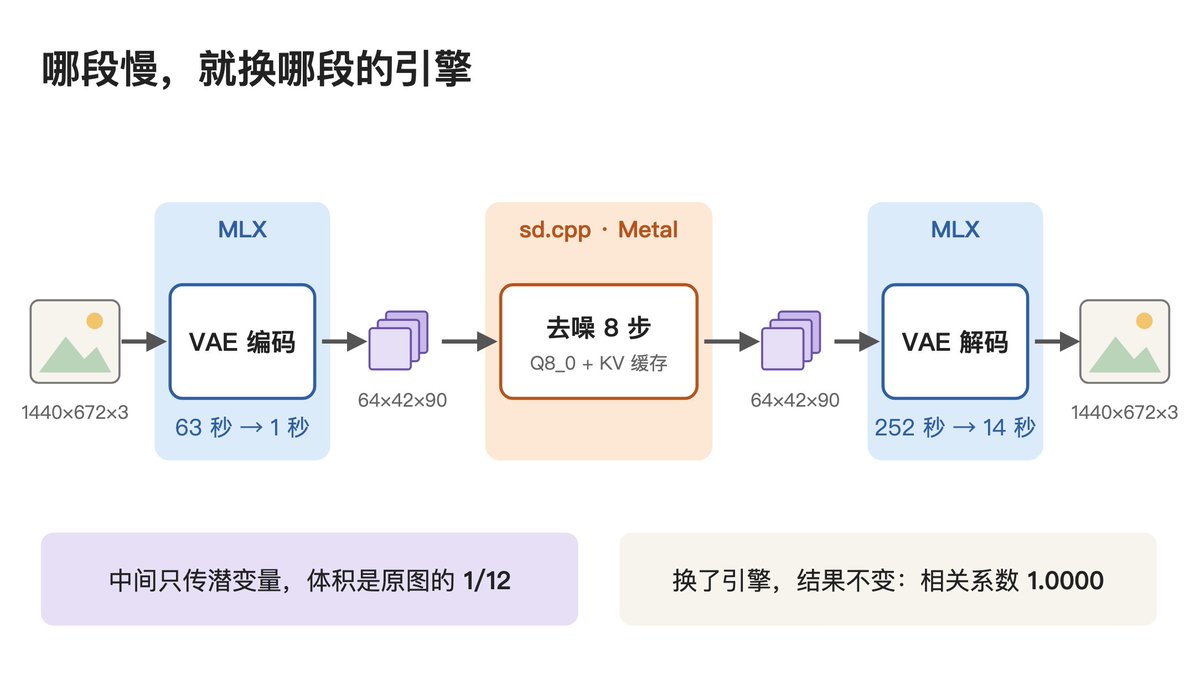
这样拆开之后:
-
编码从 63 秒降到 1 秒,解码从 252 秒降到 14 秒
-
两个引擎之间只需要传一份潜变量。Qwen-Image 2.1 的 VAE 把图片长宽各压缩 16 倍、变成 64 个通道。1440×672 的图压完是 64×42×90,体积只有原图的 1/12
-
两边算出的潜变量几乎完全一致(相关系数 1.0000),可以直接互换
具体做法是给 sd.cpp 打一个小补丁:让它从文件读入参考图的潜变量,采样完把结果写到文件里,跳过自己的解码。
这一招的思路比细节更重要:一条流水线不必只用一个引擎,哪段慢就换哪段。
四、Q8 和 Q4 一样快
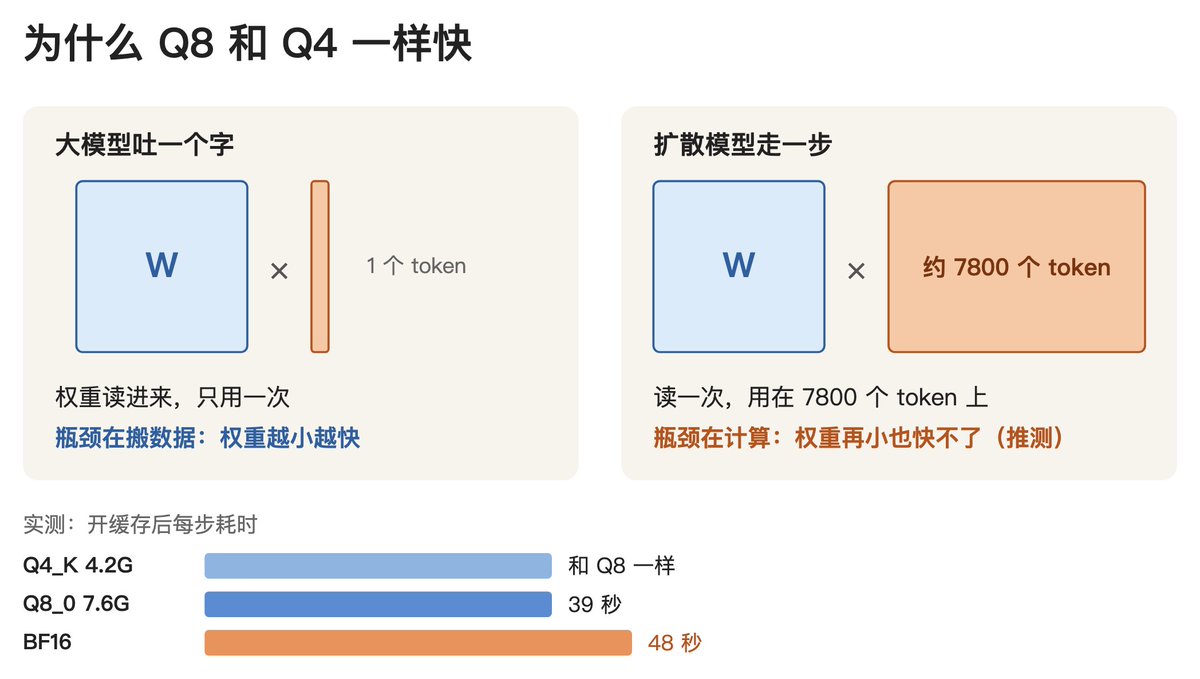
按跑大模型的经验,量化越狠越快,Q4 应该比 Q8 快不少。可我实测下来,两者每一步的耗时几乎一样,原版精度的 BF16 反而更慢。
我的理解是这样(这一段是推测,没有做性能剖析):
-
大模型吐字时,每吐一个字都要把整份权重从内存里读一遍,却只算一个 token,瓶颈在搬数据。权重越小,搬得越快,所以量化能提速;
-
扩散模型走一步时,要同时处理约 7800 个 token(目标图 90×42 = 3780 个,参考图同样多,再加上提示词)。权重读进来一次,要用在 7800 个 token 上,瓶颈在计算本身,权重压得再小也省不了多少时间。
至于 BF16 为什么更慢,一个原因是权重加上编码器一共要占 20GB 左右,32GB 的机器内存很吃紧;另一个可能是 M2 没有原生的 BF16 矩阵加速。
结论:既然 Q4 和 Q8 一样快,就选 Q8,画质更接近原版,代价只是多占 3GB 出头的内存。
五、扩散模型也能用 KV 缓存
这是我认为最有意思的一招,它让采样的每一步快了将近一倍。
改图时,模型的输入分成两部分:
-
前缀:提示词,加上那张要改的参考图
-
目标:正在去噪的新图
Qwen-Image 2.1 用的是“块因果”注意力:目标可以看前缀,但前缀从来不看目标。而且前缀用的时间步固定为 0,和当前走到第几步无关。
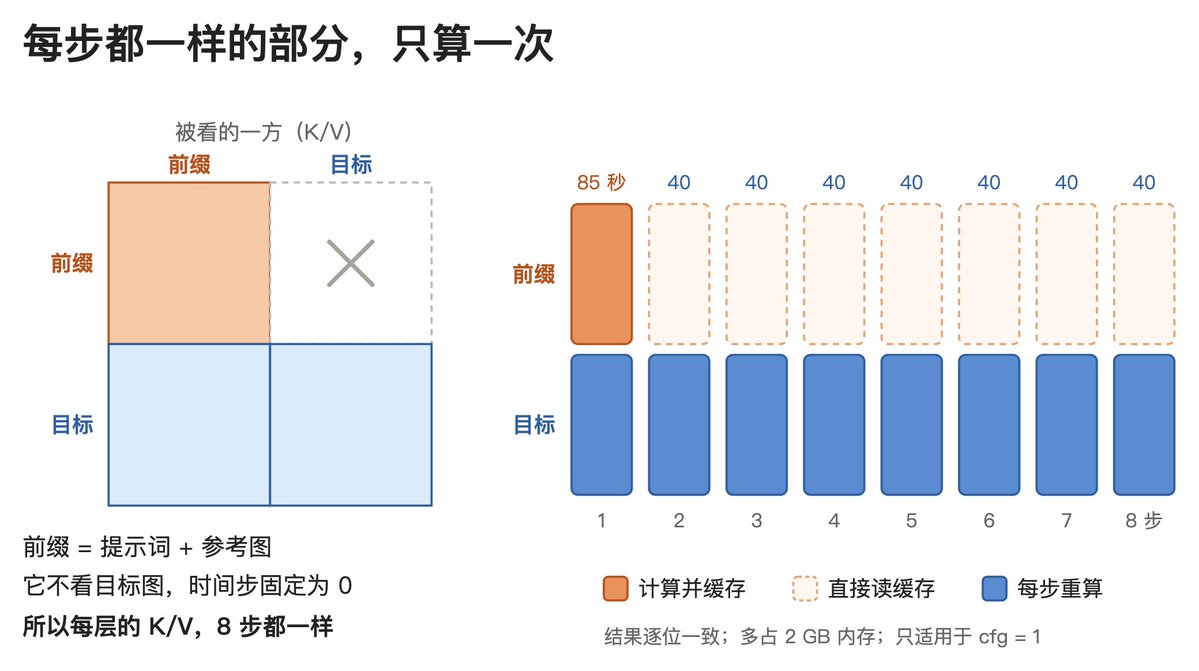
这就意味着前缀在每一层算出来的 K 和 V,8 步里一模一样。原来每一步都要把前缀重算一遍,纯属浪费。
所以我给 sd.cpp 加了前缀缓存:
-
第 1 步照常计算,同时把每层前缀的 K、V 存下来,这一步 85 秒;
-
第 2 到第 8 步跳过前缀,直接读缓存,只算目标那一半,每步从 75 秒左右降到 40 秒;
-
输出和不开缓存时逐位相同,多占约 2GB 内存。
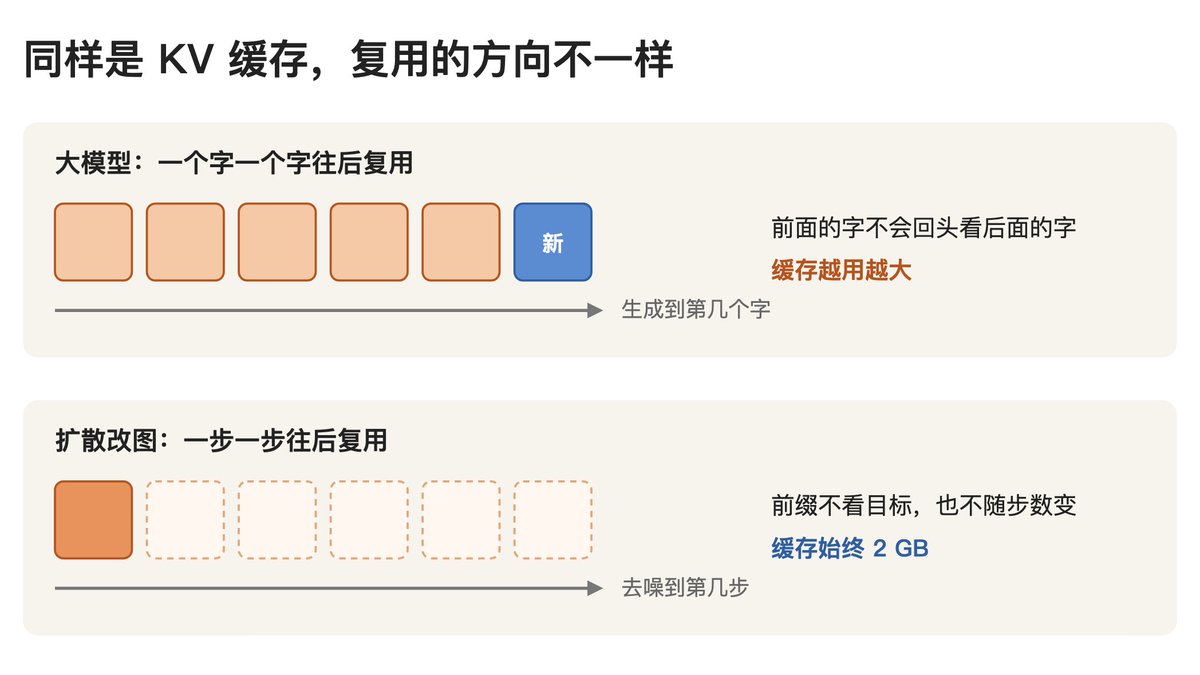
如果你读过我上一篇《图解 KV Cache》,会发现这是同一个道理,只是复用的方向不一样:
-
大模型沿着 token 复用:前面的字不会回头看后面的字,所以旧字的 K、V 可以一直留着,缓存越用越大;
-
扩散改图沿着去噪步复用:前缀不看目标,也不随步数变,所以缓存大小始终是 2GB。
这招有两个前提:
-
模型得是块因果结构,前缀不能看目标。
-
cfg 必须是 1。cfg 大于 1 时,每一步要分别跑一遍正向和负向提示词,两个前缀不一样,就没法只存一份。好在 Turbo 本来就推荐 cfg = 1。
总结
总结下来,一共叠加了四个方法:
-
换 Turbo 模型:步数从 20 步降到 8 步,这一步最省事,时间直接砍掉一半
-
VAE 换到 MLX 上跑:编码加解码从 315 秒降到 15 秒。除了采样,VAE 就是最大的一块耗时
-
Q8 和 Q4 一样快:在 Mac 上跑扩散模型,量化省下的是内存,不是时间,所以干脆用画质更好的 Q8
-
前缀 KV 缓存:扩散模型改图时,有一半计算每一步都在重复,算一次就够了,之后每步从 75 秒降到 40 秒
前三点能直接用,第四点要给推理引擎打补丁,但原理和大模型的 KV Cache 其实是同一个思路。
推荐阅读
-
普通人的 Claude 订阅方案(从 0 到 1 完整版,含支付和身份认证)https://x.com/wquguru/status/2106041666922783181
-
图解 KV Cache——DS V4.1-Flash的制胜秘密https://x.com/wquguru/article/2099119760248389730
-
图解 ASR 和 TTS:HuggingFace 开源模型测评https://x.com/wquguru/status/2096013016429211791
-
Agent Memory 架构全景:从规则文件、会话检索到反思与技能沉淀https://x.com/wquguru/status/2069641926752780384
-
成瘾者:色情、赌博与Vibe Codinghttps://x.com/wquguru/status/2022173077329871138
如果这篇教程对你有帮助,欢迎 关注 + 收藏 + 转发 👏🏻
持续分享新手友好的 AI Agent 教程和 AI 工具使用心得,关注 @wquguru
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


