
把 96.5GB 的 GLM-5.3-Flash 塞进单张 4090 48GB,我们如何跑出 41.8 token/s?
文章目录
一个 96.5GB 体积的混合专家(MoE)模型,一张 48GB 显存的单显卡。
模型体积比显存大了一倍以上。在常规认知里,这种单卡异构推理要么直接 OOM(显存溢出),要么被迫把大半参数甩给内存,让文字以一秒一两个词的龟速往外爬。
但在过去几天里,我们在一台配备 魔改版 RTX 4090 48GB、AMD Ryzen 9 9950X、128GB 内存 的工作站上,通过底层的系统级排障与压榨,最终把 GLM-5.3-Flash 的短文本生成速度推到了稳定的 41.8 token/s。
每个 token 耗时仅约 24 毫秒,P99 稳定在 31 毫秒 左右。
更关键的是,我们拆解出了这 24.47 毫秒里的每一个时钟周期究竟花在了哪里。
这是一篇纯粹由真实数据堆出来的工程排障实录。
它记录了我们怎样从理所当然的优化假设出发,经历反直觉的暴跌打脸,最终摸索出这套系统最优谐振点的完整过程。
01. 账本与底牌:96.5GB 凭什么能单卡解码?
在讲优化前,必须先把软硬件账本算得清清楚楚。
模型与量化配方
我们运行的是智谱的 GLM-5.3-Flash(Maya-S v2 分片打包),原生上下文高达 100 万,测试上下文配置为 8,192:
-
结构体量:共 46 层(前 3 层为稠密层,42 层为 MoE 专家层,加 1 个 MTP 草稿层)。每层拥有多达 288 个路由专家,每个 token 激活其中的 8 个专家 + 1 个共享专家。
-
专家总数:42 层 × 288 = 12,096 个路由专家。每个 token 会被路由到 336 个专家,对应需要读取约 2.39 GB 的专家权重。
-
量化并非粗暴的 INT4 或 AWQ:而是 GGUF 体系下的混合 i-quant(矩阵校准量化)。专家的 Gate/Up 采用极致压缩的 IQ2_XXS(约 2.06 bit/权重,占 52.32 GB);Down 投影根据层敏感度分别采用 IQ2_S 与 IQ3_XXS;稠密层和共享专家则用 Q6_K 保证精度。
-
体积折算:12,096 个专家总重 86.0 GB,每个专家平均仅 7.11 MB。
硬件与内存拓扑
-
GPU:RTX 4090 48GB(实际可用显存 47.37 GB),工作在 PCIe 4.0 x16。
-
CPU:Ryzen 9 9950X(16 核心 32 线程,单 NUMA 节点,双 CCD 各带 32MB L3 缓存,全核睿频约 5.66 GHz)。
-
内存:128GB DDR5(系统可见 123.5 GiB)。全部 12,096 个专家完整常驻在显存或锁页主机内存中,测试全程 SSD 读取为 0。
既然全部能装进内存,推理引擎(Maya)在每生成一个 token 时,就必须在毫秒内完成一场极限调度:
-
显存池(VIP 专座):能放几千个专家?
-
PCIe 走廊:缺少的专家,经 PCIe 搬去 GPU 算有多快?(实测每个专家 0.285 ms,折算吞吐约 25.0 GB/s,跑满 PCIe 4.0 理论带宽的 78%)
-
CPU 值班管家:不搬运,直接让 9950X 在内存里算有多快?(14 线程实测每个专家 0.084 ms,折算访存吞吐约 85.0 GB/s)
02. 第一次打脸:工人从 16 个砍到 8 个,速度暴涨 42%
最初分析时,CPU 计算专家消耗了肉眼可见的时间。
程序员的第一反应往往是粗暴的:
“9950X 有 16 个大核,拉满 16 线程火力全开,不就快了吗?”
然而,第一次实测便直接粉碎了常识:
把 CPU 线程从 16 个砍掉一半到 8 个,推理速度从 24.6 token/s 飙升至 35.0 token/s,暴涨 42.3%!
为什么“工人砍掉一半,产能反而井喷”?
答案藏在现代多核 CPU 的微架构与系统调度里:
-
多任务通道冲突:Maya 引擎本身需要独立线程管理 PCIe 异步搬运和事件监听。当计算线程开满 16 个核心(在 taskset 0-15 限制下),计算线程与搬运线程疯狂互斥,产生严重的抢核等待。
-
双 CCD 缓存与内存带宽争抢:9950X 拥有两个 CCD,各享 32MB L3。当 16 线程同时高强度扫内存读专家权重时,内存控制器通道被彻底打碎,L3 频繁失效。
我们曾做过一组极端测试:把计算线程强行绑在单 CCD(0–7 号核)上,速度直接暴跌 30.9%。
8 个线程恰好给搬运和全局调度留出了“绿色通道”。
在异构计算中,局部的无序狂奔只会导致全局交通瘫痪。
在这之后,我们尝试了数据预取、SIMD 融合等局部 CPU 指令级调优,但无一例外全部以微跌告终。
这明确告诉我们:CPU 的代码已经不是第一瓶颈,它的出场频率才是。
03. 空间换吞吐:显存池从 43GB 到 46GB 的质变
既然别让 CPU 太忙,那就让显存装下更多常客。
一开始,引擎的显存池上限设为相对保守的 43GB。扣除稠密层(6.86 GB)、KV Cache、激活值等开销后,留给专家的空间只有 34.24 GB(5,166 个槽位,平均每层 123 个)。
我们决定逼近硬件物理极限,将上限一举提高到 46GB(保留 700MB 冗余缓冲):
- 专家池扩大到 37.02 GB,槽位增加到 5,586 个(每层 133 个),净增 420 个席位。
这 420 个位置彻底逆转了局势:
| 关键监控指标 | 43GB 显存池(基线) | 46GB 显存池(调优后) | 变化幅度 |
|---|---|---|---|
| 显存命中率 | 79.1% | 81.4% | +2.3% |
| 每 Token 需 CPU 计算专家数 | 47.8 个 | 40.5 个 | -15.3% |
| 每 Token 经 PCIe 拷贝专家数 | ~23 个 | 21.2 个 | -7.8% |
| 端到端生成速度 | 36.49 tok/s | 40.56 tok/s | +11.1% |
这就是非均匀分布系统下的杠杆效应:
命中率看似只涨了区区 2.3%,但因为砍掉的是最拖累系统延迟的“CPU 兜底任务”(直降 15.3%),直接带动速度冲破 40 token/s。
那么把显存池再顶到 46.8GB(5,712 槽位)呢?
实测速度几乎零变化。因为高频专家已经被悉数捕获,再扩充的槽位只能兜住极低频长尾,边际收益已经归零。
04. 致命的代偿陷阱:解密 CPU_PLAN
既然 GPU 这么猛,完全不用 CPU、把所有非命中专家都搬去显卡算,能不能起飞?
在 Maya 引擎中,有一个核心参数叫 STRATA_GLM_CPU_PLAN。
它由一串 9 位数字构成,控制着每层 8 个被激活专家中,当有 k 个(k=0..8)落在内存时,究竟派几个给 CPU 算。
以 14 线程的最佳分工方案 011223344 为例:
-
k=1(只有 1 个缺席):交由 CPU 算 1 个,PCIe 搬运 0 个;
-
k=3(缺席 3 个):CPU 算 2 个,PCIe 搬运 1 个;
-
k=5(缺席 5 个):CPU 算 3 个,PCIe 搬运 2 个;
-
k=8(全部缺席):CPU 算 4 个,PCIe 搬运 4 个。
为了验证“全甩给 GPU”的想法,我们把 Plan 激进调整为偏向 PCIe 的 001122334(第一位变 0,意味着哪怕只有 1 个缺席,也必须通过 PCIe 搬到显卡):
结果惨遭滑铁卢:
-
每 token CPU 的计算数从 40.5 砍到了 18.5(CPU 彻底摸鱼);
-
但 PCIe 搬运专家数从 21.2 次激增到 36.4 次;
-
最终速度从 40.56 崩塌到了 36.24 token/s!
真相大白:
PCIe 4.0 搬运一个专家需要 0.285 ms(实测折算 25 GB/s),而 CPU 本地算一个只需要 0.084 ms(访存折算 85 GB/s)。
盲目减轻 CPU 的负担,相当于逼着整个系统去挤狭窄的 PCIe 独木桥。
GPU 算力再强,也只能干等着流水线送粮。
05. 两个“看似聪明”的优化为什么落空?
调优过程中,我们还探索了两个技术上看似无懈可击、实测却双双扑空的策略:
- 晋升门槛惩罚:STRATA_GLM_PROMOTE_MIN
-
假说:显存槽位珍贵,如果一个专家只是偶尔路过,就不该把它常驻,避免把别的有效专家挤掉。把晋升阈值从 0(默认见空位就进)改成 6(至少被点名 6 次才允许常驻)。
-
实测:专家换入换出确实从每 token 20.5 次断崖式降至 5.9 次,但显存命中率从 81.4% 跌到 75.1%,速度降至 38.54 tok/s。
-
原因:因为 128GB 大内存支撑下没有磁盘 I/O 惩罚,激进的准入限制反而让 GPU 显存陷入“大片空置无法利用”的窘境,CPU 负担不减反增。
- 按层非均匀专家槽位分配
-
假说:不同 MoE 层的路由熵不同,深层和浅层活跃专家分布不一,按统计数据给不同层定制槽位容量。
-
实测:命中率从 81.4% 变成 81.3%,生成速度毫无差异。
-
原因:当前模型在 46GB 专家池下,每层 133 个槽位的均匀分布已经处于容错极高的甜点平原,人为引入的规则调度没有实质代际差。
06. 毫秒级解剖:一个 Token 耗时 24.47ms 的去向
通过打桩开启 STRATA_GLM_PROF=16,我们在处理 1,159 个 token 的实际解码中,拿到了这台 4090 运行 GLM-5.3-Flash 最珍贵的耗时微观切片(最佳配置对比 43GB 基线):
GLM-5.3-Flash 逐 Token GPU 流耗时拆解 (合计 24.47 ms)
─────────────────────────────────────────────────────────────
[等 PCIe 搬运专家]  ██████████████████ 7.60 ms (31.1%) ★最大单项
[KDA 线性注意力]    █████████████ 5.38 ms (22.0%)
[GPU 算专家权重]    ████████ 3.31 ms (13.5%)
[MLA 稀疏注意力]    ███████ 2.85 ms (11.6%)
[路由/共享专家计算] █████ 2.14 ms (8.7%)
[GPU 等待 CPU 算完] ████ 1.75 ms (7.1%)
[HC 结构 / 稠密层]  ███ 1.44 ms (5.9%)
─────────────────────────────────────────────────────────────
这份剖析图彻底揭开了单卡大模型异构推理的物理本质:
-
CPU 与 GPU 是重叠并行的:生成一个 token 时,CPU 在自己领走的 40.5 个专家上实际花了 8.55 ms。但因为绝大部分被 GPU 算力和 PCIe 传输给“掩盖”了,GPU 实际挂起等待 CPU(moe_cpu_wait)的时间只有 1.75 ms。
-
提速 1.39 ms 的真实源头:最佳配置(46GB/14 线程)比基线(43GB/8 线程)每 token 快了 1.39 ms。其中 1.18 ms 来自减少等待 CPU(显存装得更多了,CPU 算得更快了),另外 0.27 ms 来自减少等待 PCIe。
-
不可逾越的物理墙:注意力机制固定占死约 8.23 ms(34 层 KDA 线性注意力 5.38 ms + 12 层 MLA 2.85 ms)。而等 PCIe 搬运专家依然是系统最大的瓶颈(7.60 ms,占比 31.1%)。
只要显存无法一口气吞下 86GB 的全量专家,PCIe 传输时间就是这台机器的硬天花板。
07. 终局收敛:14 线程的稳态与 41.8 token/s
在搞定了 46GB 显存池与最佳 CPU_PLAN(011223344)之后,我们带着全新平衡态重新扫描了 CPU 线程数:
| CPU 线程分配 | 端到端生成速度 | 运行表现分析 |
|---|---|---|
| 6 线程 | 40.56 tok/s | 线程不足,CPU 掩盖能力下降 |
| 8 线程 | 41.14 tok/s | 曾经的冠军点,依然稳健 |
| 10 线程 | 41.56 tok/s | 吞吐稳步爬升 |
| 12 线程 | 41.38 tok/s | 产生轻微时钟抖动 |
| 14 线程 | 41.81 tok/s | 全场最佳谐振点(三次复测均值 41.74) |
| 16 线程 | 35.14 tok/s | 悬崖式崩塌(抢占主循环与搬运线程) |
在 46GB 的全新环境里,系统最优点从 8 线程微移到了 14 线程。
因为显存留出余量、任务重新分流后,系统容许了更强悍的 CPU 并行计算来压缩那 1.75 ms 的纯等待耗时。
延迟稳定性与首字延迟(TTFT)
在最终的最佳配置下,我们在不同任务上验证了这套系统的稳定性(关闭思考模式,生成 256 token):
-
生成波动极小:
-
CSV 解析任务:40.13 tok/s(P50: 24.85ms / P99: 31.59ms)
-
物理原理解析:43.61 tok/s(P50: 22.69ms / P99: 29.69ms)
-
网页画布生成:41.19 tok/s(P50: 23.96ms / P99: 31.50ms)
-
P99 仅为 P50 的 1.25~1.3 倍左右,解码体验极为平滑顺畅。
-
首字延迟(TTFT)表现:
-
24–30 token 短 Prompt:TTFT 为 0.67–0.85 秒(含约 0.65 秒的专家预热冷启动固定开销);
-
1,000 token 长 Prompt:TTFT 为 1.65 秒(吞吐折算约 610 tok/s);
-
4,000 token 长 Prompt:TTFT 为 2.74 秒(吞吐折算高达 1,460 tok/s)。
08. 最佳落地运行配置
为了方便社区复现与验证,附上本次跑出 41.8 token/s 最佳成绩的完整环境变量与启动命令:
CUDA_DEVICE_ORDER=PCI_BUS_ID CUDA_VISIBLE_DEVICES=0 \
STRATA_GLM_SPLIT=0 \
STRATA_GLM_VRAM_GB=46 \
STRATA_GLM_RESERVE_MB=700 \
STRATA_GLM_RAM_GB=64 \
STRATA_GLM_RAM_HEADROOM_GB=16 \
STRATA_GLM_CPU_LANE=14 \
STRATA_GLM_CPU_PLAN=011223344 \
STRATA_GLM_NO_MTP=1 \
taskset -c 0-15 ~/maya-v1016/build/strata \
  --serve \
  --glm-pack ~/models/GLM-5.3-Flash-Maya-S-v2-IQ2_XXS \
  --max-context 8192
09. 我们的观点:为什么 GLM 上不去,而 Qwen3.8-Flash-Next 能到 120 tok/s?
41.8 token/s 已经是这台机器跑 GLM-5.3-Flash 的稳态天花板。
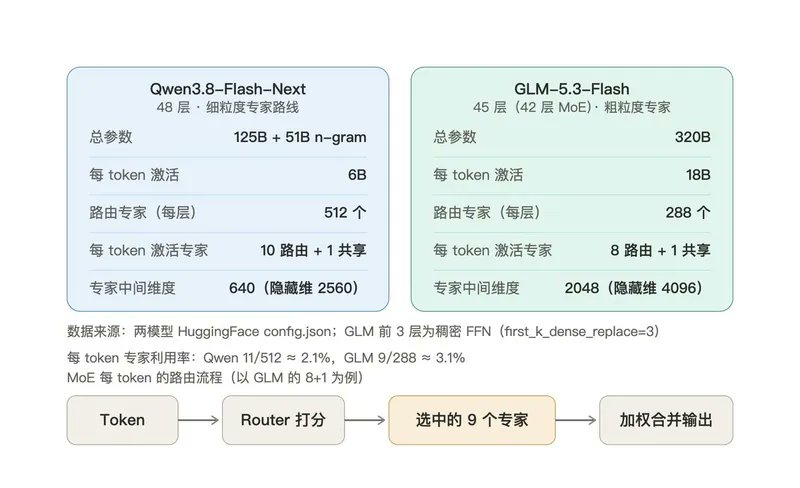
把两个模型的架构摆在一起,答案其实很直白:
-
Qwen3.8-Flash-Next:48 层,总参数 125B + 51B n-gram,每 token 只激活 6B;每层 512 个路由专家,每 token 点亮 10 个路由专家 + 1 个共享专家;专家中间维度只有 640。
-
GLM-5.3-Flash:45 层(42 层 MoE),总参数 320B,每 token 激活 18B;每层只有 288 个路由专家,每 token 点亮 8 + 1 个;专家中间维度高达 2048。
我们的观点:GLM 的权重更大,但专家并没有更多。这就是它上不去的原因。
解码阶段是带宽瓶颈:每生成一个 token,都要把被激活专家的权重从显存或内存里读出来,读多少字节,大致等于“激活参数量 × 量化位宽”。
GLM 每个 token 要读 18B 的激活权重,Qwen 只需要读 6B,少读了三分之二。
120 ÷ 40 = 3.0,18B ÷ 6B = 3.0。速度比和激活参数比几乎一模一样。
再回头看这篇文章里的每一步:
-
GLM 的专家是粗粒度的:只有 288 个,每个专家又大又重(本文实测平均 7.11 MB)。每层 133 个显存槽位,只能装下不到一半的专家,剩下的必须靠 PCIe 搬运或 CPU 兜底。
-
这就是第 04 节里 PCIe 独木桥的根源,也是第 06 节里 7.60 ms 等待搬运、1.75 ms 等待 CPU 的根源。
-
我们把线程、显存池、CPU_PLAN 调到了甜点位置,但这些都只是在搬运和分工上做文章,没有改变“每个 token 必须读 18B 权重”这个前提。
Qwen 走的是另一条路:专家池更大、粒度更细,每个 token 只点亮一小撮。每 token 专家利用率只有 11/512 ≈ 2.1%,GLM 是 9/288 ≈ 3.1%。容量可以继续涨,而每 token 的读取量几乎不动。
所以,GLM-5.3-Flash 这条路,单卡异构的极限大概就在 40 tok/s 附近。
想要更快,靠的不是继续压榨调度,而是模型本身为极稀疏而设计的专家粒度。
结语:调优到底在调什么?
把一个 96.5GB 的混合专家模型,在一张 48GB 显卡上从初期的卡顿一步步推向 41.8 token/s,给我们最深的体会是:
任何脱离全局数据流的“单点性能调优”,几乎都是盲人摸象。
-
当你盯着 CPU 算力时,往往是线程争抢堵死了内存;
-
当你全情投入 GPU 加速时,PCIe 的物理带宽可能正在发出无声的哀鸣;
-
当你想用复杂的算法做精细控制时,均匀分配反而能给硬件提供最高的吞吐平原。
真正的系统工程压榨,不是把某一个指标做到极致,而是找准那个让 GPU 计算、PCIe 搬运与 CPU 分工严丝合缝、谁都不用停下来等待的动态平衡点。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


