
27Bは終わった。Strataが変えたLLMの常識
文章目录
わずか12GBのGPUで大型MoEが高速動作。Flash-Nextと27Bの逆転を公開実測で追う。
結論:Strataの登場で、Qwen3.8-27Bを選ぶ理由だった「大型MoEより速く、動かしやすい」という優位性が崩れ始めた。
27Bは完全敗北ではない。4070ではStrataのFlash-Next、4090の別比較では27Bが速い。変わったのはGPU容量とパラメータ数だけで選ぶ常識だ。数値は2026年10月確認の外部結果で、本人の実測ではない。
目次
- なぜ今まで27Bが選ばれていたのか
- StrataはFlash-Nextの何を変えた?
- 同じRTX 4070で速度が逆転した
- RTX 4090では27Bの方が速い?
- 8GBの格安GPUでもFlash-Nextが動く
- 平均3bitでも知能は維持できるのか
- 27Bが終わった、本当の意味
1. なぜ今まで27Bが選ばれていたのか
27B級のDenseモデルは重みをGPUに置きやすく、CPU転送を抑えやすい。Qwen3.8-27B GSQ-RCOではIQ3_XXSが10.1GB、IQ3_Sが11.8GBで、12GB級GPUの候補にしやすい。[5]
これは重みファイルの容量で、実行時にはKVキャッシュやバッファ、ランタイム領域も要る。12GB未満でも全設定で12GB GPUへ収まるとは限らない。[5]
Qwen3.8-Flash-Nextは約125Bの大型MoEで、約51Bのn-gram表も持つ。IQ3_XXSの配布容量は約75.8GBで、27Bよりはるかに大きい。[4] 従来ならCPU/RAMへのオフロードで遅くなるサイズだ。
27Bは重みをGPU側へ置きやすく、対応エンジンも成熟していた。Flash-Nextは大きいが、パラメータ数だけでは測れない実行方式を持つ。
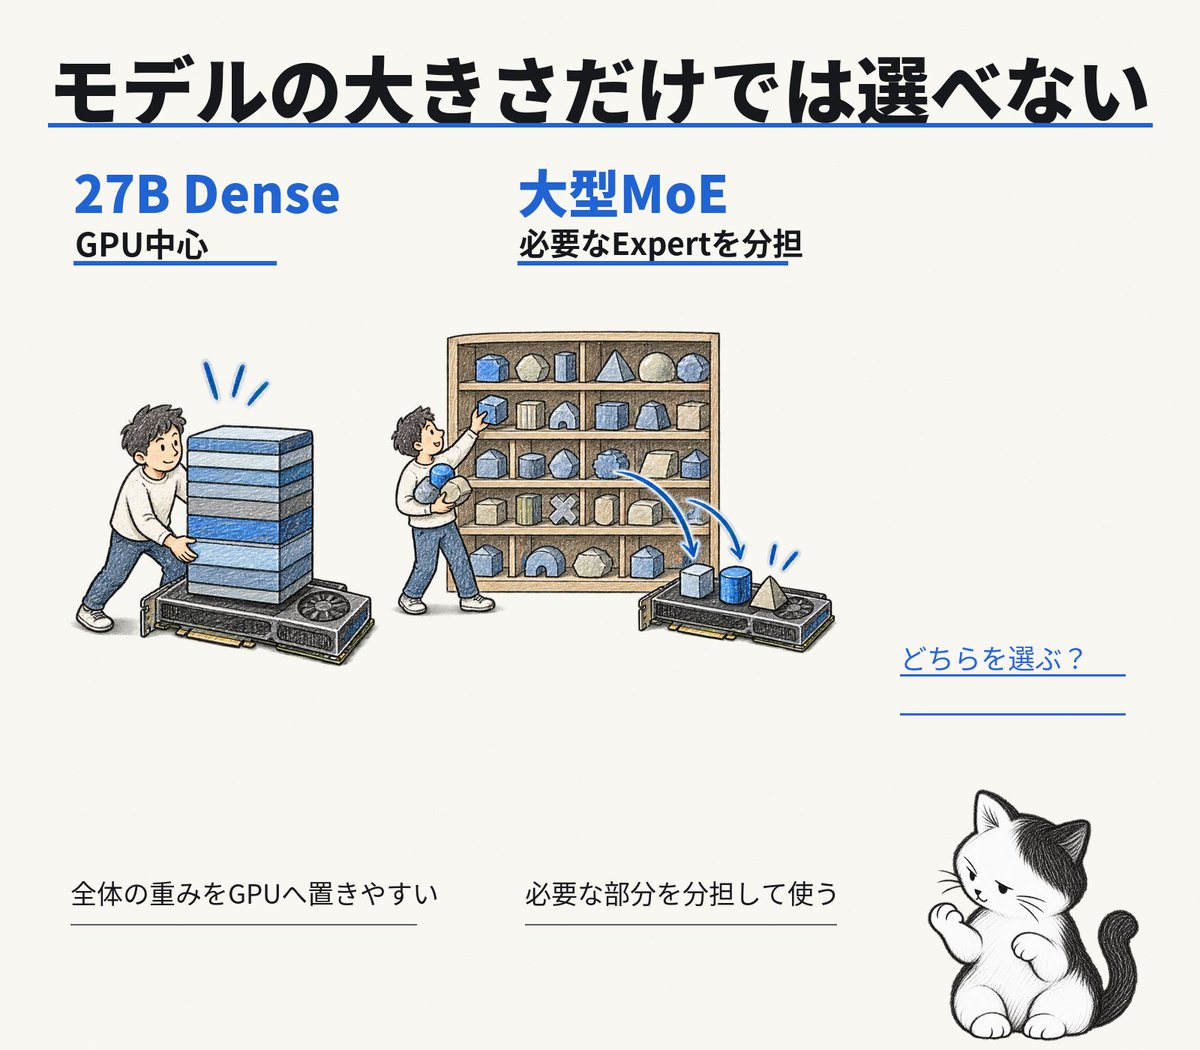
図1|Denseと大型MoEの配置差。27BはGPU側へ置きやすく、Flash-Nextは分担実行を前提にする。[1][4][5]
2. StrataはFlash-Nextの何を変えた?
Strataは大型MoEをVRAMへ詰め込むランタイムではない。GPUにAttentionなどの共通処理とhot Expert、CPU/RAMにcold Expert、SSDにn-gram表を分担させ、モデル全体をVRAMへ載せず推論する。[1]
Flash-Nextは48層・各512 Expertで、1トークンあたりtop10のRouted ExpertとShared Expertを使う。[4] 毎回すべてを計算せず、Strataは使用頻度の高いExpertをキャッシュする。圧縮ではなく、必要な部分を速い場所へ置く設計だ。
DecodeではMTP(複数トークン予測)も使う。補助予測を本体モデルが検証し、採用したトークンを確定する。入力を読むPrefillと出力を生成するDecodeは別処理で、同じtok/sとして混ぜてはいけない。[1]
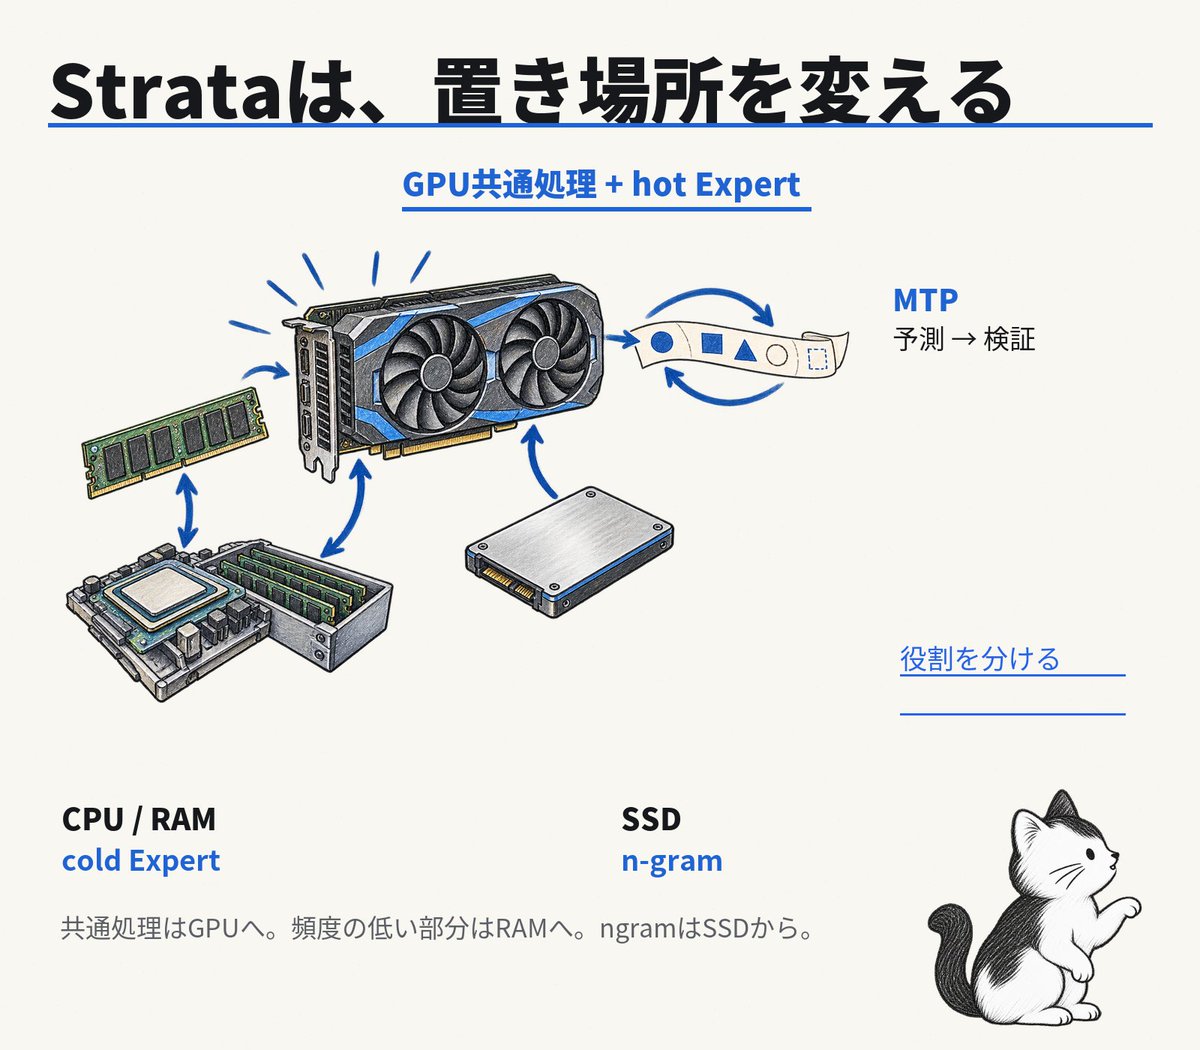
図2|Strataの配置。GPU・CPU/RAM・SSDへ役割を分担する。[1][4]
3. 同じRTX 4070で速度が逆転した
最も分かりやすい反例が、同じRTX 4070 12GBの比較だ。Core i5-12600K、RAM 64GB、NVMe SSDで、27Bはllama.cpp、Flash-Nextはllama.cppとStrataで測定された。[2] 27Bはnovel generation、Strataはsteady codeで生成内容も異なる。27BはUD-IQ3_XXS、従来のFlash-NextはAD-4.27bpw、StrataはIQ3_XXS。エンジン・量子化・生成内容の差を含む実用構成比較である。
Decodeは27Bのllama.cppが36.7 tok/s、Flash-Nextのllama.cppが20.5〜22.1 tok/s。Strataでは定常範囲53.2〜62.6 tok/sとなり、27Bも上回った。[2]
Prefillは27B約1,160 tok/s、旧Flash-Next約200 tok/s(cold)/385 tok/s(warm)、Strataは1,138〜2,013 tok/sだった。[2] 入力長や測定区間は同一と見なせず、全ワークロードの優位性へ広げられない。それでも12GBカード上で27Bを追い越す例が出た意義は大きい。
RTX 4070の外部比較
| 構成 | Decode | Prefill |
|---|---|---|
| 27B / llama.cpp | 36.7 tok/s | 約1,160 tok/s |
| Flash-Next / llama.cpp | 20.5〜22.1 tok/s | 約200(cold)/385(warm)tok/s |
| Flash-Next / Strata | 53.2〜62.6 tok/s | 1,138〜2,013 tok/s |
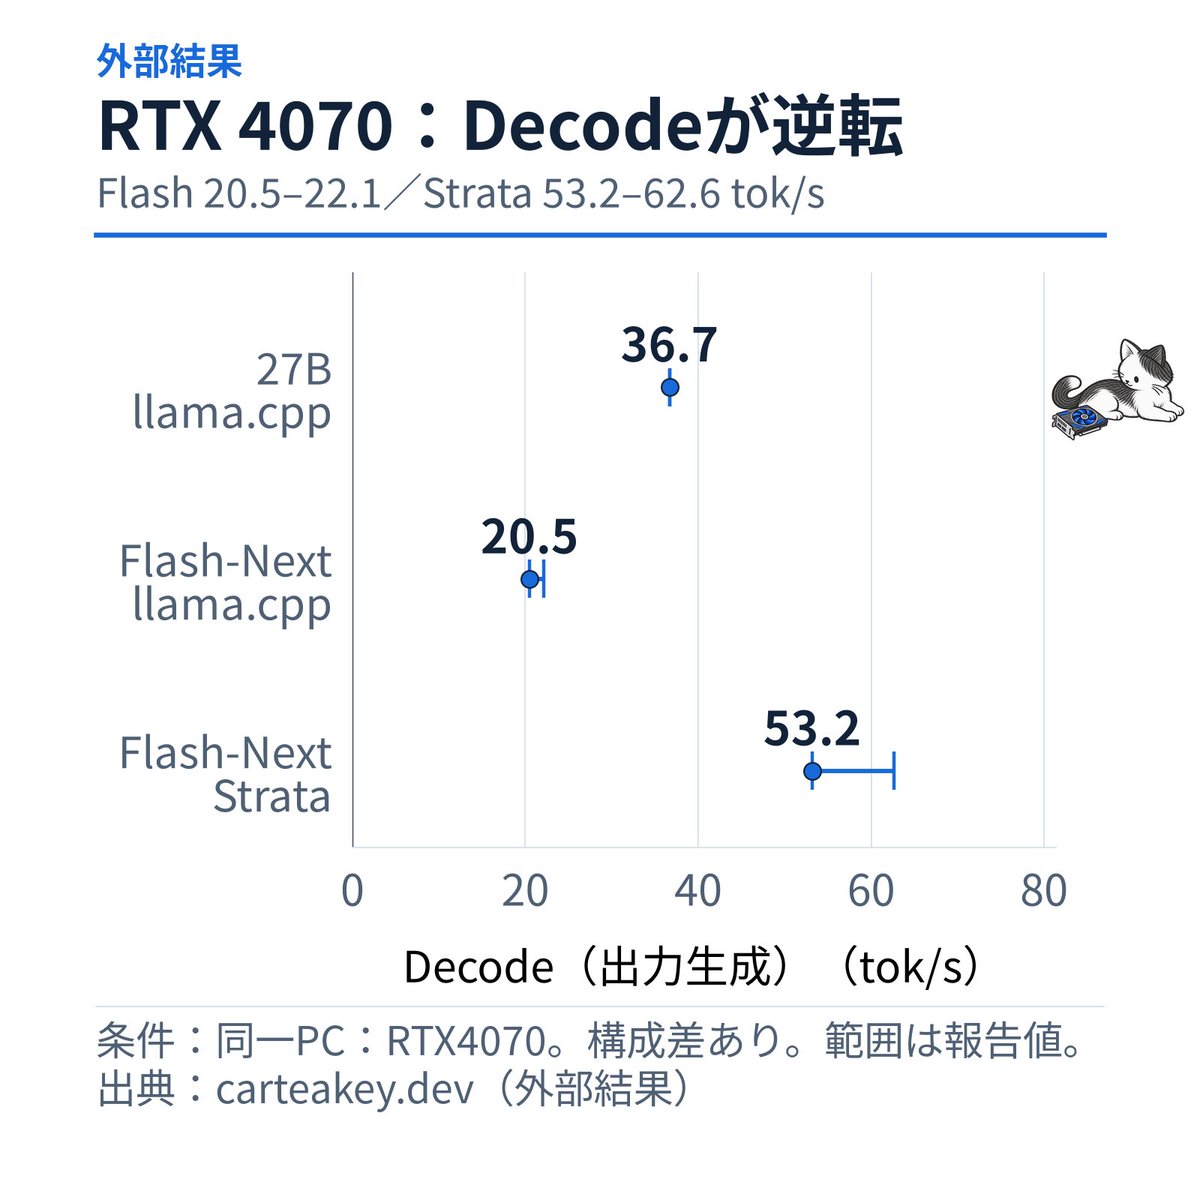
図3|RTX 4070のDecode。Strataは53.2〜62.6 tok/s。[2]
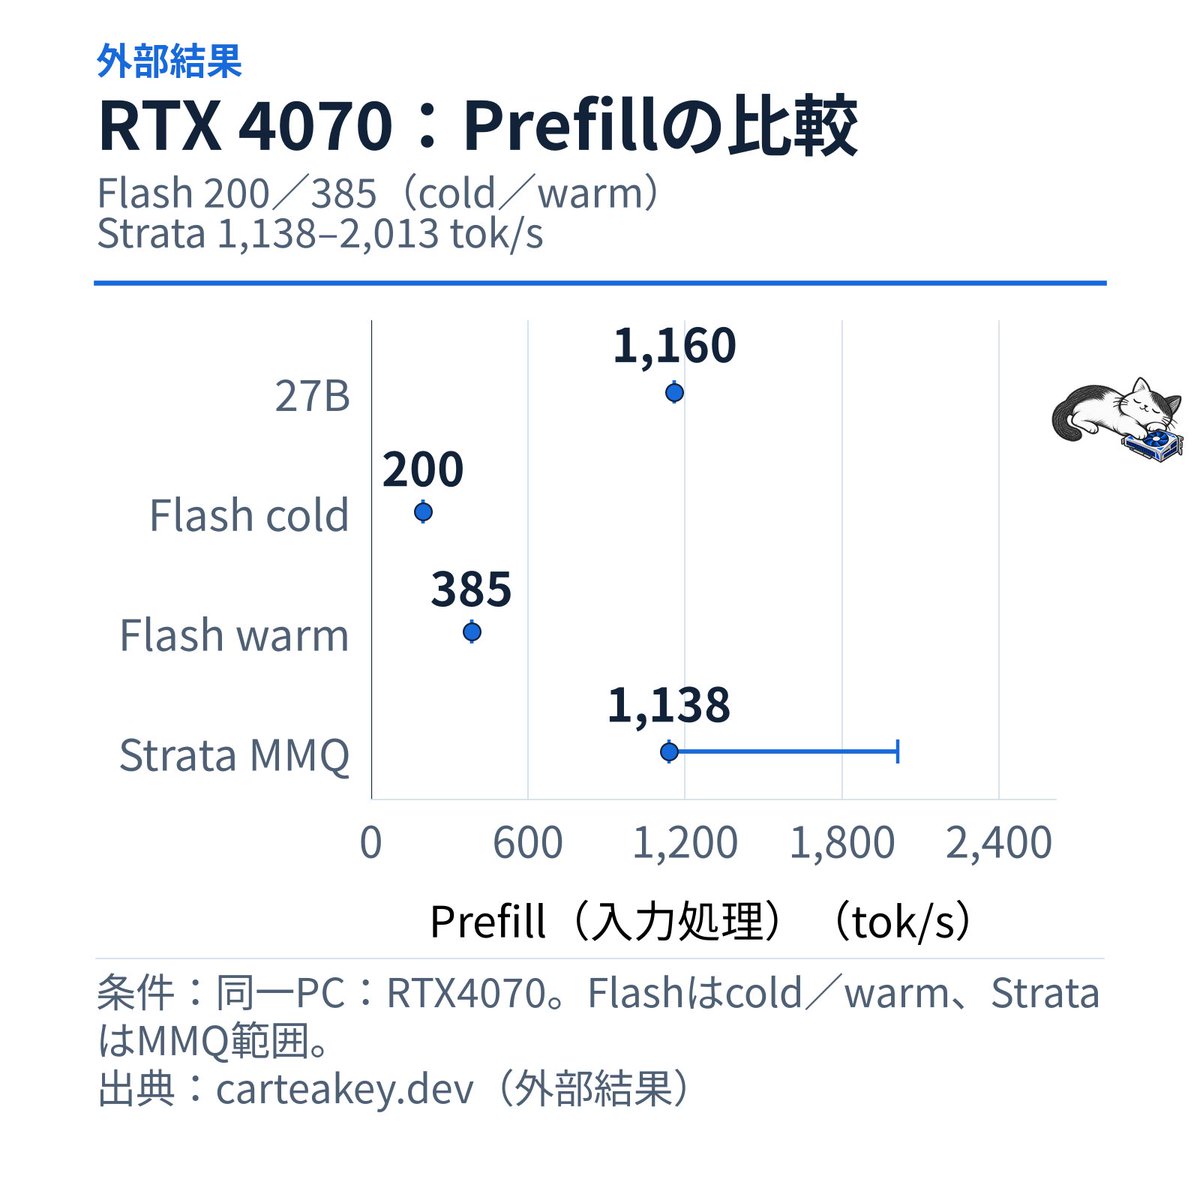
図4|RTX 4070のPrefill。Strataは1,138〜2,013 tok/s。[2]
4. RTX 4090では27Bの方が速い?
2026年10月1日のRTX 4090比較はSwift 1.5派生。27B(Q4/Q5)/NInferがDecode中央値152 tok/s、Prefill約2,700 tok/s(uncached代表値)、TTFT中央値225ms。Flash-Next(IQ3_XXS)/StrataはDecode中央値63 tok/s、Prefill約1,100 tok/s、TTFT中央値820msだった。[3] Prefillは中央値ではなく、peakは4,400/2,500 tok/s。速度だけなら27Bが速い。
RTX 4090の外部比較
| 項目 | 27B / NInfer | Flash-Next / Strata |
|---|---|---|
| Decode(中央値) | 152 tok/s | 63 tok/s |
| Prefill(uncached代表値) | 2,700 tok/s | 1,100 tok/s |
| TTFT(中央値) | 225ms | 820ms |
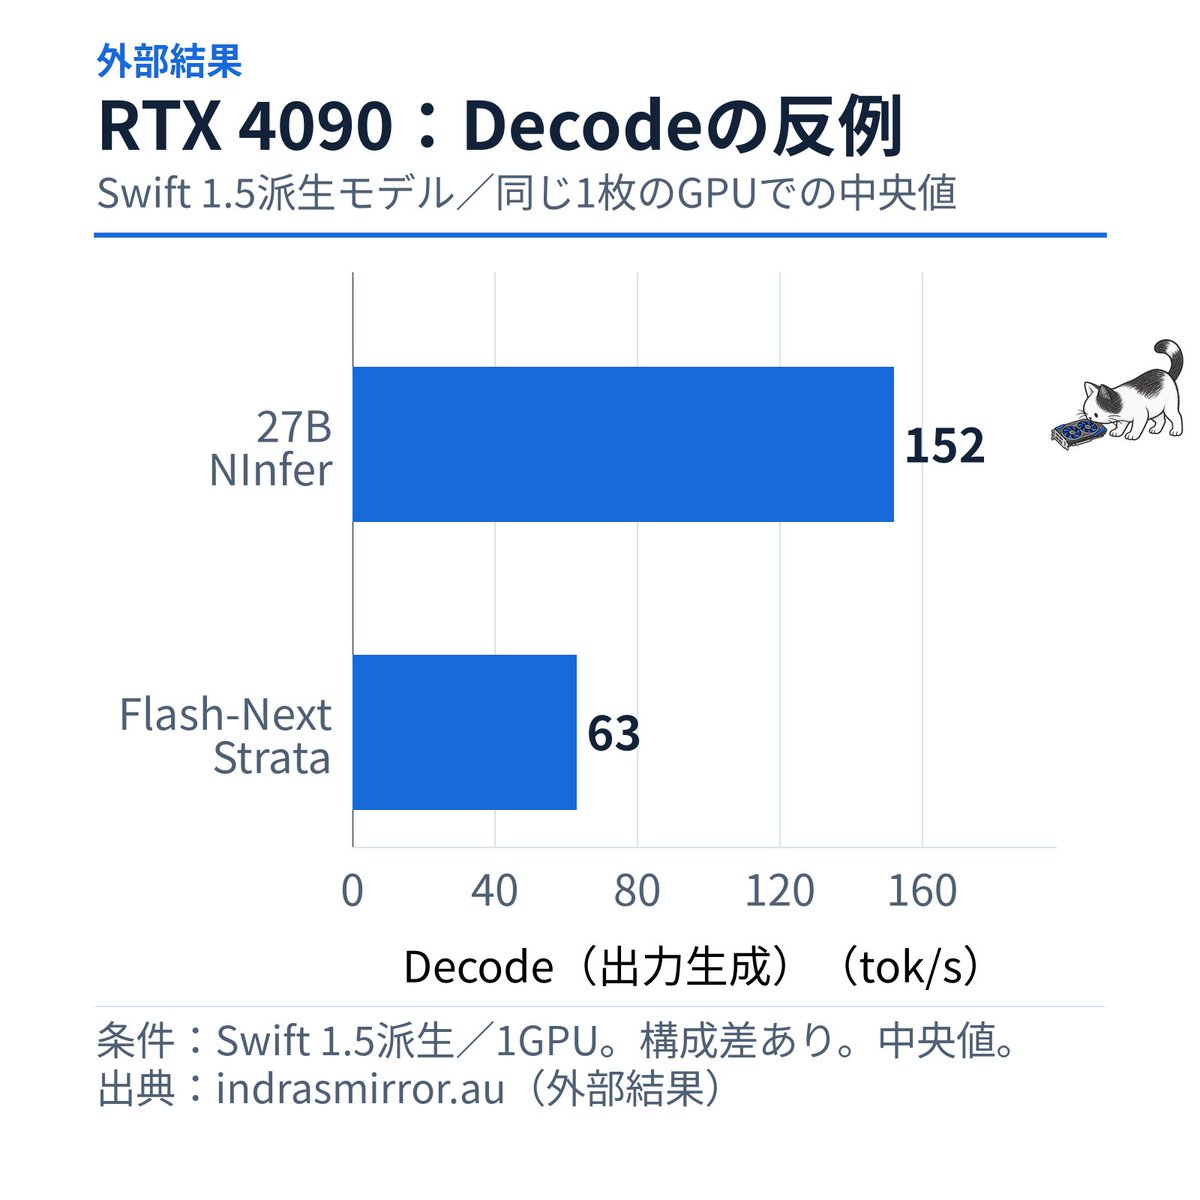
図5|RTX 4090のDecode中央値。27B 152、Strata 63 tok/s。[3]
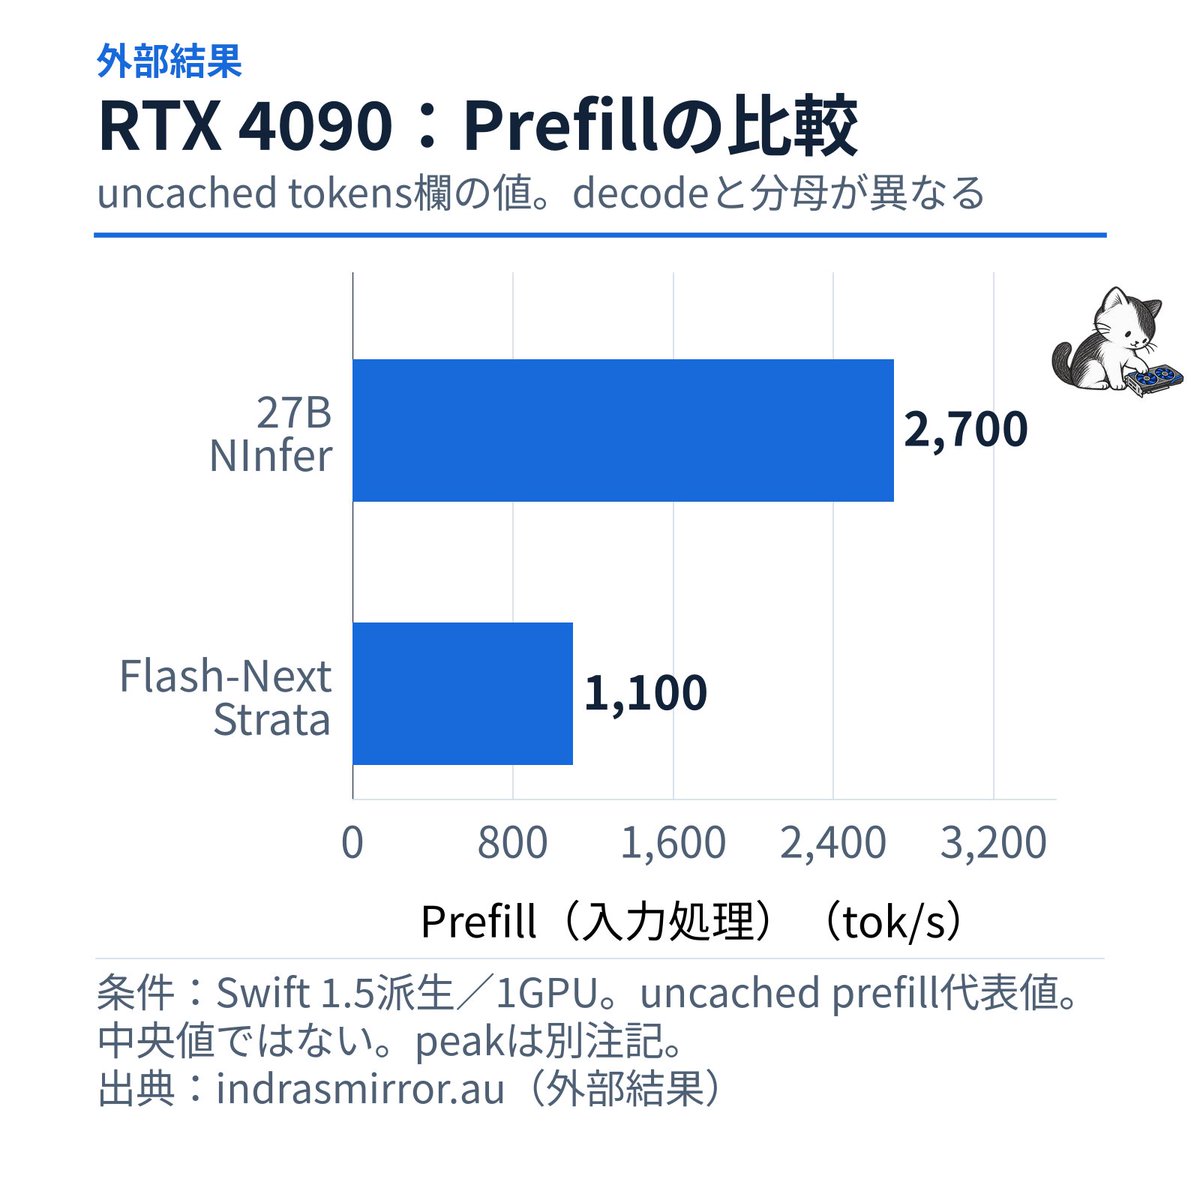
図6|RTX 4090のPrefill代表値。27B 2,700、Strata 1,100 tok/s。[3]
品質と作業内容を見ると単純な敗北ではない。日常エージェントsuiteのhidden graderは27Bが64/64、Flash-Nextが63/64。Scheme課題(spec 25+hidden robustness 35)は27Bが32/35、Flash-Nextが35/35だった。[3] 分母が異なり、一般的な正確率にはできない。
4090の結果は、StrataがどのGPUでも27Bを追い越す仕組みではないことを示す。演算性能、VRAM、キャッシュ、量子化、エンジンで位置づけは変わる。4070の逆転は、モデルの大きさだけで速度を予測できない証拠だ。
5. 8GBの格安GPUでもFlash-Nextが動く
公開例には、8GBのRX 5500 XT・IQ3_Sで15.3 tok/s、8GBのRX 5700 XT・Expert削減版Coderで18.0/20.3/23.3 tok/s(4K/16K/30K)がある。[6] RTX 3060 12GBはIQ3_XXS sampled drafting中央値43.3 tok/s。[8] V100 16GBの専用forkはQ2_0で47.3〜52.0 tok/sだった。[7]
旧GPUを含む公開動作例
| GPU・経路 | 構成・量子化 | Decode |
|---|---|---|
| RX 5500 XT 8GB | IQ3_S | 15.3 tok/s |
| RX 5700 XT 8GB | Coder削減版 | 18.0/20.3/23.3 tok/s(4K/16K/30K) |
| RTX 3060 12GB | IQ3_XXS sampled drafting | 中央値43.3 tok/s |
| V100 16GB 専用fork | Q2_0 | 47.3〜52.0 tok/s |
同条件のランキングではなく、特殊ビルド、削減版、専用fork、CPU/RAM分担を含む「動作した例」である。[6][7]
27BのIQ3_XXSは10.1GBで、8GB GPUへ全載せできない。CPUオフロードなら動く可能性はあるが、GPUだけで完結しない。Flash-NextもRAM、NVMe SSD、対応ビルド、設定調整までが実用コストになる。
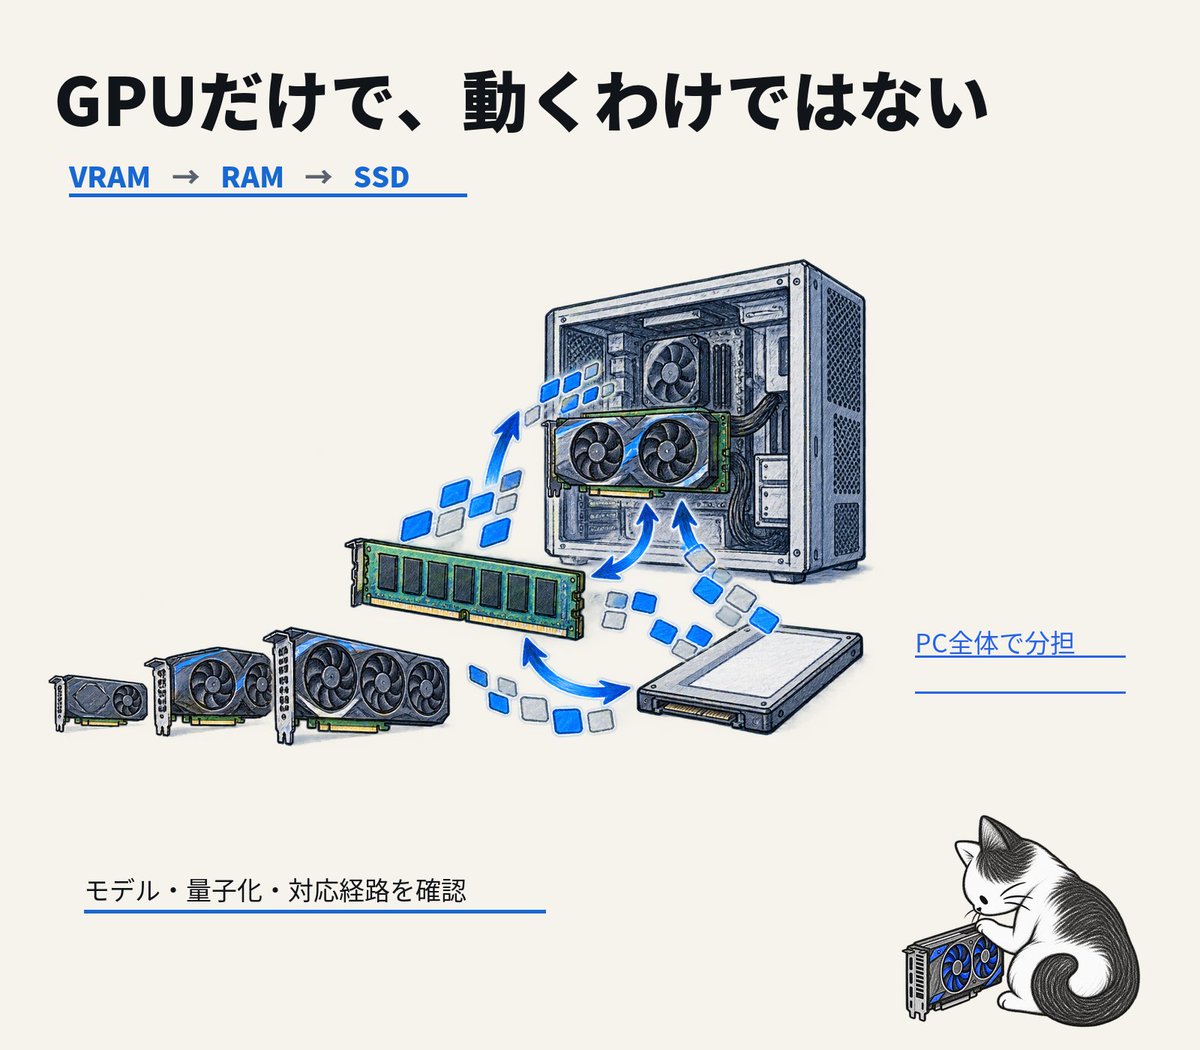
図7|GPU・RAM・SSDを含む実行条件の概念図。公開例は経路と量子化が異なる。[6][7][8]
6. 平均3bitでも知能は維持できるのか
Flash-Nextと27Bの比較を支えるのが量子化だ。Flash-NextのIQ3_XXSは本体重みの平均3.0bpwで、n-gram表は4.5bpw。GSQ-RCOは一律3bitではなく、精度に敏感なテンソルへ高いbitを配る設計だ。[4][5]
BF16対IQ3_XXSは、AIME25が100対100、GPQA-Diamondが91.9対91.4、LiveCodeBench v6が87.4対86.3。3指標の平均は93.1対92.6、スコア比は約99.4%だ。[4] 掲載3課題の平均比であり、全能力、日本語、長文、画像入力、エージェント運用を保証しない。
Qwen3.8-Flash-Nextの外部評価
| 評価 | BF16 | IQ3_XXS |
|---|---|---|
| AIME25 | 100 | 100 |
| GPQA-Diamond | 91.9 | 91.4 |
| LiveCodeBench v6 | 87.4 | 86.3 |
| 3指標の単純平均 | 93.1 | 92.6 |
「平均3bitでも知能は維持できるか」への答えは条件付きだ。IQ3_XXSは特定ベンチでBF16に近いが、量子化方法、テンソル配分、モデル構造、課題で結果は変わる。[4][5]
7. 27Bが終わった、本当の意味
27Bには今も価値がある。12GB前後のGPUで重みを扱いやすく、対応エンジンも成熟している。4090のように速度優先なら合理的な場面もあり、大型MoEより常に遅い・低品質とはいえない。
変わったのは選び方だ。VRAMとパラメータ数だけでなく、構造、量子化のbit配分、Expert配置、CPU/GPUの並列処理、エンジン対応を見る。4070の逆転と4090の反例は、名前だけで選べないことを示した。
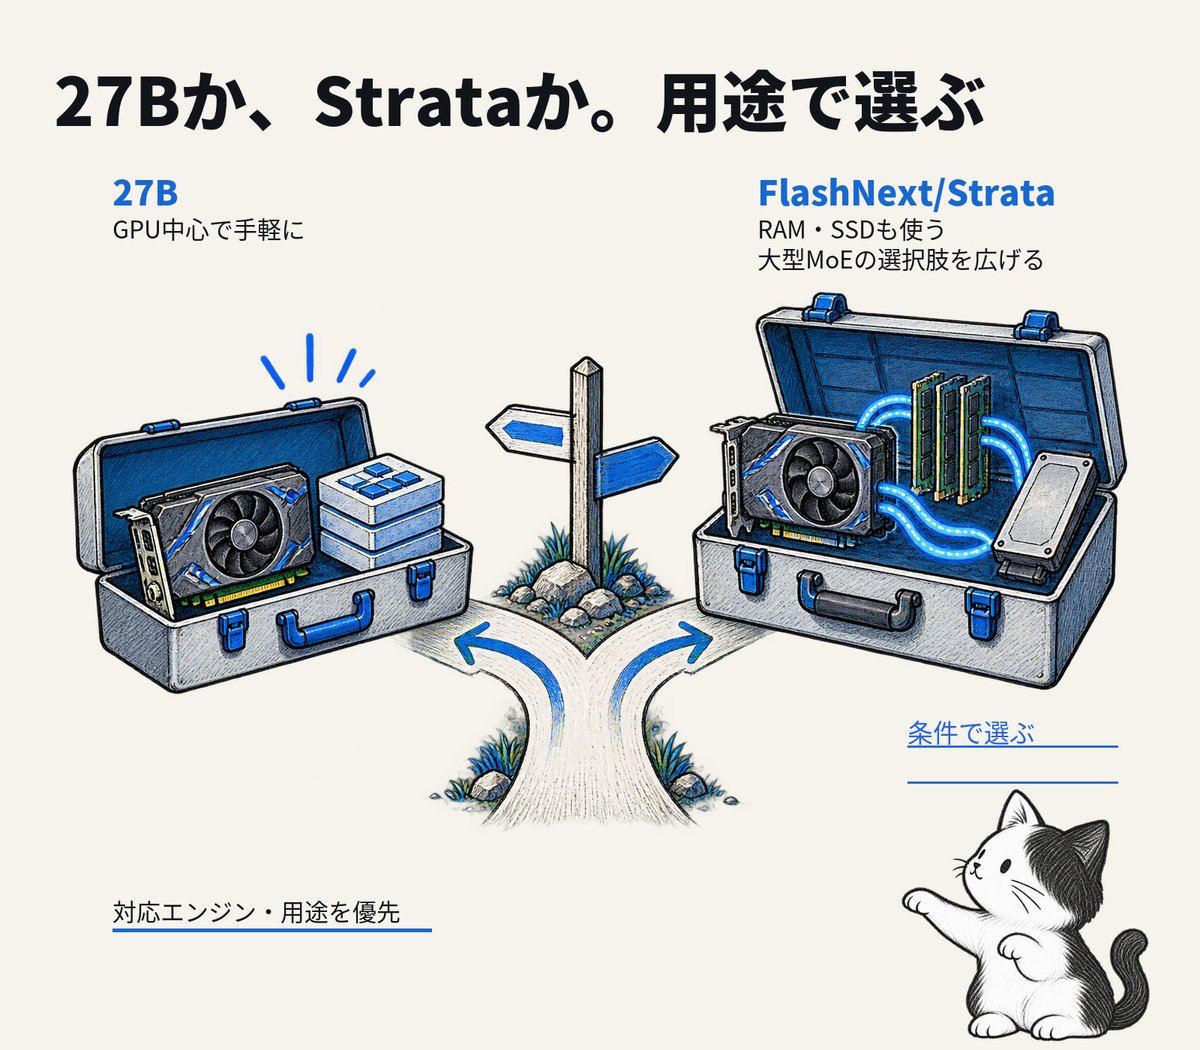
図8|選択条件。速度・VRAM・配置・対応エンジンを分けて判断。
終わり始めたのは27Bそのものではない。「限られたGPUでは27B級のDenseモデルを選ぶしかない」という、これまでの常識なのだ。
出典
確認日:2026年10月10日。数値は外部公開結果で、本記事の実機測定ではない。
注:外部ベンチは条件が異なるため、単一のGPUランキングではない。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


