
【小路独家】Anthropic 面试真题:profiler 采样还原调用事件(3 Parts / 55 分钟)
文章目录
(Anthropic Real Interview Question: Reconstructing Call Events from Profiler Samples (3 Parts / 55 min)
题目要求:采样 profiler 只能看到快照
profiler 每隔一段时间抓一次调用栈:Sample(ts, stack),stack 从外层(main)到内层(正在执行的函数)。
你看不到函数真正的进入 / 返回时刻——两次采样之间发生又结束的调用,完全 invisible,只能靠快照序列反推。
两个约定(动手前先跟面试官确认):
-
frame 的身份是 (depth, name),不是 name。递归时同一名字在不同深度 = 两个不同的 frame。
-
事件的时间戳是"观察到变化的时刻",不是函数真正的起止时刻。
Part 1:快照 → 事件
convert_samples_to_events(samples, end_time),samples 按 ts 严格递增。
-
第一个 sample:栈里每个 frame 全部 start,从外到内,时间戳记第一个 sample 的 ts。
-
相邻两个 sample:从外向内逐位对比,找最长公共前缀 LCP。老栈里位置 ≥ p 的 frame 全都 end(从内到外——被调者先返回);新栈里位置 ≥ p 的 frame 全都 start(从外到内——调用者先入栈)。时间戳都记后一个 sample 的 ts。
-
相邻 stack 完全一样 → 零事件(这就是压缩)。
-
end_time:最后一个 sample 里还活着的 frame 全部 end,从内到外。注意:input 耗尽不会提前关 frame,只有 end_time 能关。
例子:
t=0.0: [main]
t=1.0: [main, solve]
t=2.0: [main, solve, solve]       # 递归:两个不同的 solve frame
t=2.5: [main, solve, solve]       # 完全一样 → 无事件
t=4.0: [main, solve, solve, solve]
t=6.0: [main, solve, helper]      # 内层两个 solve 返回,helper 进来
end_time = 9.0
事件流:start main@0,start solve@1(t=1.0),start solve@2(t=2.0),start solve@3(t=4.0);t=6.0 时 LCP=2:先 end solve@3、end solve@2(从内到外),再 start helper@2;t=9.0:end helper@2、end solve@1、end main@0(从内到外)。
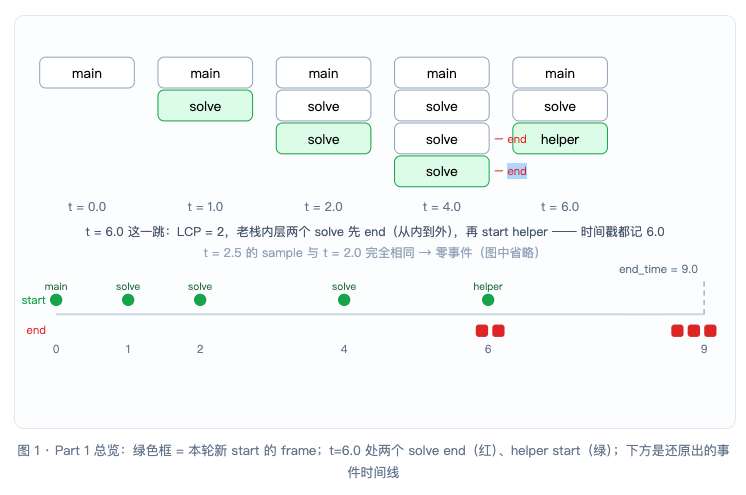
图 1 · Part 1 总览:绿色框 = 本轮新 start 的 frame;t=6.0 处两个 solve end(红)、helper start(绿);下方是还原出的事件时间线
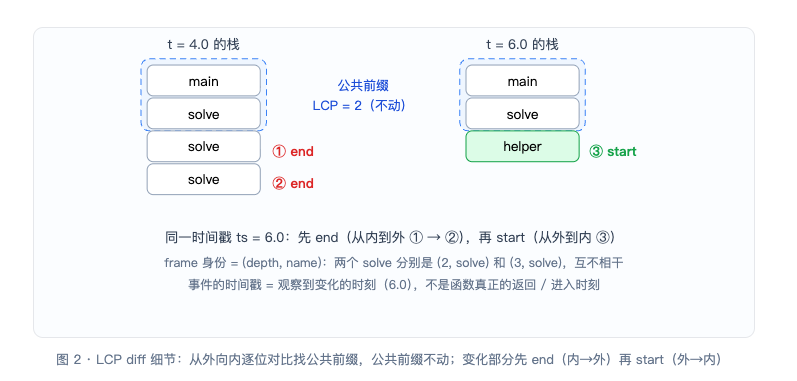
图 2 · LCP diff 细节:从外向内逐位对比找公共前缀,公共前缀不动;变化部分先 end(内→外)再 start(外→内)
Part 1 参考代码
from typing import Literal, NamedTuple

class Sample(NamedTuple):
    ts: float
    stack: list[str]          # 外层在前,内层在后

class Event(NamedTuple):
    kind: Literal["start", "end"]
    ts: float
    name: str
    depth: int                # frame 身份 = (depth, name)

def _lcp_len(a, b):
    n = 0
    while n < len(a) and n < len(b) and a[n] == b[n]:
        n += 1
    return n

def convert_samples_to_events(samples, end_time):
    if not samples:
        return []
    events = []
    first = samples[0]
    for depth, name in enumerate(first.stack):   # 第一个 sample:全员 start,从外到内
        events.append(Event("start", first.ts, name, depth))
    prev = first.stack
    for s in samples[1:]:
        p = _lcp_len(prev, s.stack)
        for d in range(len(prev) - 1, p - 1, -1): # 先 end:从内到外
            events.append(Event("end", s.ts, prev[d], d))
        for d in range(p, len(s.stack)):          # 再 start:从外到内
            events.append(Event("start", s.ts, s.stack[d], d))
        prev = s.stack
    for d in range(len(prev) - 1, -1, -1):        # end_time:全关,从内到外
        events.append(Event("end", end_time, prev[d], d))
    return events
Part 2:流式 + 去噪
真实 profiler 是流式吐 sample 的:stream_debounced_events(samples, k)。
-
samples 是只能读一次的 iterator
-
只保留 O(depth) 的状态,事件一旦确定就 yield
-
没有 end_time:输入结束时还没确认关闭的 frame,直接没有 end 事件
去噪(debounce):采样有抖动,某一帧可能昙花一现。规则:一个 frame 必须在连续 k 个 sample 里占据同一位置,才发 start(时间戳记第 k 个 sample);空位也必须连续 k 个 sample,才发 end。k=1 就退化成 Part 1(减去 end_time 关闭)。
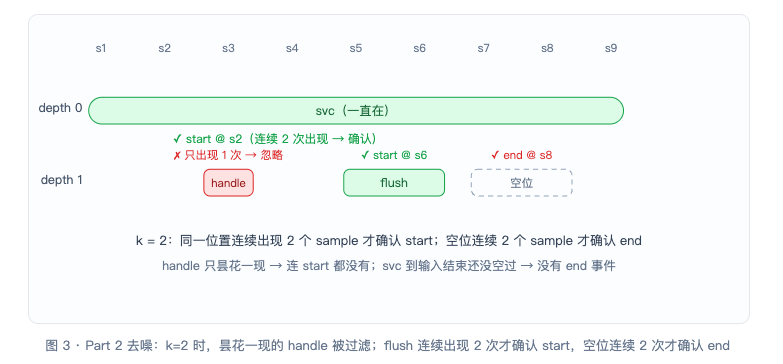
图 3 · Part 2 去噪:k=2 时,昙花一现的 handle 被过滤;flush 连续出现 2 次才确认 start,空位连续 2 次才确认 end
最容易错的点:frame 的身份沿 LCP 链追踪,不看名字。["req","validate"] → ["worker","validate","req"]:第 0 位就对不上(LCP=0),老栈两个 frame 全 end,新栈三个全是新 frame——即使 validate 还在第 1 位、req 跑到了第 2 位。链断了就是断了,名字相同也不认。
例子(k=2):[svc] 连续出现 2 次 → start 记在第 2 个 sample;中间冒出来一次的 handle(只出现 1 个 sample)直接忽略,不产生任何事件。
Part 2 参考代码
复用 Part 1 的 Sample / Event / _lcp_len 定义:
def stream_debounced_events(samples, k):
    """流式去噪:O(depth) 状态,事件一旦确定就 yield。"""
    depths = []   # 每层状态: live=已确认的frame, absent=空位连续计数,
                  #           cand=候选frame, run=占据连续计数
    prev = []

    def slot(d):
        while len(depths) <= d:
            depths.append({"live": None, "absent": 0, "cand": None, "run": 0})
        return depths[d]

    for s in samples:
        st = s.stack
        p = _lcp_len(prev, st)
        ends, starts = [], []
        for d in range(max(len(prev), len(st), len(depths))):
            cur = st[d] if d < len(st) else None
            sl = slot(d)
            if d < p:
                # 链没断:上一轮的 occupant 继续
                if sl["live"] == cur:
                    sl["absent"] = 0
                else:
                    if sl["live"] is not None:        # 旧 frame 继续 vacant
                        sl["absent"] += 1
                        if sl["absent"] == k:
                            ends.append(Event("end", s.ts, sl["live"], d))
                            sl["live"], sl["absent"] = None, 0
                    if sl["cand"] == cur:             # candidate 继续计数
                        sl["run"] += 1
                        if sl["run"] == k:
                            starts.append(Event("start", s.ts, cur, d))
                            sl["live"], sl["cand"] = cur, None
                            sl["absent"], sl["run"] = 0, 0
            else:
                # 链断了:这一层全是新 frame
                if sl["live"] is not None:
                    sl["absent"] += 1
                    if sl["absent"] == k:
                        ends.append(Event("end", s.ts, sl["live"], d))
                        sl["live"], sl["absent"] = None, 0
                sl["cand"], sl["run"] = None, 0       # 旧 candidate 静默死亡
                if cur is not None:
                    sl["cand"], sl["run"] = cur, 1
                    if k == 1:
                        starts.append(Event("start", s.ts, cur, d))
                        sl["live"], sl["cand"] = cur, None
        for e in sorted(ends, key=lambda e: -e.depth):    # 同 ts:end 从内到外
            yield e
        for e in sorted(starts, key=lambda e: e.depth):  # 同 ts:start 从外到内
            yield e
        prev = st
Part 3:后缀匹配(crash trace 归因)
TraceIndex:预先建好一批完整调用栈(entry → 出错点),给一个不完整 trace 的尾部(最后几帧),找出所有"尾部完全一样"的已知 trace。
-
match_suffix(["parse","oom"]) → 所有以 parse,oom 结尾的 trace id,字典序排列
-
谁都不匹配 → 返回字符串 "UNKNOWN"(不是空 list)
-
已知 trace 比 query 短也算不匹配
本质:后缀 trie。把每条 trace 反转后建成 trie(后缀变前缀),query 也反转,从根往下走,收集子树下所有 trace id。
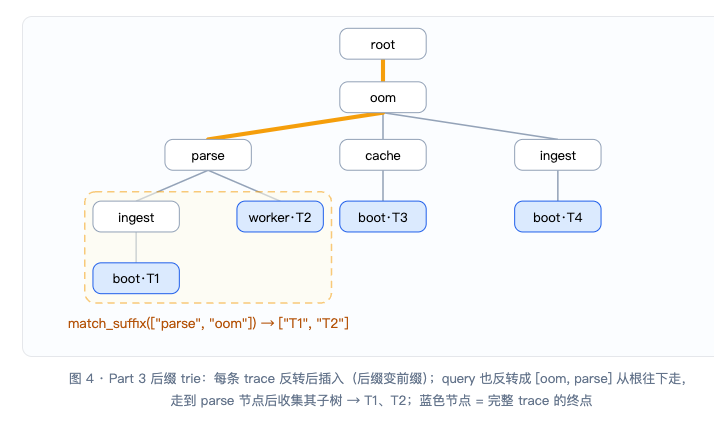
图 4 · Part 3 后缀 trie:每条 trace 反转后插入(后缀变前缀);query 也反转成 [oom, parse] 从根往下走, 走到 parse 节点后收集其子树 → T1、T2;蓝色节点 = 完整 trace 的终点
Part 3 参考代码
class TraceIndex:
    def __init__(self, traces):
        self.trie = {}
        for tid, frames in traces:
            node = self.trie
            for f in reversed(frames):     # 反转:后缀变前缀
                node = node.setdefault(f, {})
            node.setdefault("$ids", []).append(tid)

    def match_suffix(self, frames):
        node = self.trie
        for f in reversed(frames):
            if f not in node:
                return "UNKNOWN"
            node = node[f]
        out, stack = [], [node]
        while stack:                        # 收集子树下所有 trace id
            nd = stack.pop()
            out.extend(nd.get("$ids", []))
            stack.extend(v for k, v in nd.items() if k != "$ids")
        return sorted(out) if out else "UNKNOWN"
解法要点
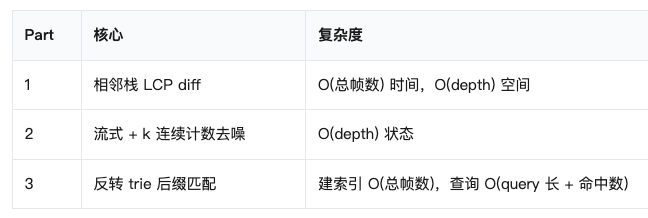
Part 1 的顺序是灵魂:end 从内到外(被调者先返回),start 从外到内(调用者先入栈)。写反了,事件流在语义上就是错的——面试官一眼能看出来。
备考清单
-
先讲清楚"为什么这个 sample 说明函数结束了"再写代码——面试官看重这个理解
-
Part 1 顺序:end 内→外,start 外→内;frame 身份 = (depth, name)
-
Part 2:frame 身份看链不看名;k=1 退化成 Part 1;O(depth) 状态是硬要求
-
Part 3:反转 trie;"UNKNOWN" 是字符串不是空 list;结果字典序
-
55 分钟 3 parts,Part 1 是地基,先写对再往后走
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


