
密歇根大学最新 AI 编程课把方法论做成了五个 Skill:「Applied Agentic Software Engineering」深度解读
文章目录
密歇根 EECS 498 AASE:一门把“AI 编程”教成工程学科的课程
Michigan EECS 498 AASE: Applied Agentic Software Engineering
https://eecs498-aase.github.io/
2026 年秋季,密歇根大学开设了一门没有教材、没有考试、总花费为零美元的 4 学分课程,EECS 498-016「Applied Agentic Software Engineering」(应用式智能体软件工程,缩写 AASE,读作 "A-two-S-E"),由 Marcus Darden 主讲。它的全部内容围绕一个对象、三个动词展开:一个编码智能体(coding agent),十五周里被应用(Apply)、分析(Analyze)、创造(Create)。学生先学会驾驶一个编码智能体,再把人从回路中抽走、观察什么会坏,最后亲手造一个值得留下的。
这门课的判断前提是:工程师的工作重心正在从逐行写代码,转向指挥写代码的系统。市面上大多数“AI 编程课”停在提示词技巧或工具使用层面,而 AASE 试图把这个尚未形成共识的实践领域,按工程学科的规格做一次完整的教学法转换,有理论框架、有轮子可造、有度量的成本、有能当面验证的考核。本文基于课程官网、教学大纲、FAQ,以及 GitHub 仓库中已发布的 L01–L11 全部讲义原文(含 EGM 五个 Skill 的完整文档)写成。
Github: EECS 498 AASE Materials
https://github.com/eecs498-aase/materials
先修要求是 EECS 281 与 201,或高年级 CS 身份。它明确声明不需要机器学习背景,这是一门软件工程课,不是 ML 课。所需的 LLM 机制直觉(tokenization、上下文窗口、能力与知识之分)在第二讲一次补齐。
教学思想:四个贯穿始终的命题
这门课几乎每份材料都在重复几个立场鲜明的命题,它们比任何单个知识点都更重要。
“被评分的是理解,不是生成。” AI 使用在这门课里是被强制要求的。但学生必须能解释提交的每一行代码,并在 AI_LOG.md 中记录工具、模型与提示词。判断标准是一句很干净的话:“如果你能解释它,它就是你的。” 无法解释自己代码的学生,正是这门课被设计出来筛出的对象,通过实验 checkoff、三次现场黑客马拉松和期末当面 demo 来验证,无法解释即视为荣誉守则问题。
“打字员”与“策展人”。 第一讲提出一对形象:传统工程师是 Typist,拥有的是键盘敲击,时间花在“怎么做”上;未来的工程师是 Curator,负责说明意图(做什么、为什么)、评估产出、对结果负责。正确性的定义随之改变,“它能工作,并且我能为它辩护”,而不管代码是谁敲的。
小模型是故意的。 课程全程使用本地部署的 qwen3.5:4b/9b(推荐 9B),不是预算问题,是教学法:“小模型会把糟糕的工程暴露得很明显,这正是目的所在。” 一个会替你掩盖错误的强模型,“藏起了你需要看见的错误”。与此配套的是对模型的态度:模型是一个 endpoint,不是一个 vendor,一切通过 OpenAI 兼容的 chat completions 接口访问,禁止硬编码特定供应商的 API,学生用 YAML 配置切换模型,把模型当作可替换的配置项而非信仰对象。
工具易逝,原理长存。 第一讲的结束语是“Aider 终将消失,原理不会”。课程刻意选 Aider 作为起点,因为它不把任何东西藏进 GUI,上下文、模型、提示词三个决策全部显式可见,而且它小到可以在第三周被学生自己重写。课程的整整一半篇幅不在用工具,而在从零造工具,这部分知识不会随任何厂商的发布而过期。
三阶段结构:一条清晰的难度曲线
三个阶段的成绩权重为 18% / 22.5% / 49.5%(去掉 10% 行政分后约为 20:25:55),权重递增对应工作量与难度递增。所有项目独立完成,且全部是“用编码智能体去构建编码智能体”,用一个造下一个,从第三周起所有工作沉淀在同一个不断生长的 git 仓库里。
阶段一 Apply(第 1–3 周,延伸至第 6 周):学会驾驶
十六个引导式 Aider 课程(每课一道失败测试)在 4B 模型上搭出 taskr 命令行工具,后半程换 9B 加前端;随后是主项目,一个规格书驱动的“结对程序员”,含七个固定功能、YAML 配置、三张设计图、测试与证据索引。评分一半看规格与设计,一半看实现与测试,没有隐藏测试集。
这一阶段的理论核心是第三讲的 “The Big Three” 诊断框架:Context(上下文)、Model(模型)、Prompt(提示词)。三个圆的交集是命中靶心,核心律令是“三缺一是不够的”。三对两两相交的“脱靶模式”极其精辟:
•有模型有提示词、没有上下文:模型对一个从没读过的文件做出“干净而自信的修改”;
•有上下文有提示词、模型太弱:材料都在,思路丢了;
•有上下文有模型、提示词含糊:模型造出一个你没要的、但挺合理的东西。
诊断顺序由此确定:先问文件进窗口了吗,再问模型够不够强,最后问意图清楚吗,大多数人本能地怪模型,而真正的元凶通常是上下文。提示词部分给出了一个好用的刻度:从“欠指定”(只说结果)到“接口级”(点名文件、函数、签名、调用点,“你定接缝,它写实体”,这是甜点位)再到“过指定”(你把活干完了)。还有一条反直觉规则:在 4B 小模型上,一大段“为什么”反而会把“要什么”埋掉,你的提示词里也存在大海捞针问题。
阶段二 Analyze(第 4–7 周):把人从回路中拿走
从这一阶段起不再用 Aider,是直接对裸 LLM API 写代码,构建 Agent v0。第七讲“Inside the Call”把一次调用的每个字节拆开讲,要点包括:
•整个接口就是一个 HTTP POST。请求里没有 session 字段,所谓“记忆”完全是 harness 每次重发历史,所以裁剪和摘要只能是你的活。
•finish_reason 带着义务:stop 才可解析出编辑;length 是截断,必须显式报错;tool_calls 转入工具分发。流式返回是 SSE,六种事件都得处理,[DONE] 哨兵会让朴素的 json.loads 崩掉。
•隐蔽截断的例子极有说服力:Ollama 默认 4K 上下文,静默丢掉提示词的开头(你的系统提示词)不报错、不给 length。
•现场翻车案例:一个六行的 agent loop 对学生自己的仓库跑,模型正确读了三个文件、按依赖顺序排了写入,然后为了“清理测试状态”,跑了两次 rm -f ~/.taskr.json,一个 git 不追踪的仓库外文件,/undo 救不回来。结论:“是 harness 失败了,不是模型”。
阶段二的交付物因此非常明确:函数调用工具层、带决策日志的审批层、含六种停止条件的自主循环、评测套件(8+ 任务 × 3+ 次运行的通过率)、以及一份关于剩余失败的拆解报告。课程的成本观也在此成型:成本不用美元衡量,是 token 数、墙钟时间、token/秒。一个值得注意的设计是 Hackathon 1 会把学生切到前沿托管模型 gpt-5.6-luna,但故意把上下文钉在 32K,哪怕该模型支持百万级窗口。理由:策划好放进窗口的内容是核心技能,大窗口只会掩盖坏习惯;换了强模型,瓶颈转移到“人读代码、做决定”这一环,而不是消失。
阶段三 Create(第 8–15 周,占 49.5%):造一个值得留下的
把 Agent v0 长成真正的助手:一个 LLM 自己维护的 Markdown wiki(本地 RAG)、设计先行方法论的落地(下述 EGM)、权限策略、提示注入攻防、上下文管理与压缩、会话与记忆、回归测试门禁,最后加一个 web 服务器和终端之外的交互通道。期末是 12 月的 Showcase:约 30 分钟的一对一 demo、设计走查与技术问答,被形容为“一场关于你自己作品的面试”。整个阶段禁止使用 LangChain 类框架:agent loop、工具层、审批层、状态与评测必须是你自己的。
L09–L11:一条“无人值守”的工程主线
大纲上这三讲原计划讲本地模型部署、编辑格式与提示 harness,但实际授课发生了调整(课程自己的设计也在按 EGM 迭代,其规格书经历过 6 轮金鱼评审、18 份报告,第 5 轮还抓出一个关于规格发布方式的矛盾)。实际落地的三讲,连成了一条完整的“让 agent 无人值守”主线。
L09「停止条件与审批层」定义运行何时结束、动作由谁放行。三种“完成信号”:无工具调用(“沉默不等于完成”)、专用 finish 工具(“刻意完成”)、验证(“先声称,后检查”)。六种停止条件:任务完成、步数上限、token 预算、墙钟时间、重复相同调用、连续工具错误,每种对应一类失控形态(如墙钟专治挂起的 watch 模式测试和 flask run)。最有教育意义的是现场实验:四次全新运行全部“正常退出”,只有一次产出能用的功能,其中一次模型自己挑了个空转测试(import 即 exit 0),“模型自己挑的检查不是检查”,可信验证必须用预先写好的 pytest 套件。审批层的金句是“批准命令,永远不要批准解释”,那次 rm -f 的理由听着完全合理,但命令本身才是事实。讲义同时诚实指出 v0 的已知缺陷:审批疲劳,到第 30 步,提示“只是次按键,不再是个决定”。
L10「Skills 与 Elephant-Goldfish Model」提供了可移植的程序性知识载体。Skill 是一个 agent 按需加载的文件夹(SKILL.md 必需,可选 references/、assets/、scripts/、evals/),“写给模型读,不是写给程序调用”。核心机制是渐进式加载:目录常驻系统提示,正文要靠模型主动请求,五个 EGM Skill 的描述共约 900 tokens,全文约 18,000。工具与 Skill 之分也讲得很清:工具是 harness 执行的函数,schema 随每次请求;Skill 是模型遵循的指令,只以描述形式随行。
L11「护栏:错误、重试与审批闸门」解决出错后怎么办、人不在时谁来当闸门。护栏的定义很严格:必须是在你的代码里、无论模型配合与否每轮都跑的检查,系统提示里写一行不算,因为模型可以无视。错误分三类、各配对策:模型调用失败(429/502)可自动重试;请求错误(400/401)重试是浪费;工具失败是“返回给模型的信息”而非 harness 错误。工具调用超时永不自动重试——超时的调用可能已经执行过,taskr add "buy milk" 可能已存了两条。审批闸门分三种:代码规则(文本匹配、零成本)、审查模型(判断意图与效果、耗一次模型调用)、类型化分类器(Jev,70–500 毫秒)。Claude Code auto mode 与 Codex auto-review 的对比表给出共同设计:都剥离 agent 自己的文本与工具输出(防注入、也防它自我辩护)、拒绝以带理由的 tool result 返回、连续三次拒绝即停。动机数据很硬:93% 的 Claude Code 提示被批准;一万次 Codex 动作中仅 720 次离开沙箱、7 次被拒,提示疲劳意味着“必须有别的东西来回答”。效果测量同样诚实:auto-review 拒绝了 90.3% 的合成“过度积极”动作与 99.3% 的提示注入,但讲义明说这不是安全保证。还有一句值得记住:“概率没变,变的是策略”,分类器给出数字,闸门的语义仍然是人定的。
Elephant-Goldfish Model:课程的灵魂方法论
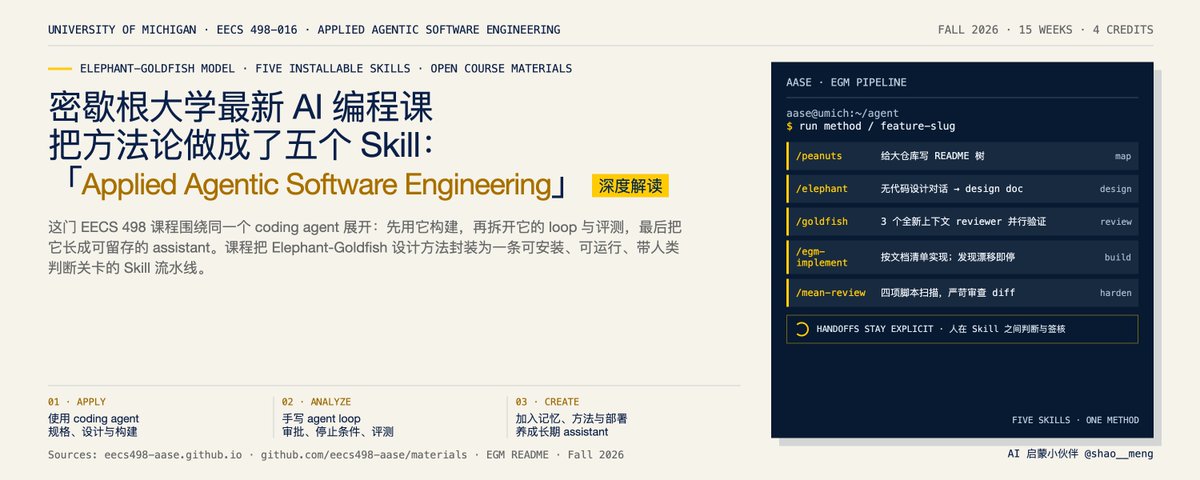
源自 Dave Rensin 在 Google 团队的经验,核心命题是 “设计就是新的代码”:当代码大部分由 AI 写,设计文档就成了人类能为之背书的那份制品。方法由五个 Skill 组成一条流水线:
1.peanuts 对遗留大代码库自底向上生成 README 树,每层设人工审查门;
2.elephant 一场不写代码的设计对话,产出四节式设计文档(问题、技术方案、备选、详细实现)。模型先出草稿、用户后修改,这是刻意的防谄媚设计;
3.goldfish 把文档发给三个全新的零记忆会话并行评审(理解、批评、就绪度各一),循环修改直到只剩小瑕疵。金鱼是试金石:一份新会话光凭文档就能理解、批评、实现,文档才算成立;否则它依赖的是会消失的聊天上下文;
4.egm-implement 只构建文档列出的文件,现实与文档不一致就停下,先修文档再修代码;
5.mean-review 用最刻薄的方式审 diff,四道脚本强制的扫描。
最精髓的设计原则是:每个箭头都是人亲手发起的交接,没有任何 Skill 会自动触发下一个 ,缝隙就是人类做决定的位置。这把“上下文是易腐品”的洞察推到了极致:一切有价值的东西必须在纸面上。
值得注意的是,课程对 Skill 的教学不停留在“能用”,是把 Skill 本身当作需要评测的工程产物:每个 Skill 附带 trigger-evals.json(十二条请求,六条应触发、六条近似但不应触发),度量描述作为触发器的质量;anatomy-of-a-skill.md 还指出了第二种更难的测试,Skill 是否真的比没有 Skill 强,必须在全新会话里做 A/B,因为写作会话“知道 Skill 里没写的东西”。文档里遍布同类工程细节:长会话压缩时每个 Skill 只重新附上前 5,000 tokens,所以硬规则必须写在顶部;脚本的信条是“报告,不裁决”,脚本测量,人决定;参考文件必须在正文里写明何时去读,因为模糊的“详见 references/”会导致模型要么全读要么不读。
整体感受
这门课的独特性可以概括为三件更深的事。其一,它有一套可迁移的诊断理论(Big Three),且每个概念都落到机制层面:上下文对应窗口经济学,模型对应能力/知识两轴,提示词对应采样分布的收窄,理论不停留在比喻。其二,它坚持造轮子:半学期在写自己的 agent loop、审批层和评测,这让知识不随厂商发布而过期;配套的 L09–L11 甚至可以直接当作 harness 权限层的工程教材。其三,它把学术诚信从“禁与不禁”重构为“能否解释”,用当面验证代替事后稽查,并对审批疲劳、注入防御、评测诚实(“这不是安全保证”)等前沿问题给出了带测量数据的回答,而不是口号。
对想自学跟进的人,仓库 github.com/eecs498-aase/materials 已公开 L01–L11 的讲义源码(Slidev 的 slides.md,可读可搜索,PDF/PPTX 同步发布)、每次课的 demo 代码库(带一键 reset 脚本)和完整的 EGM 五件套。建议阅读路径:L01(哲学)→ L03(Big Three)→ L07(API 内部)→ L09–L11(无人值守主线)→ egm/(方法论与 Skill 工程),基本可以还原这门课的思想骨架。课程尚在进行中,后续讲义将随授课陆续发布。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


