
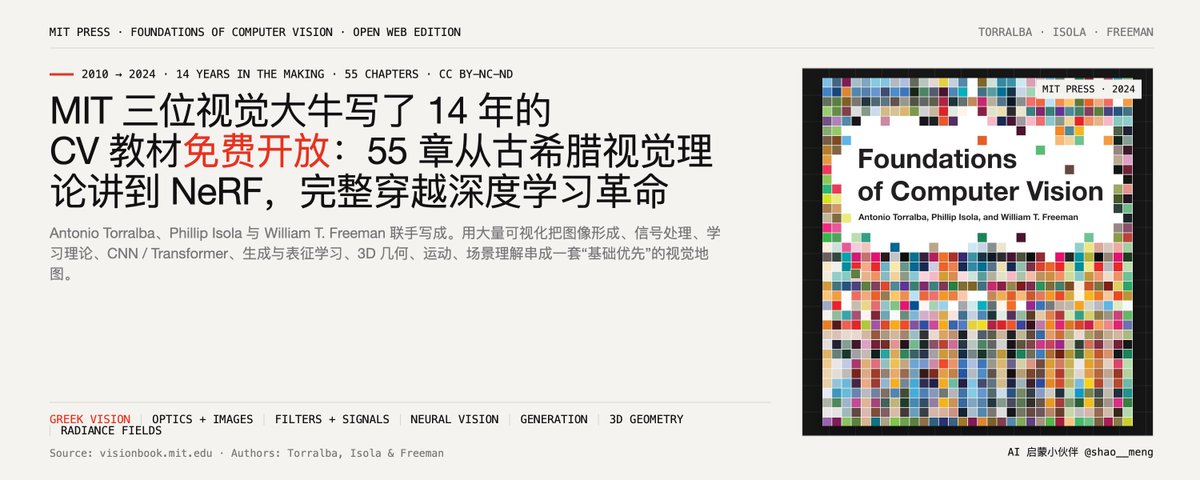
MIT 三巨头写了14年的计算机视觉(CV)教材免费开放:55章从古希腊视觉理论讲到 NeRF,完整穿越深度学习革命
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
Foundations of Computer Vision
[未转换内容,参见原始 JSON]
MIT 三位教授 Antonio Torralba、Phillip Isola 和 William Freeman 合著的《计算机视觉基础》(Foundations of Computer Vision,MIT Press)的免费官方在线版,属于著名的 Adaptive Computation and Machine Learning 系列(Bishop、Goodfellow 等经典教材所在的丛书)。全书 55 章、15 个部分,采用 CC-BY-NC-ND 许可开放阅读,纸质版另行发售,并配有可下载的教学 PPT。
这本书的地位值得先说清楚:三位作者都是该领域的领军人物,Torralba 是图像数据集与场景理解方向的奠基者之一,Isola 是对比学习(SimCLR)和生成模型研究的核心人物,Freeman 是计算视觉与图形学交叉领域的资深学者。由这样一组人花十几年写一本“基础”教材,本身就是领域的一件大事。
一个核心的写作立场:变化中的不变
理解这本书的关键,在于它的写作时间跨度,项目 2010 年立项,2024 年出版,完整穿越了 2012 年的深度学习革命。这个特殊经历塑造了全书最重要的学术立场:
作者观察到,革命早期许多传统视觉方法被当作“过时”而遗忘,但随着深度学习成熟,这些思想又大量回归(只是换了名字)。因此本书刻意不追踪 SOTA(当前最优技术),而是着力证明一件事:今天的许多方法深植于计算机视觉与 AI 的历史。第 1 章从两千五百年前的古希腊视觉理论讲起,经 Ibn al-Haytham 的《光学书》、Helmholtz 的无意识推理、格式塔心理学、Hubel-Wiesel 的神经生理学发现,一直连到 AlexNet,这是全书方法论的声明。
前言中还有一个精巧的中心隐喻:多视角(multiple views)。物理场景只有一个,但通过不同角度、传感器、时刻的多重观察才能理解真实;本书本身也提供这样一组视角,同一批核心概念(滤波、多尺度、生成、推理)会在不同部分从不同角度反复出现。
内容结构及其逻辑
全书 15 个部分的编排有清晰的教学递进逻辑,大致可归为五条主线:
1. 问题与背景(Part I–II)。从“视觉为什么难”讲起:视觉的输入只是七维全光函数的极小采样,输出却要恢复场景属性,信息大量丢失,所以视觉本质上是病态的推理问题,必须依赖对世界的先验假设。这是全书的理论基调。紧接着讲图像如何形成(成像、透镜、相机线性系统、颜色),先理解“图像从哪来”再谈“如何理解图像”。
2. 数学与信号处理基础(Part III–VI)。这部分体现了本书的特色视角,用图像处理和机器学习的语言来讲视觉:梯度下降、泛化、反向传播(Part III),线性滤波、傅里叶分析(Part IV–V),采样、混叠、金字塔(Part VI)。这些内容传统上散落在信号处理和机器学习教材里,本书把它们统一到视觉语境下。
3. 神经架构与统计建模(Part VII–IX)。CNN、RNN、Transformer(重原理而非具体架构),统计图像模型、纹理、概率图模型,再到表示学习与生成模型。把生成模型与表示学习放在一起处理(Part IX)反映了作者的研究品味,这两者本就是一枚硬币的两面。
4. 几何与运动(Part XI–XII)。这是传统视觉的“硬核”部分:相机标定、立体视觉、单应性、运动恢复结构(SfM),并延伸到现代的 NeRF 辐射场和单图深度学习。值得注意的是编排方式:经典几何方法和学习方法不是分开讲的,而是放在同一叙事里(如第 43 章“从单张图像学习估计深度”紧跟在经典单视图度量学之后)。
5. 应用、社会与研究素养(Part X、XIII–XV)。Part X 讲数据偏差、鲁棒性、迁移学习,把公平性和伦理放进了正文而非附录(第 4 章专讲“计算机视觉与社会”)。最独特的是 Part XIV:如何做研究、如何写论文、如何做报告,这是三位顶级学者写给青年研究者的经验之谈,在技术教材中极为罕见。最后 Part XV 首尾呼应,用全书学到的技术重新解决第 2 章引入的玩具视觉系统问题,完成一个漂亮的闭环。
教学理念
前言自嘲式地记录了写作史:原计划写一本“每章不超过五页”的小书,最终承认失败,但“写短书完美,因为我们没时间写长书”。这句帕斯卡式的玩笑背后是真实的取舍哲学:强调直觉培养,配大量可视化,而非穷尽推导。
目标读者是刚进入领域的本科生和研究生,同时作者相信有经验的从业者也能从中获益,对后者而言,这本书的价值恰恰在于补上深度学习时代之前的思想脉络,理解“新方法其实从哪里来”。
作者也划定了边界:不综述 SOTA,不覆盖形状分析、目标跟踪、人体姿态、人脸识别等专题,建议读者去看会议论文和专著。这种克制在信息爆炸的时代反而是优势。
对这本书的评价
这本书最可能成为下一代计算机视觉的“标准入门教材”,原因有三:
1.填补真空:现有教材要么是深度学习前的(Forsyth & Ponce、Hartley & Zisserman),要么是纯深度学习视角的。能把信号处理、概率建模、几何和学习方法统一在一个框架里、并且由亲历了范式转变的人来写的书,此前没有。
2.历史纵深带来的判断力:第 1 章和贯穿全书的“回访”结构教给读者的不是 API,而是分辨“什么是本质、什么是潮流”的能力。
3.超出技术的部分:研究方法论(Part XIV)和社会议题(第 4 章、Part X)让它不只是一本算法书,而是一部关于“视觉作为一门学科”的完整导论。
不过需要注意的是:它刻意不追踪 2022 年之后的扩散模型细节和多模态大模型进展(VLM 一章只是入门),不适合作为了解最新技术的主要来源;对数学基础薄弱的读者,Part III–VI 的密度可能偏高,需要配合信号处理或机器学习基础。


