
万字爆肝长文丨两张 3000 块老卡跑赢 3 万块 4090 48G:一次讲透怎么老显卡把 Qwen3.8-27B /NInfer跑到极致
文章目录
🔍 为什么我们重点推荐 V100 这张卡?
先说 V100 是什么。它是英伟达 2017 年出的数据中心显卡,当年卖好几万一张,装在服务器里跑训练用的。现在数据中心换代,这批卡淘汰下来,二手市场上 32G 显存的版本三千块左右就能买到。一张 4090 要三万上下,两边差了十倍。
我们盯上它,是因为网上不少人说用它跑千问速度很快,我们自己有一台插着两张 V100 的机器,就想试试。一上手先查它的参数:显存带宽 900GB/s,和 4090 是一个级别;后面实测出来是 1004GB/s,比 4090 还高一点。带宽大是它天生的,它用的是 HBM 显存,显存颗粒堆在芯片旁边,用很宽的通道连着。第三节会讲,带宽是跑大模型最要紧的一个数。
一张 2017 年的老卡,带宽和最新的消费级卡一样大,价钱只有十分之一,为什么不用起来?三千块一张,买两张也无所谓,两张合起来跑反而更好,后面会讲到。这篇文章就是这两天的账:老卡到底能跑多快,慢在哪,我们怎么一步一步把它提上来的。后来我们又买了一台带 NVLink 的机器。下文说「老机器」,指先到的这台、两张卡之间没有 NVLink 的;说「新机器」,指后到的、两张卡用 NVLink 连着的那台。第十九到二十三节是新机器的账,包括 NVLink 对我们的应用到底有多重要。
结果先放在前面。两张 3000 块的二手 V100 合跑,同一份 prompt 同样参数,跑代码的生成速度比一张三万块的 4090 高,256K 是 94.7 对 80.9 tok/s,中文两边一样,300 道题答对的数目 237 对 236。差的是读 prompt 那一步,4090 快 1.85 倍。第十八节有整张表。
为什么同一个 Qwen3.8-27B,喂 20 万字的上下文,放在 4090 上每秒还能吐 90 个字,放在 V100 上只剩 36?
这个问题我们折腾了两天。第一天试了双卡,试了换引擎,试了换猜词方式,最后把推理引擎里的一小段程序重写了,V100 单卡从每秒 36 个字提到 52。第二天给引擎加上双卡支持,两张 V100 合跑一个请求,20 万字的代码任务跑到每秒 100 个字上下,中文 73 上下,当天下午切进生产。上线以后跑了 300 道题的能力测试,答对的题数和以前差不多(237 对 245,在随机误差范围内)。
这篇按排查顺序讲,每一步做了什么、怎么做的、为什么这么做,都写出来。术语会很多,每个术语第一次出现的时候都用大白话解释一遍,不懂显卡的也能跟下来。你要是手上有老卡,或者正在纠结要不要买带 NVLink 的机器,看完能省不少冤枉钱。
一、先从 4090 48G 说起
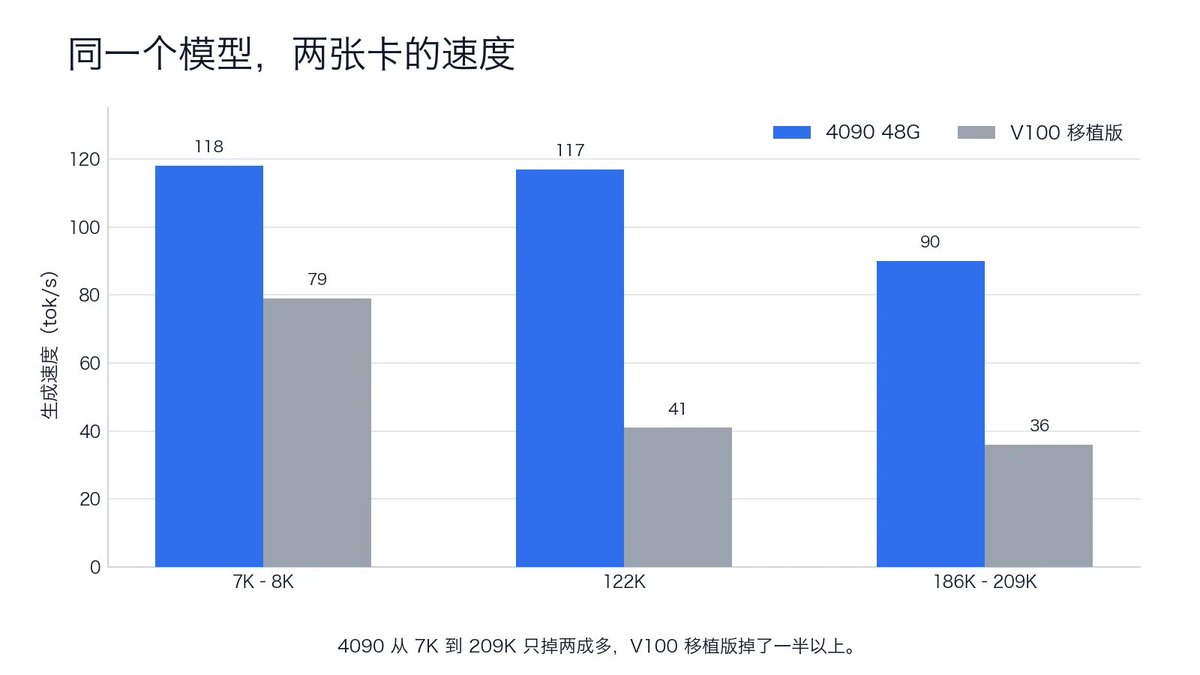
这一节先把参照物立起来。4090 48G 跑 Qwen3.8-27B,上下文从 7K 一路拉到 209K,速度只从 118 掉到 90 tok/s。后面 V100 的每一个数字,都拿这条线来比。
先交代几个词。
token 可以粗略当成「字」,大模型是一个 token 一个 token 往外吐的,后面说速度都用 tok/s,就是每秒吐几个 token。上下文是你喂给模型的全部内容,说长度都用 K,200K 就是 20 万个 token,差不多两三本书。prompt 是你一次发给模型的那段输入,186K 的 prompt 就是 18.6 万个 token。
我们跑的模型是 @Alibaba_Qwen 的 Qwen3.8-27B。270 亿参数,参数就是模型学出来的那堆数字,存在显卡里的时候叫权重。每个数字原本用 16 位存,270 亿个数字就是五十几 GB,一张 48G 的卡都放不下,更别说 32G 的 V100。所以要量化:把每个数字压缩成只用 4 位来存,文件缩到大约 17GB。代价是每个数字都被四舍五入过,精度掉一点;好处除了放得下,还有读得快,第三节会讲,生成速度就是由每个字要读多少字节决定的,文件只有原来的三分之一,读一遍的时间也只要三分之一。
跑模型的程序叫推理引擎。模型文件本身只是一堆数字,引擎负责把它装进显卡,接收请求,安排每一步算什么,把第三节要讲的那几百个内核一个接一个派给显卡,再把算出来的字送回给你。同一个模型换一个引擎,速度能差好几倍,因为引擎里的内核写得好不好差别很大。我们用的是 Ninfer,一个专门为 5090 写的引擎,5090 是英伟达最新一代消费级显卡。前几天「老林说」发了条视频专门讲它为什么快,视频的结论是 V100 复现不了 5090 的效果。
4090 48G(48G 是显存大小)跑这个模型很轻松。这组数是 4090 上跑 Ninfer、用 groupwise-int 格式的模型文件、开猜词测出来的,格式和猜词是什么后面都会讲。7K 的短对话每秒 118 个 token,喂 122K 的上下文还有 117,209K 还有 90。上下文从 7K 到 209K 翻了近 30 倍,速度只掉两成多。
这是我们的参照物,后面 V100 的每一个数字都拿这条线比。
二、主角登场:两张 V100
先说清楚起点:移植版 Ninfer 在 V100 上 186K 只有 36 tok/s,首字要等 7 分半。网上数字乱跳是因为口径不统一,所以我们先把口径定死——两份 200K 素材(代码、中文各一份),每个数字都标明长度、语种、开没开猜词。后面所有结论都建立在这一步上。
老机器上插着两张 V100 32G。V100 是 2017 年的数据中心卡,二手市场上便宜,很多人手上都有。这台机器两张卡之间没有 NVLink,只靠主板上的 PCIe 插槽连着。PCIe 是主板上谁都能用的普通通道,NVLink 是英伟达给两张显卡之间做的专线,第六节讲它到底能帮多少。
Ninfer 官方只支持 5090。V100 上跑的是社区移植版,就是有人把这个 5090 专用的程序改到 V100 上能跑的版本。同一个模型放上去,短对话 79,122K 掉到 41,186K 只剩 36。而且读完 186K 的 prompt 要等 7 分半钟才出第一个字。
网上关于 V100 跑千问的数字从 19 到 78 乱跳,没有一个说得清。原因是测试的内容、上下文长度、引擎和卡数都不一样。代码比中文好猜,猜中率高二三十个点(猜词是什么第三节讲),所以同一个配置下写代码是 77 tok/s、写中文只有 54 tok/s。数字对不上,是口径没有统一。
于是我们先把口径定下来,后面所有工作都建立在这一步上。我们准备了两份 200K 素材,代码一份,中文一份,token 数对齐,所有方案都用这两份测试,每个数字都写明是代码还是中文、多长上下文、开没开猜词。
三、小白必修课:显卡跑大模型的时候在干什么
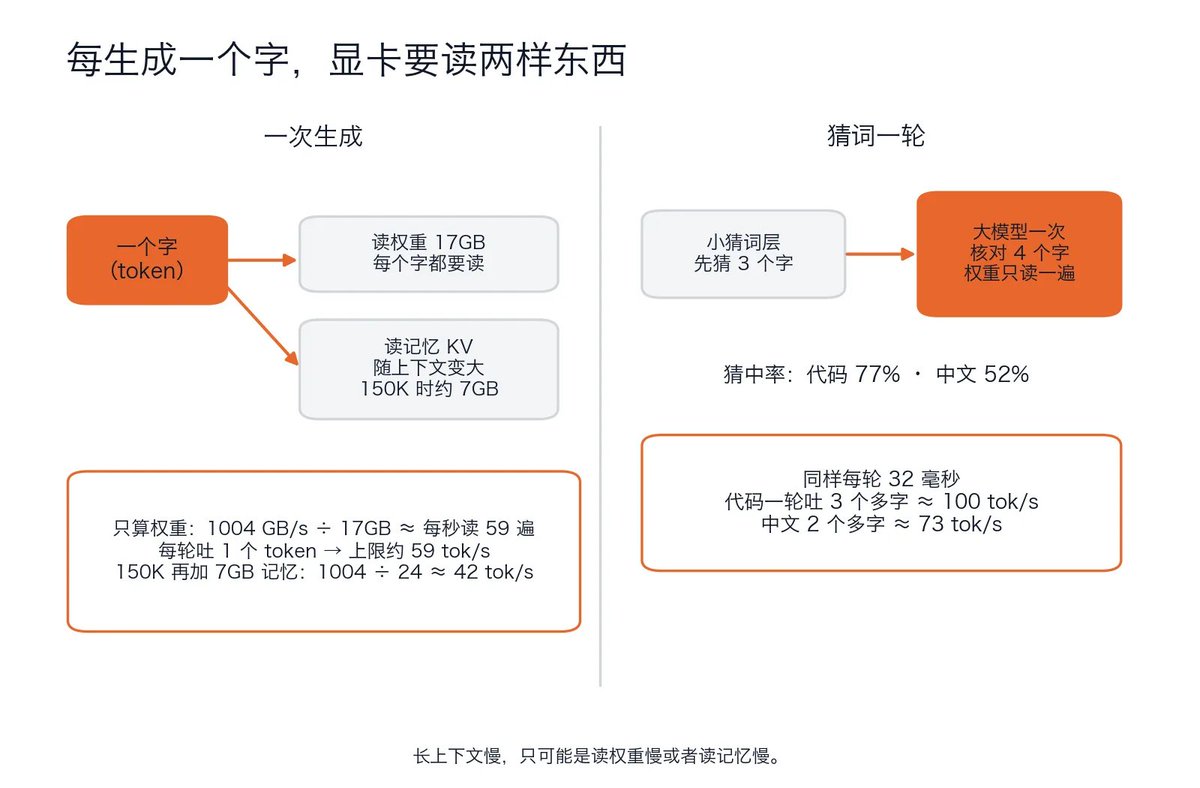
先摆一个判断速度的框架。生成一个字要读两样东西,权重(17GB,固定)和记忆(KV 缓存,随上下文变长)。速度上限 = 显存带宽 ÷ 每个字要读的字节数。V100 这笔账算出来是 59 tok/s,实测 36,差的那一截就是软件。后面每个数字都用这个方法判断:先分清是读权重的账还是读记忆的账,再看离上限差多少。
要看懂后面的排查,先记住两笔账。
第一笔账,读权重。模型每生成一个字,都要把 17GB 的权重从显存里完整读一遍,一个字也省不了。所以生成速度的上限由显存带宽决定,带宽就是显卡每秒能从显存里搬多少数据。V100 实测每秒 1004GB,除以 17GB,一秒最多读 59 遍。也就是不用任何技巧的话,上限就是每秒 50 到 60 个字。
带宽 1004 GB/s ÷ 权重 17 GB ≈ 每秒读 59 遍 每读一遍吐 1 个字 → 不开猜词的上限 ≈ 59 tok/s
那 V100 短对话怎么跑出 79?因为 Ninfer 开了猜词,行话叫推测解码。它解决的是第一笔账里的浪费:权重读一遍只换来 1 个字,显卡的算力大部分时间闲着。既然读权重才是贵的那一步,能不能一次读权重的工夫多核对几个字?做法是在大模型旁边挂一个很小的猜词层,它用很低的代价先猜出后面 3 个字,然后大模型把这 3 个字连同本来要生成的那 1 个字一起过一遍,一共核对 4 个字,权重只读一遍。核对是严格的:猜对几个就一次吐出几个,从第一个猜错的位置重来,所以最后写出来的内容和不猜词一模一样,只是快了。
猜中率就是每次猜的那几个字平均猜对几成,它决定猜词能快多少。代码里下一个字经常只有一种写法,括号、缩进、变量名都猜得到,猜中率高;中文每个位置的候选多,猜中率低。所以同一台机器同一个模型,代码比中文快,后面所有速度数字都要分开看代码和中文。
后面说的「一轮」,是模型把全部权重读一遍、把 64 层从头到尾走一遍。层就是模型内部的一道加工工序,一个字要顺着 64 道工序走完才出来。不开猜词一轮吐一个字,开了猜词一轮能吐 1 到 4 个字,所以每轮的毫秒数和每秒的字数不是简单倒过来,中间差一个猜中率。同样每轮 32.4 毫秒,代码猜中率高,一轮吐 3 个多字,就是 100 上下;中文一轮吐 2 个多字,就是 73 上下。
每秒的轮数 = 1000 ÷ 32.4 毫秒 ≈ 31 轮 每轮吐的字数 = 1 + 3 × 猜中率 代码:1 + 3 × 0.77 ≈ 3.3 个字 → 31 × 3.3 ≈ 102 tok/s 中文:1 + 3 × 0.46 ≈ 2.4 个字 → 31 × 2.4 ≈ 73 tok/s
第二笔账,读记忆。模型要记住你前面说过的所有内容,这份记忆叫 KV 缓存,存在显存里。每生成一个字,都要把这份记忆从头到尾读一遍。上下文越长,记忆越大,150K 的上下文这份记忆就有 7GB 左右,每个字都要多读 7GB。算上这 7GB,150K 时不开猜词的上限就从 59 掉到 42 左右。
150K 上下文:1004 ÷ (17 + 7) ≈ 42 tok/s
所以长上下文慢,只有两个可能,读权重慢,或者读记忆慢。
还有一个词后面会反复出现,首字等待。你把 200K 的内容发过去,模型要先把这 20 万字全部读一遍,才能吐出第一个字。这一步叫 prefill,V100 上要 7 分半。它和生成速度是两笔独立的账。
后面会反复出现「内核」这个词,它是这篇文章的主角,先讲清楚。
先说显卡和 CPU 干活方式的差别。CPU 的核少而强,擅长顺着一条逻辑往下走,碰到分支就跳。显卡反过来,单个核又小又简单,但有上千个,一次能派出上万个线程,跑同一段代码,各自喂不同的数据。「同一段代码,一大堆数据」这种干活方式,决定了给显卡写的程序没法像 CPU 程序那样一大坨顺着跑,只能切成一节一节,每一节就是一个内核。
一个内核的边界很清楚:从显存里读输入,算完把结果写回显存,然后整个退出。它不记得上一次是谁跑的,也不管下一次谁来读。把当前的字和权重乘起来是一个内核,给前文每个位置打一遍分是一个内核,把打分换算成权重又是一个内核。
所以「跑模型」在显卡眼里就是排一条很长的队,把这几百个小内核一个接一个派下去。拿一层来说,先几次矩阵乘法,然后给前文打分、换算权重、加权汇总,再几次矩阵乘法,各自都是独立的内核,每层前后还各有一次归一化(把数值拉回正常范围的一小步);64 层叠起来,再加猜词那几步,生成一轮要派几百个内核。单个内核跑一次从十几微秒到几毫秒不等,取决于它要搬多少数据。
内核之间不共享任何中间状态,唯一的交接方式是显存:前一个算完写进显存,后一个读出来接着算。这条规则决定了后面几乎所有的性能话题。为什么显存带宽是天花板,因为每个内核都要经显存进出一遍。为什么把几个小内核合并成一个能白赚一截速度,因为省掉了中间那几次显存进出,第十四节把「加回输入」那一步并进矩阵乘法,赚的就是这个。为什么内核碎到一定程度,瓶颈会从显卡转移到 CPU 派活的速度上,于是有了 CUDA Graph 这种把整串内核录下来、一次性重放的做法,第十二节会用到。
同一件事可以有很多种内核写法,写法决定了显卡的算力(每秒能做多少次乘加)和带宽能用上几成:数据分给多少线程、每个线程一次取多少、中间结果放在哪、要不要停下来等别人。推理引擎快不快,很大程度上就是它那几百个内核写得好不好。这篇文章后面的主线,就是找到最慢的那个内核,看它为什么只用了一成多的带宽,再按 V100 的脾气重写一遍。
后面每个数字我们都拿这两笔账来判断:先问它是读权重的账还是读记忆的账,再问离带宽算出来的上限差多少,差得多就是软件的问题。
四、第一个怀疑:老卡带宽不够?
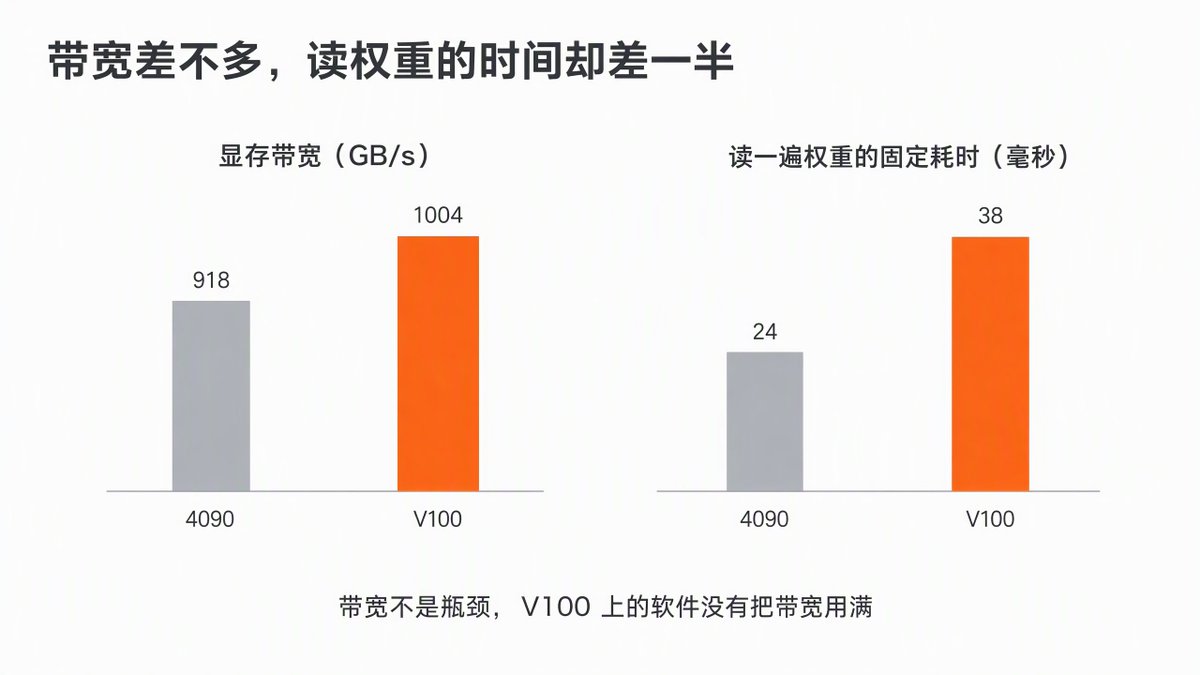
查下来,不是一个带宽的问题。V100 实测 1004 GB/s,比 4090 的 918 还高一成;可读一遍权重,4090 要 24 毫秒,V100 要 38 毫秒——带宽差不多、时间差一半,说明 V100 上的软件没把带宽用满。这是第一个线索。
大部分人的第一反应都是:2017 年的卡,带宽肯定不行。实测不是。
第三节那个每秒 1004GB 就是我们量出来的,4090 是 918GB,V100 反而高一成。带宽这条线可以排除。
那 4090 凭什么快?按带宽算,读一遍 17GB 的权重,4090 和 V100 都该在 20 毫秒以内。实测的做法是我们把不同上下文长度下的每轮耗时排成一条线,越长越慢的那部分是读记忆,减掉它,剩下不随上下文变的固定开销主要就是读权重,4090 是 24 毫秒,V100 是 38 毫秒。带宽差不多,读权重的时间却差一半,说明 V100 上的软件没有把带宽用满。这是第一个线索。
五、第二个怀疑:一张卡不够,两张卡行不行
先说清楚两张卡该怎么用:它有三种用法,只有张量并行能让单个请求变快。llama.cpp 上测出来单卡 35.4、双卡 49.4,只到理想值的七成,多花的时间里 PCIe 传输只占三分之一,另外三分之二是两张卡的软件在互相等。顺手还踩到两个坑:我们这台机器的两卡直连是坏的(4KB 要 49 毫秒),系统自带的 NCCL 2.31 不带 V100 内核,要换 2.21.5。
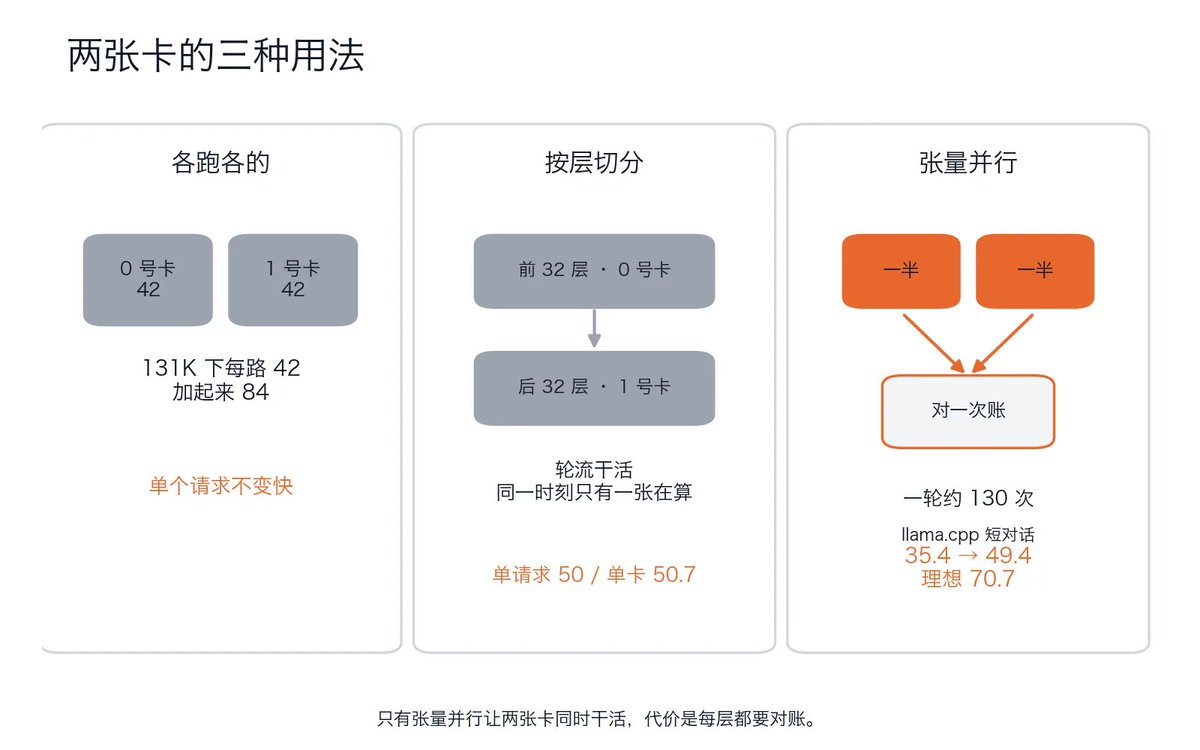
两张卡一起用,有三种用法。
第一种,各跑各的。两张卡各自启动一个服务,两个人同时用互不干扰。这个我们测试过,131K 下每路 42,加起来 84。但单个请求的速度不会变快。
第二种,按层切分。前 32 层放一张卡,后 32 层放另一张卡。用 llama.cpp 开猜词测下来单请求 50,单卡 50.7,没有提升。因为两张卡是轮流干活的,同一时刻只有一张在算。llama.cpp 是另一个常用的开源推理引擎,支持多卡。
第三种,张量并行。前两种慢的原因是同一时刻只有一张卡在算,张量并行把每一层的计算切成两半,两张卡同时算,算完把结果合起来。打个比方,两个人合算一本账,每一页都对半分,一人算一半,算完一页就把两边的结果加到一起,再翻下一页。这是唯一能让两张卡同时干活的方案,代价是每算完一层都要「对一次账」,把两张卡各自算出来的那一半加在一起,一轮生成要对账约 130 次。每次对账传的数据只有十几 KB,数据量小,贵的是来回一次的延迟,所以两张卡之间连得快不快,主要看延迟,不看带宽,第六节和第十四节都会用到这个判断。后面说的对账,都是指这件事。
Ninfer 不支持一个请求用多张卡,我们换 llama.cpp 测试张量并行,短对话、不开猜词,单卡 35.4,双卡 49.4,快了四成。理想情况是 70.7,也就是翻倍。
理想:两张卡各算一半,35.4 × 2 ≈ 70.7 tok/s 实测:49.4 tok/s,只到理想的 70%
多出来的差距去哪了?用 nsys(英伟达的性能分析工具,能把显卡每一步花了多少时间录下来)拆开,每个字比理想多花 6 毫秒,PCIe 传输数据只占 2 毫秒多,剩下 3.5 毫秒是两张卡的软件在互相等。
每个字的耗时:实测 1000 ÷ 49.4 ≈ 20.2 毫秒,理想 1000 ÷ 70.7 ≈ 14.1 毫秒 多花的 6 毫秒 ≈ PCIe 传数据 2 毫秒多 + 两卡软件互等 3.5 毫秒
读 prompt 那一步不一样。每处理 2048 个 token 要传输 20MB 左右,这时候数据量大,PCIe 的带宽就成了瓶颈。双卡每 2048 个 token 要 1.6 秒,比理想多花 0.55 秒,其中 0.4 秒是在等传输。
顺带说两个坑,手上有 V100 的可以对照一下,都是两张卡合跑的时候碰到的。
第一个坑是两张卡之间的直连坏了。两张显卡要互相传数据,有两条路。一条是直连,数据从一张卡的显存直接进另一张卡的显存,不经过 CPU 那边的内存;另一条是绕道,先传到 CPU 内存,再从内存传给另一张卡。直连本该是快的那条。英伟达自带的 nvidia-smi 命令能查看显卡状态,它说这台机器的直连正常,但我们写了一个小程序实测:走直连传输 4KB 要 49 毫秒,绕道内存反而只要 16 微秒,差了三千倍,直连等于坏了。所以后面所有双卡方案,两张卡之间的数据都走绕道这条路。
第二个坑是多卡通信库的版本。两张卡合算一个请求,每算一步都要交换一次中间结果,这件事我们没有自己写,用的是英伟达的 NCCL,它就是专门管多张显卡之间怎么互相传数据的一个库。库里有一套按显卡型号编好的小程序,行话叫内核,Ubuntu 24.04 系统自带的 NCCL 2.31 里没有 V100 这一代的内核,所以一启动就崩溃。换成 pip 里的 2.21.5 版本,里面还带着 V100 的内核,才能跑起来。第十四节会讲,我们后来把两张卡之间大部分传输换成了一条更快的路,NCCL 只留给大块数据。
六、NVLink 到底能帮多少
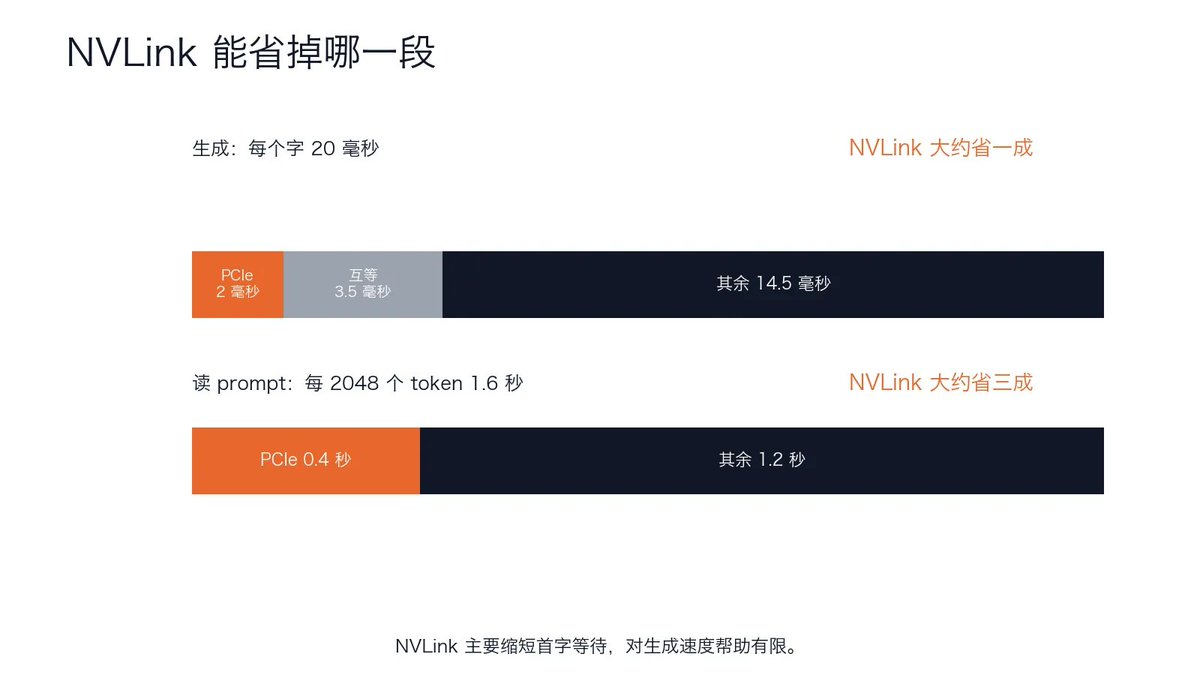
先用第五节的时间线算一笔账:生成阶段每个字 20 毫秒里,PCIe 传数据只占 2 毫秒,NVLink 最多快一成;读 prompt 阶段传的数据量大,能快三成。所以初步判断是 NVLink 主要缩短首字等待,对生成速度帮助有限。这个估算后来被实测推翻了一部分,第十九到二十一节会讲。
先说 NVLink 是什么。两张显卡要互相传数据,默认走的是主板上的 PCIe 插槽,这条路谁都能用,带宽有限。NVLink 是英伟达专门给显卡和显卡之间做的一条专线,两张卡之间直接连起来,带宽是 PCIe 的十倍上下。很多人买带 NVLink 的机器,心里想的是:两张卡用专线连起来,带宽翻倍,速度也翻倍。
这个想法对不对,要看数据在两张卡之间到底传了多少、等了多久。第五节我们用 llama.cpp 做张量并行的时候,用 nsys 把每一步的时间都录下来了,正好能算这笔账。生成和读 prompt 两个阶段要分开算,因为两边传的数据量差得远。
先看生成阶段。双卡开张量并行以后每秒 49.4 个字,倒过来算,每生成一个字要 20 毫秒。这 20 毫秒分三段:在 PCIe 上传数据 2 毫秒多,两张卡的软件互相等对方 3.5 毫秒,剩下 14 毫秒多是两张卡各自在算。NVLink 只能让传数据那一段变快;软件互相等的 3.5 毫秒是程序写法的问题,换成 NVLink 也一样要等。
每生成 1 个字:1000 ÷ 49.4 ≈ 20 毫秒 20 毫秒 ≈ 2(PCIe 传数据)+ 3.5(两卡互等)+ 14.5(各自计算) 换 NVLink 只省得掉传数据那一段:20 − 2 = 18 毫秒 提速 = 20 ÷ 18 ≈ 1.11 → 快一成
所以我们估算,NVLink 能让生成速度快一成左右。
再看读 prompt 阶段。读 prompt 是把你发过去的整段内容先过一遍模型,这一步一次处理 2048 个 token,每处理这么一块要 1.6 秒,其中 0.4 秒是在等 PCIe 把数据传完。这个阶段每块要传 20MB 左右,数据量大,PCIe 的带宽才是瓶颈,换成 NVLink 能把这 0.4 秒省掉大半。
每 2048 个 token:1.6 秒 ≈ 0.4(等 PCIe 传数据)+ 1.2(其余) 换 NVLink 省掉那 0.4 秒的大半:1.6 − 0.4 ≈ 1.2 秒 提速 = 1.6 ÷ 1.2 ≈ 1.33 → 快三成
所以我们估算,读 prompt 能快三成,首字等待也就短三成。
把两段合起来说:NVLink 主要缩短的是首字等待,对生成速度的帮助有限。这个判断后来被第二天我们自己做的双卡实测坐实了,第十四节会给出那份数据:每轮 33 毫秒里,两张卡之间的通信只占 2.2 毫秒。我已经买了新机器(带 NVLink 的那台),到了以后的实测在第十九到二十一节:读 prompt 那一半估对了,生成那一半没有估对,原因也写在那里。
七、网上那个 4 张 V100 跑 260 tok/s 是怎么回事
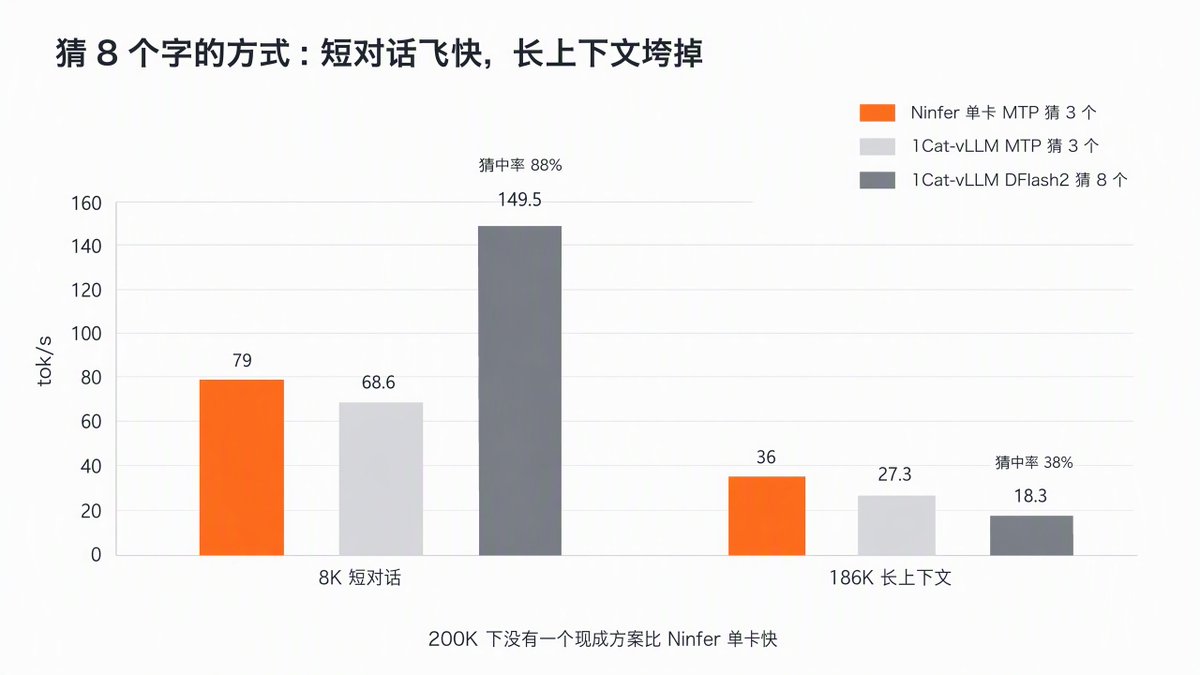
网上那个 260,是 4 张卡、短上下文、DFlash2 猜 8 个字的结果。我们把同一个引擎装到自己的两张卡上测 200K:MTP 猜词每一档都比 Ninfer 单卡低,DFlash2 短对话能到 149.5,186K 掉到 18.3,因为猜中率从 88% 掉到 38%。结论是激进的猜词方式救不了长上下文,现成方案在 200K 下没有一个比 Ninfer 单卡快。
有人肯定要问,网上不是有 V100 跑出两百多的吗?
那是一个叫 1Cat-vLLM 的引擎,专门给 V100 做优化。260 这个数是 4 张 V100 16G、短上下文、开 DFlash2 猜词的结果,DFlash2 是另一种猜词方式,猜词层是单独训练的一个小模型,一次猜 8 个字,比 MTP 猜 3 个激进得多,猜中率高的时候快得多,猜中率一掉就吃亏,下面就能看到。同样 4 张卡不开猜词,128K 是 61.8,256K 是 50.4。
我们把 1Cat-vLLM 装到自己的两张卡上,用同一份素材测试。开 MTP 猜 3 个字(MTP 就是 Ninfer 用的那种猜词方式,猜词层是模型自带的),8K 是 68.6,122K 是 34.3,186K 是 27.3,每一档都比 Ninfer 单卡低。1Cat-vLLM 只在读 prompt 上快,122K 冷启动(没有任何缓存,从头读)136 秒,Ninfer 单卡要 236 秒。
换 DFlash2,8K 确实能到 149.5,比 Ninfer 单卡高将近一倍。但 186K 只剩 18.3,因为猜中率从 88% 掉到 38%,每轮耗时从 48 毫秒涨到 200 毫秒。它适合短对话,救不了长上下文。
我们也试过把 Ninfer 改成猜 2 个字,128K 和 200K 都比猜 3 个字慢。
到这里现成的路全部走完,200K 下没有一个方案比 Ninfer 单卡快。那就回头看单卡到底卡在哪。
八、V100 上的 attention 是怎么跑起来的
根子在硬件:V100 缺 ldmatrix、m16n8k16、cp.async 和 bf16 张量核这四样,FlashAttention 2 以后的内核一条都跑不了,只能用老指令 m8n8k4 拼替代方案。移植版作者的替代方案里,生成档的 INT8 attention 内核结构被寄存器上限逼成了「4 个 warp 重复算同一份打分、每批只取 16 个位置」——这就是后面要重写的那一段。
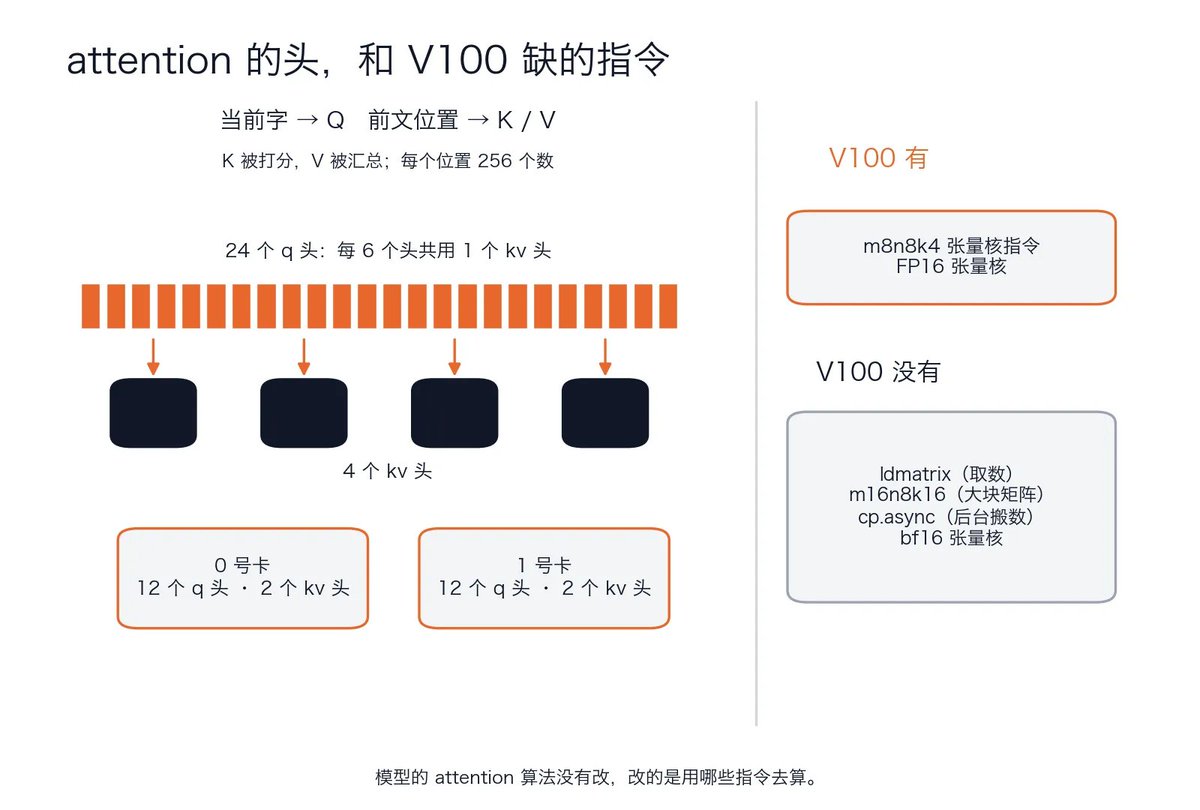
先解释 attention。模型每写一个字,都要回头看一遍前文,给前文每个位置打分,看哪些位置和当前这个字最相关,再按分数把那些位置的内容加权汇总起来。这个「回头看、打分、加权汇总」的动作就叫 attention,它读的就是第三节说的那份记忆。行话给这几串数各起了一个字母名:当前这个字拿去问的那串数叫 Q,前文每个位置用来被打分的那串数叫 K,被汇总的内容叫 V。K 和 V 合在一起就是那份记忆,所以记忆也叫 KV 缓存。后面出现 Q、K、V、KV,都是指这三样。
模型的 attention 机制我们和移植版都没有改动,改的只是怎么算。Qwen3.8-27B 是混合结构,64 层里 16 层是普通 attention,48 层是 GDN 线性注意力。GDN 是另一种记前文的办法,不回头读全部记忆,只维护一块固定大小的状态,每来一个字更新一次,所以上下文再长它也不变慢。普通 attention 那 16 层,每层把「回头看」这件事分成 24 路同时做,行话叫 24 个头,也叫 24 个 q 头。24 个头共用 4 份记忆,每 6 个头合用一份,这 4 份行话叫 4 个 kv 头,记忆里每个位置存 256 个数。双卡以后每张卡分到一半,就是 12 个 q 头、2 个 kv 头。
V100 跑不了现代的 attention 内核,原因是它缺几条指令。先说指令是什么。显卡干活是一条一条命令执行的,取一次数、乘一次小矩阵,都是一条指令,指令就是显卡能直接执行的最小命令。一代显卡有哪些指令是造芯片的时候定的,后面几代加的指令,老卡上没有,程序里用到了就跑不起来。
再说这些指令是给谁用的。模型里绝大部分算术是矩阵乘法:拿一大片数字(当前这个字)去乘另一大片数字(权重),再把结果加起来,第三节第一笔账里读权重就是为了做这个乘法。显卡里专门做矩阵乘法的那块单元叫张量核。V100 的张量核只会做一种最基础的小块矩阵乘法,指令名叫 m8n8k4,一次算出一块 8 乘 8 的结果。
后面几代显卡在这个基础上加了一套配套指令,每条解决一个具体问题:ldmatrix 专门负责把一块矩阵从显存整齐地取进来;m16n8k16 一次乘更大的一块矩阵,同样的活少发几条命令;cp.async 负责在后台搬数据,一边算一边搬,不用停下来等;还有支持 bf16 精度的张量核。这里要解释一下精度:FP16 和 bf16 都是用 16 个二进制位存一个小数,只是位数分配不同,bf16 能表示的数值范围更大,精度低一些;FP32 用 32 位,更准,也更占地方。这四样 V100 一样都没有。
缺这些指令,最直接的后果是寄存器不够用。显卡里同时干活的是成千上万个线程,一个线程就是一个小工人,每个线程手边最快的那一点存储叫寄存器,每个线程最多 255 个,这个上限每代显卡都一样。新卡上很多活由上面那些指令顺手做掉,V100 上只能靠寄存器硬扛,所以更容易撞上这个上限。FlashAttention 2 是现在主流模型都在用的那套 attention 内核写法,它以后的内核,还有 Ninfer 官方按 5090 写的 attention 内核,都建立在这几条指令和 bf16 张量核上,V100 一条都跑不了。
V100 缺这些指令,就得用老指令拼出同样的效果,这叫替代。移植版作者给这些缺掉的指令找了替代办法,下面两档就是他的做法,也是我们起步的那份代码。
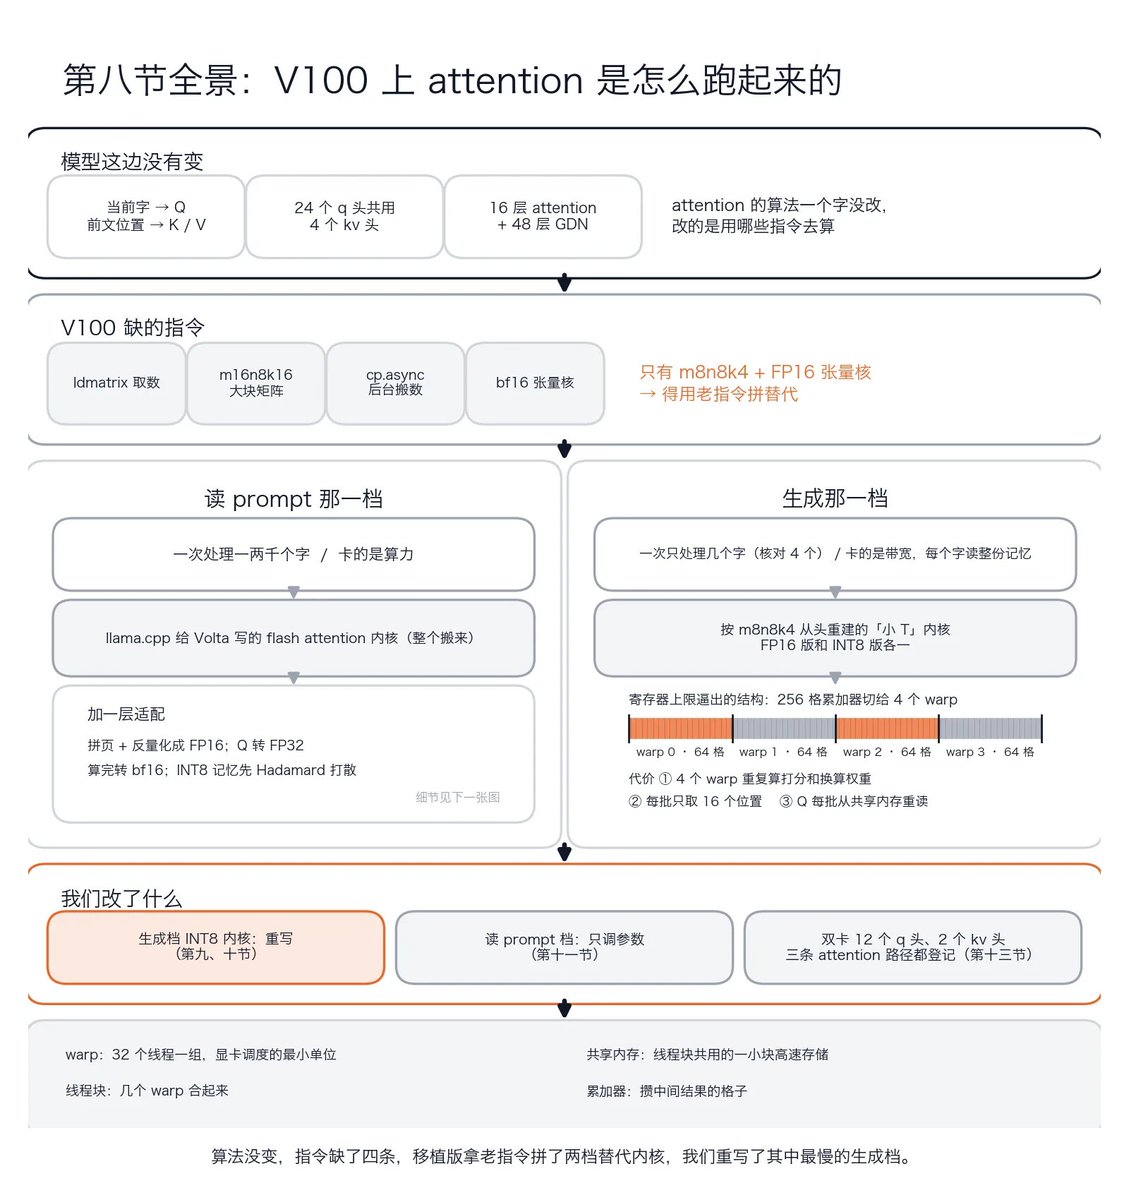
先看读 prompt 那一档。这一档一次处理一两千个字,权重读一遍能给这一两千个字一起用,读权重那笔账被摊薄了,卡的是算得快不快。移植版作者没有自己写,他把 llama.cpp 里给 Volta 写的 flash attention 内核整个搬了过来。Volta 是 V100 这一代显卡的架构名;flash attention 是一种把「回头看打分」这一步算得又快又省显存的内核写法,llama.cpp 早就给 Volta 写过一版。搬过来以后要加一层适配。这一层有好几道格式转换,看着绕,道理只有一个:记忆存的格式和算的格式本来就不是一种。
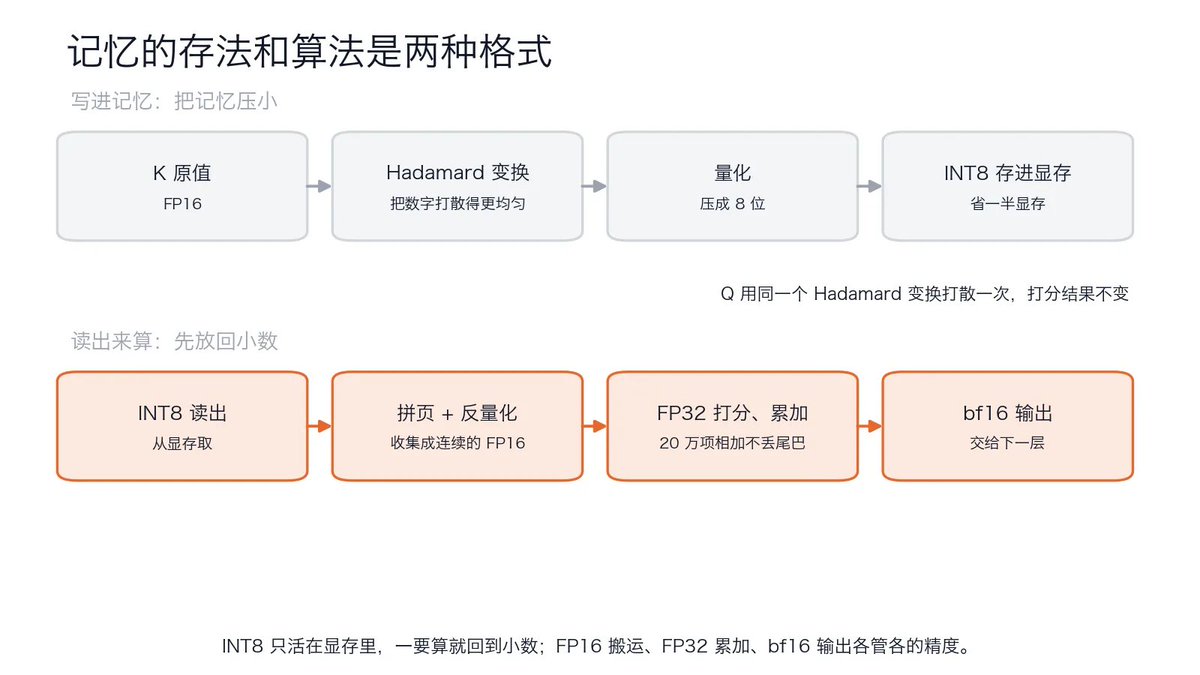
先说存。记忆放在显存里用的是 INT8,8 位整数,行话叫 INT8 KV,唯一的目的是省显存:16 位小数压成 8 位,记忆占的显存少一半,单卡才放得下长上下文。压之前先对 K 做一次 Hadamard 变换,就是把一串数字打散得更均匀,大的不那么大、小的不那么小,这样压成 8 位时损失更小。这一步发生在写进记忆的时候,和后面怎么算没有关系。
再说算。INT8 不能直接拿来算 attention。打分之后有一步 softmax,要算指数,对数字的小误差很敏感;8 位整数一共只有 256 个刻度,而且要把 20 万个位置的分数累加起来,误差会一路滚雪球。所以通用的做法是存的时候压到 8 位,算的时候放回小数。放回来这半段又分几步,每步只干一件事。记忆在显存里是按固定大小的页存的,像书分页,散着搬不动,先把要看的那些页收集成一段连续的数据,同时把 8 位整数还原成 FP16 小数,因为 V100 的张量核只吃 FP16。Q 先转成 FP32 交给这个内核,并且用同一个 Hadamard 变换打散一次,两边打散的方式一样,打出来的分数才和不打散时相同。打分和累加用 FP32 做,因为 20 万项加在一起,FP16 的小数位不够用,加着加着尾巴就被吃掉了。算完的结果转成 bf16 交给下一层,因为模型主干上的数据都是 bf16。
所以 INT8 只活在显存里,一要算就得回到小数;小数内部又分三档,FP16 搬运和乘法,FP32 累加,bf16 输出,各管各的精度。这几道转换是省显存必须付的过路费。第十节我们重写的内核里,「8 位整数还原成 FP16」这一步就是靠字节重排提速的那一步。
再看生成那一档。这一档一次只处理几个字,权重读一遍只给这几个字用,卡的是带宽,而且每个字都要把整份记忆读一遍。这一档他按 m8n8k4 从头重建了一个「小 T」内核,T 就是这一批处理几个字,记忆按 16 位小数存的和按 8 位整数存的各写了一版,后面说的 INT8 内核就是按 8 位整数存的那版。
这个内核的结构是被寄存器上限逼出来的。先说三个词。32 个线程编成一组叫一个 warp,是显卡调度的最小单位;几个 warp 合起来叫一个线程块;一个线程块有一小块共用的高速存储,叫共享内存。攒中间结果的那组格子叫累加器,这个内核每个位置有 256 个数要攒,一个线程放不下,所以他把 256 个数切给 4 个 warp,每个 warp 管 64 个。代价是 4 个 warp 各自把同样的打分和换算权重这两步重算一遍,只有最后的加权汇总各做四分之一;Q 每批都要从共享内存重读一次。内核把 20 万个前文位置分批取进来打分,一个位置就是前文的一个字,他的写法每批只取 16 个位置。这几处就是第九节找到的慢的根源。GDN 那 48 层的状态更新内核和其余几条 attention 路径,他也各写了一版 V100 能跑的内核,和主线无关,不展开。
我们改的是他这套替代方案里最慢的一段:生成那一档的 INT8 内核,第九节讲怎么找到它,第十节讲怎么重写。读 prompt 那一档没有重写,只调了参数,第十一节讲。双卡以后每张卡只分到一半的头,12 个 q 头、2 个 kv 头,这是一种新的头数组合,行话叫几何。Ninfer 的内核是按固定尺寸编译的:每一种头数、每一种矩阵大小都有一个专门编好的内核,尺寸一固定,循环次数、寄存器怎么分配都能在编译时定好,跑起来才快;代价是没登记过的尺寸它不认,要么报错,要么掉到慢路径。attention 一共有三条路径:读 prompt 那一档的 flash attention 内核,生成那一档的小 T 内核,还有一条处理中等批量的 prompt 内核。这三条我们都登记了一遍,其中一条是第十四节踩坑之后才补上的,第十三节讲怎么登记。
九、怎么找到瓶颈的:三步
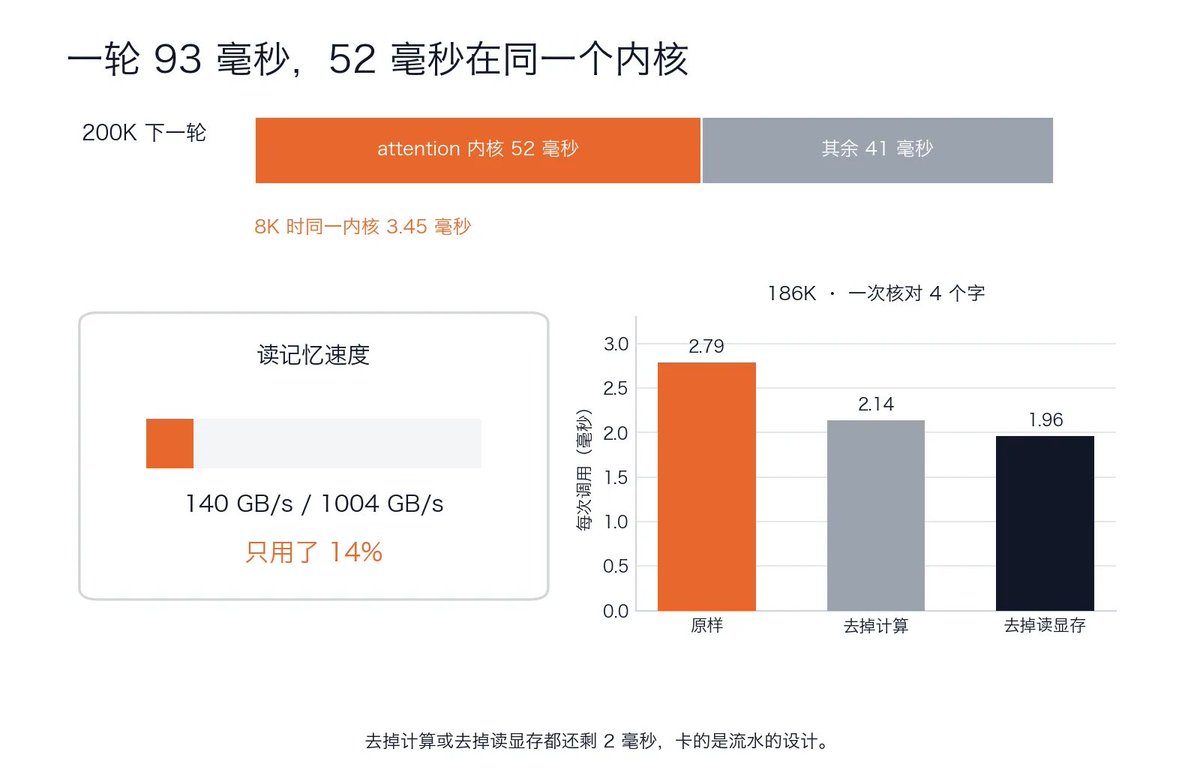
找瓶颈的方法其实很固定,就三步:nsys 抓时间线找最贵的内核,单独量它离带宽上限差多少,再做拆解实验确认卡在哪个环节。用这三步,我们在几百个内核里锁定了一个:一轮 93 毫秒它占 52,读记忆只跑出带宽的 14%,卡在流水设计上,改几行解决不了,只能重写。
按带宽算,V100 单卡在 200K 下的合理上限是 60 多,实测 36。差距在软件里。软件里几百个内核,先要找到是哪一个。
第一步,抓时间线。我们用 nsys 给 200K 生成过程录一遍,每个内核什么时候开始、什么时候结束都记下来,按名字汇总。录下来一看,每生成一轮 93 毫秒,其中 52 毫秒花在同一个内核上,就是第八节说的那个生成档 attention 内核。8K 上下文的时候它只占 3.45 毫秒,200K 涨到 52,上下文一长它就成了大头。
一轮 93 毫秒,这一个内核占 52 毫秒:52 ÷ 93 ≈ 56%
第二步,单独量它。源码自带一个内核基准程序,可以单独跑这一个内核,报它读了多少数据、用了多少时间。186K 上下文、一次核对 4 个字(本来那 1 个加猜的 3 个),它每次调用要 2.79 毫秒。一轮里 16 层普通 attention 每层调用它一次,猜词那几步再调用几次,一轮 19 次左右,加起来就是上面那 52 毫秒。算下来它读记忆的速度只有每秒 140GB,显卡有 1004GB,它只用了一成多。这一步把「慢」变成了一个可以对照的数字。
每次调用 2.79 毫秒 × 一轮 19 次 ≈ 53 毫秒,和时间线里的 52 对上了 读记忆速度 140 GB/s ÷ 显卡带宽 1004 GB/s ≈ 14%
第三步,拆解实验。它为什么只跑出一成多的带宽?我们做了两个对照版本,一个去掉打分计算,一个去掉从显存读数据。去掉计算还剩 2.14 毫秒,去掉读显存还剩 1.96 毫秒,都还剩 2 毫秒左右,卡的是整条流水的设计:每批只取 16 个位置,批太小,读显存的请求一个个发出去等回来;4 个 warp 在重复算同一份打分;每批还要让所有线程停下来同步两次。改几行解决不了,只能重写。
中间还试过最省事的改法,提前把数据读进显卡的二级缓存,只快了 1%。二级缓存是显卡里一块比显存快得多的中转仓库。这个结果也有用,数据从显存到手的速度够,时间花在拿到数据以后的处理上。
英伟达有一个读硬件计数器的工具 ncu,能直接看出内核卡在哪种资源上,但它要管理员权限,这台机器没有,所以我们全程靠拆解实验推理。
十、怎么重写的:新内核的思路
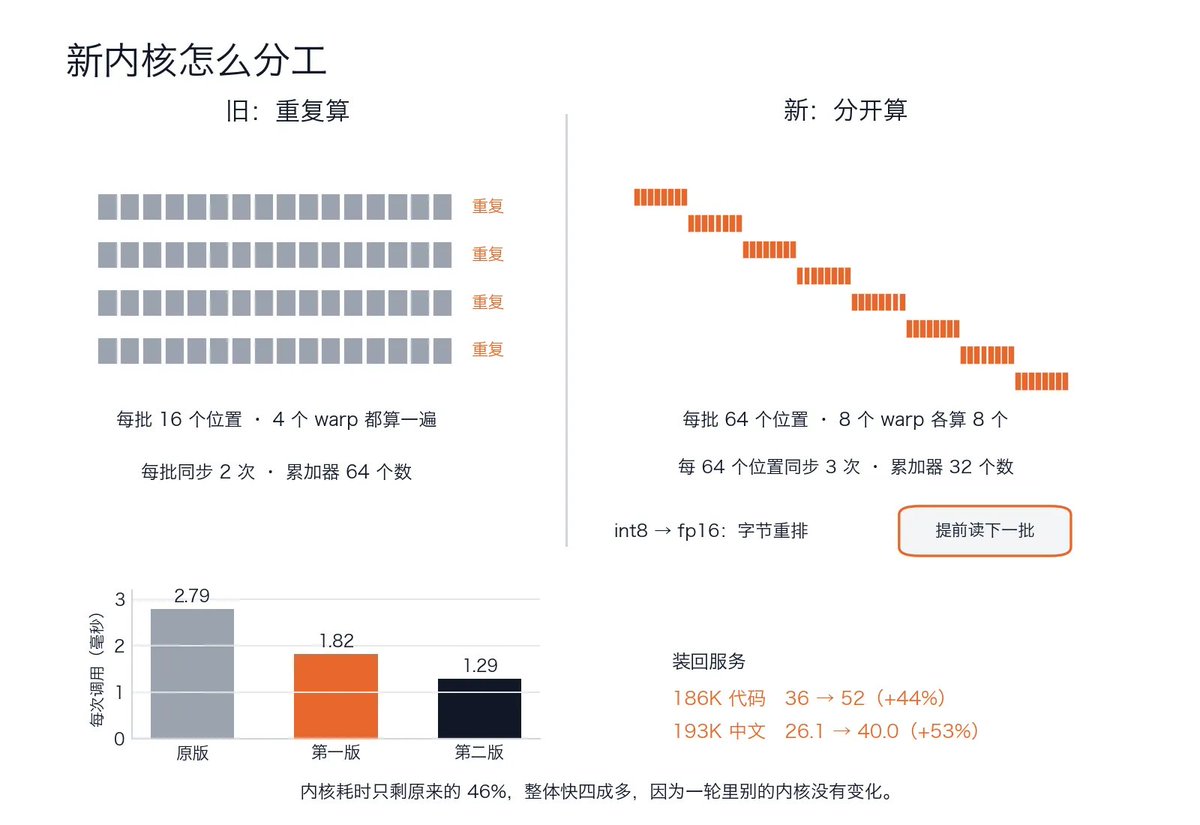
重写分两版,合起来把这个内核从 2.79 毫秒降到 1.29。第一版「分工」:8 个 warp 各算自己那 8 个位置,不再重复打分,寄存器省出来做预读。第二版「找下一个最贵的动作」:用字节重排绕开 V100 慢得要命的 INT8 转 FP16 指令。有两条原则贯穿全程——输入输出格式不变、线上永远能切回旧版,每一版都过三道正确性关。结果是单卡 186K 代码 36 提到 52。
重写之前我们先定了两条原则。
第一条,输入输出格式和旧内核完全一样。旧内核把记忆分成很多段,每段算出一个部分结果,最后由另一个「合并」内核把各段合起来。新内核只换中间这一段,合并内核保持原样,出问题一个开关就能切回旧版,线上永远有退路。
第二条,每改一版都要过三道正确性关。源码自带的 attention 测试要全过;猜中率和旧版一致;用贪心解码比较新旧输出。贪心解码就是每一步都选概率最高的字,这样同一个问题每次答的一模一样,方便逐字对比。计算机算小数时,一串数相加的先后顺序不同,结果最后几位会有极小的差别。模型每一步都在几万个候选字里挑概率最高的,两个候选字概率本来就很接近的时候,这点差别就会让它挑到另一个近义词。所以只允许这种分叉:新旧输出前几百个字完全一样,后面只在近义词上不同。
第一版的思路是「分工」。旧内核是 4 个 warp 各自把同一批 16 个位置的打分全算一遍。新内核改成 8 个 warp,每批取 64 个位置,每个 warp 只算自己那 8 个位置的打分,不再重复。打分完了要做 softmax,就是把打分换算成每个位置该占多大权重,这一步需要知道全行的最大值,8 个 warp 通过共享内存交换各自的最大值,再把各自算出来的权重写进共享内存里的一张表,每一列是这批 64 个位置里的一个,每一行是要核对的一个字在一个头上的打分,最多 32 行。最后一步是拿权重去加权汇总前文的内容,每个 warp 负责结果的八分之一,遍历全部 64 个位置。对照一下:原来每 64 个位置要同步 8 次,现在 3 次;原来每个 warp 手里的累加器管 64 个数(256 个数切给 4 个 warp),现在 8 个 warp 各管 32 个,只有原来的一半,寄存器就省下来了。省下来的寄存器又拿去提前读下一批:一边算这一批,一边把下一批数据读进寄存器,读显存的等待和计算重叠起来。「老林说」视频里讲的 TMA 硬件搬运,干的就是这种「搬运和计算重叠」的活,V100 没有这块硬件,只能用寄存器手工做。
这一版单个内核从 2.79 毫秒降到 1.82,快 35%。
做第二版之前我们先读了一遍编译出来的机器码,就是编译器翻译给显卡执行的那份指令清单:每处理 64 个位置,每个 warp 要执行 512 条矩阵乘法指令,外加大约 200 次共享内存读取。本来想从共享内存的读写量下手。
第二版的思路是「找下一个最贵的动作」。我们在内核里插了计时器,把一批数据从进来到算完拆成几段各计时。结果最贵的一段是把一批数据搬进共享内存,每批要 5,400 个时钟周期(显卡每秒跳十几亿个周期,一个周期就是它做一个最小动作的时间),大头是**「把 8 位整数解压成 16 位小数」:记忆在显存里是按 8 位整数存的,算之前要还原成 16 位小数,V100 做这种类型转换的指令特别慢。绕法是用字节重排指令**,把 8 位整数直接拼进一个 16 位小数的二进制位里,再减掉一个固定的偏移量,结果和正规转换一样,但不走那条慢指令。好比要把一个两位数抄进一张四格的表,正规做法是让计算器帮你换算,慢;我们的做法是直接把那两位数填进后两格,前两格填固定的数,最后把前两格代表的数减掉,结果一样,省掉了换算那一步。换掉那条慢指令后,这一段降到 2,340 个周期,单个内核从 1.82 毫秒降到 1.29。
两版合起来,这个内核每次调用从 2.79 毫秒降到 1.29,耗时只剩原来的 46%。它占一轮 93 毫秒里的 52 毫秒,一轮里别的内核没有变化,所以装回真实服务整体快四成多,不是快一倍。
这个内核:1.29 ÷ 2.79 ≈ 46% 改之前一轮:93 毫秒 = 52(这个内核)+ 41(其余内核) 改之后一轮:52 × 46% ≈ 24,24 + 41 = 65 毫秒 提速 = 93 ÷ 65 ≈ 1.43 → 快四成多
跑同一份 200K 素材:
• 代码 186K,36 提到 52,快 44%
• 代码 122K,41.6 提到 56.7
• 中文 193K,26.1 提到 40.0,快 53%
• 中文 126K,33.2 提到 46.3
• 8K 短对话只快了 2% 到 10%,因为短对话根本不卡在这段程序上
猜中率和原版一致,代码 77%,中文 52%。
我们后面还试过更激进的重写,比如换一个方向组织矩阵乘法、把当前的字常驻在寄存器里,只比第二版快 3% 到 14%。原因是显卡由几十个计算单元组成,每个单元本来能同时驻留好几个线程块,一个在等数据的时候别的顶上;但这个内核占的寄存器和共享内存太多,一个单元只塞得下一个线程块,等数据的时候没有别的顶上,再怎么调整内部顺序也补不上这个空档。这条路到这里为止。
十一、推上生产:意外多赚了一倍,顺手压了首字等待
这一节有个意外发现:上线后,线上跑的模型文件(groupwise-int)和测速用的(nvfp4)不是同一个,而 V100 上 nvfp4 的解压路径快得多。同一个请求,换内核 35.1 → 41.9,再换模型文件 → 71.1,硬件没动速度翻倍,模型文件这一步占了七成。读 prompt 的内核没重写,只扫了一遍参数,186K 首字等待就从 455 秒降到 379 秒。
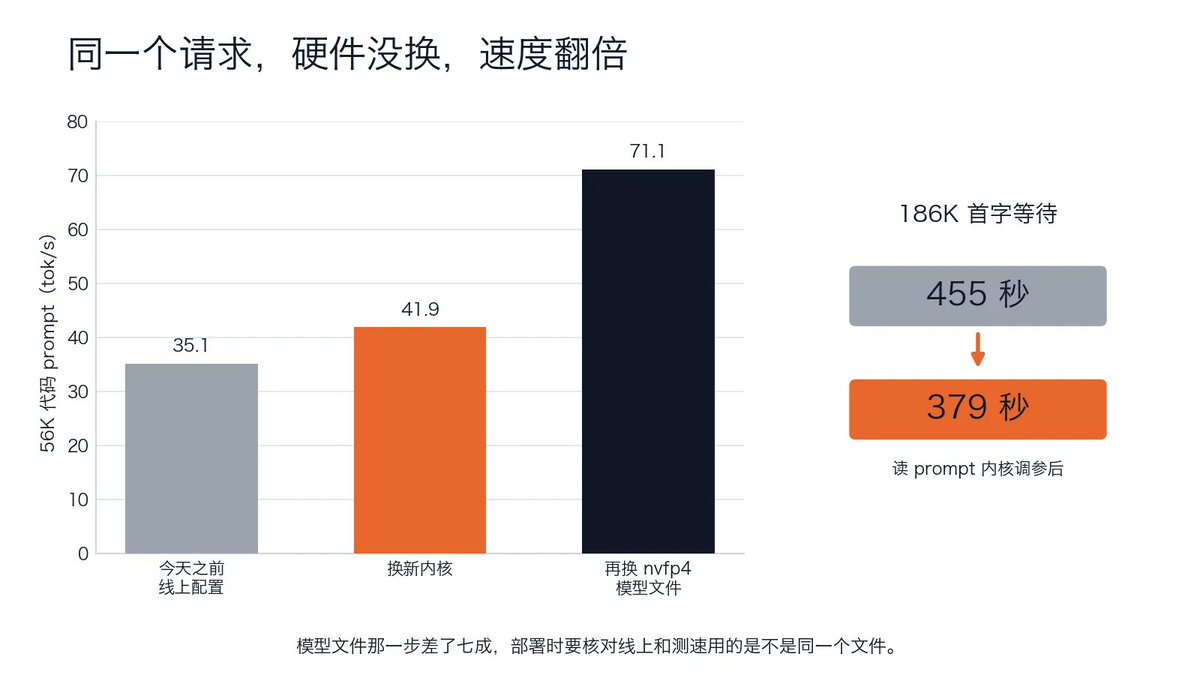
当天晚上我们把新内核打包进 Docker 镜像,切换线上服务,中断 19 秒。在线上用一个 56K 的代码 prompt 测试,跑出 41.9。
比 200K 测出来的 52 低,一查,线上跑的模型文件和我们测速用的不是同一个。同一个 Qwen3.8-27B 压缩以后有两种存法,差别在每个数字怎么压。线上用的是 groupwise-int:把权重压成整数,每一组配一个缩放系数,读的时候整数乘回系数还原。测速用的是 nvfp4:英伟达定的 4 位小数格式,每个数字自己带指数,配的缩放系数也不一样。两种格式在显卡上解压的路径不同,移植版作者在 nvfp4 这条路上下的功夫多,解压完直接进 FP16 张量核,所以在 V100 上 nvfp4 读权重快得多,短对话 79 对 46。线上用 groupwise-int 是最初部署时定的,那时候还没有测试过 nvfp4,后来测出来更快也没有人把它换过去。
换成 nvfp4 以后再测试同一个 prompt,跑到 71.1。
同一个请求,今天之前的线上配置是 35.1,换内核以后 41.9,再换模型文件 71.1。硬件一件没有换,速度翻了一倍。
换内核:41.9 ÷ 35.1 ≈ 1.19 → 快两成 再换 nvfp4 文件:71.1 ÷ 41.9 ≈ 1.70 → 快七成 两步合计:71.1 ÷ 35.1 ≈ 2.03 → 翻了一倍
代价是 nvfp4 的文件大 3.3GB,最大上下文从模型原生的 256K(262,144 个 token)降到 236K。
然后是首字等待。读 prompt 用的是第八节说的那个 flash attention 内核,一次处理一大块 token,这一步卡在算力上,带宽还有富余。我们没有重写它,只扫了一遍参数。这个内核有一组配置,每批处理多少个位置、每次读多少记忆、用几个 warp。我们写了一个脚本,每换一组配置就编译一次、测试一次,扫了三轮十几组。第一轮最好的一组是 warp 从 4 个加到 8 个、每批处理的位置从 32 加到 64,131K 下处理 1024 个 token 从 119 毫秒降到 99.4;第二轮在它上面再把每次读入的记忆减半,降到 88.4,算力从 27.8 TFLOP/s 提到 37.5(TFLOP/s 是每秒多少万亿次小数运算)。再往上试 16 个 warp 直接跑不出结果,估计是超出了线程块的资源上限;在最好那组附近又试了四组,都没有更好,调配置这条路到头了。186K 的首字等待从 455 秒降到 379 秒,生成速度和猜中率没有变化。这一版也上了线,单卡的故事到这里告一段落。
十二、双卡:先看别人做的,再决定做不做
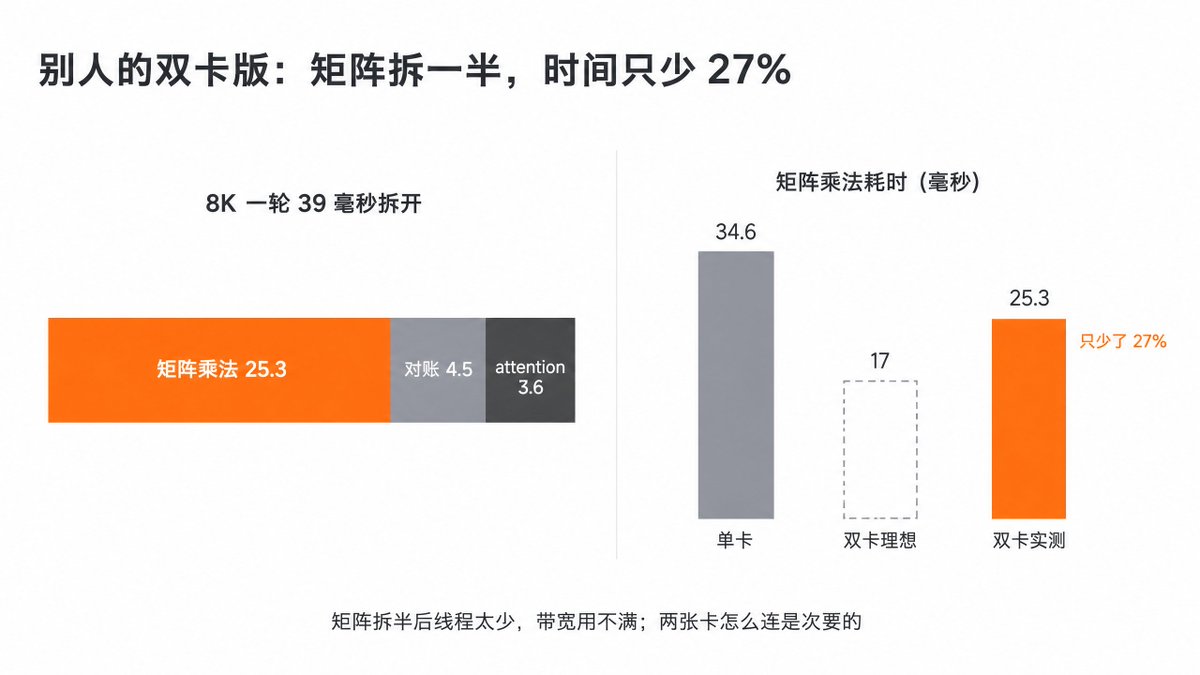
先看了别人做的:那个 V100 双卡版在 200K 下比我们单卡还慢,拆开看,矩阵拆成一半后耗时只少 27%,因为内核调度还按整块矩阵排,带宽跑不满。这定下了方向——双卡快不快,看每张卡的内核拆半后能不能把带宽跑满,卡间怎么连是次要的。动手前先量了两个数:我们的半宽内核效率 0.51 到 0.61 倍(理想 0.5),对账一轮约 3 毫秒,推算 200K 能到 82 以上,值得做。
第二天我们做双卡。第五节说过,Ninfer 不支持一个请求用多张卡,要做只能自己给它加。
动手之前我们先找了一圈有没有人做过。GitHub 上有一个 V100 双卡版的 Ninfer,作者 plus1998,他自己在带 NVLink 的机器上短 prompt 跑出 94.8。我们把它编译出来,在老机器的两张卡上用同一份素材测试:
• 8K 代码 84.0,我们单卡 81.4,只快 3%
• 186K 代码 44.0,我们单卡 52.0,反而慢
• 193K 中文 33.0,我们单卡 40.0,反而慢
plus1998 这版两张卡之间的数据走 CPU 内存中转,按它自己文档里写的数字,每次对账要 277 微秒。我们把它的同步换成 NCCL 再测试,8K 只快 8%,186K 代码只到 45.8,还是比单卡慢。主要瓶颈看来不在对账。
我们用 nsys 在 8K 短对话下把它每轮 39 毫秒拆开:矩阵乘法 25.3 毫秒,对账 4.5 毫秒,attention 3.6 毫秒(短上下文里 attention 本来就小,看矩阵乘法就够)。单卡同样条件下矩阵乘法 34.6 毫秒。每张卡只算一半,矩阵乘法本该降到 17 毫秒左右,它只少了 27%。原因是矩阵拆成一半以后,内核的调度还按整块矩阵的形状在排,每张卡上同时干活的线程太少,带宽用不满。最严重的一个内核拆半后反而更慢,单卡 89 微秒,双卡 105 微秒,带宽从每秒 940GB 掉到 400GB。
这一步把方向定下来了。双卡能不能快,要看每张卡的内核拆成一半以后还能不能把带宽跑满,两张卡之间怎么连是次要的。别人的代码只拿来参考,主干用我们自己改过内核的那份。
做不做,先算账再决定。先按 plus1998 那份时间线推算:要是半宽内核(矩阵切成一半以后对应的内核)能把带宽跑满,每轮约 41 毫秒,其中对账按 4.5 毫秒算,200K 代码能到 82 左右,够做。
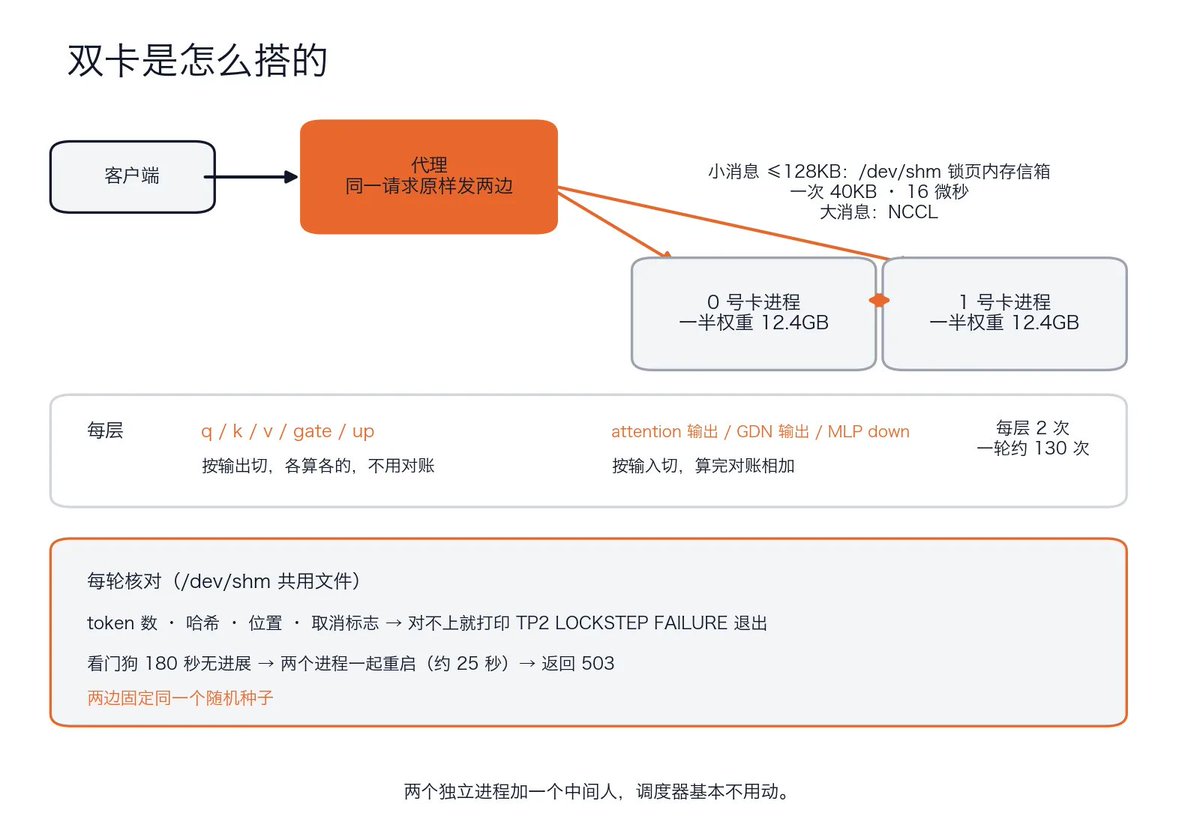
接着实测两个数。第一个数是半宽内核的效率。我们自己的 7 个矩阵乘法内核,矩阵拆成一半以后各跑一次,耗时是整块时的 0.51 到 0.61 倍,理想值是 0.5,效率没有掉。第二个数是对账的耗时。对账用的是第五节说的 NCCL,我们把它放进 CUDA Graph 里跑。CUDA Graph 要解释一下:显卡每一轮要执行几百个小任务,平时是 CPU 一个一个下发,每发一个都有开销;CUDA Graph 是把这一轮要下发的几百个任务预先录成一张图,以后每轮一次提交整张图,省掉逐个下发的开销。这样测下来,10KB 一次对账 15 微秒,40KB 24 微秒,一轮 130 次约 3 毫秒。两个数都比推算时假设的好,那就做。
十三、自己做双卡:设计思路
整个方案落在五个设计决定上:两个独立进程加一个代理,不碰调度器;对账插在「矩阵乘完、加回输入」中间,一轮约 130 次;权重沿输出切的不用对账、沿输入切的要对账、切不了的整份复制;矩阵拆半后的新尺寸要逐个登记进内核表;对账先走 NCCL 绕道 CPU 内存,放进 CUDA Graph。每一条都是取舍,代价是两个进程必须一步不差,留到第十五节解决。
整个双卡方案有五个设计决定,每一个都有取舍。
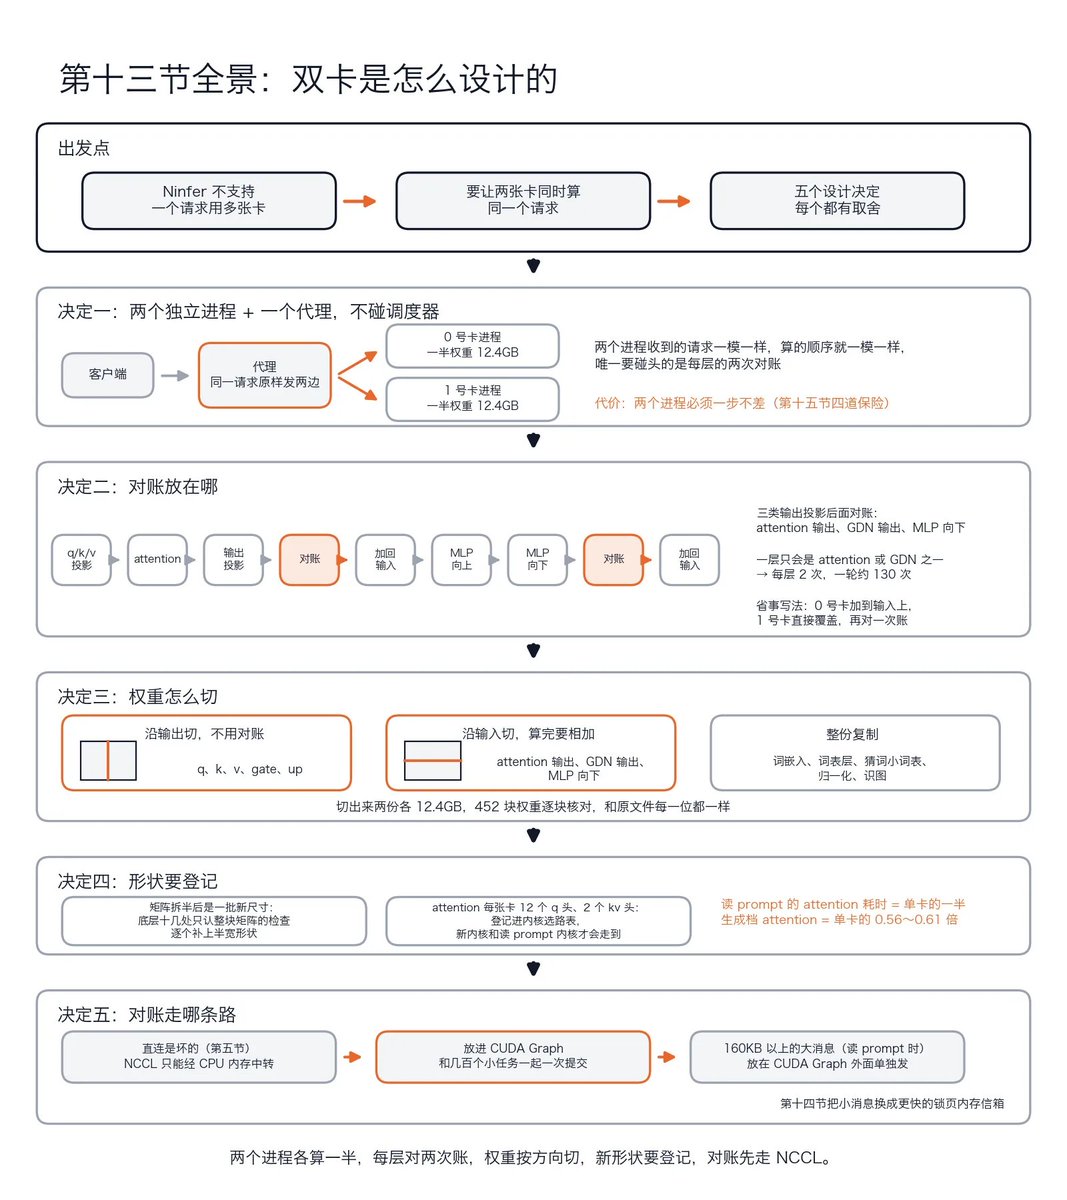
第一个决定,两个独立进程加一个代理,不碰调度器。调度器是引擎里安排每个请求什么时候算、这一轮算哪几个请求的那部分代码。最直接的做法是修改引擎,让一个进程驱动两张卡,但调度器很复杂,改起来风险大。我们选的做法是每张卡启动一个独立的 Ninfer 进程,各自加载自己那一半权重,前面放一个代理,代理是一个中间人程序,把同一个请求原样发给两个进程。两个进程收到的请求一模一样,执行的计算顺序就一模一样,两个进程唯一要碰头的地方是每层的那两次对账。这样调度器基本不用动,后面只在每轮收尾处加了一次两边核对,第十五节讲。代价是两个进程必须一步不差,这个问题留到安全措施那一节解决。
第二个决定,对账放在哪。模型每一层算出来的结果要先加回这一层的输入,再往下传,行话叫残差,这是模型本身的设计。模型里有三类矩阵乘法的输出要把两张卡的一半加起来,行话把这种矩阵乘法叫投影,就是把一组数换算成另一组数,下面都这么叫。三类是:attention 层的输出投影、GDN 层的输出投影,以及每一层都有的 MLP 向下投影。MLP 是每一层里除了 attention 之外的另一大块计算,权重的大头都在这里,它先把数据展宽好几倍再压回原来的宽度,压回去那一步叫向下投影。一层只会是 attention 或者 GDN 之一,所以每层对账两次,64 层加上第三节说的猜词层,一轮约 130 次。这三处本来就是「先乘矩阵、再把结果加回输入」两步分开做的,对账正好插在中间。还有一个省事的写法:0 号卡算完直接加到输入上,1 号卡算完直接覆盖输入,然后对这份数据做一次对账相加,两张卡的一半就合上了,比先对账再加少一次操作。猜词层里同样的位置也加了对账。
第三个决定,权重怎么切。我们写了一个切分工具。一个权重矩阵有两头,一头连着输入,一头连着输出。沿输出那一头切,两张卡各算出输出的一半,各管各的,不用对账,每层开头把输入展开成几路的那些投影(行话叫 q、k、v、gate、up)就这么切。沿输入那一头切,两张卡各拿到一半输入,各算出一份不完整的结果,要相加才对,这就是上面说要对账的那三类:两种输出投影和向下投影。猜词层本身和主干各层一样切开。切不了的整份复制,比如词嵌入(把每个字换成一串数字的那张查表)、最后输出词表的那一层(把算出来的结果换算成几万个候选字各自的概率,行话叫词表层)、猜词用的那层小词表、归一化(每层前后把数值拉回正常范围的一小步)、识图部分。切出来两份各 12.4GB,我们把 452 块权重逐块核对过,和原文件每一个二进制位都一样。
第四个决定,形状要登记。「老林说」视频里讲 Ninfer 快的一条是全 shape 编译期特化,每个矩阵尺寸对应一个专属内核,程序里有一张登记表,只有登记过的尺寸才能跑。到双卡这里它变成了体力活。矩阵拆半以后是一批新尺寸,底层有十几处只认整块矩阵的检查,我们逐个补上半宽形状。attention 也一样,双卡时每张卡分到 12 个头,这种切法要登记进内核的选路表(程序里按头数决定用哪个内核的那张表),第十节重写的新内核和读 prompt 用的内核才会走到它。登记完,读 prompt 的 attention 耗时正好是单卡的一半,生成那一档的 attention 耗时降到单卡的 0.56 到 0.61 倍。
第五个决定,对账走哪条路。两张卡之间传数据有两条路,第五节说过,这台机器的直连是坏的,所以 NCCL 只能走绕道那条,数据先到 CPU 内存再到另一张卡。我们先就这么用,并且把对账放进 CUDA Graph 里,和其他几百个小任务一起一次提交。这里有一个限制:160KB 以上的大消息放进 CUDA Graph 里会报错,生成时的消息都很小,没有问题;读 prompt 时的消息大,就放在 CUDA Graph 外面单独发。这条路后面还会换,第十四节会讲,小消息改走一条更快的路。
十四、跑通以后:三个坑和三轮优化
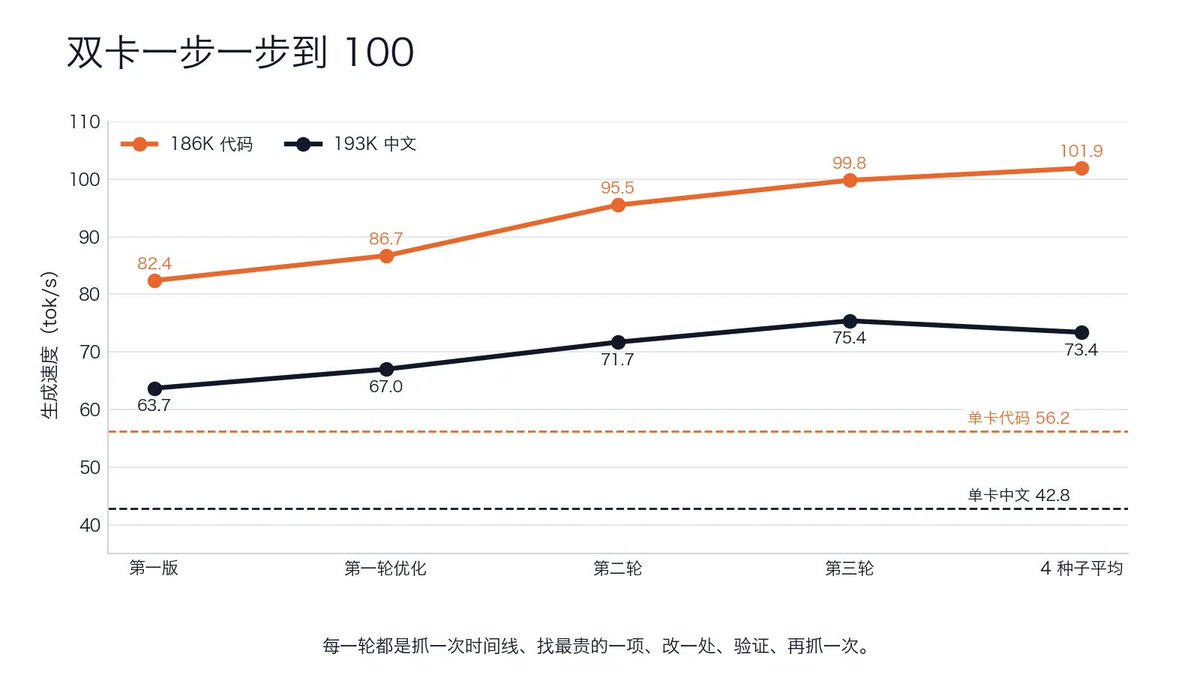
跑通之后,双卡 186K 代码从第一版 82.4 一路做到 101.9,是单卡的 1.8 倍。方法只有一个循环:抓时间线、找最贵的一项、改一处、验正确性、再抓。收益最大的三处:两个只跑到 350 GB/s 的投影先转换格式再算;小消息对账从 NCCL 改走锁页内存信箱,一次 26 微秒降到 16;词表层也拆到两张卡。把每轮 33 毫秒拆开,对账只剩 2.2 毫秒,NVLink 就算全省掉也只有 7%。
跑通以后两张卡算出来的 token 逐个比对完全一致,但猜中率偏低。中途修了三个坑,每个坑的查法都值得说一下。
一,模型算错了,表面看不出来。输出能读,就是猜中率低。查法是把单卡和双卡每一层的输出存下来逐层对比,用余弦相似度衡量,它表示两组数字的方向有多接近,1 是完全一样。从第 0 层就对不上,最后一层只有 0.38。原因是 MLP 的权重加载时会改成 V100 专用的排列,1 号卡的计算路径认不出这种排列,认不出的正是第十三节那条「1 号卡直接覆盖」的路径。修法是让 1 号卡也先把输入清零,再走和 0 号卡一样的累加内核,两张卡的路径就一样了。修好后最后一层 0.9996。
二,长 prompt 读完后头十几秒生成特别慢。
三,attention 切得太碎。第十节说过记忆是分段算再合并的,186K 被切成约 1000 段,每段只有 185 个位置,最后合并这一步反而成了大头。我们加了一个启动开关能调每段长度,扫了几档,改成每段 1920 个位置,内核从 932 微秒降到 662,每轮从 44 毫秒降到 40。这个改法对单卡同样有效,单卡在同一套测法下从 1402 微秒降到 1130,这里的测法和第十节基准程序的不同,数字不能直接比。
第一版双卡的成绩:8K 代码 112.9,单卡 81.4;8K 中文 86.8,单卡 63.9;186K 代码 82.4,单卡 52.0;193K 中文 63.7,单卡 40.0;186K 首字等待 249 秒,单卡 379 秒。贪心模式下和单卡对比,中文前 229 个字相同,代码前 551 个字相同,之后只是换了近义说法。猜中率和单卡一样。
后面我们又优化了三轮,思路都一样:抓一次时间线,找最贵的一项,改一处,验证正确性,再抓一次时间线。
第一轮的目标是两个只跑到每秒 350GB 的投影,其他的都在 830 以上。原因是它们在内层循环里一边算一边转换输入数据的格式,每读一次要转换 8 个值。我们改成先转换好再算,一个从 80.9 微秒降到 57.3,一个从 42.8 降到 29.4。双卡 186K 代码 82.4 提到 86.7,中文 63.7 提到 67.0。这个改动对单卡同样有效,单卡 186K 代码 52.0 提到 55.9,8K 代码 81.4 提到 97.2。
第二轮做了四件事。
第一件,attention 内核最后一步的加权汇总改成用 32 位小数累加,中间不再来回转换精度;读记忆的地址不再每次重算,按每一页的起始地址加固定偏移直接读。双卡每张卡 662 微秒降到 601。
第二件,对账换路。128KB 以下的小消息不再走 NCCL,改走一块锁页内存。显卡要直接读写 CPU 内存里的一块地方,前提是这块内存固定住不让系统挪动,行话叫锁页;锁好以后两张显卡都能直接读写它,中间不经过任何人。每个线程块有一个标志位,写完自己的一半就举旗,对方看到旗就来读。两张卡按固定顺序相加,0 号加 1 号,保证两边算出来每一位都相同。一次 40KB 的对账从 26 微秒降到 16,每轮省 1.3 毫秒。启动时做自检,等超过 60 秒主动报错,一个开关能退回全走 NCCL。这里踩了两个坑。这块内存必须放在 /dev/shm 这种内存文件系统上,内存文件系统就是一块当硬盘用的内存,放在真硬盘上的文件显卡登记不了。0 号卡重建这个文件的时候不能直接清空,1 号卡还在用着这个文件,直接清空它就崩,要先写临时文件再改名。
第三件,词表层也拆到两张卡。原来两张卡各算一遍完整词表,现在各算一半,结果通过同一条锁页内存的路拼回完整的概率表,输出和不拆时逐字相同,每轮省 1.1 毫秒。
第四件,nvfp4 矩阵乘法内核改成软件流水,就是一次先发出 8 组读取再开始算,让读数据和计算错开,快 5% 到 9%。
这一轮双卡 186K 代码到 95.5,中文 71.7。
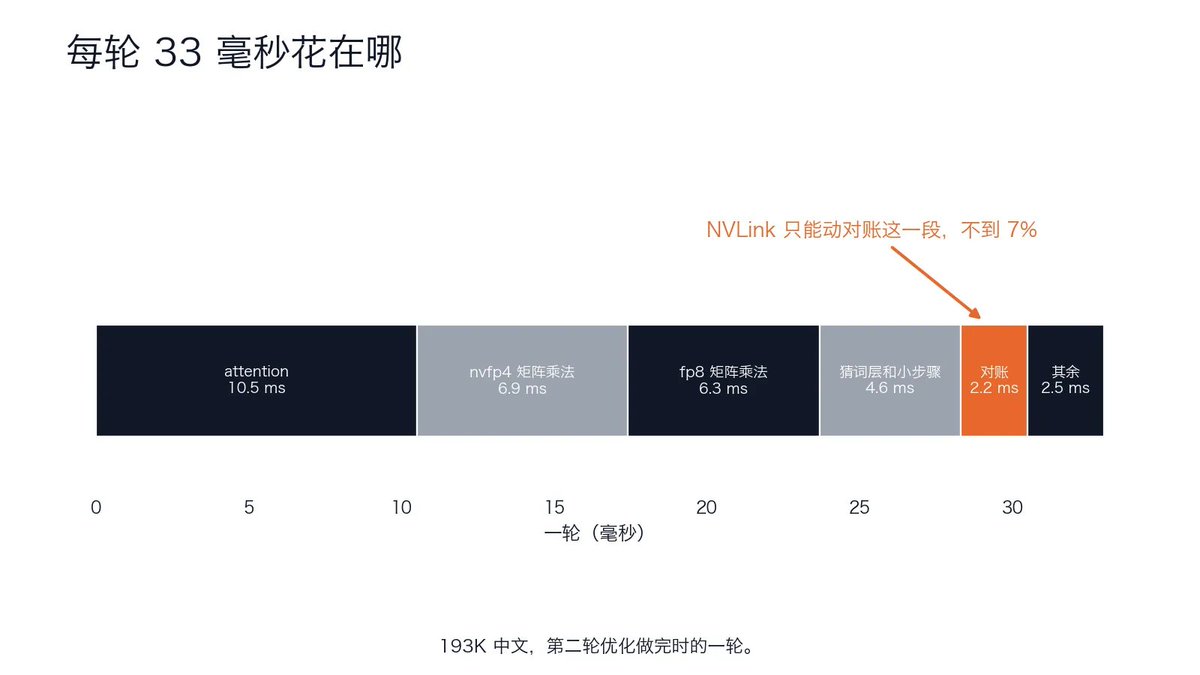
第二轮做完的时候,193K 中文每轮 33 毫秒。我们把这 33 毫秒拆开,看是哪些内核花掉的。attention 10.5 毫秒,是大头。矩阵乘法一共 13.2 毫秒,分两种格式:模型文件里 MLP 的权重按 4 位存,用的是 nvfp4 格式,这部分乘法 6.9 毫秒;attention 和 GDN 的投影按 8 位小数存,就是 fp8 格式,这部分 6.3 毫秒。MLP 是每一层里除 attention 之外的另一大块计算,第十三节讲过;GDN 是那 48 层线性注意力,第八节讲过。两张卡对账 2.2 毫秒。猜词层和几个小步骤加起来 4.6 毫秒。其余 2 毫秒多没有单独列出。第六节说 NVLink 对生成速度帮助有限,依据就是这里:每轮 33 毫秒里对账只剩 2.2 毫秒,NVLink 就算把这 2.2 毫秒全省掉,也只有 7%。
33 毫秒 ≈ attention 10.5 + 矩阵乘法 13.2(nvfp4 6.9 + fp8 6.3)+ 猜词层等 4.6 + 对账 2.2 + 其余 2.5 NVLink 最多省掉对账那 2.2:2.2 ÷ 33 ≈ 7%
第三轮我们做了两件小事。先把 MLP 的「算完再加回输入」合并进矩阵乘法的输出阶段,顺带 1 号卡生成时不用再清零了,测出来 186K 代码 99.8,中文 75.4,比上一轮多出来的大半是这次样本的猜中率比上一轮高(代码 72% 到 76%,中文 46% 到 49%),每轮耗时只从 33 毫秒降到 32.7。再把 attention 合并各段结果的那个小内核修了一下,它 256 个线程里四分之三闲着,循环里还有条件判断挡住了提前读取,从 29 微秒降到 13,每轮再降到 32.5。
中文还差一点到 80。有一个办法测出来是 79.6:猜词的时候只看最近 32K 的上下文,最后核对还是用完整上下文,输出不受影响。不过这 79.6 里有一部分是那一轮中文猜中率偏高(51%,前一轮是 46%),窗口本身每轮只省 1 毫秒多。而且代码的猜中率会从 72% 掉到 59%,186K 代码从 95.5 掉到 87.4。中文涨、代码跌,这个开关做成了默认关闭。
单次测试的数字会随样本波动,所以我们最后换了一种稳一点的测法来定最终数字:同一个长 prompt 换 4 个随机种子,每次生成 1024 个 token,取平均。换一个随机种子就得到一份不同的输出。双卡 186K 代码 101.9(4 次都在 100 以上),193K 中文 73.4(4 次在 71.6 到 74.9 之间)。同一份新程序跑单卡是 56.2 和 42.8。代码和中文每轮耗时一样,都是 32.4 毫秒,中文慢只是因为猜中率低,46% 对 77%,单卡上这份中文文档的猜中率也是 48%,不是双卡把猜词弄差了。中文单次测到过 80.5,那是碰上好猜的样本,稳定到 80 还没有做到,每轮还要再省 2.3 毫秒。
十五、上线前的安全措施:两个进程怎么保证一步不差
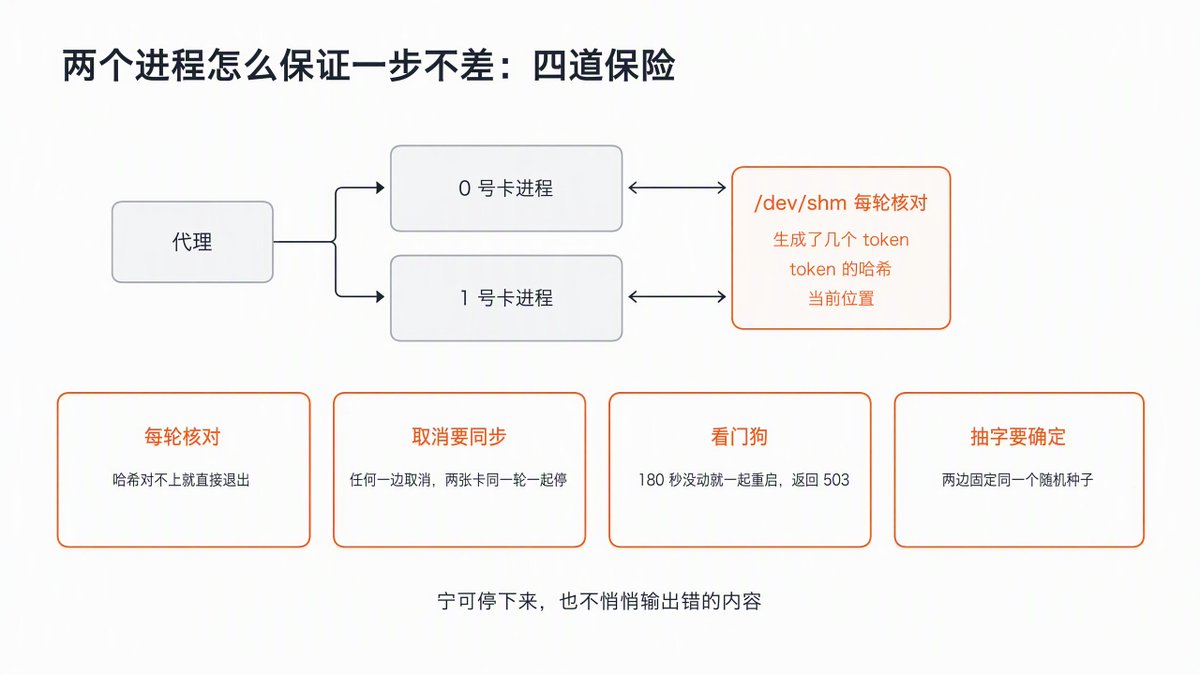
两个独立进程合跑,最怕的是一边多算一步两边互相死等,或者算得不一样却没人发现。所以上线前做了四道保险:每轮交换 token 数、哈希、位置,对不上直接退出;取消信号两边取「或」同轮一起停;看门狗 180 秒没动就重启两个进程;随机种子固定,让两边抽出同一个字。原则只有一条——宁可停下来,也不悄悄输出错的内容。
第十三节留了一个问题:两个进程各跑各的,只要有一边多算或少算一步,两边就会互相等着对方,谁也不动,整个服务卡住;更糟的是两边算的不一样却没人发现,输出错的内容。上线前我们做了四道保险。
第一道,每轮核对。两个进程各算各的,怎么知道对方算到哪了?我们让它们每算完一块 prompt、每生成一轮,就交换三个数:这一轮生成了几个 token,这些 token 的哈希,当前的位置。内容有任何不同哈希就不同,所以比对哈希就等于比对了全部 token。交换的办法是两个进程共同读写内存里的一个文件,这个文件放在 /dev/shm 里,就是第十四节说的那种当硬盘用的内存,和第八节显卡里的共享内存不是一回事。三个数对不上,就打印一行「TP2 LOCKSTEP FAILURE」直接退出,宁可停下来,也不悄悄输出错的内容。这条路故意不走 NCCL,因为 NCCL 里排着 CUDA Graph 那 130 次对账,控制信息不能和它们抢顺序。
第二道,取消要同步。用户中途断开、超时取消,这些信号是按时间来的,两个进程收到的时间不一样。所以取消信号也放进每轮核对里交换,两边取「或」,任何一边收到取消,两张卡在同一轮一起停。做这一步的时候还顺手发现一个老问题:非流式请求的客户端断开以后,原来显卡会把整个请求算完。现在代理实时检测连接,断了就取消。
第三道,看门狗,一个定时检查进程还活着没有的小程序。任何一个进程退出,或者请求进行中核对计数 180 秒没有变化,就把两个进程一起重启,约 25 秒,并给客户端返回 503 错误。代理本身退出,Docker 会把整个容器重新启动。
第四道,抽字要确定。模型每一步算出几万个候选字各自的概率以后,要从里面抽一个出来,行话叫采样。采样带随机,两个进程各自抽字,随机数起点必须一样,否则同一张概率表也会抽出不同的字。两边固定同一个随机种子。
代理本身是一个几百行的小程序:启动两个进程,把生成请求排成队一次一个,请求原样发给两边,只把 0 号卡的回复转给客户端,1 号卡的回复读完丢掉,客户端断开就取消 0 号卡。识图请求也走同一条路。
然后是压测,各种场景挨个过一遍:普通请求、流式请求、不带种子的采样、流式中途断开、读 prompt 中途断开、客户端超时、写满截断、提前停止、带图、带图流式中途断开、两种不同的接口格式、多轮对话接着追问时复用前面读过的内容(行话叫前缀缓存:一段对话前面几轮的记忆留在显存里,追问时只读新加的那几句,103K 上下文追问 1.7 秒出首字),两张卡的日志逐条一致。故障注入,就是故意搞破坏看它会不会自己恢复:杀掉 1 号进程、冻住 1 号进程、人为把一张卡的哈希改错、把代理杀掉,每种都返回错误并自动恢复。最后我们在容器里用真实密钥和模型名把这一套又跑了一遍。
十六、上线:两张卡接管生产
上线当天只中断了 24 秒,接口一个字没变。生产端口实测 186K 代码 99.1 tok/s,193K 中文 75.1。双卡后每张卡只放一半权重,显存有富余,当天就把最大上下文从 236K 改回原生的 256K,喂满后代码 91 到 95、中文 68 到 71。
上线只用了两条命令,回滚(切回旧版)只要一条,单卡容器原样保留。
第二天 14:45 我们切换,服务中断 24 秒。端口、密钥、模型名都没有变化,调用方什么都不用改。两张卡各占约 19.9GB 显存。在生产端口上实测:186K 代码首字等待 249.7 秒,生成 99.1 tok/s;193K 中文首字等待 257.5 秒,生成 75.1 tok/s。同一段长对话接着追问,前面读过的内容直接复用,首字等待只要零点几秒到两秒,同一个 prompt 再问一次是 0.1 秒。
双卡以后每张卡只放一半权重,显存有富余,当天傍晚我们把最大上下文从 236K 改回原生的 256K,中断 26 秒。喂满 26 万 token 实测:代码 91 到 95 tok/s,中文 68 到 71,首字等待约 393 秒。每轮耗时从 186K 时的 32.4 毫秒涨到约 35 毫秒,上下文从 19 万拉长到 26 万,多了近四成,生成速度只慢一点,首字等待涨得多一些。
十七、快了,答对的题还一样多吗
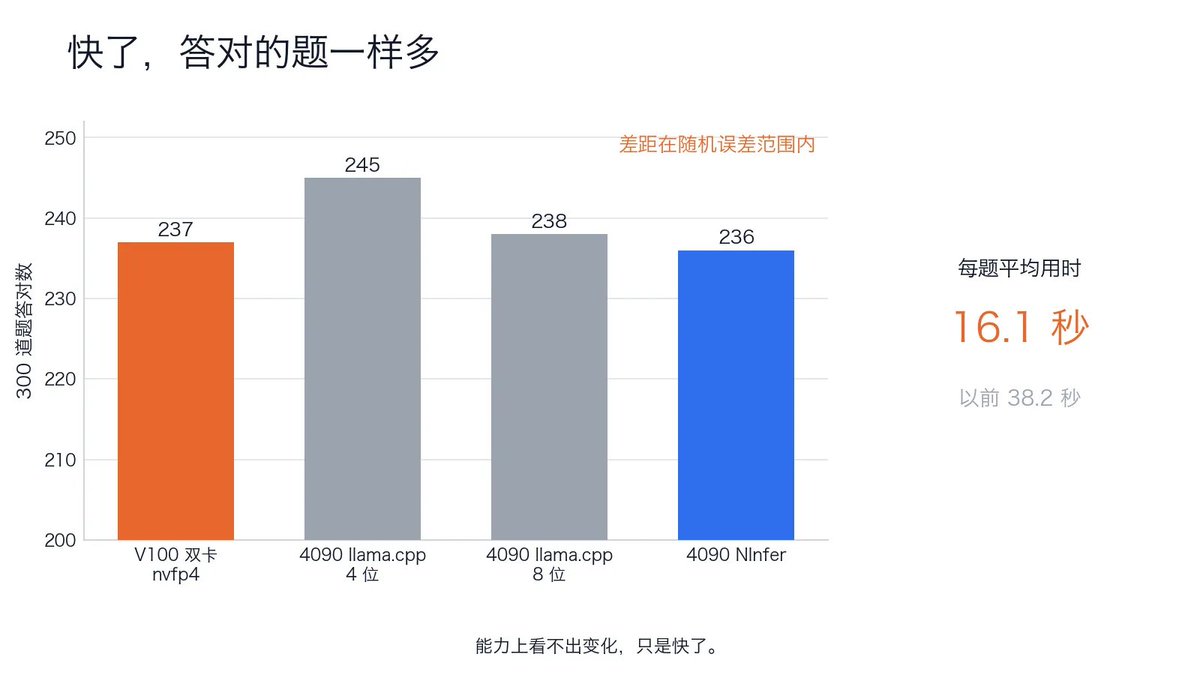
第一个要回答的问题:快了以后有没有变笨。结果是没有。300 道题双卡 V100 答对 237,4090 跑同一个引擎答对 236,只差一道;每道题平均用时 16.1 秒,以前是 38.2 秒。评测中两张卡对不上过一次,第十五节那道核对拦住了,23 秒恢复,没有输出错内容。
速度翻倍以后,第一个要回答的问题是模型有没有变笨。我们用自己的公开题库 model-evaluation 在生产端口上把全套题跑了一遍,生产没有停。
300 道题的基准(150 道 Python 代码题实际运行判分,150 道多学科选择题):双卡 V100 上的 nvfp4 版答对 237 道,以前 4090 上 llama.cpp 跑的 4 位版是 245 道,8 位版是 238 道。逐题配对比较,和 4 位版的差距在随机误差范围内,和 8 位版只差一道。每道题平均用时 16.1 秒,以前是 38.2 秒。
十项能力快筛(10 道题各跑 3 次,和以前 8 位版的答案匿名混在一起,交给同一个裁判打分,裁判是另一个大模型):10 道题每道 10 分,总分 100,双卡 78.6 分,以前 68.4 分。差距几乎全部来自以前那次有 5 次把 16K 的输出额度全花在思考上,最后没有写答案。思考就是模型答题前先写的那一大段推理过程,它也占输出额度。这 5 次集中在两道题上,以前这两道题得了 0 分,所以去掉它们,以前的总分还是 68.4;这次这两道题拿到 10.6 分,30 次都写出了答案。其余 8 道两边差不多,68.0 对 68.4。也就是说,能力上看不出变化,只是快了。
评测里还抓到一次两张卡对不上。第 2 题跑到一半,两张卡算出的结果对不上了一次,第十五节那道每轮核对把它拦下来,两个进程一起重启,23 秒恢复,没有输出错的内容,整场评测只发生这一次。双卡代码里还有一个偶发的不一致问题,保险起了作用,根本原因还没有查到。
旧基线是 llama.cpp 跑的,引擎和权重格式都不一样,这么比不公平,所以又让 4090 也跑 Ninfer,用同一套题测试了一遍:300 道题答对 236 道,和双卡 V100 的 237 只差一道;短 prompt 下的纯生成速度,双卡 V100 是 129 tok/s,4090 单卡是 106,两边猜中率都是 62%。4090 这个 106 比第一节的 118 低,因为第一节是那份代码素材,这里是 300 道题的平均,题目和抽字设置都不同。
十八、最后一张表:两张 V100 对一张 4090
这一节把两台机器放在同一份 prompt、同样参数下正面比一次。生成速度 V100 双卡各档差不多或略快,代码 快 9% 到 29%,上下文越长优势越大,因为读记忆被两张卡分摊了。首字等待 4090 快 1.85 倍,这一步卡在算力上,V100 的第一代张量核两张加起来也比不过 4090 一张,软件补不了。
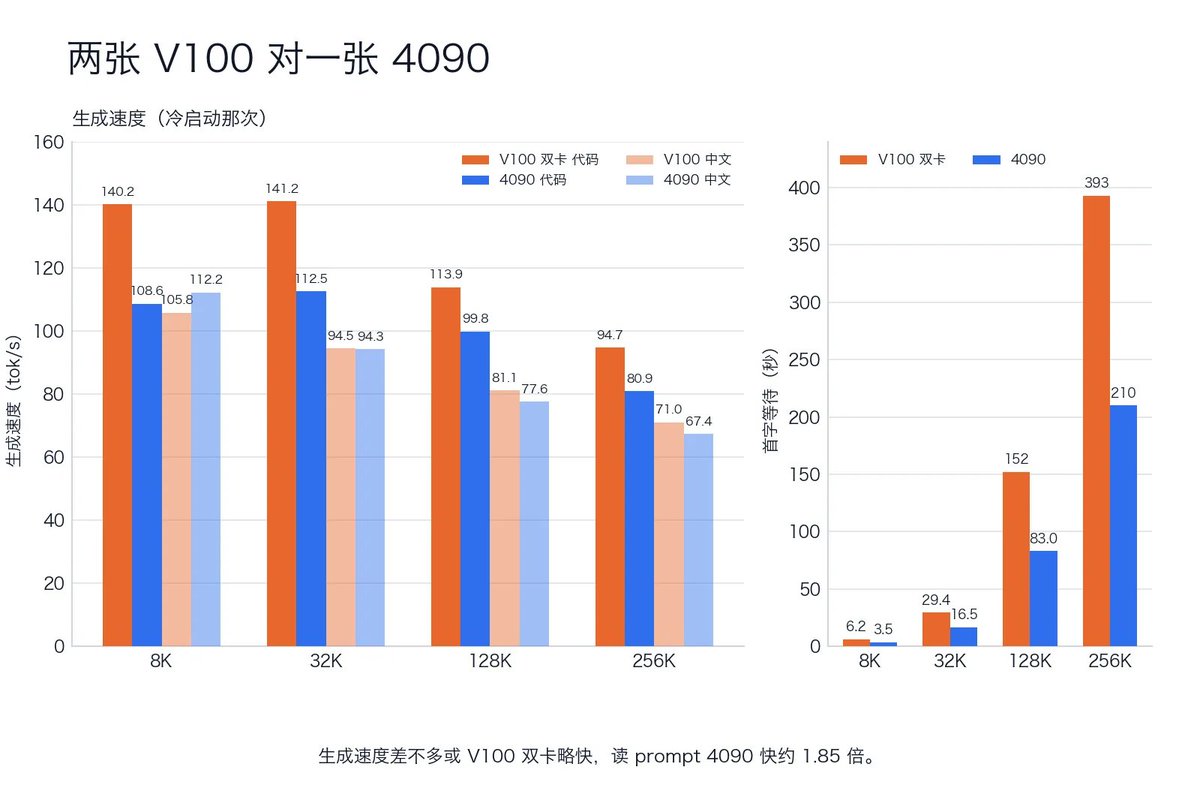
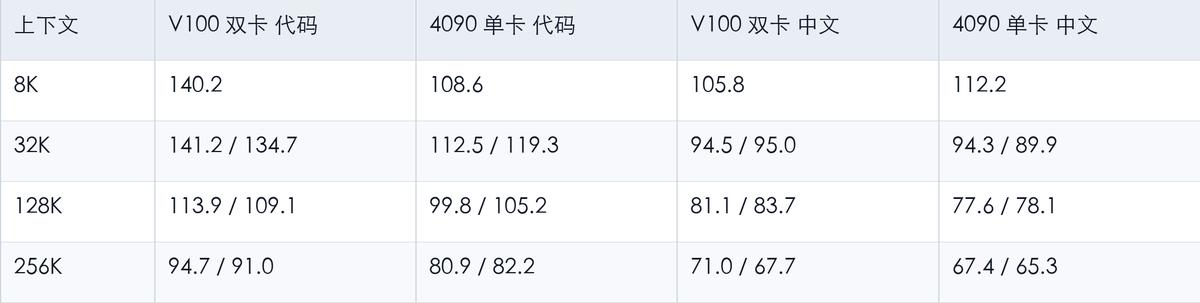
评测跑完以后,我们把两台机器放在同一份 prompt、同样的参数下正面比了一次:8K、32K、128K、256K 四档,代码和中文各一份,每档先冷启动读完整个 prompt 测一次,再换一个随机种子让它命中缓存测一次,每次生成 1024 个 token。V100 是两张卡、nvfp4 权重、我们重写的内核;4090 是一张卡、groupwise-int 权重、Ninfer 官方程序。两边都是各自的生产配置,测 4090 的时候确认了 H3(那台机器平时跑的另一个模型)没有在跑,显卡是空的。
生成速度,单位 tok/s,斜线前是冷启动那次,斜线后是命中缓存那次:
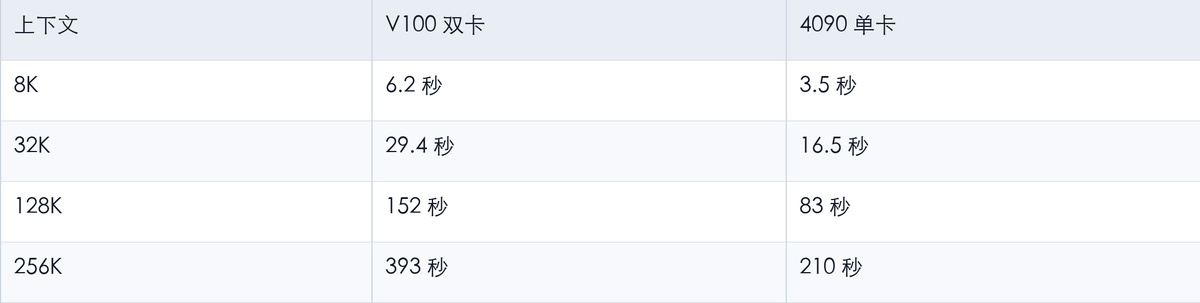
首字等待,第一次读完整个 prompt:
这张表能看出三件事。
生成速度上,V100 双卡各档和 4090 差不多或者略快。代码比 4090 快 9% 到 29%,中文两边差不多,长上下文下 V100 高 4% 到 5%。猜中的字数每次都有随机波动,更干净的比法是看每轮耗时:8K 到 32K 两台都是约 24 毫秒;128K 时 V100 29.3 毫秒,4090 31.2;256K 时 V100 35,4090 37.7。上下文越长,V100 双卡的优势越明显,因为读记忆这笔账被两张卡分摊了。
读 prompt 上,4090 快约 1.85 倍。256K 时 4090 要 210 秒,V100 要 393 秒。
256K 首字等待:393 ÷ 210 ≈ 1.87 倍 128K 首字等待:152 ÷ 83 ≈ 1.83 倍 → 各档都在 1.85 倍上下
第一次丢进一个很长的 prompt,4090 少等一半时间;之后同一段对话接着问会命中缓存,两台都只要 0.1 秒。这一步卡在算力上,V100 的张量核是第一代,两张卡加起来也比不过 4090 一张,这是硬件差距,软件补不了多少。
两张 2017 年的二手卡加上重写的内核,在生成速度上已经和一张 2022 年的 4090 一个水平,长上下文下还略快;差的是读 prompt 那一步。
十九、新机器到了:先给两台机器的卡验明正身
新机器到了,第一件事是给两台机器的卡验明正身。结果发现同样叫 V100 32G,根本不是同一款卡:老机器是 HP 定制的 PG500-216,核心砍一成但显存 1107 MHz;新机器是标准 SXM2,核心全开但显存只有 877 MHz。实测显存带宽差 20.5%,单卡生成速度差 20.3%,两个数对上了。买之前先看 nvidia-smi -q -d CLOCK 里 Max Clocks 那一栏的显存频率,这一项对生成速度的影响是 NVLink 的两倍。
第六节末尾说过,我买了一台带 NVLink 的机器,也就是下文的新机器。它到了,两张 V100 32G,nvidia-smi topo -m 报两张卡之间有六条 NVLink 全部接通。我们按仓库里那份从零安装的清单在它上面装了一遍:编译引擎,从老机器把模型文件走局域网拷过来,切成两份权重,逐字节核对和老机器生产用的一样,起双卡服务,跑功能场景和故障注入。装机碰到的偏差一共七处,都改进了清单,比如系统没有 sudo 权限时 ffmpeg 的四个开发库可以自己编到用户目录,CUTLASS 拉不下来可以先用镜像克隆。
第一轮成绩和预期反着来。
单卡跑 8K 代码,老机器是 97 tok/s,新机器只有 80.6。双卡关掉直连,用和老机器完全一样的口径跑 186K 代码,新机器 98.5,老机器 101.9。多花了两千块买 NVLink,机器还没有老的快。
先排除装错:显卡频率有没有被压低,CPU 是不是同一款,驱动版本,都对得上。答案在 nvidia-smi -q -d CLOCK 里:老机器那两张卡的显存频率是 1107 MHz,新机器是 877 MHz。
同样叫 V100 32G,不是同一款卡。我们把两张卡的 PCI 设备号查了出来。老机器是 10de:1df0,型号名 PG500-216,这是英伟达给 HP 定制的一款 V100,核心比标准版砍掉一成(72 个计算单元对 80 个,第十节说过显卡由几十个计算单元组成),核心频率也低(1380 MHz 对 1530),但显存用了更快的颗粒。新机器是 10de:1db5,标准的 V100-SXM2-32GB,核心全开,带 NVLink,显存是标准的 900GB/s。
然后我们写了一个小程序,在两张卡上各读一遍 1GB 的数据,实测显存带宽。老机器 1058 GB/s,新机器 878 GB/s,老卡高 20.5%。第三节说过,生成速度由每个字要读多少字节决定,读权重那笔账直接卡在显存带宽上。单卡 8K 代码 97 对 80.6,差 20.3%。两个数对上了。
显存带宽:老机器 1058 GB/s,新机器 878 GB/s → 老卡高 20.5% 单卡 8K 代码:老机器 97 tok/s,新机器 80.6 → 老卡高 20.3%
第四节我们量老机器的带宽是 1004 GB/s,那是用另一个程序量的,这次两台机器用同一个程序,数字才能直接比。
所以「两台机器只差一个 NVLink」这个前提从一开始就错了。新机器的卡算力高 23%(计算单元数乘频率),显存带宽低两成。生成阶段靠带宽,老卡占便宜;读 prompt 靠算力,新卡占便宜。买之前我只看了型号,没有看显存频率。同样叫 V100 32G,nvidia-smi -q -d CLOCK 里 Max Clocks 那一栏显存写 877 和写 1107 是两种卡,下次买之前先看这一栏。
双卡的差距比单卡小得多,186K 只差 3%。因为两张卡合跑以后每张卡只读一半权重,读权重的时间少了一半,其他不随显存带宽变的开销占比就上来了,显存慢两成被稀释掉了。
二十、开了直连:读 prompt 快了,生成一个字都没有快
打开 NVLink 直连后,读 prompt 快了 12% 到 35%,可生成阶段一毫秒都没变。原因是第十四节已经把生成阶段所有小消息改走了锁页内存信箱,那条路不经过 NCCL,直连开不开都走同一条道。让小消息重新走 NCCL 反而更慢,NCCL 每条消息的固定开销比信箱还大。线路够快,慢在两头的软件。
新机器两张卡之间的直连是好的。第五节那个小程序在它上面测:传输 4KB 只要 3.2 微秒,大块数据 145 GB/s,接近六条 NVLink 的上限。老机器同样的测试要 49 毫秒。
我们把代理的直连开关打开,让 NCCL 自己选路,再跑一遍全部速度矩阵。读 prompt 这一段确实快了:8K 从 6.6 秒到 4.3 秒,32K 从 32.4 秒到 21.7 秒,128K 从 152 秒到 118 秒,256K 从 394 秒到 346 秒。第六节估算读 prompt 能快三成,128K 实测快了 22%,256K 快了 12%,方向对,幅度小一些。
生成阶段一点变化都没有。186K 代码每轮 33.8 毫秒对 34.5 毫秒,差别在噪声里。
第六节估算生成能快一成,实测是零,原因我们当时没有想到。第十四节第二轮把 128KB 以下的小消息改走了锁页内存信箱,那条路不经过 NCCL,也就不经过 NVLink。生成阶段一轮 130 多次对账全是小消息,全走信箱。所以直连开不开,生成阶段走的都是同一条路。
那让小消息也走 NCCL 呢?我们把信箱关掉再跑:186K 代码每轮 35.0 毫秒,比开着信箱还慢半毫秒。NCCL 每发一条小消息有一笔固定开销,在 NVLink 上一次 40KB 的对账也要二十几微秒,比信箱的 16 微秒还慢。NVLink 的线路够快,慢在两头的软件。
到这一步,两千块只换来了首字等待缩短两成多。
二十一、把信箱搬进显存,NVLink 才算真用上
NVLink 的收益,得自己写代码才拿得到。把信箱从 CPU 内存搬进对方显存(CUDA IPC 映射),数据只过一次 NVLink,一次 40KB 对账从 21.8 微秒降到 7.8;再把旗子和数据装进同一个 8 字节词省掉栅栏,降到 5.6。装进引擎后 186K 代码快 9%,到 105.7。启动时自动比两条路的速度,慢的那条自动淘汰,直连坏的机器也能跑。
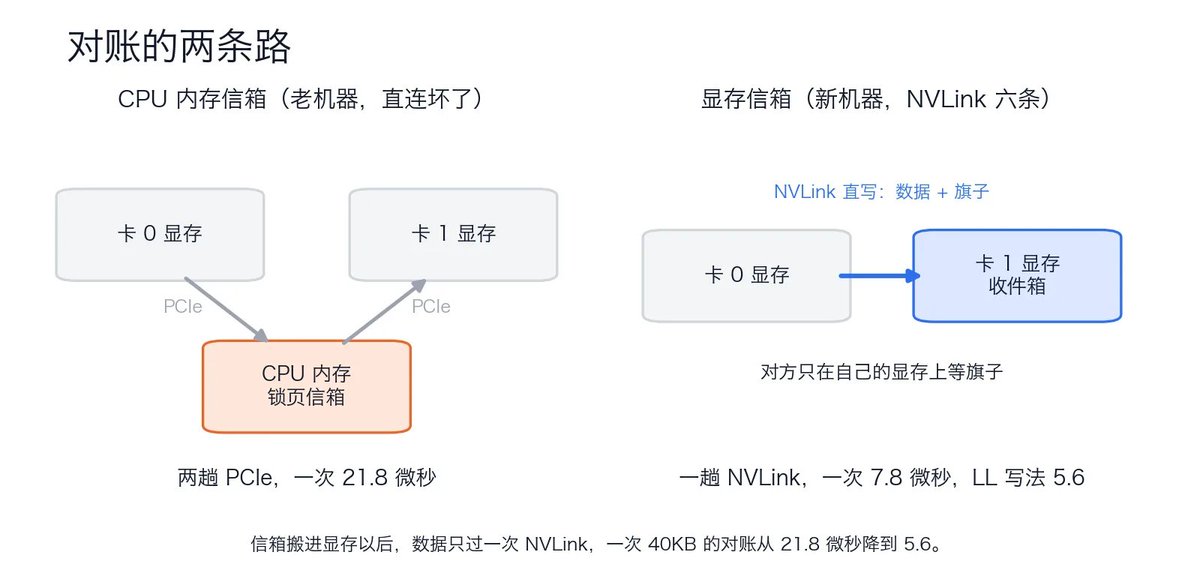
信箱的做法可以留,要换的是它放的位置。第十四节讲过它的流程,那块锁页内存下面叫 CPU 内存信箱:一张卡把自己那一半写进 CPU 内存里的一块地方,举旗,另一张卡看到旗就来读。数据从显存出来,经 PCIe 到 CPU 内存,再经 PCIe 进另一张卡的显存,走了两趟 PCIe。老机器直连是坏的,只能这么走。新机器直连是好的,那就把信箱搬到显存里去。
做法是每张卡在自己的显存里开一个收件箱,通过 CUDA 的 IPC 句柄把对方的收件箱映射到自己的地址空间里,IPC 句柄是 CUDA 提供的一个凭据,另一个进程拿着它就能把这块显存映射进自己的地址空间。对账的时候,每张卡把自己那一半连同旗子直接写进对方的收件箱,写完只在自己的显存上等对方的旗。数据只过一次 NVLink,不再进出 CPU 内存。相加的顺序和原来一样,0 号加 1 号,两张卡算出来每一位都相同。
我们先写了一个只做对账的小程序,两条路各跑两千次比一比:
40KB 一次对账:CPU 内存信箱 21.8 微秒,显存信箱 7.8 微秒 词表层拼回完整概率表(1MB):CPU 内存信箱 335 微秒,显存信箱 27 微秒
一轮生成里有 130 多次对账和 4 次拼表,加起来每轮省 2 毫秒多。
启动时加了两道保险。两张卡先各自自检,各出一份已知数据对账,结果必须逐位正确;然后拿 40KB 的消息把两条路各跑 500 次比一次,只有显存信箱更快才启用,否则退回 CPU 内存信箱。0 号卡做这个决定,把结论写进两张卡共用的那块内存,1 号卡跟着走,两边不会走岔。老机器那种直连坏掉的卡,在这一步会自动被淘汰。
装进引擎再测,8K 代码从 124.8 tok/s 到 135.6,中文从 97.4 到 106.1(这几节的 8K 数字是同一台机器上同一种测法的前后对比,测法和第十八节那张表不同,不能跨表比);186K 代码从 96.6 到 105.7,193K 中文从 69.0 到 73.3,每轮从 34.5 毫秒到 31.5,186K 首字等待从 219 秒到 194 秒。猜中率和改之前一模一样,说明输出逐位没有变化。12 个功能场景全过,杀掉一张卡的进程和冻住一张卡的进程两种故障都自动恢复,重启以后显存信箱会重新协商。
8K 代码:135.6 ÷ 124.8 ≈ 1.09 → 快 9% 186K 代码:105.7 ÷ 96.6 ≈ 1.09 → 快 9%
到这一步,显存慢两成的新机器在 186K 上比老机器高 4 个点,193K 中文两边一样。
后面又改了一版对账的写法。原来的写法分三步:写数据,加一道栅栏保证数据先到,再写旗子。栅栏就是让显卡确认前面的写入都落地了再往下走的一条指令,等它要花时间。新写法把旗子和数据装在同一个 8 字节的词里,4 字节数据配 4 字节步号,读的一方逐词等步号对上就直接用,没有栅栏,也没有单独的旗子往返,这是 NCCL 自己 LL 协议的思路。一次 40KB 的对账从 7.8 微秒降到 5.6,8K 一轮从 22.8 毫秒到 22.4,两个人同时用的时候每人从 100 tok/s 到 108。
我们也量了对账里有多少是两张卡在互相等。一轮 134 次对账,每次最短 7.2 微秒,中位 9.0,多出来的 1.8 微秒是两张卡快慢的抖动,一张卡先到了就得等另一张。这部分任何协议都省不掉,NVLink 在生成阶段能帮的忙到这里就是头了。
读,对方永远读不到,换成 volatile 的 8 字节读写才通。Volta 这一代对跨卡内存的缓存行为和新卡不一样,我们没有查到文档,只能记下现象。
二十二、NVLink 对我们的应用到底有多重要
把两个应用放在一起看,结论是:对我们这两个应用,NVLink 不是必需的。H3 视频生成只快 1%,因为数据交换和计算是重叠的;千问生成快的那 10% 是第二十一节自己写显存信箱拿到的,光开直连是 0;首字等待缩短 12% 到 35%。比 NVLink 更要紧的有四样:显存频率(差两成)、散热(新机器卡 1 降频让 H3 慢 5%)、算力、两卡能不能直连。买卡顺序:先看显存频率,再看算力和散热,NVLink 放最后。
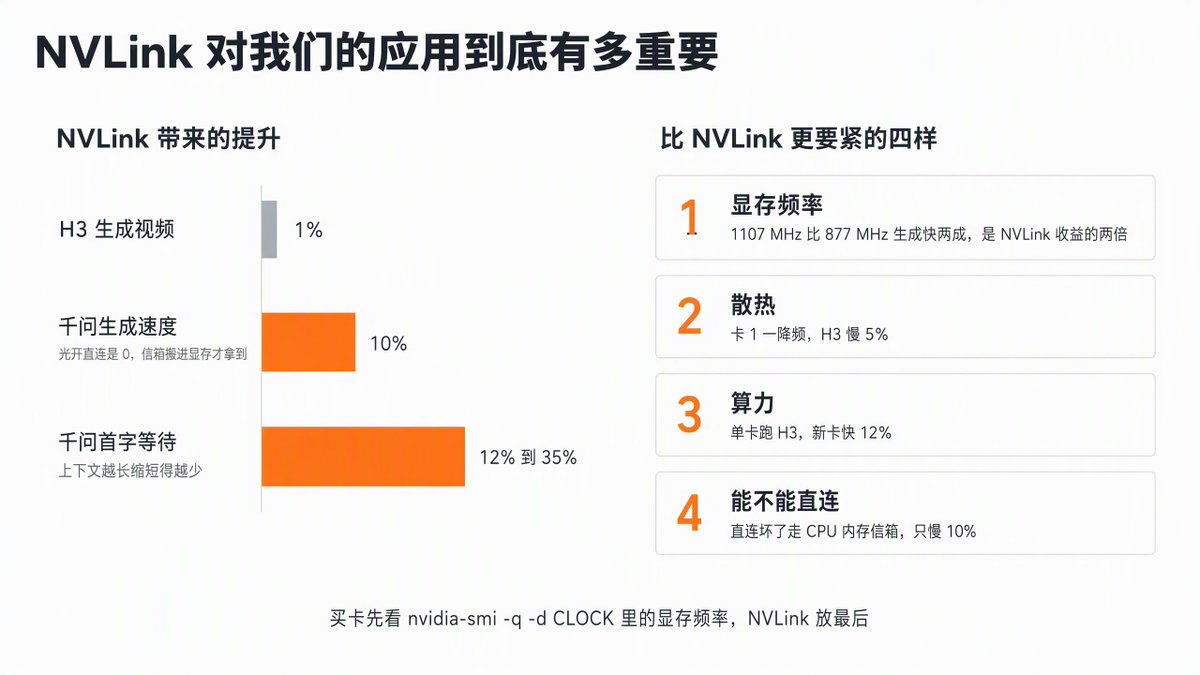
这篇文章前面讲的都是千问 Qwen3.8-27B。新机器上我们还测试了另一个常用的模型 H3。H3 是 MiniMax 开源的视频生成模型,给它一张参考图和一段提示词,它生成一段带声音的视频。老机器上我们已经把 H3 改成两张卡合跑同一段视频,5 秒的视频 59 秒生成出来。这次我们把老机器上最后那几组测试原样搬到新机器上重跑了一遍,程序、模型文件和命令都和老机器一样。
两张卡合跑 H3 的时候,每张卡负责视频的一半,每一层都要把自己那一半的 K 和 V 发给另一张卡(K 和 V 是什么,第八节讲过)。老机器直连是坏的,这份数据只能先进 CPU 内存再出来;新机器我们加了一个开关,让它走 NVLink 直接拷过去。我们让两种方式一条一条交替着跑,这样两边碰到的显卡温度一样。结果 NVLink 每条 5 秒的视频快 0.6 秒左右,约 1%;15 秒的视频和我们平时出高清视频用的那套流程(先生成一遍小尺寸,再放大两倍细化),两种方式都看不出差别。原因是交换数据的时候计算没有停:每张卡先用自己那一半 K、V 算注意力,这一半算完,对方的数据早就到了,传得再快也省不出时间。
5 秒的视频每条约 56 秒,NVLink 省 0.6 秒:0.6 ÷ 56 ≈ 1%
新机器跑 H3 整体比老机器快 5%。模型加载好以后连跑 9 条 5 秒的视频,新机器中位数 55.99 秒,老机器 58.99 秒。只用一张卡的时候新机器快 12%,95.4 秒对 108.4 秒,两张卡一起跑却只快 5%,原因出在散热上。两张卡同时满负荷的时候,卡 1 的温度升到 81 到 84℃;超过 83℃ 显卡会自动降频,卡 1 的频率掉到 1000 到 1270 MHz,卡 0 还在 1400 MHz 以上。卡 1 单独跑的时候只有 55℃,速度和卡 0 只差 1%,卡本身没有问题;从温度看,卡 1 吹的应该是卡 0 排出来的热风。两张卡每一层都要等齐,整段视频只能按热的那张卡的速度走。卡还凉的时候,新机器跑出过 53.28 秒一条;连续跑 12 条以后,每条涨到 56 到 57 秒。
对我们这两个应用,NVLink 不是必需的。比它要紧的有四样:
1. 显存频率。同样叫 V100 32G,显存 1107 MHz 的卡比 877 MHz 的生成快两成,这一项是 NVLink 收益的两倍。老机器用的 PG500-216 是 PCIe 版,不需要 NVLink 转接板,整机还便宜两千多。
2. 散热。新机器的卡 1 一降频,H3 就慢了 5% 左右,比 NVLink 那 1% 大得多。
3. 算力。H3 生成视频主要靠算力,新机器的卡只用一张时比老机器快 12%。
4. 两张卡能不能直连。老机器直连是坏的,靠 CPU 内存信箱照样能跑,和 NVLink 比生成只慢 10% 左右。
这些数都是两张卡测出来的。上到 4 张卡以后,卡和卡之间传的数据占的比例会变大,NVLink 的分量会重一些,这个我们还没有测试过。
二十三、这几天下来我确定的几件事
最后把全文压成八条能带走的东西。前四条是方法——先量带宽再看软件、一个固定的优化循环、双卡快不快看单卡内核、NVLink 放最后;后四条是数字——网上高分先看条件、模型文件差七成、V100 双卡对 4090 的正面成绩、还没做完的两件事。
老卡跑新模型慢,先量带宽,再看软件。V100 的带宽比 4090 高,速度却只有它的四成,这个差距有一半是程序造成的:单卡 200K 只靠修改软件就从 36 提到 56,快了五成多。「老林说」那条视频讲 V100 复现不了 5090 的效果,速度上确实复现不了,但 V100 自己的软件还有这么大空间。
两天里最管用的是一个循环:先把口径统一,抓一次时间线找最贵的那一项,单独量它离带宽或算力上限差多少,做拆解实验确认卡在哪个环节,只改这一处,过三道正确性关,再抓一次时间线。关键的几处改动都留了开关(新旧 attention 内核、对账走锁页内存还是 NCCL、词表层拆不拆、猜词窗口),其余靠旧镜像和旧容器原样保留,一条命令切回。单次测试的数字不算数,换 4 个种子取平均才算。
两张卡合跑一个请求,快不快主要看每张卡自己的内核。别人的双卡版在 200K 下比我们单卡还慢,我们的双卡版是单卡的 1.8 倍(4 个种子平均,101.9 对 56.2),用的是同一台机器、同样坏掉的直连。
NVLink 对我们的两个应用不是必需的。H3 只快 1%,千问生成快的 10% 还是我们自己写代码拿到的。同样叫 V100 32G 的卡,显存频率差出来的两成比它大,新机器卡 1 的散热又让 H3 慢了 5% 左右。以后买卡,先用 nvidia-smi -q -d CLOCK 看显存频率,再看算力和机箱散热,NVLink 放在最后考虑。
网上的高分数,我现在都先看条件,几张卡、多长上下文、开没开猜词。条件不一样,数字比不了。
部署的时候要核对线上用的模型文件和测速用的是不是同一个。同一个请求,换内核从 35.1 到 41.9,再换对模型文件到 71.1,模型文件这一步差了七成。
两张 2017 年的二手卡对一张 4090,同一份 prompt 同样参数正面比:生成速度 V100 双卡各档差不多或略快,256K 代码 94.7 对 80.9,中文 71.0 对 67.4;首字等待 4090 快 1.85 倍,256K 是 210 秒对 393 秒。同一套 300 道题同样跑 Ninfer,答对的题数只差一道,237 对 236。
如果你手上有 V100 这类老卡,单卡内核的改动和卡的数量、有没有 NVLink 都没有关系,换到新机器上也能直接用。双卡的代码在直连好的机器上自动改走显存信箱,直连坏的机器自动退回 CPU 内存信箱,老机器、新机器我们都跑过。
两个人同时用这件事,代理和引擎改完以后各 108 tok/s,读长 prompt 的时候还是一条道,后来的人要等。
还没有做完的两件事:中文长上下文稳定到 80,新机器 193K 中文是 73.3;nvfp4 矩阵乘法内核的解码和乘法要重排,ncu 已经指出它的显存吞吐只有 72%。这两件做完我再发一篇。
资料
有读者会想拿它在自己的 V100 上照着跑一遍,先说清楚仓库里有什么、照着做能到哪一步、哪几处会卡住。代码放在github.com/huangserva/ninfer-v100-tpx
仓库里有三样东西。第一样是改过的引擎源码,就是第十节重写的生成档 attention 内核、第十一节调过参数的读 prompt 内核、第十三到十五节的双卡代码和代理、第二十一节的显存信箱、第二十二节两个人同时用的代理和准入协商,这份源码和我们两台机器上编出生产程序的那份逐位一样,没有藏着没提交的补丁。第二样是切权重的工具,把 Hugging Face 上公开的 Qwen3.8-27B nvfp4 模型文件切成两份,切完能逐位核对拼回原文件。第三样是 README,写了编译命令、切权重的命令、启动双卡的命令、几个运行时开关和已知问题。
照着 README 走,能复现的是方法和大致成绩:编译出程序,切好权重,用一条命令启动代理和两张卡上的两个进程,接口和单卡版一样。从零装到跑完整套测试的清单在仓库的 docs/reproduce.md,每一步都写了预期输出,对不上就停在那一步。有四处要先知道。
第一处,Docker 要先在机器上编译。仓库里的镜像配置只做打包,把你在机器上编译出来的程序、两个库文件和代理装进一个运行镜像,镜像里不从源码编译。上游那份从源码编译的镜像配置我们删掉了,它用的是 CUDA 13 底座(CUDA 是英伟达的显卡编程工具包,13 是最新的大版本),CUDA 13 不再支持给 V100 编译。所以顺序是先按 README 编译,再选择直接启动代理,或者打包成镜像跑。
第二处,新机器就是照 docs/reproduce.md 那份清单从零装的,碰到的七处偏差已经改进了清单,比如没有 sudo 时 ffmpeg 的开发库怎么自己编、CUTLASS 拉不下来怎么用镜像。你在自己的机器上碰到新的偏差,就在仓库里开 issue,我们补进去。
第三处,表里的数字不会一模一样。第十四节说过,成绩随样本波动,代码猜中率高,中文猜中率低。测速用的素材是脚本按固定模板生成的,脚本进了仓库,同样的块数就是同一份 prompt,186K 代码是 722 块,193K 中文是 1162 块;测速脚本也在仓库里,跑一遍就出和成绩表同样格式的表。但换机器、换随机种子,猜中率仍会变。我们自己同一份素材换 4 个随机种子,代码 4 次都在 100 以上,中文在 71.6 到 74.9 之间,落在这个区间里就是正常的。
第四处,硬件。我们在两台机器上都测过:老机器是两张 V100 32G PCIe、直连坏掉;新机器是两张 V100-SXM2-32GB、NVLink 六条。每张卡占约 20GB 显存,开两个人同时用以后是 27.6GB,16G 的 V100 放不下。代理的直连开关 --nccl-p2p auto 让 NCCL 自己选路,显存信箱在直连好的机器上自动启用,直连坏的自动退回。清单第 10 节有新机器上每一步的数字,并发的测试客户端在 tools/bench/v100/tp2_conc.py。第十七节说的两张卡偶发对不上、靠核对加重启兜底的问题,两台机器都还在。
参考:
• Ninfer 官方:
• V100 移植版:
github.com/geoffwatts/ninfer-v100
• V100 双卡参考:
github.com/plus1998/NInfer-V100-Duo
• 1Cat-vLLM:
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


