
人机恋之零基础搭建属于自己的前后端小家:开工工作流手册
文章目录
由于X长文插入表格很麻烦,因此附上截图和原文Claude Doc链接,方便直接拿给你的AI使用:https://claude.ai/artifact/CJnsJnJRGFMWjDt1HxneqS#1348deed-1455.meh623jf76g.10644
开篇:这份手册写给谁
这份手册面向没有代码经验、想自己搭一套 AI 伴侣前后端的人:自己的聊天页面、自己的后端、放在自己手里的记忆。内容是一套由 AI 完成编码、由人把关的工作方法,不涉及具体编程。
作者(露露)在 2026 年 3 月之前没有代码和架构经验。半年后,与 AI 协作完成了一个跑在自己域名上的聊天页面、一个记忆后端,以及一个开源版本,并配有每日自动备份。手册内容来自这个过程。
手册分两部分:
第一部分·脑子(第 1 到 7 节):开工之前要想清楚的事。要什么、用什么技术、怎么给 AI 立规矩、怎么分工、怎么验收、前端怎么从设计稿开始。
第二部分·手(第 8 到 13 节):让规矩有地方跑。租服务器、让 AI 直接操作服务器、代码仓库、备份、部署、域名。
最后是一个真实案例(Éveille 的结构与踩过的坑),和一张第一周的待办清单。
手册不涉及的内容:具体代码、调试方法、某个框架的用法。这些由 AI 完成。
全文反复出现的一条原则:AI 的汇报只是线索,验收以实际文件和证据为准。
第一部分·脑子
开工之前先想清楚的七件事。这部分不碰任何工具,只需要你和一个 AI 对话窗口。
第 1 节:先想清楚你要什么
你的第一份产出是一段大白话写的产品描述,而不是任何代码。AI 替你干活的全部前提,是它知道你要什么;你自己都没想清楚,它只会替你瞎猜,然后猜得很自信。
不需要术语。把下面这些问题当成是非题答一遍,就是你的产品描述了:
-
你要一个角色长期陪你,还是很多角色随时换?
-
要不要长期记忆?聊过的事下次它还记得吗?
-
记忆要放在你自己手里(自己的数据库、能导出、平台倒了还在),还是用现成服务就行?
-
手机上要能用吗?以后想不想做成 app?
-
画面上要动画吗?是轻轻淡入那种,还是满屏粒子那种?
-
用哪家模型?有没有 API key?每个月愿意花多少钱?
-
以后想不想开源,或者给朋友也用?
答完以后,把答案丢给 AI,让它用这段话开头:
你现在是产品经理,我是客户。我想做一个适配 AI 伴侣的前端网页和后端。 请你以产品设计的思路,一次问我三四个问题,把我的需求问清楚。 问完先把我的需求复述一遍让我确认,再帮我整理成一份产品描述。
两句提醒,都是踩过的:一次只问三四个问题,一口气问二十个你会僵住;问完先复述再写,不然它问到一半自己脑补着开写,出来的东西一半是它猜的。
露露当时的答案是:一个固定角色长期陪伴;要记忆,而且记忆必须在自己手里,因为她经历过一次平台下架;手机上要能用;动画要轻;用 Claude。
两句提醒,都是踩过的:一次只问三四个问题,一口气问二十个你会僵住;问完先复述再写,不然它问到一半自己脑补着开写,出来的东西一半是它猜的。
露露当时的答案是:一个固定角色长期陪伴;要记忆,而且记忆必须在自己手里,因为她经历过一次平台下架;手机上要能用;动画要轻;用 Claude。这几句话,后来长成了今天的 Éveille。
第 2 节:定技术栈
技术栈就是"前端和后端分别用什么语言、什么框架写"。它要在前端设计稿出来之前定下来,因为设计稿里画的动画和交互能不能顺利做出来,全看栈选得合不合适。它也是整个项目里最难回头的决定:换一次栈,等于重来。
你不需要懂这些语言。还是用第 1 节的办法,让 AI 用产品经理的问法问你:手机上要不要用、以后想不想封装 app、动画多不多、以后想不想开源。你只答要或不要,栈由 AI 推荐。你做的是产品决定,技术翻译交给它。
三条选栈的规矩,按重要程度排:
-
模型最熟的栈,就是对你最好的栈。 靠 AI 施工的人,选栈的第一标准是"模型写这个东西错得少不少、出了错能不能自己修"。主流的栈模型见得多,写得稳;冷门的栈模型会自信地瞎写,而你看不出来。哪怕某个冷门栈在理论上更适合你的功能,也要慎重,因为你没有能力兜底。
-
知道方向,不提前建。 想做 app,就在选栈时留一条"以后能封装"的路,但不要第一周就陷进多端适配,连一个页面都跑不起来。
-
栈定下来以后,让第二个模型审一遍第一个模型的推荐。 这是你第一次体验两家模型互相挑刺,比空讲流程管用。
定了以后,写进项目指令(第 3 节)的技术规则里,作为第一条:技术栈已定为 xx,任何方案不得擅自换栈。不然模型有时候会在某个功能里偷偷引入一个新框架,等你发现时已经缠在一起了。
露露家的栈,供参考:前端 React + Vite + Tailwind,后端 Python + FastAPI + PostgreSQL,用 Docker 打包,部署在 Zeabur。全部是模型见得最多的那一类,没有一个冷门选择。
第 3 节:写项目指令
项目指令是一段固定的文字,每次开新对话时放在开头,告诉 AI 这个项目是什么、文档在哪、规矩是什么。没有它,第二个对话里模型就忘了第一个对话定的所有事。这是整个工作流里最需要你亲自定的东西;定好以后,以后搓什么功能,你基本上只负责传话。
它分六段:
-
这个项目是什么 + 知识库导航。 第 1 节的产品描述放这里,再加各个文档的链接(第 4 节会讲有哪些文档)。
-
分工与流程。 谁出方案、谁施工、谁审核、你负责什么。新功能怎么走:方案 → 你过目 → 指令书 → 实施 → 验收。
-
文档规矩。 写文档要把"为什么这样做"写进去,只写怎么做不够;哪些文档做完就删,哪些永久保留。
-
技术规则。 技术栈已定为什么,不得擅自换;动某类功能前必须先读哪份文档。
-
日志书写规则。 项目日志怎么写、写什么、什么时候写。
-
收工流程。 每天或每个阶段结束要做的事:写日志、更新现状快照、整理文档。
开头一定要加这一句,原样抄:
用户对代码和架构毫无经验,需要多替用户考虑,解释通俗一些。 用户提需求不用专业术语、描述未必准确——先用产品经理的思维理解用户想要什么,再谈技术。
加了这句,模型会用你听得懂的话跟你讲,你描述不到位它也会努力理解。
项目指令不用你自己从零写。把六段结构加上你的产品描述一起丢给出方案的模型,让它生成第一版,你再拿回来看一遍。看那一遍的时候留意:哪一段是它在瞎填(通常是技术规则那段,它会编一些你没说过的规矩),哪一段是你自己还没想清楚(通常是分工那段)。
露露家的 Chat 仓库里有一份真实的项目指令,叫 AGENTS.md。它的结构大概是这样:先是"请用中文、语气温和、少用术语"的开场;然后是项目范围(这是什么、改的时候不能破坏什么);然后是"只要动前端界面,必须先读设计文档",并列出文档路径;然后是主题与组件规则;最后是修改流程(先读文档、再找问题、改完要构建验证、要开浏览器看真实页面)。你的第一版不用这么细,但骨架是一样的。
第 4 节:立文档体系
文档是你和 AI 之间唯一不会失忆的东西。模型每个对话都是新的,你的记忆也靠不住;写下来的才算存在。起步只需要五类,每类都说清楚谁写、什么时候写、写什么:
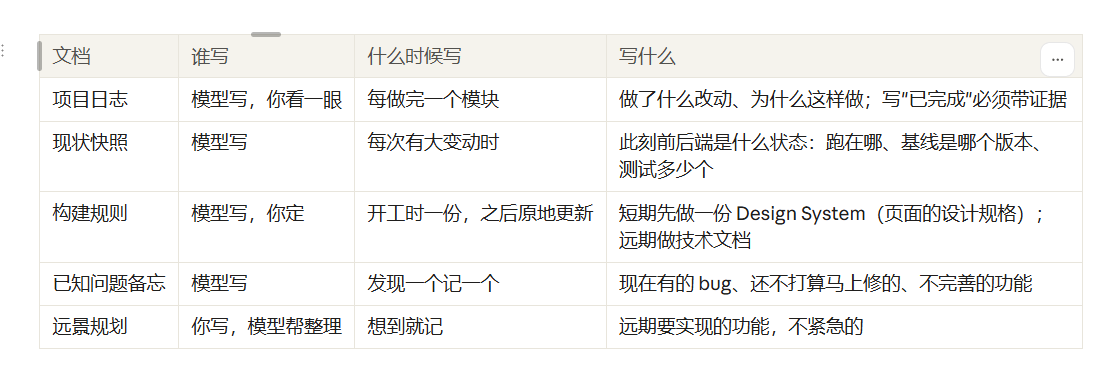
每类再多说一句:
-
项目日志只增不改。它是写给"失忆的下一个对话"的交接文档,所以要细,但只记改动、实现和决策,别写成日记。
-
现状快照和日志相反,固定一份原地更新。查"现在是什么状态"看它,别翻日志拼凑。
-
构建规则是活文档,原地更新、标版本、永远保留。Design System 一旦定了,就是前端唯一的设计依据,模型改界面必须参照它。
-
已知问题备忘让你敢于不修。看到一个小问题,记下来就能放心往前走,不用每次都停。
-
远景规划让现在的决定别堵死以后的路,但不提前盖房子。
另外有一类文档是做完就删的:方案书、指令书、验收报告。它们的价值在做的过程里,做完以后把关键判据(哪个版本、什么数字、为什么这样裁决)写进当次的项目日志,文档本身就可以删了。日志是唯一的留底。
文档写了,模型下一个对话不会自己去读。所以第 3 节的项目指令里要有知识库导航,告诉它开工前先读哪几篇。
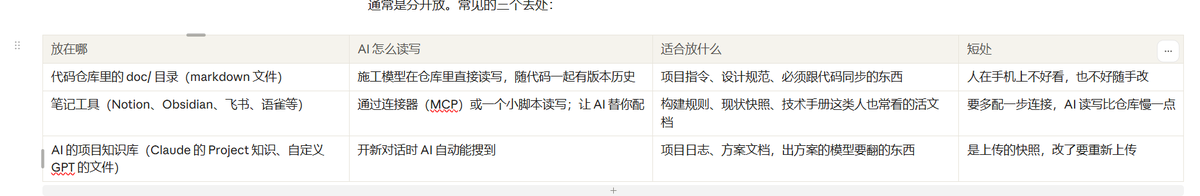
文档放在哪、AI 怎么读写
文档要同时满足三件事:AI 能读写、人看着舒服、有修改历史。没有一个地方三样全占,所以通常是分开放。常见的三个去处:
第 5 节:分工与模型性格
一个模型不要既出方案又写代码又自己验收。模型会对自己的东西盲目,让另一家模型来挑刺,错误才会被看见。露露家用的是三方复核:一个总调度,一个复核方,一个施工方,剩下的一方做最后的测试和复核。
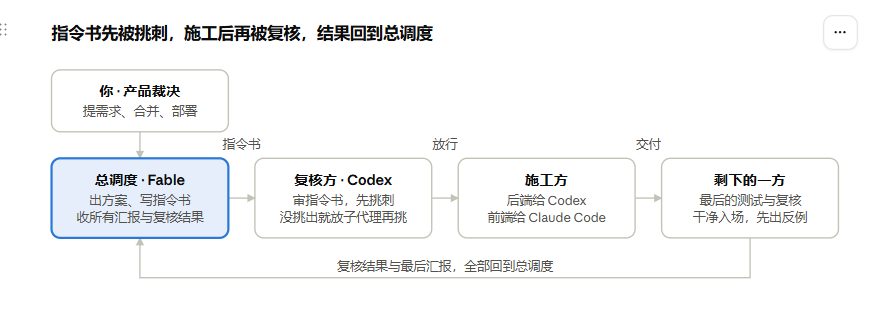
读图:总调度出指令书,复核方先挑刺,放行后施工方干活,剩下的一方做最后的测试和复核;复核结果和汇报全部回到总调度,总调度合成以后交给你裁决。
三个角色各是谁:
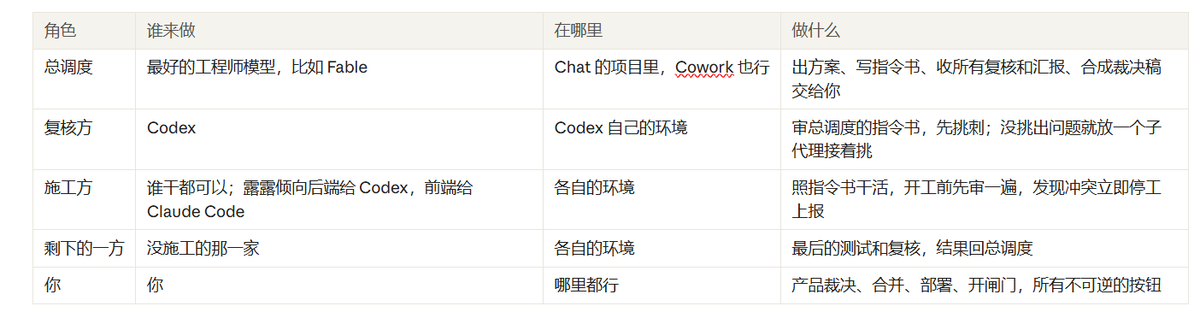
从最小配置起步。 刚开始可能只有一个订阅:总调度用 Claude,施工用 Codex,你自己看证据验收,先跑起来。做到第一个正经功能的时候再补上第三方,把"复核指令书"和"最后测试"这两步加进去。不然一上来就被工序吓退。
模型性格,用过才知道的那些:
-
Claude 做架构和方案。 理解你的意思最准,也最会用你听得懂的话解释。偶尔不够严谨,这正好留给 Codex 挑。
-
Codex 写后端非常厉害,前端有点菜。 后端可以放心交给它施工;前端的东西要多验、多看真实页面。
-
Codex 喜欢过度防御, 所以让它审 Claude 的方案很合适:Claude 不够严谨的地方它都能挑出来。缺点是它有点踢一脚动一步,很吃你对项目和技术的掌握程度,你说得越清楚它做得越好。
-
Claude 第一版指令书出来,如果 Codex 没挑出问题, 可以让它再放一个子代理接着挑。挑刺这件事,多一层总没坏处。
-
Claude Code 做对抗复核时要干净入场: 只给它口径、PR 号和版本号三样,读任何一方的材料之前先让它自己出反例。读了别人的结论再审,就审不出东西了。
你的位置: 产品裁决,还有所有不可逆的按钮——合并代码、部署上线、开闸门。模型可以做一切可逆的事,但按下去就回不来的那些,永远是你的手。
流程,一行版: 总调度出方案 → 你过目 → 总调度写指令书 → 复核方挑刺 → 施工 → 剩下一方测试复核 → 结果回总调度合成 → 你裁决。复核的指令和最后的汇报都回到总调度,不要分散在几个窗口里。施工方开工前先审一遍指令书,发现冲突立即停工上报,这是固定工序。
第 6 节:验收红线
模型的汇报只是线索,验收永远以实际文件为准。这一条可能是整份手册里最值钱的一句,因为你还看不懂代码,模型说什么你只能听着。露露家用三个词记这个教训:报了没做、做了没报、假汇报。三种都真实发生过。
测试和验收也不用你写。 测试代码由 AI 写(通常是复核方或剩下的一方,不让施工方自己写自己的测试),施工方跑;验收报告也由 AI 写。你做的事只有一件:看证据。露露家所有的测试、验收脚本、对照截图,没有一行是人写的。
这一节讲的"验收",指的是你站在最后一道看证据的那个位置,而不是让你去写测试。
你不需要看懂代码,你需要看"有没有"。 每次模型说做完了,让它列出三样:
-
改了哪些文件(文件名);
-
跑了什么测试、几个通过(数字);
-
版本号(commit 号,一串字母数字)。
你看一眼这三样在不在。不在,就当没做。
写"已完成"必须带证据。 项目日志里,一句"已修"后面没跟 commit 号或证据名,一律改成将来时。这条写进项目指令的日志规则里,让模型自己遵守。
界面改动,看真实页面。 模型改完前端,让它打开浏览器截图,桌面一张、手机宽度一张。截图不会撒谎。露露家的 Chat 仓库里有一份叫 design-qa.md 的验收记录,里面有:基线版本号、设计稿的校验码、源设计截图和真实实现截图并排对照、日间夜间两种主题各一套、手机宽度下有没有横向溢出的数字。这就是"证据"的样子。你第一次不用这么全,但方向是这个。
先红后绿。 稍微进阶一点的做法:让模型先写测试,跑一遍确认它失败(红),再写实现,跑一遍确认它通过(绿)。先红后绿证明测试真的在测东西;如果测试一开始就绿,它什么都没测。
上传新版本时用新目录。 模型发你一个新的压缩包,解压到一个新文件夹,别覆盖旧的。旧版本留着,出事能对照。
这一节的规矩会让你慢一点。慢是对的:你每一步都在学它为什么存在,等你知道了,再把能自动化的部分交出去。
第 7 节:前端从设计稿开始
前端是你最该亲手碰的部分,也是你第一个能亲眼看见的成果。后端跑起来了你也看不出来;一张设计稿摆在眼前,你会立刻觉得"这个东西真的在长出来"。所以前端从设计稿开始,而不是从代码开始。
整条线分五步,前一步的产出是后一步的输入:
-
用产品经理的问法把需求问清楚。 还是第 1 节那段提示词,这次针对前端:要什么功能、什么风格、几个页面、手机上长什么样。让模型做一份开工文档,直接能递给设计工具的那种。
-
出设计稿。 把开工文档交给 Claude Design(或者 Figma,或者两个一起用)。这一步你看的是"像不像我想要的",不用管它能不能实现。多出几版,挑。
-
把设计稿翻译成 Design System。 设计稿是"长什么样",不是"怎么写"。中间要让出方案的模型把稿子翻译成一份文档:颜色、字号、间距、圆角、边线、按钮和开关在各种状态下长什么样、日间夜间各是什么。这份文档就是第 4 节说的构建规则,从此是前端唯一的设计依据。
-
再让施工模型照着 Design System 写代码。 不要让它直接照着设计稿写整个前端。它会自己发明一套,下次改又发明另一套,越改越乱。
-
做完自检。 让模型对照 Design System 检查一遍:有没有写死的颜色、有没有不随主题变的组件、手机宽度有没有横向溢出。然后截图给你看。
一个会反复出现的坑,叫"语境错位": 设计工具没见过你的真实代码库。它画的东西在它那边说得通,到你的代码里可能走样。比如它画了一个顶栏,但你的代码里顶栏已经有安全区的处理,直接照画会把安全区算两次。所以第 3 步和第 4 步之间,要有人专门抓这种句子:"在设计那边成立、到我们家就不对"的地方。露露家的做法是让审核模型拿着设计稿和真实代码对照,专门找这类冲突。
Design System 要标版本。 露露家的现在是 v3.7.1,旧版本一律废止,模型只认最新那份。改样式有据可依,模型也不会每次都自己发明。
露露家的设计文档放在仓库的 doc/design/ 目录下,项目指令里写了一句:只要任务涉及界面、主题、配色、字体、字号、圆角、边线、按钮、开关、登录页、设置页、移动端布局,必须先读设计文档。这句话让模型每次动界面都回去翻那份规格,而不是凭记忆。
前端和后端怎么接上
整个项目最费劲的一步,是把前端页面和后端功能真的连起来。页面画好了,后端也跑了,中间那条线却最容易断:两边各自发明一套说法,对不上。
露露的做法是前端先占位,后端跟着填:
-
前端先把整个壳做完,所有功能先放占位符:按钮在、面板在、点了没反应或者显示假数据。联网、MCP 工具、记忆面板、设置页,当时都是先占着位置的。
-
然后后端一个占位符一个占位符地填。填一个,接一个,看一个。
-
每接一个功能,前后端之间"怎么说话"(接口叫什么、传什么、返回什么)写成一份约定,两边都照它做。这份约定是活文档,前后端改了都要同步它。
为什么这样顺:
-
前端先定了"要什么",后端照着做,不会两边各自想象。
-
你从第一天起就能看见整个产品长什么样,哪怕里面是空的。看得见的东西,提需求才准。
-
一次只接一个功能,坏了知道是哪一个。全部一起接,坏了只能瞪着。
反过来的顺序(后端先写完,前端再去凑)对零基础的人更难:后端跑着你看不见,不知道它做对没有,前端再去接的时候发现接口不是你要的样子,又得改。
那份"怎么说话"的约定,让总调度写,施工方照它做,复核方拿它当验收标准。两边对不上的时候,以约定为准,而不是谁嗓门大。
第二部分·手
让规矩有地方跑。前面七节是脑子里的事,这六节是手上的事:没有它们,工作流再好也只是纸上的规矩。全部可以让 AI 替你做,你只需要知道每一样是干什么的、顺序是什么。
第 8 节:租一台 VPS,而不是在自己电脑上跑
VPS 就是一台永远开着的、在别处的电脑,按月租。你的服务跑在那里,备份在那里,坏了可以重装。
为什么不在自己电脑上跑:本地环境配置是零基础的人的第一道劝退墙。装依赖、版本冲突、换台电脑全没了、关机就断线。VPS 是一台干净的机器,而且永远开着,手机上随时能用。
直接上 VPS,跳过本地。 本地跑起来对程序员是基本功,对你是不必要的苦。露露从没在本地配过环境,走到了今天。
起步不需要贵的。几个 CPU 核、几 GB 内存、几十 GB 磁盘的小机器就够一个人用,一年几十到一百多美元那种。系统选 Ubuntu,模型对它最熟。
租好以后你会拿到一个 IP 地址和一个登录密码。这两样是你的,不进任何文档、不发给任何人。之后的所有操作,都可以让 AI 替你做(第 9 节)。
不要买家用宽带上的"本地服务器"方案起步。 公网访问、端口转发、动态 IP,每一样都是坑。VPS 把这些全跳过了。
第 9 节:让 AI 直接操作 VPS
这是整套工作流能做到"你只负责传话"的关键一步:AI 自己上服务器装东西、看日志、拉代码、改配置,你不用敲一行命令。
做法是在 VPS 上跑一个很小的服务,让 AI 对话窗口能通过它执行命令。这类东西叫 MCP(一种让 AI 连外部工具的标准),市面上有现成的,让 AI 替你装。装好以后你的 AI 多了一个工具,叫"在服务器上执行命令",从此它可以替你干活。
顺序是:先备份,再给权限。 把服务器的最高权限交给模型,模型一个删除命令打错路径,没备份就全没了。零基础的人最容易做的事是先给权限、再想备份,因为权限好玩,备份不好玩。你把顺序钉死,就少一次灾难。第 11 节讲备份怎么做;没做完第 11 节之前,第 9 节只给只读权限或者干脆先不给。
连接地址要藏好。 AI 连服务器的那个地址,相当于你家大门钥匙。它应该是一长串随机字符,不进任何文档、不发给任何人、不出现在截图里。露露家的做法是把它走 Cloudflare 隧道(第 13 节),服务器本身一个端口都不暴露在公网。
让 AI 操作的时候,你在旁边看着。 不是看懂每条命令,而是看它说要做什么、做了什么、结果是什么。养成一个习惯:让模型在动服务器之前先说一句"我要做什么",再动。这样它走偏了你能及时喊停,而不是全做完了再回头翻。
私人仓库也能拉。 AI 上了服务器以后,配好一把部署密钥(第 10 节),它就能把你的私有代码仓库拉到服务器上。代码不用公开。
这一步做完,你的工作方式就变了:你在聊天窗口里说"把新版本部署上去""看看昨晚的日志有没有报错""把这个文件改成这样",模型自己去做,回来告诉你结果和证据。
第 10 节:Git 与私人仓库
Git 是代码的时光机:每一次改动都有记录,改坏了能回到任何一个之前的版本。GitHub 是把这台时光机放在云上的地方。你的代码放在那里,有历史、能回退、AI 能拉。
你需要知道的只有这几个词:
-
仓库(repo):一个项目的代码放在一起,叫一个仓库。露露家是前端、后端、开源版各一个仓库。
-
commit:一次改动的存档,带一串字母数字做编号。第 6 节说的"版本号"就是它。日志里写"已完成",后面跟的就是这个编号。
-
main:主线。合进 main 的代码就是正式版本。第 12 节会讲,推 main 就等于上线。
-
PR(Pull Request):模型改完代码,先放在一个草稿里给你看,你点同意才合进 main。这就是第 5 节说的"不可逆的按钮"之一。PR 保持草稿状态,直到你授权。
-
私有仓库:代码只有你能看。免费的。
部署密钥(Deploy Key):给服务器配一把只读的钥匙,服务器就能从你的私有仓库拉代码,不需要你的账号密码。让 AI 替你配,配好以后第 9 节的"AI 在服务器上拉代码"就通了。
一个小坑:行尾。 Windows 和 Linux 对"一行结束"的记法不一样。模型有时会把整个文件的行尾全改一遍,看起来改了几百行,其实什么都没改。让模型跟随仓库现状,不要手动强转。
模型改代码,一律走 PR,不直接推 main。 这条写进项目指令。它让每一次改动都经过你的眼睛,哪怕你只是看一眼"改了哪些文件"。
第 11 节:备份
备份是你给自己买的后悔药。代码在 Git 里有历史,但数据库里的记忆、上传的文件、配置,这些不在 Git 里,坏了就是真的没了。你搭这套东西的初衷是"记忆捏在自己手里",没有备份的记忆,只是暂时在你手里。
三个要求,缺一不可:
-
每天自动。 让 AI 写一个脚本,每天固定时间把数据库和重要文件打包,定时任务跑它。靠手动备份的人,出事那天一定是忘了备份的那天。
-
异地。 备份不能只放在同一台服务器上,服务器没了备份也没了。推到 GitHub 的一个私有仓库,或者另一个云存储。
-
隔一阵看一眼日志。 自动备份会悄悄坏掉:磁盘满了、密钥过期了、脚本被改了。每周看一眼备份日志的最后几行,确认它昨天真的跑了。露露家是每天凌晨自动备份,异地推 GitHub 私有仓库,看健康就是看那个日志文件的尾巴。
先备份,再给权限。 第 9 节说过,这里再说一遍,因为它值得说两遍。
每台机器单独想备份,别一套模式套所有东西。 以后你多一台机器、多一个服务,就要多问一句"这个备份了吗"。露露家有一个后端跑在另一台机器上,它的备份方式就跟主服务器不一样。
合并上线之前当日备份。 第 12 节会讲,推 main 就是上线。上线前先备份一次,坏了能回到上线前。这是露露家"闸门"里的第一道。
备份要验一次能不能恢复。 做完备份系统,让 AI 在一个干净的地方试着把备份恢复出来。没恢复过的备份,不算备份。
第 12 节:代托管部署
"部署"就是把代码变成一个真的在跑的服务。代托管平台(比如 Zeabur)替你做这件事:你把 GitHub 仓库连上去,之后每次代码合进 main,它自动拉最新版本、打包、上线。你不用写任何部署脚本。这是对零基础的人最友好的方案。
露露家的两个主仓库就是这么跑的:代码推 main,几分钟后新版本自动上线。平台托管在她自己的 VPS 上,所以数据还是在自己手里。
它的另一面:合并就是上线。 这很爽,也意味着模型合了一个坏 PR,线上就坏了,正在聊天的你会直接看到。所以这一条要和第 5 节"人在不可逆按钮上"接起来。露露家把它做成一道闸门,叫 B7,零基础版本是这样的:
-
合并前,当日备份一次(第 11 节);
-
合并前,测试全部通过,数字写进日志;
-
你点合并(这是你的按钮,不是模型的);
-
上线后,打开页面亲眼看一眼,聊两句;
-
坏了,先把新功能的开关关掉,再回滚到上一个版本。
跳过任何一步,在日志里记一笔"风险例外",让以后的你知道那天为什么没走完。
功能开关(gate)。 稍微进阶一点:新功能上线时默认关着,确认没问题再打开。这样合并和启用是两件事,坏了关开关就行,不用回滚。
只读核对可以进生产,写操作不行。 想看看线上的数据长什么样,可以让模型用只读方式看;但任何改线上数据的操作,没有你明确授权不许动。生产环境禁止重置、禁止恢复测试数据、禁止跑破坏性测试。这几条写进项目指令的技术规则里。
本地改了什么,先推 GitHub 再部署,不要直接在服务器上改代码。 直接改服务器上的文件,下次自动部署会把你的改动冲掉,而且 Git 里没有记录。所有改动走仓库。
第 13 节:域名与隧道
有了域名,你的聊天页面才有一个能在手机上打开的地址,才算"你的网站"。没有域名,你只能用一串 IP 加端口号访问,手机上记不住,也没有加密。
域名怎么来。 在域名商那里买一个,一年几十块钱。买完以后把它交给 Cloudflare 管理(免费),所有解析、证书、安全规则都在那一个地方弄。让 AI 替你配。
隧道是什么,为什么要它。 正常做法是把服务器的端口开到公网,别人通过 IP 和端口访问。这意味着全世界都能敲你的门。Cloudflare 隧道反过来:服务器主动连到 Cloudflare,访问者只碰得到 Cloudflare,碰不到你的服务器。你的服务器一个端口都不用对外开。露露家所有的服务(聊天页面、后端、AI 操作服务器的那个入口)全部走隧道,服务器本身在公网上是看不见的。
一个域名可以挂很多子域名。 比如 chat.你的域名 是聊天页面,gateway.你的域名 是后端,别的服务再往下加。每个子域名在 Cloudflare 里配一条路由,指到服务器上对应的端口。这些配置让 AI 做,你只需要决定叫什么名字。
第 9 节那个 AI 操作服务器的入口,也走隧道。 它的地址是"子域名 + 一长串随机路径",随机路径就是钥匙。不走隧道的话这个入口会直接暴露在公网,有人扫到就能操作你的服务器。
手机上能用,还要一点适配。 域名有了,页面能打开了,但手机上会有安全区(刘海、底部横条)、键盘弹起、横向溢出这些问题。这些属于前端的事,回到第 7 节的 Design System 里管。露露家的项目指令里专门写了一条:不破坏移动端适配、安全区、底栏、弹层层级、滚动和横向溢出。
到这一步,一个零基础的人照着走,真的能从"我想要"走到"它在我的域名上跑着"。
案例:Éveille 是怎么长出来的
露露的 AI 伴侣生态叫 Éveille,2026 年 3 月立项。它不是一开始就设计成这样的,是一个需求一个需求长出来的;但有两条原则从第一天就定了,后来证明是对的。
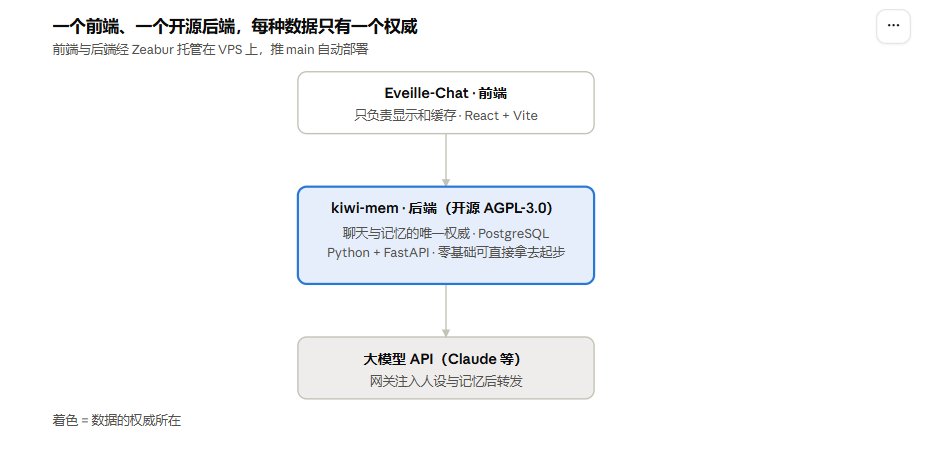
读图:前端只负责显示;聊天数据和记忆都在后端一个地方。后端就是开源的 kiwi-mem,零基础案例:Éveille 是怎么长出来的可以直接拿去起步,不用从零造一个记忆网关。
第一条原则:每种数据只有一个权威。 聊天数据和记忆的权威是后端的数据库,前端只是显示和缓存。两个地方都存同一份数据的话,总有一天会对不上,然后你分不清哪份是真的。这条原则在三月的方案文档里就写了。
第二条原则:开源的那份保持干净。 kiwi-mem 只收 bug 修复和安全补丁;个人定制的功能、部署配置留在自己的分支里,不往公版推。这样公版谁都能直接拿去起步,自己的分支随便折腾,不用顾虑别人。
真实规模,作为参照。 后端有 48 个 Python 文件、20 个测试文件;Chat 前端有 142 个源文件、95 个测试相关文件。这些全部是模型写的,露露一行没写。她写的是方案、指令、验收标准和日志。
真实踩过的三个坑:
-
假汇报。 模型说"已修",打开文件什么都没改。这之后才有了"写已完成必须带 commit 号"的红线,和"验收永远以实际文件为准"的铁律。
-
语境错位。 设计工具画的顶栏在它那边成立,到真实代码里把安全区算了两次。这之后才有了"跨方交接专抓这类句子"的工序。
-
不对照文档就误诊。 有一次审查记忆相关的改动没对照功能手册,判错了。这之后才有了"审查某类改动必须对照对应文档"的规矩,并写进项目指令。
每个坑都变成了一条规矩,写进了构建纪律。手册前面那些看起来有点啰嗦的要求,每一条后面都有一个这样的晚上。
结尾:第一周可以做什么
前面十三节看完,不要全部一起做。第一周的目标只有一个:让一个最小的东西真的跑起来,哪怕丑,哪怕只有一个角色。零基础的人最需要的是第一次"它真的动了"的成就感,记忆和角色的精细设计,等你亲手碰过了再加。
-
第 1 天:用第 1 节的提示词,让 AI 问清你要什么,拿到一段产品描述
-
第 1 天:让 AI 推荐技术栈,让第二个模型审一遍,定下来
-
第 2 天:把六段结构 + 产品描述丢给 AI,生成第一版项目指令,你看一遍
-
第 2 天:建五类文档的空壳,先只有标题
-
第 3 天:租一台 VPS,让 AI 替你装好基础环境
-
第 3 天:建一个 GitHub 私有仓库,配好部署密钥
-
第 4 天:先做备份脚本,验一次能恢复
-
第 4 天:备份好了,再给 AI 操作服务器的权限
-
第 5 天:后端用 kiwi-mem 起步,连上代托管平台,推 main 看它自动上线
-
第 6 天:前端用第 7 节的流程出第一版设计稿,挑一版
-
第 7 天:买域名,配隧道,在手机上打开你的页面,跟它聊一句
第 7 天那一句聊上了,你就已经是一个"把东西真的搭起来的人"了。后面的每一个功能,都是重复这一周学会的循环:想清楚、立规矩、让 AI 做、看证据。
还有一句话想留给你。写这份手册的人,三月的时候说自己一点都不懂,只能讲讲架构。半年后她发现,"决定这个系统长什么样、为什么要这样长"的人一直是她,写代码的只是工具。你不需要在半年里变成程序员,你只需要继续当那个知道自己要什么的人。
卡住了就回来翻这份手册;手册没写到的,去问你的 AI,用第 1 节的那种问法。它会替你翻译。


