
斯坦福 CS224V「Agentic AI」课程:Monica Lam 团队如何把会幻觉的 LLM,改造成可信赖、可追责的智能体
文章目录
Stanford CS224V「Agentic AI」
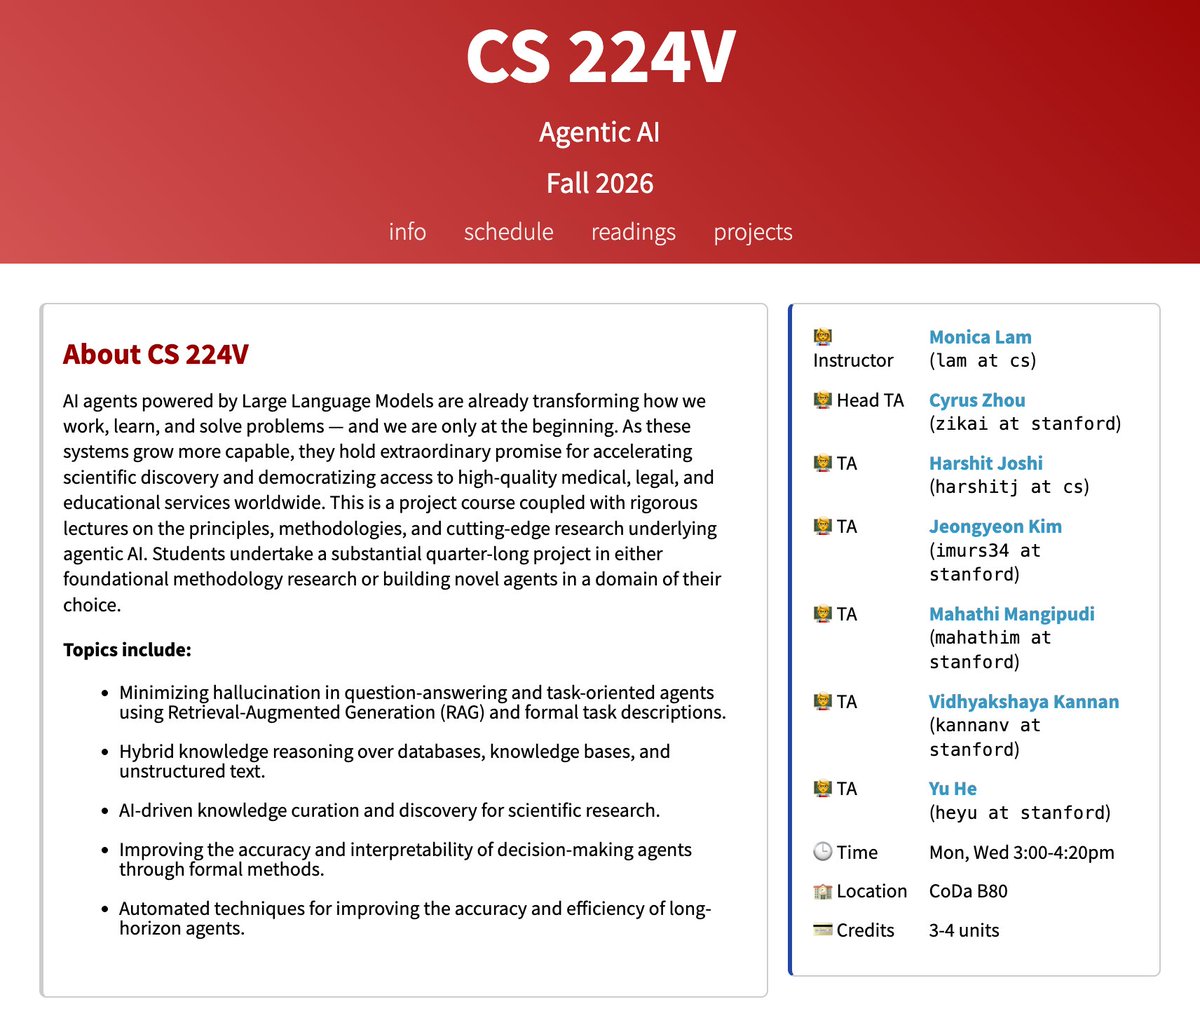
https://web.stanford.edu/class/cs224v/index.html
斯坦福大学 Monica Lam 教授主讲(其 NLP 组 OVAL Lab 出品)的以项目为核心的 Agentic AI 研究课程,但它的立场和市面上大多数“Agent 速成课”截然不同:整门课围绕一个中心问题展开,如何把本质上不可靠、会幻觉的 LLM,变成可信赖、可追责的智能体。课程相信这类系统“对加速科学发现、普及医疗/法律/教育服务有非凡前景”,但前提是先解决可靠性。
目前前两讲课件已公开:
https://web.stanford.edu/class/cs224v/lectures_2026/l-introduction.pdf
https://web.stanford.edu/class/cs224v/lectures_2026/I-DeepResearch.pdf
课程的技术主线:一条“反幻觉”的知识栈
如果把 15 讲内容和阅读清单放在一起看,课程实际上自底向上构建了一条完整的技术栈,每层都在回答“可靠性从哪里来”:
1. 基础层:LLM 本身(阅读清单第 1 节) 必读只有两篇:Transformer 原始论文(Attention is All You Need)和 Chain-of-Thought。外围是 GPT-3、InstructGPT、LLaMA、DeepSeek-R1,加上工具调用(MCP)、蒸馏与测试时扩展(S1)。这一层只是地基,不是重点。
2. 知识策展(Knowledge Curation) STORM 家族 9/28 讲 STORM/Co-STORM:让 LLM 从多视角迭代搜索、阅读之后再写作,像写 Wikipedia 词条那样生成开放域知识。这是 Lam 组的招牌工作,也常被认为是后来各家 "Deep Research" 产品的学术源头之一。
3. 自由文本上的可靠问答(RAG) 检索(ColBERT、RankGPT)+ 生成 + 验证。代表系统 WikiChat(获 Wikimedia 2024 年度最佳研究奖)强调“先验证再生成”,而非生成后再解释。同时配了一整节关于事实性评估方法论的阅读,这门课对 evaluation 的重视贯穿始终。
4. 结构化与异构数据上的 Agent 这是课程最有辨识度的部分。SUQL 是“第一个把信息检索(自然语言)与数据库查询(SQL)结合起来的查询语言”;SPINACH 用反应式 Agent 工作流攻克 SPARQL 知识图谱查询(Wikidata 150 亿条事实),已实际部署在 Wikimedia。核心思想:能交给形式化查询引擎做的事,就不要让 LLM 自由发挥。
5. 形式化方法与可追责 AI(课程最独特的标签) 10/5 一讲把约束编码为 SMT(可满足性)公式,让定理证明器充当“可追责的决策者”,保证 LLM 给出的理由(rationale)是 sound and complete 的。SatIR 和 VERDICT 用于临床试验匹配这类高风险场景。对应的阅读还包括 SATLM、Logic-LM、Lang2LTL——即“LLM 做翻译,符号求解器做推理”的神经符号路线。
6. 任务型对话 Agent Genie Worksheet 被称为“第一个高级任务型 Agent 声明式规约语言”:先用形式化的对话状态表示约束住 Agent,再让 LLM 做语义解析和回复生成,从而在垂直领域规模化复制无幻觉 Agent。
7. 元 Agent 与元优化(面向未来的一讲) 11/11 讲 Coding Agents(Claude Code、Codex)的解剖学(LLM + 工具 + harness),以及对 harness 本身做元优化。这一节阅读密度最高(11 篇):ADAS、AFlow、DSPy、OPRO、TextGrad、AlphaEvolve、STOP、Darwin Gödel Machine、Dream-RSI,从“优化 prompt”一路讲到“递归自我改进的 Agent”,紧跟 2025–2026 年最前沿。
另外有两讲比较“出人意料”但很符合 Lam 组的气质:VLM 转录历史手稿(CHURRO,与历史学者合作)和训练 LLM(指令跟随模型与训练数据)。
项目:这门课真正的主角(占 65%)
•两人一组,整季度进行,每周与导师(Stanford 或外部合作机构)见面,写作强度对标一篇小型研究论文(建议 ACL 格式)。
•明确的硬门槛:项目不能是“拿原生 LLM 直接 prompt 问题陈述”就做出来的东西,必须用上形式化方法、检索、知识推理等课程技术。
•提供开源平台 AOS(Agentic OS):模型无关、带语义文件系统,其上的组件(CHURRO、SLIDERS、GRILL、DataSTORM、Genie Worksheets、VERDICT)既是学生的工具箱,也是可改进的研究对象。
•选题沿两条轴:领域驱动(如医疗,以 OpenEvidence 在 MedXpertQA 上 44% 的准确率为靶子,覆盖知识策展、数据驱动发现、临床指南、EHR 问答)或技术驱动(改进 AOS 组件)。2026 秋季的导师提案高度集中于医学遗传学:OMIM 风格数据库的规模化策展、罕见疾病的文献溯源写作、基因组测序诊断(突破约 30% 的确诊率)、三阴性乳腺癌的 RNA-Seq 基因优先级等。
•成果记录很有说服力:课程产出的论文启发了 OpenAI、Gemini、Databricks 的商业 Deep Research 产品;WWKnowledge.org 的试点覆盖了超过 80 万用户。WikiChat、SUQL、SPINACH、Genie Worksheets、DataSTORM、VERDICT 等均发表在 EMNLP/ACL/NAACL/COLM 等主流会议。
组织与考核
•周一/周三上课,出勤强制;先修课要求 NLP 基础(CS 224N 等任一);名额限制以保证项目指导质量。
•成绩:参与 15% + 作业 20% + 期末项目 65%,权重结构明白地告诉你这是一门 research apprenticeship(研究训练营),讲课只是脚手架。
•日程设计也围绕项目节奏:期中前后安排学生 pitch 和提案答辩,期末 60 种快讲 + 海报展 + 论文。
这门课有什么特别之处?
CS224V 最值得注意的一点,是它在 2026 年“Agent 淘金热”的语境下选择了一条逆潮流的路线:业界普遍靠规模、对齐训练和端到端强化学习赌“涌现可靠性”,而这门课的哲学是系统工程 + 形式化约束,把 LLM 当作一个强大的但不守规矩的语言/推理部件,用检索做接地(grounding)、用查询语言和声明式规约做约束、用定理证明器做担保、用严格的评估做裁判。课程页面引用的系统(SPINACH 部署于 Wikimedia、WWKnowledge 服务 80 万用户、临床部署的 VERDICT)说明这条路线不只是论文美学,也经得起真实场景检验。
从阅读清单的结构还能看出它的教学观:必读篇目(约 12 篇)几乎全部是 Lam 组自己的系统论文,外围阅读则广纳全领域(从 ColBERT 到 AlphaEvolve),且把“LLM 评估”单独列为一个完整章节,这门课教的不只是“怎么造 Agent”,更是“怎么知道你造的 Agent 值得信任”。
适合谁:有扎实 NLP 基础、想在一个真实研究生态(而非玩具环境)里做一整季度 agent 研究的人;对“神经符号 + 可追责 AI + 医疗落地”这条路线感兴趣的人会尤其如鱼得水。不适合谁:想学“三天搭出一个 Agent”的工程速成者,课程的 65% 是研究项目,且明确排斥纯 prompt 工程。


