
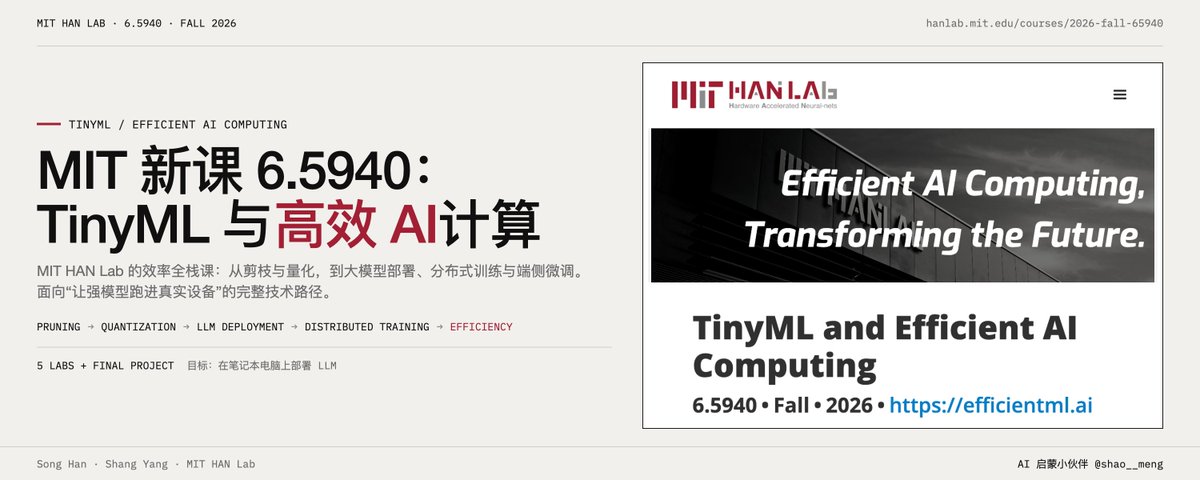
MIT 新课 6.5940 TinyML 与高效 AI 计算(MIT HAN Lab):从剪枝量化到大模型部署与分布式训练的效率全栈课
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
MIT 6.5940 TinyML and Efficient AI Computing
MIT 韩松(Song Han @songhan_mit)实验室开设的高效机器学习旗舰课程,回答一个在当下 AI 工业化进程中至关重要的问题:当深度神经网络需要“极高量级的计算”(extraordinary levels of computation)时,如何让它跑得动、跑得快、跑得起,从微控制器上的毫瓦级推理,到笔记本上的大语言模型部署。课程官网 efficientml.ai,所有讲座视频公开直播/回放(live.efficientml.ai),是全球高效 AI 方向事实上的标准公开课。
现在课程前 6 讲课件和视频都已公开!
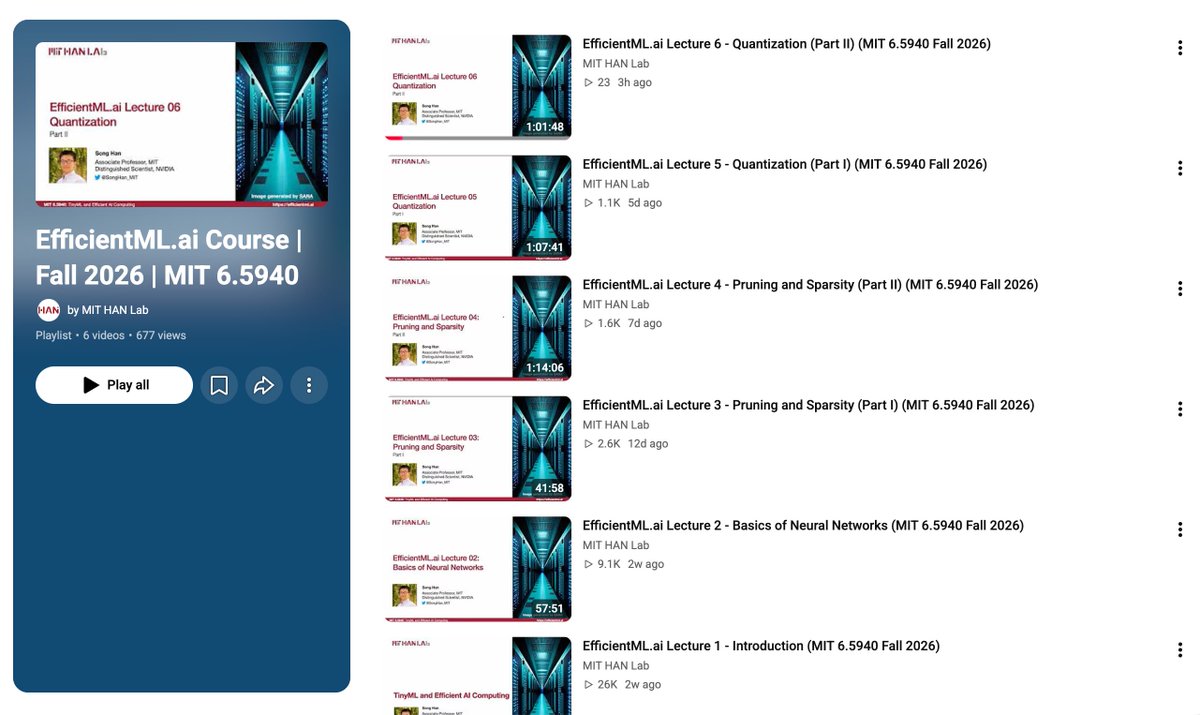
课程主页:https://hanlab.mit.edu/courses/2026-fall-65940
视频列表:https://www.youtube.com/playlist?list=PLH7PIPKvCm38
课程背景与授课团队
主讲教师 Song Han 是 MIT 电子工程与计算机科学系副教授,是模型压缩领域最具影响力的研究者之一,深度压缩(Deep Compression)、AMC、Once-for-All、MCUNet、SmoothQuant、AWQ 等一系列被工业界广泛采用的效率技术均出自其团队。这门课的独特之处在于:它不是综述别家的研究,是把 HAN Lab 自己开辟的研究脉络系统化成了一门课。联合主讲 Shang Yang 为博士生,助教团队(Jiaming Tang、Zhuoyang Zhang 等)也多为该实验室的研究者,因此课程内容与研究前沿几乎零时差。
课程结构:四章递进的完整知识体系
课程按日程清晰地分为四个篇章,逻辑上构成“从推理到训练、从通用到专用”的递进:
第一章:高效推理(Efficient Inference,9 月中–10 月中) 这是课程的地基,覆盖三大经典压缩技术:剪枝(Pruning and Sparsity,两讲)、量化(Quantization,两讲)、知识蒸馏(Knowledge Distillation),外加神经架构搜索(NAS)两讲。这条线索对应的是“如何把一个已经训练好的模型变小、变快”的问题。值得注意的是量化和 NAS 各占两讲、且各配一个 Lab,量化是当前 LLM 部署最核心的技术,这种权重分配直接反映了研究界的现实关切。
第二章:面向特定领域的优化(Domain-Specific Optimization,10 月下旬–11 月) 从通用压缩技术转向具体平台与模型形态:MCUNet 与 TinyEngine(在 Arduino 级微控制器上跑深度学习,这是韩松团队的代表作)、Transformer 与 LLM 的效率(Lec12)、LLM 量化与部署(Lec13)、LLM Post-Training(Lec14)、长上下文 LLM(Lec15)、Vision Transformer 与扩散模型(各两讲)。这一章基本就是“当前最热门模型形态 × 效率”的矩阵,LLM 占四讲、扩散模型占两讲,可见课程每年都在跟随前沿动态调整。
第三章:高效训练(Efficient Training,11 月中–下旬) 视角从推理切换到训练成本:分布式训练两讲(数据并行、模型并行、梯度压缩等)、设备端训练与迁移学习。这回应的是训练成本问题,大模型时代训练一次动辄百万美元级,如何省。
第四章:进阶专题(Advanced Topics,11 月底–12 月) 包含嘉宾讲座,随后进入期末项目展示(12 月 3、8、10 日三天)。
教学设计:以动手为中心,无考试
这是这门课最鲜明的工程设计,评分完全由两部分构成:
-
5 个 Lab:GPU Basics(CUDA 与 GPU 编程基础)、两次 Quantization、NAS、以及最后的在笔记本上部署 LLM。这条 Lab 链条本身就是一个微缩的课程叙事,从底层硬件编程到最前沿的 LLM 本地化部署,层层递进。最后一个 Lab 尤其能说明课程定位:学生结课时亲手在自己笔记本上跑起一个量化后的大语言模型,这是绝大多数 ML 课程不会触碰的工程能力。
-
期末项目:小组制,含 proposal、海报展示和 4 页 NeurIPS 模板的报告。也就是说,课程把学生当作准研究者来训练,项目产出直接对接论文写作规范。
配套政策也体现了对独立工程能力的强调:Lab 允许讨论但须独立提交并注明合作者;全学期共 6 天免罚迟交额度(自主调配),超出后每天扣 50%、两天后记零;须至少完成 4/5 个 Lab 方可通过。无期末考试,这在 MIT 的硬核课程里并不多见,与“效率研究是一门实验科学”的学科气质一致。
先修要求与适合人群
先修课程为 6.191(Computation Structures,计算机体系结构基础) 和 6.390(Intro to Machine Learning),且不接受先修豁免,本学期也不接受跨校注册。这个组合非常精确地划出了课程的能力象限:既要有硬件/系统思维(懂计算结构、存储层次、并行),又要有机器学习基础(懂训练与反向传播)。这门课的本质是“算法—系统协同设计”(algorithm-hardware co-design),两个方向缺任何一半都会很吃力。事实上,高效深度学习恰恰是介于传统 ML 与系统研究之间的交叉学科,这门课的先修要求就是这种交叉性的直接体现。
如何使用这门课的公开资源
即使不在 MIT,这门课也几乎是该方向最好的自学材料:
-
讲座视频:实时直播于 live.efficientml.ai,往期视频全部在 YouTube 的 MITHANLab 频道公开;前几讲的幻灯片也直接提供下载。
-
Lab 可复现:课程 Lab 基于公开框架(往届基于 PyTorch + TVM 等),代码与教程在 mit-han-lab 的 GitHub 上可用,是极好的动手练习。
-
往届版本:2024/2023 Fall(6.5940)、2022 Fall(6.S965)的完整存档都在线,内容主线稳定(压缩三件套 → TinyML → LLM 效率 → 分布式训练),每年主要是第二章随前沿更新。
我的整体感受
客观地说,这门课的价值在于三点。第一,知识体系的完整性:它把“效率”这个看似零散的工程话题组织成了从剪枝/量化/蒸馏的经典基础,到 LLM 量化、长上下文、扩散模型加速的前沿应用,再到分布式训练的系统层面的完整闭环,市面上没有任何一门课或一本书有同等跨度。第二,与研究前沿的零距离:讲授的内容大量就是授课团队自己的论文,学生实际上是在被原始作者直接教授这些技术。第三,动手导向的诚实性:5 个 Lab 直落到底层(GPU 编程、量化实现、本地 LLM 部署),无考试、以研究项目收尾,明确地把目标定位为培养能做效率研究的工程师和研究者,而非只会调用 API 的使用者。
对想要系统学习模型压缩、LLM 推理优化或 TinyML 的人来说,这门课(配合公开视频与 Lab)是我能给出的最直接推荐;对在校生而言,它也是进入 HAN Lab 及整个高效计算研究圈的一条标准路径。


