
UC Berkeley 2026 秋季课程「可扩展大模型 AI」:贯通理论与实践,从架构、预训练到推理的全栈工程
文章目录
UC Berkeley《Scalable AI》课程
Berkeley EECS 在 2026 年秋季开设的一门研究生/高年级课程(EE 290 / 194),由 Anant Sahai 和焦剑涛两位教授联合授课,NVIDIA 提供算力与工程支持。它的核心立场是:把大模型当作一个端到端的工程对象来教,从芯片 roofline 一路讲到部署护栏,而不把 AI 拆成“算法课”和“系统课”两半。
https://scalable-ai.eecs.berkeley.edu/F2026
课程的基本定位
课程副标题是 "Bridging Theory, Understanding, and Practice"(贯通理论、理解与实践),但它真正的鲜明态度体现在开篇之问:“如何把大规模 AI 系统当作全栈工程制品来构建、训练和部署”,其中模型行为是由硬件约束、软件栈和优化动力学共同决定的。
这句话值得展开:传统 ML 课程把模型视为数学对象(损失函数、泛化界),系统课程把硬件视为性能对象(带宽、时钟周期),而这门课的出发点是承认 2026 年的实际情况,一个 LLM 的能力边界,往往不是由算法论文决定的,是由“你在什么硬件上、用什么并行策略、喂了什么数据、推理框架怎么调度 KV cache”这一整套工程链条决定的。模型在课程中被定义为一个“计算图”,它要在硬件、数据和服务经济学的硬约束下被训练、特化、评测、部署、监控和迭代。
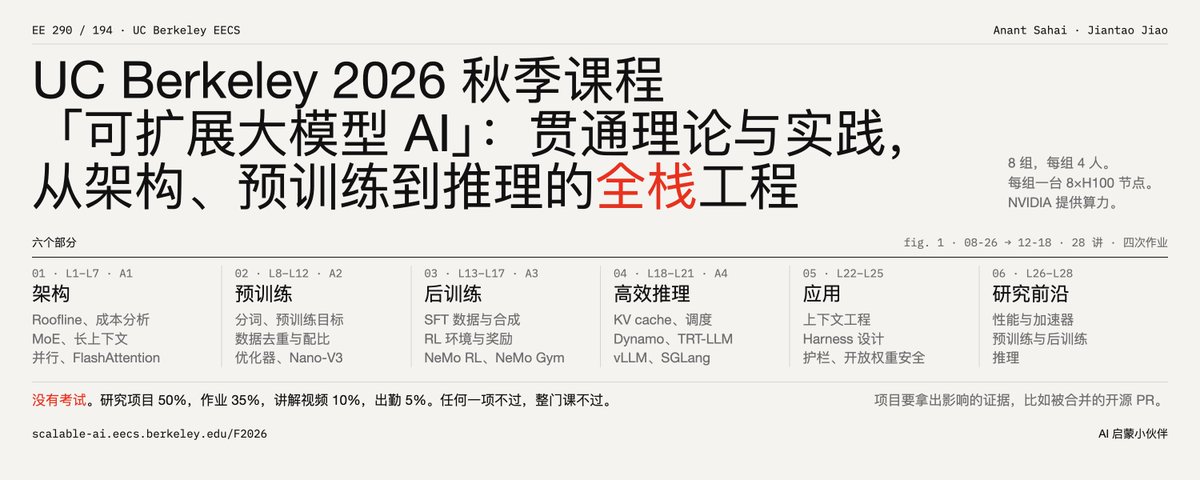
课程的生命线是六个阶段,恰好构成教学主线:
架构 → 预训练 → 后训练 → 高效推理 → 应用 → 研究前沿
教学结构逐段展开
第一部分:架构(8/26–9/21)从性能工程切入而非从 Transformer 结构切入,这是这门课最反传统的地方。第 2–3 讲直接讲 roofline 模型和 matmul 的“经济学”,也就是先把“GPU 上什么算子能跑满、什么注定受限于内存带宽”这层物理直觉建立起来,之后才讲 MoE、稀疏与长上下文架构(L4)、并行策略(L5)、FlashAttention 与 Sonic MoE(L6)。逻辑是:架构创新本质上是绕开硬件瓶颈的手段,不懂瓶颈就谈不上理解架构为什么长成这样。
第二部分:预训练(9/23–10/7)讲 tokenization、数据治理(NeMo Curator)、现代优化器(AdamW 及其调度与裁剪),并以 NVIDIA Nano-V3 的预训练全过程作为案例收尾。用一个真实的、工业界的完整预训练 run 作解剖标本,这在学术课程里相当少见。
第三部分:后训练(10/12–10/26)覆盖 SFT 与 RL 的完整生命周期:SFT 数据工程、RL 环境构建、NeMo Data Designer 和 NeMo RL/Gym 工具链,同样以 Nemotron-NanoV3 的后训练为案例。注意这里的重心是“数据工程”而非“算法”——课程明显认为后训练的瓶颈在数据与环境,不在 loss 函数。
第四部分:高效推理(10/28–11/9)KV cache、批处理、吞吐/延迟权衡,并横向对比四大推理引擎:Dynamo、TensorRT-LLM、vLLM、SGLang,还有一讲来自 xAI 的 Grok LPX。这一段基本是生产级 serving 的实战课。
第五部分:应用(11/16–11/30)Context engineering、harness 设计,以及两讲安全:部署护栏(Guardrails、Garak 红队工具)和开放权重的安全性。
第六部分:研究前沿(12 月)分别在加速器、预训练/后训练、推理三个方向讨论开放问题,同时学生的研究项目进入汇报期。
一个观察:课程的三分之二篇幅在“训练之外的工程”(架构、推理、应用占四段),这与“LLM 课程=讲论文”的旧范式形成了鲜明对照,也反映了行业重心向 inference 和 post-training 迁移的现状。
考核体系:这是一门“做真研究”的课
成绩构成没有任何笔试:研究项目 50% + 四次大作业 35% + 讲解视频 10% + 出勤参与 5%。
几个设计非常值得注意:
1.研究项目占半壁江山,且“外部影响力”明码标价。技术质量占 40%(假设清晰度、深度、正确性、严谨性、交付物质量),外部影响占 10%,要求“对社区有用的证据”,例如被合并的开源 PR、可复现的 benchmark、公开报告或 arXiv 预印本,最终需提交一份“影响力证明文档”(12 月 18 日)。这实际上是要求学生做一次微型开源研究创业,而不是交一份只给教授看的 PDF。
2.作业采用口头验收(oral checkoff),三到四周一个周期,紧贴教学段落:性能工程 → 预训练 → 后训练 → 推理与服务。每组只有 3 天 slack,每次作业最多用 1 天。口头验收意味着无法靠复制粘贴通过,你必须能当场解释自己的代码。
3.“任何一项不及格则整门课不及格”,这是一个强信号:课程不允许学生在任何环节(尤其是那 5% 的出勤)搭便车,也暗示它预期的学生是全情投入的。
4.讲解视频(10%)是个精巧的设计:每个学生独自在白板前录制一段视频,把课程里某个概念讲到超过课堂的深度,明确要求“比课堂更深,而不是复述课堂”。这本质上是强制性的费曼学习法,同时为课程沉淀一批可复用的教学素材。
资源与产业绑定
算力由 NVIDIA 赞助:8 支队伍(每队 4 人),每队一个 H100 节点(8×H100,部署在 GCP 上)。在 2026 年的算力市场环境下,这个配置对课程能否“真做”至关重要——预训练和推理优化作业没有真实 GPU 密度就只能是纸上谈兵。
工具清单几乎是一部 NVIDIA NeMo 生态目录(AutoModel、Curator、Data Designer、RL、Gym、Guardrails),外加主流开源推理引擎。这一点需要客观看待:好处是学生学到的都是工业界当下真实在用的工具链,且有一线工程师(Venkat Srinivasan)参与基础设施支持;代价是课程视角不可避免地带有单一厂商的工程范式,比如推理引擎对比虽然覆盖了 vLLM、SGLang 等非 NVIDIA 项目,但预训练/后训练的案例研究(Nano-V3、Nemotron)全部落在 NVIDIA 的模型谱系上。对想进大厂 infra 岗位的学生这是资产,对想要厂商中立视角的人则需要自己补齐。
阅读清单透露的品味
书单短而精,且能看出编者的价值取向:
•《The Bitter Lesson》(Sutton)和《The Hardware Lottery》(Hooker)作为开篇,前者主张“利用算力的通用方法终将胜过精巧的领域知识”,后者讲“研究议程被当下硬件偶然锁定的历史”,这两篇合起来基本就是这门课的世界观声明。
•Chinchilla(算力-数据最优配比)、DeepSeek-V3 技术报告(当 代开源预训练的标杆工程文档)、JAX Scaling Book / Ultra-Scale Playbook(大规模并行训练实操)、Megatron-LM / ZeRO / FlashAttention 1&2(并行与显存优化的三块基石)。
•值得注意的是还有一些非常“工匠气”的材料:Tensor Cores matmul 教程、GPU 性能工程资源、PP 调度可视化器,这些通常不会出现在任何 ML 课纲里,但对真正要写高性能代码的人是最值钱的部分。
这门课适合谁
适合的人:目标是 LLM infra、系统 ML(MLSys)、推理引擎、或打算创办 AI 基础设施相关初创的学生;以及任何想从“会调 API / 会读论文”跃迁到“理解整个技术栈为何如此演化”的研究者。入学前提页面未列硬性先修课,但从内容密度看,扎实的线性代数、体系结构直觉和 PyTorch 工程能力是事实上的门槛。
在更大的图景中:这门课代表了 2026 年顶级大学对“AI 教育”的一次重新定位,承认大模型的知识主体已经从会议论文转移到了工程实践、厂商工具链和开源社区,于是干脆把课程组织成“沿着真实模型的生命周期走一遍”,用真 H100、真预训练案例、真推理引擎来教。Berkeley 之前已有 ICOOL/LLM 系统课的探索,这门由两位分别以信息论/系统和统计闻名的教授(Sahai 与焦剑涛)联手、深度绑定 NVIDIA 的课程,可以视为这一路线的成熟形态。
一个保持清醒的注脚:它的价值恰恰建立在“追逐当下”之上,工具链、案例模型、引擎格局在两三年内可能大换血。这门教给学生的真正长期资产,不是 NeMo 或 vLLM 的用法,是第一部分建立的那套思维框架:把任何模型放回它的硬件约束与经济学里去理解。这也是为什么书单要以《The Hardware Lottery》压轴开场。


