
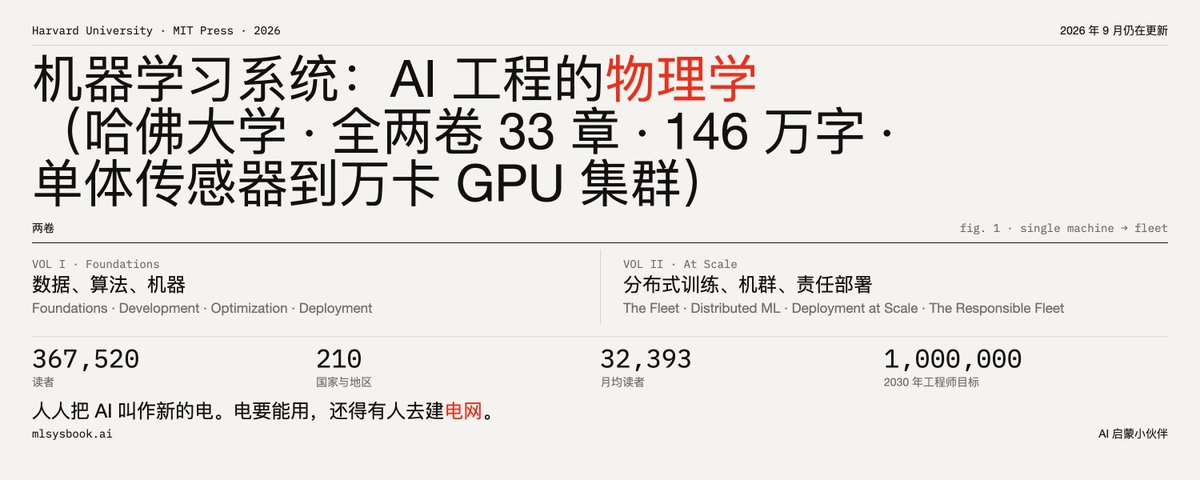
机器学习系统:AI 工程的物理学(哈佛大学 · 全两卷 33 章 · 146 万字 · 单体传感器到万卡 GPU 集群)
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
哈佛大学「Machine Learning Systems」
Harvard / Vijay Janapa Reddi · MIT Press 2026 · 开源教材(CC-BY-NC-SA)· mlsysbook.ai 副标题:The Physics of AI Engineering(AI 工程的物理学)
这是一本什么书
一句话定位:它想为 ML 系统工程做 Hennessy & Patterson 的《计算机体系结构:量化研究方法》为计算机体系结构做过的事,把一个靠直觉和经验驱动的领域,变成一门有定量定律、可教可学的工程学科。
这不是一句修辞。序言正是 David Patterson(图灵奖得主、量化体系分析方法的开创者)写的,他明确把两书相提并论。作者 Vijay Janapa Reddi 是哈佛教授,这本书脱胎于他的课程 CS249r 和 TinyML edX 项目。作者自述里那句话是全书的题眼:
"The world is rushing to build AI systems; it is not yet engineering them."(世界在争先恐后地建造 AI 系统,但还没有在工程它们。)
作者的核心判断是:过去十年 ML 研究被 model-centric 思维主导,但 model is not a system,一个在研究笔记本里表现良好的神经网络,如果满足不了延迟约束、数据管线扛不住流量、能耗超过经济价值,就一无是处。从"能跑的模型"到"能用的系统"之间的距离,不是实现细节,而是缺失的工程原理。他把这称为 ML 的"Garmisch 时刻"(1968 年 NATO 会议催生软件工程学科的那个时刻)。
书中给出三句话的学科定位,非常清晰:
•计算机科学研究什么是可计算的;
•机器学习研究什么是可学习的;
•AI 工程研究什么是可建造的,在真实硬件与真实数据的物理约束之下。
全书两卷、33 章,从单个芯片讲到万卡集群,从微瓦级传感器讲到兆瓦级数据中心。配套生态包括 TinyTorch(从零构建 ML 框架的 20 个模块)、交互式 Labs、硬件套件和 StaffML 练习平台,这反映了作者的另一个信念:理解系统的唯一方式是动手构建。
书籍对应的开源项目:
[未转换内容,参见原始 JSON]
全书的"物理学":几个贯穿始终的定律
这本书最独特之处,是它真的像物理教材一样,用少数几条定量定律组织全部内容。
1. The Iron Law of ML Systems
[未转换内容,参见原始 JSON]
任何 ML 工作负载的耗时都分解为三项:数据搬运(数据量除以带宽)、计算(操作数除以峰值算力与硬件效率)、延迟开销(调度、排队、同步等)。第二卷把它推广为分布式形式的 Fleet Law:
[未转换内容,参见原始 JSON]
加 GPU 线性削减计算项,但通信和同步项随 N 增长,这就是"1 万块 GPU 得不到 1 万倍速度"的全部数学。两卷的所有章节本质上都在教你怎么诊断自己当前被哪一项"绑定"(binding constraint),然后针对性地移动它。
2. 屋顶线模型(Roofline)与内存墙
[未转换内容,参见原始 JSON]
这条来自 H&P 传统的模型在书中反复出现,因为它揭示了当代 ML 最残酷的物理事实:算力增长远快于带宽增长(H100 的脊点已到约 295 FLOP/byte)。算力每 2–3 年数量级提升,DRAM 带宽十年只涨了个位数倍。后果是:LLM 的 decode 阶段每生成一个 token 需要搬运全部权重,算术强度只有约 1 FLOP/byte,比脊点低两个数量级,tensor core 99% 的周期在等数据。加算力对此毫无帮助,唯有加带宽或减少搬运。
3. 能耗阶梯(Horowitz 数据)
45nm 工艺下:INT8 加法 0.03 pJ,FP32 乘法 3.7 pJ,SRAM 访问 0.5 pJ(每字节),DRAM 访问 640 pJ。一次 DRAM 访问的能量约等于十万次 INT8 加法。这解释了全书一系列工程选择的共同根源:kernel fusion、FlashAttention、systolic array、2:4 稀疏,它们都不是"更快地算",而是"干脆不搬"。作者反复强调:当代 ML 芯片的能耗和延迟由数据移动主导,而非计算。
4. Amdahl 定律与"开销只能转移"
加速比上限由串行部分封顶。预处理占 45% 延迟的系统里,模型提速 10 倍只换来端到端 1.8 倍。作者由此提炼出全书的元原则(他称之为复杂度守恒启发式):开销无法被消灭,只能被转移,量化把成本转移到精度验证,分布式把内存压力转移到通信量,自动化把人力转移到维护。好工程师不是消除开销的人,而是清楚知道每一笔开销被转移到了哪里、并保证它落在有人测量的地方的人。
5. 漂移方程
[未转换内容,参见原始 JSON]
部署后精度随分布散度衰减。这是第一卷第 14 章"week-two problem"(模型第 1 周 94% 精度、第 4 周跌到 88%,而所有基础设施指标全绿,"perfectly available and perfectly wrong")的数学化,也是全书强调 ML 系统会静默失败的理论根据。
6. 两大分类法
•D·A·M(第一卷,单机):Data(燃料)× Algorithm(蓝图)× Machine(引擎)。任何问题都可沿三轴诊断,且瓶颈会在轴间迁移。
•C³(第二卷,集群):Compute × Communication × Coordination。Llama 这类前沿模型先绑定 Communication,推荐系统先绑定 Coordination,联邦学习先绑定 Compute,同一套集群理论,三种绑定顺序,工程师的功夫在于"读出"而不是假设。
第一卷《导论》:单节点上的一切
第一卷围绕单机(1–8 卡)讲完整的 ML 系统栈,四部分结构:
基础篇(1–4 章)。导论确立"双重使命":模型行为统计上可信 + 机器能在时间/内存/能量预算内产出该行为。第 2 章是全书空间观的核心:约束决定架构。光速(跨美往返 36ms 起步)、功耗墙(P ∝ V²f,倍频≈8 倍功耗)、内存墙三堵物理墙把部署世界切成 Cloud/Edge/Mobile/TinyML 四个范式,功率跨越约 9 个数量级(MW 到 mW)。同一模型在四个范式下需要的是根本不同的工程,而不是缩放。第 3 章用糖尿病视网膜病变筛查的案例讲透"lab-to-field gap":实验室 AUC 0.99 的模型,在泰国诊所因老相机和光线问题灵敏度跌到 78%,失败不是模型失败,是 workflow 失败。第 4 章提出"Data is code":数据集是被编译的源代码,改数据就是改程序逻辑,所以数据必须像代码一样被版本化、测试、审查。
开发篇(5–8 章)。这一部分把"神经网络是可核算的"贯彻到底:全连接层的 MAC 数就是输入维×输出维;backward 是 forward 的 2 倍,一个训练 step ≈ 3× forward FLOPs;训练内存 = 权重 + 梯度 + 优化器状态 + 激活四分量(Adam 下仅优化器状态就 16 字节/参数,175B 模型训练态约 2.8TB,这是一切分布式内存优化的起点)。架构章的系统视角很有教益:五大"灯塔模型"各自钉死一种资源约束(ResNet-50=算力、GPT-2=带宽、DLRM=内存容量、MobileNetV2=延迟功耗、KWS=毫瓦功耗),并且指出 FLOPs ≠ 速度——比 ResNet-50 少 10 倍 FLOPs 的 MobileNetV2 在带宽受限硬件上可能更慢。框架章把框架定义为"针对硅契约的编译器",用编译净收益公式回答"什么时候值得用 torch.compile"。训练章的纪律性最强:先内存可行、再吞吐、先喂饱数据管线再调 kernel,"饥饿的加速器看起来就像低效的加速器"。
优化篇(9–12 章)。数据选择章提出 ICR(信息-算力比):在固定算力下,选对数据比堆数据收益高,EL2N 评分可以删掉一半 CIFAR-10 训练集而不损精度。压缩章的"复杂度守恒"很有启发性:剪枝花容量、量化花精度、蒸馏花算力,"硬件设定汇率";且压缩技术是组合优化问题而非独立函数,剪枝改变幸存权重分布会破坏量化校准,正确顺序是结构剪枝→蒸馏恢复→QAT 锁定。硬件章是全书物理浓度最高的一章:TPU 的 systolic array(权重驻留、每个数据进阵列被所有单元复用,访存次数从每操作 4 次降到 2/N 次)讲得非常透彻。基准章引入 MLPerf 体系并给出三条测量纪律:基准是代理而非真理、Goodhart 定律(指标成为目标就不再是好指标)、端到端胜过组件指标。
部署篇(13–15 章)。服务章讲"serving inversion":训练最大化吞吐,服务必须在延迟 SLO 内回答单个请求,瓶颈从计算转移到搬运、排队与调度。排队论在此落地:利用率 ρ=0.7 时延迟已达均值 3.3 倍,p99 是均值的 4.6 倍,容量规划必须留余量,高利用率本身是危险信号。LLM 服务的技术核心(continuous batching、PagedAttention 把 KV cache 浪费从 60–80% 压到 4% 以下、推测解码)都有定量讲解。MLOps 章以静默失败为核心,给出重训经济学(最优重训间隔 T* ∝ √(C/QVγ))、PSI/KS 漂移检测、canary/A/B 的统计功效计算。负责任工程章的立场很工程化:MLOps 是可靠性的控制回路,负责任工程是安全性的控制回路,系统可以通过 verification(符合训练目标)却通不过 validation(违反运营/法律要求),因为规约本身不完整;公平性不是调参问题而是数学上的多目标约束(Kleinberg/Chouldechova 不可能定理:基率不同时,校准与错误率均衡不可兼得)。
第二卷《规模化》:集群即计算机
第二卷的立场在开篇就锋利地立起来:单机的三个经典约束在集群尺度演化为"三堵墙"(内存墙、带宽墙、能耗墙)外加一条鸿沟:可靠性鸿沟。锚点数据是 Llama 3 的 war story:16,384 块 H100、54 天连续训练、419 次中断(约每 3 小时一次),仍维持 90% 以上有效训练时间。规模把故障从例外变成常态,把调度从便利变成产能本身。
集群篇(2–4 章)把数据中心讲成"组装物理计算机":带宽层级(片内 3.3TB/s → NVLink 900GB/s → PCIe 64GB/s → IB 50GB/s)中 NVLink 与 IB 之间约 9 倍的悬崖,正是张量并行不出节点的物理原因;网络的本质是"梯度总线"(为 AllReduce、AllToAll、P2P 三种集体通信模式服务);存储被 ML 反转了全部假设,checkpoint 每 10 分钟写 2.45TB,朴素数据并行会产生"checkpoint 风暴"(64 副本 ≈157TB),ZeRO 分片加分层暂存把它压到 25 秒以内。
分布式训练篇(5–7 章)是理论核心。3D 并行立方体 N = d×p×t(数据×流水线×张量)配有编译器心智模型:DP=并行 for、TP=SIMD 向量化、PP=指令流水线。各策略的通信指纹决定了放置规则(TP 进节点、PP 进机架、DP 跨集群)。集合通信章用 α-β 模型和能耗阶梯(SRAM 0.5 pJ/bit 到光 IB 1000 pJ/bit,2000 倍差距)讲透 Ring/Tree/Butterfly AllReduce 的算法选 zoo,以及"每个字节都有旅行成本"的世界观。容错章的 Young-Daly 定律(最优 checkpoint 间隔 τ* = √(2·T_write·MTBF))是全卷最美的结果之一,它是期望值最优解,而生产中真正的合同是 RPO/RTO。
部署与责任篇(9–16 章)。推理章给出全书最重要的经济学事实:推荐系统推理/训练成本比可达 100–1000 倍,服务才是生命周期成本的大头,因此"serving 反转了训练的一切假设"。边缘章回到第一卷的物理传统:GB/s 而非 TOPS 才是选型指标(LPDDR5X 与 H100 带宽差 30–50 倍)。可持续 AI 章立场鲜明:能耗是物理上限而非环境情怀,并给出完整的碳核算体系(PUE、电网碳强度选址差异 8–40 倍、embodied carbon、AI 版 Jevons 悖论,效率提升必须配绝对碳预算,否则被需求增长吞噬)。负责任 AI 章把治理写成工程:6 类版本化工件(Claim/Argument/Evidence/Assumptions/Owner/Invalidation rule)的 assurance lifecycle,把"合规"变成了可审计的软件工程。
这本书真正教的是什么
把 33 章读完后会发现,具体技术(NCCL 环境变量、TensorRT tactic、K8s operator)都只是例题。全书真正反复锤炼的是一种诊断纪律,两卷结论章各自收敛到同一句话:
找到当前绑定的约束,量化它施加的成本,并设计运营路径使该约束保持可见,而不被转移到另一层。
支撑这个方法论的是几个反复出现的世界观:
1.约束驱动而非目标驱动。先问"什么在绑定",再动手优化。加算力解决不了带宽受限的问题(LLM decode),加批次解决不了延迟受限的问题(p99)。
2.一切皆有价格。混合精度用数值风险换吞吐,checkpointing 用 33% 重算换 71% 激活内存,DP-SGD 用 2–5 倍计算换隐私保证,公平准则之间互斥需要显式选边。工程不是找最优解,是在 Pareto 前沿上有意识地选点并能辩护。
3.静默失败是默认模式。ML 系统不崩溃,只是悄悄变差,精度随分布漂移衰减、特征训练/服务两套实现必然分叉、HTTP 200 但特征已过期。所以监控、漂移检测、可观测性不是运维附加项,而是系统本体。
4."The system is the model"。第一卷结论章的点题:真正的模型不是 500MB 的权重文件,而是数据管线 + 训练设施 + 服务系统 + 运维回路的总和。优化系统,模型才变好。
5.尾部即真相。p99 可以是均值的几十倍;100 分片扇出有 63% 概率撞上 1% 尾部;服务系统的容量规划、负载均衡、缓存设计全部由尾延迟支配。均值是给报表看的,分位数是给用户感受的。
每章末尾的 Fallacies and Pitfalls 是全书最有经验密度的部分(继承自 H&P 的体裁传统):约百条"谬误与陷阱",几乎每一条都对应一个昂贵的真实事故,Knight Capital 45 分钟亏 4.6 亿美元、Zillow 3.04 亿美元减记、OVH 数据中心火灾、Facebook "size zero" 文件、Uber Tempe 事故……这些案例让定律落地为教训。
这本书的独特之处
•稀缺的定位。市面上讲 ML 系统的书要么偏算法理论,要么偏工具操作(K8s/PyTorch 手册),要么是论文集。以"定量原理"为主线、从物理约束讲到治理义务的完整教材,目前没有第二本能与之对标。
•物理直觉极其扎实。能耗阶梯、带宽悬崖、roofline 脊点移动("rising ridge")这些内容在别处散落在几十篇论文里,这里被组织成连贯的因果链。读完再看 LLM 推理的种种优化(PagedAttention、推测解码、量化),会有"原来都是同一件事"的通透感。
•教学设计成熟。lighthouse models 作为"约束探针"贯穿两卷、D·A·M/C³ 两个分类法提供检索结构、Fallacies and Pitfalls 提供反例学习、配套 TinyTorch/Labs 提供动手回路。这是被真实课堂(CS249r)打磨过的教材,不是论文堆砌。
•负责任 AI 的处理方式。不 preachy,而是数学化(不可能定理)、经济化(公平税)、工程化(assurance lifecycle),把伦理变成可度量、可审计的约束,这可能是对从业者最有效的讲法。
谁该读、怎么读 ?
•ML 工程师/Infra 工程师:这是目前最体系的"补课"材料。作者给的 ML Engineer 路径是略读第一卷后精读框架、训练、硬件、基准、服务五章。
•算法研究员:第一卷的 2、5、11 章值得完整读,它解释了你的方法在真实硬件上会遇到什么。
•技术管理者/创业者:两卷的导论 + 结论章 + MLOps/可持续两章,约 6 章的量,足以建立正确的成本与风险直觉(推理:训练成本比、尾延迟、静默失败、碳预算)。
•学生:按顺序通读第一卷就是一门完整课程;TinyTorch 是配套的"从零造轮子"路径。
最后值得记住的是作者对 Sutton "Bitter Lesson" 的工程化转述:长期可持续的优势不属于最聪明的架构,而属于能把算力吸收掉的系统工程。这句话在两卷 33 章里被反复验证:从 AlexNet 的双卡模型并行,到 Llama 3 的 419 次中断后仍保持 90% 有效算力,AI 十年的历史中,真正拉开差距的从来是系统。


