
2018年的8G显卡跑未审查AI?太tm能了
文章目录
以为本地跑未审查AI,得先买张4090?早已经不是啦。
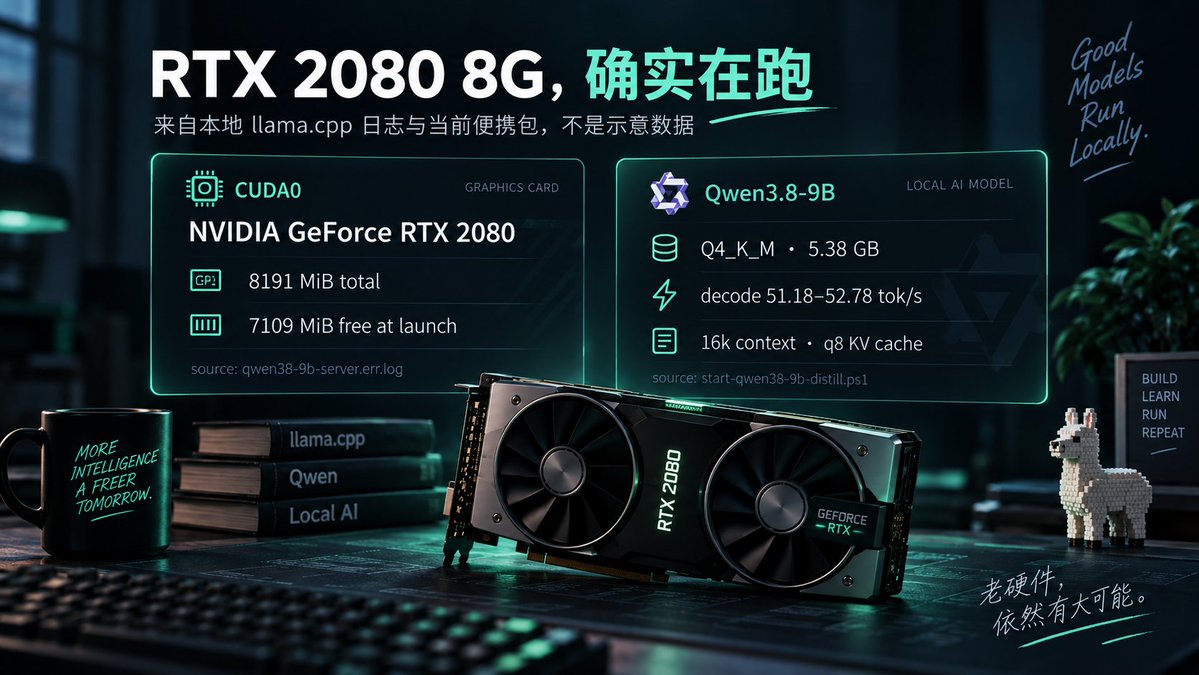
我手上这张是RTX2080,2018年的卡,显存8G,放到今天连入门都算不上。就这么一张卡,跑起来的模型脏话敢写、成人向场景敢写,一秒能吐几十个字,体感甚至不比我平时等不少云端API慢。门槛比我想的低太多。
先从我为什么去折腾27B说起
Qwen3.8刚出的时候,网上讨论清一色在聊27B参数的大杯版本。我也跟风下了三份27B的未审查GGUF,同时留了两份9B的做对照,加一份之前一直在用的3.6版本垫底,同一台机器、同一套问题,挨个起服务测。
测试方式很简单:起服务后拿同一批真实请求打过去——脏话吐槽、成人向场景、直接问"你有没有安全限制",记录能不能写出来、写得快不快。不听模型自己怎么介绍自己,只看它实际吐出来的字。
然后9B把我整懵了
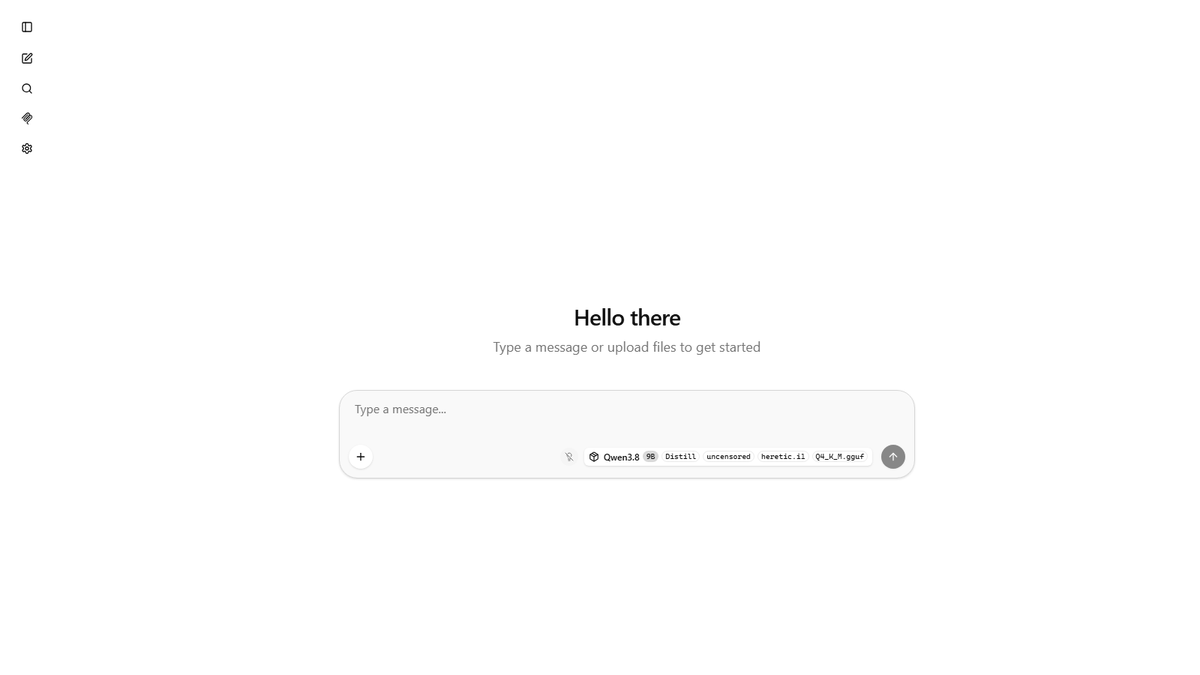
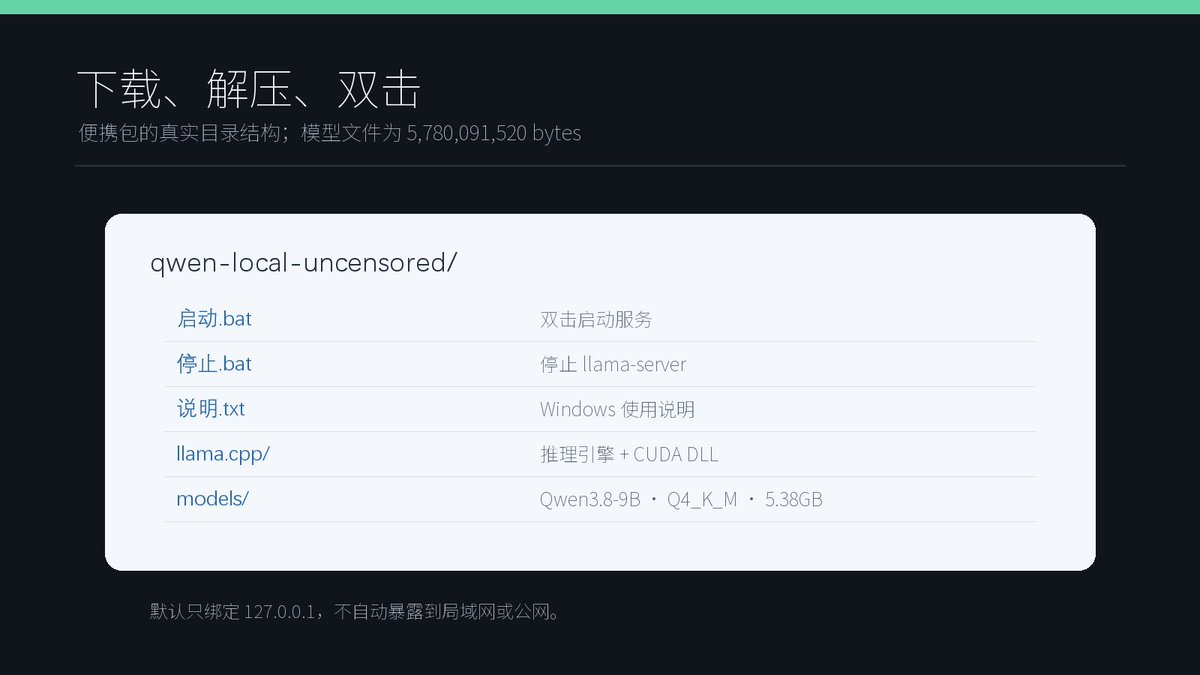
最后落地用的是Qwen3.8-9B-Distill-uncensored-heretic,Q4KM量化,模型文件只有5.38G,往显卡里一放,8G显存还能剩出一截。
效果是这样的:脏话请求直接写,成人向场景直接写,拿它写过一整篇NSFW小说,没有星号打码,也没有写两句就转去讲道德。速度大约50多tok/s,一段80token的短回答一秒多就写完,跟等云端接口返回的感觉差不多,不是那种一个字一个字往外挤的老式聊天机器人体验。
上下文给到16k,日常聊天、写点长文、来回几十轮对话完全够用。这不是"凑合能用"的水平,是真的可以当日常聊天工具用的水平:一张老显卡、一个llama.cpp、一个几GB的模型文件,跑通以后就能一直聊,不用租服务器,也没有什么月费。
再然后我发现,“未审查”这几个字也不能信
不过9B跑起来以后,我又发现了两个坑。
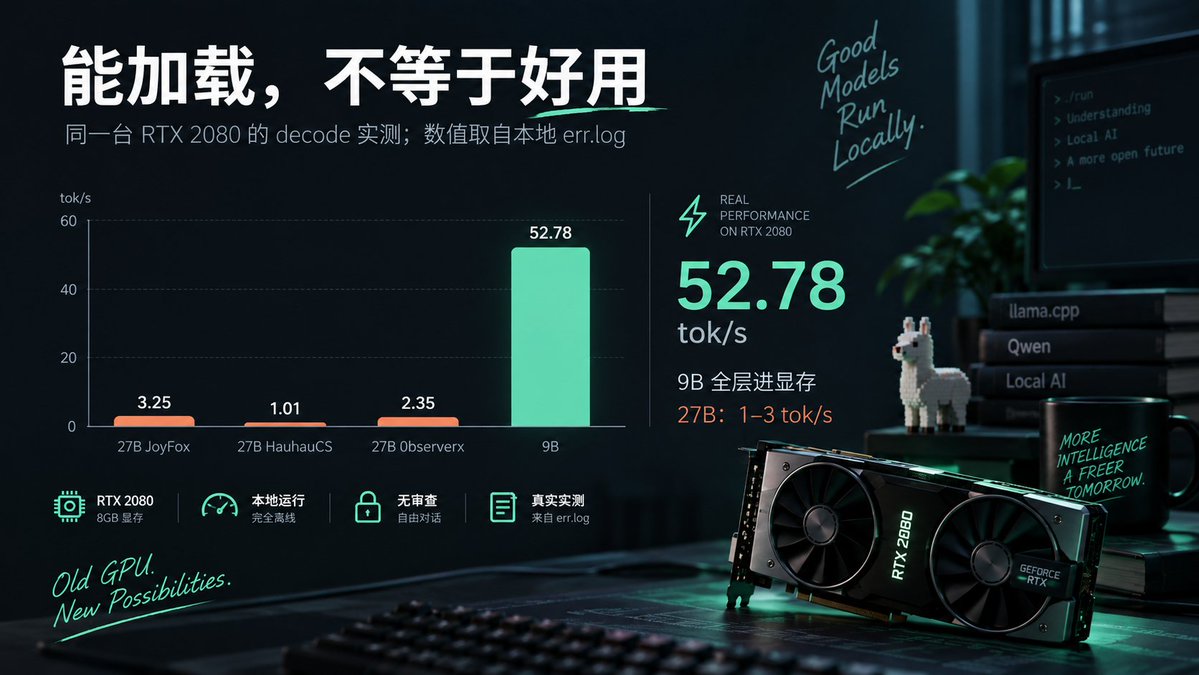
第一个坑是27B。三份27B未审查版本都能正常加载到8G显卡里,服务起来也没报错。但问它"有没有安全限制",三份全都回答"有";真拿脏话和成人向内容去试,写得磕磕绊绊,还得靠额外的提示词硬掰。同时速度只有1到3 tok/s——写一段短回答要等半分钟。
后来想明白也很简单:27B这么大,8G显存塞不下,大量东西只能丢到系统内存里,算一个token就得来回等。量化再狠,也绕不开这个物理瓶颈。
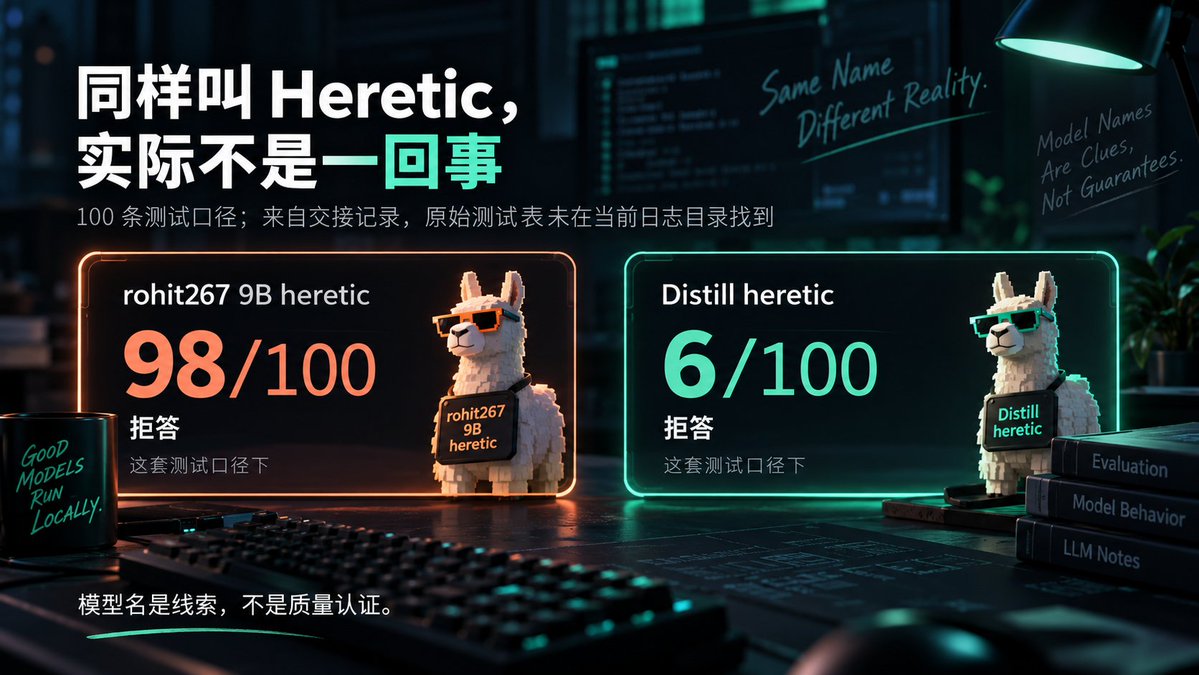
第二个坑更隐蔽:9B里也分真假。我后来翻到同一套测试口径的数据:第一份下的9B(rohit267那支)是98/100拒答,另一份Distill heretic只有6/100。
这不是整个模型的官方拒答率,只是那套100条测试里的结果。但差距已经够大了:同样打着未审查的名号,实际用起来完全不是一回事。
后来我算看明白了,Uncensored、Heretic、Aggressive这些词,看看就行。谁都能往名字里挂,不是什么认证。
同一个词能贴在完全没开的模型上,也能贴在真正开了的模型上。省事的办法就一个:不看名字,自己拿真实问题打一遍。
最后这事简单到什么程度
回过头看,真正花时间的不是"能不能跑起来",而是"到底该下哪一份模型"。至少聊天这件事,硬件门槛已经比我原来想象的低太多了。8G显存的老卡就能玩得很舒服,真没必要为了这件事先去升级显卡。跑起来以后,日常聊天、写点东西,9B这个尺寸速度快、内容也放得开,完全够用,压根不需要盯着参数量往大了追。
我这次最后发现,真正浪费时间的根本不是显卡。
是选模型。
27B我折腾了半天,跑出来一秒两三个token;最后真正留在机器上的,是一个5.38G的9B。
2018年的RTX2080,50多tok/s。
所以现在谁再跟我说本地AI必须好显卡,我第一反应已经不是信了。
先看看你到底想跑什么。
至少聊天这件事,8G真的太tm能了。
下载链接: 达芬七8G未审查一键包-v1.0
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


