
网易有道开源实时语音+同传双子星,本地部署与极限挑战全实测
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
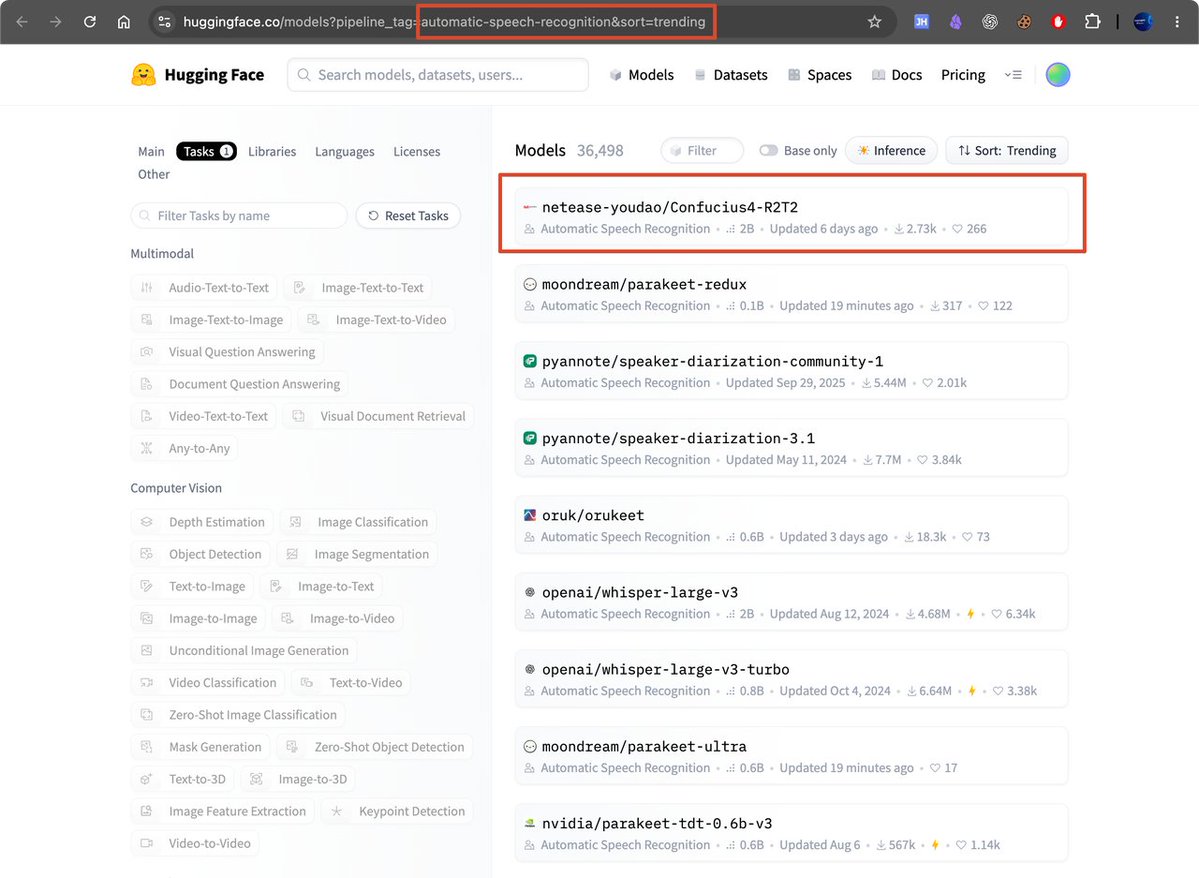
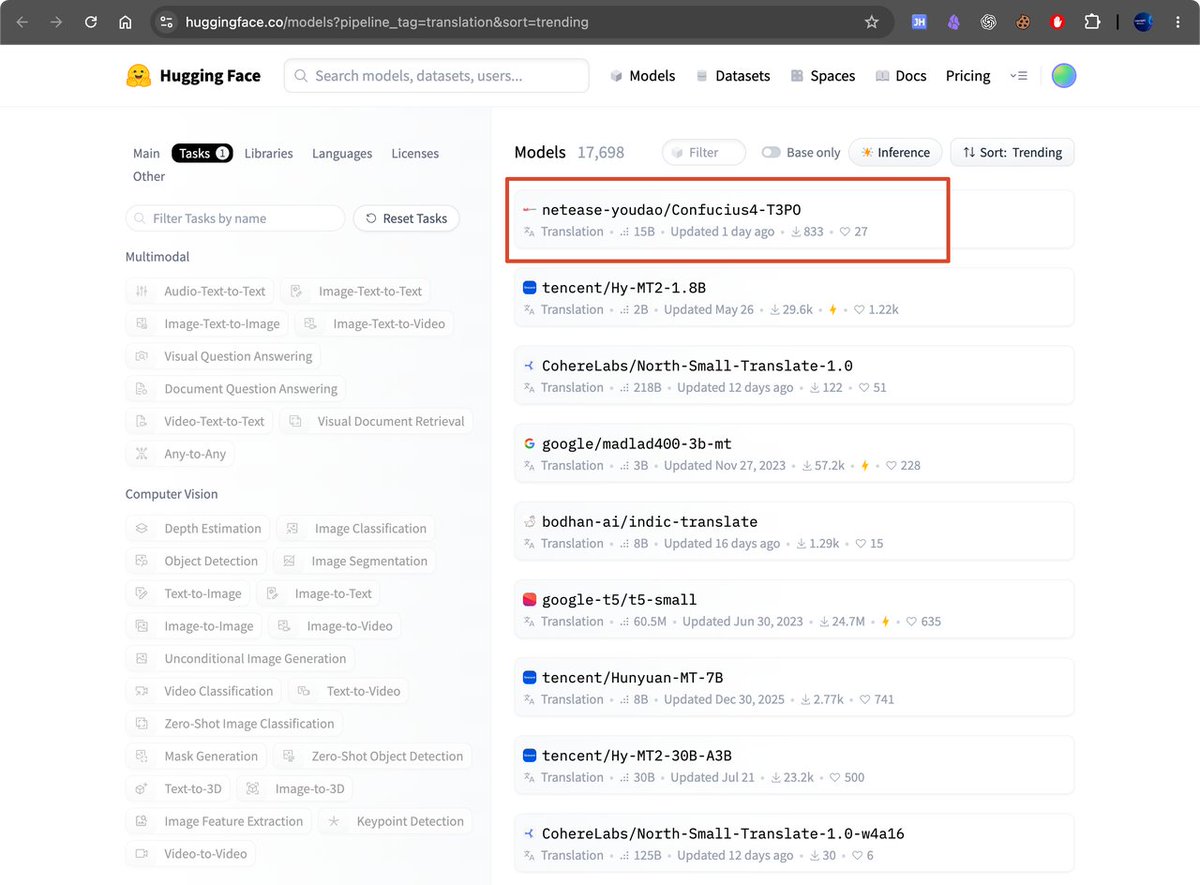
就在此刻网易有道的两颗双子星:实时语音识别模型 Confucius4-R2T2 和实时文本翻译模型 Confucius4-T3PO 在 Hugging face上的各自细分领域双双称王登顶。
Confucius4-R2T2 登上Automatic Speech Recognition(ASR)Trending 榜首。
Confucius4-T3PO 则登上Translation Trending 榜首。
榜单前排不乏全球AI行业中最领先的科技公司发布的模型,例如OpenAI、谷歌、英伟达、微软、甚至腾讯、阿里等旗下的多个模型。
为了看看双子星的实力,我就写下本篇文章来:把这两个开源模型本地直接部署,看他们的实时语音识别和实时文本翻译到底做到了什么程度
下面开始进入正题,目录如下可进行选看
-
1、双子星登顶详情
-
2、实时语音识别介绍:真流式 vs 伪流式
-
3、实操对决:Whisper large-v3 vs Confucius4-R2T2
-
4、实时文本翻译模型介绍:Confucius4-T3PO
-
5、双子星搭档实测:端到端实时听写 + 同传翻译
-
6、极限场景实测:嘈杂菜市场与方言挑战(地狱级难度)
-
7、总结
一、双子星登顶详情
Confucius4-R2T2 登上的是 Automatic Speech Recognition(ASR)Trending 榜首,你可以直接点击链接就可以查看这个榜单,发文时截图如下:
https://huggingface.co/models?pipeline_tag=automatic-speech-recognition&sort=trending
同样的,Confucius4-T3PO 则登上Translation Trending 榜首。你也可以直接点击链接就可以查看这个榜单,发文时截图如下:
https://huggingface.co/models?pipeline_tag=translation&sort=trending
应该说热度还在持续。
二、实时语音识别介绍:真流式 vs 伪流式
实时语音识别也就是真流式语音识别模型,就是把正在说的话实时转换成同语言文字。
而我们之前看到最多的OpenAI 家的 Whisper,它处理的实时语音识别是伪流式。
它其实更擅长处理的是完整的音频片段。
简单对比一下实时语音识别 Confucius4-R2T2 和 Whisper 两者的区别,也就是真流式和伪流式的区别
## Confucius4-R2T2

我今天
我今天准备
我今天准备测试一下
我今天准备测试一下实时语音识别

## Confucius4-R2T2 识别出来就是固定下来的

## Whisper

我今天
我今天准备考试          <-- 猜错
我今天准备测试一下      <-- 推翻前文重改
我今天准备测试一下实时语音
我今天准备测试一下实时语音识别

## 应该还是很明显的
## Whipser识别之后还会修改前面的
用一句话来总结的话:Whisper 是不断重听最近一段,然后修改答案,也就是前面输出的也有可能被修改。Confucius4-R2T2 是听到足够确定后再输出,输出文字之后只往后追加,不会进行修改。
Whisper 更适合视频、录音等以最终转写结果为主、不要求中间字幕始终稳定的场景。
而 Confucius4-R2T2 不仅仅有 Whisper 功能,它专为实时而生: 实时字幕、语音输入、同传和语音 Agent等各种场景适配。
比如以下常见场景:
-
会议、课堂实时字幕
-
直播的实时字幕
-
视频通话的字幕
-
语音输入和语音助手
-
客服通话实时转写
-
听障人士辅助字幕
-
采访、庭审、演讲实时记录
-
Vibe Coding 中直接用语音输入需求
三、实操对决:Whisper large-v3 vs Confucius4-R2T2
首先说一下环境,我是在M5 24G Mac上进行测试的,跑这两个模型还是轻松松松
https://huggingface.co/openai/whisper-large-v3

## Confucius4-R2T2 推理代码、运行脚本、Python 示例、WebSocket 服务端与客户端,以及安装说明
https://github.com/netease-youdao/Confucius4-R2T2
## Confucius4-R2T2 模型权重、配置文件、Tokenizer,以及模型介绍
https://huggingface.co/netease-youdao/Confucius4-R2T2

我要对比这两个模型,前者是伪流式实时语音,后者是真流式实时语
帮我确认本地环境,并根据链接中的两个模型进行适配
如果不符合安装条件,请提供给我更好的建议
基本上根据这个提示词就可以在本地安装好合适的版本。
Whisper的话已经非常成熟了,直接安装即可
因为这里我是mac,而 Confucius4-R2T2 又比较新,但是社区发展也非常快,也有了适配mac版本的量化版本了。
链接就在此:https://huggingface.co/selcukkubur/Confucius4-R2T2-mlx-4bit
下面我又制作了一个网页,主要就是来对比一下 Whisper large-v3和 Confucius4-R2T2 的真实区别
详情可以直接看视频
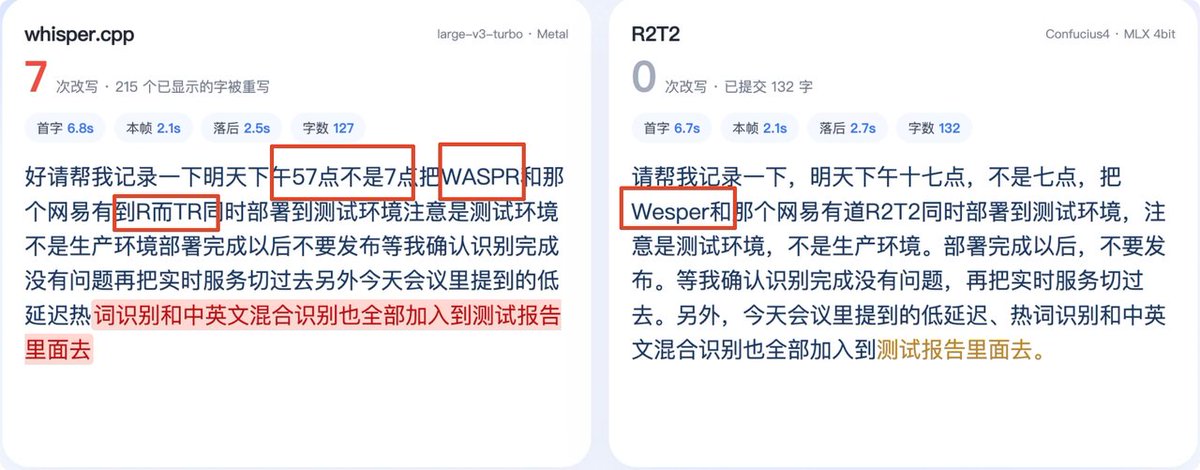
也可以直接看最终截图结果如下,左侧Whisper 其实总共回改了七次,而且有三个地方是明显的错误,并且默认没有适配标点符号。
而 Confucius4-R2T2 只有一处错误,可能是我读的不够标准。也识别的差不多,并且标点符号都是正确的,不得不夸一下网易有道,真的有点实力啊。
四、实时文本翻译模型介绍:Confucius4-T3PO
现在的大模型100% 都能翻译成别的国家的语言,比如给它一段完整的英文内容,它能很快帮你把整段翻译为中文。
但是它不太擅长原话还没说完,就开始持续的输出译文,并且不再修改译文。
所以实时的文本翻译(实时文本同传)不仅仅需要模型的速度,还需要一套决定何时输出的机制。
-
读到多少个字了开始翻译
-
哪些译文是可以固定的
-
哪些需要再等等待一下翻译
-
还有其他很多问题
网易有道的 Confucius4-T3PO 就能很好的解决这些问题
而且它刚好可以跟 Confucius4-R2T2 搭配使用。
Confucius4-R2T2 负责边听边转写,Confucius4-T3PO接着边读边翻译。
于是我直接本地部署,然后快速搭建了一个网页
这里同样你可以直接提供网易有道提供的版本给AI,叫AI帮你去看看能否安装
GitHub: https://github.com/netease-youdao/Confucius4-T3PO
Hugging Face: https://huggingface.co/netease-youdao/Confucius4-T3PO

帮我看看这两个链接,然后看看我本地的环境能否进行安装并跑起来
根据提示词,和对话给你的建议,基本都能跑起来了,然后写个简单的页面,就可以开跑测试了。
这里如果你单独测试的话 他是比较简单的,我就直接在下一节中一起进行组合测试了
五、双子星搭档实测:端到端 实时听写 + 同传翻译
两个都部署好之后,我叫AI写了一个网页:Confucius4-R2T2 负责边听边转写,Confucius4-T3PO接着边读边翻译的网页
由于单 Confucius4-T3PO 的权重就在10G左右,所以两个一起跑的时候,速度上相对更慢了一点。
从音频到原文需要一点时间,从原文到译文又需要一点时间,所以整体有一定的延时性。
但是连我的电脑都能跑起来,而且非常流畅,除了有一点延时。走在了Whisper的前面。
几年前我记得非常清楚,也就是Whisper刚发布的时候,很多普通的电脑也是跑不起来了,但是现在都能轻松畅跑了。
六、极限场景实测:嘈杂菜市场与方言挑战(地狱级难度)
来看一个菜市场嘈杂的环境下,实时语音识别再加上翻译为英文。
然后又测试了一下方言实时语音识别再加上翻译为英文。
效果都非常巴适。这样如果再想出国旅游沟通交流真的巴巴适适一点问题不大了,完全不用再去买那些动辄数千元、价格昂贵的专用硬件翻译机了。
七、总结
技术的飞速前进,不仅让 AI 模型的效果上限不断突破,更让端侧化、轻量化的工业级模型真正飞入寻常百姓家。
网易有道这次开源的 Confucius4-R2T2 和 Confucius4-T3PO,精准击中了真流式实时转写与低延迟流式同传这两个以往门槛极高的领域
-
不搞伪流式推翻回改的视觉抖动
-
在个人 Mac 端侧就能把近 15B 级别的双模型流水线跑顺
这波开源确实展现了扎实的技术沉淀,妥妥的实力圈粉!
最后再次附上开源链接
R2T2 语音识别
GitHub: https://github.com/netease-youdao/Confucius4-R2T2
Hugging Face: https://huggingface.co/netease-youdao/Confucius4-R2T2
T3PO 同传
GitHub: https://github.com/netease-youdao/Confucius4-T3PO
Hugging Face: https://huggingface.co/netease-youdao/Confucius4-T3PO


