
从 CRDTs 到本地优先的同步引擎 录播及文字版 上
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
本文是 2026 年 9 月 20 日 @zx_loro 在 local-first 线上会议的分享录播以及文字版内容。主要分享我们团队从 @loro_dev 到 @lody_ai 在 local-first 架构和同步引擎上的一些实践分享。
Lody GitHub:
[未转换内容,参见原始 JSON]
Loro GitHub:
[未转换内容,参见原始 JSON]
有时间的话直接看视频效果最好~
录播视频(B站):https://www.bilibili.com/video/BV1Myez6LEKc/?vd_source=424d63be0b8226c9b8fbe1a2cc4bb21c
今天我讲一下“CRDTs are not enough”,也就是:如果要做一个本地优先的同步引擎,现在还缺什么东西。
先简单自我介绍一下,我叫陈子轩 @zx_loro ,和 Leon @leon7hao 从 2022 年开始做 loro.dev,它是一个 CRDT library。到 2025 年末,我们开始基于 Loro 做 lody.ai,它是一个 local-first 的团队 AI agent 控制面。通过 Lody,我 们从真实的产品需求、从用户 UI/UX 的打磨出发,挖掘本地优先同步引擎现在该有的形态。中间我们发现了很多现在还缺失的东西,今天就分享一下我们的经验。
首先,什么是本地优先软件?
简单说几个点:用户控制数据,可以自由切换不同的云端,作为数据备份。云端是一个备份和辅助者,而不是权威所有者。在这个架构里,云端只是一个备份和额外的副本。local-first 和 local-only 不 一样:local-only 是只能在本地做这些事情,而 local-first 仍然希望保持多设备同步的便利性。
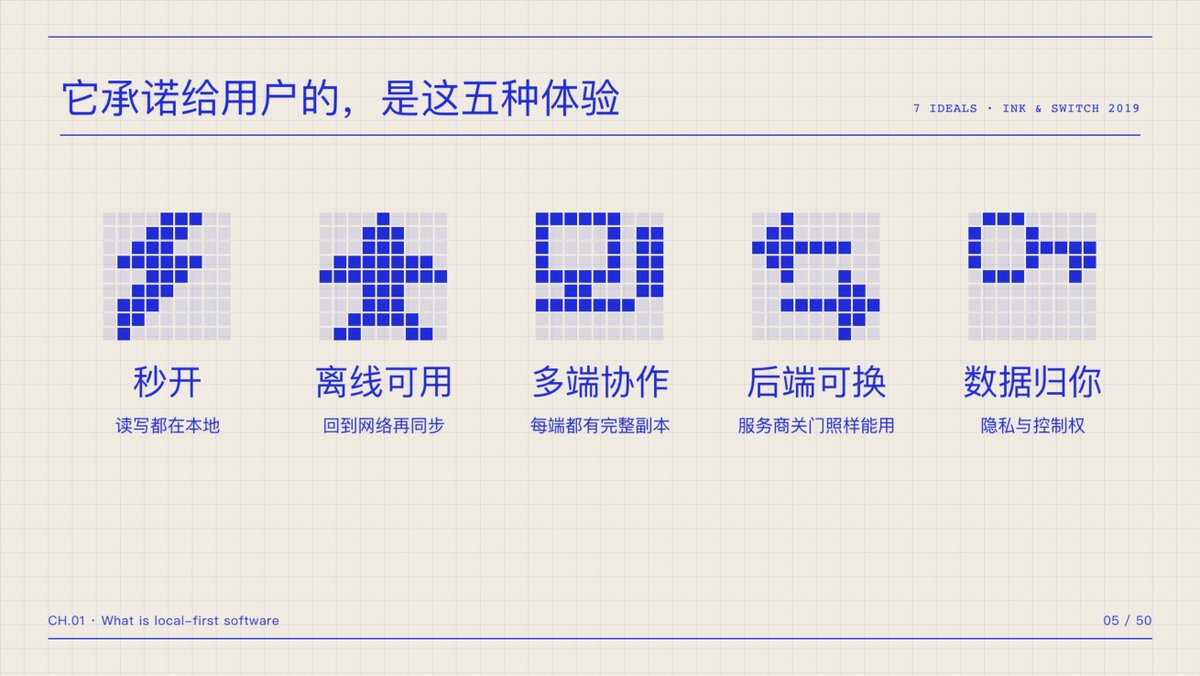
它给用户承诺五种体验:能秒开,因为数据读写都在本地;离线可用;多端协作;后端可以切换,不会因为软件服务提供商关门就影响使用;数据归我所有。这里面,一方面是软件服务提供商不能把我阻拦在使用软件之外;另一方面是隐私,我的数据不能被服务提供商随意读取。
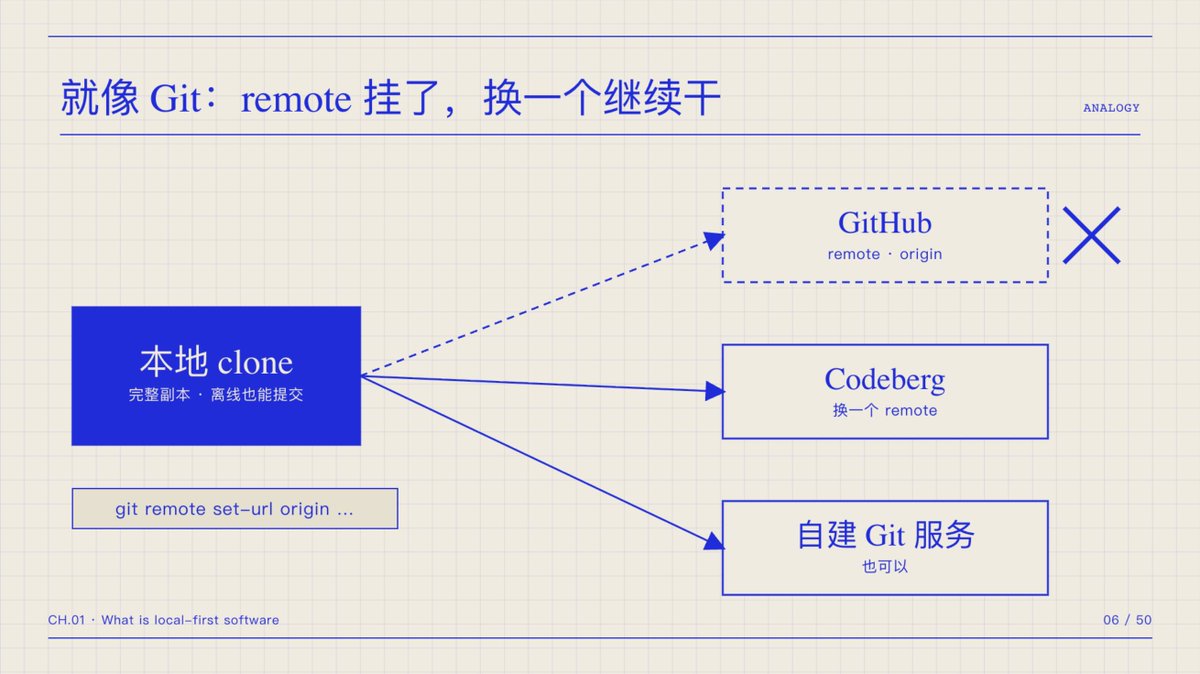
最经典的例子是 Git。虽然 Git 还没有做隐私这部分,但它已经非常接近本地优先软件理想中的形态。 首先,它以协议的形式定义好本地和远端怎样交换数据。你可以切换不同的后端:GitHub 挂了,或者不想用 GitHub 了,可以切换 Origin,改用 GitLab,或者自己 self-host。
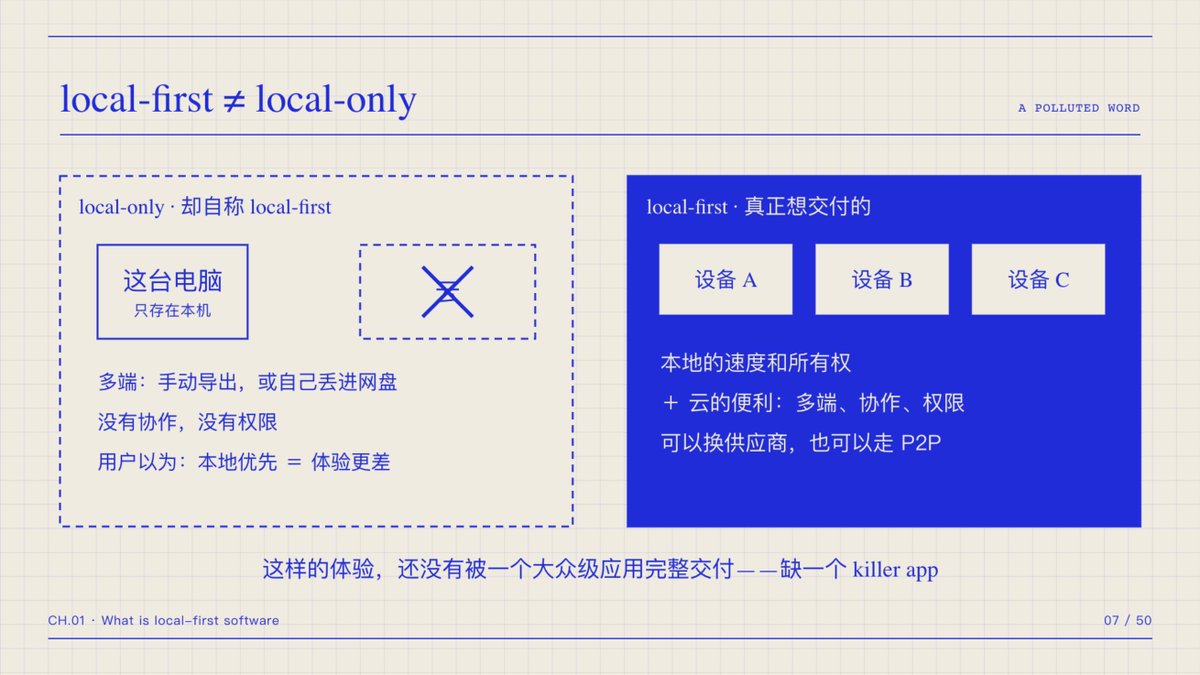
local-first 和 local-only 是不一样的。我看到群里挺多人会把两者混在一起。但现在其实缺一个大众级的应用,来完整交付这样的 local-first 体验。很多应用缺少云端的便利性,本来是 local-only,却称自己为 local-first;实际上没有提供云端便利,也没有提供 P2P 同步等选项。
我们和 local-first 社区对同步引擎的想象是什么样的?
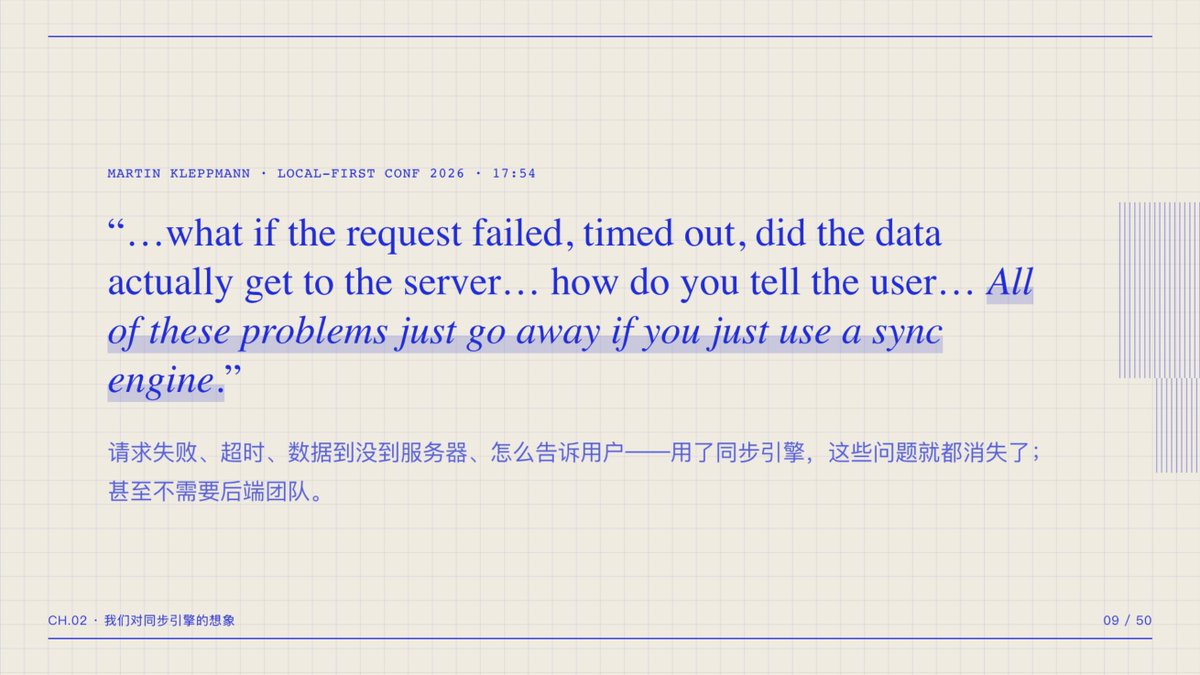
可以引用今年 Martin Kleppmann 在 Local-first Conference 上的分享:对于开发者来说,不用再担心请求失败、超时、数据是否到达服务器、要怎样告诉用户,这些复杂问题全部交给同步引擎就好 了。但其实我们现在还没有这样的同步引擎。
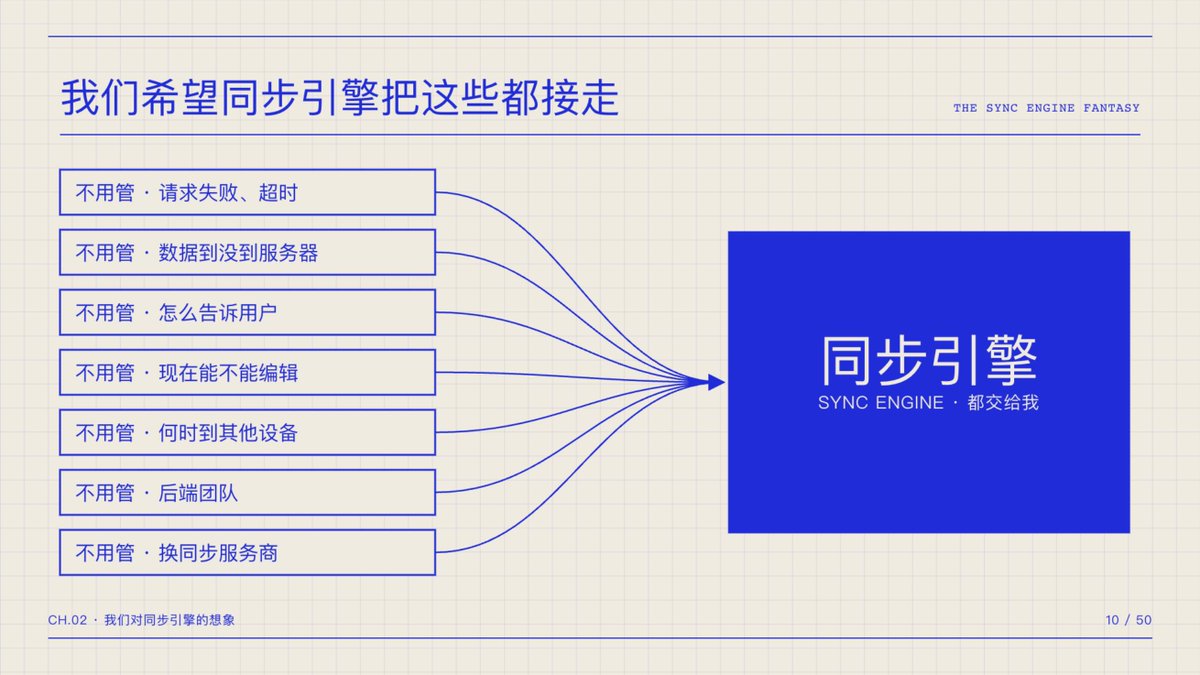
大家希望一个统一、通用的同步引擎吸纳这些事情:请求失败怎么处理,数据没到服务端怎么处理, 前端怎么告知用户,怎么管理权限,让用户能不能编辑这些事情都符合直觉、显而易见。还有,本地 和后端怎样持久化,怎样切换不同的服务提供商。
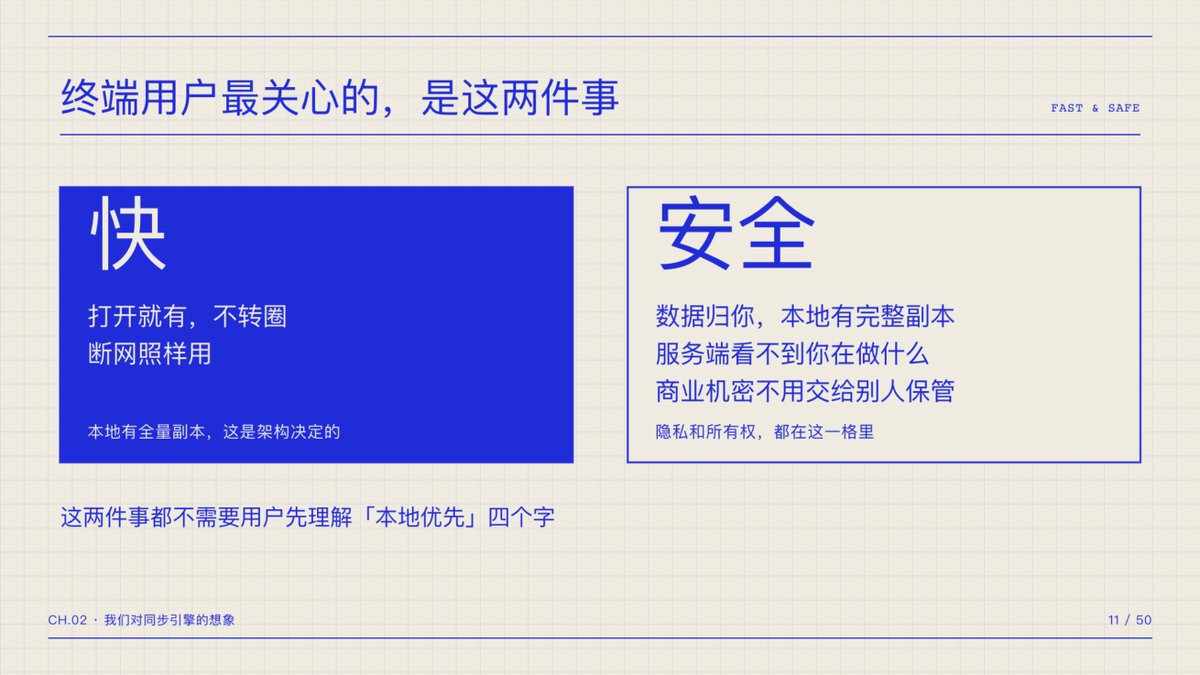
从最终用户的角度,本地优先带来最直接的好处,一个是快,一个是安全。这样的同步引擎能够给终端用户带来这两种好处。
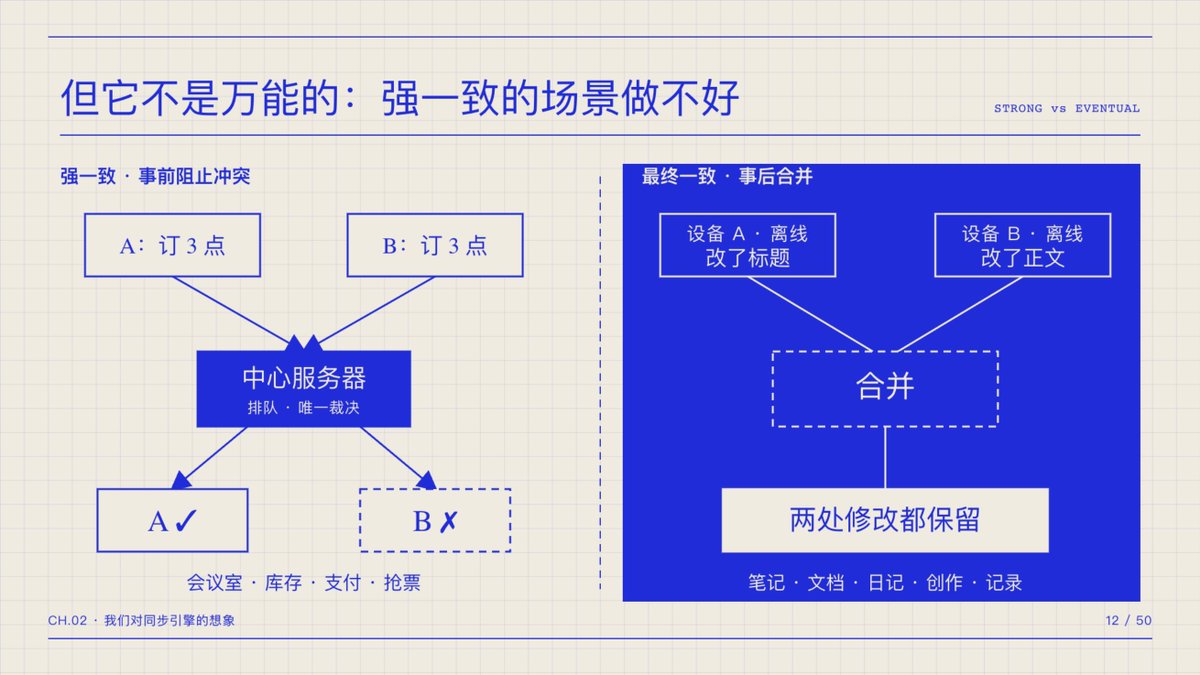
但从理论上来说,它绝对不可能是万能的。有一大类场景它解决不了,就是强一致性的场景。比如抢票、库存管理、支付、会议室抢占式预约,这些都是本地优先同步引擎从原理上没有办法处理的问 题。因为这一系列问题需要强一致性,而本地优先的同步方式可以处理好最终一致性的场景。
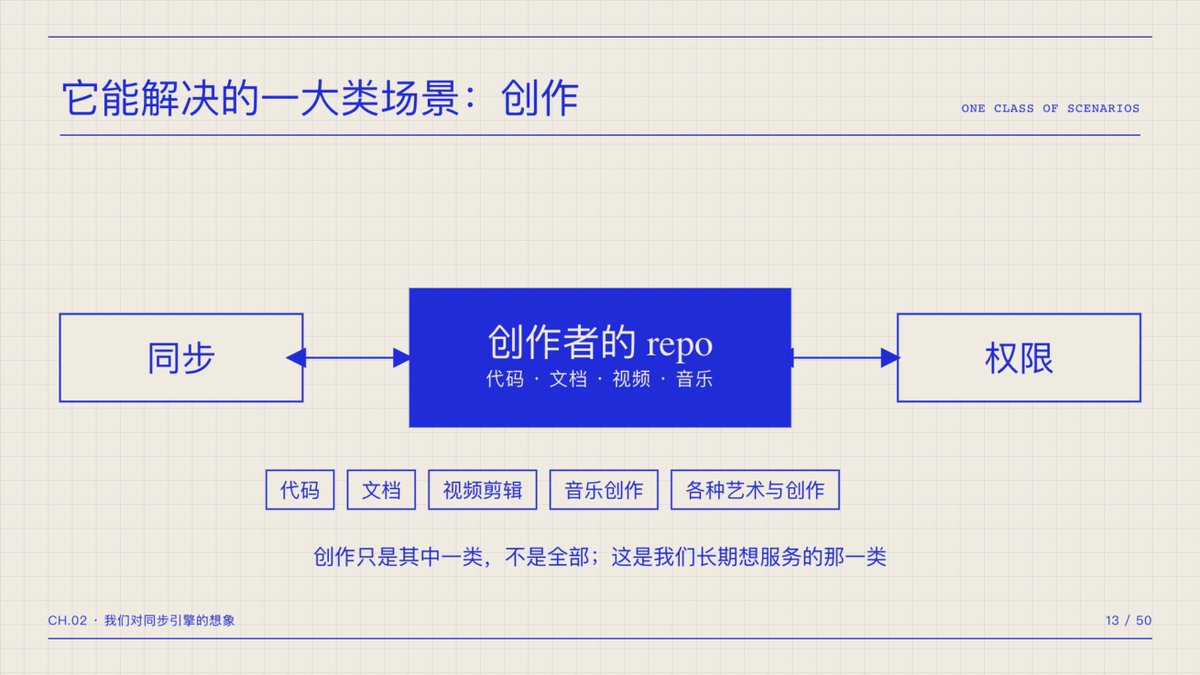
这类场景很多时候就是创作,比如代码、文档、视频剪辑、音乐创作、各种艺术创作。这一大类场景是这类同步引擎可以统一解决的。
背后的必要复杂度,要从应用开发者转移到同步引擎上。
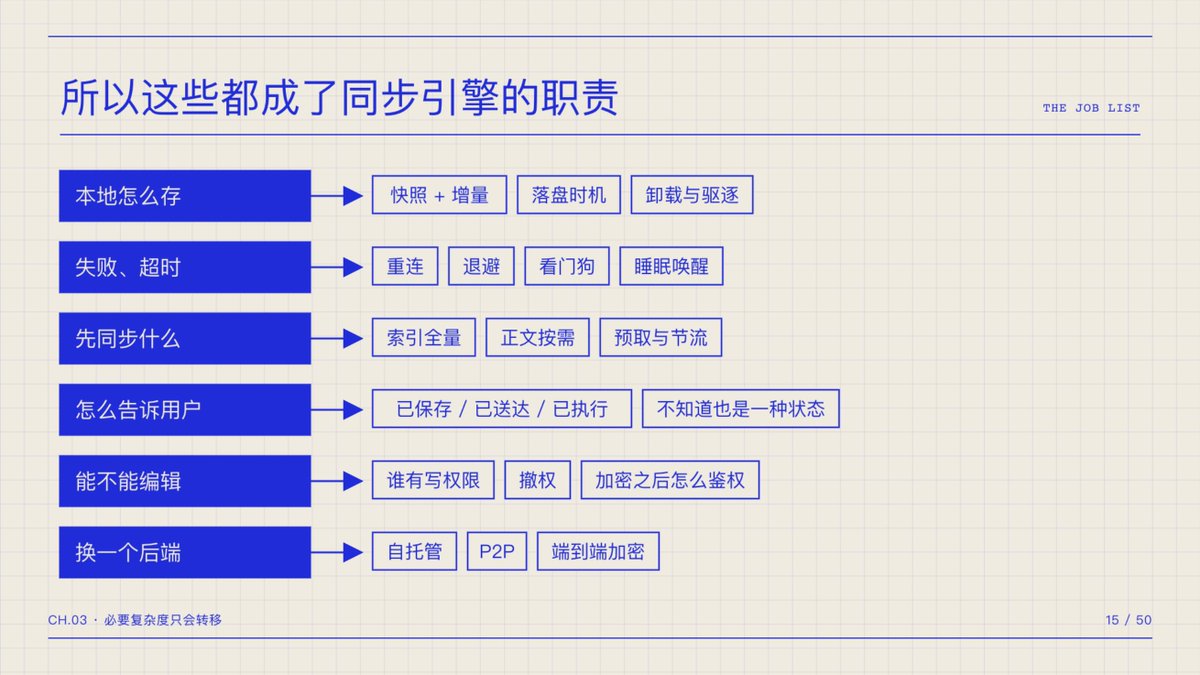
包括本地怎么存、超时怎么办、怎么告诉用户、要提供哪些事件、怎样表达背后的权限、怎样切换后端、怎样提供 P2P、怎样同时提供端到端加密。这些都变成了同步引擎的职责。
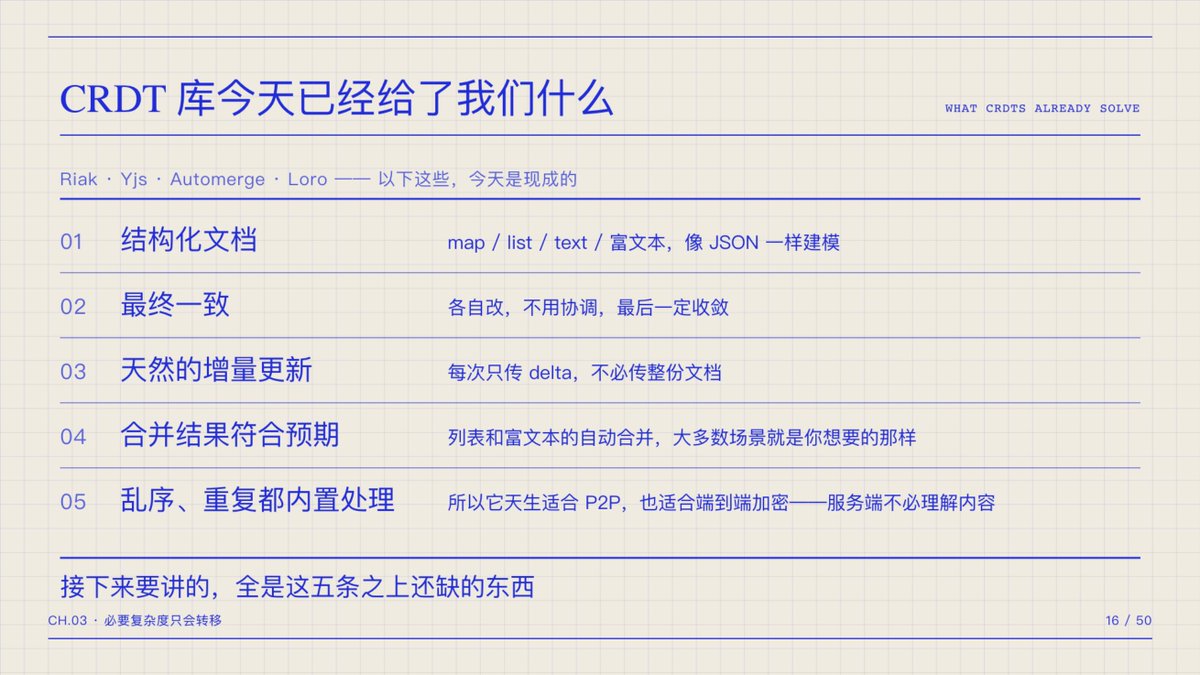
现在 CRDT 库已经提供了这些能力:Loro、Yjs、Automerge 都能像 JSON 一样建模结构化文档,并提供最终一致性。只要各端最终拿到的更新集合一致,最终状态就一定一致。它们也提供增量同步; 对文本、富文本、列表等类型,合并结果会尽可能符合预期。这里有比较多的相关论文,成果也被吸纳到这些 CRDT library 里了。更新同步时的乱序、重复等事情,也都被覆盖了。你不用关心一个更新在什么时间到达,可以安全地重发更新,它不会被应用两次。但这些并没有解决刚才说到的所有问 题。这些 library 本质上是比较纯的计算,不覆盖网络层、持久化层等涉及 I/O 的部分。这些却都是同步引擎需要做好的事情。
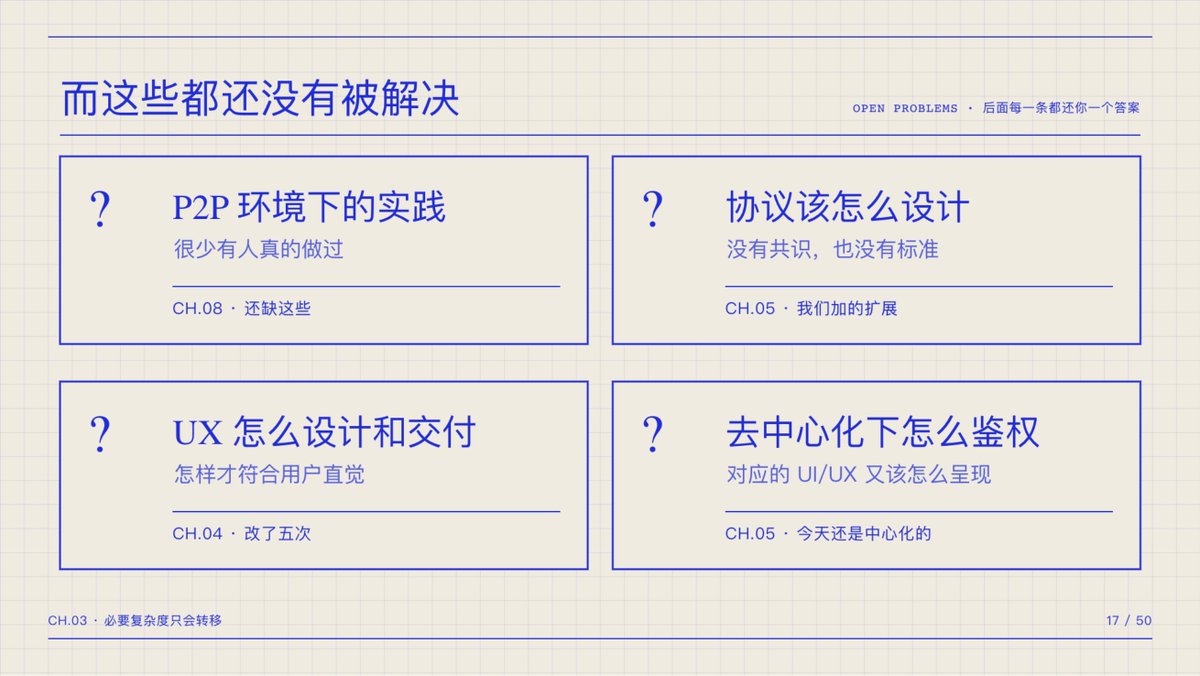
比如,P2P 环境下的实践应该怎么做?这里还缺少很多东西,现在没有答案。同步协议怎么设计?目前也比较百花齐放。UX 怎么设计和交付,尤其在去中心化环境里,怎样让它更符合用户直觉?还有在去中心化环境下怎么做鉴权,相应的 UI/UX 怎么呈现?
我们在 Lody 落地的过程中一步步反推
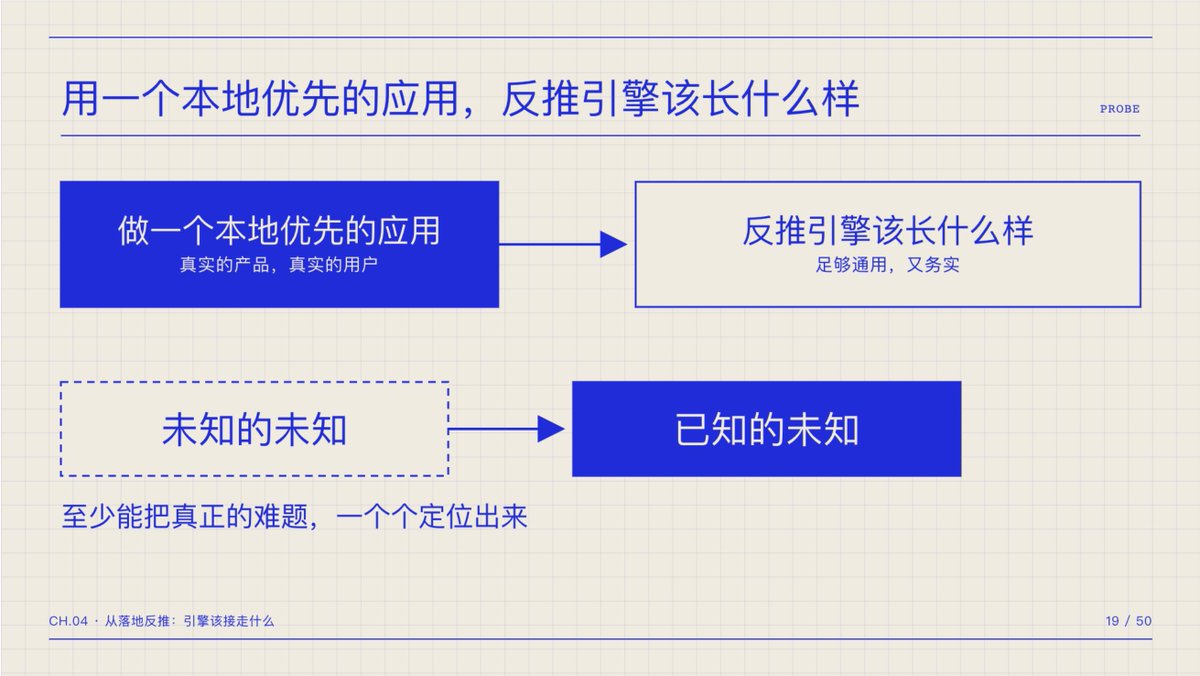
积累了一些经验,简单分享一下,作为抛砖引玉。
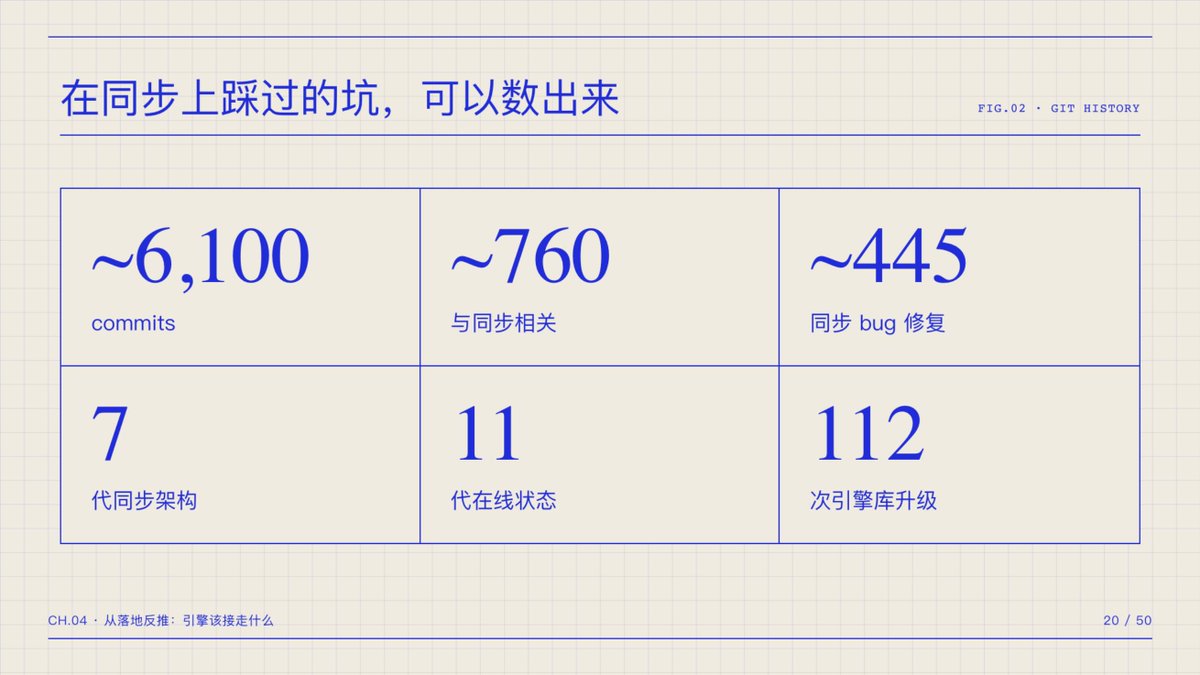
https://github.com/LodyAI/Lody 这个项目现在应该有七千多个 commit,其中有大量的同步相关的升级和改造。
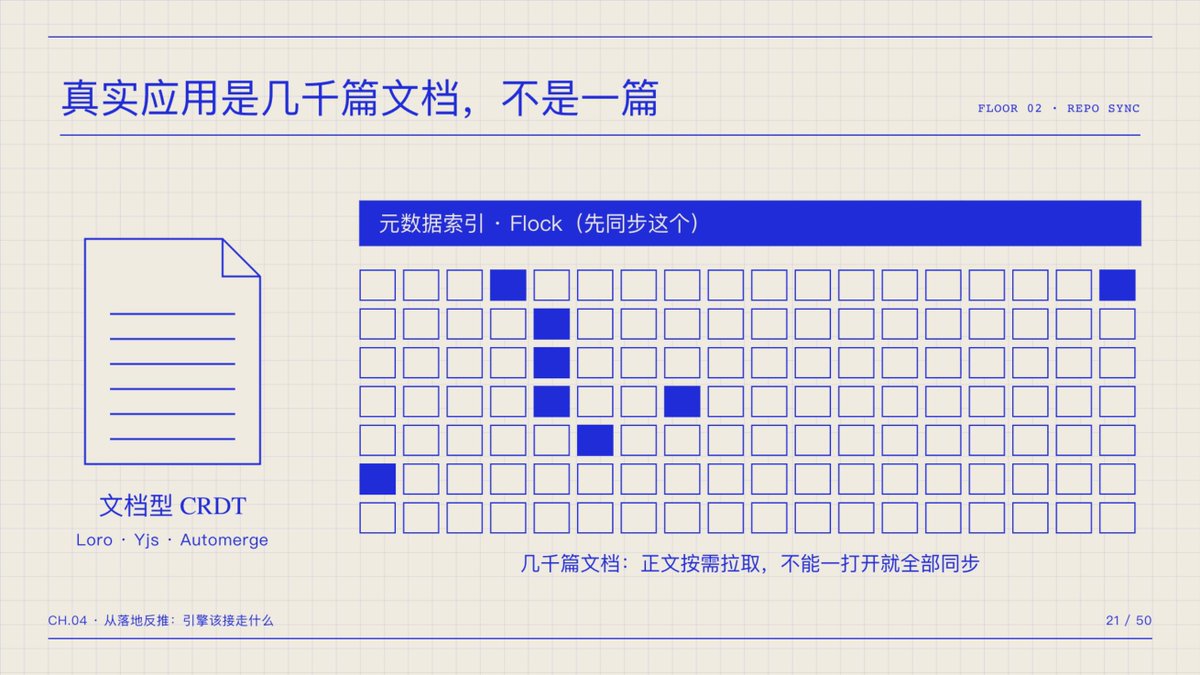
lody.ai 是一个 agent 控制面,需要同步各种对话信息,未来还会有更多文档信息。这里面相当于有几千篇文档,要同步它们的数据:怎么做懒加载?怎么同步整个 repo?这是我们遇到的第一个问题。你不可能一打开应用就全量加载所有文档内容。但 Loro、Yjs、Automerge 这三个 CRDT library 本身只提供文档级同步能力。要做整个 repo 的同步,经常需要组合别的方式。
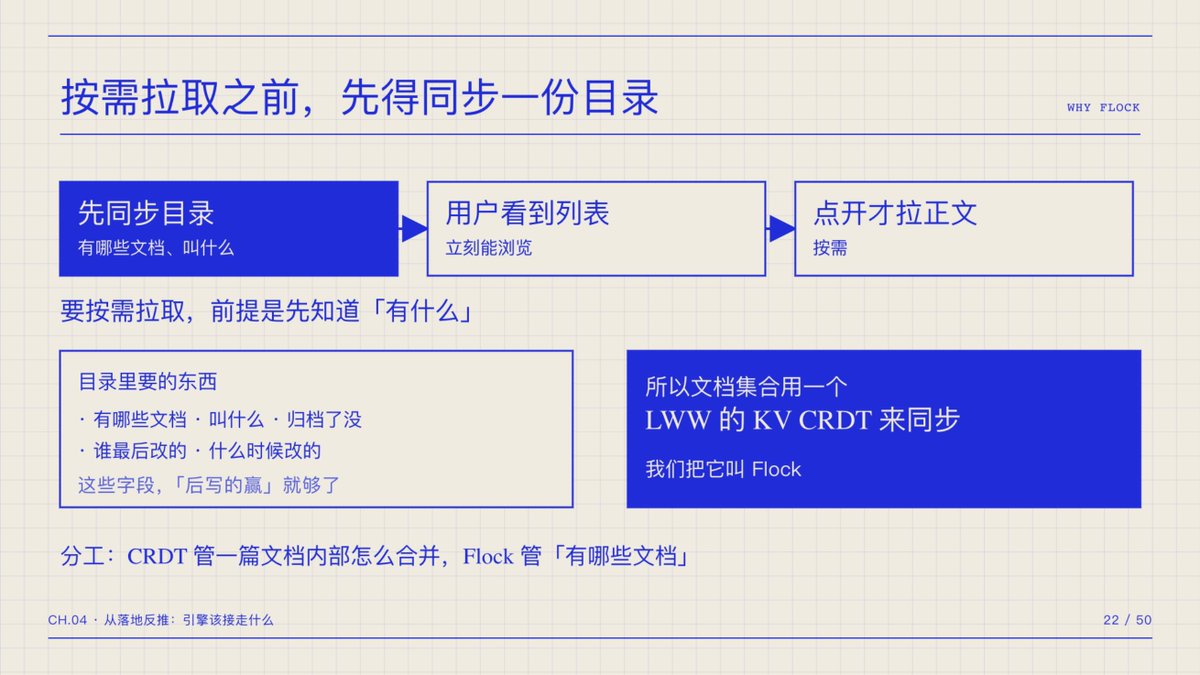
我们研发了一个新的 CRDT,叫 Flock,未来也会开源。它相当于同步一份目录。比如打开 Notion,你先看到有哪些文档。或者打开 Notion database,先看到所有的 row 及其 metadata。点开一篇具体文档之后,才拉取对应的内容。Flock 就是负责背后目录同步这一部分的 CRDT。我们用这个 library 同步 Lody 内所有对话的标题等需要首先看到的信息。
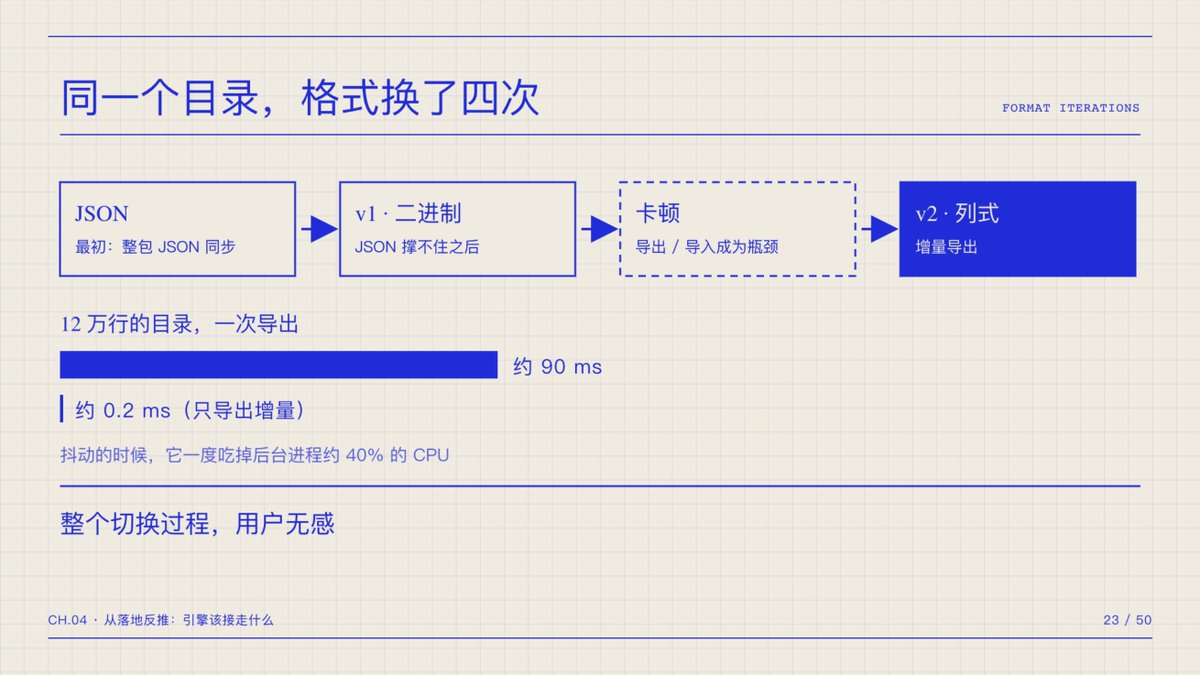
Flock 做过很多次演进。最开始用比较简单的 JSON 格式,很快就撑不住了;后来换成 V1 二进制格 式,但设计太复杂,容易出错。再后来切换到列式的 V2 数据格式。V1 有点受 SQLite 原地更新存储 方式的启发,V2 则改成另一种受数据库设计启发的文件格式。它的性能和稳定性比之前高很多,整个切换过程对用户没有感知。
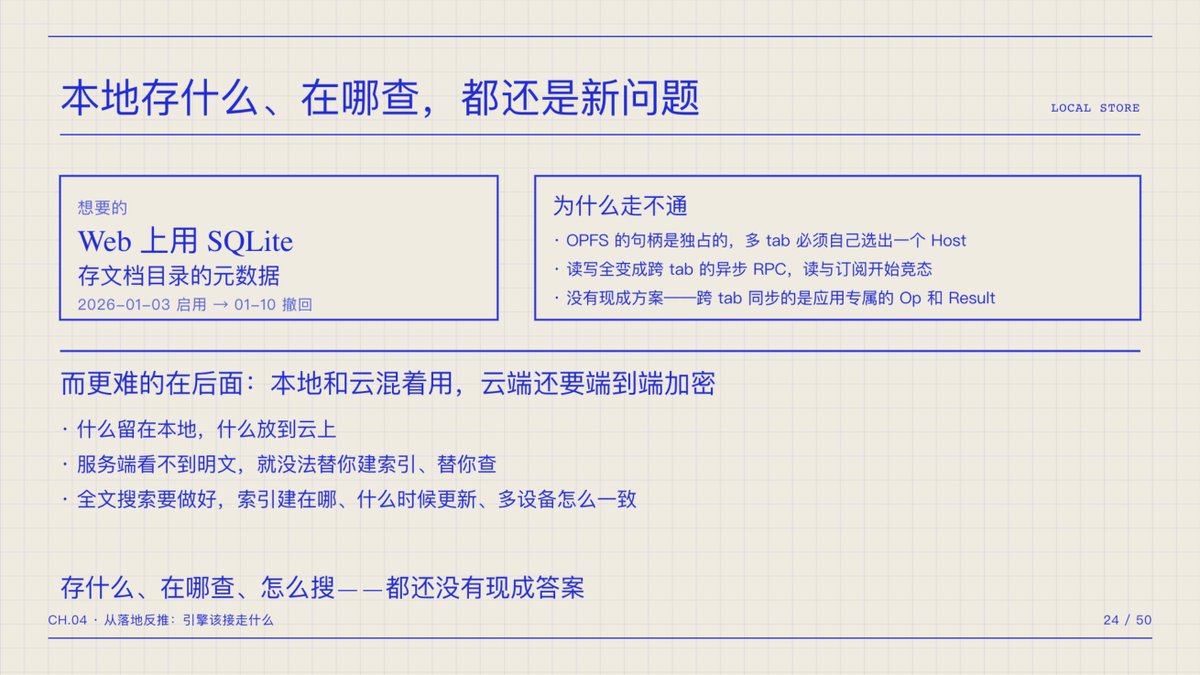
接着,本地怎么存、在哪里查,也都变成了新问题。我们最开始尝试在 Web 上接 SQLite。现在有一 些 OPFS 之类的实践,包括 Notion 也是这样做的。但很快发现这条路径复杂,很难走通。浏览器每个 tab 都是独立的,访问 SQLite 时,SQLite 本身只能有一个 writer。如果有多个 tab,相当于每个 tab 都要抢占 writer 的权限。所以架构需要变成:浏览器选出一个 leader,持有 SQLite,负责所有写入。 这一整套就很复杂。当时找了一下,没有找到可以直接使用的开源解决方案。那是今年二月份,不知道现在有没有什么变化。后来我们换成了 IndexedDB。但这只是问题的一小部分。后面还有全文搜索:在纯云端架构里,其实是很容易解决的问题,直接用 Elastic,或者给 PG 配一些全文搜索插件就可以。可是在本地做这些事情,UX 要怎么设计?尤其在浏览器里,不会一打开就把所有数据加载下 来。再加上我们会把云端的数据尽可能包装成端到端加密的形式,这部分怎么做,也是现在还没有解 决、仍在尝试解决的问题。我觉得未来可能可以使用语义化搜索,并尝试结合一些加密手段。这也是新问题。
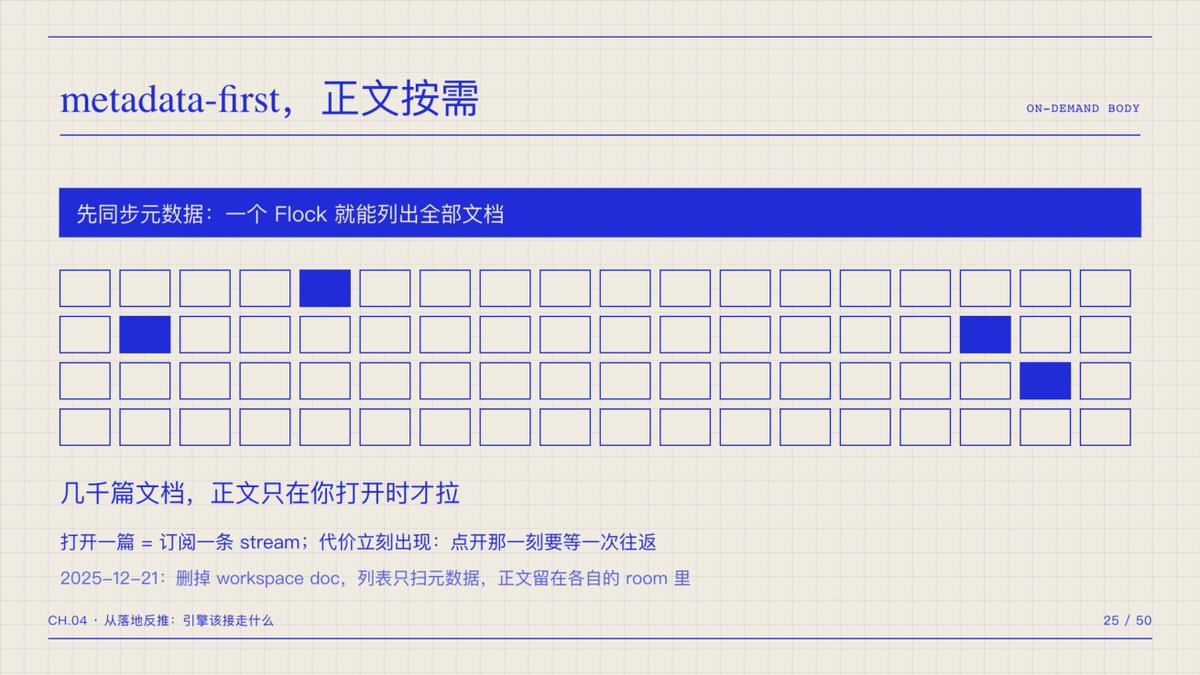
metadata-first 也就是按需同步,之前讲的先同步元数据。
X 文章居然还有图片上限?移步下一篇:


