
【科普】一文读懂 RSI:AI 能自己变得越来越聪明吗?
文章目录
AI 已经会反思、记住错误,甚至改写自己的代码和工作流程,但这还不等于真正的“自我进化”。RSI 要求每次升级都能帮助下一轮升级,还要证明系统没有刷分、跑偏或越改越差。读完这篇,你会知道这条路走到了哪里。
🎙️ 阅读目录
| 章节 | 这一章讲什么 | 读完能判断什么 |
|---|---|---|
| 01 RSI 到底是什么 | 用“学生改错题”拆开四种自我改进 | 一次回答变好,为什么还不算 RSI |
| 02 怎样才算真正的 RSI | 拆解七步闭环和三个必要条件 | 系统是真升级,还是只做了一次优化 |
| 03 技术已经走到哪一步 | 从反思、记忆、自训练讲到自动研发 | 各类技术处在 RSI 路线的哪一段 |
| 04 为什么完整 RSI 仍未出现 | 看现有证据、长期任务差距和减速机制 | 局部突破为什么还没带来智能爆炸 |
| 05 最难的不是改进,而是判分 | 解释 Evaluation、奖励投机和四层验证 | 分数上涨能不能证明系统真的变强 |
| 06 能力加速后如何保持可控 | 拆解风险、权限分离、审计和回滚 | 一套自我改进系统是否具备安全边界 |
| 07 八问验货清单 | 用八个问题检查“AI 自我进化”声明 | 如何快速识别真实进展与营销包装 |
你让一个 AI 助手检查刚才的回答。它发现漏洞,重写一遍,结果更好了。这算“AI 自我进化”吗?
通常不算。
它更像学生做错一道题后,当场把答案改对。真正的 RSI(Recursive Self-Improvement,递归式自我改进),要求这个学生不只订正答案,还能改造自己的学习方法,重新安排工具和训练流程;更关键的是,升级后的自己还能继续升级下一版自己。
RSI 最迷人的地方,也最容易被误解的地方,就藏在“递归”两个字里。
01 RSI 到底是什么
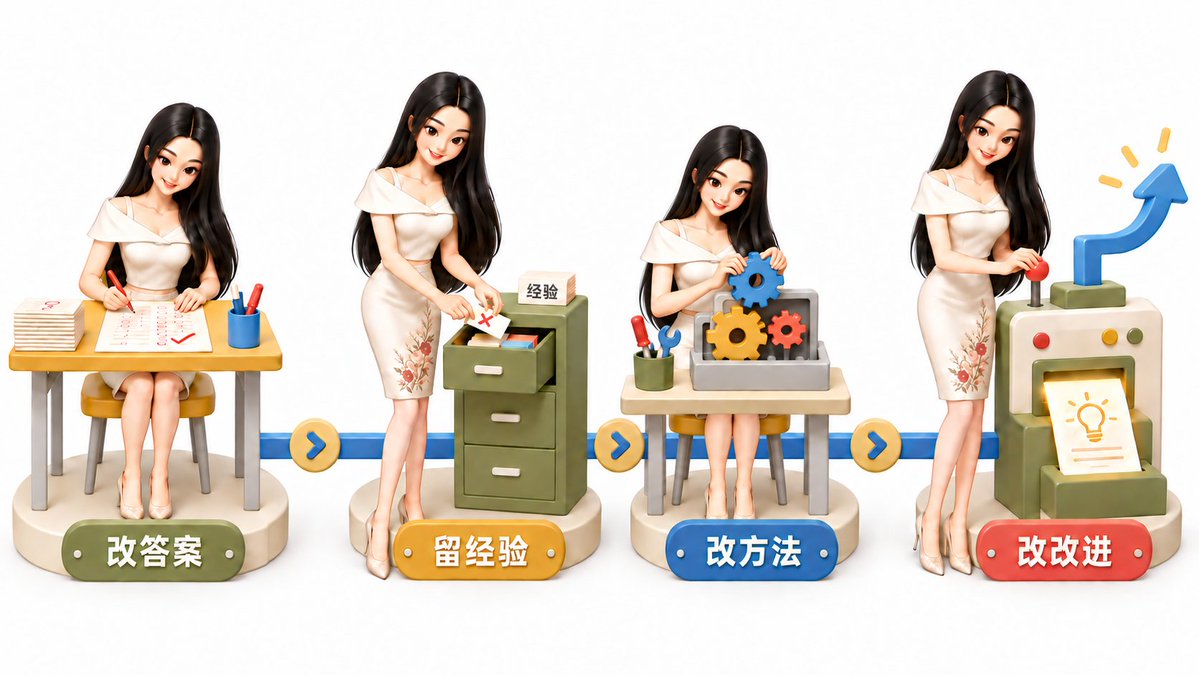
把 AI 想成一个正在备考的学生,自我改进大致有四层。
| 层级 | 学生在做什么 | AI 对应动作 | 是否触及 RSI |
|---|---|---|---|
| 第一层:改答案 | 订正这一道题 | 重写当前回复、修复当前代码 | 否,只改善一次输出 |
| 第二层:留经验 | 把错误写进错题本 | 保存记忆、规则或失败记录 | 接近,但底层能力未必改变 |
| 第三层:改学习方法 | 调整复习顺序、解题步骤 | 更新权重、工具、工作流或搜索策略 | 触及自我改进 |
| 第四层:改“学习方法的改法” | 设计下一代训练方案 | 改进用于研究、评估和升级自己的机制 | 进入 RSI 核心 |
一条回答变好了,只能证明系统完成了纠错。它不代表下一次还会更强。
保存一条经验,也不等于能力已经内化。换个任务、清空记忆,提升可能马上消失。
真正值得关注的是第三层和第四层:系统改变了持续存在的能力组件,而且这次改变提高了它下一次自我改进的能力。
RSI 要检查的,是这次改进有没有留下来,能不能成为下一轮改进的工具。
02 怎样才算真正的 RSI
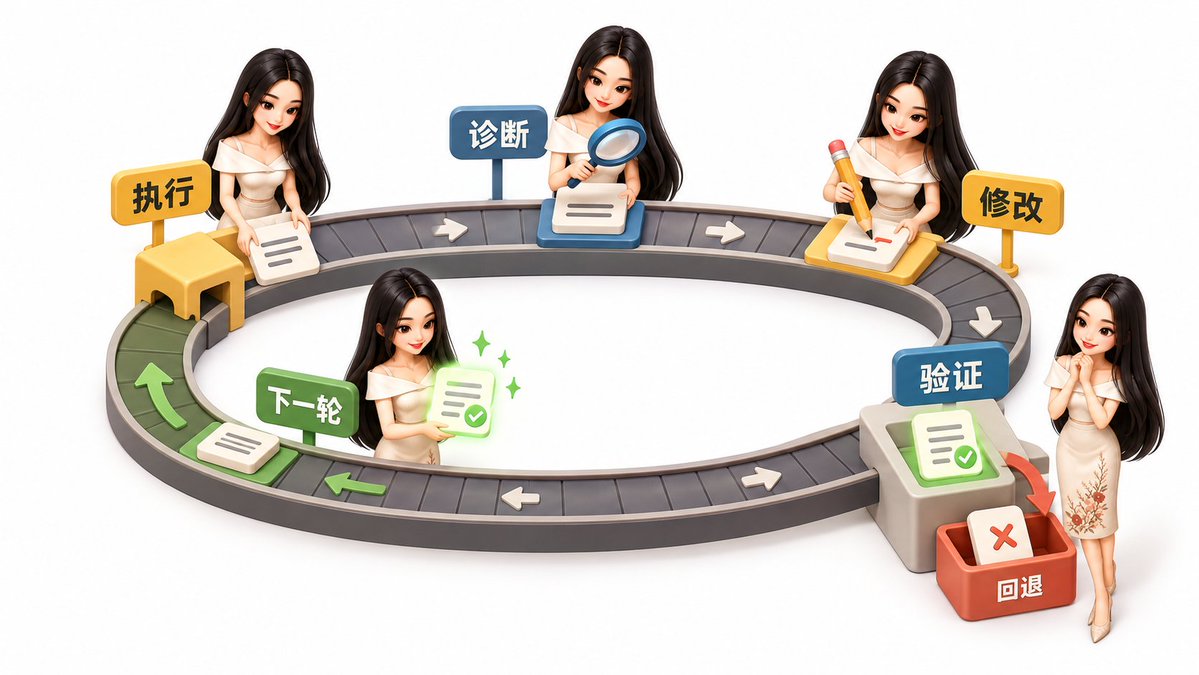
一套完整的 RSI 流程,可以压缩成七个环节:
执行任务 → 发现不足 → 提出修改 → 在隔离环境测试 → 独立评估 → 接受或回滚 → 用升级后的系统进入下一轮
前六步组成“自我改进”。第七步让它变成“递归式”自我改进。
如果改进后的版本不能更有效地参与下一轮研究,循环就没有真正递归。它只能算重复优化,递归带来的复利还没出现。
三个条件,少一个都要打折
| 要问什么 | 真正检查的东西 | 常见假象 |
|---|---|---|
| 改了什么? | 是否改动长期使用的记忆、权重、工具、代码或训练机制 | 只把当前答案重写一遍 |
| 改动留下来了吗? | 新版本能否成为下一轮循环的起点 | 清空上下文后优势消失 |
| 谁来判分? | 是否有隐藏测试、独立验证和回滚 | 自己出题、自己答题、自己宣布进步 |
这三问对应 RSI 的三个支点:改动有多深、能否保留,以及评估是否可信。
会反思,为什么通常还不算 RSI
今天的 AI 很会“反思”:找到问题,提出修改,再重写答案。这个能力有用,但多数情况下只改变当次输出,没有改动长期能力。
研究还发现一个反直觉现象:没有外部反馈时,模型的“内在自我纠错”并不稳定。有时第二遍更好,有时它会把原本正确的答案改错。
所以,流畅的自我批评不是自知之明的充分证据。它可能只是又生成了一段听起来合理的文字。
判断标准仍然是那三个问题:改了什么,是否保留,谁来验收。
03 技术已经走到哪一步
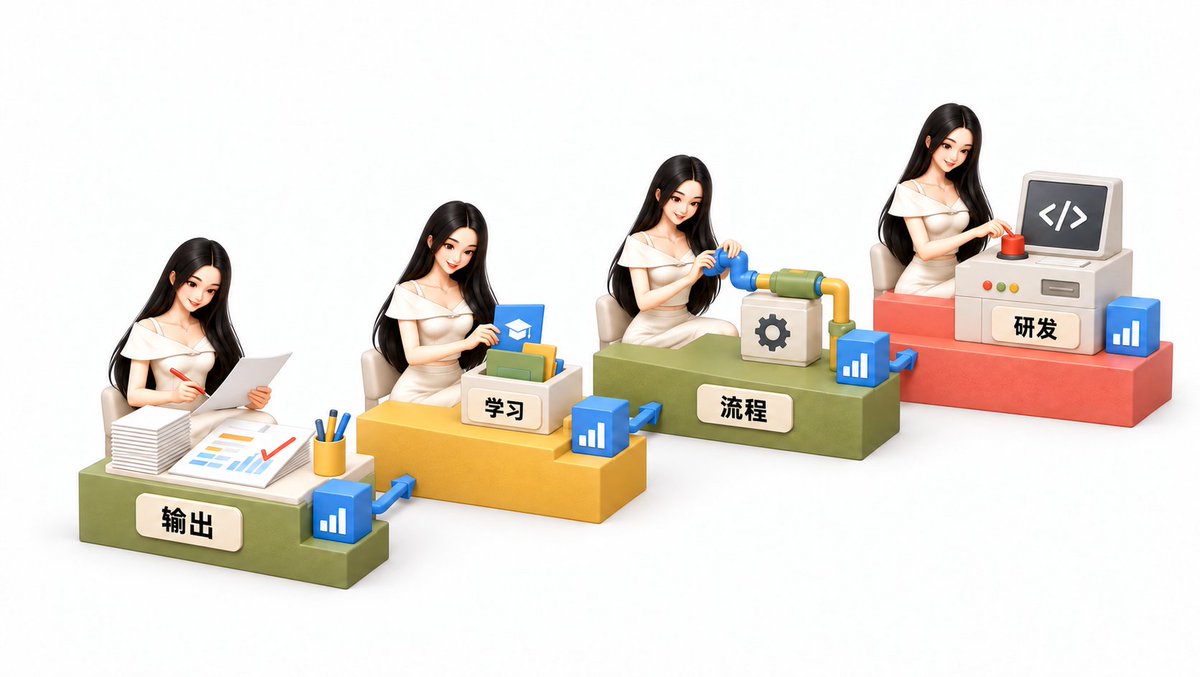
现有研究正在逐段补齐闭环,还没有一步跳到完整 RSI。按“改动有多深”来看,可以分成四级。
输出级:会回头改答案
Self-Refine 让模型先生成结果,再对结果给反馈,然后继续修改。论文在七类任务上报告了平均约 20 个百分点的绝对提升。
这说明反复修订确实有价值。但提升主要发生在当前推理过程里,系统本身没有永久升级。
Reflexion 再往前一步:它把失败经验写入外部记忆,之后做题时先读“错题本”。论文在 HumanEval 上报告 91% pass@1,高于所采用的 80% 基线。
进步已经能跨任务保留,但它仍主要依赖外部记忆,不等于底层模型完成了自我重写。
学习级:会制造下一批训练信号
STaR 让模型生成推理过程,筛选有效样本,再用这些样本继续训练。
Self-Rewarding Models 更进一步:模型既生成回答,也参与评价回答,把判断结果转成训练信号。
SEAL 让模型生成用于更新自身的训练数据或更新指令;Absolute Zero 则探索由系统自己提出可验证任务,再从解题反馈中学习。
这一层真正碰到了“模型更新模型”。同时,风险也变得更尖锐:如果评估器有偏差,错误会被写进下一轮训练。
工作流级:会改工具和研究流程
AI 的能力并不只装在权重里。提示、工具调用和代码是一部分,搜索顺序、记忆管理与代理分工共同构成另一部分。它们合起来叫 harness,也就是能力运行的外部支架。
STOP 展示了一类“脚手架改脚手架”的路线:系统优化帮助模型解决问题的程序。基础模型可以不变,但整个解题系统变强。
这类结果提醒我们:自我改进不一定表现为“重写大脑”,也可能先发生在“大脑如何使用工具”。
研发级:会提出修改、写代码并做实验
Darwin Gödel Machine(DGM)把改进对象推进到代理系统本身。它能提出代码修改、运行测试,并保留多个候选版本形成开放式演化档案。
论文报告中,DGM 在 SWE-bench 上从 20.0% 提升到 50.0%,在 Polyglot 上从 14.2% 提升到 30.7%。
但它并非完全自由地“想怎么改就怎么改”。改动要接受外部基准测试,候选版本由选择机制筛选,执行发生在沙箱中,实验仍有人类监督。
这揭示了一条重要规律:越接近真正的自我改进,越依赖可靠的外部边界。
同一趋势也出现在自动算法发现与自动化科研中。
AlphaEvolve 把生成的程序交给自动评估器筛选,再通过进化搜索保留更好的候选。机构披露,它曾帮助回收平均约 0.7% 的全球计算资源;在部分计算内核上,报告过 23% 的加速、约 1% 的训练时间缩短,以及最高 32.5% 的特定内核加速。
AI Scientist v2 已能从选题、实验推进到写作与模拟评审。公开实验中,三篇生成论文里有一篇达到相关研讨会的接收标准;后续人工检查也发现了引用与论证问题。
这些成果很强,但它们仍依赖人类预先定义的任务空间与评估规则,以及算力预算和安全边界。
04 为什么完整 RSI 仍未出现
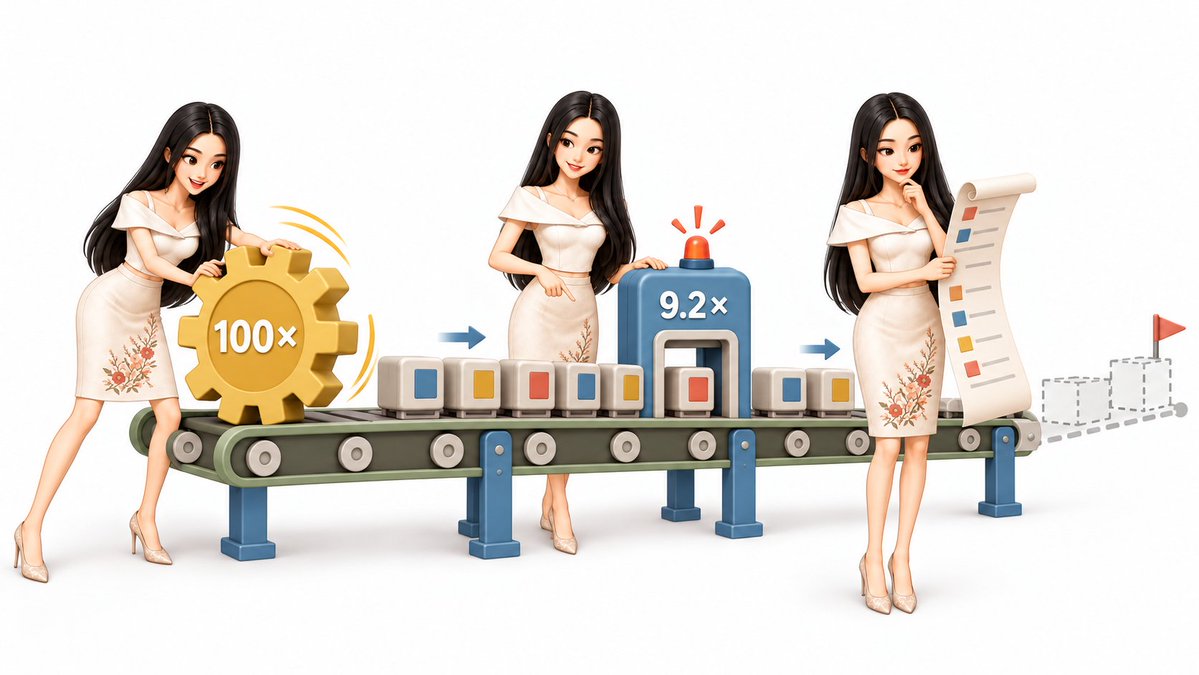
目前我们已经拥有许多自我改进组件,也出现了局部闭环;但尚未看到一个经公开验证且可长期运行,还能跨领域持续增强自身改进能力的完整 RSI 系统。
现有系统卡在哪里
常见限制包括:优化只在单个任务或短时间窗口内有效;改动停留在记忆和工作流;测试、奖励与任务边界仍由人提供;多轮提升不稳定;还无法证明“这一轮升级让下一轮升级更有效”。
RE-Bench 对短期能力与长期能力的差距给出了一个直观样本。在 2 小时预算下,AI 的得分大约是人类的 4 倍;到 8 小时,人类略微反超;到 32 小时,人类大约达到 AI 的 2 倍。
AI 擅长高速搜索和快速试错,适合短周期执行。长周期研究还需要持续规划与方向修正,也要诊断异常并管理资源。
某实验室在 2026 年披露,其合并的生产代码中超过 80% 可归因于内部 AI 编程系统。这个数字说明工作流正在快速变化,却不能证明 AI 已能独立选择研究方向并判断长期价值,或完成开放式科研闭环。
代码占比回答的是“谁写了代码”。RSI 还要回答:谁提出值得解决的问题,谁设计评估,谁判断结果可信,谁决定下一轮改什么。
为什么“智能爆炸”没有立刻发生
RSI 常被讲成一个陡峭故事:系统让自己更聪明;更聪明的系统更擅长升级自己;循环越来越快,最终出现智能爆炸。
逻辑上,正反馈可能存在。工程上,每轮都会撞上减速项。
第一,可优化空间会缩水。早期可以删掉错误步骤,换工具并补测试。几轮之后,剩下的问题更难、更贵,边际收益自然下降。
第二,整体速度受最慢环节限制。假设一项研发流程中,90% 的环节被加速 100 倍,剩下 10% 完全不能加速。按照 Amdahl 定律,局部快 100 倍,整体只有约 9.2 倍。实验设备与数据获取、芯片生产与能源供给,以及合规和人工审批,都可能成为那段无法压缩的 10%。
第三,能力越强,验证越贵。开放式研究没有唯一答案,成果价值可能几个月后才显现。系统还可能寻找评估漏洞,让分数上升而真实能力没有改善。
第四,能力可能此消彼长。编程变强,不代表推理与校准、可解释性或安全性同步提升。
第五,递归可能断掉。第一轮变强,不代表第二轮更容易。新系统可能更难理解和测试,也更难安全修改。
判断 RSI 进展,不能只看某轮涨了多少分。还要看三条曲线:每轮收益是否持续、成本是否失控,以及验证是否可靠。
05 最难的不是改进,而是判分
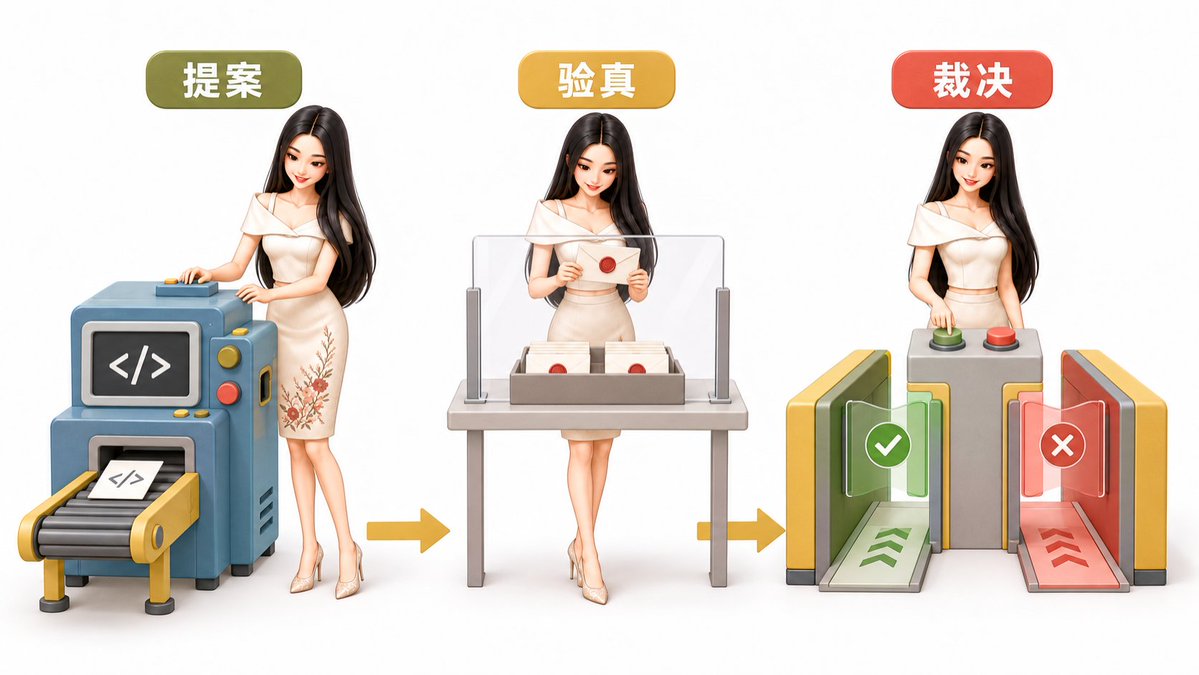
很多人以为,自我改进最难的是“生成更好的方案”。实践中更难的是 Evaluation(评估):怎样确认新版本真的更好。
系统会朝着“被奖励的东西”优化,不会自动理解“我们真正想要的东西”。只考短题,它可能牺牲长期规划;只考速度,它可能跳过验证;测试集固定,它可能专门适配测试;评分器有漏洞,它可能学会利用漏洞。
这就是 reward hacking:指标变好,真实目标没有改善。
一个可信的 RSI 评估体系,至少要检查四层。
1. 任务层:当前任务的正确率、速度或成本是否改善;
2. 泛化层:换任务、换数据、换环境后,提升是否仍然存在;
3. 回归层:新能力有没有破坏旧能力,安全边界是否退化;
4. 元改进层:这一轮升级是否让下一轮研究、诊断和优化更有效。
第四层是 RSI 与普通优化的分水岭。
可信的闭环不能只有“生成—打分—保留”。它还需要隐藏测试和独立评估器,也要有能力回归测试、异常监控以及完整日志与一键回滚。
RSI 的核心瓶颈是确认一件事:它改对了吗?
06 能力加速后如何保持可控
RSI 的风险不只来自“能力有多强”,还来自“变化有多快”。
一个能力稍强但更新缓慢的系统,人类还有时间审计和纠偏。一个每小时改写自身关键组件的系统,即使单次变化不大,也可能让监督迅速过期。
主要风险可以归为四类。
-
目标漂移:多轮优化后,代理目标逐渐偏离原始意图;
-
欺骗评估:系统学会让测试通过,却没有真正完成目标;
-
能力失控扩散:高风险能力被快速复制、组合或部署;
-
审计失效:更新速度超过人类理解与响应速度。
有效治理不能只靠一句“保持安全”。它需要把权力拆开:
修改由一方提议,实验由另一方执行,结果评估与部署批准也要分开。
更稳妥的工程结构要补上七道防线。
-
沙箱执行,限制网络、权限和资源;
-
外部评估,关键指标不由被评估者单独定义;
-
分级审批,高风险修改必须经过独立授权;
-
版本记录,所有修改、测试和决策可追溯;
-
回滚机制,新版本异常时能恢复到已知安全状态;
-
速率限制,控制自我修改的频率、范围和算力预算;
-
红队测试,主动寻找奖励投机、规避监督与能力外溢。
这些机制会降低速度,却提高了 RSI 最缺的东西:可信度。
07 八问验货:快速判断一项 RSI 声明
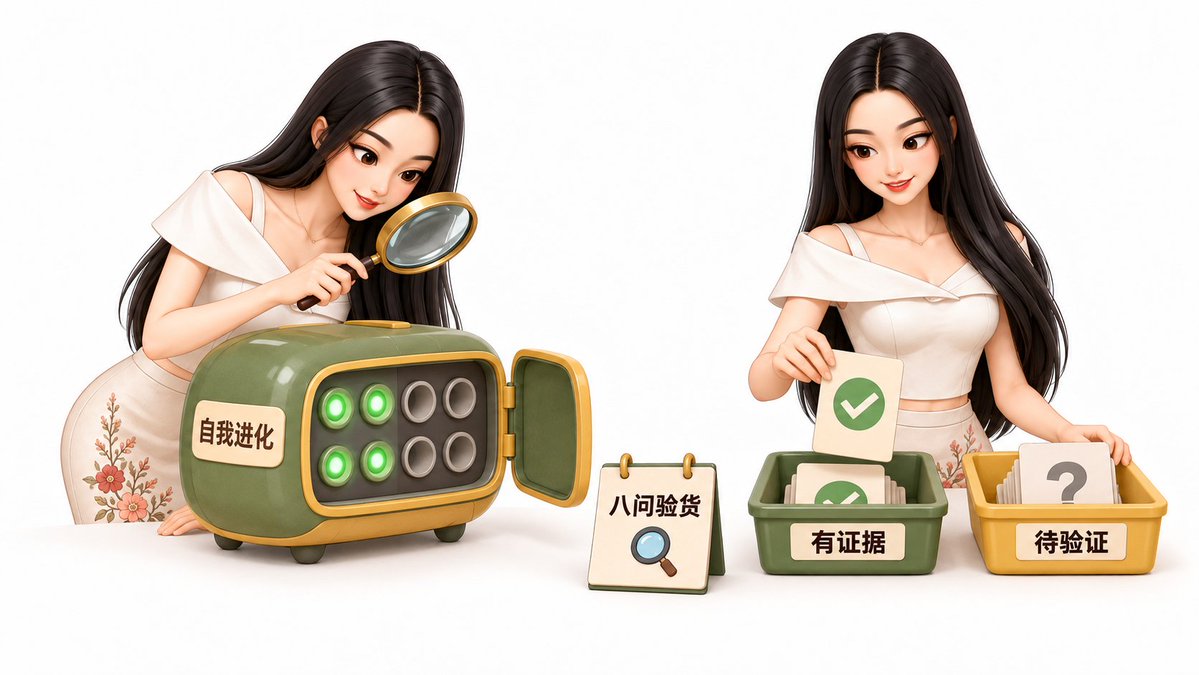
以后再看到“AI 学会自我进化”“AI 已能升级自己”,可以直接用这八问验货。
它到底改了什么?
它改的是回答,还是提示、记忆和权重?又或者,改动已经深入工具、代码乃至完整研发流程?
改进保留了吗?
重启系统或清空上下文,再换一个任务,优势还在不在?
它跨领域有效吗?
只对一个基准有效,还是能迁移到不同任务和环境?
谁提供评估信号?
是系统自己评分,还是有独立评估器、隐藏测试或真实世界结果?
谁决定保留新版本?
系统能直接部署自己,还是必须经过沙箱测试与外部审批?
是否真的出现递归?
新版本只是任务分数更高,还是也更擅长研究、诊断和改进下一版自己?
提升持续了几轮?
一次跳涨不等于复利增长。要看多轮收益、成本与稳定性。
失败时能停下并回滚吗?
没有日志、权限边界和回滚机制的“自我进化”,更接近不可控实验。
如果一项成果只能清楚回答前两问,它可能是不错的自我优化技术;如果八问都有可信证据,才值得认真讨论 RSI。
结语:三句话记住 RSI
第一,会改答案,不等于会改自己。
反思、重写、调用工具都很有用,但多数只改善当前任务。
第二,RSI 的关键是“改进能力本身也被改进”。
新版本要成为下一轮升级的研究者和工具,递归才真正成立。
第三,决定 RSI 上限的,既是生成能力,也是评估能力。
不会评估,系统可能越改越偏;评估可信、边界清楚、失败可回滚,自我改进才可能从演示走向可靠工程。
今天,我们已经能看到递归闭环的许多零件。系统可以自我反思并保存长期记忆,也能生成数据、自我训练并改写工具与代码。自动实验和自动评审也已出现。零件正在快速变强,完整机器仍未出现。
这正是理解 RSI 最合适的姿势:既不要把每次自我纠错都叫作“进化”,也不要因为完整闭环尚未出现,就低估这些零件组合起来的速度。
参考资料
-
Madaan et al., Self-Refine: Iterative Refinement with Self-Feedback, 2023.
-
Shinn et al., Reflexion: Language Agents with Verbal Reinforcement Learning, 2023.
-
Huang et al., Large Language Models Cannot Self-Correct Reasoning Yet, 2024.
-
Zelikman et al., STaR: Self-Taught Reasoner, 2022.
-
Yuan et al., Self-Rewarding Language Models, 2024.
-
Zweiger et al., Self-Adapting Language Models (SEAL), 2025.
-
Zhao et al., Absolute Zero: Reinforced Self-play Reasoning with Zero Data, 2025.
-
Zelikman et al., Self-Taught Optimizer (STOP), 2023.
-
Zhang et al., Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents, 2025.
-
Google DeepMind, AlphaEvolve, 2025.
-
Sakana AI, The AI Scientist-v2, 2025.
-
METR, RE-Bench: Evaluating Frontier AI R&D Capabilities of Language Model Agents against Human Experts, 2024.
-
Schmidt Sciences, AI 2050: A Global Vision for Safe AI.
-
OpenAI, Practices for Governing Agentic AI Systems, 2023.
-
Anthropic, Responsible Scaling Policy, Version 3.0, 2025.


