
从一次 Batch Size 争论,思考 SGLang Omni 的性能验证与调度取舍
文章目录
在《重新审视 CPU 资源作为语音模型 Serving 过程的一等公民》一文中,我们讨论过一个颇为尴尬的问题:同一个 commit 的吞吐可以随着主机争用大幅变化,如果连测试环境都没有控制好,所谓的优化可能只是恰好赶上了机器比较空闲。看上去是 CPU 资源的争用问题,其实更本质的思考在于,如何为我们的性能验证提供一个严谨的单一变量实验环境。同一个 commit 的性能可能受到 CPU 可用资源和争用程度这些难以察觉的变量的影响,更何况是各类模型 serving 的参数这些显性的变量呢?
这几天,我们围绕 MiniCPM-o 4.5 模型的 Code2Wav batching 再次开展了一些改动不大,但是颇有意思的性能优化。简单来说,我们尝试对 Code2Wav 的 batching 参数进行搜索。逻辑上,既然我们已经不主动等待凑 batch,把 batch size 上限从 1 提高到 8,难道性能还会变差?社区同学在 A800 上观察到了这样的现象,而我在 H200 上的验证却得到相反的结果:
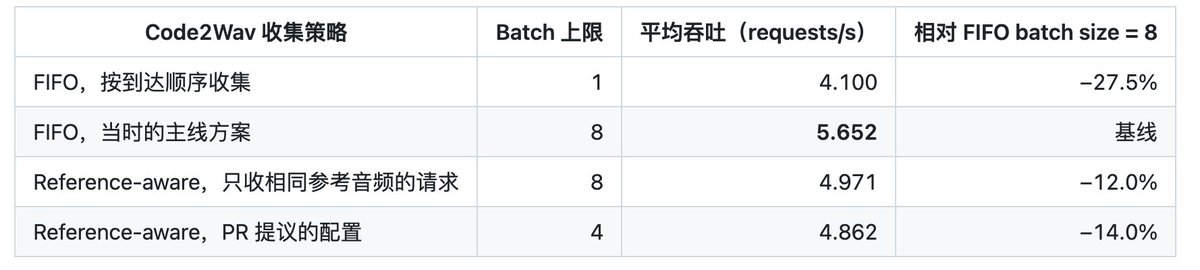
这组结果来自单张 H200、SeedTTS 完整 EN 数据源的前 200 条请求、并发 16、零主动等待,每个 mixed-reference 配置重复三次;每次启动服务后另做 50 条预热并剔除,CPU 绑定与争用检测条件也保持一致,完整实验记录可参考此处。
最初,我很有把握地认为,不等待凑 batch(max_batch_wait_ms=0),更大的 batch(max_batch_size=8)应该有收益;随着问题的深入,我们发现的 trade off 自然不止于此。因此,我们想借这篇短文,分享我们如何把一个看起来很小的参数问题,拆成可以逐项验证的控制变量科学实验,并且引出我们的一些思考。
-
区分并发数、调度 batch 与模型内部的计算 batch,理解这次争论从何而来。
-
通过三组实验,分别验证收集策略、batch 上限和计算结果的返回时机对性能的影响。
感谢朱时昊、孙哥、Charlie,以及参与 PR review、复测和机制讨论的各位朋友。这篇文章沿用当时的实验记录,其中还有没有解释透彻的地方,也欢迎大家继续提出意见。
Batch 的直观收益
正如广为人知的那样,Batching 把多条请求组织到一次处理过程中,让它们有机会共享固定开销和计算资源。对熟悉 LLM serving 的朋友来说,这个动机并不陌生:逐条处理需要反复派发工作,而合批之后,一次模型调用可以推进多条请求。不过,“组织到一次处理过程”可以发生在不同层次,仅仅看到配置里写着 Batch size = 8,完全不足以知道 GPU 实际做了怎样的计算。
在 SGLang Omni 的 benchmarking 系统中,我们需要区分客户端并发数与不同层次的 batch size:
首先是客户端的 concurrency,它限制整个系统中最多有多少条在途请求;这些请求可能正在网络上传输、做预处理、等待上游生成,也可能已经进入最后的波形生成阶段。因此,并发 16 不意味着任意一个 stage 的队列里始终有 16 条可执行请求。
进入某个 stage 后,调度器从已就绪的请求里收集一批工作,这才是本文讨论的调度 batch。就本文而言,我们讨论的实际上是 MiniCPM-o 4.5 模型的 Code2Wav stage 的 batch 操作,其 max_batch_size 是一次收集的容量上限,max_batch_wait_ms 是为了组成更大的 batch 而主动等待的时间预算。上限为 8、等待为 0,意味着每一组收集时最多拿走 8 条现成请求;上一组结束,开启下一组时,如果只能拿到 2 条,就处理这 2 条,不为剩下的 6 个位置额外等待。
当然,即使调度器拿到了 8 条,模型内部也未必能把它们放进同一次计算。输入条件、序列长度以及后端支持的 batch 形式,都可能要求继续拆组。比如仔细观察 code2wav 的 batching 实现,调度器收集的最多 8 条请求还需要按解析后的 reference audio identity 再次分组,只有 reference 兼容的请求才有机会在组内合批。一次外层调用既可能包含真正的 GPU batching,也可能只是把多个小组的执行封装在一起;前者有机会提高计算效率,后者仍有机会减少调度往返;只有组内存在多条兼容请求时,才可能进一步获得 GPU 合批收益。如果 8 条请求的 reference 全部不同,内部仍可能逐条串行计算,因此减少调度开销与提高计算并行程度需要分别观察。
此外,max_batch_wait_ms=0.0 消除的仅仅是收集阶段为更多请求进入此 batch 而预留的等待窗口。请求在队列里等待前一批执行、不同小组在同一 batch 内串行计算,以及已完成的结果等待整批一起返回,这些时间依然存在。不主动等待凑 batch,只能说明少付出了一定成本,并不意味着更大的 batch 一定更快。
MiniCPM-o 的 Code2Wav Batching 策略
上述讨论可以结合 MiniCPM-o 的 batching 策略来进一步理解。本文测试的是 MiniCPM-o 4.5 的语音生成路径,它属于我们在框架设计文章中讨论的 multi-stage 场景:从输入理解、内容生成,到音频 token 生成和波形还原,一条请求要经过计算特性不同的阶段;这次调整集中在末端的 Code2Wav stage,其他 stage 并未进行任何修改。
沿着数据流来分析,上游 Talker 产出目标语音的离散 codec token,Code2Wav 再利用这些 token 与参考音频条件生成波形。其中,Flow / CFM 先生成 mel 声学特征,HiFT 再将这些特征转换成可播放的音频。参考音频用于提供目标音色等条件,它与 Talker 生成的目标语音 token 共同组成 Code2Wav module 的输入。
最初,PR #2254 为此前逐条执行的 Code2Wav 补上了 batching 能力:调度器可以收集多条请求,模型路径也能处理多条 token 序列。不同长度的输入需要 padding,并保留有效长度来处理后续计算和输出裁剪。此外,注意到 HiFT 的实现还会按有效 mel 长度再次分组。因此,即便共享 reference,Flow 与 HiFT 实际执行的 batch 也可能不同。
在 PR 2254 之前,这条 Code2Wav 路径尚不支持多请求 batching。PR 2254 早期的 commit 引入了 batching,但是却设置默认参数为 Batch size = 1,推荐用户自行开启 batch size = 4 与 10 ms 等待。我在 PR #2264 中承接这项工作,整理实现、补充测试,并将 batching 默认开启。这是一个我经常强调的原则:
如果一个 feature 已经在明确的目标场景下验证了正确性和性能收益,就应该把它默认开启,让用户可以无感知地享受收益。开发者需要对自己的实现负责,不能只声称带来了收益,却把验证责任留给用户;无论代码是否借助 AI 完成,都应该说明适用条件,完成必要的回归验证,并清理已被替代、没有保留价值的旧 code path。如果收益尚未确认,也欢迎提交探索性的 PR,但应当公开实验条件与不确定性,不能把待验证的想法当作已经成立的优化。
PR 2254 的作者对这项工作相当负责,既提供了 batching 实现,也记录了性能与质量方面的顾虑;后续的复测,正是我们共同把适用边界弄清楚的过程。
除了默认开启和代码风格重构之外,我做出的最大变化实际上是如下的设置:
def code2wav_stage(*, gpu: int, process: str) -> StageConfig:
    return StageConfig(
        name="code2wav",
        process=process,
        factory_path=f"{PKG}.stages.create_code2wav_executor",
        factory=FactoryArgs(
            max_batch_size=8,
            max_batch_wait_ms=0.0,
            batch_wait_when_idle=False,
        ),
        # Note (Chenyang): As a general comment and my usual understanding
        # of SGLang Omni, SGLang Omni has a poor runtime which leads to a
        # underutilized GPU/SMs. To address this, we recommend users to set
        # batchs for your compute but never wait for grouping the batchs.
        # As SGLang Omni Runtime moves better, we shall probably wait several
        # ms for grouping the batchs, but right now, set it to 0.0.
        gpu=gpu,
        terminal=True,
    )
max_batch_size 允许一次收集最多 8 条,max_batch_wait_ms 则将主动等待预算设为零;batch_wait_when_idle 约束空闲时的等待行为,在当前零预算下不会额外引入等待。除开 max_batch_size 我和 PR 2254 的作者选择略有区别外,其实 max_batch_wait_ms = 0.0 才是最主要的区别。这个选择的灵感其实源自于 PR 2202 的讨论:
我的考虑是,如果为了组 batch 额外等待,希望这段时间 GPU 上仍有其他工作可做,让收集请求与计算尽量 overlap。对于 TTS 这种高频短请求,如果 GPU 已经没有可执行任务,CPU 却还在等下一条请求来凑 batch,主动等待就可能推迟关键路径。因此,在当时的 MiniCPM-o 实现上,我优先将等待预算设为零;是否应当增加等待,要看它能否换来足够的合批收益,而不能仅凭 runtime 有所改善就下结论。
作为另一个配置实例,Fun-CosyVoice3 的 vocoder 收集配置使用了 30 ms 等待预算,收集后的请求再参与 Flow 合批。它与本文 MiniCPM-o Code2Wav 的零等待配置服务于不同计算路径,不能直接据此推导哪个值更好,等待预算仍应结合各自的端到端实验评估。
回到 Code2Wav stage 的 batching 实现,正如前文所述,虽然 Scheduler 按照 FIFO 策略,在 max batch size = 8 的情况下收集请求,但是内部的 vocoder 实际不是按照上游传入的 batch 进行计算,而是要按照 reference audio 在 batch 内再次进行分组,vocode_code2wav_payloads 中的关键循环如下:
waveforms_by_index = {}
for group_indices in groups.values():
    group_waveforms = model.vocode(
        [codec_tokens[idx] for idx in group_indices],
        references[group_indices[0]],
    )
    for idx, waveform in zip(group_indices, group_waveforms, strict=True):
        waveforms_by_index[idx] = waveform
groups 将相同 reference 的请求索引放在一起;外层循环逐组调用 model.vocode,每次只传入当前组的 token 与共享 reference,再将波形写回。这个函数在所有 group 处理完成后才返回整批结果,因此先完成的 group 也要等待后续 group。讨论中,我们把这种整批统一返回造成的等待称为批内 head-of-line blocking,简称 HOL;已经生成的波形本可以更早交付,因而改变返回时机存在潜在收益。
举一个示意例子:外层收到了 8 条请求,按 reference 分成大小为 3、2、1、1、1 的五组。那么 Flow 面对的是五个小 batch;第一组完成时,属于它的三条请求仍要等后四组结束。
当然,消除 HOL 本身也存在一些代价,后文的 H200 实验会显示,两种消除 HOL 的尝试都出现了端到端回退;具体付出了哪些成本,还需要结合日志与 profiling 分析。
严谨的控制变量实验以验证 HOL 消除的收益
针对刚才的 HOL 等待,PR #2271 提出在收集阶段就跳过 reference 不兼容的请求,让每批只含一个 reference group,将这种策略称为 reference-aware batching;同时,作者把默认 max batch size 从 8 改成了 4。作者在 A800、SeedTTS-50 上的初步实验观察到,reference-aware B4 与 B8 的吞吐分别为 2.406 和 2.444 requests/s;相对 PR 中列出的历史 FIFO B8 结果 1.851 requests/s,分别提升约 30.0% 和 32.0%。若以同表中的 B1(2.226 requests/s)为基线,则分别提升约 8.1% 和 9.8%,因此必须先明确每个百分比的比较对象。
读到结论,包括作者之前在 PR 2264 中的补充试验,batch size 8 的性能甚至不如 batch size 1,我觉得有些诧异,遂决定做一些实验来验证作者的这两个结论是否正确。
-
batch size 8 的性能是否真的不如 batch size 1?
-
reference-aware batching 的性能是否真的比 FIFO batching 更好?
后者的 trade off 比较直观:reference-aware batching 需要筛选兼容请求,也可能把外层 batch 拆小、增加调度往返,这些成本需要与减少 HOL 的收益比较。至于 batch size = 8 不如 batch size = 1,我最初没有想到清楚的解释;结合前文的分组与统一返回机制看,零主动等待本身也不足以排除这种可能,仍然需要实验判断。
当然,我注意到 PR 2271 的作者的实验设计未必严谨,于是试图从中寻找一些线索:
-
PR 2271 的测试 samples 只有 50 个,而我们发送请求的 client 端的 concurrency 就是 16,这样的测试数据量可能会引发显著的测试误差;
-
如前文所述,TTS 这种高频短请求,对 CPU core 数目是高度敏感的,而且不好意思的是,可能并不是每个开发者都知道这个事情,因此我需要在重新验证的时候引入对 CPU core 数目这一变量的控制,参考 重新审视 CPU 资源作为语音模型 Serving 过程的一等公民一文中的 CPU 资源争用问题;
-
作者的实验同时变动了两个参数:一个是是否开启 reference-aware batching,另一个是 max batch size。我们应当分别控制变量来验证这两个参数的独立效应;
于是,我们保留开篇表格中的四个配置:FIFO batch size = 1 与 FIFO batch size = 8 用来观察 batching 收益,FIFO batch size = 8 与 reference-aware batch size = 8 用来隔离策略变化,reference-aware batch size = 8 与 batch size = 4 则用来观察新策略下的性能变化。
样本、预热与 CPU 共同构成实验条件
如同前文所述,50 条请求可以快速发现异常,但测试较短,启动与收尾的影响更明显,少数长句、参考音频组成和运行时波动,也更容易左右最终结果。因此,这轮实验使用 SeedTTS EN 数据源的前 200 条,包含 131 个不同 reference audio,作为实验的样本。此外,每个 mixed-reference 实验配置重复三次,每次服务启动后先完成 50 条预热,并从正式统计中剔除。预热是为了减少首次执行、缓存建立等因素对比较的干扰;重复运行则让我们看到同一配置本身会波动多少,两者解决的问题不同,不能互相替代。
GPU 之外,我们固定 OMNI_CI_CPUSET=80-95,176-191,对应当时机器 NUMA 1 上的 16 个物理核及其 SMT sibling;复用 CI 的 ContentionSampler,每两秒采样一次,核区内外来 CPU 占用峰值 peak_foreign_cores 超过 2.0 就拒绝该轮并重试。这是该实验的资源控制条件,借此固定可使用的核区,并监控外来任务的 CPU 争用。当然,此处我额外强调 CPU,是因为此前排查 CI 波动的经历已经说明,语音 serving 的短计算与高频调度对 host 很敏感:线程晚拿到 CPU,下一批 GPU 工作就可能晚发出去。只固定 GPU 型号,却任由 CPU 资源变化,几个百分点的收益很容易失去解释力。这组实验没有触发污染判定,不过两秒一次的采样仍可能漏掉更短的干扰,“通过污染检查”只意味着通过了既定检测条件。
消除 HOL 的同时,也可能打碎了调度 batch
控制上述条件后,就得到了开篇的结果:FIFO batch size = 8 相对 batch size = 1 提升约 37.9%,而 reference-aware batch size = 8 相对 FIFO batch size = 8 下降约 12%。为了理解回退的发生,考虑为什么我和 PR 2271 作者得出了相反的结论,我们进一步看服务日志:
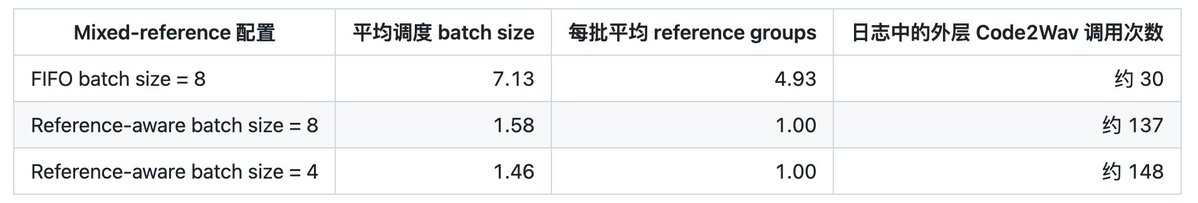
这些调用数沿用公开记录的服务日志口径,用来观察配置之间的机制差异;它们不是 GPU kernel 数,也不应直接当成恰好覆盖正式 200 条请求的计数来反推平均 batch。
在 200 条请求、131 个 reference 的流量里,收集窗口中同时出现多个相同 reference 的机会有限。Reference-aware 虽然保证了 groups=1,却经常只能收进一两条请求,batch size = 8 的容量大部分没有用上;FIFO 则把多个 reference group 留在同一次外层调用中,仍然逐组计算,但减少了反复退出计算路径、收集下一批、派发和返回的次数。
粗看这笔账,外层调用从约 30 次变成约 137 次,增加到约 4.6 倍;这不代表总开销增加到 4.6 倍,却说明被消除的 HOL 批内等待有明确的交换成本。日志支持的解释是,在这次 H200 workload 中,FIFO 摊薄外层开销的收益占了上风,因此这次以拆分调度 batch 减少 HOL 的尝试出现了回退;至于差额有多少来自 Python、通信、同步或 GPU 执行,还需要更细的 profiling 才能分清。
为了进一步检验 reference 混合程度的影响,我们用 --no-ref-audio 做了一个共享默认 reference 的对照。batch size = 8 下,FIFO 与 reference-aware 分别为 7.122 和 7.069 requests/s,只差约 0.7%;去掉 reference 差异后,两种策略趋于接近,支持前面的机制解释。不过这个对照也改变了输入与参考条件处理,重复次数有限,不能仅凭它排除所有其他影响,具体结果可以参考对照结果。
Batch 上限的独立验证
既然 reference-aware 在这组流量下很难形成大 batch,它的 batch size = 4 与 batch size = 8 接近就不奇怪了;但这还不能说明 FIFO 的上限是否应该从 8 改成 4,所以我们保留主线 FIFO,单独再做一轮 batch-size 实验。
这一轮仍使用 H200、并发 16、零等待、CPU 绑核及两秒一次的争用检测,换到 GPU 0 与 OMNI_CI_CPUSET=48-63,144-159,每次预热 16 条。由于 GPU、CPU 核区和预热数量与上一轮不同,两轮数据只能分别解读,不能合并成同一实验的重复样本。
先看官方 SeedTTS-50 的三次重复,FIFO batch size = 1 吞吐为 3.689、3.811、3.988,batch size = 8 为 4.406、4.816、4.819 requests/s,均值分别为 3.829 与 4.680,batch size = 8 提升约 22%。这里也能看到短测试的波动:batch size = 1 最高与最低相差约 8.1%,batch size = 8 相差约 9.4%(均以最低值为分母),因此拿一轮结果来判断百分之几的变化,依据远远不够。
随后,我们测试了完整 EN 数据源的不同长度前缀,得到下面的趋势:
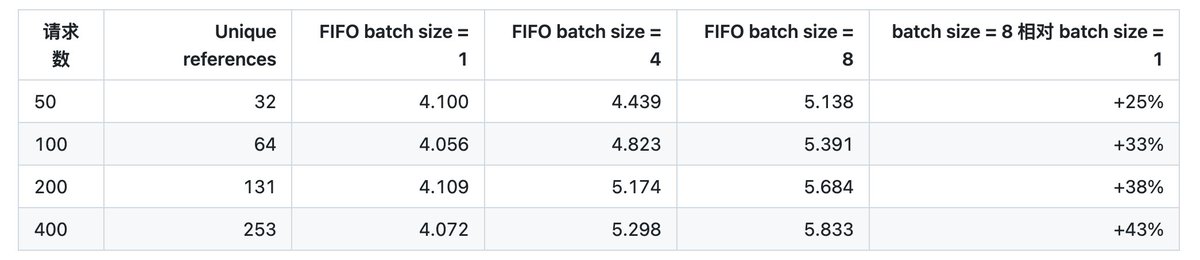
吞吐单位均为 requests/s。本表每个配置仅运行一轮干净实验,用于观察趋势;完整 EN 的前 50 条与官方 SeedTTS-50 不是同一份 workload。 独立实验记录可参考此处。
这些结果支持在当前 H200 条件下保留 batch size = 8,却还不足以宣布 batch size = 8 是普遍最优配置。样本前缀变长时,运行时长、reference 组成、句长分布与收尾占比都会变化,不能把提升从 25% 增至 43% 全部归因于“样本更多”;同样,这里没有穷举更大的 batch size,也没有搜索非零等待时间。
至于 A800 上为何出现不同结果,目前硬件、host 环境与实验流程还没有完全对齐,我们不能只因为换了一张卡,就把差异归因于 GPU 架构。更稳妥的做法是拿同一份输入、代码和测试流程跨机器复测,再看具体成本发生了怎样的变化;H200 上的结果给出了一个需要解释的对照,这并没有让 A800 上的观察失去价值。
提前返回结果,会改变后续请求的到达
FIFO 的外层开销更低,但批内统一返回仍然存在等待,于是我又尝试了一种折中方案:保留 FIFO 收集和组内计算,只在每个 reference group 算完后立即返回该组结果,更直接地尝试减少结果等待。这个 early-emit 方案不需要在收集时筛选 reference,看起来能够保留大部分已有收益,同时让已经完成的请求早点离开。
这次我在同一份实验代码上用开关控制 wait-all 与 early-emit,固定 H200、前 200 条请求、并发 16、零等待和相同 CPU 核区,每次启动后剔除 50 条预热;mixed-reference 两组各重复三次,均通过 CPU 污染检查。结果如下:
返回策略,均为 FIFO batch size = 8平均吞吐(requests/s)平均延迟(s)平均 reference groupsGPU utilizationWait-all,整批完成后返回5.7302.7394.96约 74%Early-emit,逐组完成后返回4.7293.2915.08约 89%
提前返回后,吞吐下降约 17.5%,平均延迟增加约 20.1%,实际收集的 batch size 仍然约为 7,reference group 数也基本一致,实验设置与完整结果参考此处。
对于这一情况,我能够想到的解释如下:
在本次 MiniCPM-o 测试配置中,Thinker、Talker 与 Code2Wav 共享一张 GPU,客户端采用 closed-loop,并发上限为 16。每完成一条请求,客户端才释放对应的并发名额并补发下一条,因此返回策略会影响后续请求进入 server 的时间。
沿用前面 8 条请求分成 A 到 E 五组的例子。Wait-all 会让 Group A 算完后仍坐等整批结束,这 8 条请求的并发名额一直占用到最后一起返回,对应的补发因此被推迟:
time → Group A ████ Group B ████ Group C ████ Group D ████ Group E ████ └──────── 8 条一起返回 ────────┘
不过,系统中另外的在途请求仍可能执行上游计算或完成并触发补发,因此不能由此断言 GPU 被 Code2Wav 独占。
Early-emit 则会在 Group A 完成后先返回它的 3 条结果,允许客户端更早补入对应的新请求。新请求经过网络与预处理后,其 Thinker / Talker 工作可能与剩余的 Code2Wav 计算发生资源竞争,从而拉长后续组的完成时间:
time → Group A ████ → 立刻返回 A Group B ██████ ← 被新的 prefill 拉长 new thinker ████████ Group C ██████ Group D ██████ Group E ██████
这是一种与实验现象相符的解释,但现有数据尚未证明新请求的 prefill 是否构成主要干扰,更不能将 17.5% 的损失全部归因于它;返回路径自身的开销,以及 Thinker、Talker、Code2Wav 之间具体怎样交叠,仍需 GPU 时间线来验证。共享 reference 的单轮对照中,wait-all 与 early-emit 分别为 7.087 和 6.994 requests/s,相差约 1.3%,也与“一个 group 时提前返回的空间很小”相符,但同样不能代替完整的因果验证。
还有一个很值得注意的现象:early-emit 的 GPU utilization 更高,完成请求却更少。GPU 更长时间处于忙碌状态,但这不意味着更有效地完成了用户工作;当多个阶段共享资源时,我们最终要观察的仍然是端到端吞吐、延迟和质量,不能把利用率上涨直接当成优化成功。
最后,经过两天的研究,我们的优化方案没有任何变化,还是选择在 H200 上的 FIFO,batch size = 8 且 max batch wait time = 0 😂,看上去我们毫无进展:
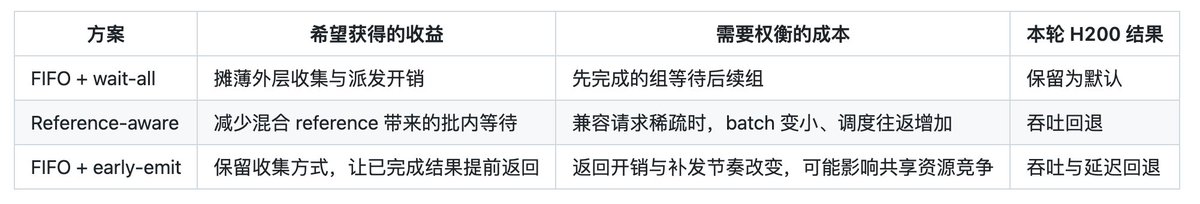
我们希望怎样验证一次优化
前面几组实验已经足以支持一个工程决定:在这次 H200 测试条件下,保留 FIFO batch size = 8、零主动等待;它们也留下了几个需要继续工作的边界,包括 A800 与 H200 的差异、early-emit 的具体资源竞争。我觉得,严谨开发很重要的一点,就是理解请求在各阶段的完整生命周期,并据此设置严谨的控制变量实验。
首先,“变快了多少”需要与“原本会波动多少”一起报告。Reference-aware batch size = 4 与 batch size = 8 在策略实验中只差约 2.2%,而该组记录的跨轮吞吐波动约为 3%–7%,我们没有足够把握据此判断两者存在稳定差异;12%–14% 的策略回退和 17.5% 的 early-emit 回退更值得重视,但幅度大于观察到的波动,也不自动等于完成了统计显著性检验。
如果要对更小的收益下结论,就需要增加独立重复,交错或随机安排 A/B 运行顺序,报告每轮差异和置信区间。同一轮里几百条请求共享排队、资源竞争和环境变化,不能简单把它们当成几百次独立实验;样本数增加与实验轮次增加,都有价值,但提供的是不同的证据。
质量验证也不能因性能结果漂亮而放松。PR 2271 曾在 batch size = 8 下观察到两个短句 WER outlier。WER 用替换、删除和插入的词数除以参考文本词数,短句的分母小,确实容易因少量错误发生大幅变化。比如一条 4 词短句出现 3 个词错误,WER 就达到 75%。观察到性能上的潜在收益时,一定要小心正确性是否会受到影响。
我在群里的第一反应也倾向于把这些 outlier 理解为随机误差;写成完整的实验结论时,还需要回到异常样本,配对检查生成音频、ASR 转录和文本归一化,并通过重复运行判断问题能否稳定复现。Batching 涉及 padding、有效长度和输出对应关系,这些地方都值得检查,性能数据不能替代质量 gate。
当然,即便工程实现正确,改变 batch 形状也可能改变 kernel 选择或浮点归约顺序,使同一输入产生略有差异的数值结果,PyTorch 的数值精度说明也专门讨论了批量计算与逐项计算的差异。Batch invariance 指同一输入的计算结果不随 batch 大小或组成变化;这里需要警惕的是缺乏这种不变性。 这类差异不限于 neural encoder,也可能出现在 decoder、Flow 或 vocoder 中,但数值不同不必然意味着质量下降,更不能直接解释本次的 WER outlier,仍需对具体路径和样本进行验证。关于推理数值差异的相关讨论,也可以参考我们团队的文章RL 训推不一致的根源其实在 inference 系统中广泛存在。
这些要求最终都应该进入我们的日常开发流程。PR 需要让 reviewer 知道改动了什么、与哪个基线比较、输入和环境是什么、预热与污染轮次怎样处理,并能沿着日志找到实际 batch、分组和返回行为。像此前的 TTS 重构把重复的生命周期管理沉淀进框架一样,我们也希望把可靠的测量方法沉淀进 benchmark 和 CI,让下一位贡献者能够复用,而不必重新猜一遍哪些条件会影响结果。
我们仍然希望,SGLang Omni 开发者能够对经过验证的优化有信心,把适合目标场景的参数设为默认值,减少让用户自行摸索的负担。这份信心来自能够复现的证据,也来自愿意公开不符合预期的结果;reference-aware 和 early-emit 没有在这轮实验里胜出,仍然帮助我们理解了调度成本与反馈关系,社区贡献的价值并不止于最终有没有合入。
如果你也对这样的工作感兴趣,非常欢迎参与 SGLang Omni 的开发。可以从复现一组跨硬件的对照开始,也可以补全一段 GPU 时间线,研究 reference 分布对 batch 的影响,或者用带时间戳与复现步骤的 issue,验证客户端补发节奏是否会让实际 batch size 周期性重复。这里既需要熟悉 kernel 的朋友,也需要愿意认真检查 benchmark、异常样本和调度细节的朋友。
我们期待一起建设的推理框架,能够说清楚优化为什么有效,条件改变后又为什么失效。把一个反常结果追到可以解释、可以复现,再把这些认识写进代码和测试里,本身就是很扎实的系统工作,也正是我希望更多朋友在 SGLang Omni 中共同完成的工程训练。


