
Jev 工程化:从零搭起 AI 的「新大脑」—— 10 步完整路线图
文章目录
本文中文翻译,原作者 @0xCodila,原文链接见下。版权归原作者所有。
本文译自 @0xCodila 的百万浏览长文,建议对照原文阅读
目录
-
开场:杰文斯悖论
-
- 找出 Agent 里 Jev 能接管的部分
-
- 先在 Playground 里给它一个判断
-
- 把 API 接上一次
-
- 把一个请求变成落盘的交接
-
- 问「能带到下一步」的问题
-
- 偷 Browser Use 最好的一招:重建菜单
-
- 别再为「互相等待的问题」付钱
-
- 给过夜的工作一个「停下来」的地方
-
- 搞清楚那个「白菜价」到底买到了什么
-
- 真实用例
-
转折点
开场:杰文斯悖论
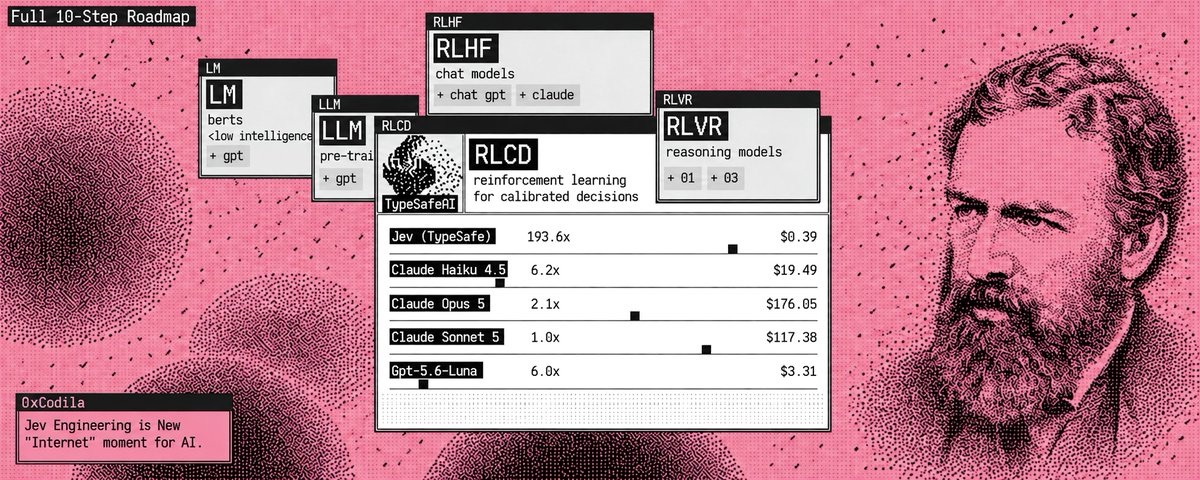
杰文斯悖论(图里那位就是杰文斯本人)说的是:一项资源的使用效率提高,不会减少它的总消耗,反而会让总消耗增加。
这正是 AI 今天面临的全局问题 —— 大模型和 Agent 都逃不掉。
而 @typesafeai 做的 Jev,号称能帮你省下 101% 的钱和时间,同时提升你用 AI 的效率。
所以信我 —— 这是你现在就该装上的 2030 年配置。
想追更新的 alpha,订阅我的 substack:https://substack.com/@0xCodila
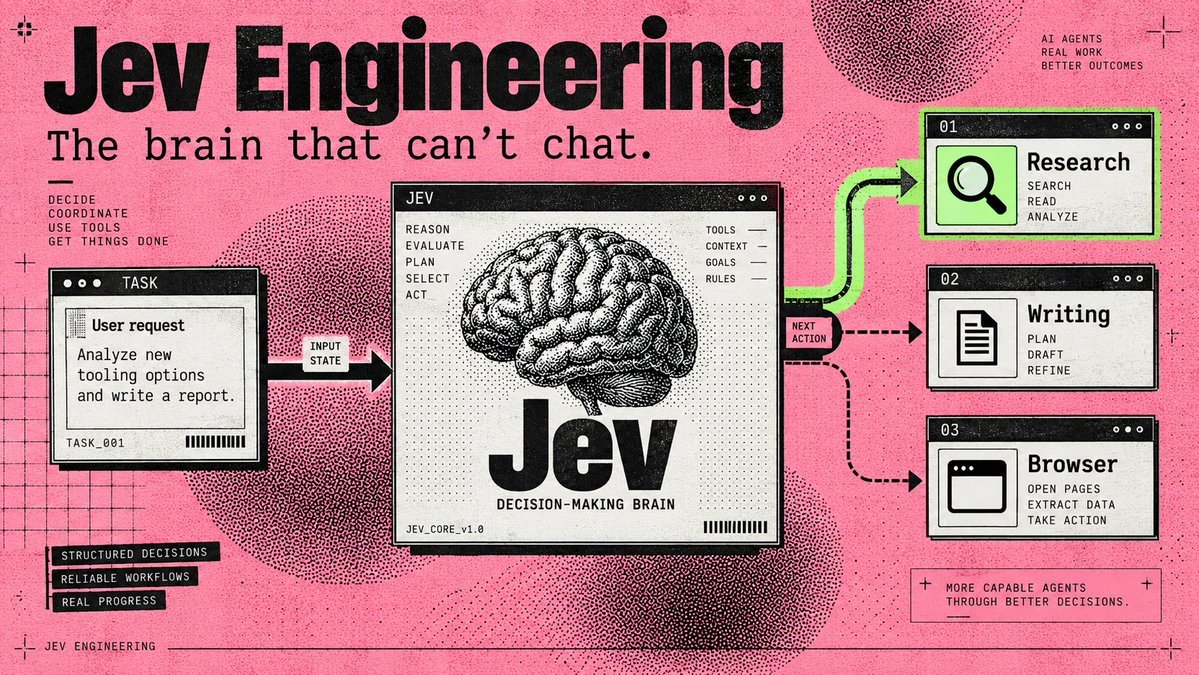
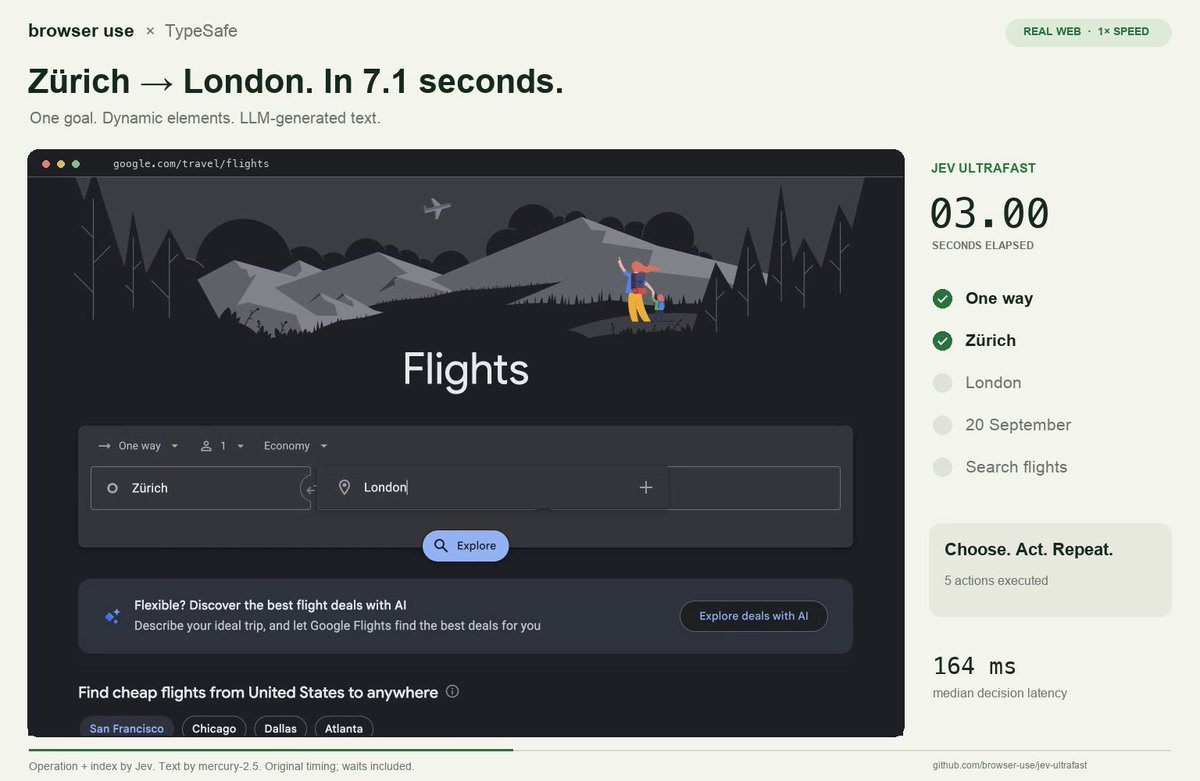
这个数据值得注意:Browser Use 把 Jev 塞进一个 Agent 里,7 秒找到了航班,花了 0.0039 美元。
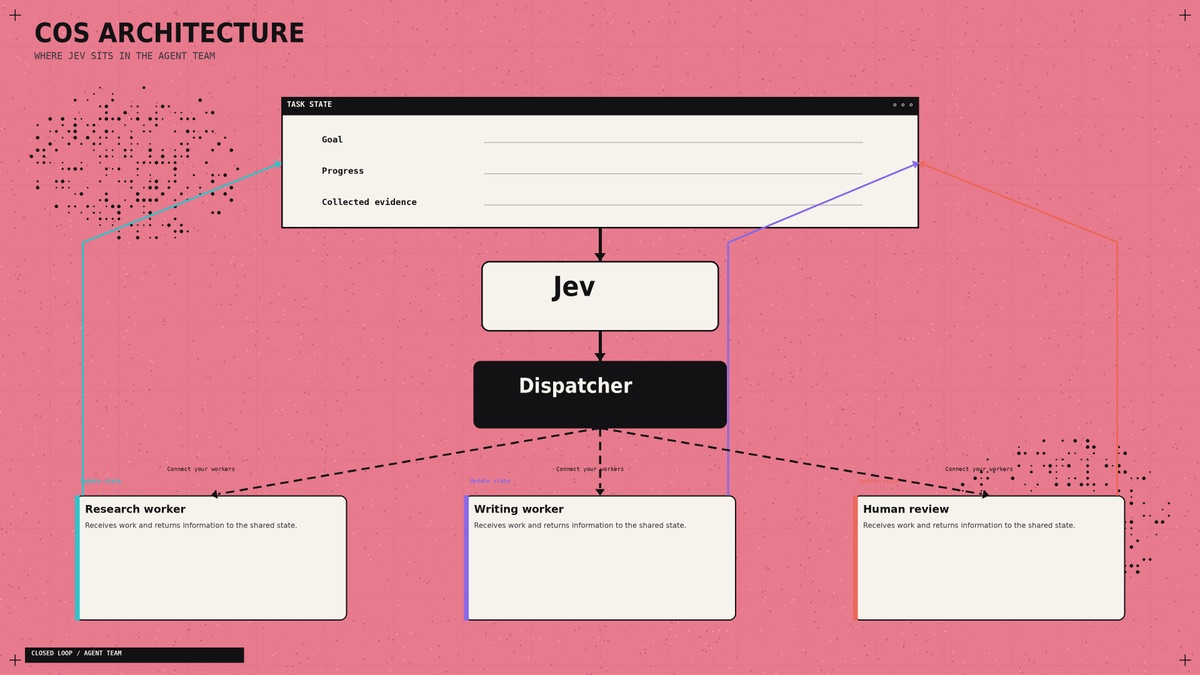
你想想一个幕僚长整天在干什么:挑一个执行者、看结果、决定要不要继续。在真正有价值的活发生之前,每个岔路口都已经烧掉一次模型调用。
Jev 给了这些判断一个专属的模型。
你的写作 Agent 继续写,研究 Agent 继续研究。它们之间那些小判断,变成一个独立组件 —— 你可以检查它、给它定价、替换它。
先从最简版本开始:一个独立的任务路由器 —— 输入一个任务,让 Jev 选目的地,把这次交接存到本地。然后再跑 Browser Use 那套完整的浏览器 Agent。(前者只要一个 API key,浏览器项目要两个。)
01. 找出 Agent 里 Jev 能接管的部分
Jev 是 TypeSafe AI 的 System One 模型:你提供信息和预先定义好的问题,它返回带类型的答案和概率。它写不了简报、生成不了代码、也不能用散文解释推理过程。
拿这样一个任务举例:
研究三款新的 AI Agent 工具,起草明天的简报。把草稿存下来供我审核。
这个任务里藏着好几个判断:资料够了吗?下一个该谁上?草稿能送审了吗?
这些就是 Jev 的候选。而抓取资料、写段落、存文件,仍然属于你的工具和生成式模型。至于「执行十次之后就停」这种确定的规则,应该写在代码里。
如果你要的是 GrokBot 那种「幕僚长」,保存下来的交接记录可以喂给已有的执行者。接上执行者是在下面这套独立配置之后的事 —— 第一次跑通不需要 Agent 团队。
02. 先在 Playground 里给它一个判断
打开 TypeSafe Playground。登录,如果你的账号需要走访问审批就先走完。
用这段作为你的 state:
Goal: Compare three AI-agent tools in a morning briefing.
Completed work: No sources collected yet.
Available workers: Researcher, Writer.
Constraint: Save drafts for review. Do not publish.
加一个 Choice 问题:「下一个该哪个执行者上?」
定义三个选项:
-
research —— 证据不足,需要补研究
-
write —— 证据已足够,可以起草
-
review —— 请求不清晰,或工作已完成
跑一次。然后把「已完成工作」那个字段换成真实的研究笔记,再比一次结果。这就是官方快速入门里描述的基础交互。
03. 把 API 接上一次
你需要一个开了 API 权限的 TypeSafe 账号,以及从 key 设置里生成的密钥。API 调用计入该账号。
装 Python 3.12 或更新版本,然后在 macOS/Linux 打开终端,Windows 打开 PowerShell。
macOS / Linux:
mkdir jev-starter
cd jev-starter
python3 -m venv .venv
.venv/bin/python -m pip install --upgrade typesafe-sdk
Windows PowerShell:
mkdir jev-starter
cd jev-starter
py -3 -m venv .venv
.\.venv\Scripts\python.exe -m pip install --upgrade typesafe-sdk
这些命令会创建一个隔离环境并装上官方 Python SDK。密钥不要写进源码,下面的脚本会私下问你要。
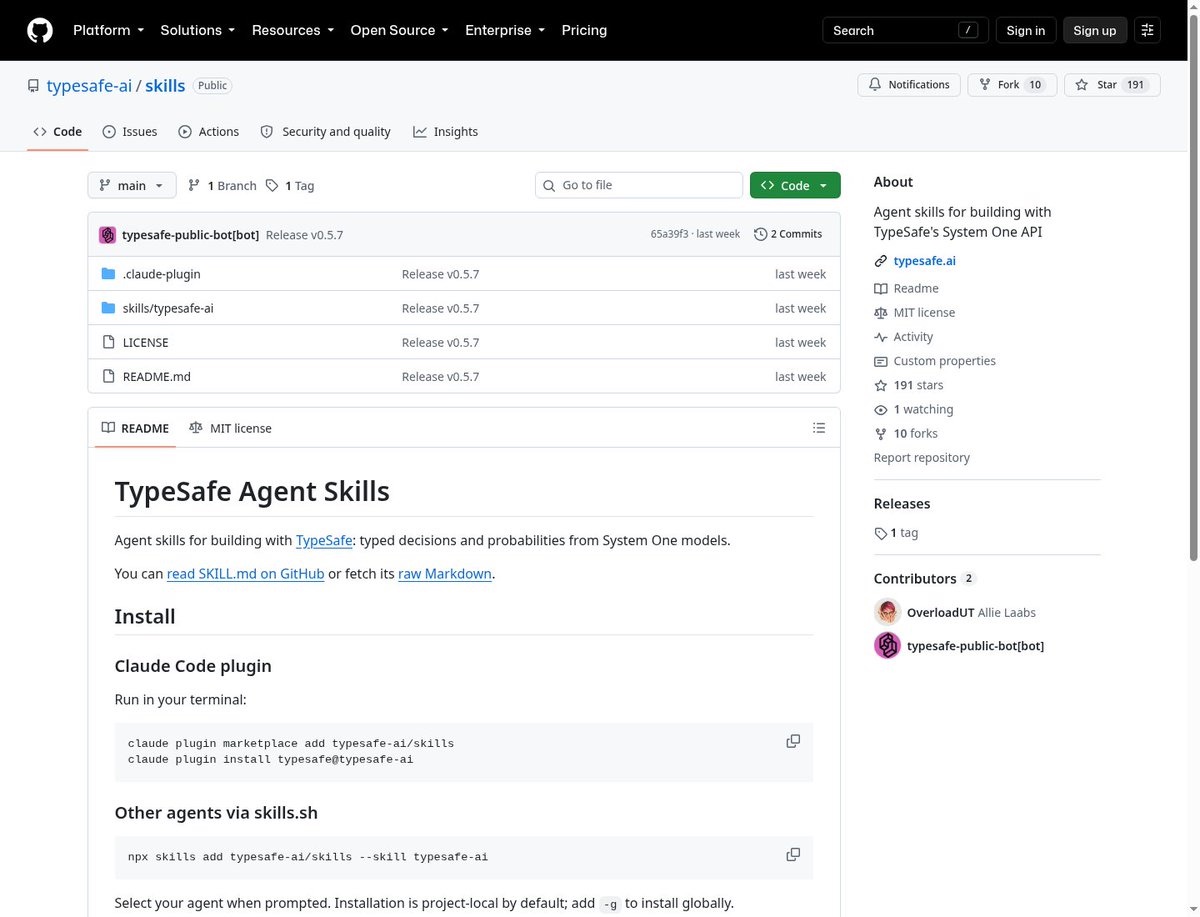
如果你用的是编程 Agent:装了 Node.js/npm 之后,加上 TypeSafe 官方 skill:
npx skills add typesafe-ai/skills --skill typesafe-ai
按提示选择你用的 Agent。这个 skill 给它集成说明,Jev 本身还是走 API。
04. 把一个请求变成落盘的交接
在 jev-starter 里创建 chief.py(放在 .venv 外面)。用纯文本编辑器,文件名叫准,别存成 chief.py.txt。
# 这个脚本的作用:输入任务和当前进度 → 让 Jev 选择下一步 → 保存 JSON 派工单。
# 注意:它只负责判断和保存,不会自动搜索资料或撰写简报。
# 运行方式:在本文件所在目录执行 .venv/bin/python chief.py
# 注释、交互提示和模型指令使用中文;程序逻辑、字段名和队列目录名保持不变。

# 一、导入工具
# json:把任务信息转换成 JSON 文本;os:读取和设置环境变量。
import json
import os
# getpass:输入 API 密钥时不在终端显示内容。
from getpass import getpass
# Path:处理文件和目录路径;uuid4:为派工单生成随机标识,避免文件重名。
from pathlib import Path
from uuid import uuid4
# Choice:定义选择题;TypeSafeAPIError:接口异常;TypeSafeClient:调用 Jev 的客户端。
from typesafe_sdk import Choice, TypeSafeAPIError, TypeSafeClient

# 二、准备 API 密钥
# 如果环境变量中没有密钥,就提示输入。粘贴时看不到字符是正常现象。
# strip() 用来去掉首尾空白。
if not os.environ.get("TYPESAFE_API_KEY"):
    os.environ["TYPESAFE_API_KEY"] = getpass("请输入 TypeSafe API 密钥:").strip()

# 三、收集任务信息(这里可以输入中文)
# 填写你想完成的目标,例如:对比三款 AI Agent 工具,整理成简报。
goal = input("任务目标:").strip()
# 如果没有填写目标,就退出。
if not goal:
    raise SystemExit("请填写任务目标。")
# 填写已完成的工作;直接回车则记为“尚未完成任何工作”。
# 例如:还没有收集资料。后续也可以填入实际收集到的资料摘要。
notes = input("已完成的工作:").strip() or "尚未完成任何工作。"
# state 是交给 Jev 判断的当前状态,包含目标和已完成的工作。
state = {"goal": goal, "completed_work": notes}

# 四、调用 Jev,让它回答“下一步应该由谁处理?”
try:
    # 使用指定模型;with 语句负责在结束时关闭客户端。
    with TypeSafeClient(model="jev-1.13.0") as client:
        result = client.system_one(
            # 把刚才填写的目标和进度传给模型。
            state=state,
            questions={
                # next_worker 是这道选择题的标识,后面用它读取答案。
                "next_worker": Choice(
                    # 指令含义:为研究简报选择下一步。
                    instructions="为研究简报选择下一步。",
                    criteria={
                        # research = 研究:收集完成目标仍然缺少的证据。
                        "research": "收集完成目标仍然缺少的证据。",
                        # write = 写作:已有足够证据,可以起草简报。
                        "write": "根据已有的充分证据起草简报。",
                        # review = 人工审核:目标不清楚、超出范围,或者工作已完成。
                        "review": "目标不清楚、超出范围,或者工作已完成。",
                    },
                )
            },
        )
except TypeSafeAPIError as error:
    # 如果接口调用失败,就显示状态码并退出,参见教程第 08 步。
    raise SystemExit(f"API 调用失败,状态码:{error.status};请参见教程第 08 步。")

# 五、读取模型的选择,再由代码决定派工单实际放到哪里
# answer.choice 是选项;answer.confidence 是模型给出的置信度,不等于准确率。
answer = result.choices["next_worker"]
# 默认交给人工审核,作为不确定时的兜底。
destination = "review"
# 只有选中研究或写作,且置信度至少为 0.85,才分派到对应目录。
# 因此,模型的 choice 与最终的 destination 不一定相同。
if answer.choice in {"research", "write"} and answer.confidence >= 0.85:
    destination = answer.choice

# 六、把派工单保存到本脚本旁边的 queue 目录
# 例如:queue/research/随机标识.json;queue 表示等待处理的任务队列。
folder = Path(__file__).resolve().parent / "queue" / destination
# 目录不存在就创建,已经存在则继续使用。
folder.mkdir(parents=True, exist_ok=True)
# 每次运行生成一个新的文件名,不会自动识别或合并重复任务。
job = folder / f"{uuid4().hex}.json"
# 派工单包含:目标、已完成工作、模型选择、置信度、实际去向和状态。
# queued = 等待处理;这里只写入状态,不代表已经启动研究或写作程序。
payload = dict(state, choice=answer.choice, confidence=answer.confidence,
               destination=destination, status="queued")
# indent=2:缩进排版,方便阅读;ensure_ascii=False 和 UTF-8:保留可读的中文。
job.write_text(json.dumps(payload, indent=2, ensure_ascii=False), encoding="utf-8")
# 提示派工单已保存,后面打印的是文件路径。
# 程序到这里结束。后续需要由人或另一个程序读取 JSON,执行实际任务。
print("派工单已保存:", job)
macOS/Linux 下运行:
.venv/bin/python chief.py
Windows 下运行:
.\.venv\Scripts\python.exe chief.py
提示时粘贴你的 API key —— 终端会把它藏起来。
「目标」填 Compare three AI-agent tools for tomorrow's briefing(对比三款 AI Agent 工具用于明日简报),「已完成工作」填 No sources collected yet(尚未收集资料)。
你会得到一行 Saved handoff: 加一个完整路径。打开那个 JSON 文件,里面有:你的请求、进度、Jev 的选择、置信度、以及目的地。
每次运行都会在 queue/research、queue/write 或 queue/review 下新建一个文件。这些是本地任务队列 —— 存下来的任务在等一个执行者来消费它。
API 调用和错误处理遵循 SDK 使用指南。我把初始的送审阈值设成 0.85 —— 你要拿自己工作流里标注过的例子来调。⚠️ 置信度不是准确率。
05. 问「能带到下一步」的问题
三类答案对应三种不同的活:
-
Choice —— 从列表里选一个。用于「下一个该谁上?」返回选中的选项、概率分布和置信度。
-
Score —— 按你定义的一条刻度打分。用于「这条资料有多相关?」返回刻度上的数值,加概率和置信度。
-
Noul —— 回答是/否。用于「这个请求需要发布吗?」返回「是」的概率,0 到 1。
定义一个相关性 Score,三档描述:不相关 / 部分相关 / 直接回答了问题。数值结果是 0 到 2,包括小数。而 Noul 接近 0.5 意味着「是/否不确定」。
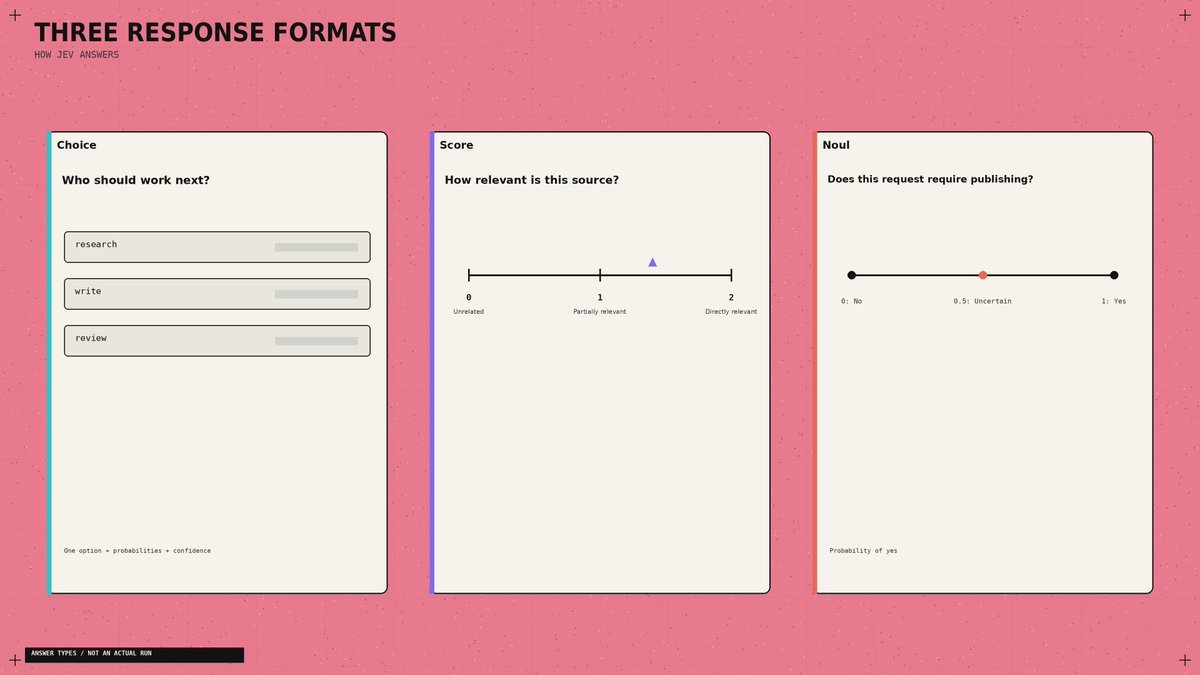
一个有用的细节:Jev 看不到你的问题 ID。 把字段命名成 safe_to_publish 不会提供任何指令。真正的要求要写进问题正文,每个选项都要描述清楚。
另外,给它证据。「研究员完成了」给 Jev 的信息,远少于把来源、发现和剩余缺口一起摆出来。把这些字段和原始请求分开。
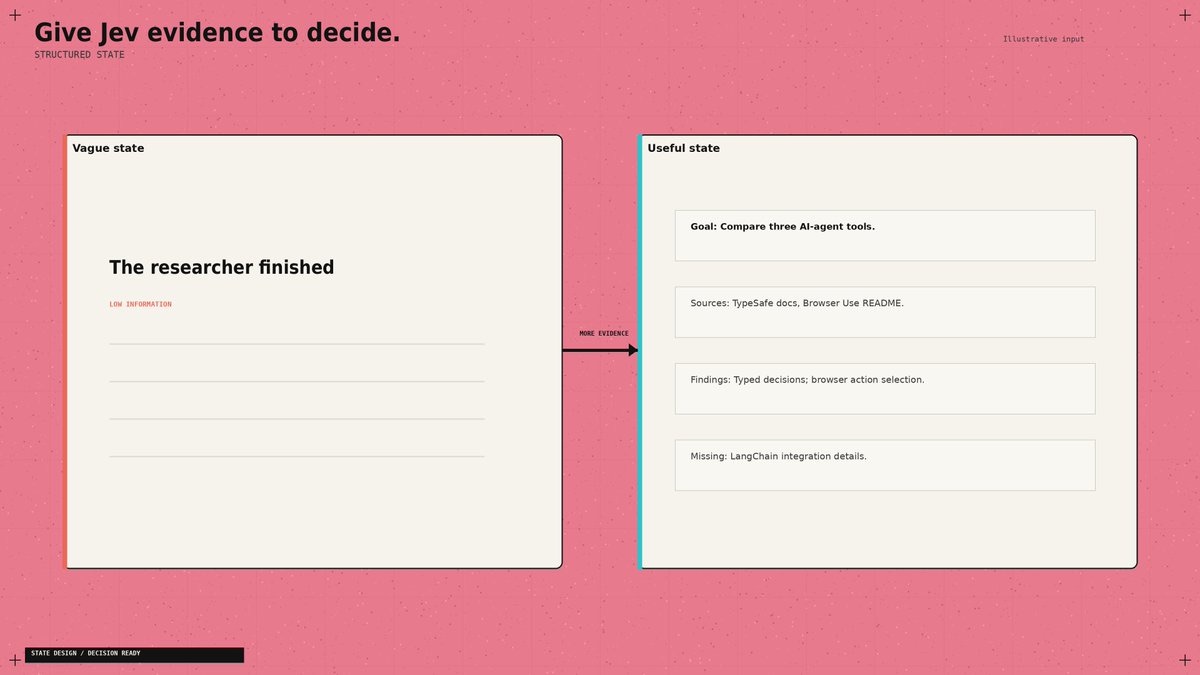
06. 偷 Browser Use 最好的一招:重建菜单
浏览器的可用动作每点一下就变。Browser Use 的做法是:每次重新构建一份「当前观测到的控件」清单,让 Jev 从这份清单里选。只有输入框需要填字时,才叫一个小模型去生成文本。
把这个设计搬到你的「幕僚长」上:选项要从「现在真实存在且可用的执行者」里构建。挑研究资料时,把当前的来源 ID 一起放进选项。工具改变了状态之后,刷新选项。
否则你的决策模型是在从昨天的菜单里点菜。
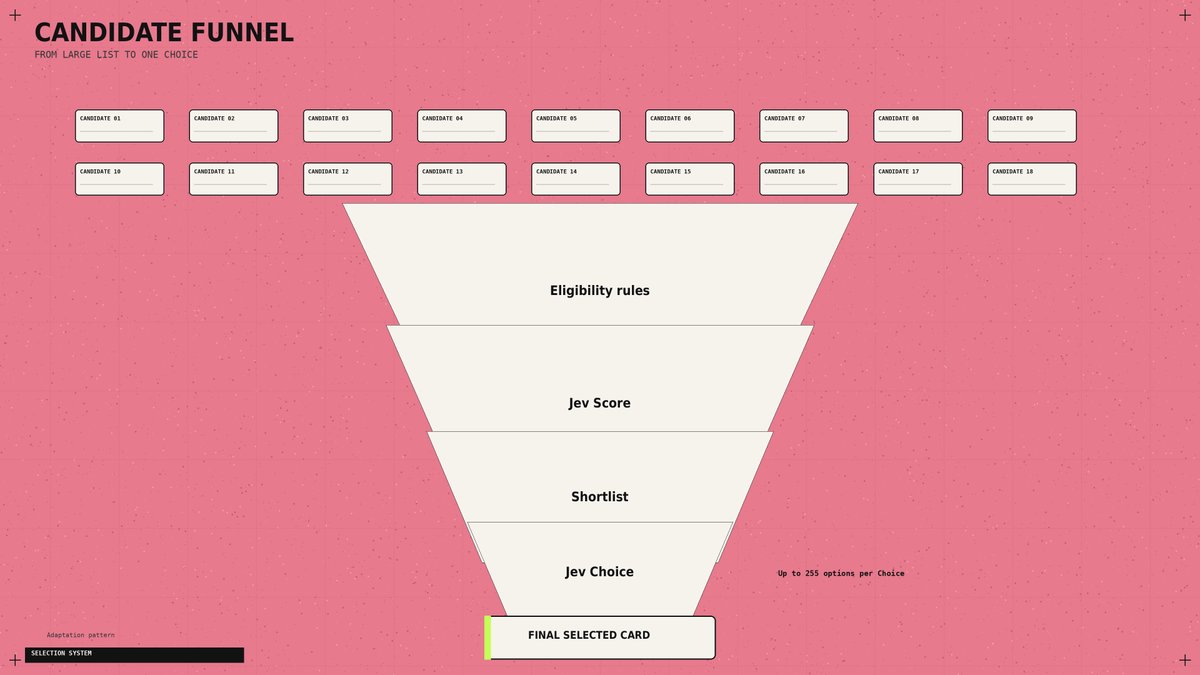
候选清单很大时:先用代码过滤掉明显不匹配的,再给剩下的打分,最后从入围名单里选。 Choice 最多支持 255 个选项。
07. 别再为「互相等待的问题」付钱
你的调度器可能需要:一个执行者、一个紧急度分数、一个审批检查。
如果这三件事看的是同一份状态,就一起发出去。 TypeSafe 支持并行提问和推测性分支 —— 把几种可能的下一步都问一遍,然后只用跟选中分支相关的那一个答案。
⚠️ 问题之间读不到彼此的答案。 如果某个判断需要一份新的搜索结果,先搜,再问。
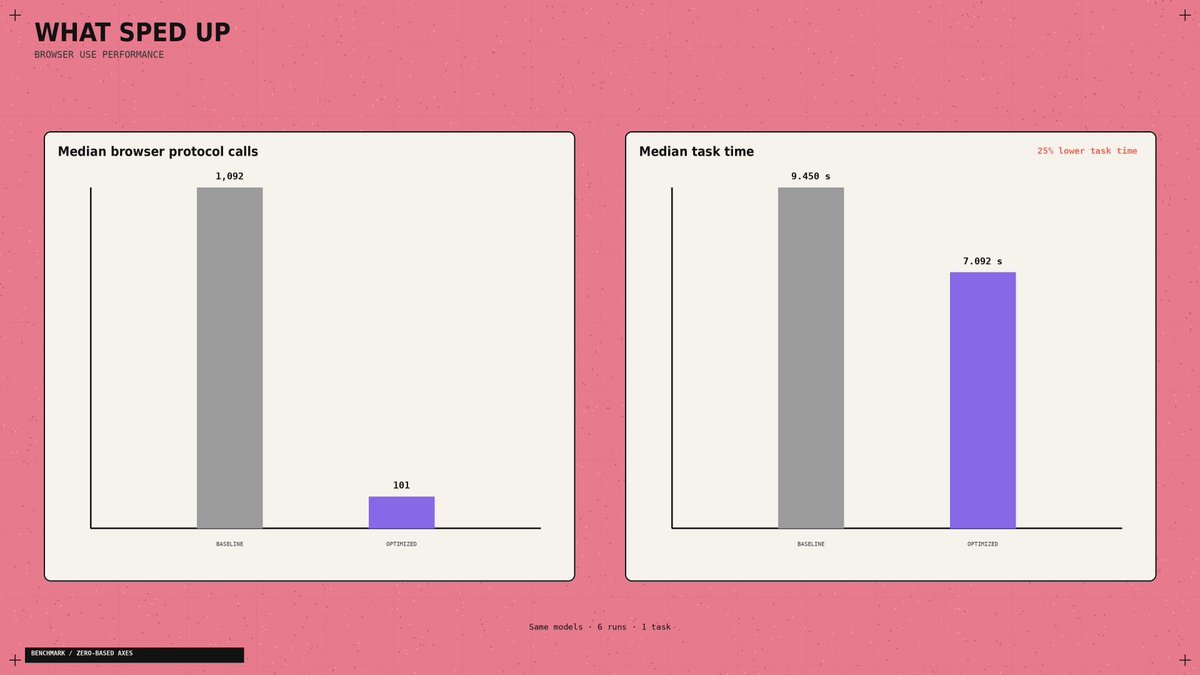
浏览器那个例子暴露了另一个瓶颈:它优化后的运行时把浏览器协议调用的中位数从 1,092 次降到 101 次,而任务耗时中位数在三个配对样本上降了 25%。两个版本用的是同样的模型。
改动包括:一次读取就收集完整页面状态、不再为无关动画做新的预测。
在花钱换更快的模型之前,先检查有没有重复的工具调用。
08. 给过夜的工作一个「停下来」的地方
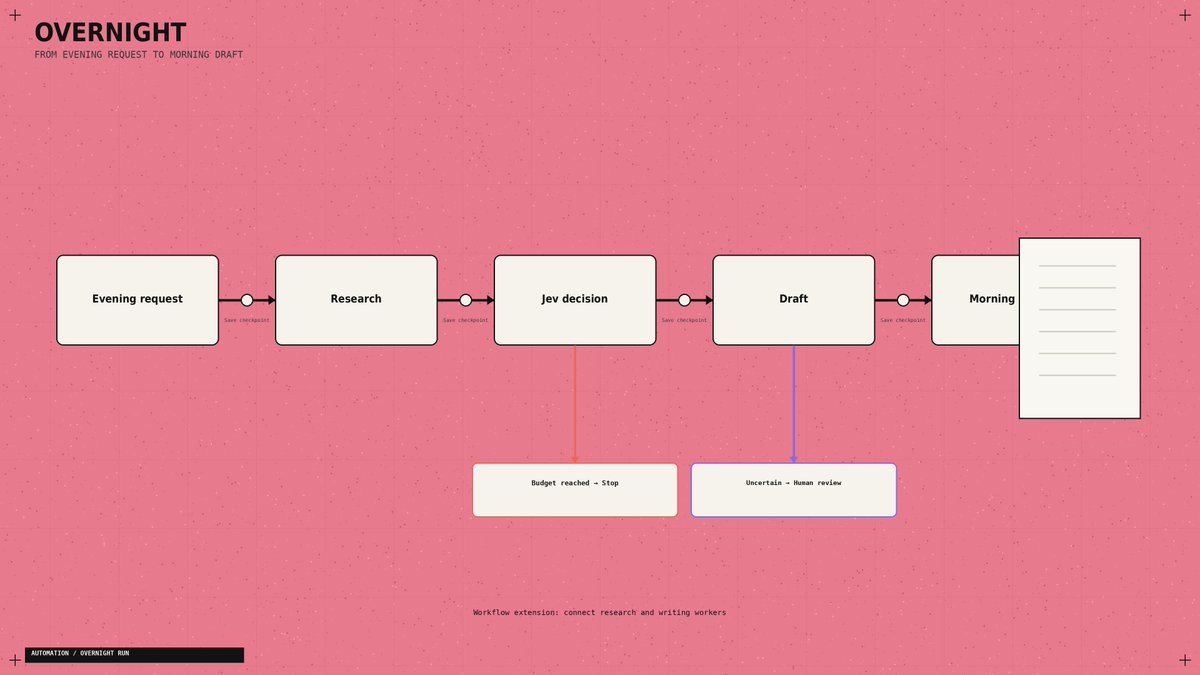
做晨间简报的话,我会允许它收集来源、创建草稿,然后停在送审。发布应该需要单独的权限检查。
应用还需要:动作上限、花费上限、以及保存进度。
被打断之后,它应该先检查最后完成的那一步,再决定要不要重做。⚠️ 一个有信心的答案,证明不了文件真的存了、消息真的发了。
Browser Use 在 Jev 选出 DONE 之后,会独立地再验证一次结果。把你自己的完成检查也照这个分开。
本地路由器跑通之后,用这段话去接你已有的 Agent:
读 TypeSafe skill,检查我的执行者接口。把 chief.py 的 JSON 队列接到已有的研究和写作处理器上。防止重复处理。每步之后保存进度。加上调用上限、花费上限、不确定时送审、以及「草稿是否存在」的完成检查。发布保持在审批之后。明确列出缺哪些连接器。
如果启动脚本报错,按错误选修法:
| 报错 | 处理 |
|---|---|
| 找不到 Python 命令 | 装完 Python,重开终端 |
| 找不到模块 | 用同一个 .venv 解释器重装 SDK |
401 | 换 API key 重跑 |
422 | 拿粘贴的代码核对报错里点名的请求字段 |
429 / 529 | 允许退避;如果限流或过载持续,稍后再试 |
SDK 自带重试;如果 API 错误仍然存在,脚本会停下。
09. 搞清楚那个「白菜价」到底买到了什么
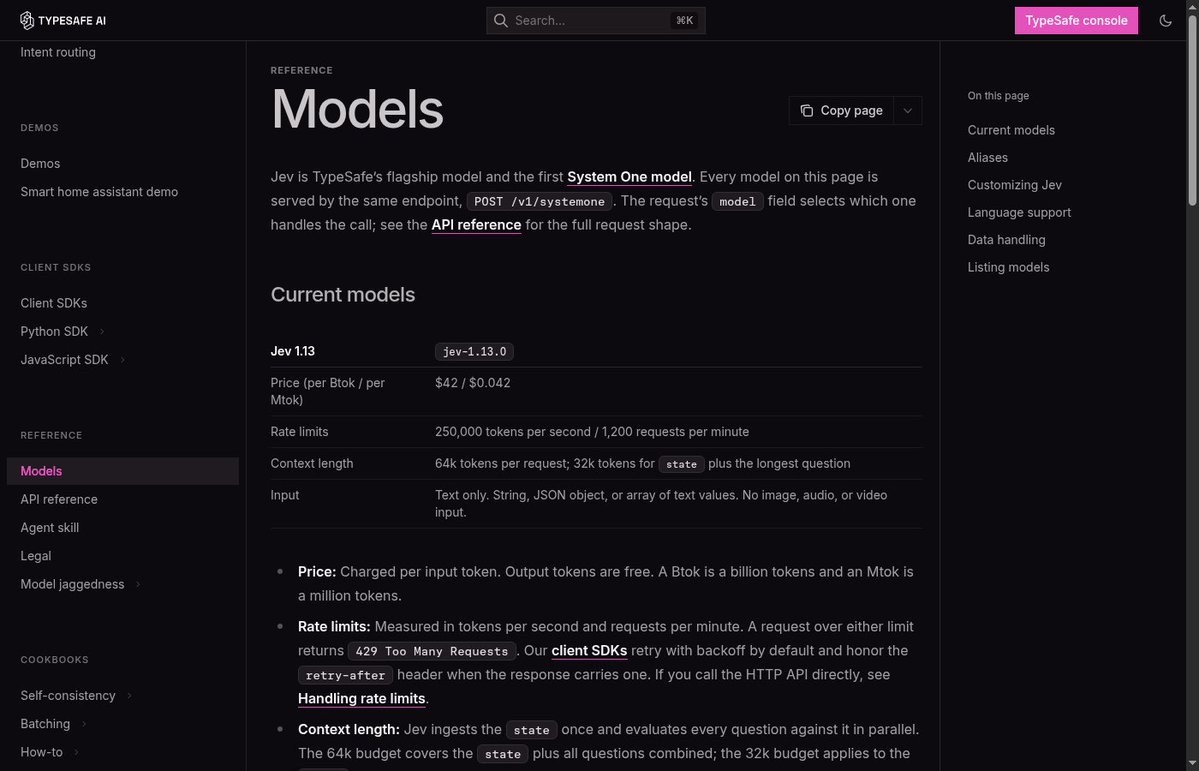
Jev 1.13 每百万输入 token 收 0.042 美元,输出 token 不收费。
按每次判断 1,000 个计费输入 token 算,10,000 次判断的 Jev 推理成本是 0.42 美元。
那个航班演示报出来的 0.0039 美元,跟它记录的 90,558 个 Jev 输入 token 加上文本辅助工具的收费是对得上的。
⚠️ 浏览器本身的成本不在这个计算里。 它那个大约 7 秒的计时,从初次页面观测之后才开始,也不包含跑完之后的重新验证。
所以:它找到航班结果,但它不订票。
换个工作负载看:Vercel 的 fx 团队报告说,安全检查比 GPT-5.6-luna 快大约 5–18 倍,同时准确率还有提升。
⚠️ 但那个比较针对的是分类器本身,不是整个 Agent 运行的时长。
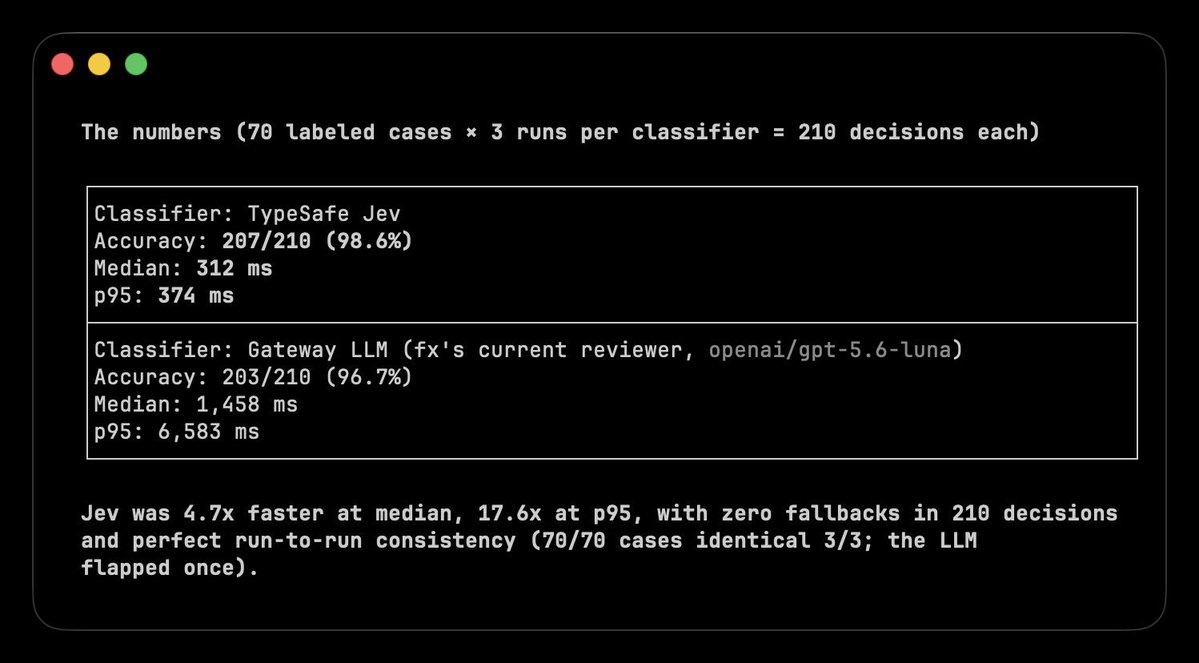
要按「每个完成的任务」来算账。 一次便宜的判断如果把你送上了错误的分支,可能比这次判断本身贵得多。
10. 真实用例
基础配置之后,Jev 已经能读任务状态、在预定义选项里做选择。接下来你只需要决定:哪一个重复发生的判断该被自动化。
① 控制浏览器
Browser Use 用 Jev 来选择下一个动作和正确的页面元素。Agent 7 秒找到航班,花了 0.0039 美元。
怎么复现:跑官方项目,加上你的 TypeSafe 和 OpenRouter 密钥,然后给 Agent 一个网站和一个目标。Jev 选动作和目标,浏览器执行这个决定。
② 分类研究资料
Hassan 用 Jev 分类了 1,018 篇 AI 论文。全部分类花了 0.08 美元,每篇端到端延迟中位数 256 毫秒
怎么复现:把每篇论文的标题和摘要发给 Jev,把你要的主题定义成 Choice 选项。保存选中的类别,把最强的几篇送给你的写作 Agent。
③ 收件箱分诊
Riley Brown 演示了 Jev 如何分类来信、并决定下一步该做什么。
怎么复现:把每封邮件作为 state,加上 reply / research / wait / review 四个 Choice 选项。把每个答案接到对应的文件夹或邮件 Agent 上。
④ 在模型之间路由任务
LangChain 用 Jev 根据任务在「更便宜」和「更强」的模型之间做选择。
怎么复现:接几个模型,描述每个最擅长什么,把进来的请求发给 Jev。简单的任务路由到便宜模型,复杂的路由到推理模型。
还有其他场景:
转折点
大模型负责产出工作 → Jev 负责决定下一步发生什么。
Jev 不是又一个聊天机器人。它是一个快速的决策层 —— 读取你系统的当前状态,在你定义的选项之间做选择。
而真正的 alpha,不是那个 7 秒找航班的演示,也不是 0.08 美元分类论文。
真正的 alpha 是意识到:你 Agent 内部有多少昂贵的 LLM 调用,本来根本不需要「生成」。
-
让 LLM 去研究、规划、写作
-
让 Jev 去路由、打分、批准、升级
-
让代码去执行决策
这个切分会改变整个 Agent 技术栈。
你现在有了配置、有了能跑的任务路由器、还有四种真实部署方式。从一个重复发生的判断开始。测量它。然后替换下一个。
大多数开发者会继续为每一个「是」「否」「路由」「打分」烧前沿模型的 token。
少数把「思考」和「决定」分开的人,会用零头的成本造出更快的 Agent。
在搭下一个 Agent 之前,先把这份手册存起来 → @0xCodila
大家好, 我是想风@xaiwind,一个关注AI 与出海的天涯沦落人!如果这篇翻译文章对你有帮助,欢迎点赞收藏、关注、有任何问题可以评论区或者私信我。 可以一起学习进步!
每天进步一点,我们终会到达目的地!
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


