
OpenAI 是否更 Open? 浅析 Codex Model Catalog 配置
文章目录
随着 Kimi k3 Response 格式的推出,主流的国产模型已经都拥有了原生 Response 接口,可以直接配置到 Codex 中使用,不再需要 Chat-Response 格式转换,但是由于模型能力和各模型之间差别的增大,配置模型有了一定的复杂度。本文的目的就是介绍具体的配置项,以及 CC Switch 做了哪些工作来帮助配置。
以往使用第三方模型接入编程工具时,我们习惯先找三个配置项:API 地址、API Key 和模型名称,填好之后,能够正常对话,往往就算接入成功了。
但对 Codex 这样的编程 Agent 来说,事情还没有结束。它还要知道:这个模型能接收图片吗?上下文有多大?支持哪些思考档位?应该用什么方式向它提供文件编辑工具?
这些信息会影响模型菜单,也会影响实际请求。只知道模型名称,客户端无法可靠地推断出全部答案。
Codex 为此提供了一个可以由用户配置的入口:Model Catalog,模型目录。 用户可以通过本地 JSON 文件声明模型信息,让 Codex 按这些声明展示和使用模型。这也给第三方模型厂商和 CC Switch 这样的配置工具留下了适配空间。
标题中的“更 Open”,讨论的就是这项具体的扩展能力。我们从这个文件入手,看看它能配置什么,以及 CC Switch 如何把这些配置变得容易使用。
本文基于已核对的 Codex 0.154.0 和 CC Switch 3.20.2 实现。配置示例采用 Kimi Code 官方公布的 K3 参数,核对日期为 2026-09-18;实际使用需具备对应的 API Key 和模型权限。
一、Model Catalog 在解决什么问题?
给 Codex 一份模型使用说明
Model Catalog 可以理解为一份供 Codex 阅读的“模型使用说明书”。
假设某个服务提供两个模型:一个支持图片、拥有较大上下文,另一个只接收文本、只有一个有效的思考档位。它们可能使用同一个 API 地址,也都支持 Responses API,但 Codex 对待它们的方式应该有所不同。
如果客户端不知道这些差异,就可能出现菜单选项不合适、上下文容量估计错误,或向上游发送不支持的参数等问题。
Responses API 描述请求与响应的协议,Model Catalog 则补充模型在 Codex 中的能力声明。 两个服务使用同一种协议,并不能保证它们支持完全相同的参数和工具。
这种设计把一部分模型适配工作放进了数据文件。当新模型可以使用 Codex 已有的协议和工具形式时,用户或厂商就有机会通过修改目录完成适配,减少为了一个新模型名称修改客户端代码的需要。
引入 model_catalog_json 的官方 PR 也说明了这一用途:通过本地 JSON 覆盖模型元数据、添加模型,方便在不修改后端的情况下测试配置。这是一个通用扩展入口,第三方模型接入是它的实际用途之一。官方 PR #12101
为什么不能点一下“获取模型列表”就解决?
供应商的模型列表接口通常能够告诉我们有哪些模型 ID,却未必包含 Codex 所需的全部信息。例如,编程任务应使用哪种编辑工具、配什么基础指令、展示哪些思考档位,并没有一套所有供应商都统一提供的返回格式。
因此,获取模型 ID 可以辅助填写目录,却不能代替完整的能力配置。厂商需要提供适配说明,工具维护者也需要整理这些信息。
目录本身同样不会探测或创造能力。给纯文本模型填写 "image",不会让它获得视觉能力;把上下文窗口写大,也不会增加账号实际能够使用的额度。错误的模型能力声明轻则影响模型性能,重则直接报错。
连接配置和能力配置,各管一部分
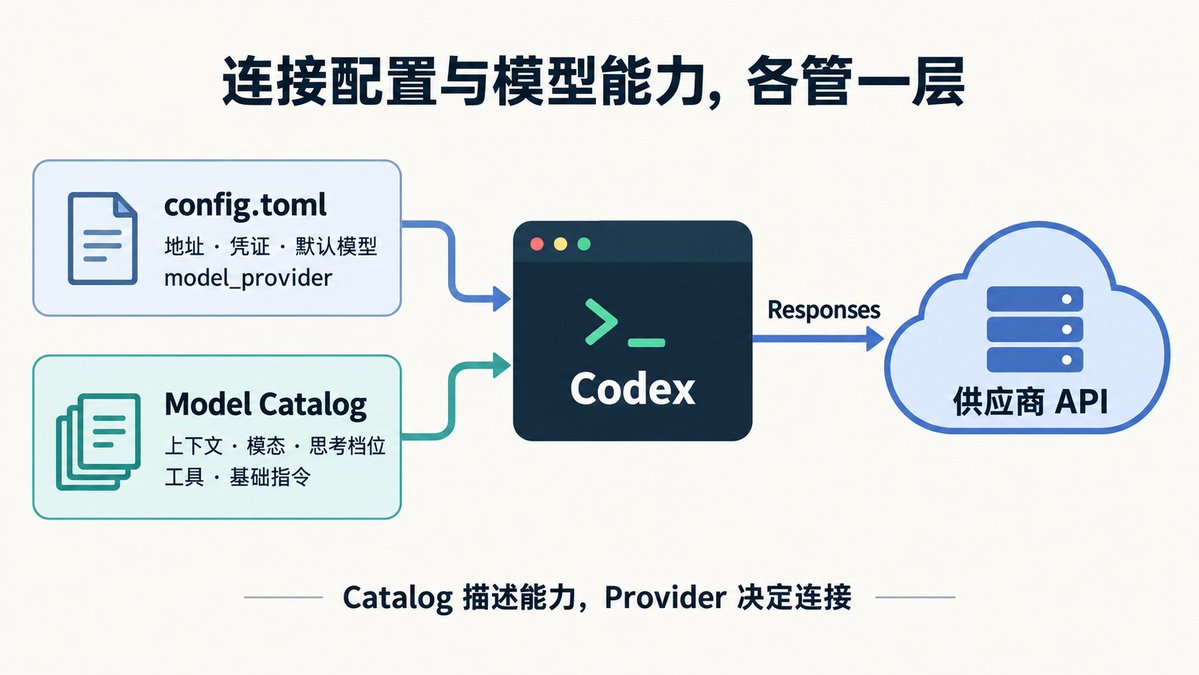
在 Codex 中,可以把有关配置分成两层:
-
model:默认使用哪个模型 ID
-
model_provider:当前选择哪个供应商连接
-
[model_providers.<id>]:这个连接的 API 地址、协议和认证方式
-
model_catalog_json:启动时从哪里读取模型目录
-
目录中的模型条目:如何展示模型,以及使用哪些能力和工具配置
model_catalog_json 指向本地 JSON 文件;API 地址和凭证则放在供应商配置中。这种分工也体现在 Codex 官方配置参考中。
一份目录可以包含多个模型,但它不会根据模型名称自动切换供应商:
-
同一供应商的多个模型:可以共用,前提是当前接口和凭证有权访问这些模型
-
聚合平台提供的不同厂商模型:可以共用,由聚合平台根据模型 ID 路由
-
不同供应商各自的官方接口:可以收录模型信息,但调用时仍需切换对应连接,或使用统一网关
例如,目录同时包含 DeepSeek 和 MiniMax 的模型,而当前连接指向 DeepSeek 官方接口,那么选择 MiniMax 模型后,请求仍然会发往 DeepSeek。目录里没有为每个模型单独绑定 API 地址和 Key 的路由机制。
还有一个容易忽略的行为:在本文核对的 Codex 版本中,自定义目录会替换当前进程使用的内置目录。 它不会自动追加到内置列表,随后模型菜单还会受到认证资格和可见性过滤。如果文件只包含第三方模型,原来的 GPT 条目可能不再出现在 CLI 菜单里。修改目录后,需要完全退出并重启 Codex,让新进程读取它。目录加载实现
二、两份文件,怎样配合工作?
手动配置通常涉及两份文件:config.toml 负责连接和选择目录,JSON 文件负责描述模型。
下面以 Kimi Code 的 K3 为例。它在这个端点上的实际模型 ID 是 k3,不是 kimi-k3。在用户级 ~/.codex/config.toml 中增加名为 kimi 的连接,并将目录保存为同一配置目录下的 models.json。顶层字段要放在 [model_providers.kimi] 前面,避免被 TOML 解析为供应商表内的字段。Kimi Code 官方 Codex 配置
model = "k3" model_provider = "kimi" model_reasoning_effort = "high" model_catalog_json = "models.json"
[model_providers.kimi] name = "Kimi Code" base_url = "https://api.kimi.com/coding/v1" wire_api = "responses" experimental_bearer_token = "填写你的 Kimi Code API Key"
这里采用与 CC Switch 表单 API Key 常见写入路径一致的 experimental_bearer_token,其值直接填写你在 Kimi Code 控制台创建的 Key,无需另设环境变量。它与填写环境变量名称的 env_key 是两种不同的认证方式,本例只使用前者。实际 Key 会保存在配置文件中,分享配置或截图时应替换为占位内容。
kimi 是自定义连接 ID,应避免使用 openai、ollama、lmstudio 等保留名称。本文版本的 wire_api 使用 responses;上游只支持其他协议时,需要另外处理协议转换。相对路径 models.json 按本文版本的 CODEX_HOME 解析,默认即 ~/.codex/models.json。连接与认证配置、目录路径处理
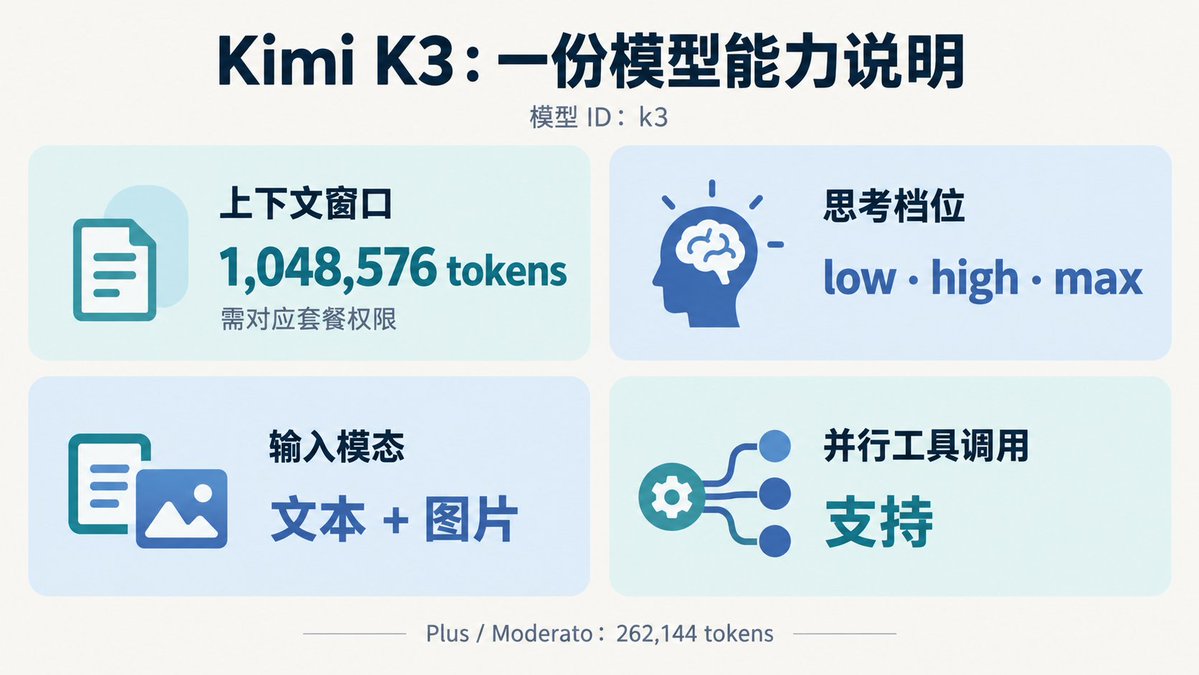
接下来是 models.json。下面依据 Kimi 官方目录中的 k3 条目整理:上下文为 1048576 tokens,支持 low / high / max 三档思考、文本与图片输入,以及并行工具调用。示例保留官方的旧版摘要字段,并补入本文 Codex 版本使用的 supports_reasoning_summary_parameter。K3 目录与会员权限
1M 窗口有套餐条件。 核对时,官方表格为 Pro 及以上/Allegretto 及以上的 k3 列出 1048576;Plus/Moderato 的 k3 则为 262144。后者使用本例时,应把下方两个窗口字段都改为 262144,并同步修改描述。填写更大的数字不会增加账号额度。
{ "models": [ { "slug": "k3", "display_name": "Kimi K3", "description": "Kimi Code K3,1M 上下文(需对应套餐权限)", "base_instructions": "", "default_reasoning_level": "high", "supported_reasoning_levels": [ { "effort": "low", "description": "轻量思考" }, { "effort": "high", "description": "增强思考" }, { "effort": "max", "description": "深度思考" } ], "shell_type": "shell_command", "visibility": "list", "supported_in_api": true, "priority": 0, "supports_reasoning_summaries": true, "supports_reasoning_summary_parameter": true, "default_reasoning_summary": "none", "support_verbosity": false, "truncation_policy": { "mode": "bytes", "limit": 10000 }, "supports_parallel_tool_calls": true, "context_window": 1048576, "max_context_window": 1048576, "effective_context_window_percent": 95, "experimental_supported_tools": [], "input_modalities": ["text", "image"] } ] }
这里的 base_instructions 沿用官方示例的空字符串,表示目录不额外提供这段基础指令;它与完全缺少字段不同,本文核对版本的解析器接受这个值。显示名称和档位描述做了中文整理,模型能力参数保持官方声明。这份目录看起来字段不少,但日常理解和调整可以从下面几组入手。完整字段定义及必填要求,应以所用版本的 `ModelInfo` 结构为准。
模型身份与菜单展示
slug 是实际模型 ID,应当与请求使用的模型名称对应;display_name 是展示名称,可以写成更容易辨认的文字。修改显示名,不会改变上游收到的模型 ID。
description 提供描述,visibility 控制可见性,priority 参与排序,supported_in_api 则参与 API 认证场景的模型筛选。它们共同影响展示,但不能保证一个模型在所有客户端、所有登录状态下都出现。
上下文与输入模态
-
context_window:模型上下文窗口的声明
-
max_context_window:最大上下文窗口的声明
-
effective_context_window_percent:客户端计算有效上下文预算时使用的比例
-
input_modalities:输入类型,例如文本,或文本加图片
-
supports_image_detail_original:是否支持原始图片细节模式,和“能否接收图片”是不同声明
这些值应对应实际使用的模型、端点和账号权限。同名模型经不同套餐或网关提供时,可用窗口和图片支持也可能不同。
此外,config.toml 还可以显式设置 model_context_window。排查上下文行为时,需要同时检查全局配置,不能只看目录中的一个数字。
思考档位与推理摘要
supported_reasoning_levels 描述可选思考档位,default_reasoning_level 描述目录中的默认档位。
档位要按供应商的实际语义配置。有些模型提供多个推理强度,有些只有思考开关,还有些只接受一个有效值。把菜单补成 low / medium / high / xhigh,并不意味着上游真的具备这些差异。
还要留意:目录默认档位与 TOML 中的 model_reasoning_effort 是两处配置。手动配置时最好保持一致,排查请求时也应检查显式设置。
推理摘要又是另一项能力。在本文版本中,supports_reasoning_summary_parameter 控制是否发送 reasoning.summary,不能把它当成关闭全部推理功能的开关。一些旧目录仍使用 supports_reasoning_summaries,该旧键在此版本中不再承担相同作用。请求构造实现
工具形式与基础指令
这组字段最容易影响“能聊天,但执行编程任务报错”的情况。
shell_type 描述 shell 工具配置;apply_patch_tool_type 描述独立的补丁工具形式。本文版本中,shell_command 是 unified_exec 的兼容别名,apply_patch_tool_type 只接受 freeform,不能想当然地填成 function。
供应商支持 Responses API,不代表它接受所有 custom/freeform 工具。目录里的工具声明必须与具体端点匹配;工具最终是否注册,还受执行环境和功能配置影响。
base_instructions 则提供模型使用的基础指令。例如,指令要求模型通过某个工具编辑文件,实际配置却没有提供该工具,就会产生不一致。本文版本也支持 model_messages.instructions_template;两种指令来源至少要有一个。工具类型定义、基础指令校验
其他字段还包括并行工具调用、输出详细程度、工具输出截断等配置。尤其不要把 supports_search_tool 与托管网页搜索开关混淆:工具检索与网页搜索属于不同功能。
实际操作时,优先采用与服务端点和 Codex 版本匹配的完整模板。不合法的 JSON、缺少必填字段、空的 models 数组或缺少基础指令,都可能导致目录加载失败。
三、CC Switch 做了哪些事来帮助配置?
理解原理之后,可以发现手工配置的主要负担:既要查供应商资料,又要维护目录结构,还要保证模型 ID、窗口、档位、工具和连接信息相互匹配。
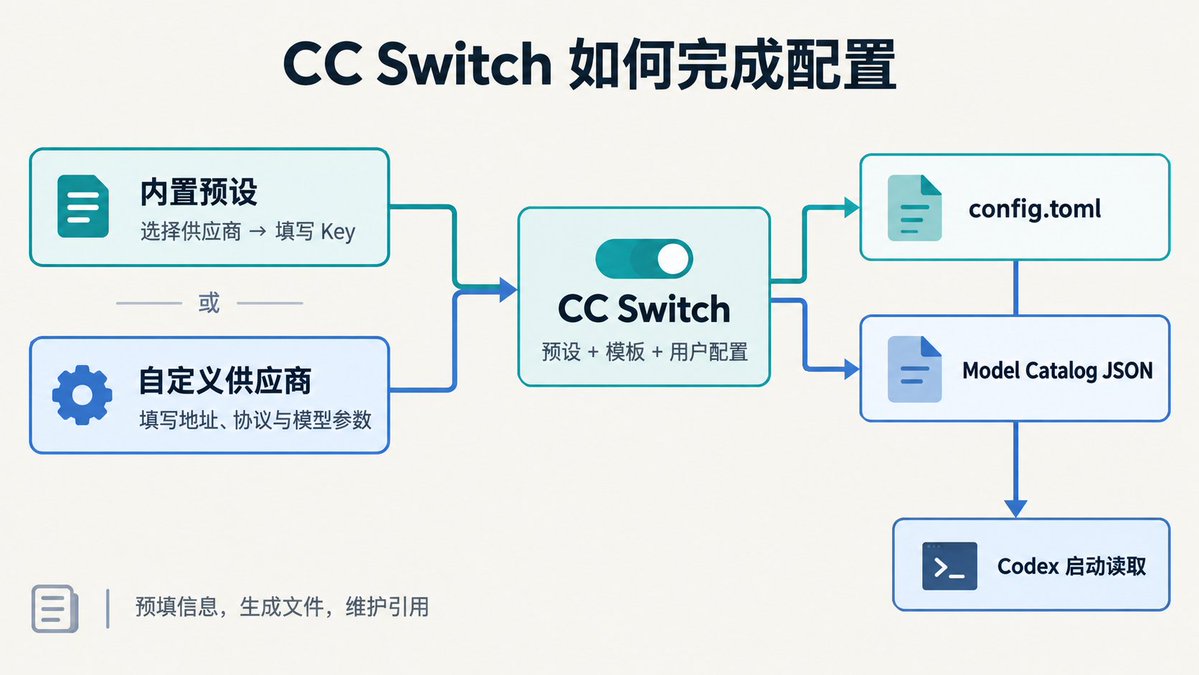
CC Switch 把这部分工作整理成预设和表格,并在保存、启用供应商时生成 Codex 所需的文件。它能够这样做,正是因为 Codex 提供了可由外部工具生成的配置入口。
厂商提供资料,CC Switch 整理和补齐
很多国产模型厂商已经在自己的 Codex 教程中提供模型目录或配置示例,比如 DeepSeek、Kimi Code、智谱和 MiniMax。
厂商掌握自家模型和网关的能力,这些资料是适配的重要依据。CC Switch 在本文基线中采用两类主要方式:
-
使用专用目录资源:DeepSeek 原生官方接入的相应分支,以软件打包的专用目录为基础,保留配套工具和基础指令,再应用用户覆盖
-
使用能力预设和通用模板:将模型窗口、思考档位、模态等整理进预设,由生成器展开为完整目录;自定义供应商也可以使用这条路径
因此,“厂商有示例就参考,没有完整配置就补齐”,描述的是资料整理和配置生成。软件不会在每次切换时自动下载全部厂商教程,也不会实时探测所有模型能力。
有官方示例,也不等于原样照抄。例如,通用原生 Responses 模板采用 shell 工具配置,避免直接继承不一定被第三方端点接受的 freeform 补丁工具;DeepSeek 的专用分支则保留其配套工具和指令。具体采用哪条路径,还取决于连接地址与运行方式。
从预设和表格生成完整 JSON
CC Switch 的界面中,这部分仍叫 模型映射。在原生 Responses 场景下,它也承担模型目录的编辑功能,不再需要开启本地路由来接入 Codex。
模型映射表主要包含显示名、实际模型 ID、上下文窗口和思考等级。使用内置预设时,这些信息已预填;添加自定义供应商或新模型时,用户再按需填写。默认思考等级在相应浮层中设置,输入模态、并行工具和基础指令等信息则可以由预设携带。
软件在内部保存这份简化配置,再将每一行展开为 Codex 的完整模型条目,补齐模板字段。这样用户就不必为每个模型反复复制一大段 JSON。
但模板回退值仍然只是回退值。例如,本文基线的通用生成器会先看模型行中的上下文,再看顶层上下文配置,最后使用默认值;它不会向上游验证这个窗口是否真的可用。新增模型时,仍应优先填写厂商明确提供的参数。
维护目录文件和供应商切换
在正常托管配置的情况下,CC Switch 将生成的目录写入当前 Codex 配置目录,并维护下面的引用:
model_catalog_json = "cc-switch-model-catalog.json"
默认配置目录是 ~/.codex。切换供应商时,软件根据该供应商保存的模型列表重新生成目录,同时更新连接配置。因此,一个供应商可以配置多个模型,但软件不会把所有供应商自动合并成一份能够自行路由的目录。
如果用户已经指定了自己的外部目录,CC Switch 会保留那个路径。此时,即使软件生成了自己的 JSON,Codex 仍可能读取原来的文件。遇到“表格改了,模型菜单却没变”,可以先检查 model_catalog_json 实际指向哪里,再确认是否完整重启。
处理配套的认证和兼容配置
目录之外,CC Switch 还需要整理 API 地址、凭证和部分兼容开关。
在使用表单 API Key、且没有另外配置认证来源的常见路径中,软件将 Key 放入 provider 的 experimental_bearer_token。如果用户已经配置 env_key 等认证来源,则按相应规则保留,而不是无条件改用表单 Key。
对已知不支持托管网页搜索的原生配置,软件还会按规则禁用相应功能,避免发送上游不接受的工具。这些工作有的体现在目录中,有的体现在 config.toml 中,需要两份配置共同生效。
最后,要区分目录生成与本地路由代理。对于使用普通 API 地址和 API Key 的原生 Responses 接口(目前大部分国产模型官方),Codex 可以直连供应商,CC Switch 在配置阶段完成工作。如果上游提供的是 Chat Completions 或 Anthropic Messages(大部分聚合API站点),则需要本地代理承担协议转换。生成一份 Catalog 本身不会完成这项转换。
实际使用时怎么操作?
使用内置预设:选择供应商,填写 Key 即可。 对于本文介绍的原生 Responses 供应商预设,CC Switch 已经预填 API 地址、协议、默认模型、模型映射及相应能力参数,生成目录所需的模板信息也由软件提供。选择与自己账号区域、套餐对应的预设后,用户只需要填写 API Key,不必逐项研究和手写 Model Catalog。
-
在 CC Switch 的 Codex 页面添加供应商,选择对应的内置预设。
-
填写自己的 API Key,保存并启用供应商。
-
完全退出并重启 Codex,开始使用。
只有需要调整默认模型、按套餐修改上下文窗口,或添加预设之外的模型时,才需要进一步编辑相应配置。例如,前文 K3 的上下文窗口就应与账号权限一致。
添加自定义供应商:需要用户自行填写连接和模型信息。 没有对应预设时,CC Switch 无法替用户确定服务地址、模型名称和实际能力,需要根据供应商文档填写:
-
供应商名称、API 地址和 API Key。
-
“高级选项”中的上游格式;原生 Responses 接口选择“Responses(原生)”。
-
默认模型,以及“模型映射”中的显示名、实际模型 ID、上下文窗口和思考档位等信息。
“获取模型列表”可以辅助选择模型 ID,其余能力参数仍需用户提供。填写完成后,CC Switch 负责补齐目录结构、生成 JSON 和维护配置引用,用户无需手写整份目录文件。保存、启用供应商并重启 Codex 后即可验证。
首次使用时,可以在 CLI 的 /model 中检查模型和档位,发送简短请求,再完成一次小型文件读取或编辑任务,确认工具调用正常。桌面端菜单的具体呈现应结合客户端版本检查。
Model Catalog 给第三方模型接入提供了一个可编辑、可生成的能力描述入口。厂商可以提供模型说明,用户可以修正声明,CC Switch 可以把分散的资料整理成日常使用的配置。就这项具体机制而言,Codex 为外部适配留下了实际空间;能否把模型用好,仍取决于服务能力、目录声明和工具约定是否一致。
回到标题的提问,虽然 Codex 目前只支持 OpenAI 独有的 Response 格式,但是为接入第三方模型留下了相对自由的配置空间,所以在这方面可以称得上 Open。
实现依据:Codex rust-v0.154.0;CC Switch 3.20.2,调研提交 39cdc85e6ef83030f373272c97fecf38ff850bd0。CC Switch 的目录生成、模板选择和路径维护可参见公开 v3.20.2 标签下的 codex_config.rs,供应商预设可参见 codexProviderPresets.ts。本文未使用真实 API Key 验证示例的端到端调用。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


