
把 Sydney Sweeney 装进 MiniMax H3:人物 LoRA 的原理和本地使用
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
0. TL;DR
昨天我发了一条Post, 介绍一个有点离谱的开源模型。
一个叫 Playtime-AI 的用户,给 MiniMax H3 做了一个 Sydney Sweeney 的人物 LoRA。文件只有 155 MB,从Huggingface下载之后和 H3 一起加载,不需要参考图,只要在 Prompt 里写出她的名字,就能生成带有她外貌特征的视频。
不少人问我,这个东西到底怎么用。
于是我把它下载下来,接进本地运行的 MiniMax H3,做了一段类似当年让 Sydney Sweeney 名声大噪的 American Eagle 广告风格的视频。
这篇文章想把这件事彻底拆开来看:一张脸,究竟是怎么被“压缩”进一个只有 155 MB 的 LoRA 里?它为什么能让 MiniMax H3 在没有参考图的情况下,仅凭一个名字就生成对应人物?从训练原理、加载方式,到实际使用中最容易踩的坑,我把整个过程从头走了一遍。
1. Sydney Sweeney LoRA不是一个视频模型
我们使用的基础模型是 MiniMax H3。
H3 是一个 330 亿参数的视频生成模型。动作、表情、口型、布料、镜头运动和声音等视频生成能力,主要都由它负责。MiniMax 官方仓库 对 H3 的结构有更完整的说明。
但 H3 本身并不真正“认识” Sydney Sweeney。直接在 Prompt 里写她的名字,通常只会得到一个大概符合描述的金发女性。如果我们希望视频模型生成某个特定人物,会给它一张或几张参考图,让模型根据这些图片保持人物身份。但参考图更像是临时给模型“看一眼”:一旦换了角度、场景、镜头或者表情,人物的脸就可能开始漂。
而且,一份人物身份背后,往往需要十几张甚至几十张不同角度、光线和表情的图片才能描述得比较完整。实际生成视频时,每次都把这么多图片作为参考输入并不现实,多数工作流也很难处理如此复杂的参考条件。
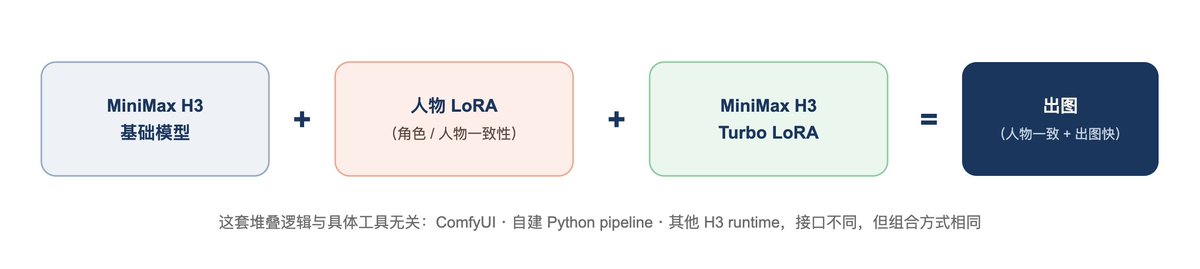
这时候就可以用 LoRA。
LoRA,全称低秩自适应,是一种高效微调大型机器学习模型的技术。人物 LoRA 通常会用十几张到几十张不同角度、光线和表情的照片进行训练,把这个人的身份特征写进一小组额外的权重里。生成视频时,这组权重会和 H3 一起加载。这样就不需要每次重新提交整套参考图片。即使换场景、换镜头、换表情,人物身份通常也会比单纯依靠参考图更加稳定。
可以把 H3 想成一个已经会拍电影的剧组:导演、摄影、灯光、动作和演员调度能力都已经准备好了。人物 LoRA 则像一份额外的选角资料,告诉这个剧组:
“这次主角应该长成这个人。”
基础模型没有被替换。换掉 LoRA,就相当于换了一个主角。
Playtime-AI 做的并不只有 Sydney Sweeney。它的 Hugging Face 页面目前已经放出了 70 多个模型,包括 Anya Taylor-Joy、Sadie Sink、Ana de Armas,以及其他大量公众人物。每张脸都被压缩成一个可以单独下载、随时加载的“身份插件”。Playtime-AI 的模型列表
2. LoRA 到底改变了什么
假设模型里原来有一个很大的权重矩阵 W。完整微调会直接更新这个矩阵,成本很高,也很容易破坏基础模型原来会做的事情。
LoRA 不修改 W。它在旁边增加两个小矩阵 A 和 B:
# 每个挂了 LoRA 的层
y = base(x)  +  scale · (x @ Aᵀ) @ Bᵀ
训练时,基础模型的 W(权重) 被冻住,只学习 A 和 B。
因为这两个矩阵的秩很低,需要训练和保存的参数远少于原模型,所以最后得到的文件可能只有一百多 MB。推理时再把它们产生的增量叠加到基础模型上。
这也是 LoRA 可以随挂随卸的原因。
底模仍然负责“怎么生成视频”,人物 LoRA 只给结果增加一个方向:当 Prompt 里出现 Sydney Sweeney 时,脸型、头发、肤色和一些典型表情应该往哪里偏。
我们拆开这个文件看了一下。
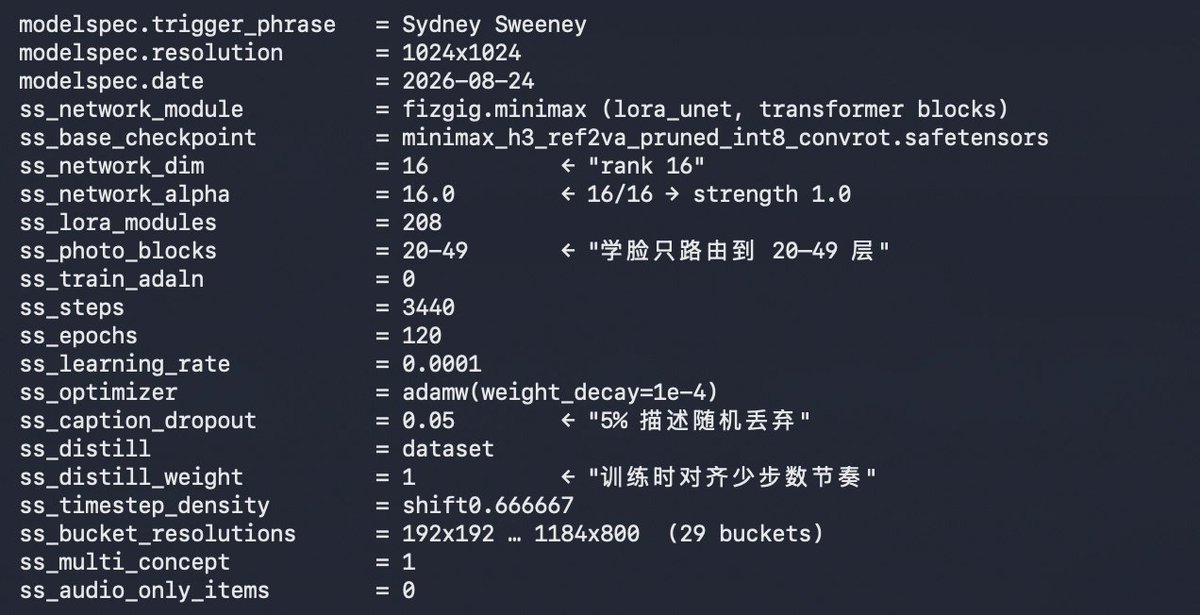
它训练的工具是 Fizgig(ss_network_module = fizgig.minimax),一个开源的 LoRA 训练工具,专门给 MiniMax H3、Krea 2 这类视频/图像扩散模型做角色和风格微调,把底模压成低精度冻住、只训练那圈小矩阵,所以消费级显卡也能跑。
它包含 208 对小矩阵,分布在 50 个主干层和两个文本精修层里,主要挂在注意力的 qkv、输出投影,以及前馈网络的两层上。
它的 rank 是 16,alpha 也是 16,因此原始缩放比例正好是 1.0。
还有一个容易让人误判的细节:第 0 到 19 层的 B 矩阵全部是零。
这不是文件损坏。训练者有意保留了前 20 层,只让后面的第 20 到 49 层学习人物身份。加载器如果只检查模块数量,会显示它们都加载成功;但真正产生增量的主要是后面那些层。
3. 一张脸怎样被训练成 LoRA
从文件里的训练记录,可以大致还原出这个 LoRA 的训练过程。
第一步是准备人物图片。图片需要覆盖不同角度、光线、距离和表情,再按分辨率分桶,最高到 1024×1024。每张图片还要配一段文字描述,其中反复出现 Sydney Sweeney 这个名字。
这个名字后来就成了 LoRA 的触发词。模型学习的不是抽象的“一个漂亮的金发女人”,而是“当文字里出现 Sydney Sweeney 时,画面应该向这一组面部特征靠近”。
为了避免模型只会死记某一种描述,训练配置还使用了大约 5% 的 caption dropout,随机丢掉一部分描述。
接下来,整个 MiniMax H3 基础模型被冻结,只训练新增的低秩矩阵。
这份记录显示训练大约进行了 3440 步,共 120 个 epoch,使用 AdamW,学习率是 1e-4。它没有重新学习动作、打光和镜头,而是在 H3 已经具备的视频能力上,学习一个与人物身份有关的差量。
最后保存下来的 155 MB,装的不是一个完整的 Sydney Sweeney 生成模型,而是“怎样让 H3 的普通人物向 Sydney Sweeney 偏移”这一小部分信息。
需要说明的是,这个 Hugging Face 页面只提供了 LoRA、Demo 视频和非常简单的说明,没有公开训练数据集。我们可以从模型元数据里看到训练配置,但无法确认每张图片的来源和处理方式。
4. 为什么训练底模和我们的底模名字不一样
LoRA 不是通用插件。它必须和训练时使用的基础模型在结构上对得上。
这个文件的元数据写的是:
ss_base_checkpoint = minimax_h3_ref2va_pruned_int8_convrot.safetensors
而我们本地运行的是:
MiniMax-H3-FL2VA-…-8bit
名字看起来差得不少,实际包含三个问题。
第一是量化格式。训练底模使用 int8 ConvRot,我们使用的是另一种 8-bit 格式。一开始我们怀疑 LoRA 的矩阵也在旋转后的基底里,甚至做了一套“反旋转”的方案。后来读训练器源码才发现,ConvRot 的旋转发生在冻结层内部,LoRA 读到的仍然是正常基底下的输入。它本身不需要反旋转。看到 ConvRot 或 Hadamard,不要直接改 LoRA。很可能原文件就是对的,反而是你把它转坏了。
第二是 Ref2VA 和 FL2VA。它们是 H3 同一套主干结构上的不同分支。至少在我们使用的实现中,LoRA 对应的模块名和张量形状都能对上,实际生成也证明可以工作。
第三是 pruned。裁剪版本移除了一部分推理时不需要的模块,而这个人物 LoRA 没有训练 AdaLN,被裁掉的部分不在它的作用范围内。
所以,同一个 H3 家族中的分支或量化版本,有可能兼容;换成 Wan、LTX、SDXL 之类结构完全不同的模型,则不能使用。
不过,还有一种情况更难判断:底模和 LoRA 都能正确加载,采样配置却不匹配。它不会报错,只会给你一段不好看的视频。
5. 我们实际怎么加载
先从 Hugging Face 下载其中的 LoRA 文件:
hf download \
  Playtime-AI/Minimax_H3-Sydney_Sweeney \
  "MM-H3 - Sydney Sweeney.safetensors" \
  --local-dir ./loras
无论使用 ComfyUI、自己的 Python pipeline,还是其他 H3 runtime,逻辑都是一样的:
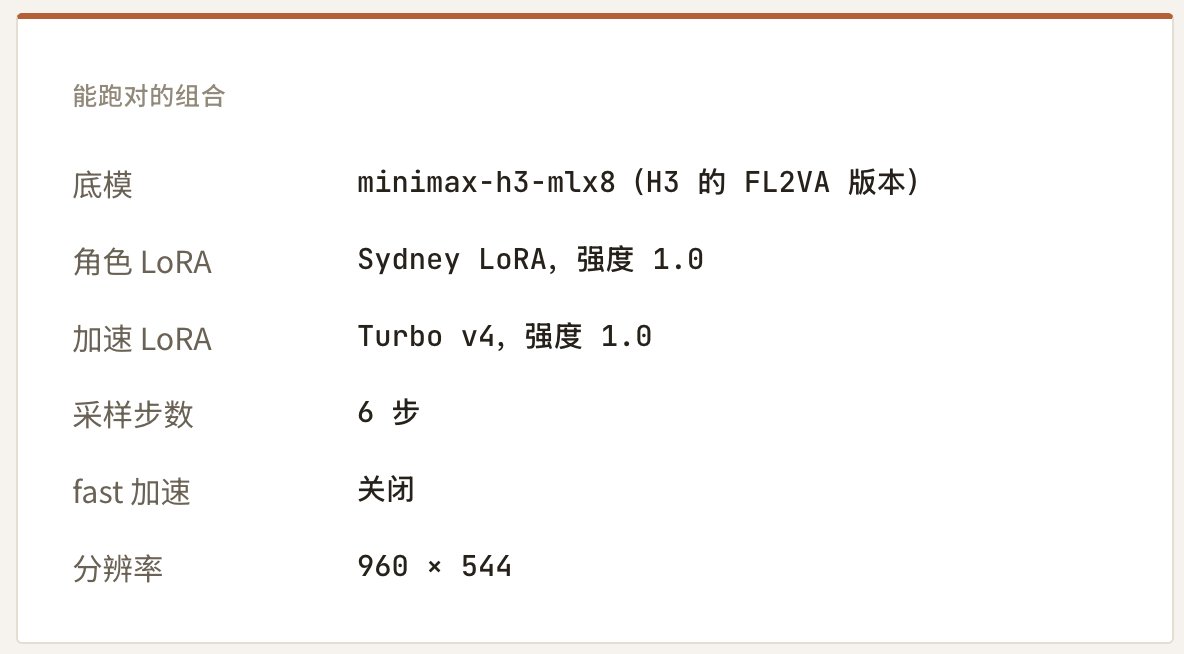
我们最后跑通的配置是:
我的本地封装叫 video-shot,对应命令是:
# 一条命令搞定:balanced 档 = 6 步 + Turbo + 关掉 fast
export H3_LORA_PATHS=/路径/minimax-h3-sydney-sweeney.safetensors
H3_TIER=balanced video-shot minimax-h3-mlx8 out.mp4 7781 prompt.txt
这里的 balanced 不是一个模糊的质量档位。它具体代表 6 步、加载 Turbo LoRA,并关闭另外一套 fast 加速。
如果使用其他运行环境,不需要照搬命令名,但这几个实际参数要对应上。
6. 最隐蔽的坑:30 步反而比 6 步模糊
第一版生成时,所有日志都很正常:lora 1/2: 208/259 modules, scale 1.00
LoRA 成功加载,基础模型也没有报错,但视频发灰,人脸像蒙着一层雾。
我们先怀疑量化格式,又换了更接近训练配置的底模,还尝试关闭各种加速。结果都没有明显改善。后来还是Astra从Player AI的视频元数据里得到他们自己生成视频用道德参数, 才发现要把 30 步换成 6 步。脸立刻清楚了。
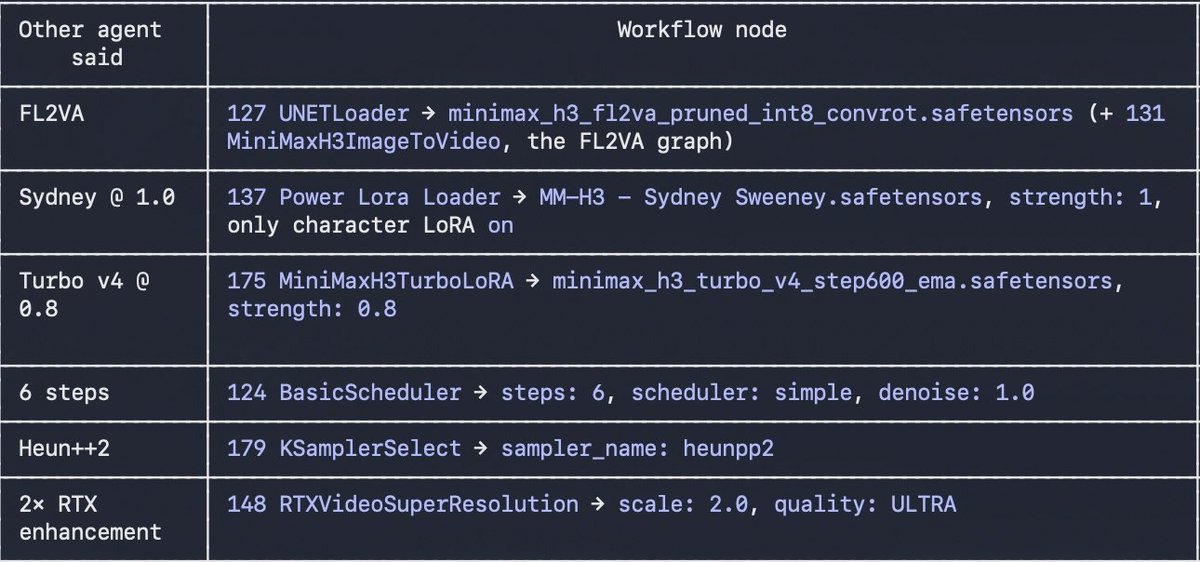
这个 LoRA 的训练记录里包含 distillation,以及经过偏移的时间步分布。换句话说,它适配的是少步数的快采样节奏。再叠加 Turbo LoRA 后,6 步才是它熟悉的工作方式。
用 30 步不是“多算一点,所以质量更好”,而是拿一套已经针对少步采样训练过的增量,放到另一套时间表里运行。
模型不会告诉你配置错了。它会认真跑完,再交给你一个模糊的结果。
这条经验不能反过来套到所有 H3 生成上。不加载这个人物 LoRA 时,我们的普通渲染仍然是 30 步略锐。采样步数不是统一的质量旋钮,要看 LoRA 是按什么节奏训练的。
7. Prompt 里的名字必须一字不差
这个 LoRA 的触发词是:Sydney Sweeney,拼写必须完整。我们第一版写成了 Sydney Sweeny,少了一个 e。看起来只是一个小拼写错误,对 tokenizer 来说却已经是另一组 token,人物特征马上就弱了。
多镜头视频还有一个问题。如果第一个镜头写 Sydney Sweeney,后面的镜头只写“她”,切镜头之后很容易换脸。我们把完整名字写进每一个镜头,身份才稳定下来。例如:
Shot 1: Sydney Sweeney walks into a quiet hotel lobby...
Shot 2: Close-up of Sydney Sweeney looking toward the window...
Shot 3: Sydney Sweeney turns back and speaks softly...
这次生成没有使用任何参考图。整段视频 15 秒、24 fps,一次生成 362 帧,在本地 Mac 上大约用了 44 分钟,没有调用云端算力。
8. 真正需要记住的几件事
如果要把一个人物 LoRA 接进 MiniMax H3,我现在会先检查这些:
-
LoRA 是否确实为 MiniMax H3 训练,而不是其他视频模型。
-
模块名和张量形状是否能和当前底模对应。
-
是否需要同时加载 Turbo 或其他训练 adapter。
-
训练时使用的是常规采样,还是蒸馏后的少步数采样。
-
LoRA strength 是否保持在训练时的 1.0。
-
Prompt 是否在每个镜头里完整写出触发词。
-
如果能加载但画面异常,先检查采样时间表,不要立刻改 LoRA 权重。
LoRA 原本是一种降低微调成本的方法。放到开源视频模型上以后,它同时改变了人物身份的传播方式。一个 330 亿参数的视频模型负责创造整个世界,一张具体的脸则被压缩成一百多 MB,可以下载、复制、组合和删除。
技术已经开源了,人的脸也快要被开源了。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


