
效率提升100%!分享我的 AI Coding 大杀器:SDD 工作流
文章目录
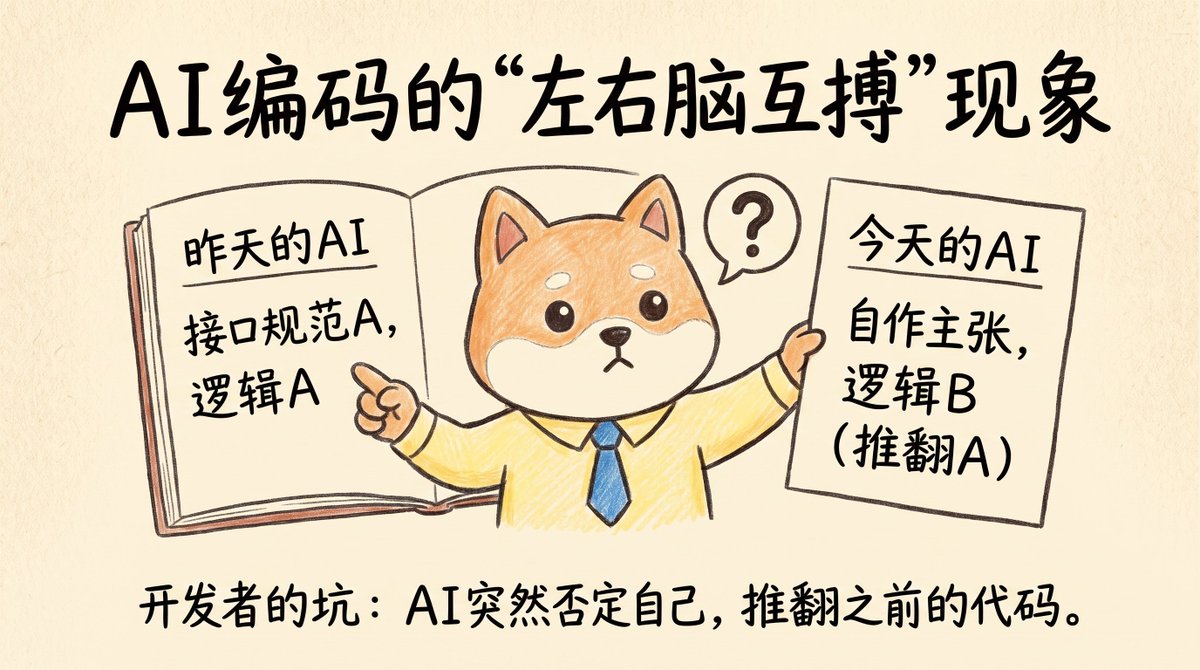
很多人高强度用 AI 写代码时,经常会遇到一种让人哭笑不得的局面:今天的 AI 在否定昨天的 AI,现在的 AI 在推翻上一轮对话的自己
你明明在三个小时前跟它敲定了接口规范,换了个窗口或者聊了十几轮之后,它突然自作主张换了一套写法,甚至把之前写好的逻辑全盘推翻。这种"左右脑互搏",几乎是每个深度 AI 开发者都会踩的坑
这种问题为什么会发生?业界有没有很好的解决方案?今天这篇文章Left就带你来揭晓答案
一、为什么 AI Coding 总会左右脑互搏?
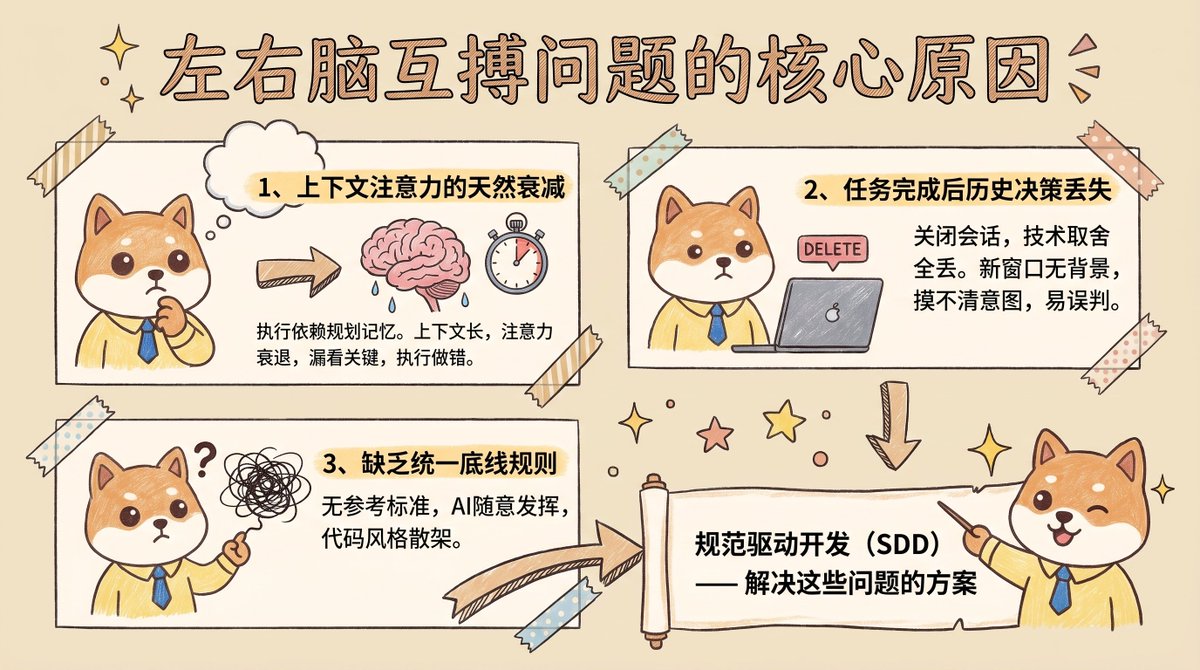
造成左右脑互搏问题的核心原因有三点:
1、上下文注意力的天然衰减:执行阶段高度依赖规划阶段的记忆。但大模型的注意力有限,上下文越聊越长,注意力就会衰退,导致漏看关键决策,在执行阶段直接做错
2、任务完成后历史决策丢失:每次关闭会话,当时的技术取舍就全丢了。下一次新建窗口,AI 拿不到历史背景,摸不清之前的设计意图,极易产生误判
3、缺乏统一底线规则:AI 在长期开发中没有参考标准,非常容易随意发挥,写着写着代码风格就彻底散架
规范驱动开发(Spec-Driven Development,简称 SDD),就是为了解决这些问题而生的
二、什么是 SDD?
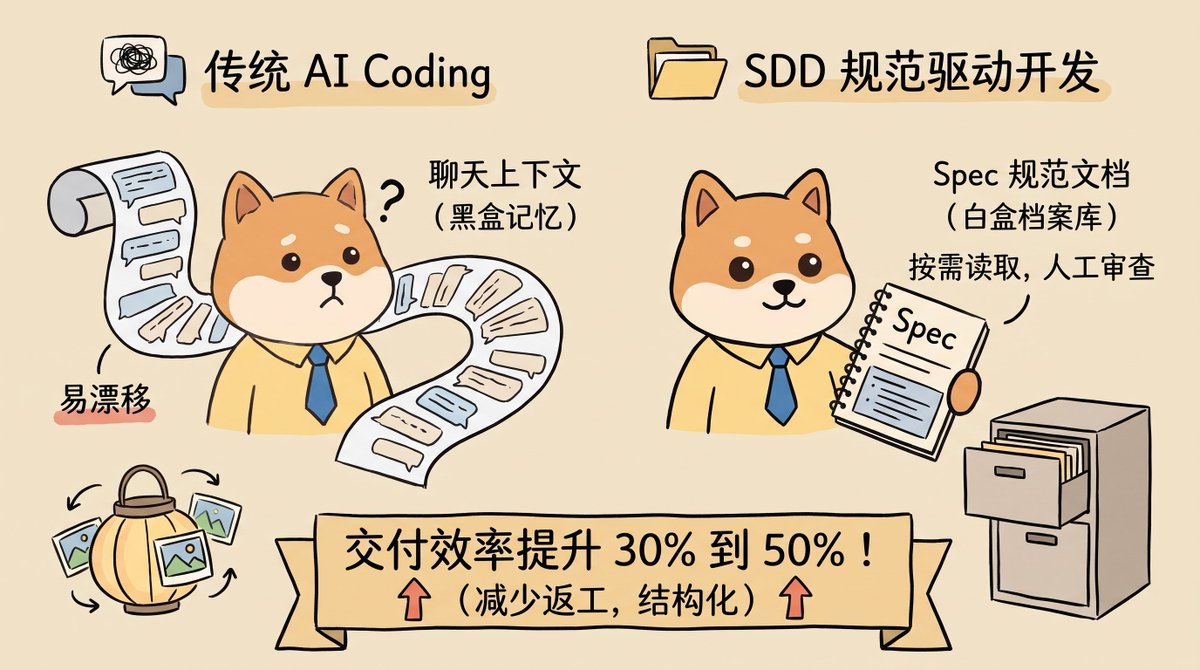
简单来说:普通 AI Coding 以聊天上下文为准,SDD 规范驱动开发以规范文档为准
看到这里,很多朋友会疑惑:Left,你把规范喂给 AI,AI 不照样是从上下文读吗?
虽然 SDD 最终也是加载到上下文,但 SDD 跟普通模式的关键差异在于:只依赖历史上下文开发像走马灯,在任务执行过程中极易跑歪;而 Spec 是人工审查确认后固化下来的结构化文件,就算跑歪也能及时补救回来
SDD 的本质,是把依赖海量聊天记录的黑盒记忆,转变成按需读取、每次只读一小段的白盒档案库
举个栗子:
普通模式就像每次在输入框打字都要反复叮嘱 "用 TypeScript 写、错误要用 AppError 包装、别用 any"。聊了十轮之后,AI 上下文被冲刷,第十一轮它又开始偷懒写 any
而 SDD 模式中,输入框只聊业务 "新增一个登录接口",AI 自动读取项目规范里的 code-style.md,从第一行代码开始就严格遵循既定规则
Thoughtworks 等工程团队在 AI 研发的落地实践中也验证过,把规范前置之后,由于减少了反复返工与对齐成本,整体交付效率相比普通的对话式开发能带来 30% 到 50% 的提升。现今越来越多的团队和独立开发者也都在践行这套模式
三、最简开发流程
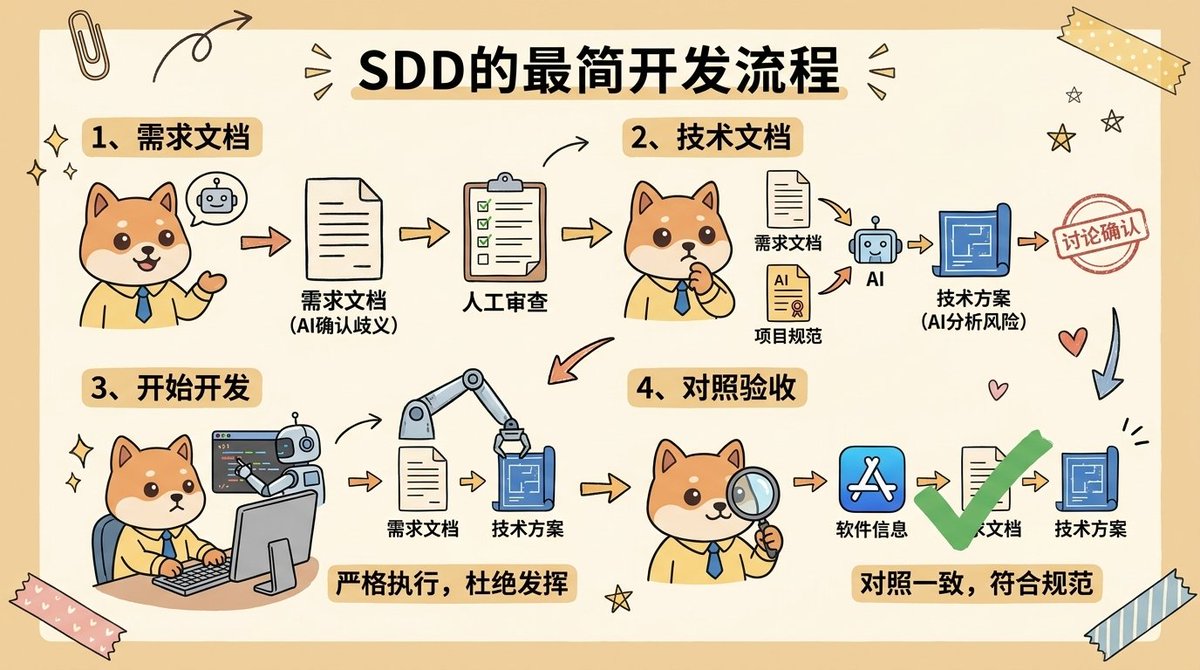
从我的最佳实践出发,SDD 的最简开发流程就四步:
1、需求对齐:给 AI 输入一句话需求,要求它充当产品经理反问:"指出这段逻辑里所有模糊、有冲突的边界条件"。讨论完毕后,由 AI 整理成结构化的需求文档,人工只做审查确认
2、技术方案:把需求文档发给 AI,让它结合项目现有架构列出影响范围与潜在技术风险,输出技术方案与改动文件清单
3、精准编码:向 AI 明确约束范围:"严格根据上述文档执行,只允许改动清单内的文件,严禁擅自重构未提及的模块"
4、对照验收:让 AI 按照需求文档与技术文档自检,逐条核对验收项并生成交付报告
在这套流程里,人类的核心精力放在前两步的文档把关和最后的验收上,写代码和验收则全权交给 AI 对照执行
四、Spec 如何分类
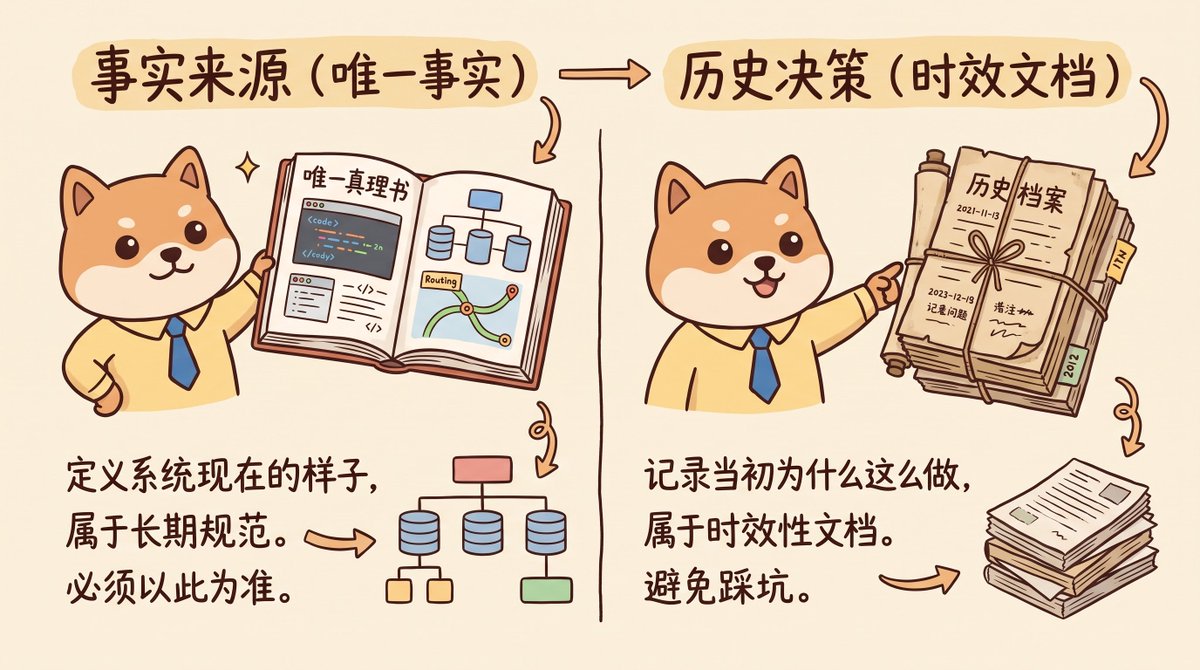
很多朋友不知道规范该怎么存。其实规范主要分两类:
1、事实来源(唯一事实)
它的作用是定义系统现在的样子,属于长期规范。比如统一的代码风格、数据库表结构、全局路由规则。它应该是唯一的,不散落多处,长期有效,开发新功能都必须以此为准
2、历史决策(时效文档)
就是上面提到的需求文档和技术方案。它的作用是记录当初为什么这么做,属于时效性文档。这类文档只满足当前某次迭代的需求,功能上线后就可以归档。保留它们是为了让 Agent 随时看懂当时的决策意图,避免后人踩坑
五、Spec 如何管理
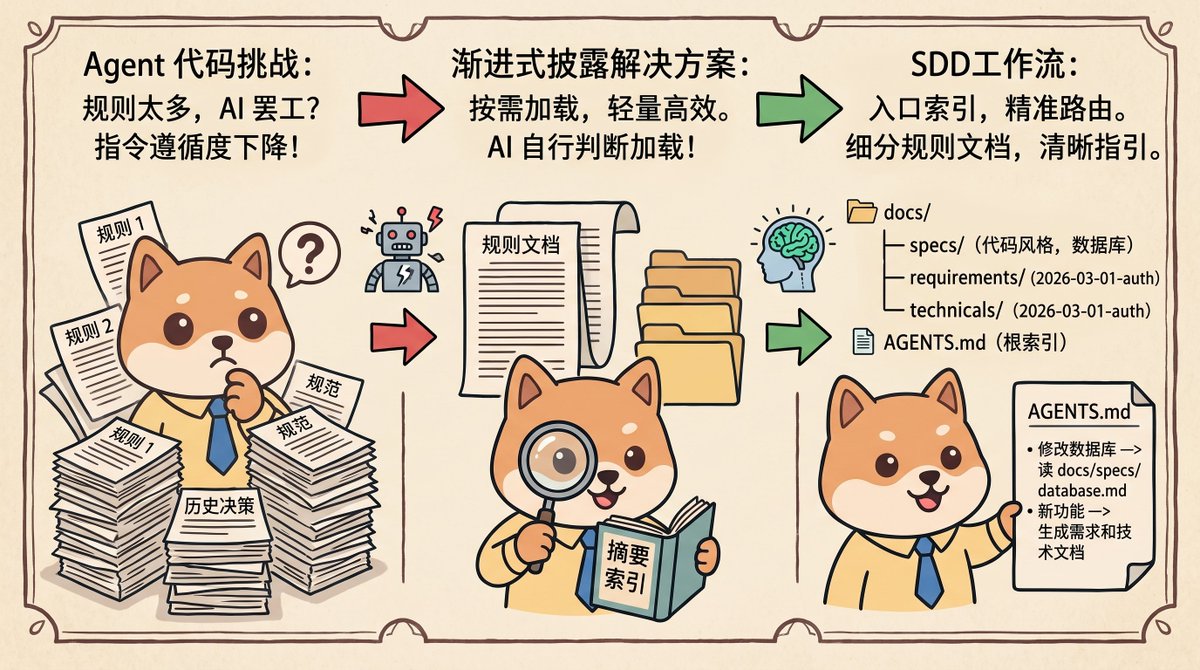
经常用 Agent 写代码的朋友都知道,每个会话窗口一次给 Agent 喂的规则不能太多,太多了会导致指令遵循度断崖式下降。那历史有这么多的决策和规范,要如何喂给 AI?
答案就在渐进式披露中
渐进式披露最早在 Skill 中被广泛应用。会话加载时,并不会把完整的规则一股脑塞进上下文,而是先加载一层轻量的摘要索引。任务进行过程中,Agent 会自行判断是否需要某份规范,需要的时候再去完整加载对应内容
我的 SDD 工作流也是基于这个原理:不把所有规范都塞在同一个规则文件里,而是把入口规则文件当成索引,指向细分的规则文档
实际的目录结构长这样:
docs/ ├── specs/ # 事实来源(长期有效的全局规则) │ ├── code-style.md # 代码风格与架构约束 │ └── database.md # 数据库设计与现有表结构 │── requirements/ # 历史决策(按需求方案归档的时效文档) │ └── 2026-03-01-auth/ # 某次具体迭代的需求方案 └── technicals/ # 历史决策(按技术方案归档的时效文档) └── 2026-03-01-auth/ # 某次具体迭代的技术方案 AGENTS.md # 根索引:告诉 AI 什么时候该去读哪份规则
在 AGENTS.md 里面只需要写清晰的路由指引:
在修改数据库相关代码前,必须先完整读取 docs/specs/database.md 在开启新功能开发前,必须先在 docs/requirements/、 docs/technicals/ 目录下生成本次的需求和技术文档
看到这里,有的朋友可能会问:在 AGENTS.md 里面写了指引,AI 真的会老老实实去读子文档吗?
我们在根文件(CLAUDE.md、AGENTS.md)注入的是高优先级的触发规则,在会话创建时就注入到系统提示词中。AI 在生成修改方案前,会先根据根文件规则读取指定的 Spec 文件。这样既不把几万字的完整规则一次性塞爆上下文,又能确保在动关键代码时规范精准生效
六、开箱即用的 Spec 管理 Skill
手动维护这套结构虽然有效,但现实中往往很繁琐:写着写着规范路径失效了、规则之间出现冲突,或者换个新项目又得重新手搓一遍目录
为了解决这些重复劳动,我把上面这套经过验证的目录规范与治理逻辑,封装成了一个开箱即用的开源 Skill:agents-spec
它主要帮你搞定几件事:
1、自动化规范审计:直接对项目现有的指令和文档做结构体检,指出哪些规则写散了、哪些索引没挂上,先出迁移报告再动工
2、标准的渐进式目录治理:一键梳理出标准的根目录 AGENTS.md,并在 docs/ 下自动组织好 specs/(项目规范)、requirements/(需求决策)和 technical/(技术方案)
3、自带轻量 Guard 校验:内置了无第三方依赖的 Python 校验脚本,在本地或 CI 流程里随时检查 AGENTS.md 的合规性,防止规则被误改写崩
4、全平台通用:基于标准的 Agent Skills 规范开发,无论你平时用的是 Claude Code、Cursor 还是 Codex,都能无缝接入
安装极其简单,在终端里敲一行命令就行,或者把仓库地址丢给 AI 让 AI 帮忙安装:
npx skills add https://github.com/leftzzzz/agents-spec-skill
装好后,直接在你的 Agent 会话里用大白话下指令:
"用 agents-spec 帮我审计一下当前项目的规范索引,整理出迁移计划"
仓库完全开源,感兴趣的朋友可以去 GitHub 自取,直接集成到你现有的工作流里体验
https://github.com/leftzzzz/agents-spec-skill
七、最后的话
很高兴你能看到这里,如果这篇文章对你来说有收获,Left 在这里跪求一个小小的赞
本教程是基于我的 AI Coding 实践编写的,如果有问题的话,欢迎跟我交流探讨,大家一起讨论交流,共同进步
我是程序员 Left,关注 AI Coding、Agent 与独立开发,我们有缘再见!


