别天天想着vibe coding,分享我用AI帮助孩子学习,一个月提高30分
文章目录
这也是我真实的案例,因为暑假孩子一直在上英语班,那么我有时候也坐在教室里面听课。但我发现孩子是不可能全程认真听的,这也很正常。所以我就突然想到,我为什么不录下来,然后回家用ai整理了?
这里就拿我这次的案例拿出来分享,所以ai并非仅仅你想的只能去做代码?去做图片文字?其实只要能想,就能解决生活中的很多问题。
全程无保留分享我用 GPT 做的一个事:把老师讲课录音下来,本地分析,做讲义。
一句话原理:录音在本机转成文字,AI 抽出能确认的老师讲解,排版成孩子第二天能用的复习卡。
一、信息量太大,孩子听不全;那我为什么不在现场录下来?
现在很多暑期班,一上就是两是哪个小时,讲句真心话,不是孩子不努力,而是课堂信息密度高、节奏快——老师在讲解题型的同时还要纠正语法、补充例句、提醒考点,孩子完全不开小差是不现实的。
我的第一反应:与其干着急,不如在允许的情况下把录音留在自己电脑上,课后整理成孩子能直接复习的讲义。这节课是英语课(贴合我手头的案例),但方法不限于英语。
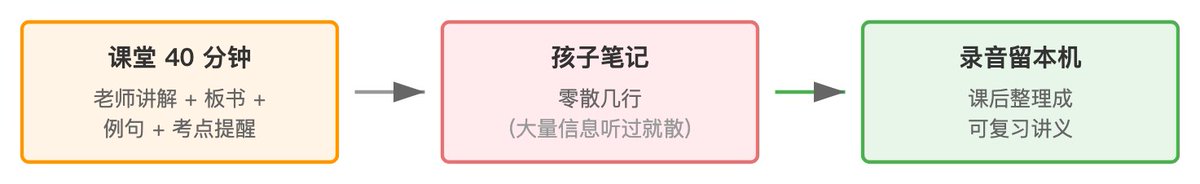
课堂信息量大,孩子无法 100% 听全;录音留本机,课后提取老师讲解
二、本机工作流:从录音到讲义,AI 每一步在干什么
2.1 前置
录音分上下半节,分别存为两个文件,方便后续按分钟对齐。原始录音文件不动,所有处理都在本机完成,不把整堂课先丢到公网。
说明一下:这不是「AI 帮你听写」,而是先用本地 Whisper 模型转写,再用 GPT 类对话模型整理成讲义。Whisper 是个语音识别模型,不是 ChatGPT——它只负责把音频变成文字,不负责理解课程内容。
2.2 转写(重点机制)
本机跑的是 Whisper Large-v3 MLX,支持 Apple Silicon 本机串行运行,不需要上传云端。转写完成后不只是一个纯文本,而是一个 JSON 文件,里面按音频时间轴分段,每一段包含:
· start / end:这段音频的开始和结束时间(秒)
· text:这段转写出来的文字
· avg_logprob:整段平均对数概率,反映模型对这段文字的整体信心(白话:可信程度)
· compression_ratio:压缩率,反映这段文字是不是模型在重复说车轱辘话(白话:幻觉或复读痕迹)
· no_speech_prob:这段音频里没有语音的概率(白话:这段是不是静音或噪声)
· words:字级(词级)数组,每个字/词都有自己的概率和时间戳,用来定位字词级别的低置信度问题
关键点:JSON 是后续所有处理的原料,必须保留下来,不能只留纯文字稿。
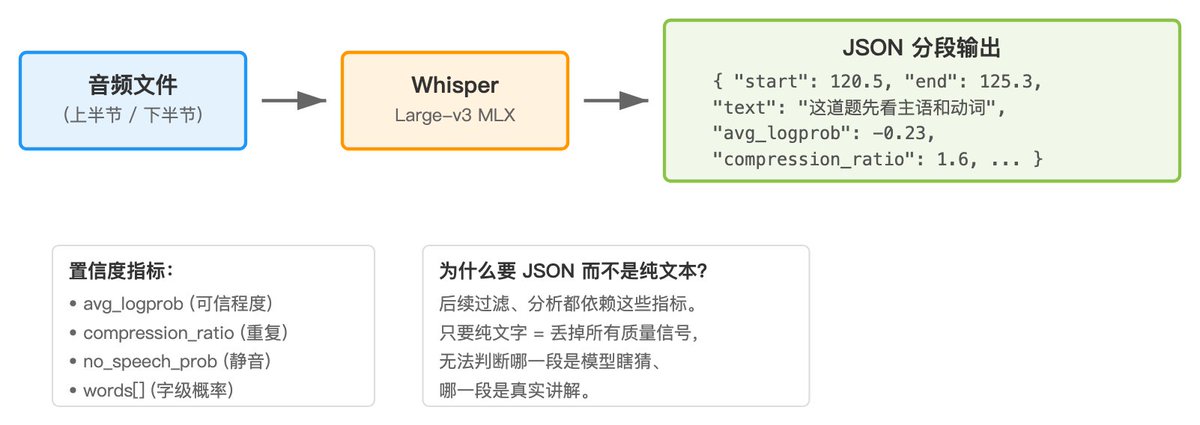
Whisper 工作机制:音频 → 模型推理 → 带时间戳、置信度的 JSON 分段
2.3 过滤不可靠段(重点机制)
转写出来会有大量垃圾内容,比如静音、噪声、重复幻觉、识别不清的片段。过滤脚本 tools/build_review_corpus.py 会读取 JSON,进行两种处理:
硬过滤规则(不满足条件就直接标记为 reliable: false):
· 空段:没有文字或文字长度太短
· 压缩率 > 2.4:说明模型可能在重复,有幻觉嫌疑
· no_speech_prob > 0.60 且 avg_logprob 很低:说明大概率没有语音,或识别极不可靠
· 连续重复:相邻分段时间戳异常或内容重复
· 时长异常:一段音频过长或过短,不符合正常说话节奏
软警告(只标记但不强制删除):
· 低 avg_logprob
· 低字级概率(words 里某些词概率低)
这些标记不会直接抹掉内容,而是输出一个按分钟对齐的 reviews/minute_corpus.md,方便人工回头检查哪一分钟不可靠。
关键点:过滤不是靠人肉听,而是靠模型自己给的置信度指标。 AI 不能保证 100% 正确,但能告诉你哪一段可能错了。
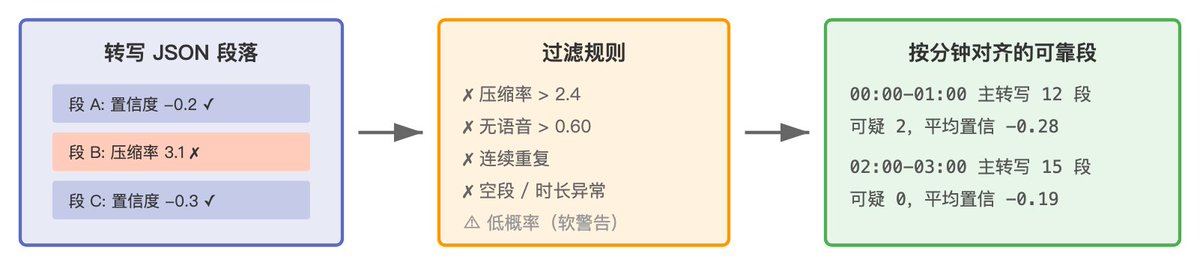
过滤机制:读取 JSON 置信度指标,标记不可靠段,输出按分钟对齐的可用段落
2.4 抽老师讲解
转写稿里混杂着老师讲解、学生回答、点名、闲聊、翻书声。这一步是在转写稿基础上对照原始音频和关键词索引,只保留老师连续讲解、板书、示范句、答题方法,删掉学生回答、点名、无关对话。
工具里有一个 analysis/keyword_hits.md,按关键词索引(比如「背」「读」「时间」「疑问句」「语法」「填空」),帮助快速定位老师正在讲的知识点。
关键点:这一步不是让 AI 自动抓取,而是人对照转写稿做筛选,AI 主要负责定位。
2.5 GPT 重写讲义
筛选后的老师讲解内容,交给 GPT 类对话模型重写成孩子能看懂的讲义。目标结构固定为:
1.核心复习卡:今天最重要的 5–6 条,写成卡片形式,一眼能记住
2.分主题方法:按知识点拆开,每部分对应老师讲的具体方法
3.必背板书:需要背下来的板书内容、公式、例句
4.限时顺序:提醒孩子按什么顺序复习,每步大概花多少时间
5.订正题:从课堂练习题里挑出易错点,做成孩子可以重新做一遍的题目
英文示范按标准语法整理,不能照抄原声。开头明确标注:「这不是逐字稿」,避免孩子误以为 AI 抄了原话。输出为 output/*_孩子复习讲义.md。
2.6 去隐私、导出终稿
写一个脚本 build_study_docx.py,读取 Markdown 讲义,自动设置配色、字体、段落格式。加上封面,自动分页。清空 Word 文件的 author / comments 信息,避免留下家长姓名、孩子姓名或其他隐私。导出为 *_孩子复习讲义.docx。
最后做 QA:把 Word 转成 PDF,再每页渲染成 PNG,检查排版是否有问题、有没有遗漏姓名。
关键点:这一步不是为了好看,是为了让孩子拿到手就能用,同时不泄露隐私。
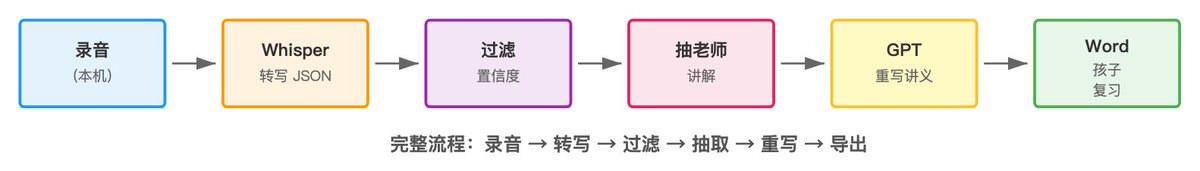
完整流程图:录音在本机转写、过滤、抽老师讲解、GPT 重写、导出 Word
三、这就是孩子领到的复习讲义
下面是真实导出的文件,不是模拟效果图。可以指回 /Volumes/恋山/codex/8.12英语课复习整理/output/8.12英语课_孩子复习讲义.md 和 QA 渲染图。
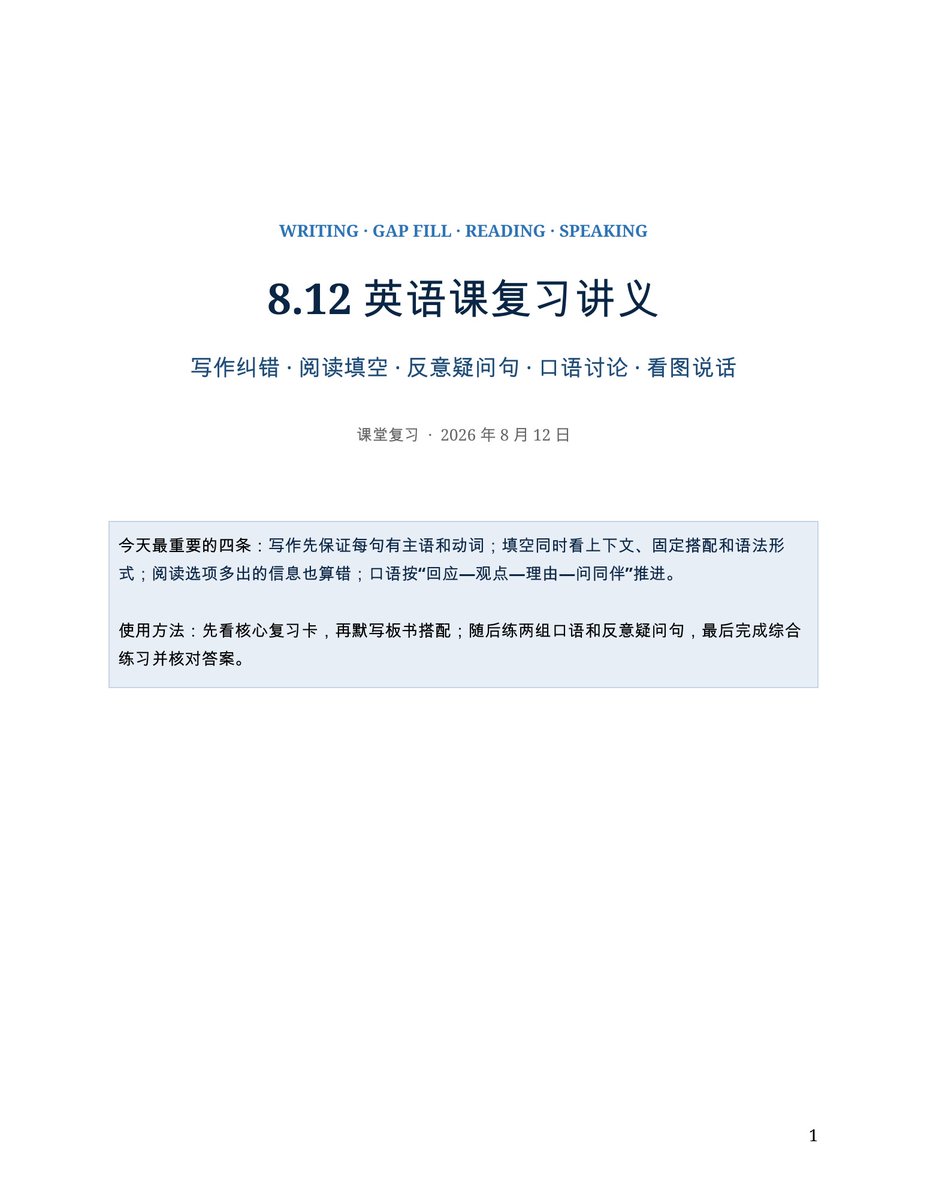
封面页:干净、明亮,只有课程名称和日期,不出现孩子名、家长名。上方写明「WRITING · GAP FILL · READING · SPEAKING」,中间大标题「8.12 英语课复习讲义」,副标题「写作纠错 · 阅读填空 · 反意疑问句 · 口语讨论 · 看图说话」,底部「课堂复习 · 2026 年 8 月 12 日」。开头有一个浅蓝色提示卡:「今天最重要的四条:写作先保证每句有主语和动词;填空同时看上下文、固定搭配和语法形式;阅读选项多出的信息也算错;口语按"回应—观点—理由—问同伴"推进。」
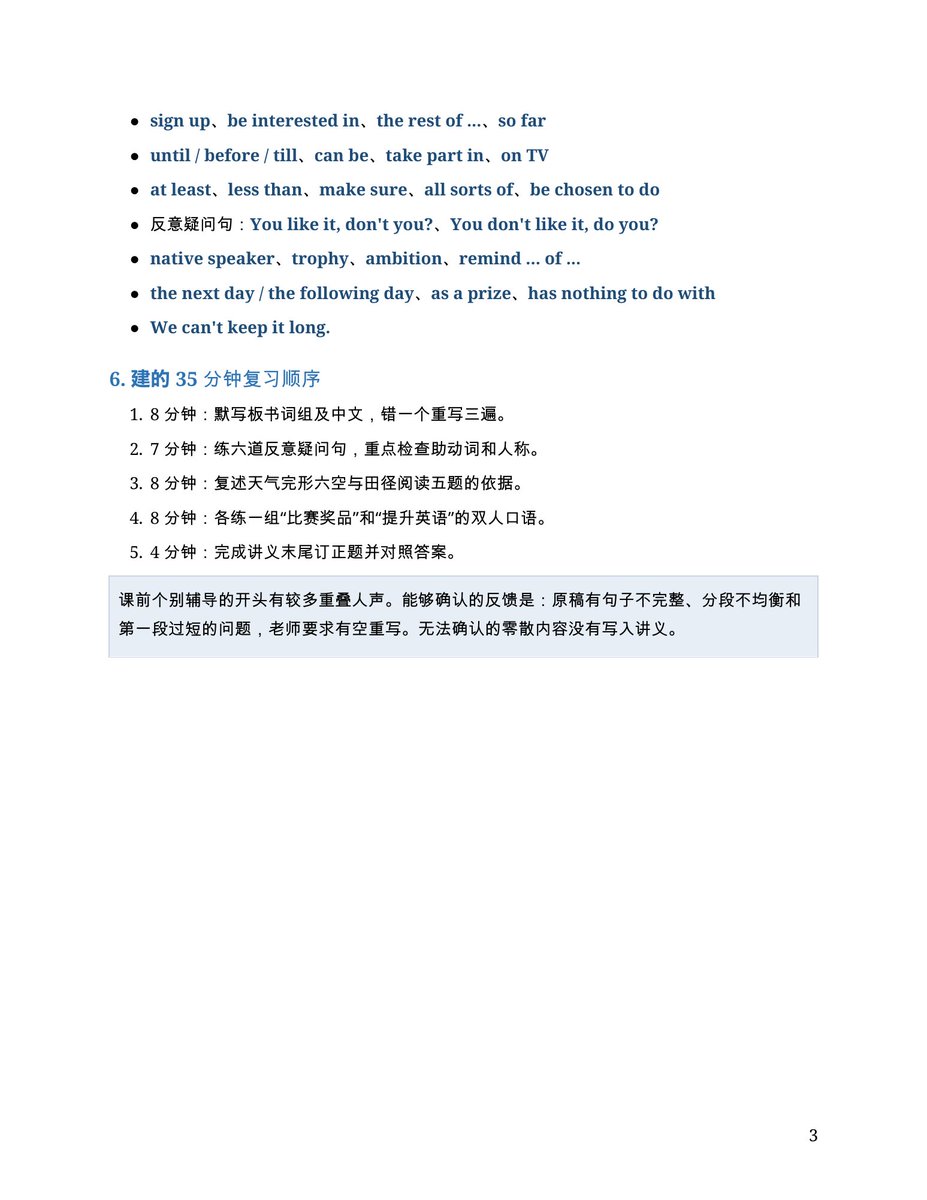
内页:顶部是「一、今日核心复习卡」,下面按主题拆开(写作、阅读填空、阅读选择题、口语讨论、板书重点、复习顺序),每块都有亮色标题,适合孩子抓重点。底部标注「整理说明:本讲义依据 8 月 12 日上下半节课堂录音与两张板书整理。只保留能够确认的老师讲解、个别辅导、示范句、答题方法与考试提醒;学生回答、姓名、课间闲聊、纪律提醒、重叠人声和明显误识别均已剔除。英文示范已按标准语法整理,适合孩子复习,不是课堂逐字稿。」
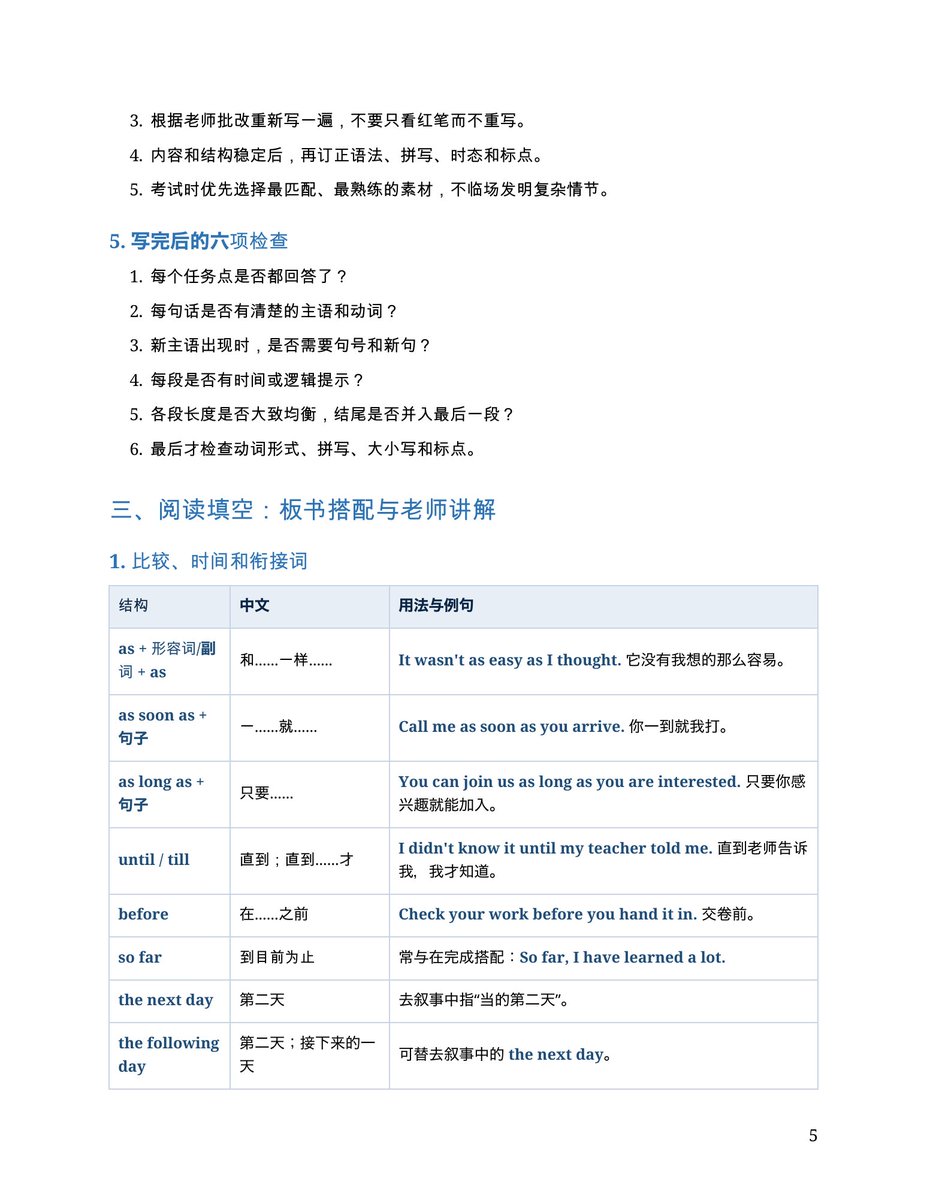
方法详解页:「二、阅读填空用"三步锁定"」整页都是方法拆解、示例句、固定搭配,字密集、可操作,适合孩子反复看。每个知识点都有「参考翻译」「自查口令」「常见错误」,不是只给结论。
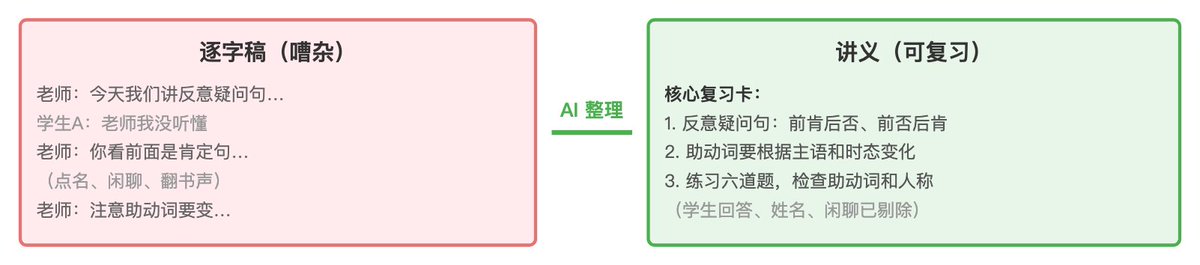
这是把「嘈杂的逐字稿」变成「可复习讲义」的效果:没有废话,只有要点和方法。
对比:逐字稿(嘈杂、夹杂学生回答、点名)vs 讲义(可复习、只保留老师讲解要点)
四、想试的话,先过一遍这张自检清单
自检清单(逐条检查再开始):
· ☐ 录音前经过老师允许
· ☐ 原始音频留本机,不上传公网
· ☐ 转写用本地 Whisper 模型,不是直接丢给 ChatGPT
· ☐ 过滤掉了明显不可靠段(压缩率高、无语音概率高)
· ☐ 已从转写稿里剔除学生回答、点名、闲聊
· ☐ 讲义开头标了「不是逐字稿」
· ☐ 导出 Word 前清空了 author / comments
· ☐ 孩子复习前自己读一遍,确认没有遗漏姓名
谁不适合用:
· 没有征得老师同意的人
· 想把录音发布到网上的家长
· 以为有了讲义就可以不上课的人
最后补一句温柔提醒:这方法的起点是「想帮孩子节省时间」,不是「替代课堂」。孩子拿到讲义后,先看核心复习卡,再默写必背板书,再订正易错题——这才是把「听过就散」的课堂,变成「能反复看」的复习纸。
五、两种上手方式
5.1 自己配置(从零开始)
如果你想自己用 ChatGPT 或其他对话模型试试,需要先把录音转成文字,再让 AI 整理成讲义。假设你的电脑里什么也没有,下面是完整步骤:
第一步:安装 Whisper 转写工具
方案 A:Mac 用户推荐 MacWhisper(图形界面,最简单)
1. 打开 Mac App Store,搜索「MacWhisper」,下载安装(有免费版,足够日常使用)
2. 打开 MacWhisper,第一次启动会自动下载模型(Large v3,约 3GB,需要等几分钟)
3. 把录音文件拖进去,点「Transcribe」,等转写完成
4. 导出为「JSON」格式(不是纯文本),保存到桌面
方案 B:Windows 用户或喜欢命令行的 Mac 用户(Whisper.cpp)
1. 访问 https://github.com/ggerganov/whisper.cpp/releases,下载对应系统的预编译版本:
2.下载方式
· Windows:下载 whisper-bin-x64.zip
· Mac:下载 whisper-bin-arm64.zip(Apple Silicon)或 whisper-bin-x64.zip(Intel)
3. 解压到一个文件夹(比如桌面的 whisper 文件夹)
4. 下载模型文件:在解压出来的文件夹里找到 models 目录,运行里面的下载脚本(Windows 双击 download-ggml-model.cmd,Mac 打开终端运行 ./download-ggml-model.sh large-v3)
5. 把录音文件(比如 lesson.m4a)放到 whisper 文件夹里
6. 打开命令行(Windows 按 Win+R 输入 cmd,Mac 打开「终端」),进入 whisper 文件夹:
cd Desktop/whisper
7. 运行转写命令(替换 lesson.m4a 为你的文件名):
whisper-cli -m models/ggml-large-v3.bin -f lesson.m4a -of lesson --output-json
8. 等几分钟(一小时录音大约需要 5-10 分钟转写),完成后会生成 lesson.json
方案 C:不想装软件的用户(在线工具 OpenAI Whisper API)
1. 访问 https://platform.openai.com/,注册 OpenAI 账号
2. 充值最低 5 美元(Whisper API 按分钟计费,1 小时录音约 0.36 美元)
3. 获取 API Key(在 API keys 页面创建)
4. 用下面的 Python 脚本转写(需要先装 Python,从 python.org 下载):
pip install openai
python3 -c "
import openai
import json
openai.api_key = '你的API_KEY'
with open('lesson.m4a', 'rb') as f:
    result = openai.Audio.transcribe('whisper-1', f, response_format='verbose_json')
with open('lesson.json', 'w') as out:
    json.dump(result, out, ensure_ascii=False, indent=2)
"
⚠️ 重要:方案 A 和 B 在你自己电脑跑,录音不上传;方案 C 会把录音传到 OpenAI 服务器。如果课堂录音涉及隐私,优先用方案 A 或 B。
第二步:筛选转写稿
打开刚才生成的 lesson.json(用记事本或文本编辑器),你会看到很多段落,每段都有时间和文字。人工过一遍,标出哪些是老师讲解、哪些是学生回答。如果某段的 no_speech_prob(无语音概率)大于 0.6,或者 compression_ratio(压缩率)大于 2.4,可以直接删掉(这些是模型瞎猜或重复幻觉)。
把筛选后只保留老师讲解的部分,复制到一个新文本文件 teacher-only.txt。
第三步:用 AI 整理成讲义
打开 ChatGPT(chat.openai.com,免费版就够用),复制下面的提示词,把 [在这里粘贴] 替换成你刚才筛选好的 teacher-only.txt 内容:
你是课堂讲义整理助手。我会给你一份课堂录音的转写稿(已经用 Whisper 转写成文字,并手动筛选出只保留老师讲解的部分)。  你的任务:
1. 重写成孩子能复习的讲义,结构固定为:
- 核心复习卡(今天最重要的 5-6 条,一眼能记住)
- 分主题方法(按知识点拆开,每部分对应老师讲的具体方法)
- 必背板书(板书内容、公式、例句)
- 限时顺序(提醒孩子按什么顺序复习,每步大概花多少时间)
- 订正题(从课堂练习题里挑出易错点)
2. 英文示范按标准语法整理,不能照抄原声。
3. 开头明确标注:「本讲义依据课堂录音整理,不是逐字稿。」
4. 去掉所有姓名、学生名字、老师名字。
现在,这是筛选后的老师讲解内容: [在这里粘贴你的 teacher-only.txt 内容]
第四步:检查和导出
ChatGPT 输出的讲义,你需要:
· 再检查一遍,确认没有遗漏姓名
· 确认没有编造老师没讲过的内容(对照原始转写稿抽查几处)
· 复制到 Word,调整字体、颜色、分页,加封面
· 清空 Word 文件属性里的作者名(Word → 文件 → 属性 → 摘要,把「作者」「上次保存者」清空)
✓ 完成:现在你有一份可以交给孩子的复习讲义了。记得告诉孩子:先看核心卡,再默写必背,再订正易错题。
记住一句话:讲义是帮孩子节省时间的工具,不是替代课堂的捷径。