实测新号4天3万曝光,爆款「海绵宝宝经济学」是怎么自动化产出的?
文章目录
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
说流程之前,先看看这个内容 社群内测小伙伴 最近实战的战况,让大家有一个体感:
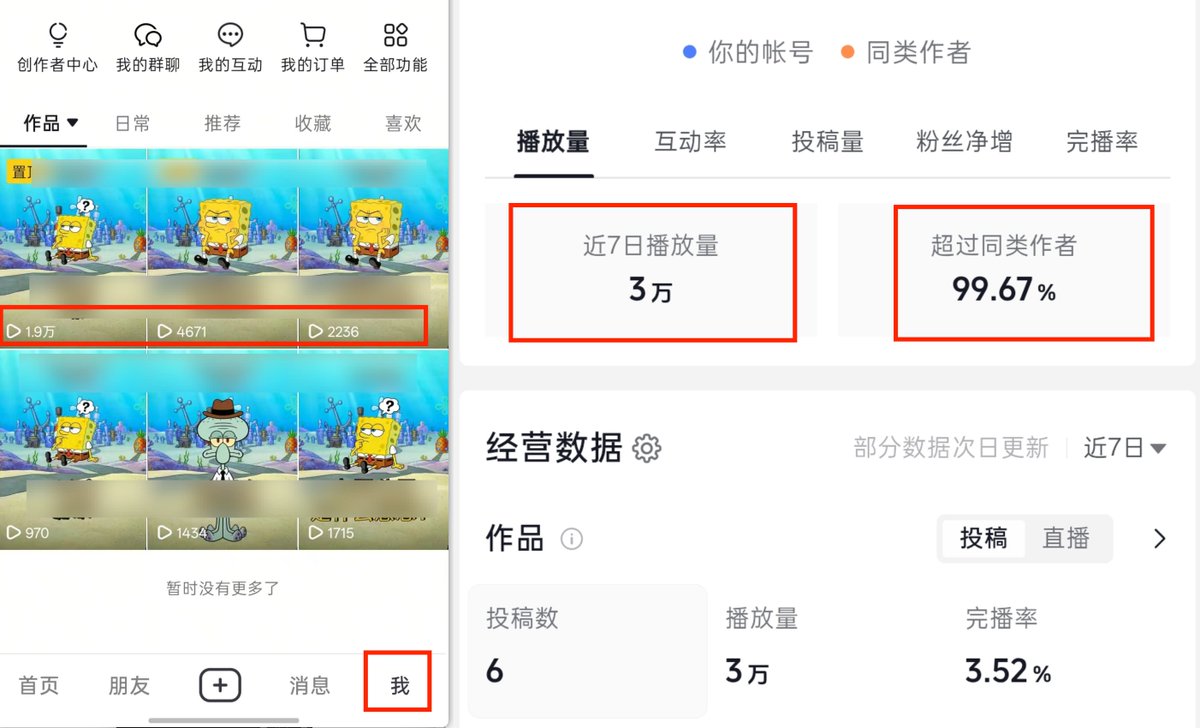
社群内测小伙伴 8月8号一次性生成了一周要发的视频,开始每天发布一个,截止昨天,一共6个视频。累计播放已经破了 3 万,完全新号,没有任何的投流或者加热操作。直接入选抖音精选。
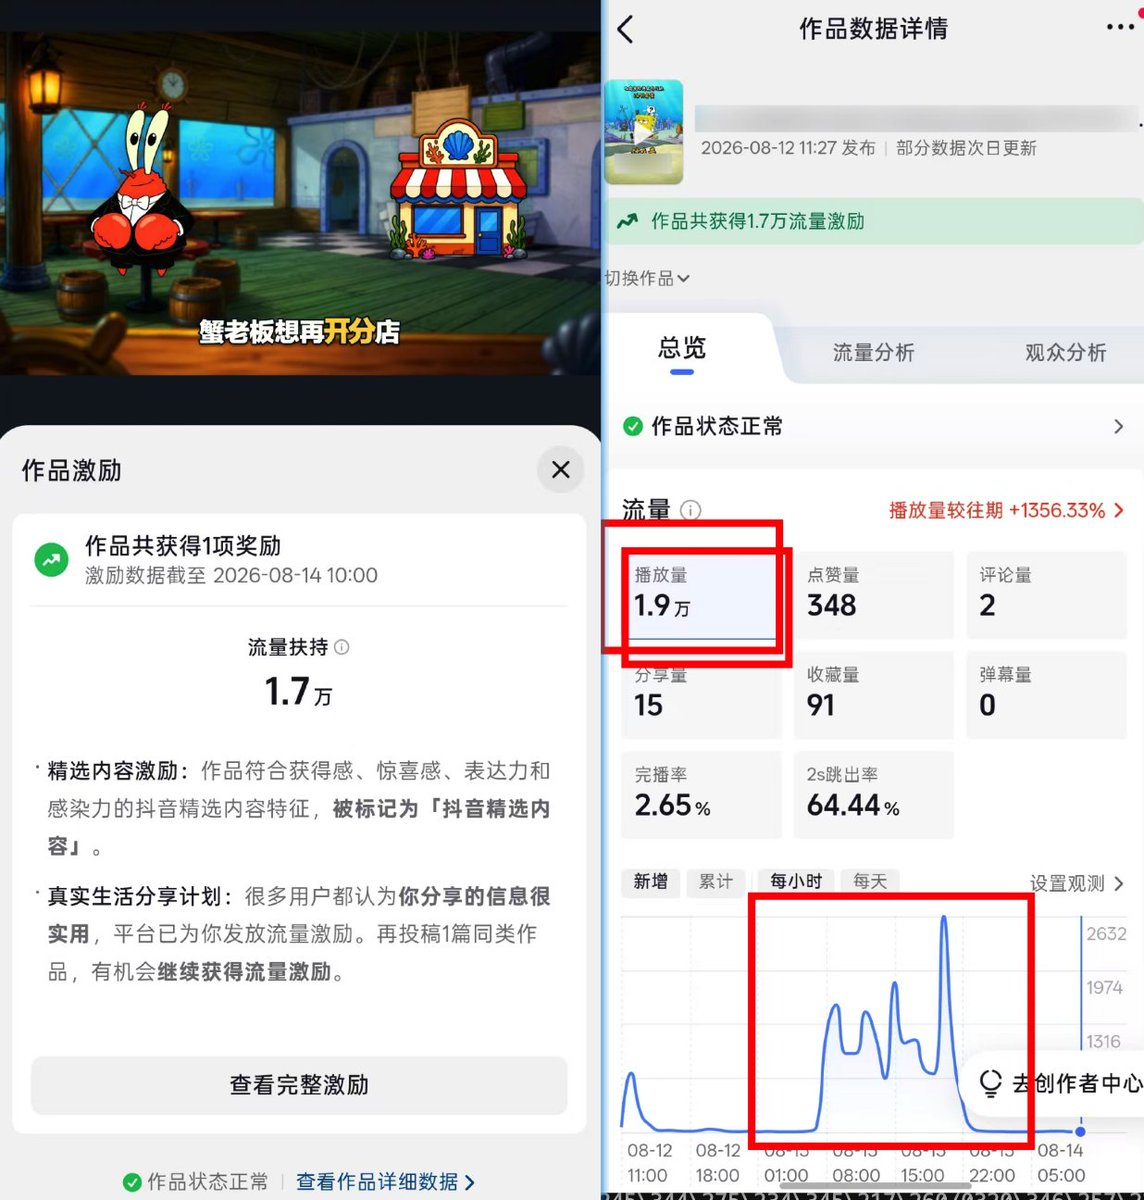
纯自然流实现的,这个对于新人做视频账号还是有不少正反馈的,直呼这波算是入行“自媒体赛道了”。
最近我也一直在更新相关的进展:
这套流程我改了很多轮,才把一条六十多秒的视频完整跑顺。
刚开始做 AI 科普视频,最容易低估的是画面和口播之间的关系。旁白说蟹老板倒卖深海珍珠,画面里就要同时有蟹老板、交易状态和珍珠。下一句说他害怕被追查,角色表情要变,之前的道具也要及时退出。字幕、人物和声音还得落在同一段时间里。
单独做一条,手工拖一拖也能完成。连续做几条以后,素材会重复,文案会修改,字幕和画面开始互相牵连。每次都回到剪辑软件里重新找图、推时间,很快就会耗掉一整天。
我最后用 Codex 管内容和制作任务,用 Remotion 组织画面与声音,再把转写、生图、抠图、配音和检查工具接进来。输入一个主题,或者放进一条参考视频,流程会先跑到逐画面审稿,等画面确认以后再继续生成声音和成片。
这篇用《什么是洗钱》把过程从头走一遍。成片规格为 1920×1080 / 30fps / H.264,时长约 65.75 秒。
整条制作线只需要几类工具。
| 环节 | 主要技术 | 需要解决的问题 |
|---|---|---|
| 内容与任务控制 | Codex | 分析输入、写故事、拆画面并追踪制作状态 |
| 参考视频转写 | Whisper 或 Paraformer | 得到完整口播和词语时间 |
| 背景与道具生成 | GPT Image 或 Flux | 补齐当前画面缺少的普通素材 |
| 透明素材处理 | rembg 或 BiRefNet | 把角色和道具变成可独立控制的 PNG |
| 中文配音 | 云 TTS 或 CosyVoice | 生成旁白和可用的声音时间 |
| 视频合成 | Remotion | 统一控制图层、字幕、音效和渲染 |
| 成片检查 | FFmpeg、ffprobe 和 OpenCV | 检查文件规格、关键帧和音画问题 |
这些工具沿着同一条顺序工作。
主题或参考视频
→ 口播与故事
→ 逐句画面
→ 素材检索和补缺
→ 合成预览
→ 人工确认
→ 配音与时间
→ Remotion 时间轴
→ 渲染和质检
00|先把工作台、素材库和单条项目分开
这套流程开始写代码以前,先要把目录分清楚。
最外层的工作台只分三块。教程资料保存制作规范和参考案例,共享素材库保存可以跨项目使用的图片与声音,单条项目目录只记录这一条视频自己的内容和过程文件。
0320比奇堡海滩海绵宝宝科普教程/
├── 00_教程资料/
│   ├── 制作手册与公开文章
│   └── 爆款参考视频与拆解资料
│
├── 01_素材库/
│   ├── material-library.json
│   ├── font/
│   ├── generated/
│   ├── rejected/
│   └── spongebob/
│       ├── characters/
│       ├── props/
│       └── backgrounds/
│
└── 02_项目/
    ├── C001_有限公司是什么意思/
    ├── C005_什么是洗钱/
    ├── C008_什么是融资/
    └── C009_什么是做空/
共享素材库只维护一份正式素材。角色、背景和通用道具不会因为新建项目就复制一遍。每张新图先进入生成区,检查通过以后再登记;水印、绿边和错误角色会进入淘汰区,后面的项目检索不到它们。
material-library.json 负责把文件路径和实际内容接起来。文件名方便人看,素材记录还要说明它属于角色、背景还是道具,画面里是谁、在做什么,以及它当前能否使用。
单条视频拥有自己的项目目录。《什么是洗钱》的主要文件是下面这些。
02_项目/C005_什么是洗钱/
├── project.json
├── DESIGN.md
│
├── data/
│   ├── project-plan.json
│   ├── reference-analysis.json
│   ├── material-operations.json
│   ├── scene-config.json
│   └── timeline.json
│
├── script/
│   ├── 故事脚本.md
│   ├── narration.txt
│   └── narration-by-scene.json
│
├── audio/
│   ├── voice.mp3
│   ├── voice.srt
│   └── voice-alignment.json
│
├── qa/
│   ├── story-review/
│   ├── final-frames/
│   └── semantic-alignment-report.json
│
└── deliverables/
    ├── 什么是洗钱_字幕.srt
    └── 抖音封面_什么是洗钱_3x4.png
这些文件可以按人读和机器读分成两组。
| 文件 | 谁会看 | 负责什么 |
|---|---|---|
DESIGN.md | 人 | 画幅、字体、色彩、构图和禁止项 |
script/故事脚本.md | 人 | 口播、逐画面素材和联合审稿 |
project.json | 人与程序 | 项目入口、题目和交付位置 |
data/project-plan.json | 程序 | 故事、口播、画面与素材引用 |
data/reference-analysis.json | 程序 | 参考片转写与结构分析结果 |
data/scene-config.json | 程序 | 渲染前的场景、元素与字幕配置 |
audio/voice-alignment.json | 程序 | 旁白词语与时间的对应关系 |
data/timeline.json | Remotion | 最终画面、字幕、声音和时长 |
qa/semantic-alignment-report.json | 人与程序 | 逐句核对口播和可见素材 |
普通审稿时不需要翻完所有 JSON。人主要看 [视觉设计说明]、[故事脚本与画面审核稿]、合成预览和最终字幕。机器文件负责让每次修改能够追到来源。
关键文件沿着固定方向生成。
reference-analysis.json
→ project-plan.json
→ 故事脚本.md 与 story-review/
→ voice.mp3 与 voice-alignment.json
→ scene-config.json
→ timeline.json
→ final-frames/ 与 deliverables/
这里最容易犯的错误,是让同一份信息出现在三四个文件里,再分别手改。口播在计划文件里改了一次,字幕文本又改一次,时间轴里还留着旧句子,后面一定会打架。源文件确定以后,其余文件都从它派生,旧产物发现上游变化就重新生成。
Skill 的运行代码也单独放,不混进任何一个内容项目。
skills/hot-science-video-skill/
├── SKILL.md
├── scripts/
├── remotion/
├── assets/
└── tests/
scripts/ 负责转写、编译、素材处理和质检,remotion/ 只负责渲染组件,assets/ 保存通用模板与字体,tests/ 检查时间、字幕、素材和片尾规则。更新渲染器以后,所有项目都能使用新版本,不用进每个项目复制代码。
01|先把参考视频拆成可以重写的结构
输入参考视频以后,第一步是提取声音并转成文字。
这一步主要比较过 Whisper 和 Paraformer。Whisper 方便本地部署,工具多,处理不同语言也省事。Paraformer 更值得关注中文长音频、标点和时间信息。转写准确率只是其中一项,后面的字幕和动画还需要知道每个词大概落在哪里。
原始转写拿到以后,先别让模型直接改稿。第一轮只做校对,把声音里确实存在的内容还原准确。
| 校对位置 | 具体动作 | 出错后的影响 |
|---|---|---|
| 人名与术语 | 对照原音频修正同音字 | 后面检索到错误角色和概念 |
| 数字与单位 | 重新听前后句,确认数值口径 | 故事冲突和事实判断发生变化 |
| 断句 | 按说话停顿切开长句 | 字幕块太长,画面切换位置错误 |
| 漏字与重复 | 检查静音段和识别重叠 | 新稿误学一段不存在的内容 |
校对完成后,再把转写稿和原视频放在一起看。开场承诺来自哪句话,冲突在哪一段发生,知识解释持续了多久,都要能回到原视频找到位置。
转写完成以后,先保留四类信息。
| 要提取的内容 | 在新视频里的用途 |
|---|---|
| 开头承诺 | 决定观众第一秒知道自己会学到什么 |
| 人物冲突 | 给知识点找一个能继续发展的故事 |
| 解释顺序 | 决定专业概念在什么位置出现 |
| 最终记忆点 | 决定片尾让观众复述什么 |
参考片里的原句、人物和具体例子都重新写。新稿只沿用已经被验证过的信息节奏。这样换一个题材以后,故事仍然能独立成立。
如果输入的只是一个主题,这一步会更短。Codex 先判断题目太大还是太小,再把它收成一条视频能讲清的问题。
这一步结束时,产物只需要一页。上面写清参考片的开场方法、故事冲突、解释顺序和结尾记忆点。程序把完整结果保存到 data/reference-analysis.json,后面的内容计划只读取这份分析,不再反复转写原视频。
02|一条视频只回答一个问题
《什么是洗钱》只回答洗钱是什么意思。
故事先压成一条很短的因果链。
蟹老板倒卖偷来的深海珍珠
→ 得到一笔说不清来源的钱
→ 不敢直接使用
→ 把钱混进餐厅营业额
→ 改动账本制造正常收入的外观
→ 钱的来源仍然有问题
这一步先不写镜头,也不急着生成图片。内容要过三个检查。
| 检查项 | 《什么是洗钱》的答案 |
|---|---|
| 谁遇到了问题 | 蟹老板拿到一笔来源有问题的钱 |
| 他采取了什么行动 | 把钱混进餐厅收入并改动账本 |
| 观众最后要记住什么 | 掩饰来源不会改变这笔钱原来的性质 |
把洗钱两个字拿掉,读者还能复述这个故事,说明因果已经写顺。复述时只能记住黑钱、银行和餐厅几个散词,口播还需要继续改。
知识类题材还要单独核事实。《什么是洗钱》涉及法律与金融,故事可以口语化,定义和行为边界不能跟着剧情随便变化。事实检查在写口播时完成,等画面全部做好再纠正,返工会大很多。
口播定稿前还要完整念一遍。读到专业词时卡住,说明句子还不够口语;一句话读完已经忘了前半句,就继续拆短。删掉字幕以后,声音本身也要能把故事讲明白。
内容确认以后,故事稿至少能给出下面四份结果。
完整口播
每段承担的故事任务
需要核验的事实
片尾问题和答案
这些内容先进入 data/project-plan.json。面向人的 script/故事脚本.md 随后从计划文件生成,把口播、画面任务和素材预览排在一起,方便一次审完。
03|按新信息拆画面
口播通过以后,开始拆语义画面。
普通分镜常写蟹老板出现、展示黑钱、展示账本。人能理解,程序拿到以后仍然不知道该找什么图。每个小段还要继续问清当前人物、动作、对象和状态,最后写出观众应该看见的关系。
《什么是洗钱》前半段可以这样拆。
| 口播推进 | 人物状态 | 关键对象 | 画面任务 |
|---|---|---|---|
| 蟹老板倒卖深海珍珠 | 得意 | 珍珠宝箱 | 交代问题资金的来源 |
| 他赚到一大笔钱 | 兴奋 | 暗色钱袋 | 让观众看见收益与风险同时出现 |
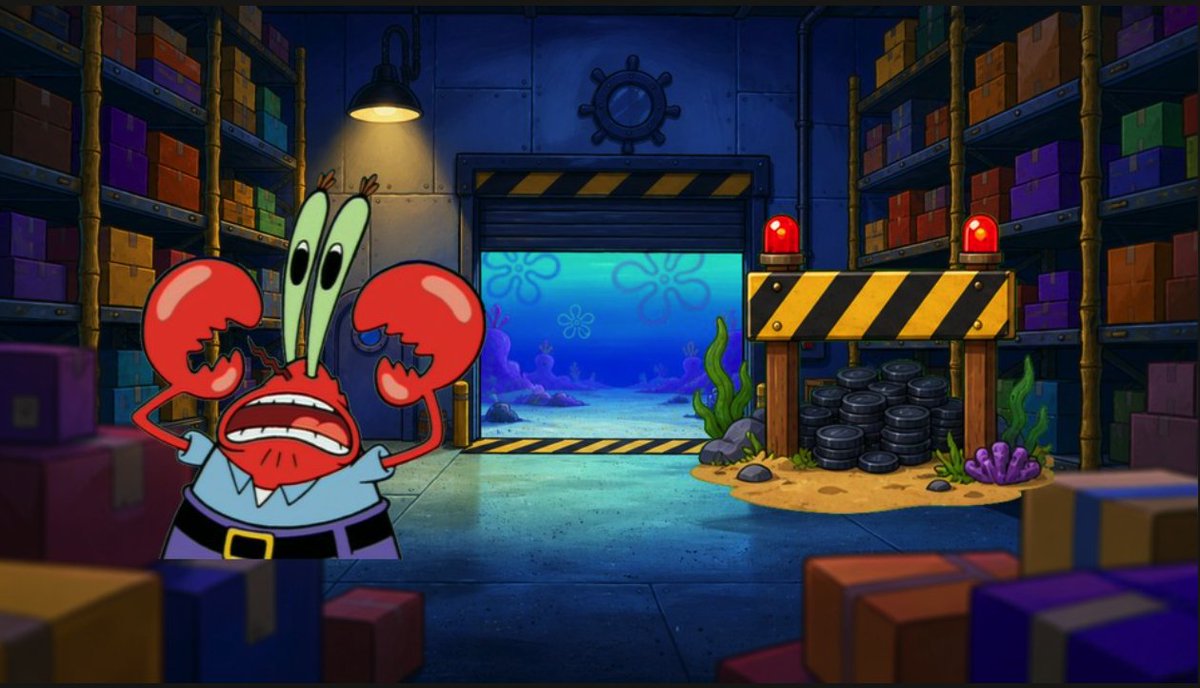
| 他不敢直接使用 | 惊恐 | 警戒与追查道具 | 说明这笔钱说不清来路 |
| 他把钱混进营业额 | 自信 | 两种收入流向收银机 | 表达混合过程 |
| 他又改动餐厅账本 | 紧张 | 账本和金额关系 | 表达掩饰来源 |
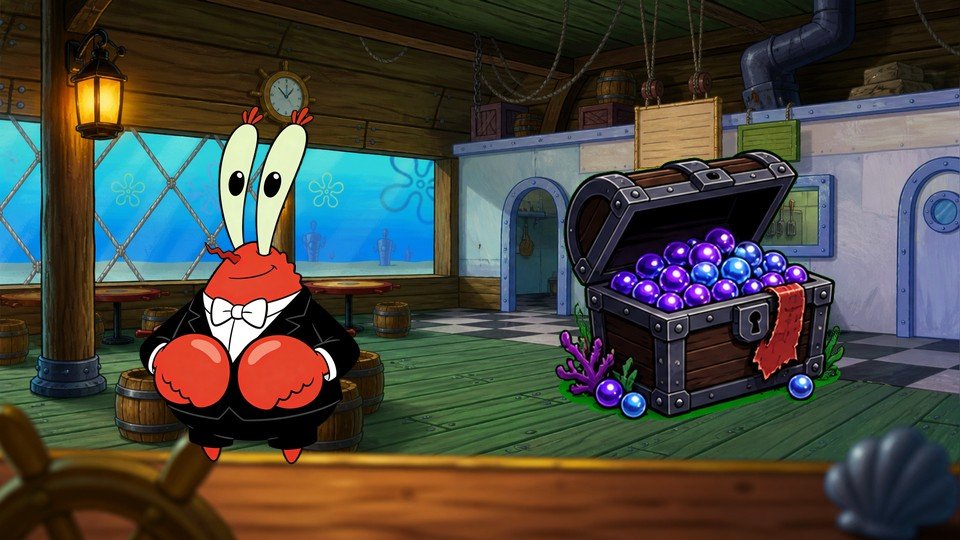
这里没有按固定秒数切画面。新人物出现、动作改变、关键对象更换,或者因果往前走了一步,画面才变化。口播只是继续解释同一件事,原来的构图可以多停一会儿。
这样做还有一个好处。文案改动以后,可以很快找到受影响的画面。只改账本那一句,前面的珍珠和钱袋不用全部重做。
每个语义画面进入素材阶段以前,再按依赖顺序检查一次。
先确认口播原句
→ 再确认人物动作和情绪
→ 找出必须出现的关键对象
→ 写清人物与对象的关系
→ 排除会让故事走错的元素
缺少人物时,画面没有叙事主体;缺少关键对象时,画面只剩角色表演。两个都齐了,还要看它们有没有共同说明当前句子。
04|先查素材,再决定要不要生图
每个画面确定以后,先去素材库找角色、背景和道具。
角色检索需要同时看名字、动作和情绪。旁白说蟹老板害怕,一张开心举钳子的蟹老板不能凑合使用。道具也一样,餐厅账本和普通合同都属于纸质文件,放进当前故事里的含义完全不同。
检索可以先从精确标签做起,再加一层多模态相似度。精确标签方便解释结果,多模态检索可以找到文字描述不一致的近义素材。两层都命中时仍要看图片本身,模型觉得相似,不等于它能解释当前口播。
素材匹配时,我会顺着下面的顺序看。
角色身份
→ 动作和情绪
→ 关键对象
→ 画面用途
→ 画幅与透明状态
→ 水印和质量
结果只有两种。准确就复用,关键语义不对就补新素材。复用率不需要被单独追求,一张错误的旧图会让整段故事失去连贯性。
素材进入正式画面以前,还要记录它实际画了什么。文件名只能帮助人快速浏览,后续检查要依靠图片内容、角色身份和使用场景。否则文件被替换以后,时间轴仍然会把它当成原来的图。
素材从找到到使用,中间需要经过几个状态。
| 素材状态 | 允许做什么 | 进入下一步以前检查什么 |
|---|---|---|
| 待确认 | 查看原图和来源 | 内容是否与登记描述一致 |
| 待处理 | 抠图、裁边或统一画幅 | 主体是否完整,边缘是否干净 |
| 可使用 | 放进合成预览 | 角色、动作、情绪和用途是否准确 |
| 已淘汰 | 保留记录,不再进入新项目 | 说明水印、错图或质量问题 |
同一张图也要控制使用方式。一个开心蟹老板可以在相邻画面里连续停留,不能跨过剧情转折继续充当害怕或紧张的角色。
05|角色、背景和道具分开处理
海绵宝宝、蟹老板和章鱼哥这类熟悉角色,连续镜头里的身份稳定很重要。
角色素材可以走参考图生成,也可以维护一套规范角色库。参考图生成适合补动作,脸型、服装和手脚容易波动。规范素材库比较稳定,遇到新情绪时需要继续补齐。无论走哪条路,同一段故事里的角色造型都要保持一致。
背景和普通道具更适合交给图片模型。GPT Image 的提示服从和文字理解比较方便,Flux 更适合搭建可控的本地工作流。生成时先说清素材要承担什么任务,再限制主体和构图。
一个普通道具的提示顺序可以这样组织。
画面用途
→ 主体是什么
→ 主体处于什么状态
→ 构图和视角
→ 需要哪种风格
→ 背景与边缘要求
→ 禁止出现的文字、水印和额外人物
提示词只写漂亮的海底宝箱,模型可能给出一张完整插画。补上独立道具、主体完整和边缘清楚以后,后续抠图与动画才容易处理。
需要透明底的素材,可以比较 rembg 和 BiRefNet。rembg 接入批处理比较快,BiRefNet 更适合继续观察复杂轮廓与细线。卡通角色经常有手指间空洞、睫毛和白色边缘,抠图完成以后还要再查一遍遮罩。
| 透明素材检查 | 常见问题 |
|---|---|
| 透明通道 | 文件带透明后缀,棋盘格却已经画进像素里 |
| 主体遮罩 | 模型没有找到主体,输出接近全空 |
| 边缘颜色 | 绿幕或原背景残留在角色外沿 |
| 内部空洞 | 手臂、道具把手和人物缝隙被错误填满 |
| 水印与伪文字 | 小角标和乱码混进正式素材 |
背景不需要抠图。它只交代地点和气氛,主要人物与关键道具都留在背景外面。这样文案变化以后,可以只换当前对象,不必重新生成整个场景。
图片交付时不要只留最终 PNG。原图、处理后的透明图和用途说明应该能互相找到。后面发现绿边或裁切错误,可以回到原图重新处理,不必再向图片模型碰运气。
不同素材进入画面以前,还要统一几个基础条件。
| 条件 | 背景 | 角色与道具 |
|---|---|---|
| 画幅 | 覆盖成片画布 | 主体完整,四周留出动画空间 |
| 透明 | 不需要 | 必须有可用透明通道 |
| 文字 | 避免无关文字 | 不接受乱码、标签和水印 |
| 风格 | 与栏目场景一致 | 线条、色彩和光向不能突然跳变 |
06|先摆静态画面,再加动画
素材准备好以后,先把动画全部关掉。
正文画面通常分成四层。
| 层级 | 内容 | 负责什么 |
|---|---|---|
| 背景层 | 餐厅、仓库、城市和办公室 | 交代地点与气氛 |
| 角色层 | 当前故事人物 | 承担动作和情绪 |
| 概念层 | 钱袋、账本和关系道具 | 解释当前知识点 |
| 字幕层 | 正在说的短句 | 帮观众跟上口播 |
大多数正文使用左右关系构图。人物占一边,道具放在另一边,中间留出明显空隙。观众会先认出谁遇到了问题,再看他面对什么。遇到金额变化或因果关系,可以把道具做成一组,但同一时刻仍然只保留一个视觉重点。
正文常用的布局不用太多,三种已经能覆盖大部分句子。
| 布局 | 适合的内容 | 安排方式 |
|---|---|---|
| 单主体 | 介绍人物、情绪或单个概念 | 主体居中,背景负责交代地点 |
| 左右关系 | 人物与对象、原因与结果 | 两个主体分居两侧,中间留出关系空间 |
| 过程关系 | 金额变化或前后步骤 | 对象按阅读顺序排列,人物只保留一个 |
布局确定以后,再检查字幕安全区。字幕不能盖住人物嘴部、手势和关键数字,道具也不要贴着屏幕边缘。横屏画面在手机上观看时,过小的道具很容易失去解释作用。
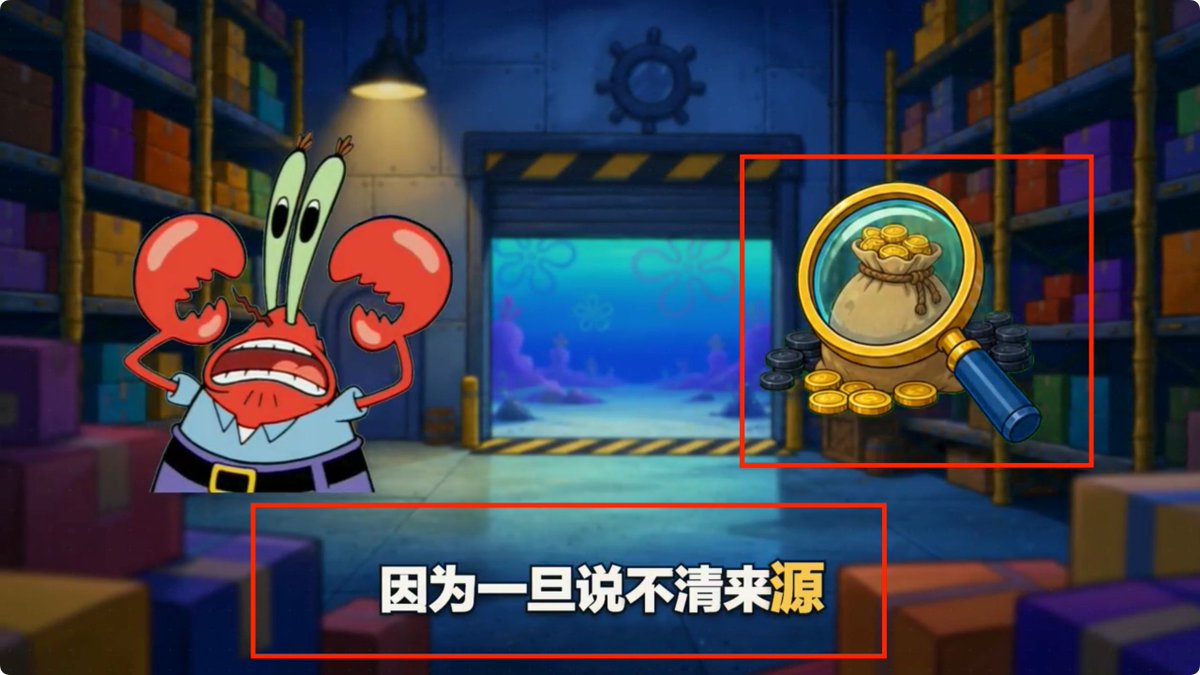
静态画面要过两个问题。
-
关掉字幕以后,能不能看出当前在讲什么。
-
角色的脸、手和关键道具有没有被遮挡。
这两个问题都通过,再给人物和道具加进入、退出和轻微漂浮。动画服务信息顺序。角色先出现,观众先认人;道具稍后进入,画面再补上原因或结果。旧对象完成表达以后退出,新对象才能占用同一个位置。
07|先审融合画面,再做配音
单独看脚本和素材,很多构图问题发现不了。
所以每个语义画面都要先生成一张融合预览。背景、角色、当前动作、情绪和全部道具一起出现,审稿时已经能看到接近成片的布局。预览图片集中放在 qa/story-review/,对应位置会回写进 script/故事脚本.md。
《什么是洗钱》的联合审稿一共展示了 66 次素材引用,去重后是 26 项。数字本身不重要,它说明一条六十多秒的视频里,实际发生的素材切换远比肉眼感觉的多。只审十来张原图,很容易漏掉组合后的问题。
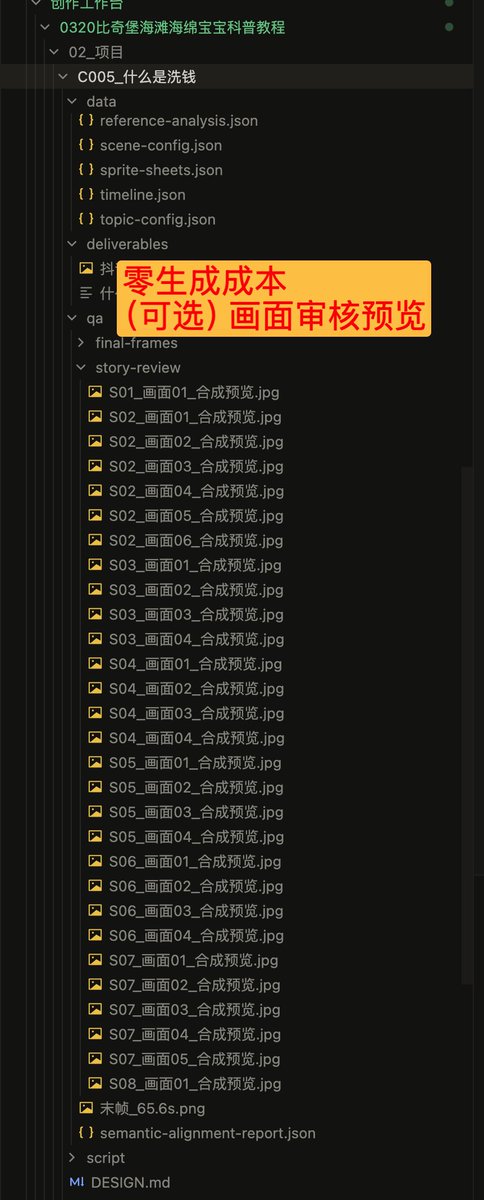
每张预览依次检查下面这些内容。
| 审核位置 | 要确认的事情 |
|---|---|
| 口播 | 当前句子有没有讲清一个完整意思 |
| 角色 | 人物、动作和情绪是否符合剧情 |
| 道具 | 当前对象能否准确解释知识点 |
| 构图 | 主体有没有挡脸、重叠或贴边 |
| 素材质量 | 透明边缘、水印和乱码是否干净 |
审稿不通过时,先判断问题来自哪里。口播说得不清楚就回到故事稿,素材内容不准就重新检索,只有构图问题才在画面里移动位置。把所有问题都交给排版解决,最后会得到一张整齐的错图。
逐画面预览通过以后,再看一张全片联系表。单张画面都清楚,不代表连续播放时有节奏。联系表可以发现同一背景用得太久、角色表情连续重复,以及多个画面的道具颜色过于接近。
口播、角色或关键道具改动以后,对应预览也要重新生成。旧画面已经看过,不能证明新组合仍然成立。
08|让声音决定字幕和画面时间
画面通过以后,再生成正式旁白。完整音频写入 audio/voice.mp3,字幕草稿和词语时间放在同一目录,项目换声音时可以整体失效并重新生成。
中文配音可以比较云 TTS 和 CosyVoice。云服务省部署,对常用中文音色和并发支持比较完整。CosyVoice 适合本地控制与继续调试。选配音工具时,声音自然度只解决听感,视频还需要稳定的时间信息。
最理想的结果是配音同时返回词语时间。服务只能给音频时,可以再做强制对齐。用音频总时长平均分配文字虽然简单,遇到停顿、数字和语气变化,字幕很快会慢半拍。
声音生成以后,时间会沿着下面的关系传下去。
旁白词语时间
→ 当前字幕出现和高亮
→ 语义画面的开始与结束
→ 角色和道具的进入与退出
→ 音效触发位置
字幕只显示当前短句。遇到自然断句,上一块字幕结束,下一块重新出现。标点负责声音停顿,不需要占据画面。这样不会出现人物已经在演下一句话,底部还挂着上一段文字的情况。
配音改动以后,旧的字幕和画面时间不能继续沿用。哪怕只换一个数字,后面的停顿也可能发生变化。稳妥的做法是从新音频重新生成时间,再让字幕和元素跟着更新。
字幕生成后可以先单独播放一遍,只看三件事。
| 字幕检查 | 合格表现 |
|---|---|
| 分句 | 一屏只承担当前短句,读完能自然停顿 |
| 高亮 | 当前发音位置跟着声音移动,不提前抢字 |
| 结束 | 旁白停顿时旧字幕及时消失,不拖进下一句 |
09|用 Remotion 统一画面、字幕和声音
这类视频也能用 FFmpeg 直接合成。FFmpeg 性能高,适合处理转码和规则清楚的媒体操作。画面里有大量 React 组件、动态字幕和图层动画时,Remotion 调试起来更直观,还能在浏览器里逐帧查看。
视频时间轴只保留一套。旁白、字幕、背景音乐和音效都进入同一个 composition,画面元素也从同一份时间信息派生。渲染前的元素关系保存在 data/scene-config.json,声音时间合入以后再生成 data/timeline.json。这样改口播以后,不会出现字幕改了一套秒数,人物还在使用旧时间。
每个正文画面只做几类动作。
| 动作 | 使用位置 | 目的 |
|---|---|---|
| 侧向进入 | 人物与主道具第一次出现 | 建立阅读顺序 |
| 淡出退出 | 当前信息讲完以后 | 给下一件对象让位置 |
| 轻微漂浮 | 人物和道具停留期间 | 避免画面完全静止 |
| 场景切换 | 故事地点或解释阶段变化 | 帮观众重新定位 |
动作不需要堆得很满。人物持续旋转、缩放和摇晃,会抢走知识点的注意力。新信息出现时再动,画面节奏会更清楚。
声音可以分成旁白、背景音乐和提示音。旁白决定主时间,音乐保持在人声下方,提示音只放在关键人物、道具和转场出现的位置。
进入 Remotion 以后,每个场景至少要知道背景是什么、当前有哪些元素,以及字幕采用哪种显示方式。人物和道具还要带着各自的进入方向、显示区间和层级。数据缺一项,渲染器宁可报错,也不要悄悄给一个随机默认值。
浏览器预览时按顺序检查片头、每次场景切换和片尾。发现问题以后先定位到当前场景,再判断是素材、时间还是组件样式。整片反复渲染很慢,局部预览能省掉大量等待。
10|片头、片尾和封面分别处理
片头先告诉观众两个信息。视频大概需要多长时间,这一条会解释什么问题。标题阶段不急着塞角色和道具,观众先认清主题。
正文讲完以后,片尾用问答复习。先提出一个能概括全文的问题,再显示答案和少量结论。旁白把问题和答案完整念完,黑板一直停留到最后一帧。
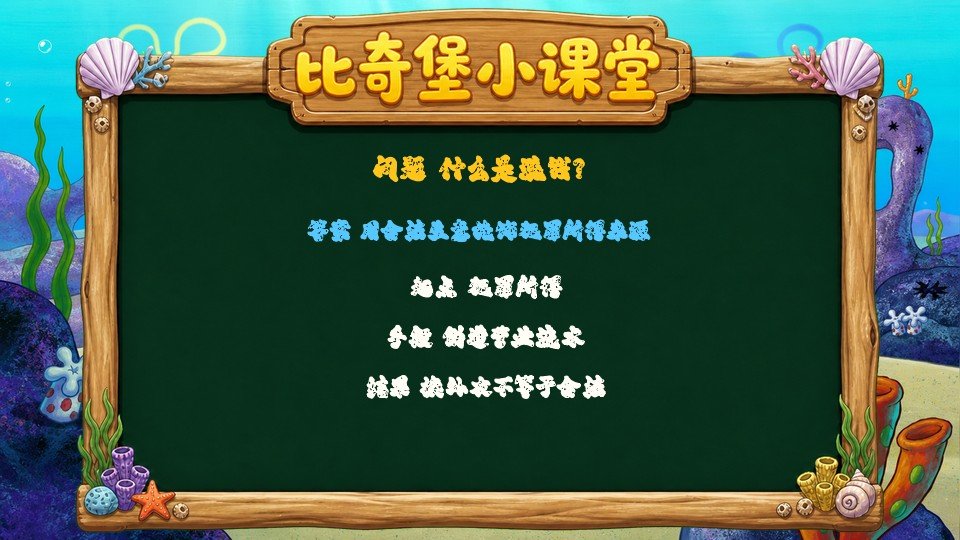
发布封面单独制作。视频片头负责开场节奏,封面负责信息流里的点击。两者可以使用同一套字体、角色和色彩,构图不用强行共用。
11|渲染成功以后,再做四遍检查
Remotion 输出 MP4,只能说明渲染程序完成了任务。交付以前还要从四个方向重新检查。
| 检查方向 | 具体检查 | 可以使用的工具 |
|---|---|---|
| 文件 | 分辨率、帧率、编码、音轨和总时长 | ffprobe |
| 画面 | 黑帧、挡脸、重叠、字幕越界和末帧 | FFmpeg 抽帧、OpenCV |
| 语义 | 角色、动作、情绪和道具是否对应口播 | 逐句审片与素材记录 |
| 事实与权利 | 专业表述、水印、来源和 IP 使用范围 | 人工复核 |
技术检查还可以形成一张固定结果表。每次渲染后自动记录视频时长、音频时长、首帧和末帧状态,再把抽出的关键画面放进 qa/final-frames/。人打开报告以后先看异常项,随后再做完整审片。
语义审片沿着口播逐句进行。每句话旁边列出当时可见的角色和道具,再对照素材的实际描述,结果写进 qa/semantic-alignment-report.json。这样能发现一张图本身很好看,放到当前句子里却讲错了故事。
随机抽几帧只能查构图。语义问题要沿着每句口播往下看。嘴里说账本,画面放了一份合同,文件规格再标准也不能发布。
我在调试时碰到过一些很小的问题。角色动作和口播对不上,最后一段声音还没结束,黑板已经消失;透明图片周围残留底色,字幕又刚好盖住人物脚部。每一项只改几行代码,漏掉以后都会出现在最终成片里。
整条流程最后可以收成下面这些步骤。
确定一个问题
→ 转写参考片或直接写故事
→ 核对事实和叙事因果
→ 按新信息拆语义画面
→ 检索角色、背景和道具
→ 补图、抠图并检查素材
→ 先摆静态构图
→ 生成逐画面融合预览
→ 人工确认口播和画面
→ 生成旁白与词语时间
→ 编排字幕、图层和声音
→ Remotion 渲染
→ 检查文件、画面和语义
这套方法也能用于原创角色、历史人物、商业故事和城市发展。题材变了,制作顺序仍然成立。第一条视频留下的角色、背景和道具通过检查以后,下一条可以先检索它们,缺少的部分再补。
连续生产的速度就从这里开始变化。
使用现有 IP 做公开发布和商业化时,还要另外确认素材来源、平台规定和授权范围。
我会继续拿新题目测试这套流程。遇到新的问题,再把解决过程写出来。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。