做自媒体,你可能一直在用错误的方式拆对标(附 AI 工作流和提示词)
部分视频或图片暂未收录,已在正文保留提示;需要时可查看原文。查看原文 ↗
做自媒体的都知道要拆对标,可大多数人只拆文案。
一条爆款视频,有一半功力藏在声音里。哪句突然放慢,哪个字重读,哪里停了半拍,哪个词后面跟了一声音效,这些看字幕都看不出来。
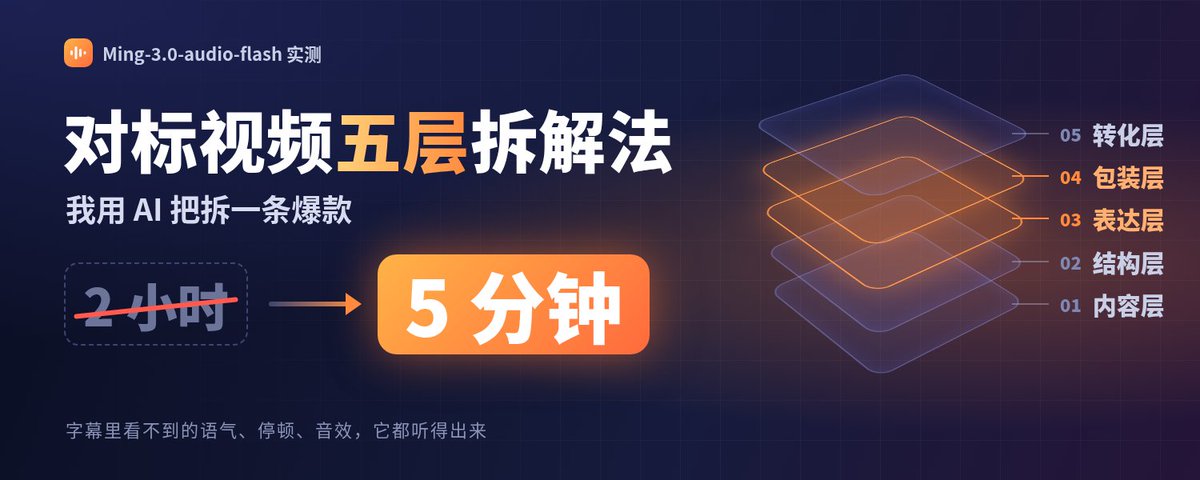
我把自己拆对标的方法整理成五层,再交给一个能直接听音频的 AI 模型来做。拿 小Lin说 讲 DeepSeek 融资的 6 分 26 秒视频试了一遍,5 分钟拆完,剪辑师埋的音效卡点也被找了出来。
方法和提示词都在下面,复制就能用。
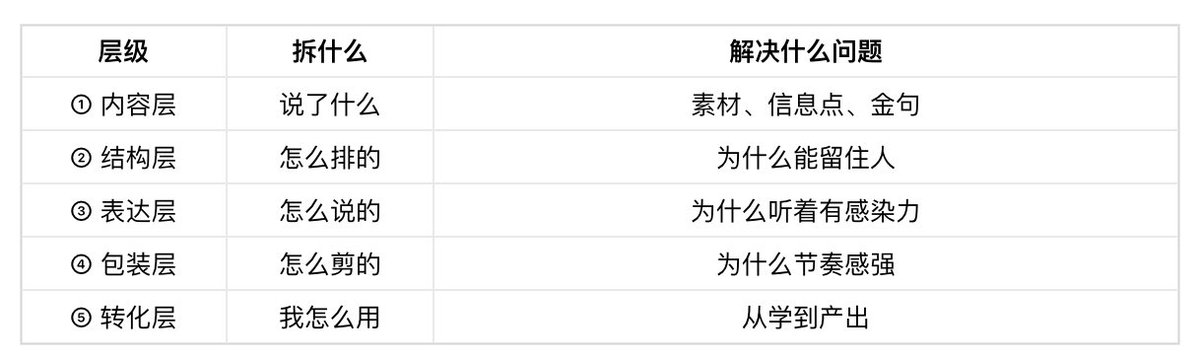
一、方法论:对标视频五层拆解法
前两层,大部分 AI 工具都能做。拉开差距的是第 ③ 和第 ④ 层,这两层得靠耳朵。
这次用的是蚂蚁百灵刚开源的 Ming-3.0-audio-flash。它直接听音频,中间不用先转成文字,语气、停顿、音效和配乐都在。
二、准备:2 分钟拿到音频
1. 保存对标视频
把要拆的视频存到本地,仅作个人学习。
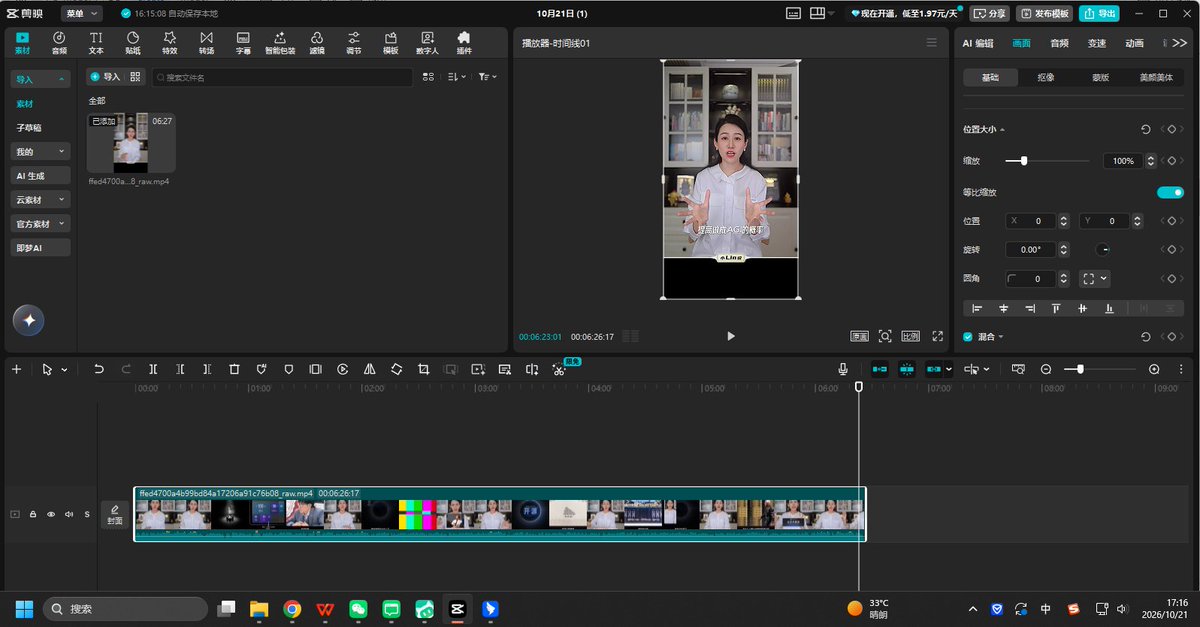
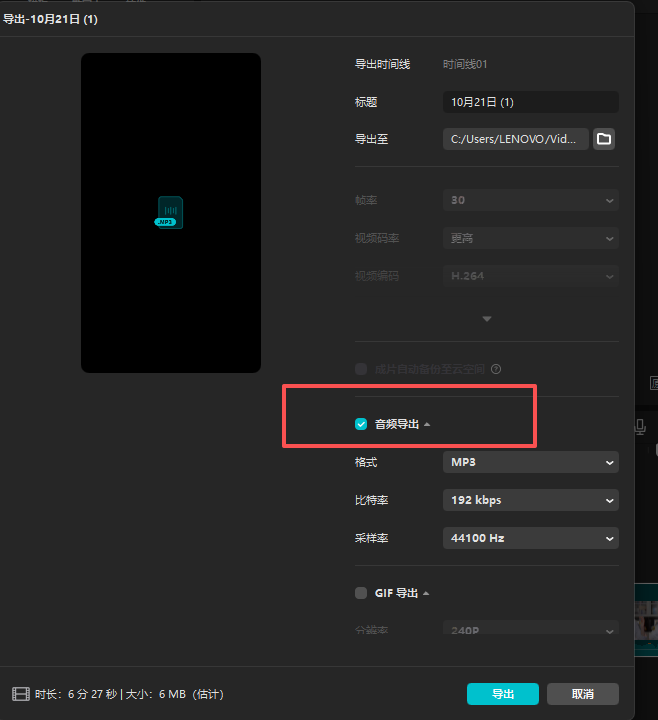
2. 用剪映导出音频
把视频拖进剪映,点右上角「导出」,取消勾选视频,只勾「音频导出」,格式选 MP3。
3. 上传给模型
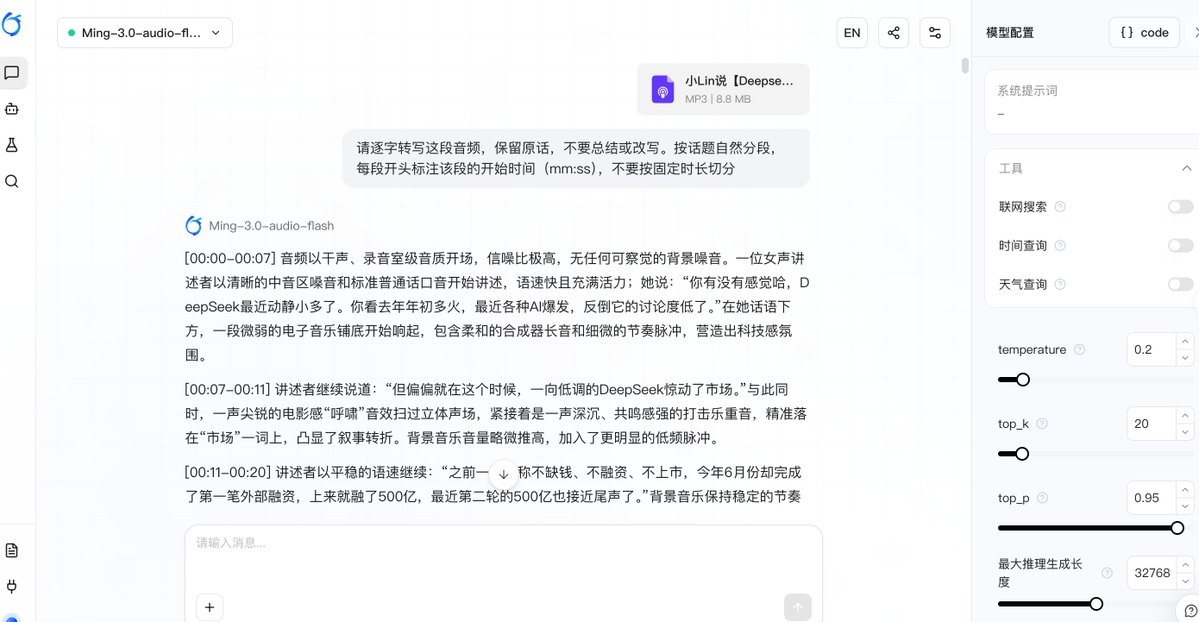
打开 chat.ant-ling.com ,选 Ming-3.0-audio-flash,点「+」上传 MP3。
temperature 建议调到 0.2,输出更稳。做逐字稿时关掉「思考」,后面几步分析再打开。
三、实操:五层逐一拆解
下面是完整录屏,一次上传,问了 5 个问题,中间没剪。
① 内容层 · 先拿一份带音效标注的逐字稿
这一层只看说了什么、信息点在哪、每段在讲什么。提示词这样写。
请逐字转写这段音频,保留原话,不要总结或改写。按话题自然分段,每段开头标注该段的开始时间(mm:ss),不要按固定时长切分。
6 分 26 秒的音频,3 秒出第一个字,18 秒出完整逐字稿。梁文锋、腾讯 100 亿、宁德时代 50 亿、Bloomberg、CUDA、AGI,人名、金额和英文词都对。
让我意外的是,我没提要求,它自己把背景音乐和音效也标了出来,比如开头这句。
"但偏偏就在这个时候,一向低调的 DeepSeek 惊动了市场。"与此同时,一声尖锐的电影感"呼啸"音效扫过立体声场,紧接着是一声深沉、共鸣感强的打击乐重音,精准落在"市场"一词上。
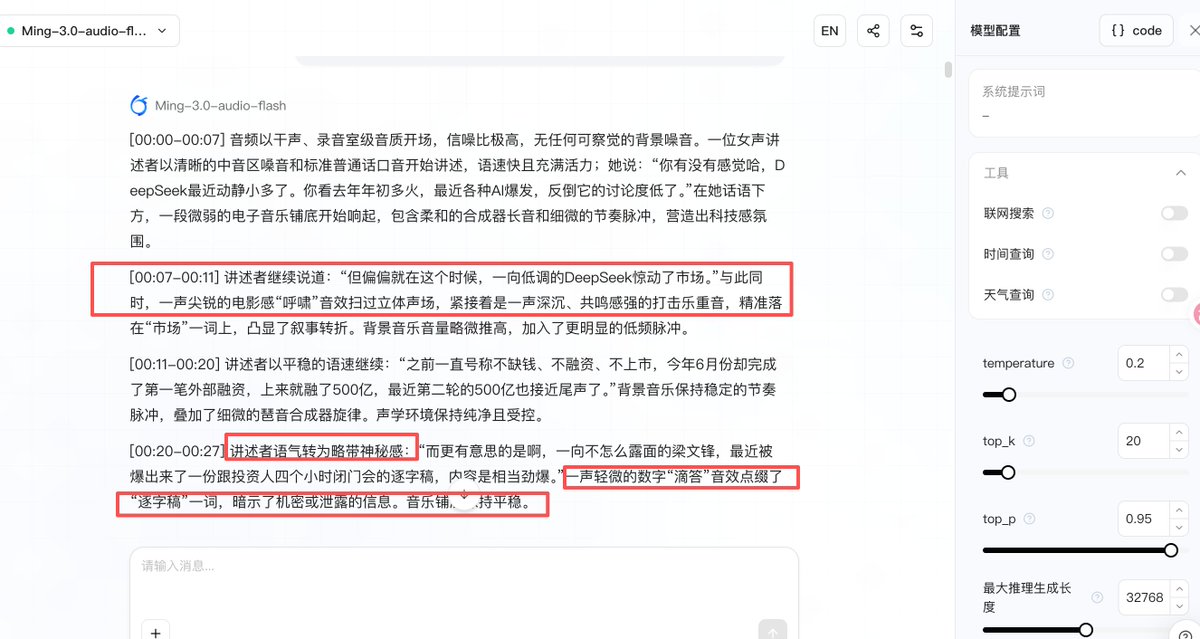
普通转写工具只给你字,它连声音里的情绪一起给你。
② 结构层 · 开头怎么留人,全片怎么排
这一层看前 30 秒怎么留人、全片分几段、结尾怎么收。让它站在编导的角度来拆。
以自媒体编导的视角拆解这条视频:
开头用了什么钩子?前 30 秒如何留住观众?
整体分几个部分,每部分的作用是什么?
结尾怎么收束?有没有引导互动?
每部分引用一句原话作为定位。
它把开头钩子归为反差悬念加利益承诺。先说 DeepSeek 最近动静小多了,紧接一句「但偏偏」,话锋转到惊动市场。
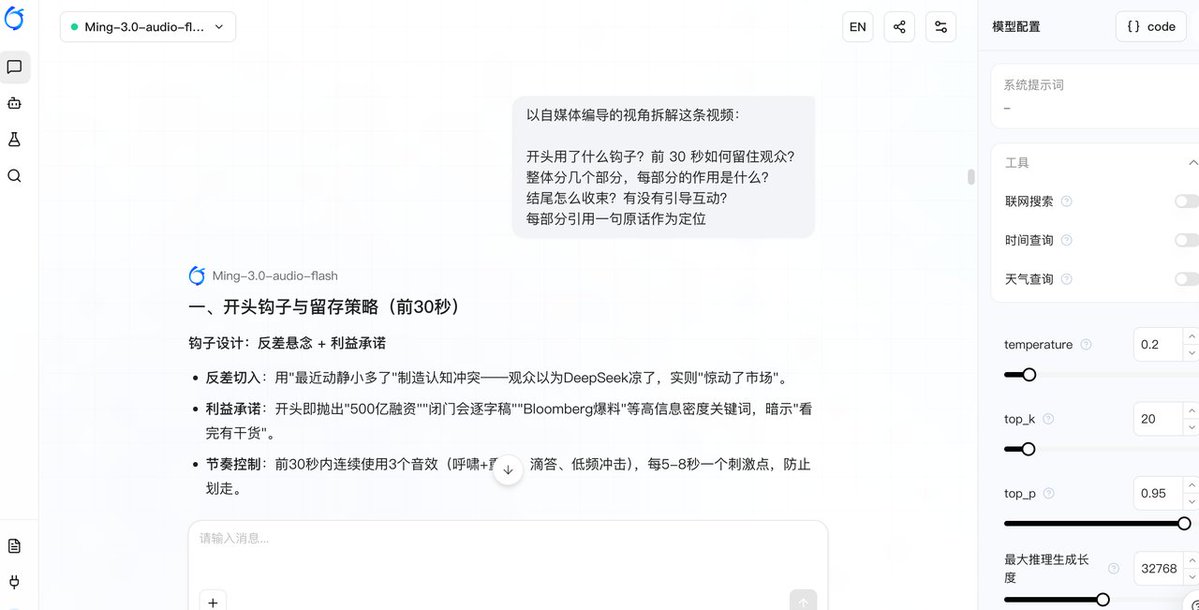
前 30 秒放了 3 个音效,差不多每 5 到 8 秒就有一个刺激点,观众很难划走。
全片被拆成 5 段,逻辑链是为什么融资、做什么、凭什么。最后它还提了条建议,中段音效变少了,可以补一两个悬念停顿。
这份输出,拿去开复盘会都够用。
③ 表达层 · 听她哪里加速,哪里重读
这一层听语速、重读、停顿、反问和情绪转折。③ 和 ④ 可以合成一次问,记得打开「思考」。
请仔细听这段音频,从"声音表达"和"剪辑包装"两个角度拆解:
一、说话人的语气和节奏变化(5 处):语速明显加快或放慢、重读强调、刻意停顿、反问、情绪转折。
二、音效或配乐卡点(3 处):音效出现的位置、配乐切换或推高的时刻。
每处给出:时间点(mm:ss)、原话(一字不差)、变化类型、这样处理的表达效果。最后用表格汇总。
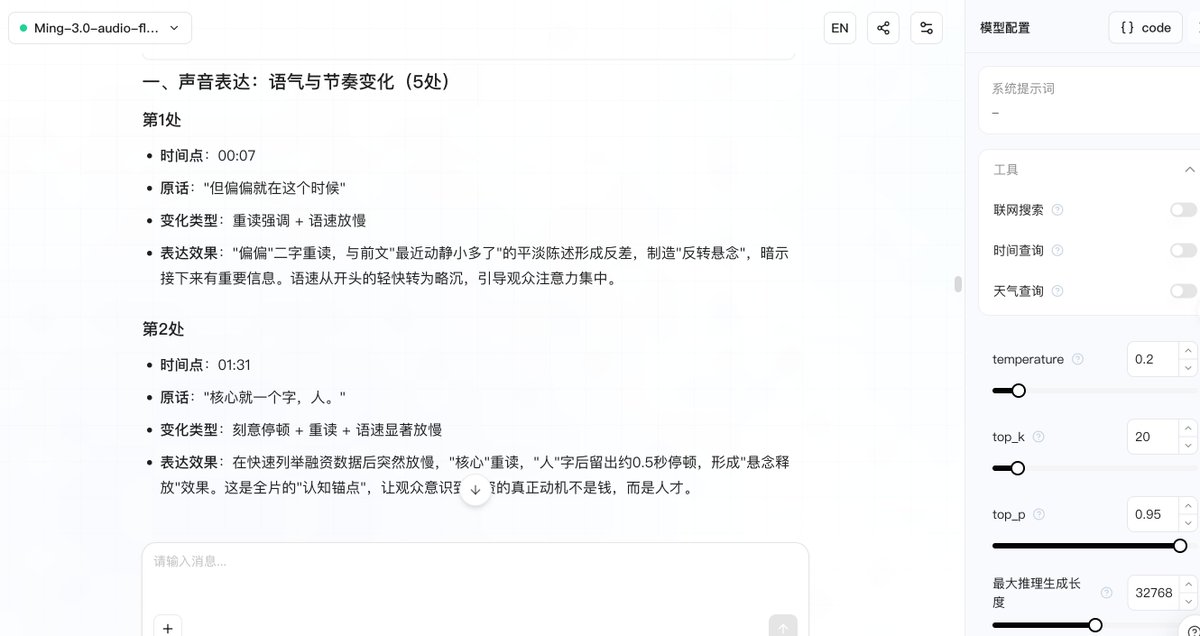
它找出了 5 处语气变化,基本都落在全片的关键节点上。
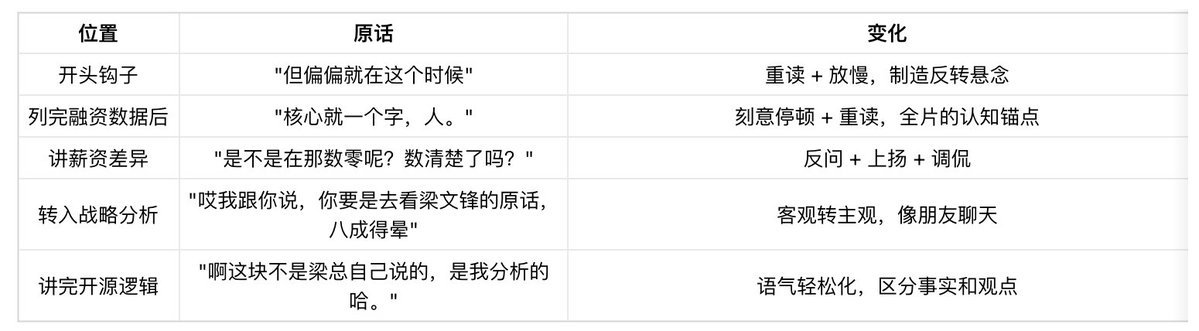
最让我服气的是「核心就一个字,人。」这句。它听出前面在快速报融资数据,到这里突然放慢,「人」字后面还停了大约半秒。这半秒,字幕上看不到。
④ 包装层 · 找出剪辑师埋的卡点
这一层看音效落在哪个词上,配乐在哪里切换、推高或停下。下面三处和上一层出自同一个回答。
-
开头说到「惊动了市场」,一声呼啸接一记低频重音,正好砸在「市场」两个字上。
-
说到「核心就一个字,人。」,「人」字落下时有一声低沉的鼓点,配乐跟着停了半秒左右。
-
说完「踏踏实实搞这干吧」,跟了一声欢呼,配乐转向昂扬。
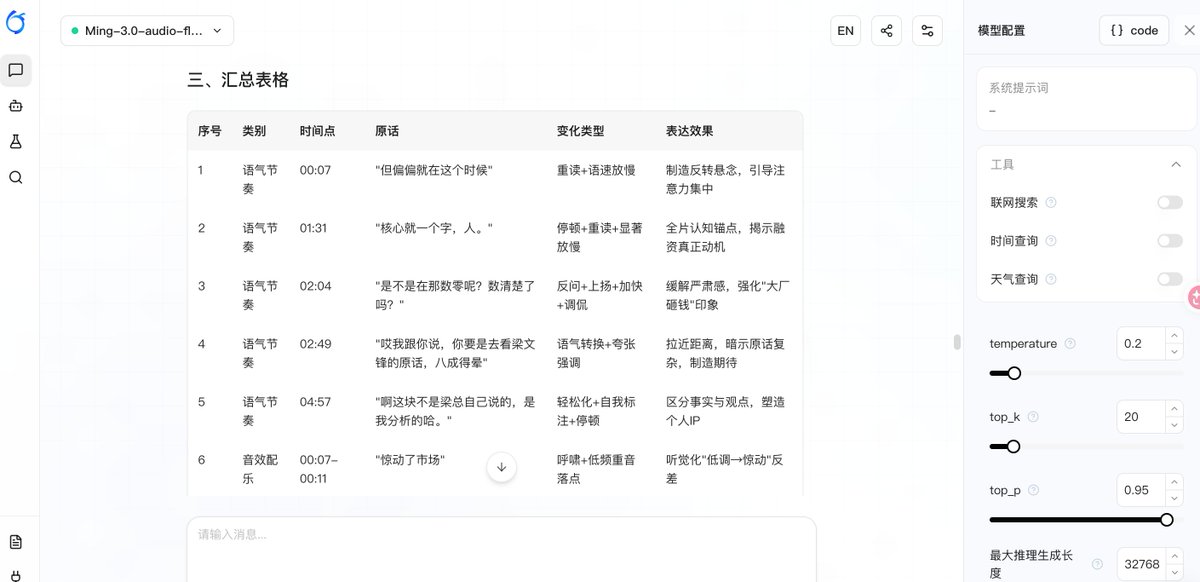
这是我觉得最值钱的一层。以前想学别人的剪辑节奏,只能拖着进度条一帧帧扒。现在问一次,整条片子的卡点就全出来了。
⑤ 转化层 · 拆完别人,写自己的
拆完要能用上。先让它总结能复用的句式。
总结这条视频能成为爆款的 3 个关键表达技巧,每个技巧给出可直接模仿的句式模板。
它总结的爆款公式很简单,反差钩子拉人进来,数字对比把人留住,一句话锚点让人记住,口语化反问引人互动。
还配了三个模板,填空就能用。
-
钩子句:"你有没有感觉,最近__?但偏偏就在这个时候,__。"
-
锚点句:"说到底就一个字/两个字:__。"
-
反问句:"是不是在那__呢?__了吗?"
再让它借这套结构给我出选题。
我是 AI 工具博主。借鉴这条视频的结构和节奏,给我 3 个选题,并为其中最有爆款潜力的一个写 30 秒开头口播稿,标注哪里该加速、重读和停顿。
它给了 3 个选题,最推荐扣子(Coze)那个,还顺手写好了 30 秒口播稿,哪里加速、哪里重读、哪里停顿都标好了,拿去就能录。
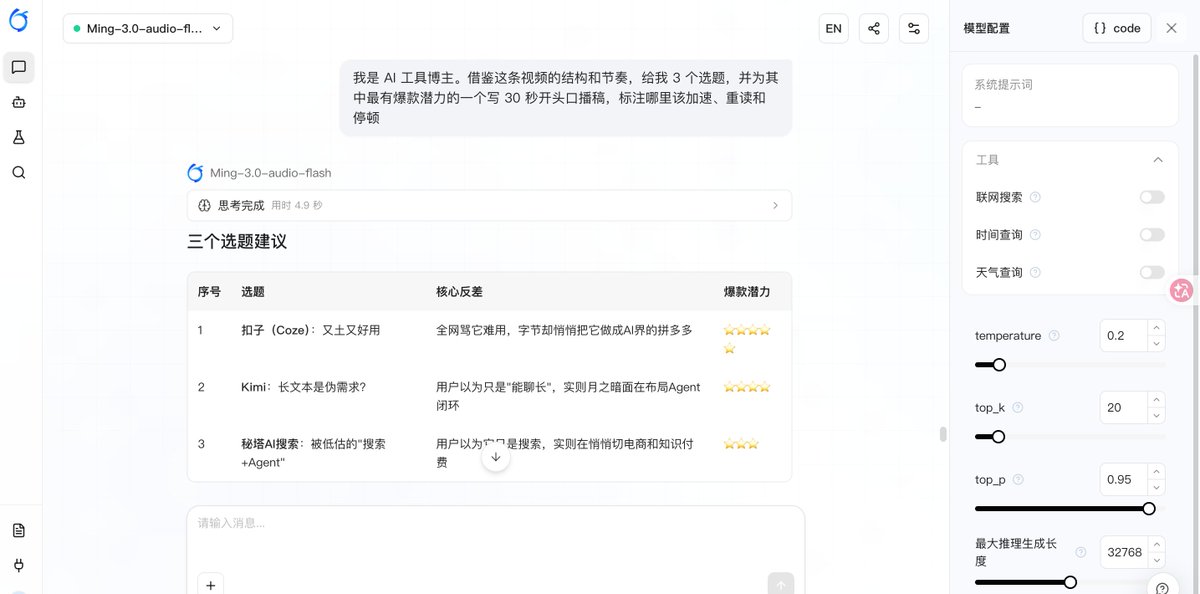
从拆到写,一个对话里就走完了。
四、五层拆解法速查卡
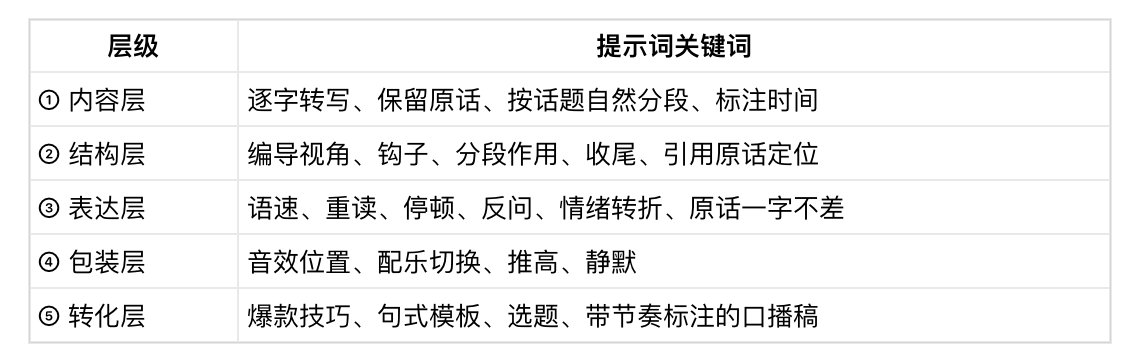
一次上传,5 个问题,一条对标视频就拆透了。(素材来源:@小Lin说 公开视频,仅作学习拆解)
五、注意事项
1. 提示词写清楚逐字、不改写、按话题分段。不写的话,模型会顺手帮你总结,逐字稿就不干净了。
2. 多人对话先告诉它谁在说话。拆访谈、圆桌、播客时,把嘉宾名字写进提示词,观点才能对上人。
3. 分析类问题打开「思考」,语气和音效会拆得更细。
4. 要引用的原话,回原片听一遍。
5. 口播稿里的数字要自己查。模板可以用,数据换成你核实过的。
6. 拆解是为了学方法。结构和节奏可以借,选题和表达要用自己的。
以前拆一条爆款,我得反复听、手动记,2 小时打底。现在 5 分钟拆完,省下的时间全拿来写自己的东西。
拆对标,别只用眼睛,也要用耳朵。
提示词都在上面,复制就能用。你拆对标时最头疼哪一层?评论区聊聊 👇
这次实验用的是蚂蚁百灵新一代音频模型Ming-3.0-audio-flash,Ming-3.0 音频模型家族包括发布三个模型。
-
Ming-3.0-asr-tiny:语音识别
-
Ming-3.0-audio-flash:音频理解与交互
-
Ming-3.0-tts:语音合成
趁现在可以免费体验,在线体验入口:https://chat.ant-ling.com
-
在线体验:访问 Ling Studio Chat,选择 Ming-3.0-audio-flash,体验音频理解与对话能力。
-
API 调用:Ling Studio 提供 Ming-3.0-tts-0.5B、Ming-3.0-audio-flash 和 Ming-3.0-asr-tiny 的 API 服务,开发者可将语音识别与语音生成接入自己的业务工作流。
模型与部署资源入口:
- Ming-3.0-tts-0.5B
Hugging Face:https://huggingface.co/inclusionAI/Ming-3.0-tts-0.5B
ModelScope:https://www.modelscope.cn/models/inclusionAI/Ming-3.0-tts-0.5B
- Ming-3.0-tts-tiny
Hugging Face:https://huggingface.co/inclusionAI/Ming-3.0-tts-tiny
ModelScope:https://www.modelscope.cn/models/inclusionAI/Ming-3.0-tts-tiny
- Ming-3.0-audio-flash
Hugging Face:https://huggingface.co/inclusionAI/Ming-3.0-audio-flash
ModelScope:https://www.modelscope.cn/models/inclusionAI/Ming-3.0-audio-flash
- Ming-3.0-audio-tiny
Hugging Face:https://huggingface.co/inclusionAI/Ming-3.0-audio-tiny
ModelScope:https://www.modelscope.cn/models/inclusionAI/Ming-3.0-audio-tiny
- Ming-3.0-asr-tiny
Hugging Face:https://huggingface.co/inclusionAI/Ming-3.0-asr-tiny
ModelScope:https://www.modelscope.cn/models/inclusionAI/Ming-3.0-asr-tiny
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。