
我用Codex做了一个东方仙界Skill,附详细教程。
文章目录
大家好,我是李岳。
最近研究了一下一些比较流行的Skill,发现他们一个比较强大的共同点,就是使用了规则路由。
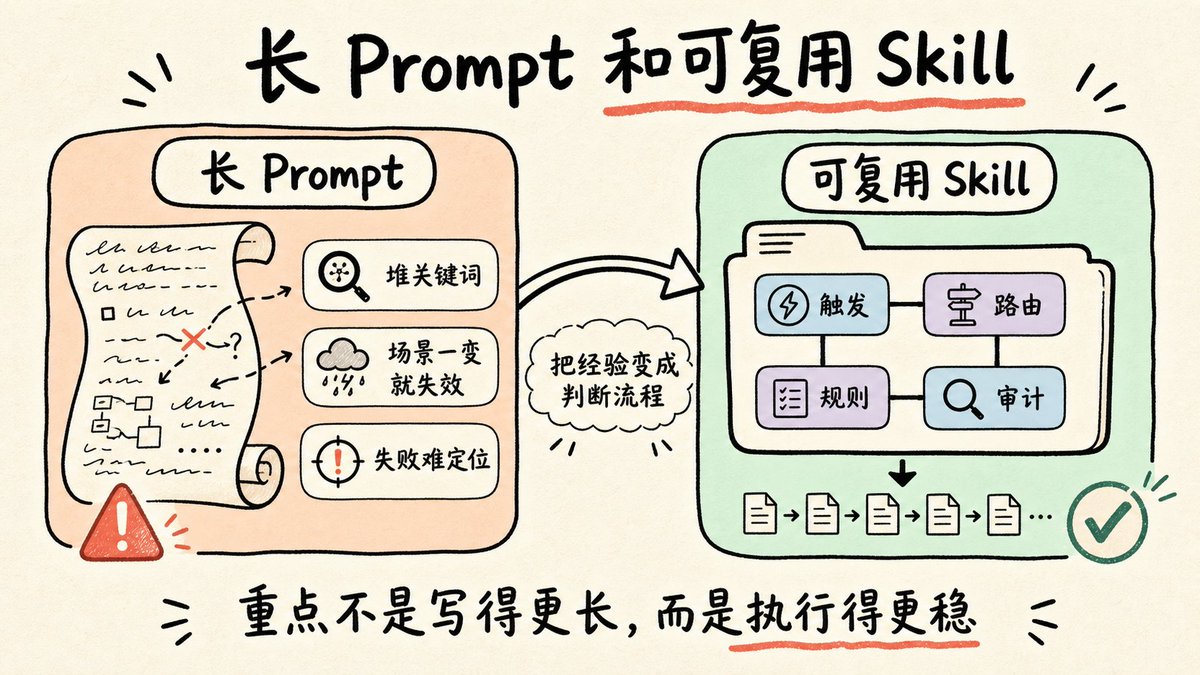
很多人第一次制作 Skill,会把自己积累的提示词全部塞进一个 SKILL.md。
文件看起来很专业,实际调用几次就会发现,它仍然只是一条加长版 Prompt:场景稍微变化就失效,模型会擅自修改参数,不同风格互相串味,生成失败后也不知道该怎么修。
一个真正可复用的 Skill,应该是保存一套稳定的判断流程。
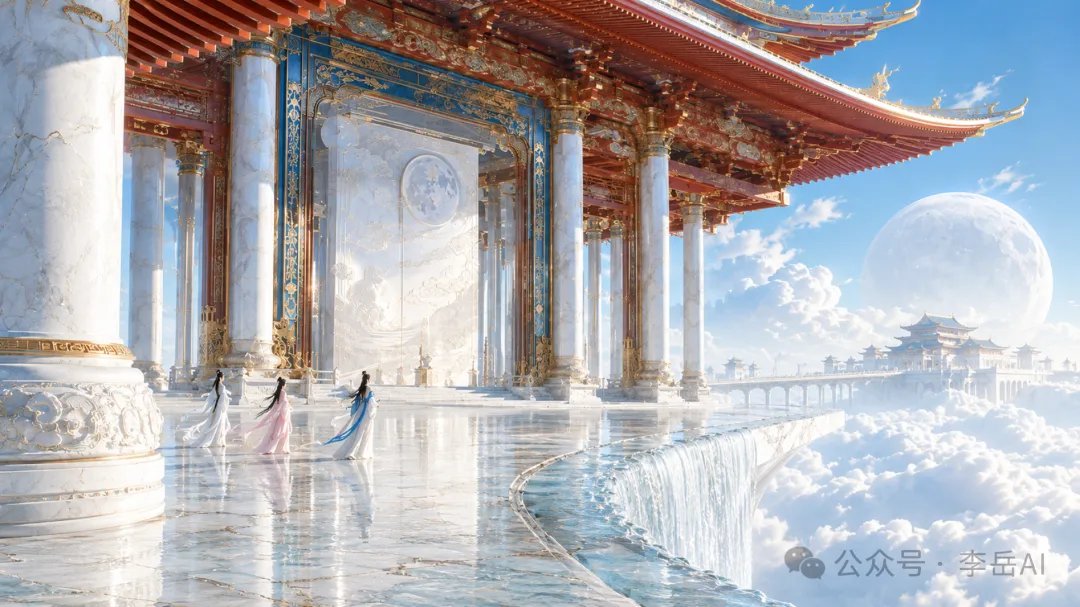
最近抖音上东方仙侠的视频爆火,有很多不同的风格,于是我尝试用Codex制作了 xianxia-visual-director,中文名东方仙侠视觉导演。
它能把一句简单构想扩展成完整的仙侠环境提示词,也能在单体仙境、神域城市、东方巨构等路线之间自动选择。
目前项目在 GitHub 已获得 260+ Star 和 46 Fork。
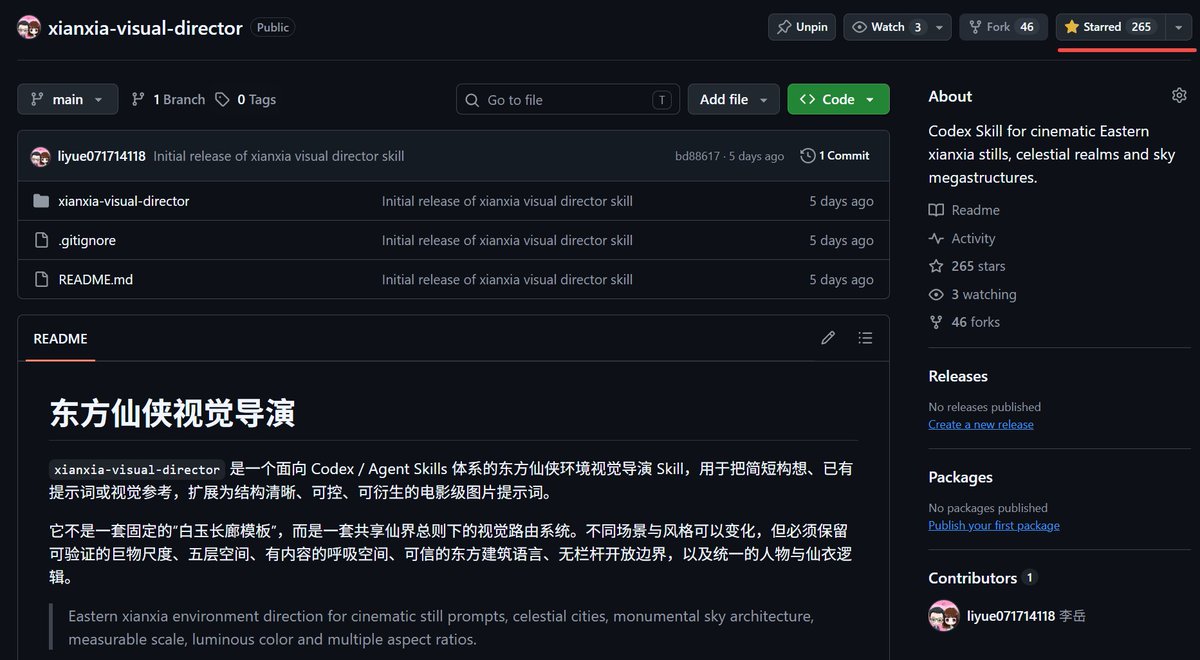
项目地址:
想使用该Skill的可以直接阅读README文件,用法很简单。
下面不展开讲怎么使用Skill,而是以它为案例,拆解新手如何制作一套带规则路由同类型的视觉导演 Skill。
1、先定义它反复解决什么问题
不要从「做一个万能仙侠 Skill」开始。范围越大,触发越混乱,内部规则也越容易互相冲突。
更有效的做法,是先写出 6 到 10 条真实需求。例如:
-
设计一座雨后的悬空藏经阁;
-
生成一座有人居住的九重天宫城;
-
把普通仙侠宫殿改成具有压迫感的东方巨构;
-
修复画面灰雾过重、空间扁平和人物太大的问题;
-
保留原有设定,只优化构图、尺度和光线;
-
在同一视觉体系下生成多个差异化方案。
把这些需求放在一起,就能得到清晰边界:这个 Skill 负责东方仙侠环境图片的创建、衍生、优化和诊断,不负责剧情写作、视频运镜或人物写真。
2、先搭Skill的最小骨架
一个可用 Skill 的最低要求只有 SKILL.md。如果需要在 Codex 界面中显示更友好的名称和默认提示词,可以增加 agents/openai.yaml。
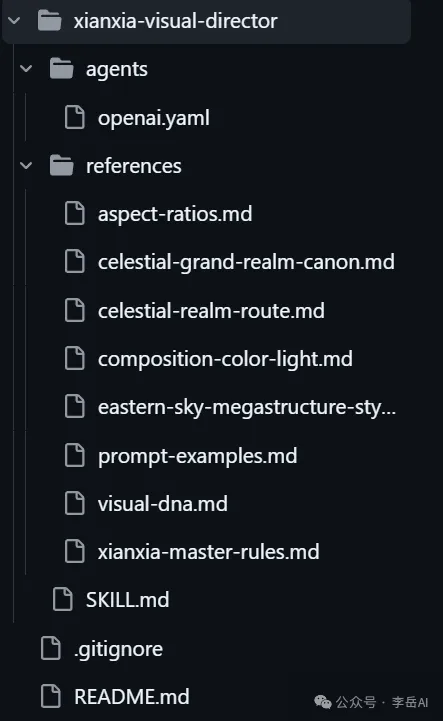
视觉导演包含多条风格路线和大量专业规则,因此再增加 references 目录。最终结构如下:
xianxia-visual-director/
├── SKILL.md
├── agents/
│   └── openai.yaml
└── references/
    ├── visual-dna.md
    ├── xianxia-master-rules.md
    ├── aspect-ratios.md
    ├── composition-color-light.md
    ├── celestial-realm-route.md
    ├── eastern-sky-megastructure-style.md
    └── prompt-examples.md
创建时可以直接让 Codex 调用 $skill-creator 初始化,而不是手工拼写目录和 YAML:
使用 $skill-creator,在我的 Codex Skills 目录中创建一个
名为 xianxia-visual-director 的 Skill。先生成最小结构,
并增加 references 目录和 agents/openai.yaml,
暂时不要写具体视觉规则。
这里有一个容易混淆的点。Skill 本体中不需要 README、安装说明和更新日志;如果要发布到 GitHub,可以在仓库最外层增加 README,真正安装到 Codex 的仍然只是内层 Skill 文件夹。
3、把Skill触发条件写进 description
SKILL.md 顶部必须有 YAML frontmatter,而且只需要 name 和 description。
---
name: xianxia-visual-director
description: 为东方仙侠环境图片创建、衍生、优化和诊断结构化提示词。用于仙境地标、天宫仙城、神域聚居地、东方苍穹巨构、云海宫阙、仙侠构图、尺度、色彩、光线和失败修复等任务。
---
description 不是产品宣传语,而是触发器。它要同时说明「能做什么」和「用户在什么场景下会需要它」。只写「一个专业的仙侠视觉 Skill」,Codex 很难判断什么时候应该加载。
可以准备三类测试语句:直接点名、自然口语和模糊表达。该触发时没有触发,就补充场景词;不相关任务也触发,就收窄描述。
4、把审美经验改写成可检查的规则
视觉 Skill 最常见的问题,是写满「高级、史诗、电影感、通透」这类形容词,却没有可执行标准。
制作时要把主观感受改成可观察关系。例如,不写「建筑非常巨大」,而是规定人物只占画面高度的 1% 到 4%,主柱直径约为 5 到 10 个成年人高度,门洞约为 20 到 50 个成年人高度,屋檐继续延伸到画面之外。
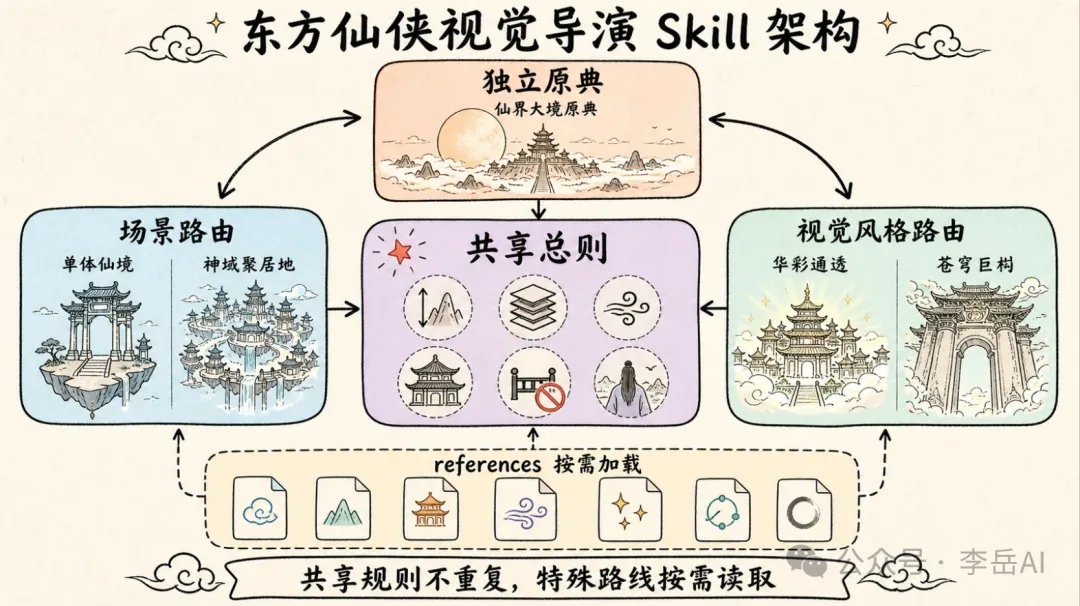
东方仙侠视觉导演最终提炼出六条共享规则:
-
每张完整提示词至少有四项尺度证据;
-
每张画面都有近景门槛、承人界面、统治主体、从属空间和天际终点五层空间;
-
保留约 40% 到 60% 的有内容空气;
-
东方建筑先讲梁柱、屋檐、平台和承重,再讲装饰;
-
平台、桥梁、台阶和长廊默认没有栏杆;
-
环境人物保持小比例、背影或斜后方,服装遵循同一个风向。
这一步决定 Skill 是否稳定。规则必须能够在输出前回答「通过还是不通过」,不能只表达审美偏好。
5、用规则路由解决不同需求
当一个 Skill 支持多种场景时,不要把所有规则同时加载,也不要为每种风格复制一份完整 Prompt,这事我第一次干过,每次Skill都跑很久而且浪费Token。
更合适的结构是「共享总则 + 条件路由」。本例设置了两条场景路由和两条视觉风格路由:
-
单体仙境,用于天门、神树、祭台、书阁等单一地点;
-
神域聚居地,用于主城区、从属城区、桥梁、云港和极远聚落共同组成的仙界文明;
-
华彩通透仙侠,强调明亮色彩、精致材质和清晰空气;
-
东方苍穹巨构,强调低机位、建筑裁切、巨物压迫和门槛窥视。
场景路由与风格路由可以自由组合,不必为四种组合重复四套规则。特殊程度更高的 仙界大境原典 则作为独立路由,只在用户明确点名时加载。
在 SKILL.md 中只保留选择逻辑,并明确什么时候读取哪个 reference。详细的城市拓扑、巨构构图和范例分别放入独立文件。这就是渐进加载,它能减少上下文占用,也能防止路线串味。
6、建立参数锁定、默认值和冲突规则
Skill用编程的视角来看,就像一个写好的函数,里面包含各种参数,传入不同的参数会得到不同的结果。*
Skill也是如此,我们可以给它建立参数,例如画幅、场景、构图、人物、色彩、光线、材质、氛围和输出模式。
用户明确给出的值设为硬锁。未填写时才使用默认值,例如默认 16:9、史诗级尺度和选择性高饱和。遇到不支持的比例或枚举值,不要悄悄近似,而是指出问题。
还要把容易混淆的概念拆开。例如「远距离」不等于「高机位」,「大全景」不等于「俯拍」。如果不单独规定,模型为了展示完整仙城,很容易自动飞到城市上空,结果失去巨物压迫感。
7、固定工作流和输出格式
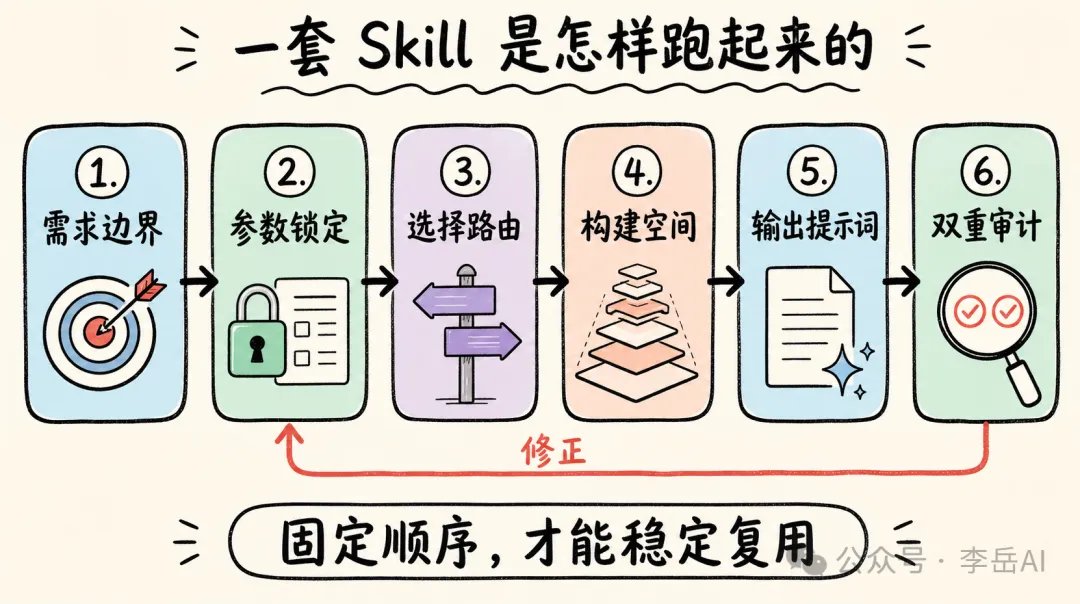
SKILL.md 的正文应该主要写行动顺序,而不是继续堆知识。视觉导演的核心工作流可以压缩为:
-
锁定用户要求与默认参数;
-
选择场景、风格和镜头意图;
-
建立一个主要构图骨架;
-
分配五层空间和尺度证据;
-
设计色彩预算、主光方向和材质;
-
生成人物与服装规则;
-
输出正向提示词、负面约束和衍生方案;
-
按共享总则和当前路由完成双重审计。
标准输出也要固定。本例包含参数锁定、视觉导演方案、完整提示词、负面约束和三个衍生方向。用户只要提示词时再切换为精简模式。
8、用失败案例测试
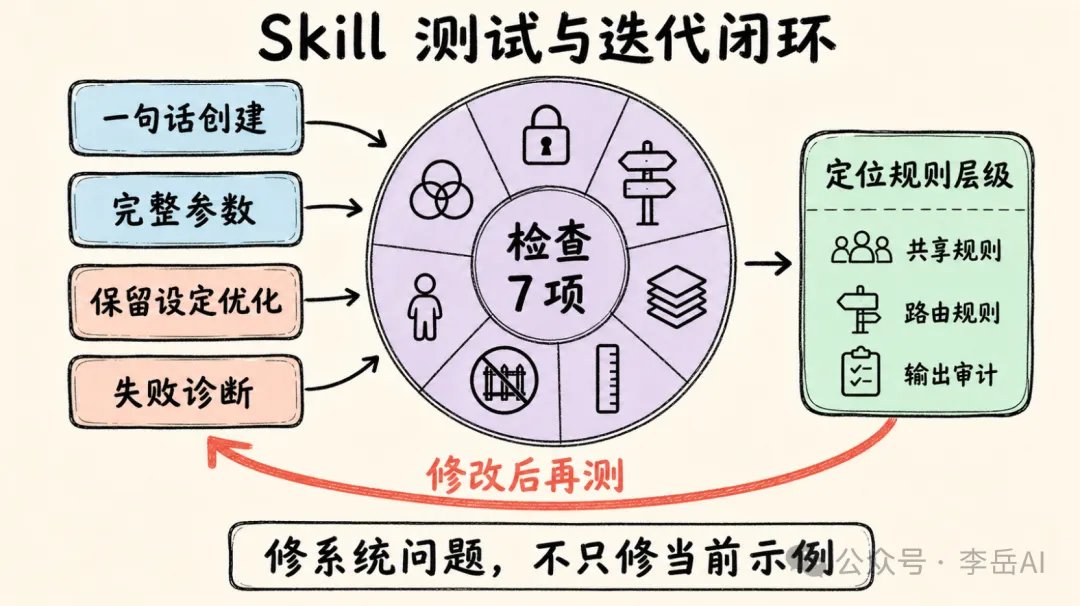
完成初稿后,先运行 quick_validate.py 检查 YAML、命名和目录格式,再进行真实任务测试。
测试集至少覆盖四类情况:一句话创建、完整参数创建、保留原设定的优化、带明确问题的诊断。还要加入竖屏、超宽画幅、仙城和巨构等边界情况。
每轮测试重点观察:用户参数有没有被修改、路由是否选对、五层空间是否完整、是否出现栏杆、人物是否过大、颜色是否被全局橙金污染、多个衍生方案是否只是换色。
发现失败后,不要只修当前示例。先判断问题属于共享规则、路由规则、参数冲突还是输出审计,再修改对应文件。这样修复才能迁移到后续任务。
9、发布 GitHub 前检查安装闭环
仓库最外层的 README 面向使用者,应包含能力简介、目录结构、安装方法、最小调用示例、完整调用示例、输出格式、许可证和相关项目。
发布前重新从 GitHub 下载一次,按 README 安装到一个干净目录,再检查 Codex 能否识别和触发,使用$即可调用Skill。
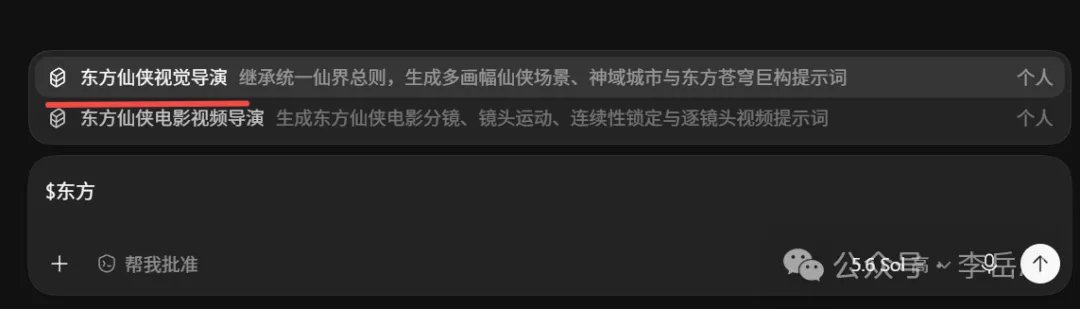
确认仓库外层与 Skill 内层没有复制错位,SKILL.md 引用的 reference 全部存在,agents/openai.yaml 与当前能力一致。
到这一步,一套可以分享的视觉导演 Skill 才算真正完成。它不是把经验写长,而是把边界、选择、默认值、冲突、输出和检查做成一条可重复执行的生产线。
10、4条测试提示词
可直接作为 Skill 制作完成后的测试集。
测试 1,一句话创建
使用 $xianxia-visual-director。设计一座雨后初晴的悬空藏经阁,
画面明亮通透,植物鲜绿,石材带湿润反光。输出标准完整格式。
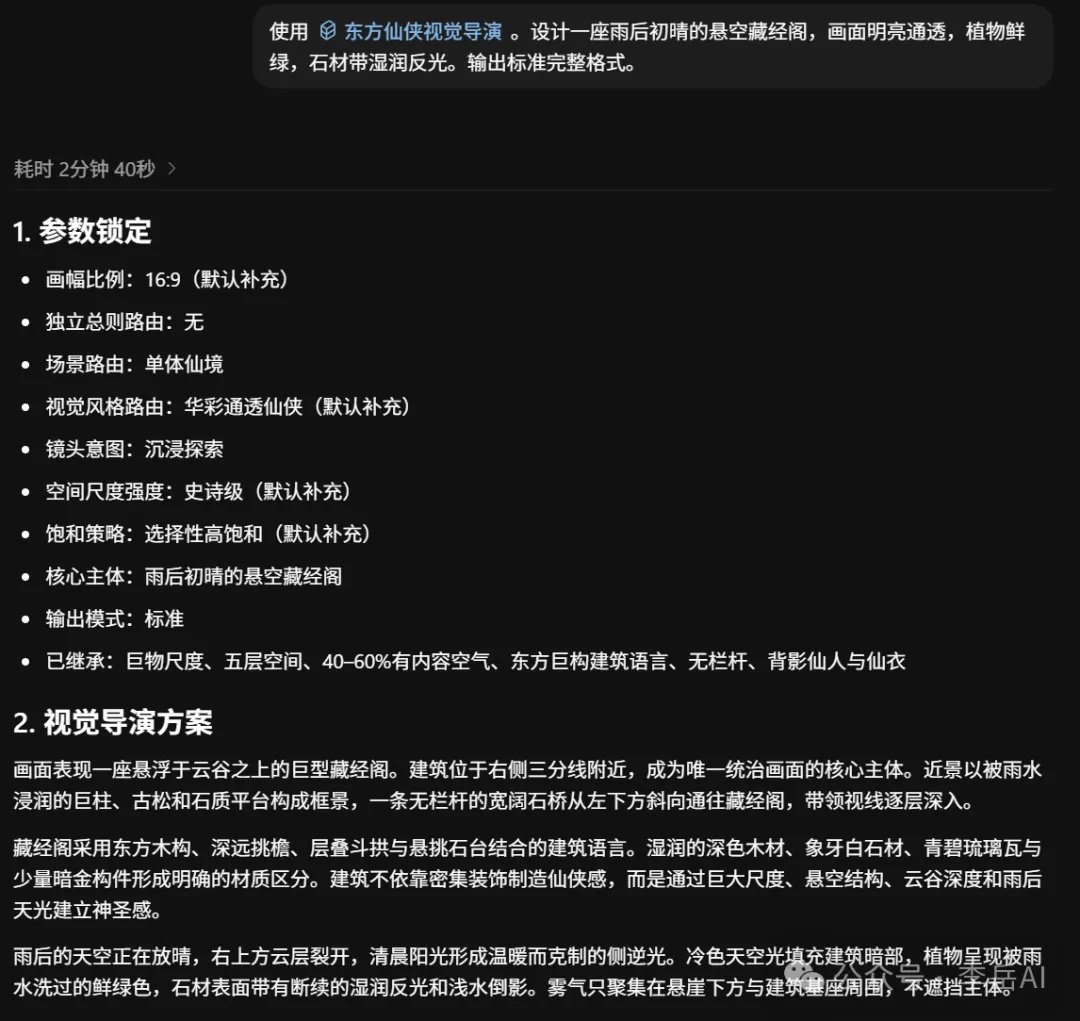
由于输出的内容较多,这里的提示词就不截图了,大家直接看提示词生成的效果与我们实际是否一致即可。
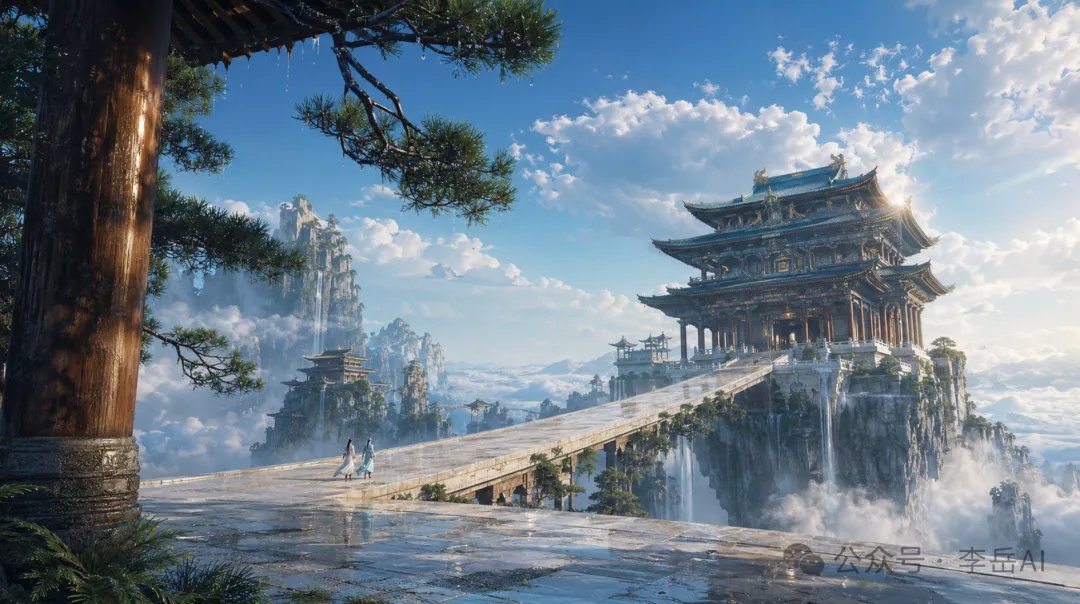
测试 2,完整仙城
使用 $xianxia-visual-director。画幅 16:9,场景路由选择神域聚居地,
设计一座建立在多层浮空大陆上的九重天宫城。超远距离低机位,
人物只作为极小背影尺度参照,不要变成俯拍地图。
所有建筑材质要求华丽,富有仙家气息.
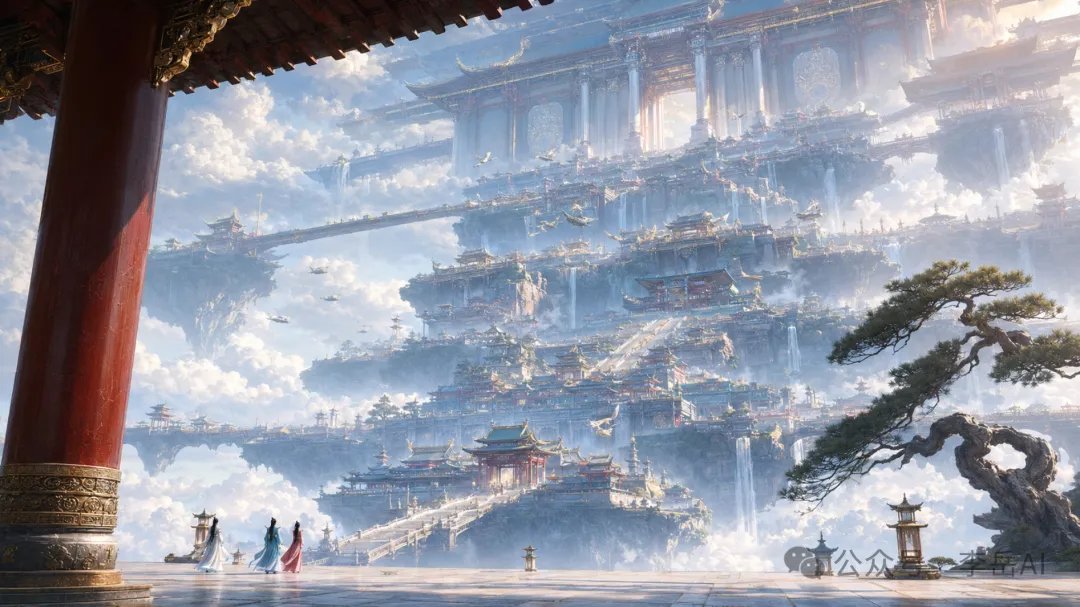
测试 3,东方巨构
使用 $xianxia-visual-director。场景选择神域聚居地,
风格选择东方苍穹巨构,使用远距离低机位和 85mm 长焦,
让一座看不见完整边界的巨型天门悬压在连续宫城上方。
材质要求非常华丽。
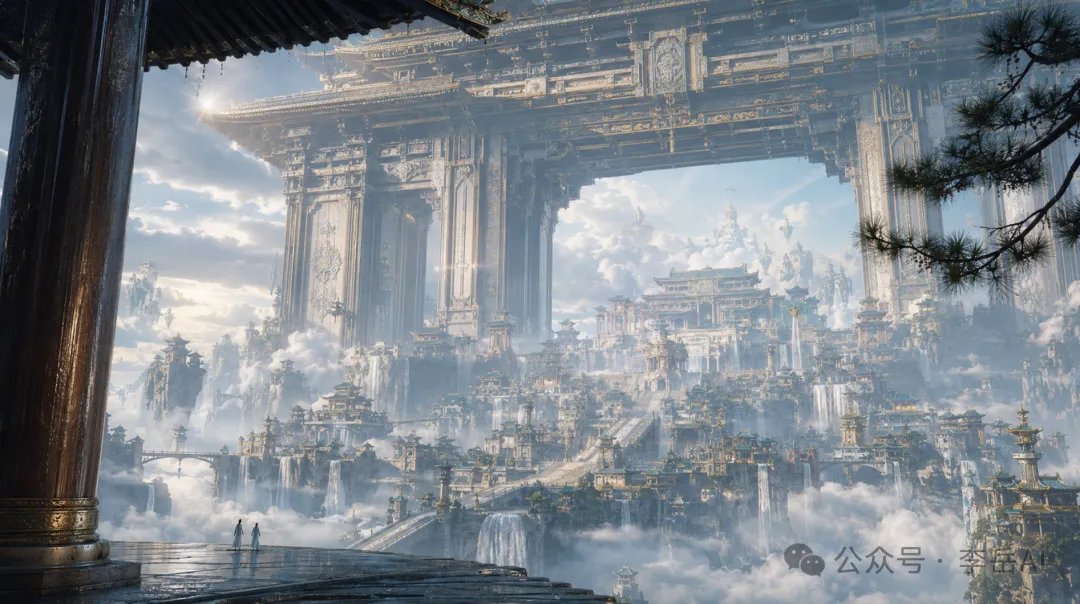
测试 4,仙界原典
使用 $xianxia-visual-director 输出一张「仙界原典」的提示词。
材质都非常华丽,有3个极小的仙女作为参照。
更多AI视觉方面优质内容,请关注我的账号@liyue_ai
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


