
本地模型小白从0到1完整入门教程
文章目录
最近一直在玩本地大模型,写小X文,做小X图,做数字人视频都跑通了。 本篇文章告诉你本地模型该怎么玩。
第 1 章 为什么要用本地模型
云端的 AI 那么好用,为什么还有人费劲在自己电脑上跑?
1.1 云端和本地,到底是什么区别
你平时用的 ChatGPT、DeepSeek、豆包,都是云端模型。
用大白话讲, 模型跑在人家机房里的几千张显卡上,你发一句话过去,它算完再传回来。
你用的是"别人家的电脑"。
本地模型正好相反, 把模型文件下载到你自己的电脑里,用你自己的显卡和内存跑。 网线拔了照样能聊。
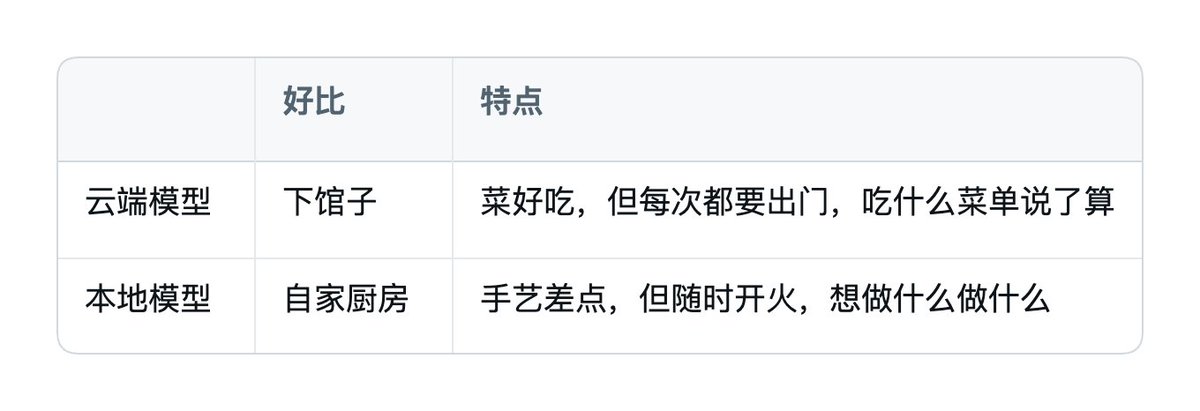
打个比方。
1.2 四个真实的理由
人们把模型搬回自己电脑,动机主要是这四个。
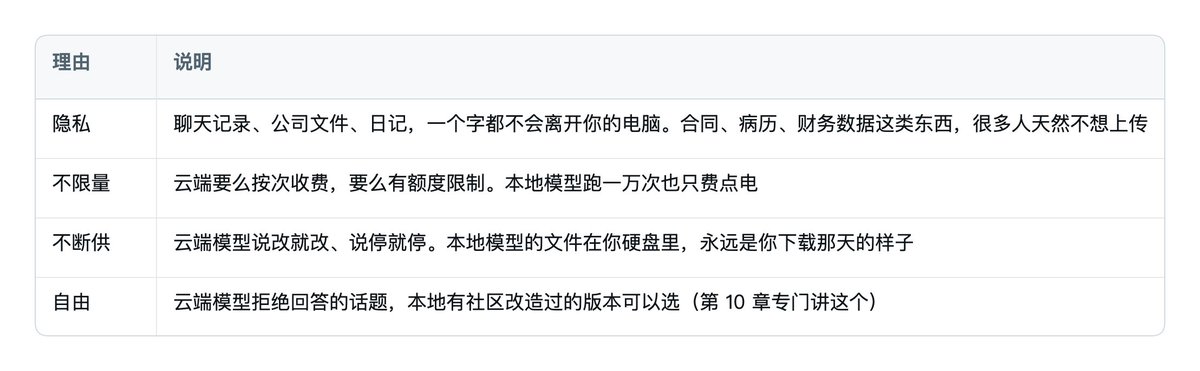
这四条里只要有一条戳中你,本地模型就值得折腾。
1.3 确认清楚你的需求
说完好处,必须说代价,不然你跑通第一个模型就会失望。
你家电脑跑得动的模型,没有云端的聪明。
原因很简单。 ChatGPT、DeepSeek 云端版这些模型,是在几千张专业显卡上跑的庞然大物。 你家电脑塞得下的,是它们的"缩小版"。
缩小版能干什么? 日常问答、翻译、总结文章、改写文案、简单代码,都没问题。
缩小版不擅长什么? 复杂推理、长篇深度写作、高难度编程。这些活儿,该用云端还得用云端。
所以心态要摆正。本地模型是拿来干那些不方便给云端、或者量大到给不起钱的活的。 要拼聪明,云端仍然是老大。
第 2 章 看懂模型的名字
打开模型下载页,你会看到一串这样的名字。
Qwen3-30B-A3B-Instruct
DeepSeek-R1-Distill-Qwen-14B
gemma3-12b-it
看着像乱码,其实是一套非常规整的"命名公式"。
2.1 拆解一个真实的名字
拿 Qwen3-30B-A3B-Instruct 开刀,从左往右拆。
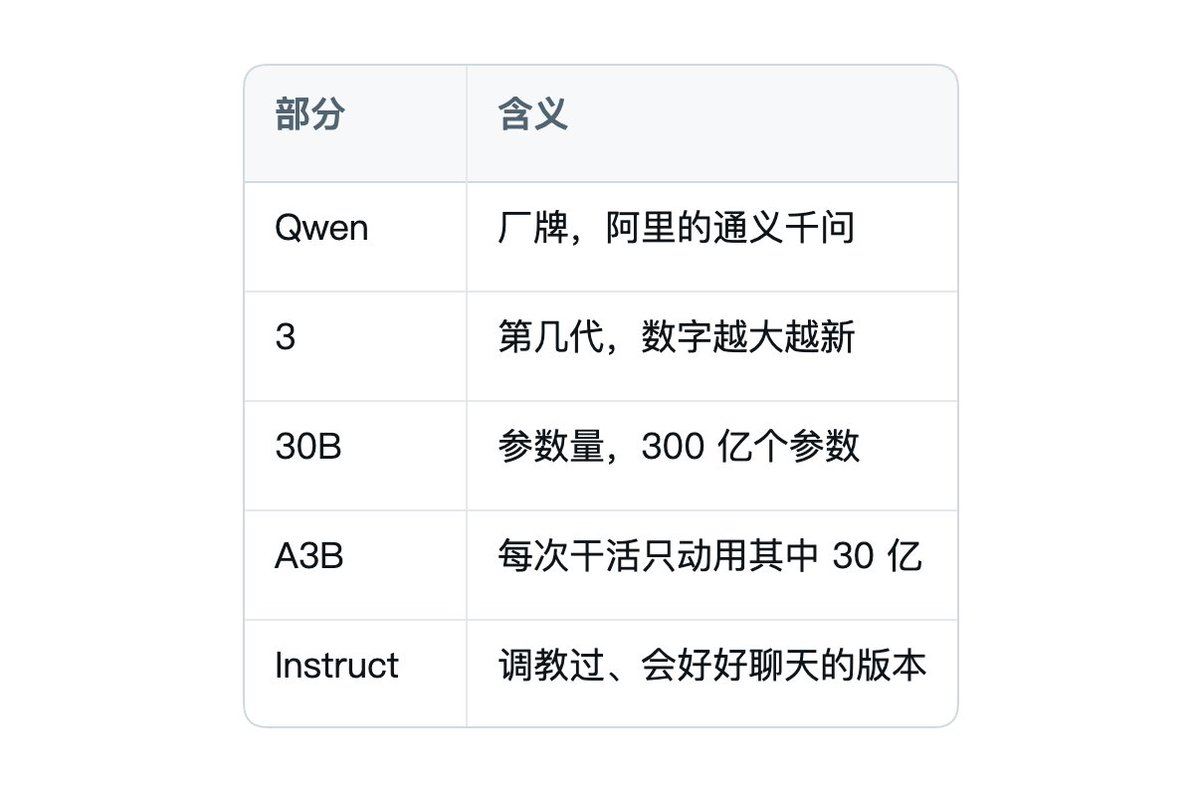
厂牌和代数不用多讲,跟手机型号一个道理。重点是后面三个参数。
2.2 B 是什么,参数就是脑细胞
B 是英文"十亿"的缩写。7B 就是 70 亿个参数,30B 就是 300 亿个。
参数是什么?你可以把它理解成模型的"脑细胞"。
模型训练的过程,就是用海量文字把这几十亿个脑细胞的连接方式调出来。 脑细胞越多,模型能记住的知识越多、越聪明。
但脑细胞越多,也越占地方。
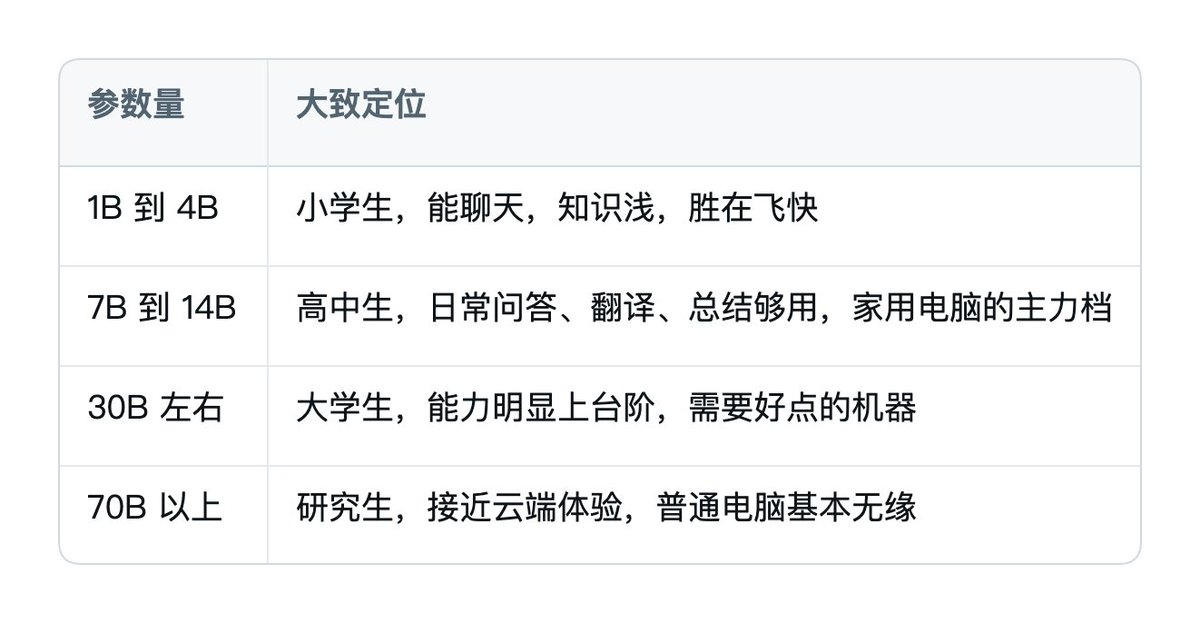
参数量决定了模型的智力上限,也决定了你的电脑装不装得下。
2.3 Instruct、Chat、Base,认准会聊天的那个
同一个模型经常有好几个版本,后缀不一样。
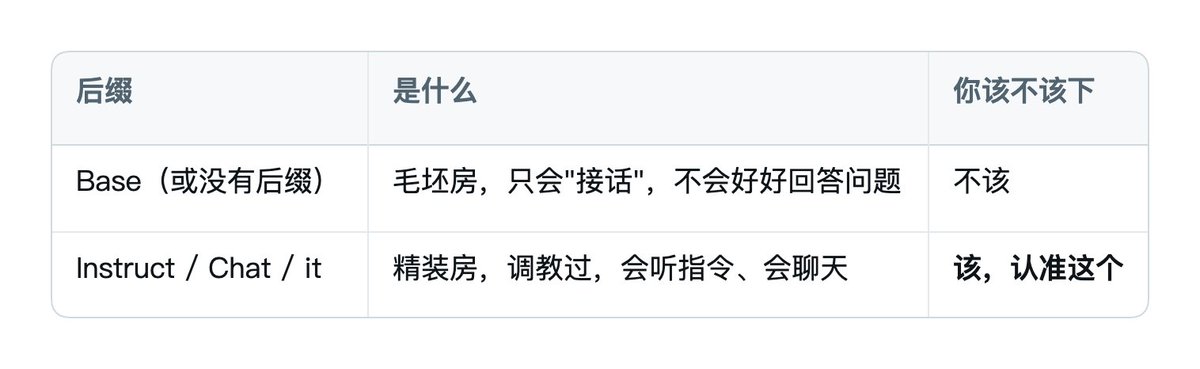
Base 版是训练的半成品,只学会了"接着往下写"。 你问它"怎么煮鸡蛋",它可能给你续写出十个类似的问题,就是不回答。
Instruct 版才是被教会"好好回答问题"的成品。
不同厂牌叫法不同,有的叫 Instruct,有的叫 Chat,谷歌的 Gemma 叫 it,都是一回事。
下载时选 Instruct、Chat、it。
2.4 A3B 是什么,一群专家轮流上班
有些模型名里有两个参数量,比如 30B-A3B。
这种叫混合专家模型(英文缩写 MoE)。
用大白话讲,模型里住着一群各管一摊的专家。 每次回答问题,只叫醒最相关的几个干活,其他人接着睡。
30B-A3B 的意思就是,专家团一共 300 亿参数,每次干活只动用 30 亿。
好处和代价都很直接。
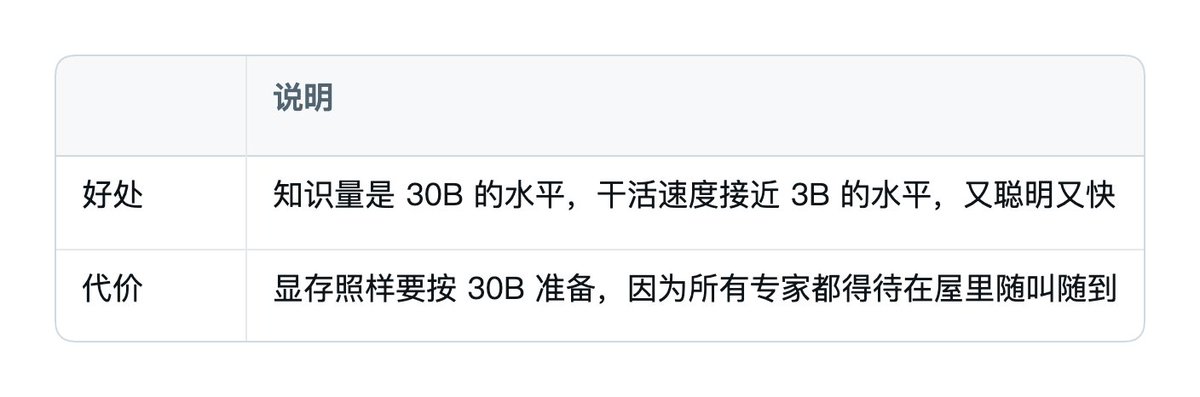
这类模型是这两年的大趋势,因为性价比高。
2.5 Distill 是什么,学霸教出来的学生
名字里带 Distill 的,叫蒸馏模型。
比如 DeepSeek-R1-Distill-Qwen-14B,让 6710 亿参数的大模型 DeepSeek-R1 当老师,把它的解题思路整理成教材,喂给 14B 的小模型 Qwen 学。
学生当然赶不上老师,但比同尺寸的普通模型强得多,尤其是数学和推理。
蒸馏模型就是"学霸补课班"出来的学生,小身材,学到了大模型的做题套路。
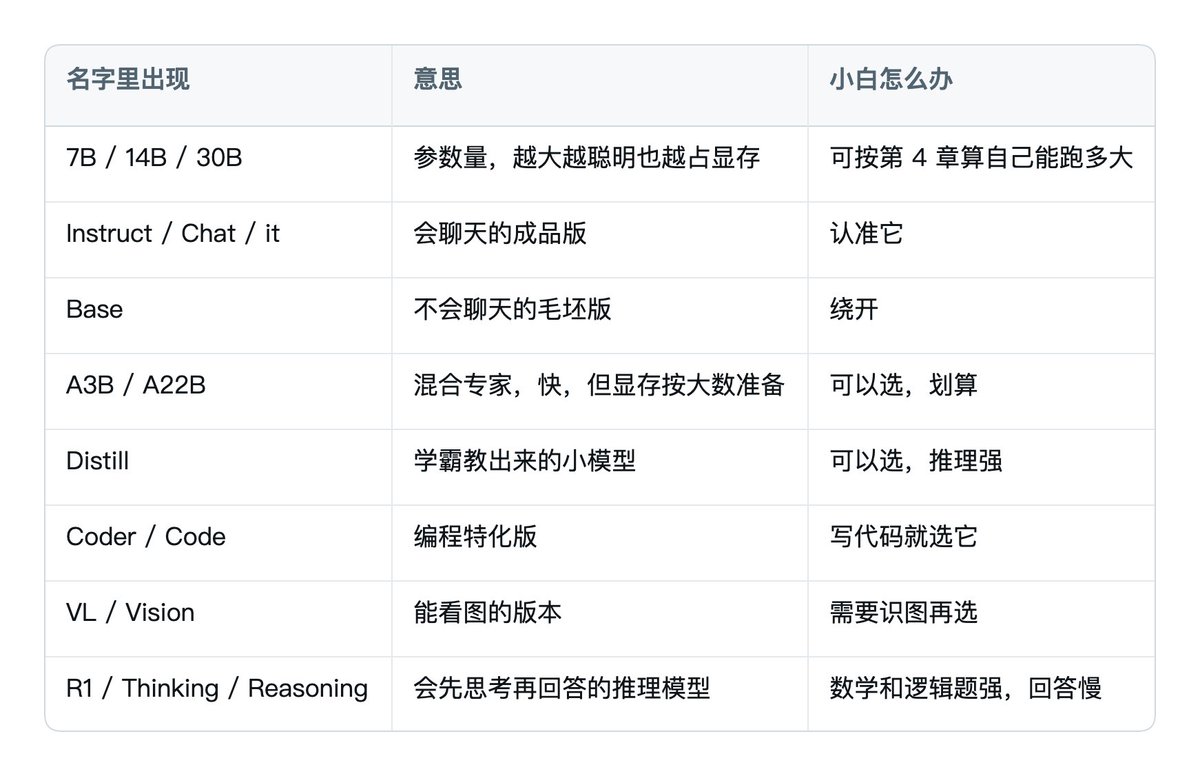
2.6 后缀速查表
把这一章浓缩成一张表,下载时对着查。
第 3 章 量化,把大象装进冰箱
为什么原版模型你家电脑跑不动,网上的人却能跑?秘密全在"量化"两个字上。
3.1 原版模型有多大
模型的每个参数,本质上是一个小数。 原版模型里,每个小数要占 2 个字节的空间。
算一笔账,7B 模型有 70 亿个参数,每个占 2 字节,整个模型就是 14GB。
14GB 什么概念? 主流家用显卡的显存是 8GB 到 16GB。
也就是说,一个 7B 的"小"模型,原版就能把你的显卡塞爆。
30B、70B 更不用想。
照这么算,本地模型这事根本玩不起来。所以有了量化。
3.2 量化就是压缩画质
量化就是把模型里的每个小数用更粗糙的方式记录,换取体积大幅缩小。
这跟压缩照片是一回事。 原图 50MB,微信发出去变 2MB。 放大细看有损失,但正常看完全不影响。
模型也一样,原版每个参数占 16 位,量化到 4 位,体积直接缩到四分之一,智力只掉一点点。
下载页上那些 Q 开头的代号,就是压缩档位。
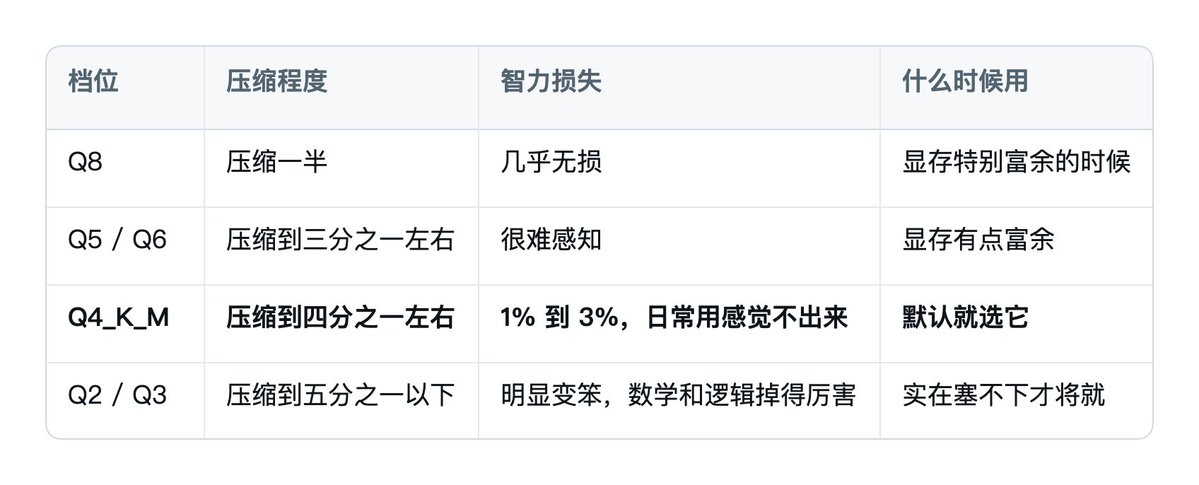
不知道选哪个,就选 Q4_K_M。这是整个社区公认的甜点档位,质量和体积的最佳平衡点。
3.3 GGUF 是什么
下载页上还有个躲不开的词,GGUF。
它就是量化模型的文件格式,好比视频圈的 MP4。 一个 GGUF 文件里打包了模型的全部家当,下载一个文件就能跑。
你还会看到另一种格式叫 safetensors,那是给专业开发者训练用的原版格式。
本地聊天认准 GGUF。看到 safetensors,那不是给你准备的。
Ollama 和 LM Studio 这些软件(第 6 章讲)用的都是 GGUF,你在它们的商店里下载时甚至不用关心格式,软件已经替你选好了。
3.4 根据你的显存选模型
现在可以算体积了。Q4 量化下,模型文件大小约等于参数量乘以 0.6。
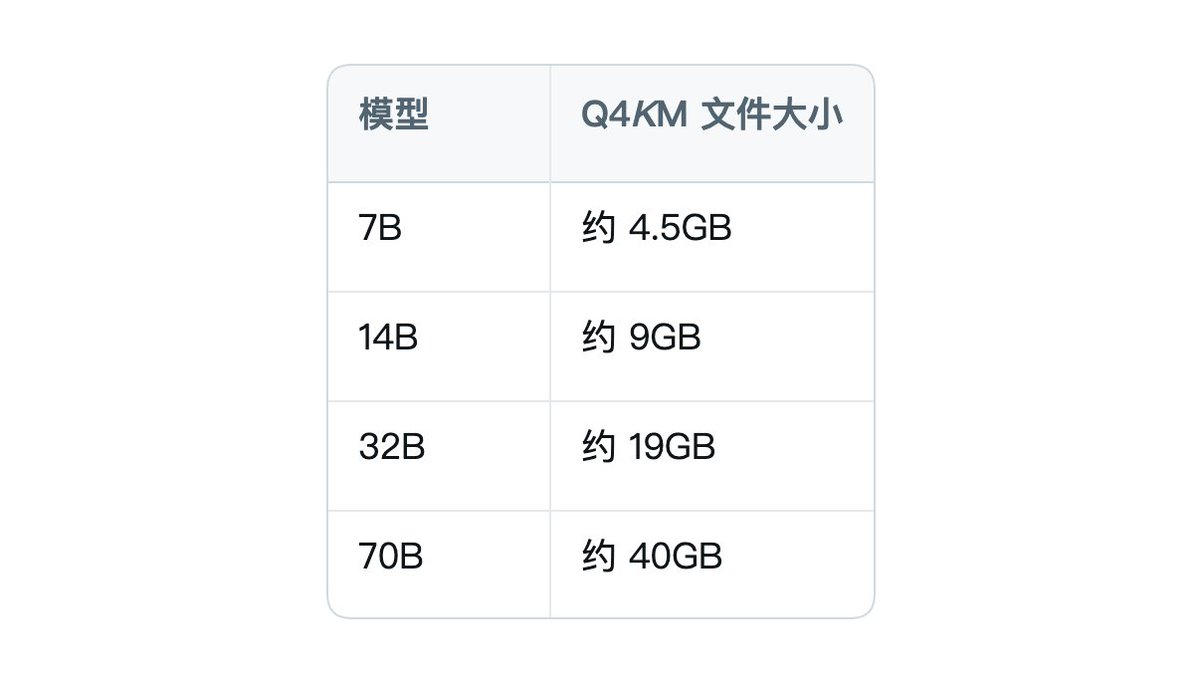
有了这个换算,引出一条新手最容易搞反的铁律。
同样的显存,装一个压缩过的大模型,胜过装一个不压缩的小模型。
比如你有 8GB 显存,能装下 Q8 的 7B,也能装下 Q4 的 14B,体积差不多。选哪个?
选 Q4 的 14B。实测反复证明,14B 压到 Q4 掉的那点智力,远远小于 7B 和 14B 之间的智力差距。
所以选型时先挑显存装得下的最大参数量,再用 Q4_K_M 去压。这个顺序不能倒。
会算体积了,下一步搞清楚你的电脑到底有多大的"冰箱"。
第 4 章 算清你的机器能跑什么
4.1 只看显存这一个数字
跑模型,CPU 快不快、硬盘大不大都是次要的。决定性的数字只有一个,显存。
显存是显卡自带的专用内存。模型必须整个塞进显存里,显卡才能全速干活。
两类电脑,看的地方不一样。
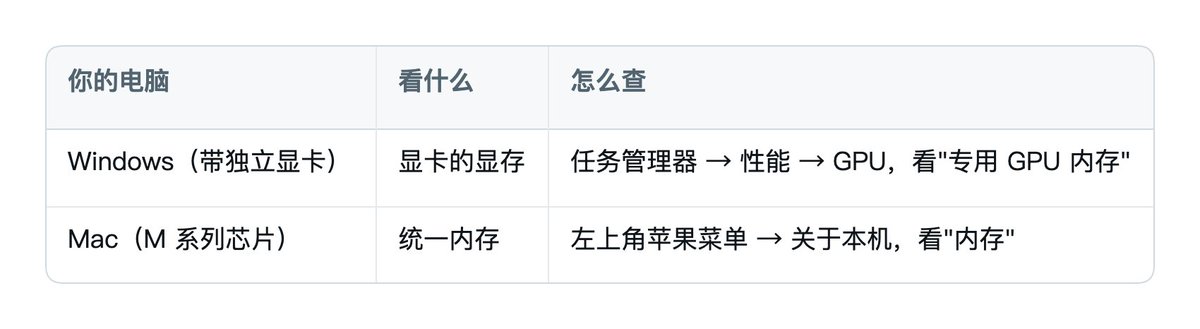
Mac 要多说一句。M 系列芯片的内存是 CPU 和显卡共用的,叫统一内存。跑模型时大约七成可以当显存用。16GB 内存的 Mac,约等于一张 11GB 显存的显卡。
4.2 换算公式
一个模型要占的显存这样算。
模型文件大小 + 2 到 3GB(对话上下文和系统开销)
反过来推你的可用档位。
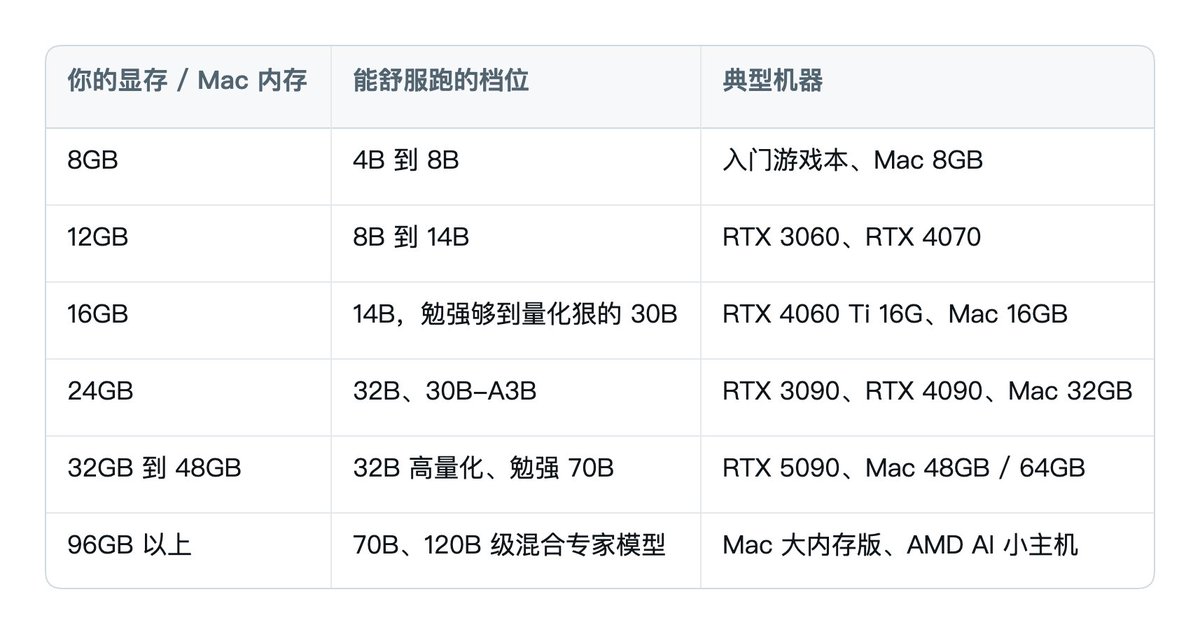
显存减掉 3GB,除以 0.6,就是你能跑的最大参数量(Q4 量化)。
不想算的,直接查这张表。
4.3 塞不下会怎样
有人会问,模型比显存大一点,是不是就彻底跑不了?
能跑,但你不会想用的。
现在的软件都支持"溢出",显存装不下的部分放到内存里,用 CPU 慢慢算。 溢出一点点,速度小降。溢出一大半,速度断崖式下跌,从"唰唰出字"变成"一个字一个字往外蹦"。
判断标准很简单。模型回答的速度,肉眼读起来跟不上,就是健康的。 你读得比它出得快,就说明溢出了,换小一档的模型。
4.4 一个先后顺序的忠告
算完档位,有人一看自己只能跑 8B,觉得太寒酸,想先买机器。
停一下。顺序反了。
先用现有的电脑跑通一个小模型,用上两个星期,确认自己真的会用、真的常用,再考虑掏钱。
8B 模型不寒酸,翻译、总结、日常问答足够体面。而"先买设备再培养习惯",是 99% 小白浪费钱的开始。
第 5 章 购机建议,显卡、小主机还是 Mac
5.1 买 AI 机器只看一个数字
上一章说了,跑模型看显存。买机器同理。
能用的显存有多大,是唯一重要的数字。算力、跑分、核心数,全是次要的。
这条规矩专治商家话术。销售跟你吹"这卡游戏性能多强",你只问一句,显存多大。8GB 显存的新卡,跑模型不如 12GB 显存的老卡,再新也没用。
5.2 先想清楚玩不玩生图生视频
掏钱之前先回答一个问题。你以后想不想在本地玩生图、生视频
这个问题决定了你有几条路可走。
-
想玩,只有英伟达显卡一条路。生图生视频的软件生态几乎全绑在英伟达的 CUDA 技术上,Mac 和 AMD 都跑得磕磕绊绊
-
只玩文本模型,下面三条路线随便选
5.3 路线一,英伟达显卡台式机
最经典的路线,速度最快,生态最好,什么软件都第一时间支持。
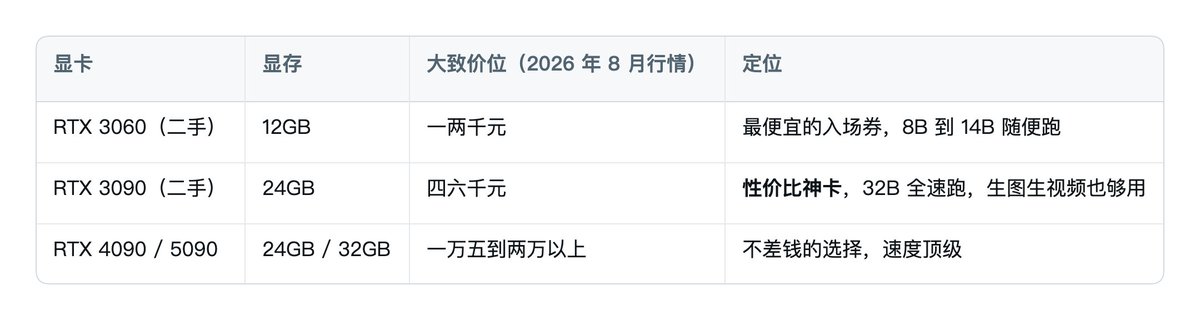
重点说二手 3090。它是上上代的旗舰,游戏玩家嫌它旧,但 24GB 显存跑模型一点不过时。同样的钱买新卡,显存只有它一半。这是整个本地模型圈公认的性价比之王。
5.4 路线二,AMD 统一内存小主机
这是 2026 年杀出来的新物种,代表型号是搭载 AMD Ryzen AI Max+ 395 芯片的迷你主机。
它的玩法跟 Mac 一样,128GB 内存由 CPU 和显卡共用,其中约 96GB 可以当显存。
96GB 显存什么概念?上面表格里两万块的 5090 才 32GB。而这种小主机 128GB 版本只要一万出头,用三分之一的价钱,拿到三倍的"显存",70B 模型整个塞进去都绰绰有余。
代价也要讲清楚。
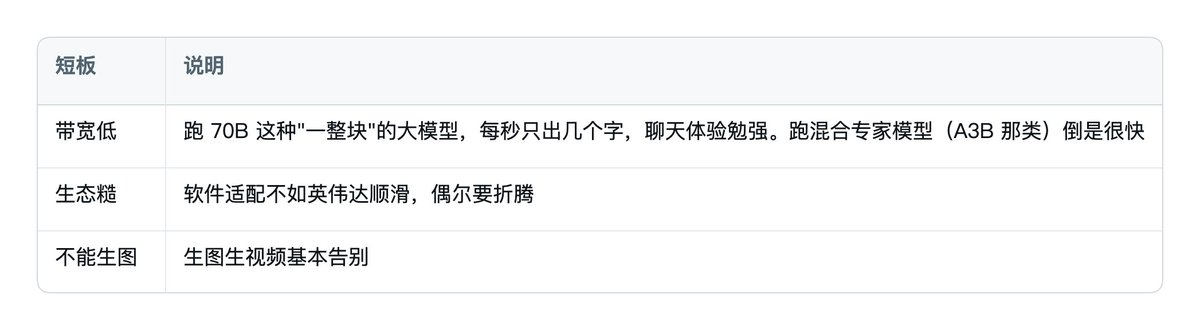
适合的人也清楚,只玩文本模型、想在本地跑大家伙、预算一万出头、不怕偶尔折腾。
5.5 路线三,Mac
如果你本来就用 Mac,或者本来就打算买 Mac,这条路线最省心。
M 系列芯片跑模型是真行,安静、省电、开箱就能用。买的时候只认一个原则,内存往大了买,其他配置随意。
Mac 的短板跟 AMD 小主机类似,生图生视频生态弱。另外同样是大内存,Mac 的价格是 AMD 小主机的两三倍,买的是省心和做工。
5.6 内存条怎么配
说的是台式机路线的普通内存,不是显存。32GB 起步。
理由很实际。模型溢出时要靠内存兜底,浏览器和微信本身就要吃掉七八个 GB,16GB 内存的机器跑着跑着就卡死。内存便宜,别在这里省。
第 6 章 软件选型,LM Studio 还是 Ollama
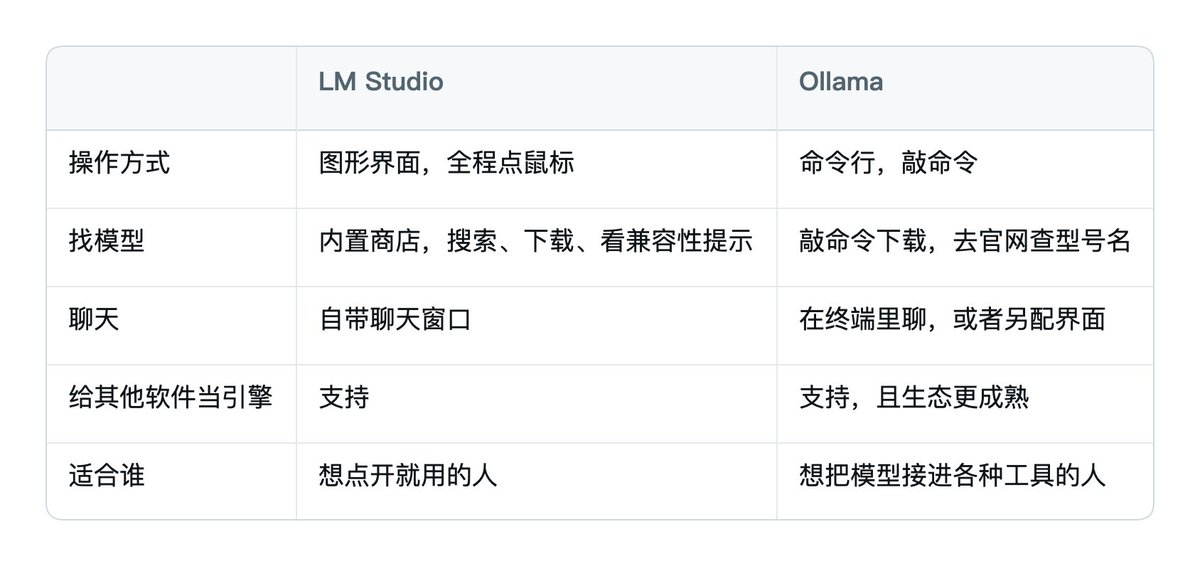
跑本地模型不用写代码,装一个现成的软件就行。主流选择就两个,LM Studio 和 Ollama。
6.1 两个软件是干嘛的
它们干的是同一件事,帮你下载模型、加载模型、提供一个聊天的地方。区别只在操作方式。
6.2 一个流传很广的误区
网上老有人争论"哪个跑得快"。
实测结论很干脆,同一个模型、同一个量化档位,两个软件的速度完全一样。
因为它们底层用的是同一套开源引擎,好比两个牌子的播放器放同一部电影,画质不会有区别。感觉到的快慢差异,都是默认设置不同造成的。
所以别纠结性能,按操作习惯选就行。
6.3 小白的选择
从 LM Studio 起步。 理由有三。
-
全程图形界面,装完就能用
-
内置模型商店,会根据你的显存标注"这个模型你能不能跑",新手最容易犯的"下了跑不动"错误,它直接帮你拦住
-
以后想换 Ollama,模型概念全通用,学习成本为零
什么时候需要 Ollama?当你想让别的软件调用本地模型的时候,比如接进 Obsidian、接进浏览器插件、接进自己写的脚本。到那天再装不迟,两个软件可以共存,互不干扰。
第 7 章 按用途选模型
选本地模型跟选云端模型是同一套办法,你要干什么,就选那件事上单科最强的,别看综合排名。
7.1 2026 年 8 月的推荐表
按"你的显存档位"和"你想干的事"两个维度查这张表。
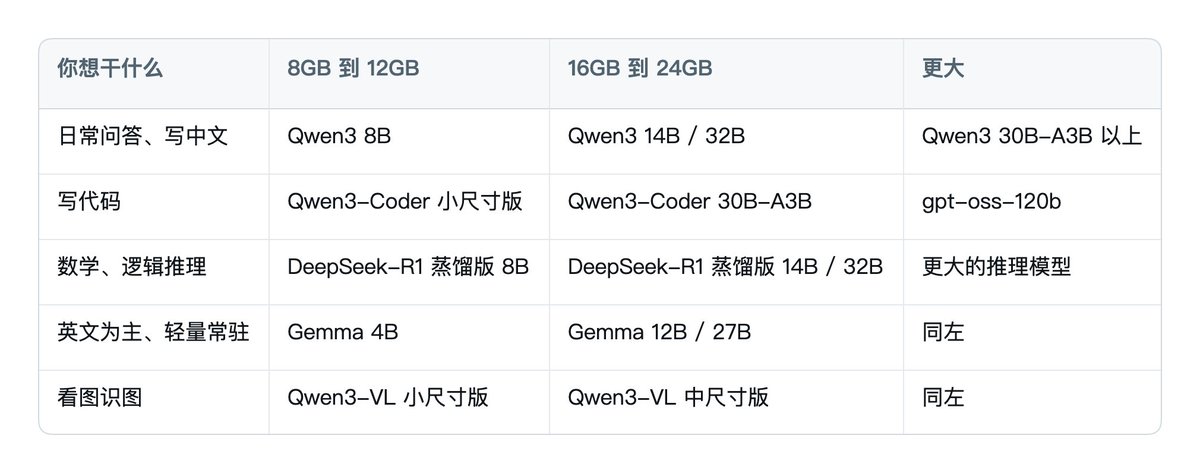
两条补充说明。
-
中文场景无脑选 Qwen 系,它的中文能力是同尺寸里最强的一档,而且量化版、特化版最全
-
gpt-oss 是 OpenAI 放出来的开放模型,20B 版 16GB 显存就能跑,代码和推理都不错,值得一试
7.2 这张表会过期,方法不会
本地模型圈几乎每个月都有新王登基,半年后这张表一定过时。
选型方法倒是一直有效,需要更新认知时照着做。
-
打开 LM Studio 商店或 Ollama 官网的模型列表,按下载量排序,前排的就是当前的主流
-
看单科,写代码找名字带 Coder 的,推理找带 R1、Thinking 的,跟第 2 章的后缀速查表对着看
-
拿不准就搜"模型名 + 评测",重点看真实用户的使用感受,少看厂商宣传
7.3 自己考它一遍
榜单和推荐表只能帮你筛出两三个候选,最终拍板要靠你自己的题。
方法很土但极其有效。把你日常真实会问的问题攒 20 个,每个候选模型都问一遍,对比答案。
写周报的拿真实周报素材试,翻译的拿真实文档试,写代码的拿自己的真实需求试。半小时就能试完,比看一百篇评测都准。
模型这条线到此就完整了。接下来是加餐,文字之外的玩法。
第 8 章 本地生图
本地不光能跑聊天模型,还能生成图片。这是另一个世界,模型、软件、规则全换了一套,规矩倒还是那一条,显存决定一切。
8.1 生图模型分三档
文生图的主流模型就三个系列,正好对应三个显存档位。
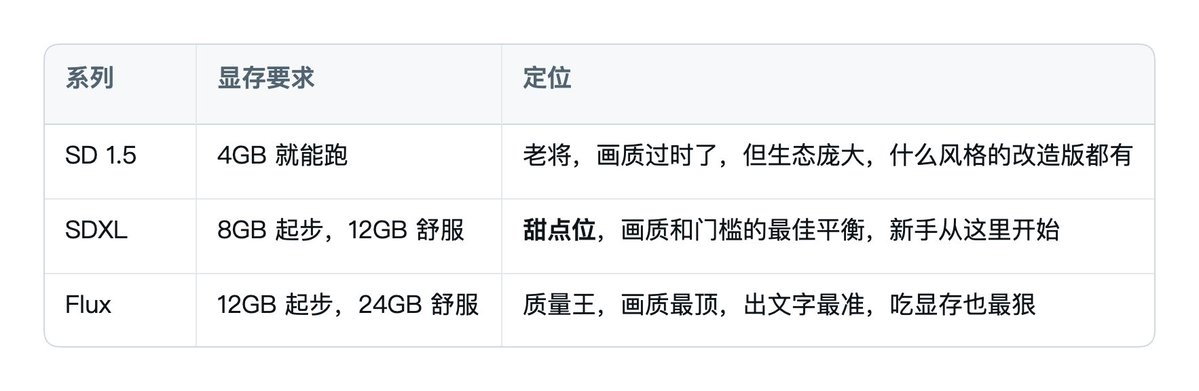
选择逻辑跟文本模型一样,显存够到哪档跑哪档。
8.2 软件用 ComfyUI
生图圈的事实标准软件叫 ComfyUI。
它的界面是"节点式"的,一个个方块用线连起来,像电路图。第一眼很唬人,但新手不用自己连,装好后加载别人做好的工作流文件,点一下运行就出图。
上手路径就三步。
-
官网下载桌面版(Windows、Mac 都有),安装
-
首次启动按提示下载一个 SDXL 底模
-
用内置的默认工作流,输入提示词,点运行
生图对显卡的挑剔远超文本模型。
英伟达显卡什么都能跑,Mac 能跑但速度慢一截,AMD 显卡最折腾。这就是第 5 章让你先想清楚玩不玩生图的原因。
8.3 LoRA,给模型装风格插件
生图圈还有个词你一定会遇到,LoRA。
它是模型的"风格小插件",底模负责画画的基本功,LoRA 负责特定画风、特定人物、特定物品。一个几十 MB 的 LoRA 文件挂上去,模型立刻会画某种特定风格。
社区里有海量现成的 LoRA 可以下载,这是生图圈最大的乐趣来源。
8.4 商用要看授权
如果你生的图要用于赚钱的事,停下来看一眼授权。
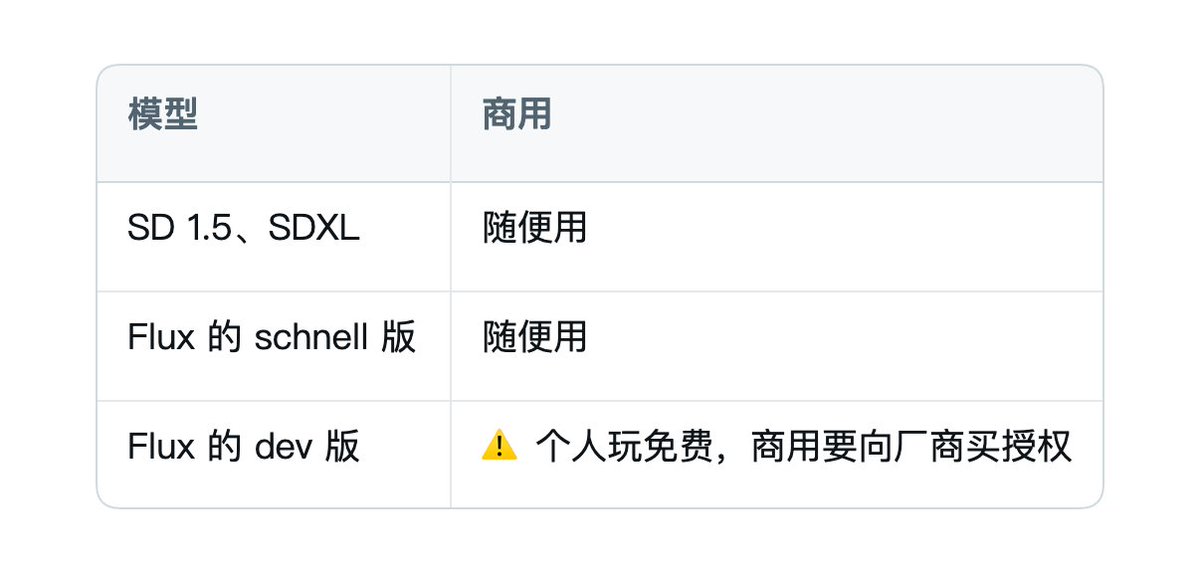
自己电脑上跑不等于生成物随便商用,这是生图圈新手最常踩的法务坑。
第 9 章 本地生视频
生图再往前一步就是生视频。能玩,但离好用还有距离,显存 16GB 以下的建议只围观。
9.1 现在是什么水平
主流的开源视频模型是阿里的 Wan 系列和腾讯的混元系列,都能在消费级显卡上跑量化版。
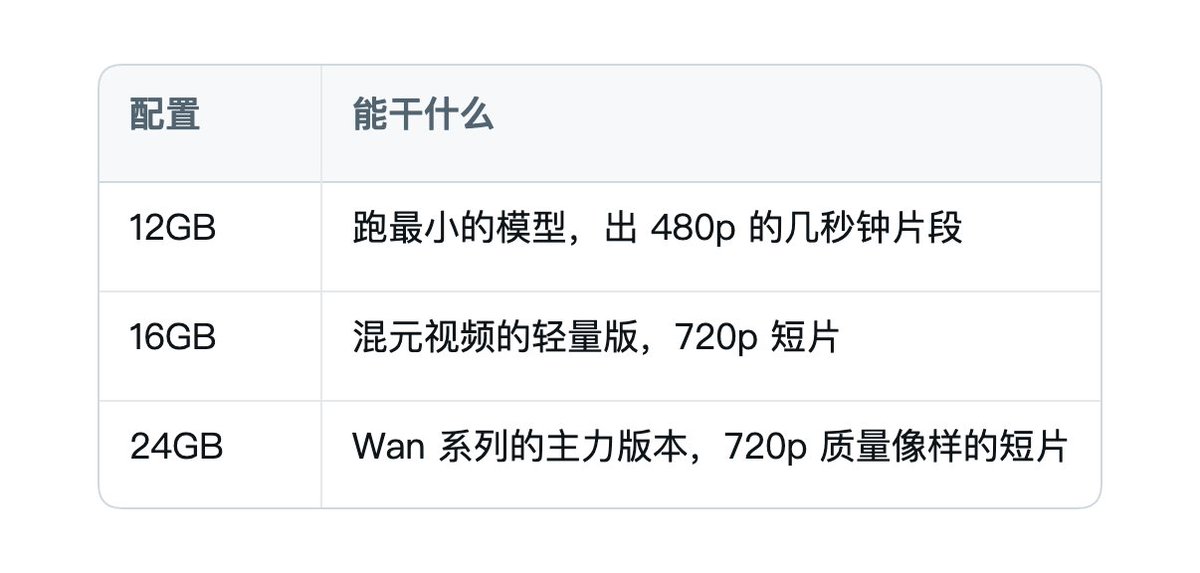
9.2 为什么说离好用还有距离
一个数字就够了。24GB 的顶级显卡,生成一段 5 秒的 720p 视频,要算大约 9 分钟。
而且生视频是抽卡游戏,动作崩了、画面闪了,都得重抽。抽五次才出一条能看的,就是 45 分钟换 5 秒钟。
云端视频服务一两分钟出片。本地生视频目前的意义在尝鲜和学习,谈生产力还早。
9.3 什么人值得折腾
满足三条再入坑,24GB 以上的英伟达显卡,玩熟了 ComfyUI(视频工作流就在它里面跑),以及对着显卡吭哧吭哧算视频这件事本身让你感到快乐。
三条差一条,都建议再等等。这个领域进步飞快,明年的门槛一定比今年低。
第 10 章 未审查模型
搜本地模型时,你迟早会撞见 uncensored、abliterated 这些词。这一章把它讲清楚,是什么、为什么存在、代价是什么。只做科普,不做推荐。
10.1 模型为什么会拒绝你
第 2 章说过,Instruct 版模型是被调教过的。调教内容除了"好好回答",还有"什么不能答"。厂商在训练最后阶段教会模型对危险、违法、敏感的话题说不。
这层调教俗称"对齐"或者"护栏"。云端模型的护栏拆不掉,但本地模型的文件在你手里,社区就动手改造出了去护栏的版本。
10.2 两种改法
这些版本在国外最大的模型仓库 Hugging Face 上公开存在,名字就是在原模型名后面加上这些后缀。
10.3 什么场景下需要未审查模型
典型场景有三类。
-
写小说的人,写悬疑、犯罪、战争题材,正经创作需求被原版模型反复拒绝
-
问医疗、法律问题的人,原版护栏经常过度敏感,正常咨询也弹拒绝
-
安全研究,研究模型的攻防,本来就需要没有护栏的实验对象
护栏的尺度是厂商定的,未审查模型的存在,本质是社区对"误伤"的回应。
10.4 未审查模型的代价
-
变笨。无论微调还是手术,都会伤到模型智力,消融版尤其明显。护栏和能力在模型内部是缠在一起的,拆墙必带走砖
-
没有兜底。原版模型会在危险话题前踩刹车,改版不会。它顺着任何话头说下去,输出的内容没人替你把关
-
责任归你。法律红线不因为模型没护栏就消失。用它生成违法内容,责任在使用的人,跟用菜刀伤人怪不到菜刀厂一个道理
用不用、怎么用,是你自己的判断。
写在最后
选本地模型的动作串起来就五步。 查显存,定参数档位,量化选 Q4KM,版本认准 Instruct,最后拿自己的真实问题考它一遍。
该不该升级硬件,看懂这篇基于你的需求在定,切勿乱花钱!
黄小木|T11级工程师|内容为codex创作,若有侵权请指出|持续分享 AI 信息、副业赚钱、程序员转型OPC心得|X:@ai_xiaomu
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


