
换套 Harness,让你的 Agent 便宜又好用
文章目录
Agent 效果不行,大家的第一反应就是换个更贵的模型!!
贵的就该更好,这个逻辑我们从小信到大,但真的是这样吗?
最近有个开源项目叫 OpenSquilla,发了新版本,还同步放出一份技术报告,我把两边对照着核了一遍,越核越不对劲:
一群单拎出来都打不过 Fable5 的模型,凑一起,居然赢了 换套Harness,差点的模型就比肩最强模型了吗?
数据不会说谎,请看下面
不小心打赢了Fable5
OpenSquilla 官方自己说,这组数据来回核了好几遍才敢发
先看战绩:相较 Fable5,质量分 +1.05,成本降 67.77%
相较 Opus 4.8,质量分 +8.59,成本降 40%
相较 GPT-5.5,质量分 +10.84,成本降 13%
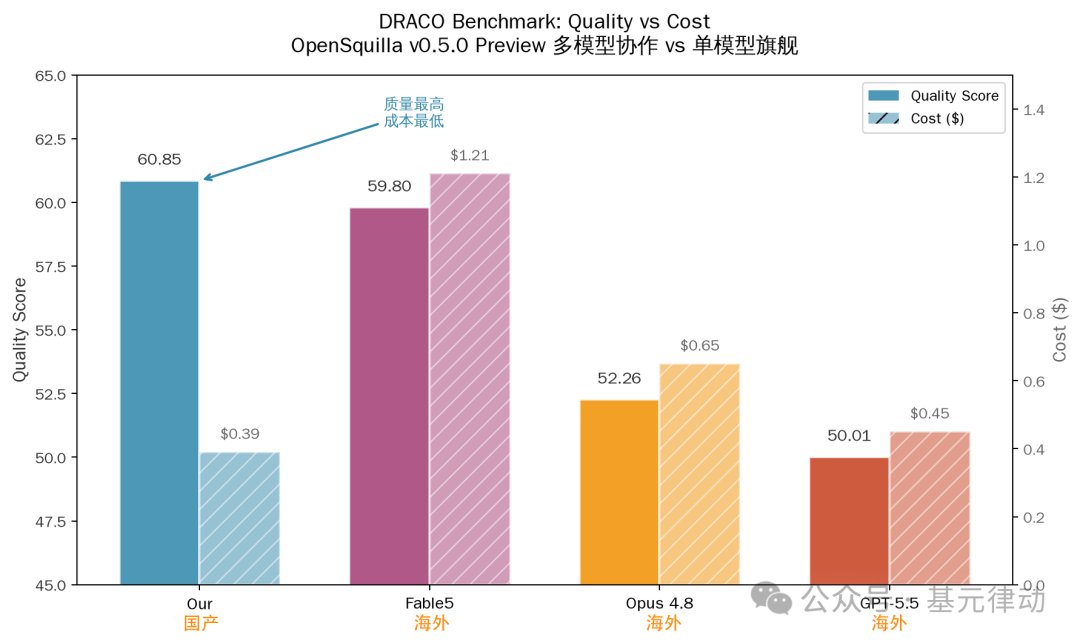
但到底用了什么牛逼的模型,能打赢Fable5?
结果让人十分意外,它只是用4个提案模型:DeepSeek v4、GLM-5.2、Kimi K2.7、Qwen3.7,全是国产,没有一个国外旗舰
单独拎出来看,DeepSeek、GLM、Kimi、Qwen,这几个哪个都打不过旗舰
那问题来了,一群打不过旗舰的模型,凑一起怎么就赢了?
难道这就是Harness的魔力,换了一个对的Harness,就妙手回春:四个臭皮匠打死一个诸葛亮?
那这事到底是怎么做到的?
好的Harness价值巨大
这套Harness里,其实一直有两个功能在干活
第一个叫智能路由,从 v0.1.0 就有,负责调度
它怎么判断该派哪个模型呢?靠一个叫 LightGBM 的排序模型,过四道关卡
先筛掉明显简单的任务,直接走便宜模型通道
再看这个任务具体需要什么能力
然后按风险调整,这一步万一判断错了,后面要不要花更多钱补救
最后才由这个排序模型,在剩下的候选模型里,挑一个最匹配的
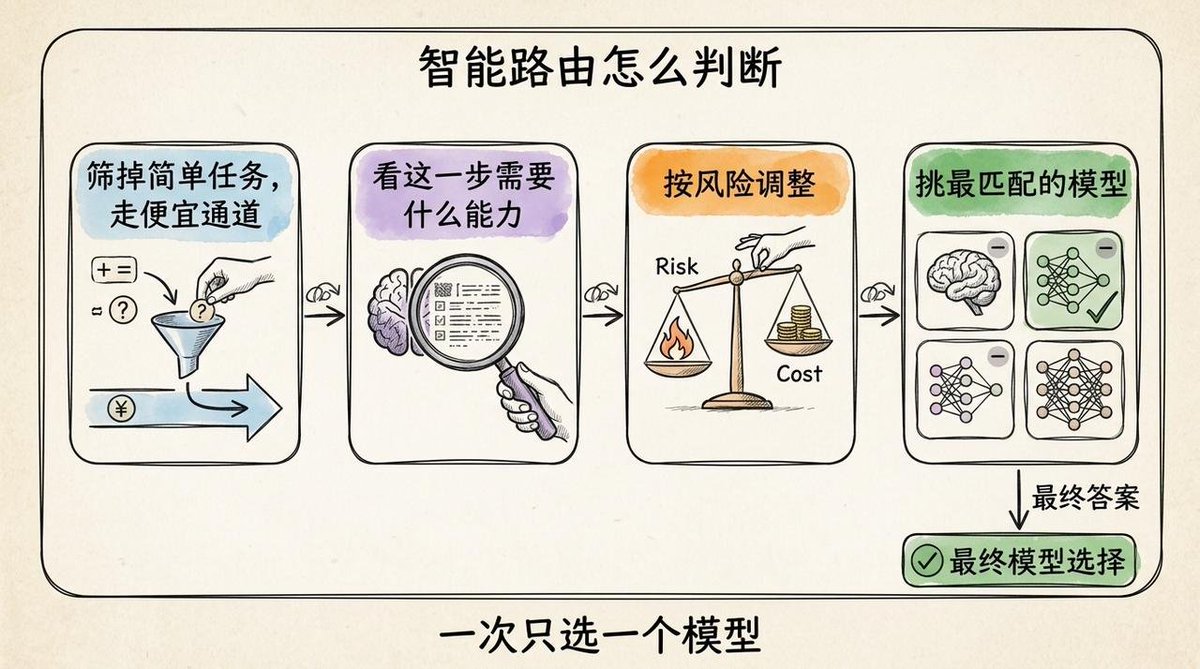
说白了,就是简单活儿分诊到普通门诊,难活儿转专家门诊,一次只转一个人
第二个是刚更新的,多模型集成,专门用在难活儿上
难度越高的活儿,喊来搭伙的人也越多
这几个人不是随便凑的,是挑出来的,既要能打,又不能都是一路人,还得划算。
打个比方,难活儿不再只转一个专家,可以喊几个不同科室的大夫一起会诊,各自看一遍,再让其中一个把几份诊断融合成最终结果
这么干为什么管用?
一个人查资料,容易漏关键信息源
一个人算数,没人帮着核对,容易出错
一个人干活,顾得了这头顾不了那头,条件一多就丢三落四
几个人一起上,这三个老毛病,都被垫平了!
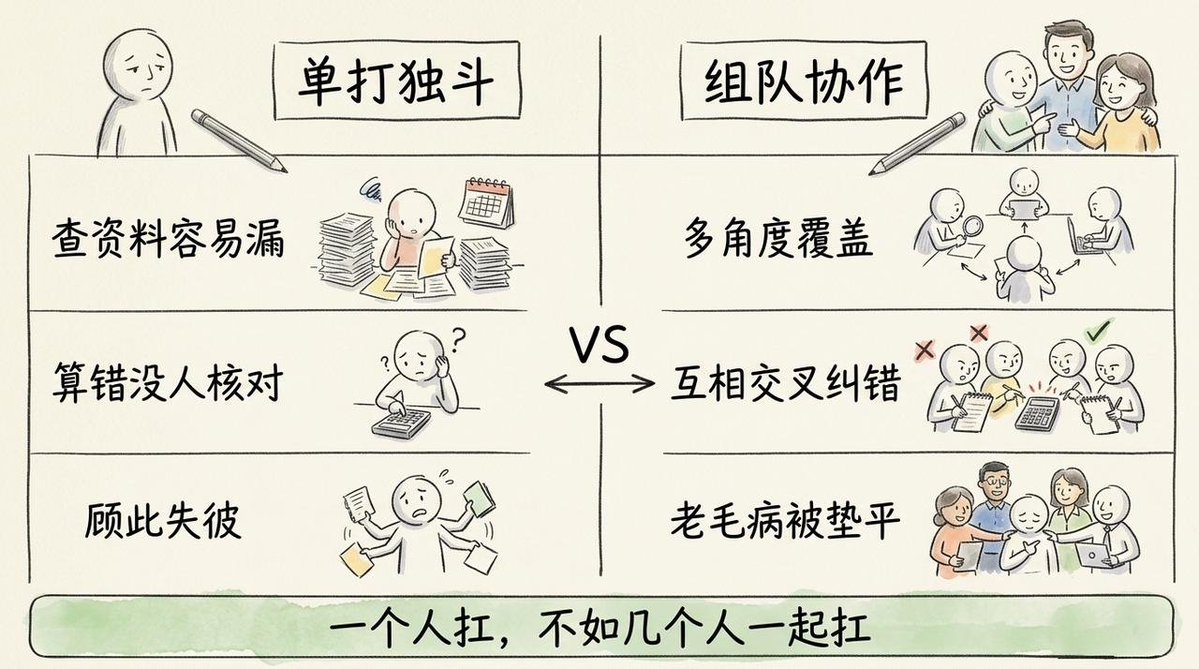
所以,换套对的 Harness,你的 Agent 便宜又好用
但这个框架除了降本增效哦,还有别的功能吗?
OpenSquilla产品演化史
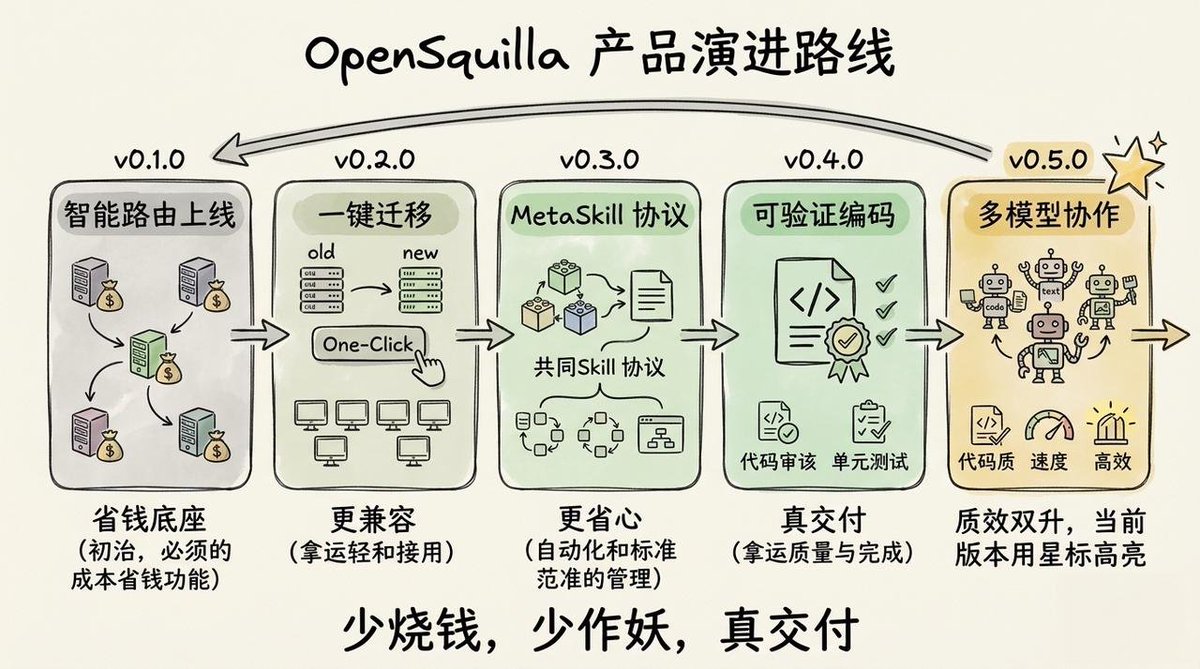
这几个版本里,还藏着两个东西,一直在给这套系统攒底子
第一个叫 MetaSkills,v0.3.0 上的
官方的说法是,把反复干的多步骤工作,打包成可复用、可检查的工作流
打个比方,你总让 AI 帮你调研写报告,每次都要从头交代一遍要求,费口舌
MetaSkills 做的事,就是把这套流程写成模板存下来,跟写菜谱一样,下次照着做,不用每次现教
第二个叫 Coding mode,v0.4.0 上的,官方管它叫 code-task
AI 改的代码,先扔进一个隔离的沙盒里跑一遍,验证通过了,才允许真正写进你的源码
打个比方,这就跟装修队一样,样板间先试装,验收过了,才让他们进你家正式施工,不会让人直接抡着锤子上你家墙就砸
这两个东西看着跟省钱没直接关系,但干的是同一件事,把对不对这件事,从靠人工判断,变成系统自己能说清楚
这才是 v0.5.0 敢把几个模型一起上这件事做成的基础!!
所以决定Agent好不好用的因素模型固然重要,但好Harness同样价值巨大
这可能才是往后 Agent 真正的竞争点!!
我用关注这套Harness已经很久了,它还有个巨大的优势:
这套东西开源,Apache 2.0 协议,能本地私有化部署,数据不用出内网
想直接体验的,仓库地址和体验官通道放在下面
GitHub:github.com/opensquilla/opensquilla
产品体验官计划,进群即送 10 美金 API Key每天抽 ChatGPT 会员:https://opensquilla.ai/zh/invite/


