
配音要花钱,自己录又费劲?小米限时免费的 AI 配音,新手 5 步上手
文章目录
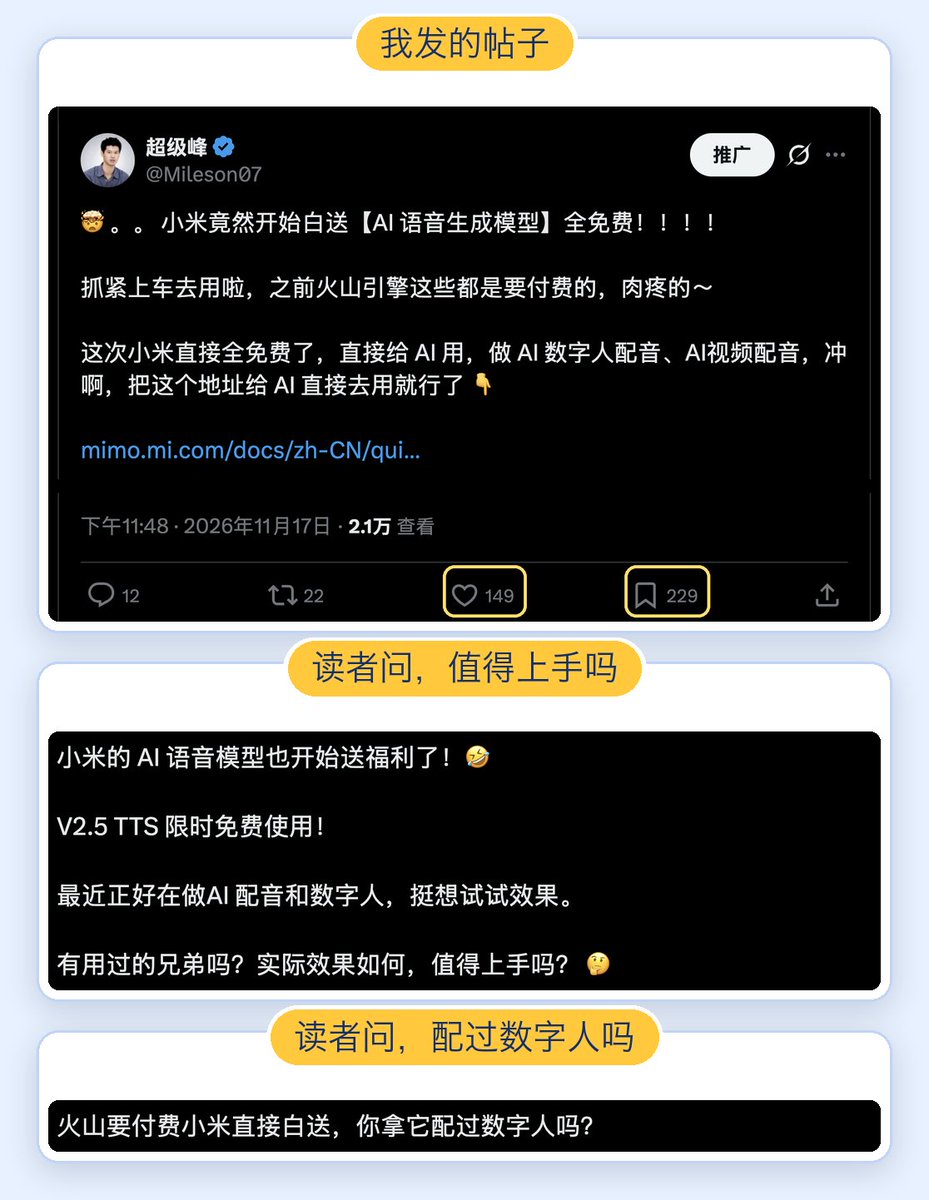
这两天我在 X 上发了小米 AI 语音模型免费的消息,两万多人看过,收藏的人比点赞的还多。帖子下面和相关的讨论里,有人问到底怎么用,效果值不值得上手,也有人问能不能拿来配数字人。
这篇把这些问题一次讲清楚。先讲它是什么、现在免费到什么程度,再用一段旁白走完 5 步,最后回答大家问到的那些事。读完你能把一段文案变成一段声音,会换声音、换语气,也知道怎么检查、怎么配进视频。
1、是什么
1.1 视频做完了,卡在声音这一步
画面有了,文案也有了,只差一段旁白,这是很多人做视频时最后卡住的地方。自己录,要找安静的地方,说错一个字就得重来。请人配,要花钱,改一句话还得重新约。
AI 配音解决的就是这一步。你把写好的文字交给它,选一个声音,等一小会儿就能拿到一个声音文件。它和真人配音最大的区别在改稿,真人配音改一句要重新约,AI 配音只重新合成这一句,换个声音也只是改一个名字。
这类工具的学名叫语音合成,英文缩写 TTS,意思是把文字念成人声。小米做的这一套叫 MiMo-V2.5-TTS,视频旁白、数字人口播、课程讲解这些要大量声音的活,都用得上。
我把配音当成一条固定的流程,文案进去,声音出来,听一遍,再配进视频。小米这个模型只是中间那个工具。我之前用过本机的开源模型,也用过火山引擎的声音复刻,现在多了小米这个。工具会换,流程可以一直用,下面 5 步里的后三步,换成别的配音工具照样成立。
1.2 小米这个模型能做什么,三个型号各管一件事
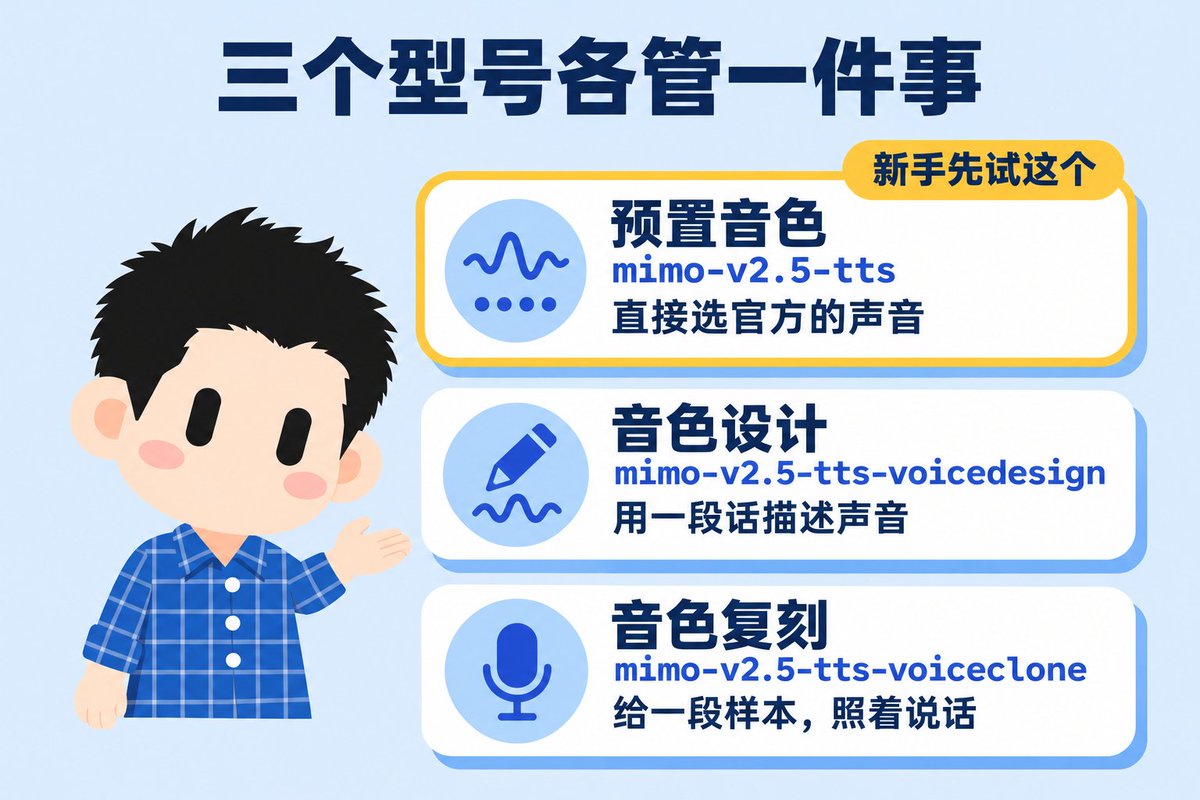
官方把语音合成做成了三个型号,每个型号对应一种想法。
-
预置音色,型号 mimo-v2.5-tts。直接用官方准备好的声音,内置中文的冰糖、茉莉(女声)和苏打、白桦(男声),还有四个英文声音。唱歌只有这个型号能做。
-
音色设计,型号 mimo-v2.5-tts-voicedesign。不选现成的声音,用一段话描述你想要的声音,比如“五十多岁的男性,声音沉稳有磁性,语速适中,像纪录片旁白”,它按描述生成一个声音。
-
音色复刻,型号 mimo-v2.5-tts-voiceclone。给它一段声音样本,它照着这个声音说话,样本只支持 mp3 和 wav 两种格式。
预置音色和音色复刻这两个型号,都能用一句话控制语气,也能用括号标签切换情绪和方言。
新手先从第一个开始,它不需要准备任何材料。等第一条视频做出来,再去试另外两个。
1.3 现在免费到什么程度,要准备什么
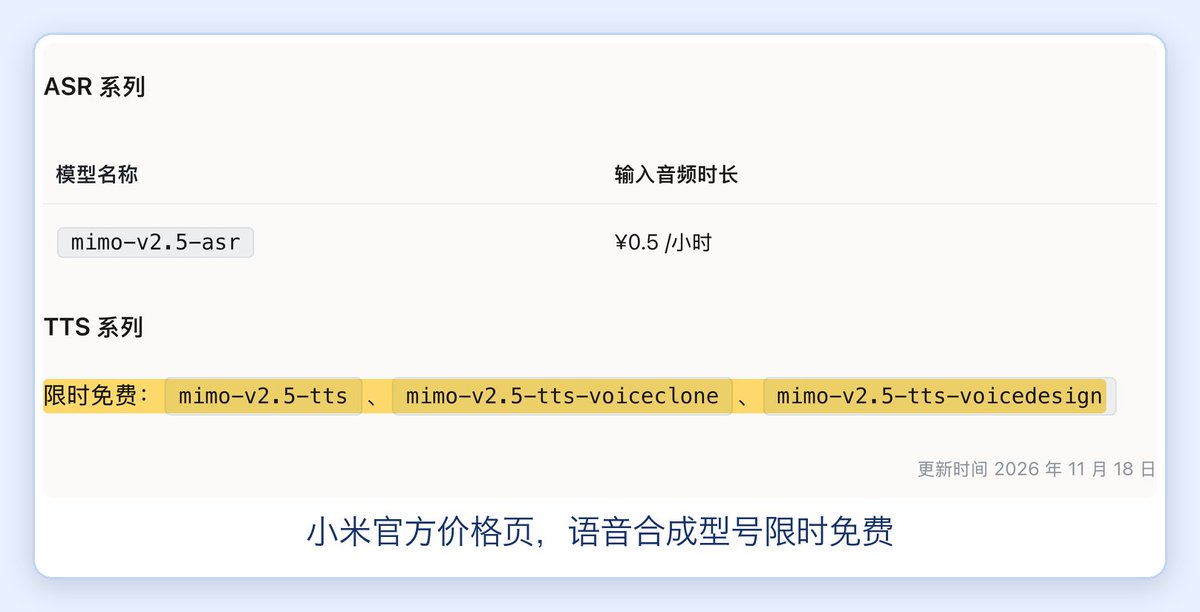
小米官方价格页(11 月 18 日更新)里,三个语音合成型号后面都写着“限时免费”,没有写什么时候结束。我的建议是现在就用起来,但别把长期的流程押在它一直免费上。免费也有代价,你的文案要发到小米的服务器,免费还有期限,这两点在常见问题里都会讲到。
官方还有一条速率限制,每个型号每分钟最多 100 次请求,每个账号有并发上限,服务器忙的时候会变慢,也可能返回 429 报错。这些你不用自己处理,第 2 步的提示词里已经让 AI 加了失败重试。
准备工作只有三样。一是小米账号,目前开放平台只支持个人账号,用小米账号登录,没有的话去 id.mi.com 注册。二是一个能写代码的 AI 助手,Cursor、Codex、Claude Code 都行,它负责写那个小工具。三是一段你想配音的文案,几句话就够第一次试。
2、怎么做
下面用同一段旁白走完 5 步,你照着做,最后把文案换成自己的就行。旁白一共两段,第一段是“今天教你三步,给自己的视频配上声音。第一步,写好文案;第二步,选一个声音;第三步,合成之后再听一遍。”,第二段是“声音合成好以后,别急着直接用,先从头到尾听一遍,把读错的词改成更口语的写法,再重新合成那一句。”
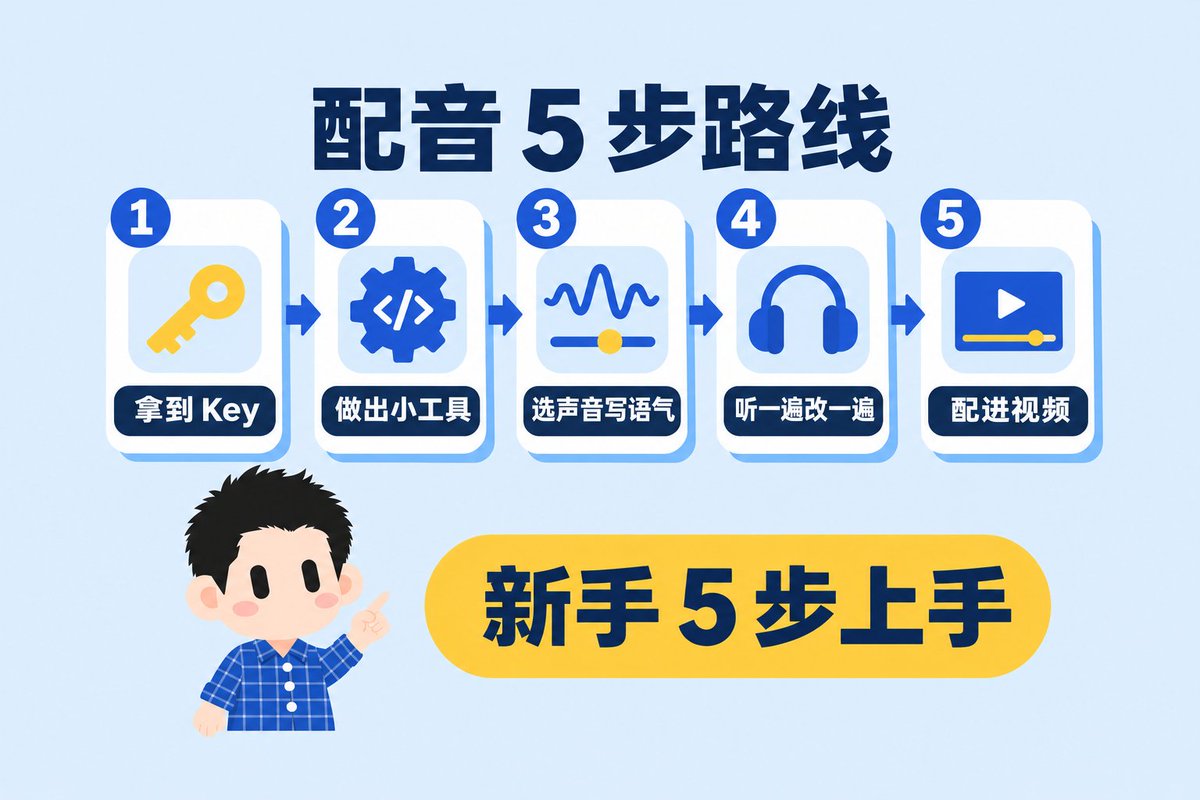
5 步依次是拿到 Key,做出小工具,选声音写语气,听一遍改一遍,配进视频。
2.1 第 1 步 拿到 Key 并存在自己电脑里
Key 是一串以 sk- 开头的字符,小工具每次向小米要声音,都要带着它,小米靠它认出这是你的账号。
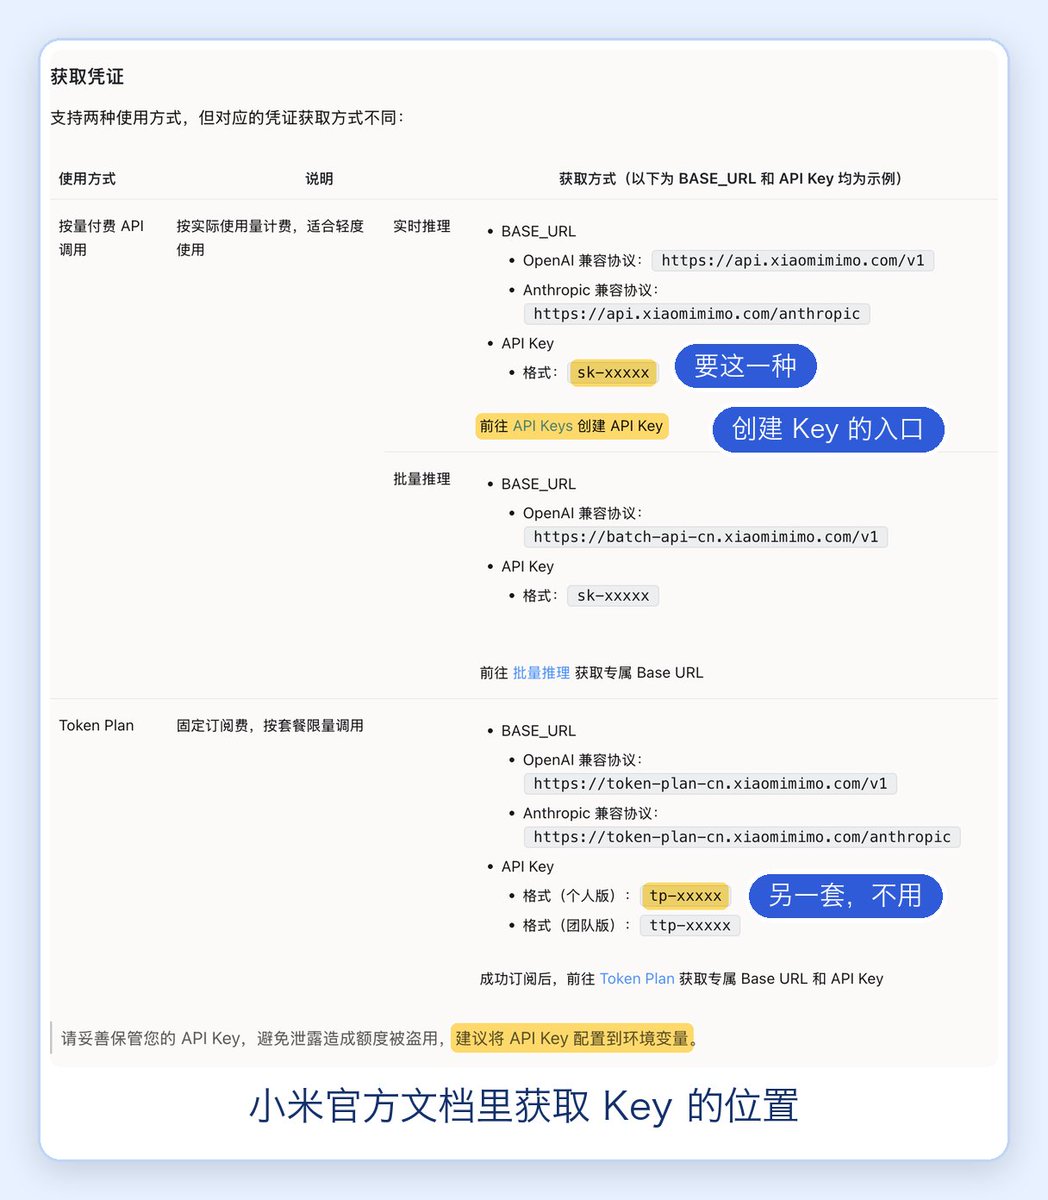
创建的位置在开放平台 platform.xiaomimimo.com。登录后进入控制台,找到 API Keys,创建一个新的,复制下来。官方的“首次调用 API”页把这一步写在“获取凭证”里。要创建的是按量付费那一种,格式是 sk-xxxxx。Token Plan 套餐里 tp- 开头的 Key 是另一套,额度和按量付费不互通,这里不用它。
然后建一个文件夹,比如叫“配音”,用你的 AI 助手打开它。在里面新建一个叫 .env 的文本文件,写一行内容,等号后面粘贴你的 Key。
MIMO_API_KEY=你的Key
官方文档建议把 Key 配置到环境变量,不要直接写进代码,.env 文件是最省事的做法。Key 只放在这个文件里,不要贴进聊天窗口,不要发给别人,也不要上传到 GitHub 这类公开的代码网站。
写完这一步,你会得到一个存着 Key 的 .env 文件,后面所有步骤都从这里读它。
2.2 第 2 步 把官方文档和需求交给 AI,做出小工具
我发那条帖子时说过,把官方文档的地址直接给 AI 去用就行。下面这段提示词,原样粘贴给你的 AI 助手。
请先阅读下面两个官方页面,再帮我写一个配音小工具。
https://mimo.mi.com/docs/zh-CN/quick-start/usage-guide/audio/speech-synthesis-v2.5
https://mimo.mi.com/docs/zh-CN/quick-start/summary/first-api-call

具体要求
1. 用 Python 写,放在当前文件夹,文件名 dub.py。
2. 从当前文件夹的 .env 文件里读取 MIMO_API_KEY,不要把 Key 打印出来,也不要写进代码。
3. 读取当前文件夹里的 文案.txt,空行隔开的每一段合成一个声音,保存到 声音 文件夹,格式用 wav。
4. 模型名、音色和语气,写在 dub.py 最上面的三个变量里,方便我随时修改。先用 mimo-v2.5-tts 和 冰糖,语气留空。
5. 每一段合成 3 遍,文件名按段落编号,末尾分别加 a、b、c,比如 01-a.wav。
6. 遇到 429 或网络错误,等几秒再重试,最多重试 3 次,还不行就告诉我是哪一段。
先只合成第一段,成功了我再让你合成全部。
再把旁白存成同一个文件夹里的 文案.txt,两段话中间空一行。AI 写好以后,先让它只合成第一段。成功的话,文件夹里会多出一个“声音”文件夹,里面有 01-a.wav、01-b.wav、01-c.wav 三个文件,是同一段话的三遍合成,双击就能播放。确认能出声,再让它合成全部。
出错的时候,把报错信息原样发给 AI,让它自己改。
写完这一步,你会得到一个能反复使用的配音小工具,和第一段旁白的声音。
2.3 第 3 步 选声音,写语气
dub.py 最上面有三个变量,管着模型名、音色和语气。先试音色,把同一段旁白用冰糖、茉莉、苏打、白桦各合成一遍,挑最适合你这条视频的那个。
语气有两种写法,放的位置不同。
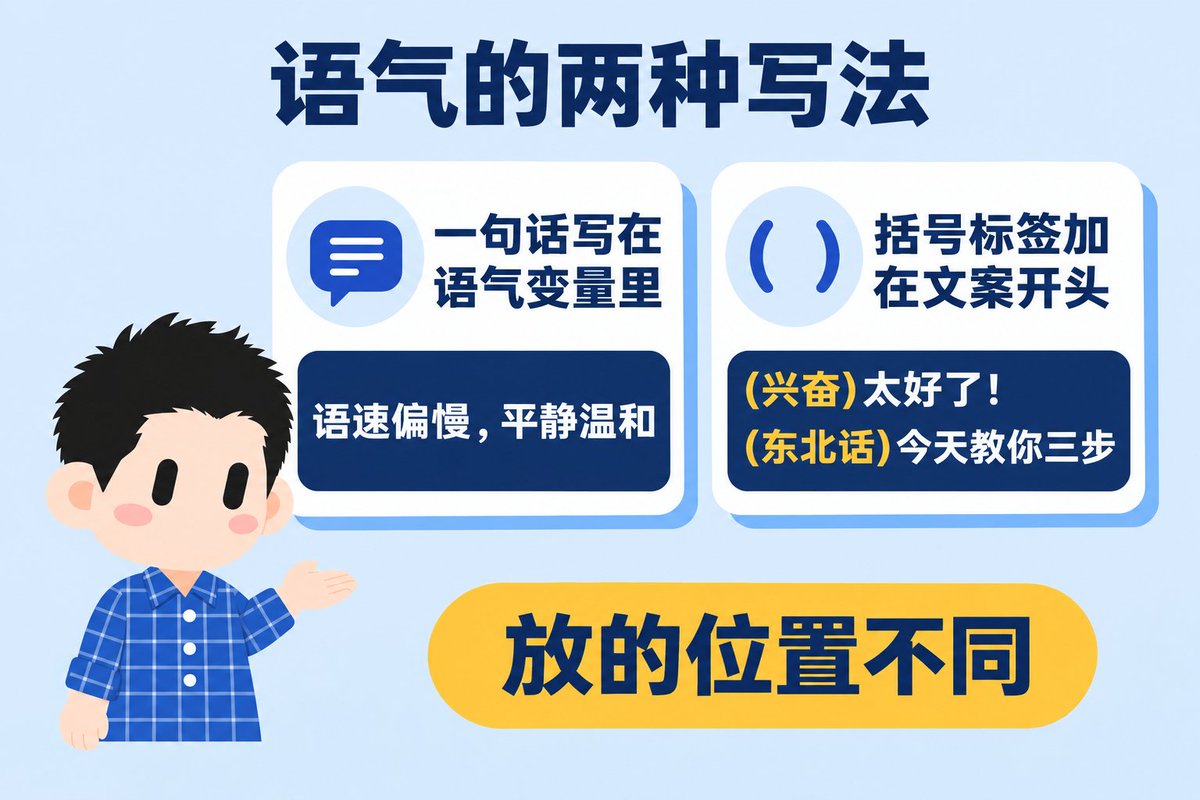
一种是一句话,写在语气变量里,比如“语速偏慢,平静温和,像在耐心地给新手讲解”。另一种是括号标签,直接加在文案开头,比如 (兴奋) 或者 (东北话),官方支持的方言有东北话、四川话、河南话、粤语。
我拿同一段旁白试过。加上“语速偏慢,平静温和”以后,整段话慢了约一成,停顿也多了。换成“语速偏快,兴奋有感染力”,这段平铺直叙的步骤几乎没有变化。语气要配有情绪的句子才用得上。比如“太好了!我的第一条配音视频,终于做出来了!”,加上语气指令,或者在开头加一个 (兴奋) 标签,音调都抬高了一截,这是我用软件量出来的。
想要官方没有的声音,用音色设计型号 mimo-v2.5-tts-voicedesign。它不用选音色名,只要一段对声音的描述,描述写进语气变量。我试过,小工具里只把型号换掉会报错,因为请求里还带着音色名,让 AI 把这一处一起改掉就行。官方的建议是写 1 到 4 句,把性别年龄、声音质感、情绪和语速说清楚,比堆很多要求有用。合成的文案也要和这个声音相配,温柔的声音配晚安独白,不要配激烈的体育解说。
想用自己的声音,用音色复刻型号 mimo-v2.5-tts-voiceclone,再给一段干净的录音当样本,只支持 mp3 和 wav,原文件大约 7 MB 以内。每次合成都要带上这段样本,所以趁免费先录好存好。这个模式同样要让 AI 改一下小工具,把样本一起发出去。
写完这一步,你会得到一份自己的声音设定。把试出来最顺的音色和语气记在文案旁边的一个文本文件里,下一条视频直接照用。
2.4 第 4 步 听一遍,改一遍,再重新合成
同一段话合成三遍,三遍不会一模一样。我把第一段旁白的三遍声音转成文字,和原文对了一下,有几个字对不上,下图黄色的地方就是差别。
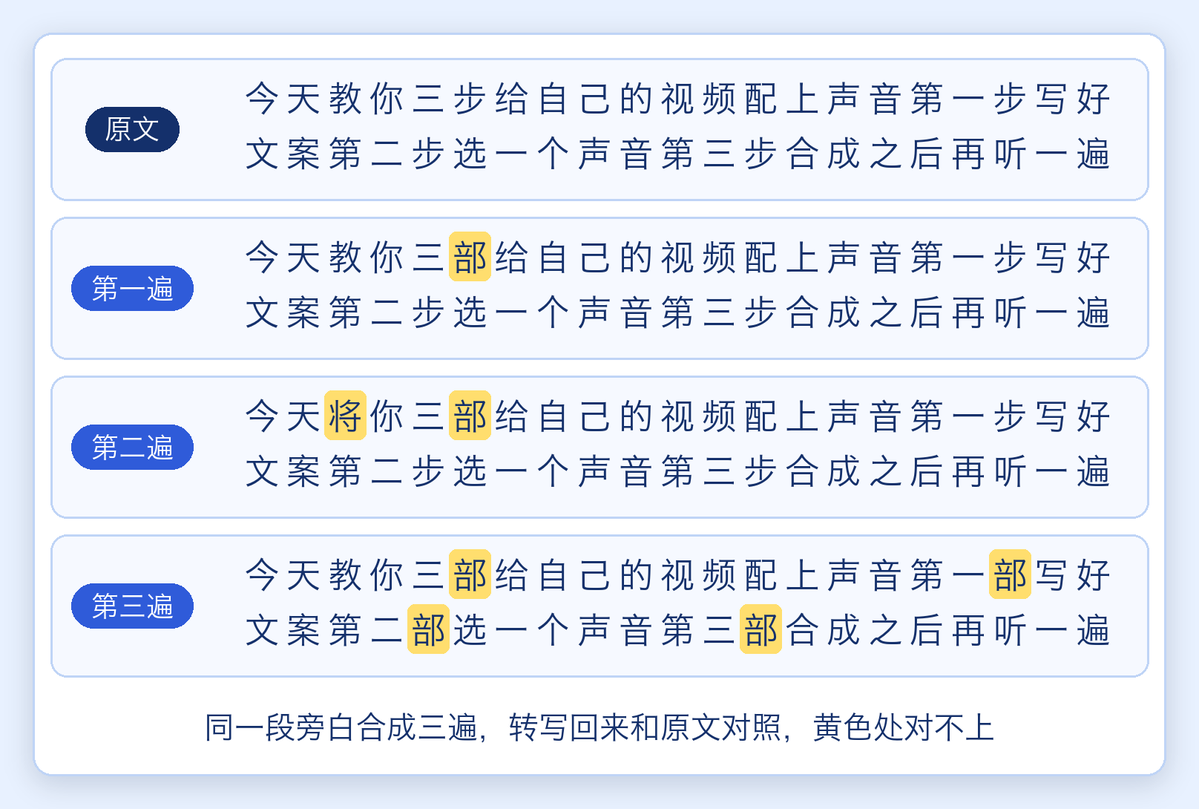
对不上的地方,可能是识别软件把同音字写错了,比如“步”和“部”读音一样,也可能真的读错了。转写只能帮你把可疑的地方找出来,最后还是要自己听一遍。
听的时候重点听数字、人名、英文缩写和多音字。读错的词,换一种更口语的写法再合成,或者把长句拆成两句。三遍里挑最顺的一遍,改个名字存好,其余的删掉。同一条视频的所有句子,用同一个音色和同一句语气,前后才像一个人在讲。
旁白有几十句的时候,逐句听很累。可以让 AI 再写一个小工具,把声音转成文字,自动和原文对一遍,你只听对不上的那几句。官方有一个语音识别型号 mimo-v2.5-asr,价格页写的是每小时 0.5 元,用本机的开源转写工具也行。
写完这一步,你会得到一批挑好的、核对过的声音文件。
2.5 第 5 步 配进视频或数字人
声音文件有三种去处。第一种是剪辑软件,把 wav 文件拖进时间线,起点和画面对上就行。
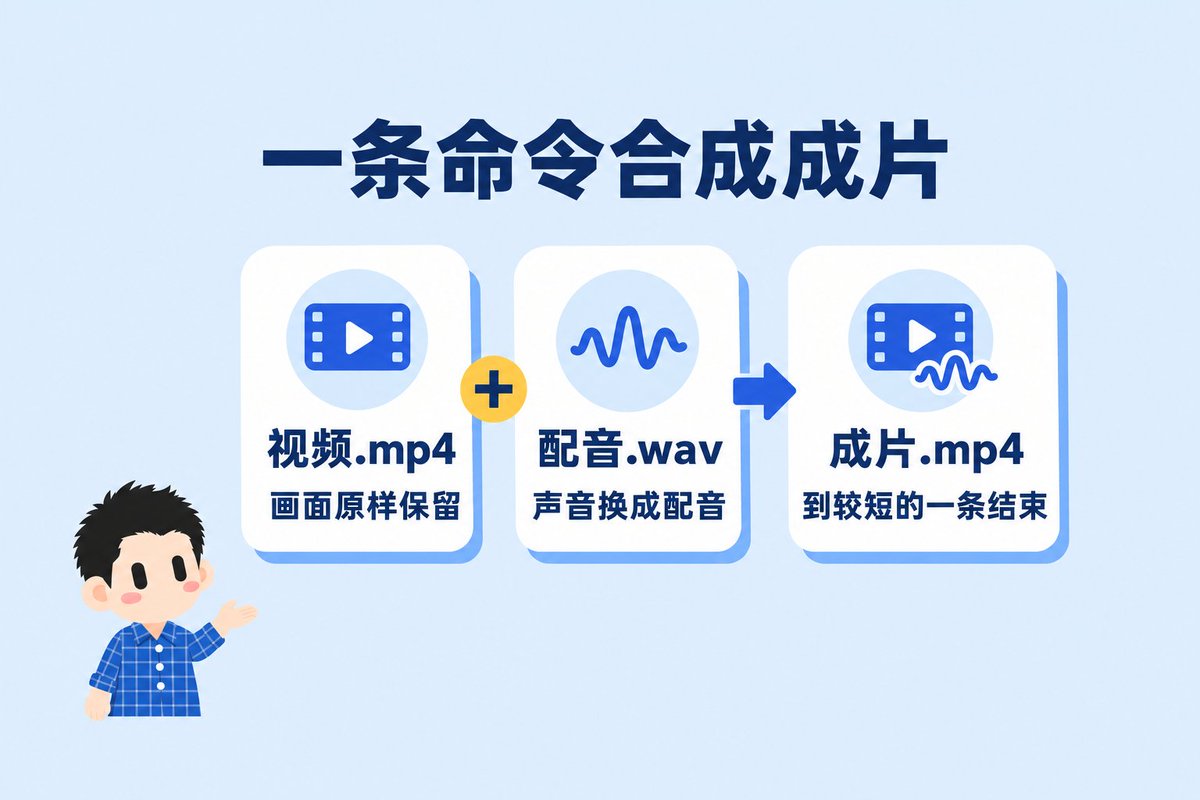
第二种是命令行,用 ffmpeg 一条命令合成,把文件名换成你自己的。
ffmpeg -i 视频.mp4 -i 配音.wav -map 0:v:0 -map 1:a:0 -c:v copy -c:a aac -shortest 成片.mp4
这条命令画面原样保留,原视频里的声音换成配音,成片到画面和声音里较短的一条结束。声音有好几段的时候,先让 AI 按顺序接成一个文件,再合成。
第三种是数字人,把挑好的声音文件交给数字人工具当配音,做法放在常见问题里。
声音有了,剪辑、字幕和特效可以接着交给我开源的视频 Skill,地址是 https://github.com/mileson/chaojifeng-video-content-creator
写完这一步,你会得到一条有声音的视频。
3、常见问题
3.1 效果到底怎么样,值得上手吗
值得试一次。现在不花钱,成本主要是你花的一点时间。我在帖子下面回过一句,这个效果不错,建议试试。能不能用在你的视频上,我的判断是合成之后自己听一遍最准,所以先试,再决定要不要长期用。
3.2 我完全不会写代码,能做吗
能。你要做的只有三件事,拿 Key,把提示词粘给 AI,听结果,代码由 AI 来写。出错的时候,把报错信息原样发给它,让它自己改。
3.3 会一直免费吗
不能当成一直免费。官方只写了限时免费,没有写结束时间。留后路有三个办法。挑好的声音文件自己存好,别每次重新合成。复刻用的样本录音自己存好。模型名只放在 dub.py 最上面的变量里,以后换成同类的模型,先改这一处,第 2 步的提示词已经这样要求了。
3.4 稳定吗,会不会被限流
会有限流,批量合成的时候一段一段排队来,不要同时开很多个。官方写明每个账号有并发上限,服务器忙的时候会变慢,也可能返回 429,所以第 2 步让 AI 加了失败重试。帖子下面有读者说稳定性一般,也有读者说用了很长时间,就是限制并发。我自己的感觉是还好,让 AI 连着合成了一批,都一次成功。
3.5 本地开源的配音工具也能跑,为什么还要用小米的
看你要什么,三条路各有各的用处。
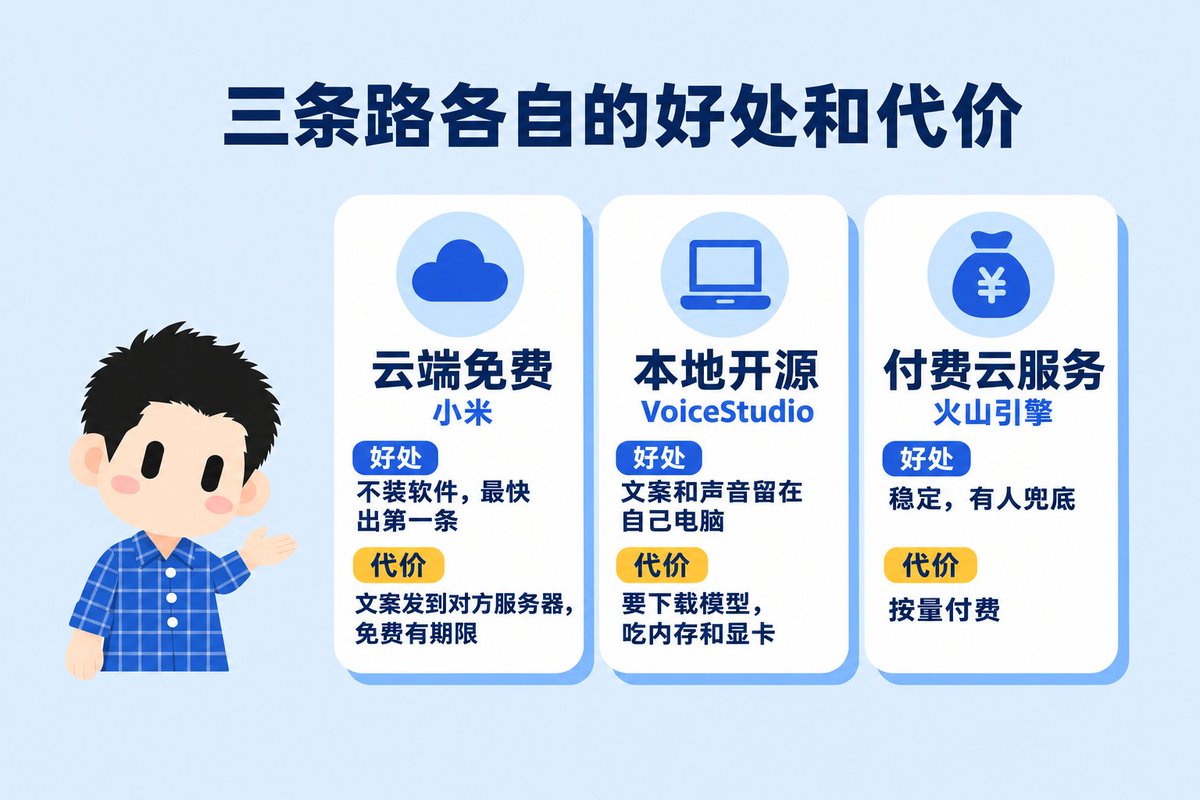
想最快出第一条,又不想装东西,用小米这类云端免费服务。一个 Key 加一个 AI 助手就能开始,代价是文案会发到对方的服务器,免费也有期限。
文案或声音不想离开自己的电脑,或者要长期大批量地做,用本地开源工具。这两周 X 上很热的开源配音工作室 VoiceStudio,在自己电脑上就能克隆声音、设计声音、给视频配音,Mac、Windows、Linux 都有安装包,项目地址是 https://github.com/debpalash/VoiceStudio 。第一次要下载模型,对内存和显卡有要求,电脑配置越好越顺。
要长期稳定,又要有人兜底,用付费云服务。我做外文访谈解读视频时用过火山引擎的声音复刻,按量付费,一期视频估算下来不到 2 块钱,比较稳定。我现在的做法是默认走火山,本机的 Qwen3-TTS 当后备,再多试一个小米的。
3.6 能配数字人吗
能。X 上 @Pluvio9yte 公开过一套数字人的全流程,输入就是一张人物图加一段配音。把第 4 步挑好的声音文件交给数字人工具当配音就行。AI 口播视频从怎么做出来,到每个环节要花多少钱,我之前写过一篇零基础教程,地址是 https://x.com/Mileson07/status/2108820979560649125
3.7 想用自己的声音,要注意什么
最要注意授权,只用你自己的声音,或者有书面授权的声音。官方服务协议要求,你使用的内容要取得相关权利人的授权。样本录一段干净的,只支持 mp3 和 wav,每次合成都要带上它。合成之后找熟悉你声音的人听一遍,像不像,听的人说了才算。
3.8 能商用吗,发布时要标注吗
商用没有查到明确说明,发布合成声音要按规定标注。商用这一条,我在官方文档里没有找到关于合成声音能不能商用的说明,所以商用之前先读一遍服务协议,拿不准就写信问官方,邮箱是 support-mimo@xiaomi.com。标注这一条,服务协议要求你发布或传播 AI 生成合成内容时,按《人工智能生成合成内容标识办法》等规定添加显式和隐式标识,不能删除或隐藏。发到各个平台时,也按平台的 AI 生成内容规则勾选或标注。
如果你身边有人正卡在视频配音这一步,把这篇转给他,他今天就能合成出第一段声音。你最想先给哪条视频配音,是产品介绍、课程讲解,还是数字人口播,在评论区说一句。


