
Agent 高频题 27. Function Calling 的原理:模型怎么决定调哪个工具
文章目录
字节剪映一场 AI 应用开发一面让候选人选一个自己实现的工具,讲清完整调用链路:模型怎么知道这个工具接收哪些参数?模型返回调用请求之后,程序怎么处理?执行结果又怎么返回给模型?小鹏汽车一场端侧 Agent 一面问,模型怎么知道该调用 A 工具还是 B 工具?同一个问题多跑几次,工具调用的先后顺序会不会不一样?
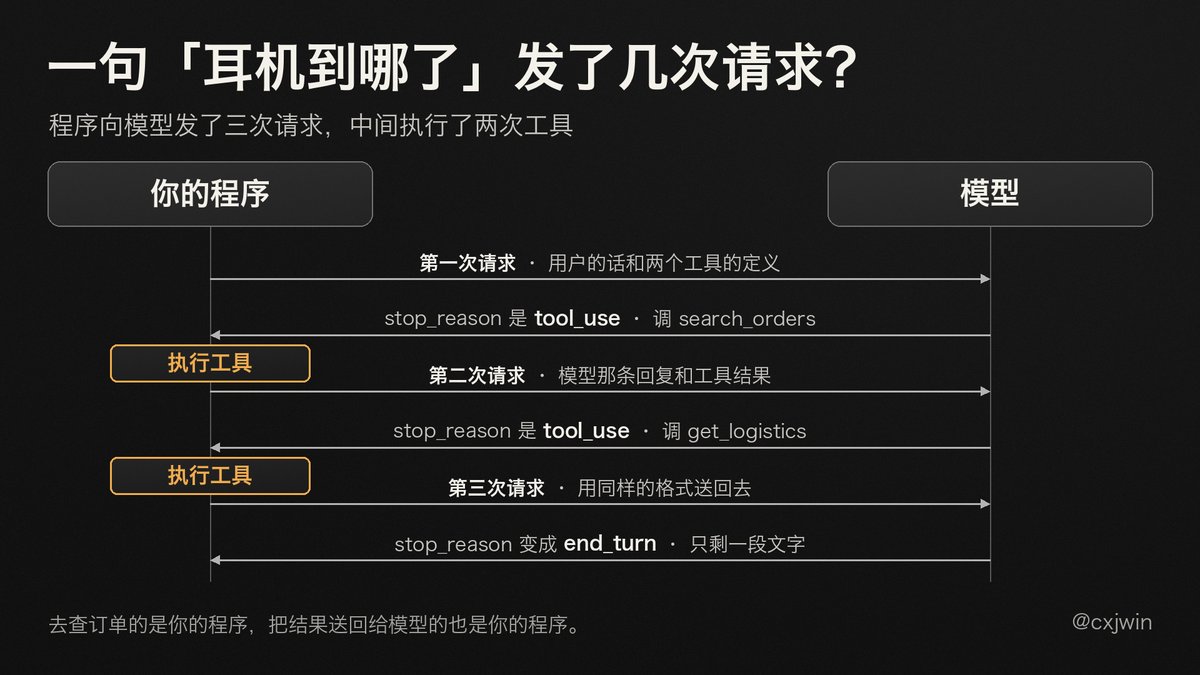
设想一个订单助手,接了两个工具:search_orders 按商品关键词和下单时间找订单,get_logistics 按订单号查物流。用户问「我上周买的耳机到哪了」。模型读完这句话,回了一段固定格式的内容:调 search_orders,关键词填「耳机」,时间填上周。它自己什么都没查。去查订单的是你的程序,把结果送回给模型的也是你的程序。
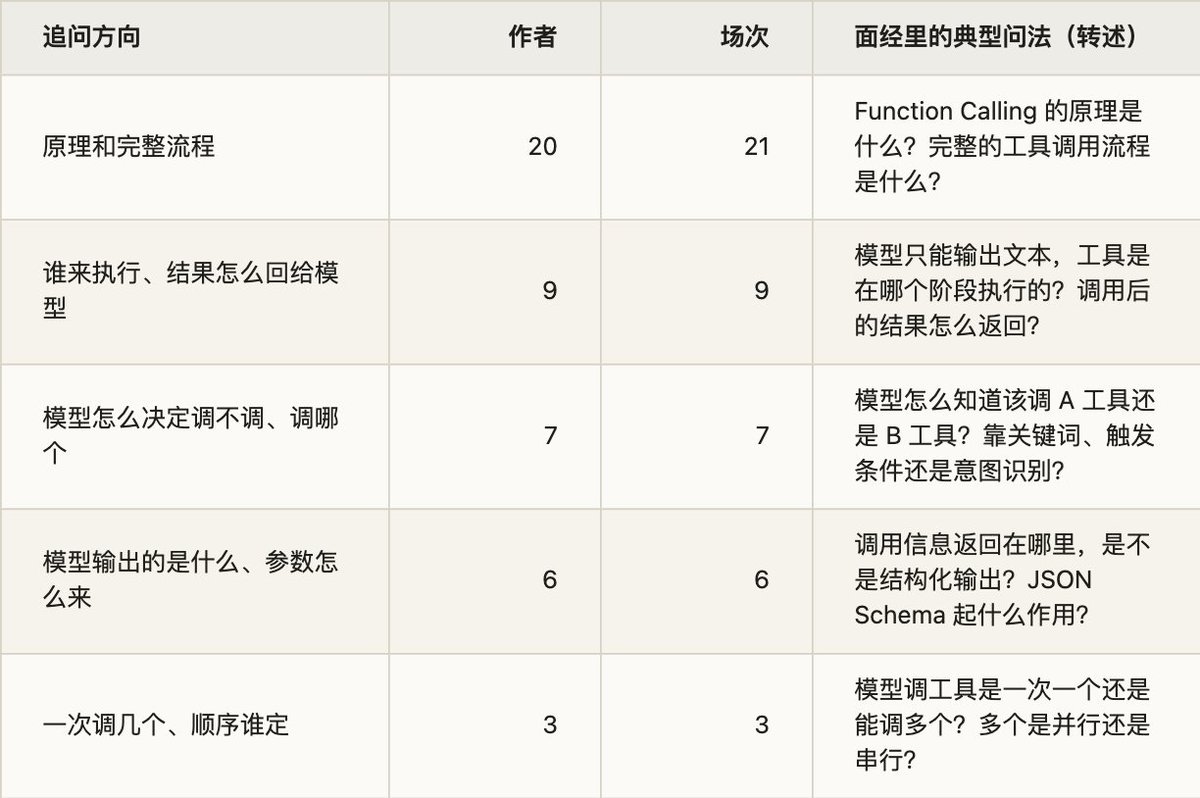
这是 Agent 高频面试题单第 27 题。原题单记了 14 位作者、14 场面试。这次重读了库里留有链接、还能看到正文的 515 篇面经,其中 24 位作者在 26 场面试里遇到了这道题。下表按作者数排序,一场面试可以问到几个方向。
一、「耳机到哪了」这句话,前后发了几次请求
阿里千问一场 Agent 开发二面要候选人简述 Function Calling 工具调用的完整运行原理。B 站一场 AI 应用 Agent 开发一面在一问里问了三层:执行流程是什么,模型怎么判断需要调用工具,对应的参数又是怎么生成的。
Function Calling、Tool Calling、Tool Use 指的是同一件事。OpenAI 的指南开头写着 function calling 也叫 tool calling,Claude 的文档叫 tool use。下面用 Claude 的 Messages API 把订单助手走一遍,只留和工具有关的字段。
第一次请求,程序把用户的话和两个工具的定义一起发给模型。
{
  "system": "你是订单助手。今天是 2026-11-10,星期二。",
  "tools": [
    {
      "name": "search_orders",
      "description": "按商品关键词和下单日期范围查找当前用户的订单,返回订单号、商品名、下单日期和状态。用户没给订单号,只说了买过什么、大概什么时候买的,用这个工具。它不返回物流信息。",
      "input_schema": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string", "description": "商品关键词,比如「耳机」"},
          "start_date": {"type": "string", "description": "下单日期范围的起点,格式 YYYY-MM-DD"},
          "end_date": {"type": "string", "description": "下单日期范围的终点,格式 YYYY-MM-DD"}
        },
        "required": ["keyword"]
      }
    },
    {
      "name": "get_logistics",
      "description": "按订单号查这笔订单的物流状态和包裹最新位置。必须先有订单号,不知道订单号时先用 search_orders 找。",
      "input_schema": {
        "type": "object",
        "properties": {
          "order_id": {"type": "string", "description": "订单号,取自 search_orders 的结果"}
        },
        "required": ["order_id"]
      }
    }
  ],
  "messages": [
    {"role": "user", "content": "我上周买的耳机到哪了"}
  ]
}
模型的回复里,stop_reason 是 tool_use,content 里有两个块。
{
  "role": "assistant",
  "stop_reason": "tool_use",
  "content": [
    {"type": "text", "text": "我先找一下你上周下的耳机订单。"},
    {
      "type": "tool_use",
      "id": "toolu_01",
      "name": "search_orders",
      "input": {"keyword": "耳机", "start_date": "2026-11-02", "end_date": "2026-11-08"}
    }
  ]
}
程序取出 name 和 input,调自己的订单接口,查到一笔订单。第二次请求在原来的消息后面接两条:模型刚才那条回复原样带上,再加一条装着工具结果的消息。
{
  "role": "user",
  "content": [
    {
      "type": "tool_result",
      "tool_use_id": "toolu_01",
      "content": "[{\"order_id\": \"E1105001\", \"item\": \"蓝牙耳机\", \"ordered_at\": \"2026-11-05\", \"status\": \"已发货\"}]"
    }
  ]
}
模型拿到订单号,回的又是一个 tool_use,这次调 get_logistics,order_id 填 E1105001。程序查完物流,用同样的格式送回去。第三次请求之后,模型不再要工具,stop_reason 变成 end_turn,content 里只剩一段文字,告诉用户包裹到了哪里。
一句「耳机到哪了」,程序向模型发了三次请求,中间执行了两次工具。OpenAI 的指南把一次调用写成五步:带着工具发请求,收到工具调用,在应用这边执行,带着工具输出再发请求,收到最终回答或者更多的工具调用。两家的字段名不一样。OpenAI 的 Responses API 用 parameters 放参数说明,调用是输出里的 function_call 条目,参数 arguments 是一段 JSON 字符串,结果用 function_call_output 按 call_id 送回。这个循环怎么写、怎么停,第 9 题讲过。
二、工具定义去了哪里
字节剪映那场的第一小问是,模型怎么知道工具接收哪些参数。启云方一场 AI Agent 一面问,工具调用要不要提前注册,要定义哪些信息。
要提前给,每个工具三样东西:名字、一段给模型看的描述、一份用 JSON Schema 写的参数说明,里面写明每个参数叫什么、什么类型、哪些必填、有哪些可选值。模型看不到 search_orders 的代码。Claude 文档的说法是,模型收到的只有你提供的 schema 和你返回的结果。
这些定义进了模型的输入,和提示词在一起。Claude 文档写着,请求带了 tools 参数时,API 会用工具定义、工具配置和你自己写的系统提示词拼出一段专门的系统提示词。文档贴了模板:开头告诉模型这个环境里有一组工具可用,接着是格式说明和 JSON Schema 格式的工具定义,然后才是你的系统提示词。OpenAI 的指南说法接近:函数会按模型训练时见过的语法注入系统消息。
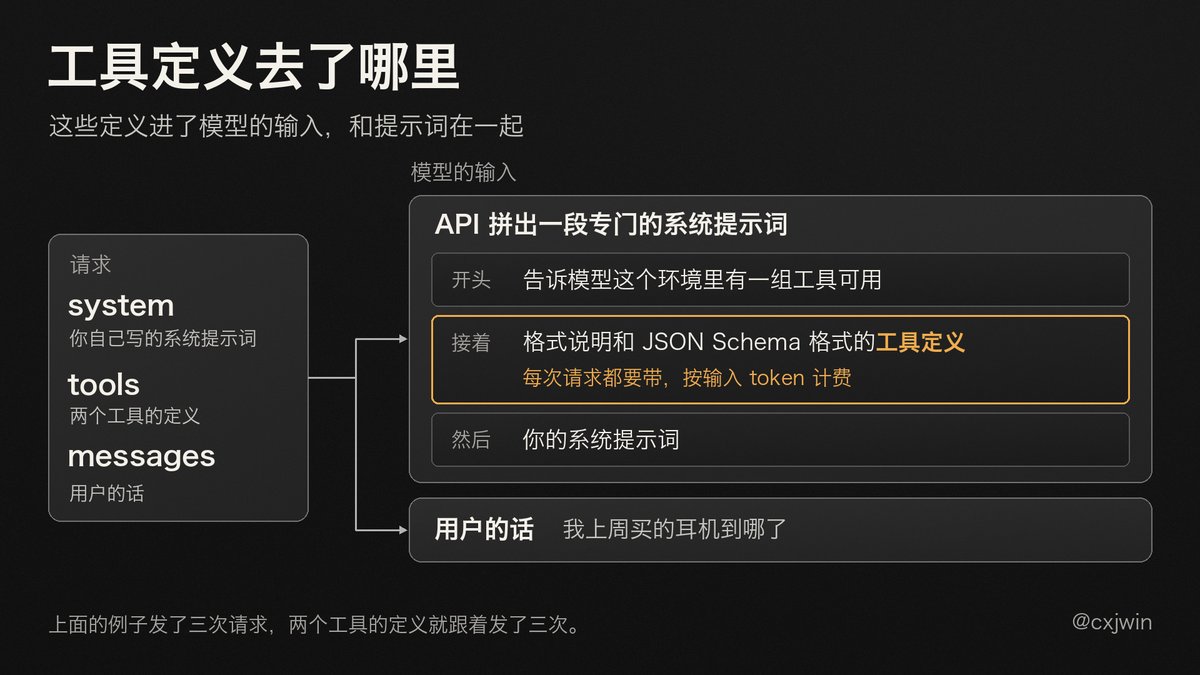
所以工具定义占上下文长度,按输入 token 计费,而且每次请求都要带。上面的例子发了三次请求,两个工具的定义就跟着发了三次。Claude 文档另有一张表:只要带了工具,API 还会加一段启用工具的系统提示词,Opus 5.5 是 286 个 token,工具定义本身另算。工具多了怎么筛是第 24 题的内容,重复发送的部分怎么用缓存省钱,第 12 题讲过。
MCP 接进来的工具走的是同一条路。第 18 题讲过,Host 把 tools/list 取到的定义转成模型接口接受的格式,和你自己写的工具一起放进 tools。到了模型那里,两种工具没有区别。
三、模型凭什么先调找订单的那个
小鹏那场问的是,模型怎么知道该调 A 工具还是 B 工具。蚂蚁一场 AI-Agent 开发一面、快手一场电商后端实习一面、字节抖音电商一场客户端一面,也都问到模型怎么确定调哪个工具。启云方那场给了三个选项:靠关键词,靠触发条件,还是靠意图识别?
三样都不是单独的一步。工具定义和用户的话在同一份输入里,模型接着这份输入往下生成,出来的可以是一段回答,也可以是一个工具调用。调不调、调哪个、参数填什么,和写一句回答是同一个生成过程。两家的文档讲到这一步,都只说由模型判断,没有提到关键词表或者另一个意图分类器。在模型前面自己加一层路由、先筛掉一部分工具是可以的,那是程序的设计,第 17 题和第 24 题讲。
这个能力是训练出来的。第 7 题引过 OpenAI 2023 年 6 月的公告:模型为此做过微调,学的是判断什么时候该调函数,以及按函数签名输出 JSON。Hugging Face 的文档现在写的是,对话模型普遍在训练时就支持了工具调用。Claude 文档提到,bash、文本编辑器这几个由 Anthropic 定义的工具,模型在几千条成功使用它们的轨迹上优化过,调起来比功能相同的自定义工具更可靠。
回到例子。模型在输入里读到这几样:用户的话里有「耳机」和「上周」,没有订单号;get_logistics 的 order_id 必填,描述里写着没有订单号先用 search_orders;search_orders 的描述写着用户没给订单号时用它。照这份输入往下写,写出来的就是 search_orders 的调用。
Claude 文档对默认行为的描述是:请求对得上某个工具描述的能力,答案又不在上下文里,模型就调工具;稳定的知识、创作类任务和闲聊,它直接回答。用户问「降噪耳机是什么原理」,助手可以直接答。这条界线能用系统提示词挪动,比如加一句让它回答前先用工具查清楚,模型调工具会更积极。
影响选择的是四样东西:工具名、描述、参数说明、对话内容。Claude 文档把描述排在第一位,建议写清工具做什么、什么时候该用、什么时候不该用、每个参数的含义,每个工具至少三四句。Hugging Face 的文档说,函数体里的代码模型看不到,起作用的是函数名、参数名、参数类型和说明文字。假如两个工具的描述都只写「查询订单信息」,模型只能靠工具名和参数名猜,可能直接调 get_logistics,再编一个订单号填进去。调错了怎么查,第 11 题讲过。
四、模型输出的到底是什么
启云方那场追到了字段:工具调用如果是结构化输出,体现在哪,是不是约定好的 JSON 格式和固定字段?模型返回的文本和工具调用信息是什么关系,是不是两个独立的数据块?
第一节那份回复可以直接回答。调用信息在 content 数组里,是一个 type 为 tool_use 的块,固定三个字段:id 用来和后面的结果配对,name 是工具名,input 是一个 JSON 对象。文字在另一个 type 为 text 的块里。两个块并排放在同一条回复里,也可以只出现其中一个。Claude 文档提醒,这段文字的措辞不固定,程序不要依赖它的格式。要不要执行工具,看 stop_reason 和 tool_use 块。
斑头雁一场 Agent 实习一面问,模型输出什么内容,让本地的 Agent 去执行工具?模型只会一个 token 一个 token 地往外写,写出来的是文本。字段是推理服务从这段文本里解析出来的。开源模型上能直接看到这一层。Hugging Face 文档的例子里,工具列表传给对话模板(chat template,把消息列表拼成模型实际读到的文本的那套规则),模板把工具定义写进提示词。例子用的 Hermes-2-Pro-Llama-3-8B 要调工具时,生成的原始文本是:
<tool_call>
{"arguments": {"location": "Paris, France", "unit": "celsius"}, "name": "get_current_temperature"}
</tool_call>
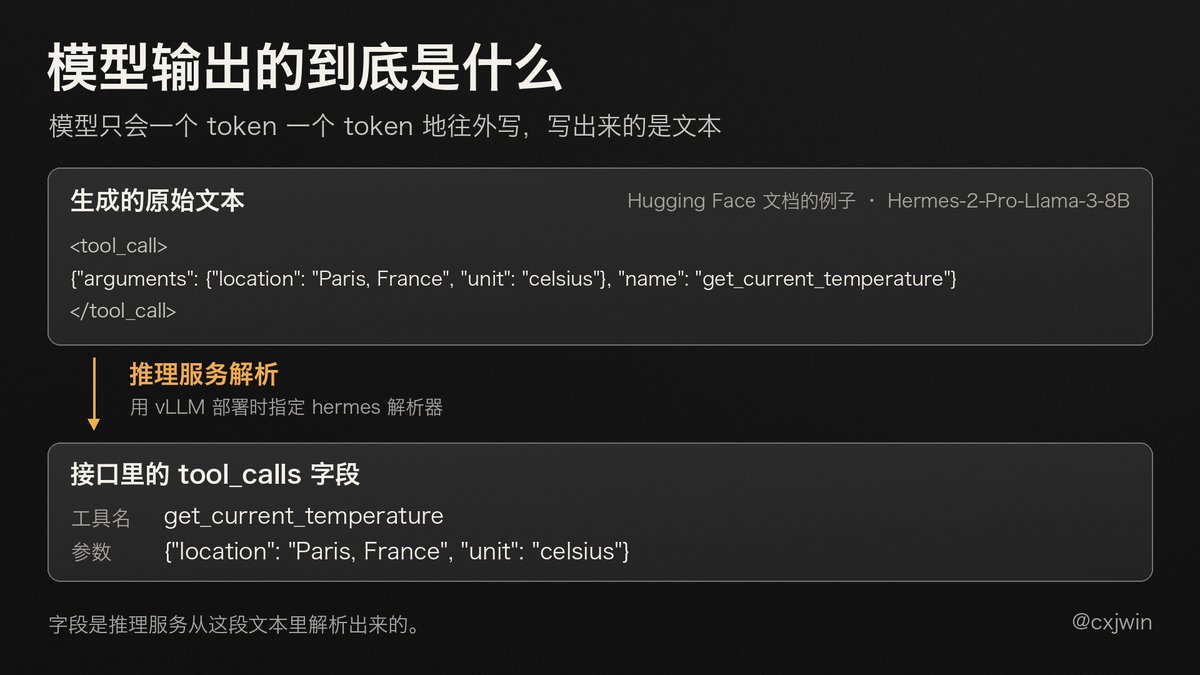
一对标记,中间一段 JSON。Qwen 的文档说,Qwen3 的对话模板已经支持这种 Hermes 风格的工具调用,用 vLLM 部署时指定 hermes 解析器,服务会把这段文本解析成接口里的 tool_calls 字段。vLLM 的文档写了这样做的局限:没有加约束时,工具调用是从原始文本里提取的,参数偶尔会格式不对,或者不符合参数 schema。
托管的 API 把这一层包起来了。Claude 文档贴出的那段系统提示词模板里,有一句写给模型的话,意思是输出不要求是合法的 XML,会用正则表达式解析。启云方那场问过,模型是不是先返回一段普通文本、再用正则解析出工具调用(第 7 题引过)。按这份模板,解析这一步是有的,只是在服务端,你拿到手的已经是字段。
百度一场后端开发一面问,JSON Schema 起什么作用。有三个用处。给模型看:它是输入的一部分,告诉模型有哪些参数、怎么填。给推理服务用:工具定义上加 strict: true,推理时按 schema 约束采样,input 一定符合 schema,工具名也一定在清单里,OpenAI 有同名的开关。给你的程序用:执行前拿它校验收到的参数。不开严格模式,符合 schema 只是尽力而为,Claude 文档举的例子是该给整数 2 的地方给了字符串 "2",或者漏掉必填字段。严格模式保证的是形状:order_id 一定是字符串,这个订单号是不是真的存在,它不管。约束解码的细节在第 22 题。
参数的值从哪来?B 站那场 AI 应用 Agent 开发一面问到了这一层。keyword 取自用户说的「耳机」。「上周」要换算成日期,靠的是系统提示词里那句今天是 11 月 10 日。第二次调用的 order_id 是从上一条工具结果里抄的。上下文里没有的值,模型只能猜。是谁在查不用模型填,两个工具都没有「用户 ID」这个参数,程序从登录态里取。
没有原生 Function Calling 的模型也能调工具,要自己补上这一层:工具说明写进提示词,约定一种输出格式,自己解析。Qwen 的文档写着,Function Calling 本质上是靠提示词工程实现的,即使提示词和模板都对,也不保证模型每次都按约定输出,生产代码要备好补救。
五、谁来执行,结果怎么回给模型
恒生电子一场 AI 应用开发岗的 AI 面试里有一问:模型本身无法执行函数,那它在整个机制里起什么作用?千问一场 AI 研发一面问,模型生成工具调用的 JSON 之后,代码层做什么?
模型做的是判断:要不要调,调哪个,参数填什么。结果回来以后,再决定接着调还是写回答。Claude 文档的说法是,模型自己从不运行任何东西,它发出一个结构化的请求,由你的代码去执行。程序拿到回复以后做四件事。
-
看 stop_reason,是 tool_use 才往下走。流式时参数只收到一半不能执行,第 16 题讲过。
-
取出每个 tool_use 块的 id、name、input,按 name 找到对应的函数。
-
校验参数,确认当前用户有权查这笔订单,然后执行。超时和重试也在这一步,第 11 题讲过。
-
把结果包成 tool_result,带上对应的 tool_use_id,连同原来的消息和模型那条回复,再发一次请求。
工具结果必须紧跟在对应的调用后面,中间不能插别的消息。有调用没结果,请求会报错。
虾皮一场 Agent 开发一面问,工具返回结果时消息结构怎么设计,为什么要单独设计 Tool Message?一个原因是配对。模型一次可能发出几个调用,结果靠 ID 才对得上。Claude 把结果放进 user 消息里的 tool_result 块,按 tool_use_id 对。OpenAI 兼容的对话接口用一条 role 为 tool 的消息,按 tool_call_id 对。另一个原因是标明来路:这是工具返回的数据,不是用户说的话。Claude 文档建议,网页、邮件、第三方接口这类不受你控制的内容留在 tool_result 块里,别放进系统提示词或普通的用户文本,因为里面可能藏着想指挥模型的指令。怎么防注入是第 20 题的内容。
结果里写什么由你的程序决定,模型只看得到你返回的内容。字节剪映那场接着拿读文件工具追问:文件有 1 万行,工具每次最多读 2500 行,返回的具体结果是什么?模型怎么知道还没读完?换到订单助手上是同一个问题。上周买了两副耳机,search_orders 就把两笔都返回,模型才有依据去问用户指的是哪一副。命中 37 笔、只返回了前 10 笔,就在结果里写明总数和怎么取下一页。
有一类工具不由你执行。Claude 的网页搜索、网页抓取、代码执行和工具搜索由 Anthropic 的服务器运行,你不用自己构造 tool_result,回复里的 server_tool_use 块会显示跑了什么。OpenAI 也有网页搜索、代码运行这类内置工具。模型照样只发请求。
第 18 题有一句:日志记的如果是模型的回复,只能确定模型选了工具。这里一样,订单接口到底调没调,看程序的执行记录。
六、一次调几个,顺序谁定
拼多多一场 Agent 一面问,模型调用工具是一次一个,还是能调多个?多个的话是并行还是串行?
能调多个。Claude 文档写的是,默认情况下模型可以在一次回复里调用多个工具。OpenAI 的指南说回复里可能有零个、一个或多个调用,处理逻辑最好按有多个来写。用户要是问「耳机和键盘都到哪了」,模型可以在一条回复里放两个 search_orders 的调用块。
这里的「并行」有两层。模型一次发出几个调用,是模型定的。这几个调用同时跑还是挨个跑,是程序定的,API 不规定执行顺序。两次只读的订单查询可以同时跑。跑完以后,每个调用各回一个 tool_result,放在同一条消息里一起送回。有写操作、有先后依赖时怎么排,第 11 题讲过。
找订单和查物流有先后。查物流要订单号,订单号等第一个工具的结果回来才有,正常的走法是两轮。万一模型把有依赖的两个调用放进了同一批,后一个缺订单号、执行不了。Claude 文档对没有执行的调用的要求是,照样回一个 tool_result,带上 is_error: true 和一句说明,模型下一轮可以重新发起。
小鹏那场的第二问是,同一个问题多跑几次,调用顺序会不会不一样。会。Claude 文档的术语表写着,即使 temperature 设成 0,结果也不是完全确定的,相同的输入可能得到不同的输出。耳机的例子里,顺序被订单号这层依赖定住了。换成查订单和查优惠券这样互不依赖的两个工具,先后可能变,也可能在一条回复里一起发出来。那场的下一问是为什么不用固定的代码 workflow。顺序必须固定的流程写进代码更稳,怎么选在第 23 题。
恒生电子那场还问,用户的需求要连续调几个不同的工具时,模型在多轮调用里做什么。每一轮它都读一遍完整的历史,包括前面每个工具的结果,再给出下一个调用或者回答。循环由程序来跑:stop_reason 是 tool_use 就继续,不是就停。停不下来怎么办是第 28 题的内容。
程序还有几个开关能管住模型的选择。面经里没有人问到这几项,下面按两家的文档列出来。
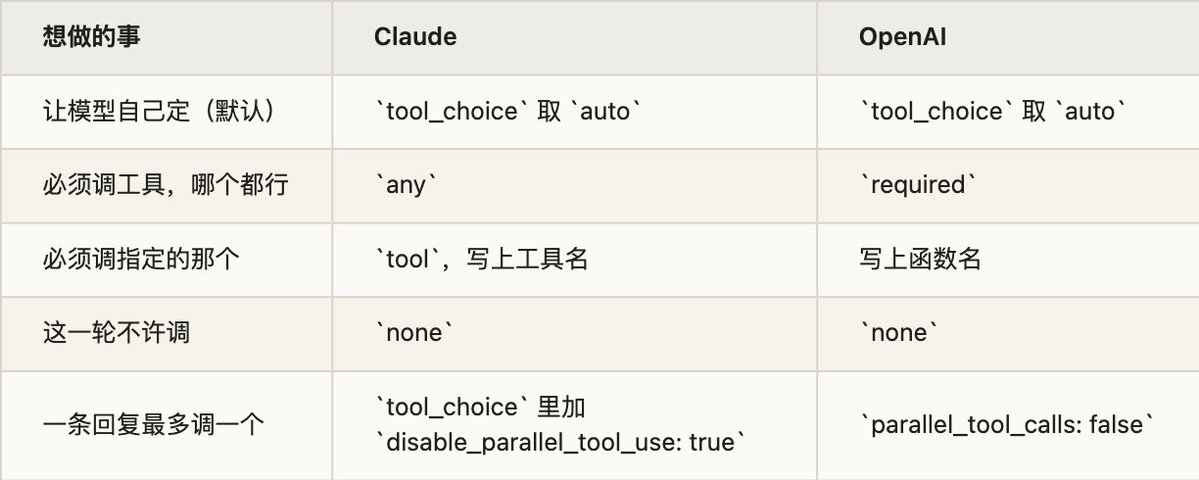
用强制调用之前,先知道两件事。取 any 或 tool 时,Claude 的 API 会替模型预先写好回复的开头来逼出工具调用,tool_use 前面不会再有一句解释。另外不是每款模型都支持:文档列了 Opus 5.5、Sonnet 5.5 等几款较新的模型,这两个取值会返回 400 错误,建议改用 auto 加严格模式,或者用结构化输出。
七、面试怎么答
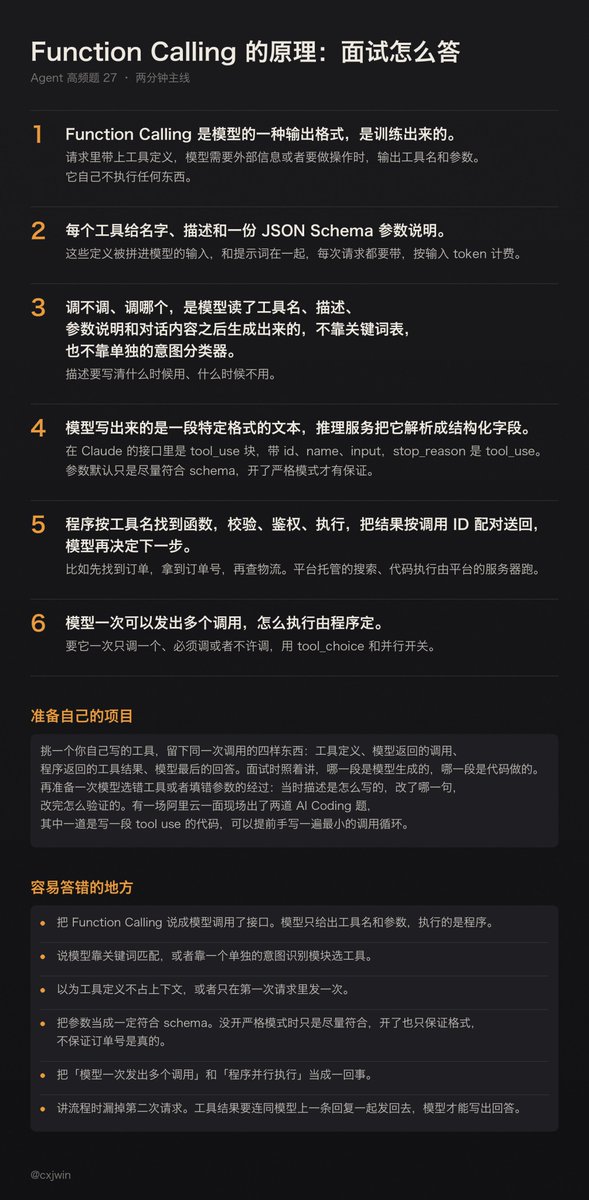
两分钟主线
-
Function Calling 是模型的一种输出格式,是训练出来的。请求里带上工具定义,模型需要外部信息或者要做操作时,输出工具名和参数。它自己不执行任何东西。
-
每个工具给名字、描述和一份 JSON Schema 参数说明。这些定义被拼进模型的输入,和提示词在一起,每次请求都要带,按输入 token 计费。
-
调不调、调哪个,是模型读了工具名、描述、参数说明和对话内容之后生成出来的,不靠关键词表,也不靠单独的意图分类器。描述要写清什么时候用、什么时候不用。
-
模型写出来的是一段特定格式的文本,推理服务把它解析成结构化字段。在 Claude 的接口里是 tool_use 块,带 id、name、input,stop_reason 是 tool_use。参数默认只是尽量符合 schema,开了严格模式才有保证。
-
程序按工具名找到函数,校验、鉴权、执行,把结果按调用 ID 配对送回,模型再决定下一步。比如先找到订单,拿到订单号,再查物流。平台托管的搜索、代码执行由平台的服务器跑。
-
模型一次可以发出多个调用,怎么执行由程序定。要它一次只调一个、必须调或者不许调,用 tool_choice 和并行开关。
准备自己的项目
挑一个你自己写的工具,留下同一次调用的四样东西:工具定义、模型返回的调用、程序返回的工具结果、模型最后的回答。面试时照着讲,哪一段是模型生成的,哪一段是代码做的。再准备一次模型选错工具或者填错参数的经过:当时描述是怎么写的,改了哪一句,改完怎么验证的。有一场阿里云一面现场出了两道 AI Coding 题,其中一道是写一段 tool use 的代码,可以提前手写一遍最小的调用循环。
容易答错的地方
-
把 Function Calling 说成模型调用了接口。模型只给出工具名和参数,执行的是程序。
-
说模型靠关键词匹配,或者靠一个单独的意图识别模块选工具。
-
以为工具定义不占上下文,或者只在第一次请求里发一次。
-
把参数当成一定符合 schema。没开严格模式时只是尽量符合,开了也只保证格式,不保证订单号是真的。
-
把「模型一次发出多个调用」和「程序并行执行」当成一回事。
-
讲流程时漏掉第二次请求。工具结果要连同模型上一条回复一起发回去,模型才能写出回答。
出处
面经按发帖人记述转述。原题单和本次复核的样本范围、收录条件有差别。
-
原理和完整流程:B 站 AI 应用 Agent 开发一面 · 快手大模型应用 Java 实习一面 · 面经-8 · B 站测开一面 · 百度广告投放大模型研发二面 · 小厂全栈面经(偏前端) · 蚂蚁 AI-Agent 开发一面 · 启云方 AI Agent 一面 · 小鹏汽车端侧 Agent 一面 · 字节 Agent 开发一面 · 字节抖音电商客户端一面 · 斑头雁 Agent 实习一面 · 千问 AI 研发一面 · 阿里千问二面(9.22) · 百度后端开发一面 · 字节剪映 AI 应用开发一面 · 恒生电子 AI 应用开发岗 AI 面试 · 宏图智能一面 · 阿里千问 Agent 开发二面 · 字节抖音开放平台一面(内部跨转) · 网易 Agent 开发一面。
-
谁来执行、结果怎么回给模型:虾皮 Agent 开发一面 · 启云方 AI Agent 一面 · 字节抖音电商客户端一面 · 斑头雁 Agent 实习一面 · 千问 AI 研发一面 · 阿里千问二面(9.22) · 字节剪映 AI 应用开发一面 · 恒生电子 AI 应用开发岗 AI 面试 · 老虎国际后端实习一二面。
-
模型怎么决定调不调、调哪个:B 站 AI 应用 Agent 开发一面 · 百度广告投放大模型研发二面 · 蚂蚁 AI-Agent 开发一面 · 启云方 AI Agent 一面 · 快手电商后端实习一面 · 小鹏汽车端侧 Agent 一面 · 字节抖音电商客户端一面。
-
模型输出的是什么、参数怎么来:B 站 AI 应用 Agent 开发一面 · 启云方 AI Agent 一面 · 韶音 AI 应用开发一面 · 斑头雁 Agent 实习一面 · 百度后端开发一面 · 字节剪映 AI 应用开发一面。
-
一次调几个、顺序谁定:小鹏汽车端侧 Agent 一面 · 拼多多 Agent 一面 · 恒生电子 AI 应用开发岗 AI 面试。
外部资料按用途分组,文档页面是 2026-11-11 读到的版本。
-
调用流程、工具定义怎样进系统提示词、tool_use 和 tool_result 的格式、token 计费表。Anthropic How tool use works · Define tools · Handle tool calls · Tool use overview。
-
一次多个调用、强制调用、严格模式和输出的不确定性。Anthropic Parallel tool use · Strict tool use · Glossary。
-
OpenAI 的五步流程、函数定义计入输入 token、tool_choice、parallel_tool_calls 和 strict。Function calling 指南 · Function calling and other API updates(2023-06-13,沿用第 7 题的引用)。
-
开源模型的对话模板、调用标记和服务端解析。Hugging Face Tool use · Qwen Function Calling · vLLM Tool Calling。


