
我手执 Gemini 修文物:复原已故计算机科学家的失传代码
文章目录
事情是这样的。
我在开发 ScopeDB 的时候,很自然地遇到了要支持近似不重复计数的需求,也就是实现 approx_count_distinct 函数。
这个函数典型的实现方式,就是使用 HyperLogLog 数据结构。由于 Rust 生态当年的 HLL 实现参差不齐,起初经过一番调研,我选择了 Cloudflare 开源的 cardinality-estimator 库。但是,这个库包含了不少 unsafe 代码,并且还引入了各种手工位打包的奇技淫巧。为了代码可控,我不得不在 ScopeDB 里单独 Fork 并维护一份内部版本。
在调研期间,我了解到 Apache DataSketches 有一套久经考验的 HllSketch 实现,以及号称效果更好的 CpcSketch 方案。可惜,当时的 DataSketches 项目只有 Java 和 C++ 实现,而 ScopeDB 是 Rust 写的。
好在机缘巧合,我确认了 DataSketches 上游对维护一个 Rust 版本有兴趣。从去年底开始,我跟其他几位对草图算法颇有研究的 Rust 开发者一起开发发布了若干个 datasketches-rust 的版本,其中就包括 HllSketch 的第一版实现。随后,我把 ScopeDB 近似计数的实现切换到了 datasketches-rust 实现的 HllSketch 上。
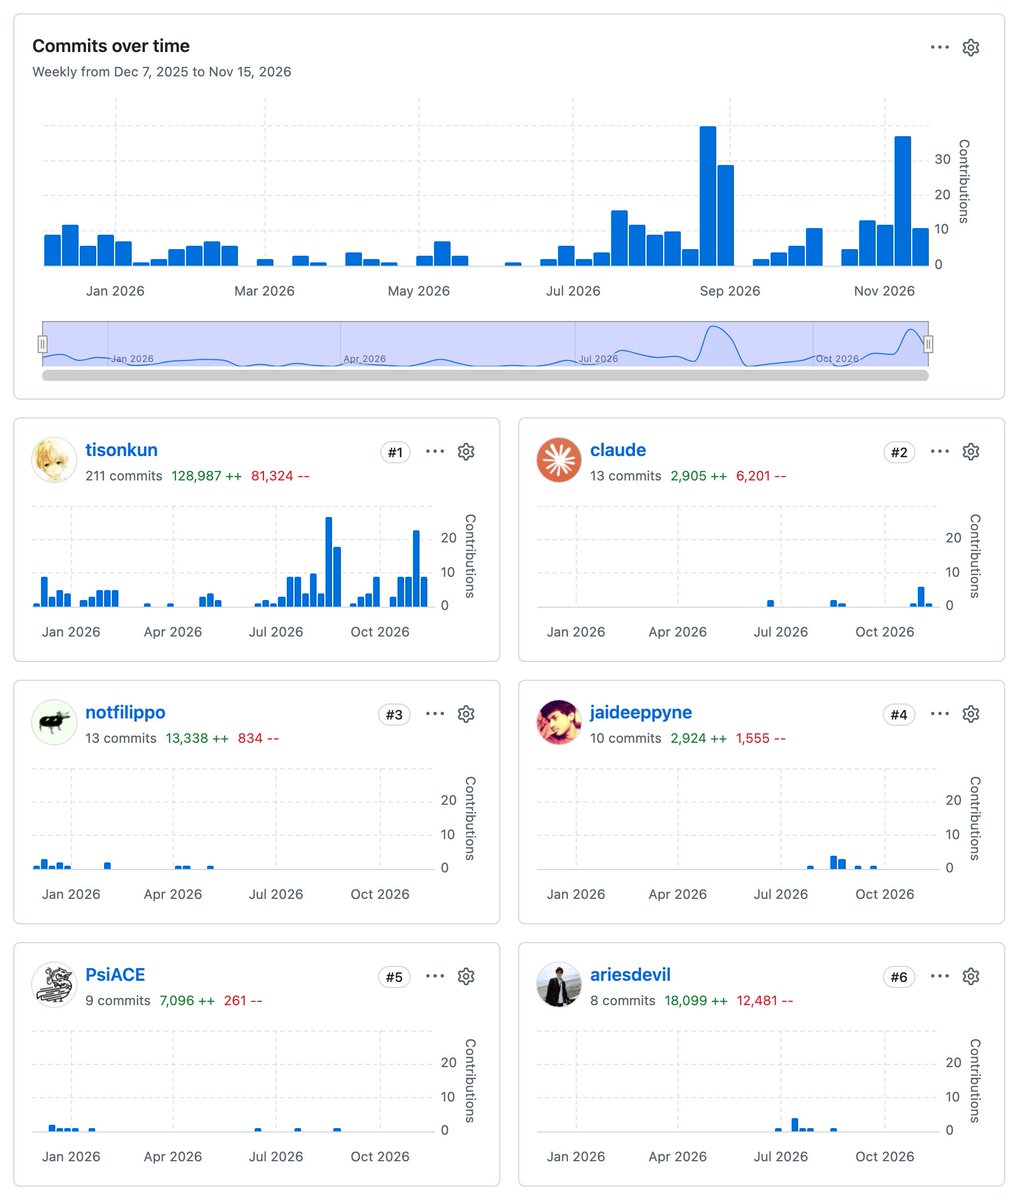
Apache DataSketches Rust Contributors
实现过流式不重复计数算法的开发者大多熟悉 HLL 的原理:它将元素哈希后投进 K 个桶里,每个桶只记录见过的最大前导零个数,通常占用 4 到 6 个比特。这样一来,同一个桶里除最大值以外的其余命中记录都会被直接丢弃,而且进入稠密模式后,每个桶都要维持固定位宽的寄存器。
Yahoo! Research 的计算机科学家 Kevin J. Lang 在 2017 年发表了论文 Back to the Future: an Even More Nearly Optimal Cardinality Estimation Algorithm 并在其中提出了一个返璞归真的方案:不再只取每桶最大值,而是直接保留经典 FM85 优惠券收集过程中的 K × 64 位矩阵,每当第 r 行遇到一个前导零数为 c 的哈希值,就把矩阵第 r 行第 c 列置为 1 来记录这次命中。保留完整的二维命中记录,让 CPC 能配合流式的 HIP 估计器和可合并的 ICON 估计器拿到比 HLL 更高的统计效率;在序列化时,它又会根据填充密度自适应切换格式,低基数时直接用稀疏的 PairTable 记录行列坐标对,中高基数则结合滑动 8-bit 窗口、长度受限的 Huffman 编码以及列置换把体积压到接近信息熵。按 DataSketches 官方文档的说法,在同等精度下,序列化后的 CPC 比 HLL 缩小了 30% 到 40% 的体积。
今年 1 月底,我通过 PR-75 动手把 CpcSketch 移植到了 datasketches-rust 项目里,随后将 ScopeDB 近似计数的实现也切到了 CpcSketch 上。半年多来,线上相关功能一直运行得很稳。
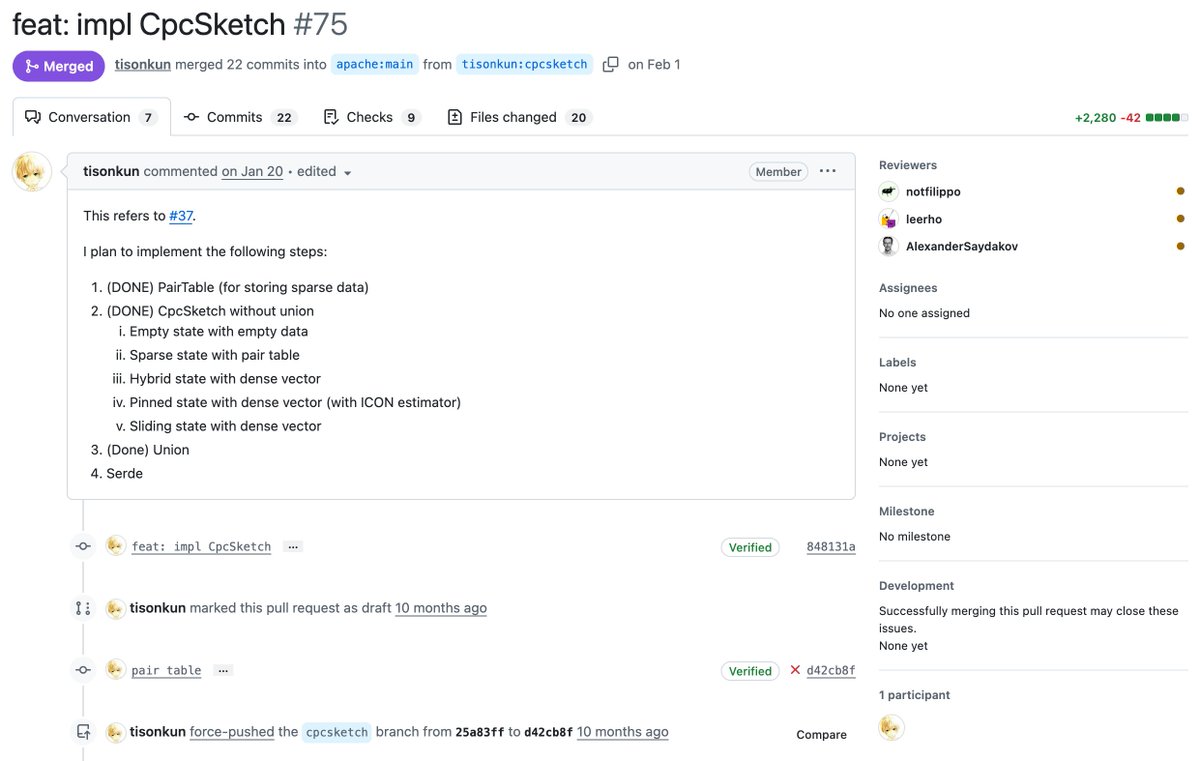
https://github.com/apache/datasketches-rust/pull/75
不过,在对照上游 C++ 和 Java 源码移植 CpcSketch 的时候,我发现源码里存在着一系列硬编码的魔数表:
-
23 张静态 Huffman 编码表;
-
16 张滑动窗口列置换表;
-
23 组 19 阶多项式修正系数;
-
4 张置信区间经验分位数表。
具体来说,这四类静态表分别写在 compression_data.rs 和 estimator.rs 两个文件里,截取几行大概长这样:
// datasketches/src/cpc/compression_data.rs
pub static LENGTH_LIMITED_UNARY_ENCODING_TABLE65: [u16; 65] = [
    // entropy:    2.0
    // avg_length: 2.0249023437500000000; max_length = 12; num_symbols = 65
    0x1000, 0x2001, 0x3003, 0x4007, // ...
];
pub static COLUMN_PERMUTATIONS_FOR_ENCODING: [[u8; 56]; 16] = [
    [0, 1, 2, 3, 5, 6, 7, 8, /* ... */ 54, 55, 34, 14, 4],
    // ...
];
pub static ENCODING_TABLES_FOR_HIGH_ENTROPY_BYTE: [[u16; 256]; 22] = [
    // entropy:    4.4619200780464778333
    // avg_length: 4.5415773046232610355; max_length = 12; num_symbols = 256
    [0x9017, 0x5009, 0x7033, 0x3002, /* ... */],
    // ...
];

// datasketches/src/cpc/estimator.rs
static ICON_POLYNOMIAL_COEFFICIENTS: [f64; ICON_TABLE_SIZE] = [
    // log K = 4
    0.9895027971889700513, 0.3319496644645180128, 0.1242818722715769986, // ...
];
static ICON_LOW_SIDE_DATA: [u16; 33] = [
    //1,  2,    3,   kappa
    6037, 5720, 5328, // 4 1000000
    // ...
];
static ICON_HIGH_SIDE_DATA: [u16; 33] = [ /* ... */ ];
static HIP_LOW_SIDE_DATA: [u16; 33] = [ /* ... */ ];
static HIP_HIGH_SIDE_DATA: [u16; 33] = [ /* ... */ ];
我在移植一些简单查表模块时,习惯在单元测试里从第一性原理直接算出整张表,再和静态数组逐项比对。比如对于 kxp_byte_lookup 表,我通过测试保留了推导这个魔数表的逻辑:
for byte in 0u8..=255 {
    // expected value
    let expected = KXP_BYTE_TABLE[byte as usize];

    // computed value
    let mut computed = 0.0;
    for col in 0..8 {
        let bit = (byte >> col) & 1;
        if bit == 0 {
            // note the inverted logic
            computed += inv_pow2(col + 1); //note the "+1"
        }
    }

    assert_eq!(expected, computed);
}
但是,在 CpcSketch 当中存在着 CompressionData 等几个完全没有推导逻辑的魔数矩阵。上游注释里只留下了两行构建命令:
~/ocaml-4.03.0/bin/ocamlopt -o generateHuffmanCodes columnProbabilities.ml generateHuffmanCodes.ml
./generateHuffmanCodes > raw-encoding-tables.c
我翻遍所有 Apache DataSketches 仓库都找不到这些 .ml 文件。于是,我在 datasketches-java 仓库提了 Issue-720 询问生成源码在哪。社区负责人 Lee Rhodes 回复道:
Kevin did most of his math simulations and modeling in OCaml. And his code was on his computer, which no longer exists. And his personal code died with him … even if they have a copy of his old computer it might be trying to find a needle in a haystack.
Kevin 已于 2019 年 4 月离世,相关代码或许曾留在他的个人电脑上,但是要再找到原始的代码,恐怕也无异于大海捞针了。
我深表遗憾。Kevin 在草图算法上的贡献众所周知,DataSketches 当中的很多 Sketches 就是脱胎自他的研究。但是我转念一想,既然运行时解码表的构建逻辑还在,注释里也留有线索,也许我们能从注释和静态表反推出原来的生成程序。于是我继续问老李,论文里有没有记载推导出这些表的细节?对此,老李回复道:
You should definitely read the paper. But it won't tell you any details on the Huffman codings. As I recall, in his paper he used a more standard compression scheme. He finished his work on the code after he had finished his paper -- and in the process came up with the modified Huffman coding idea, which is quite a bit more efficient than what he discussed in the paper.
这就不是我一下子能看懂的内容了。
由于即使不知道推出魔数表的逻辑,只要有正确的查找表,处于 datasketches-rust 当中的 CpcSketch 就能正常运行,于是我也就暂时搁下了寻找打表源代码的念头。
直到最近正好赶上 Gemini 4 Carbon 发布,我也正打算发布 datasketches-rust 的下一个版本,这时我突然想到:现在的 LLM AI 应该有能力反推出这些魔数表的构造方法了,要不我试试?
整个过程最后变成了三个模型的接力:
-
Gemini 4 Carbon 顺着静态表和源码注释从零反推,搭起了第一版生成器测试,逐位复现了全部码字和置换表,并以相近精度重建了 ICON 多项式拟合;
-
Claude Opus 5.5 对初步结论做数学 Review 与证伪,用消融实验推翻了初版的「左边界截断」假说,揪出了一处浮点舍入陷阱,划清了多项式拟合的可辨识边界,还重跑了百万次蒙特卡罗统计;
-
GPT 6 Astra 对上面的结果做了一轮交叉审查,用变异测试找出了两处测试保护缺口,纠正了初稿里好几处数学错误和过度推断,还顺手给出了渐近常数最后几位数字的一个精确解释。
当然,实际过程不止一轮,而是几个模型之间交叉合作来回复核。最终结果就是通过 PR-355 以跟上面记录 kxp_byte_lookup 表生成逻辑一样的方式,在 datasketches-rust 仓库中以测试的形式记录了逆向工程出来的原始 OCaml 文件的打表逻辑。
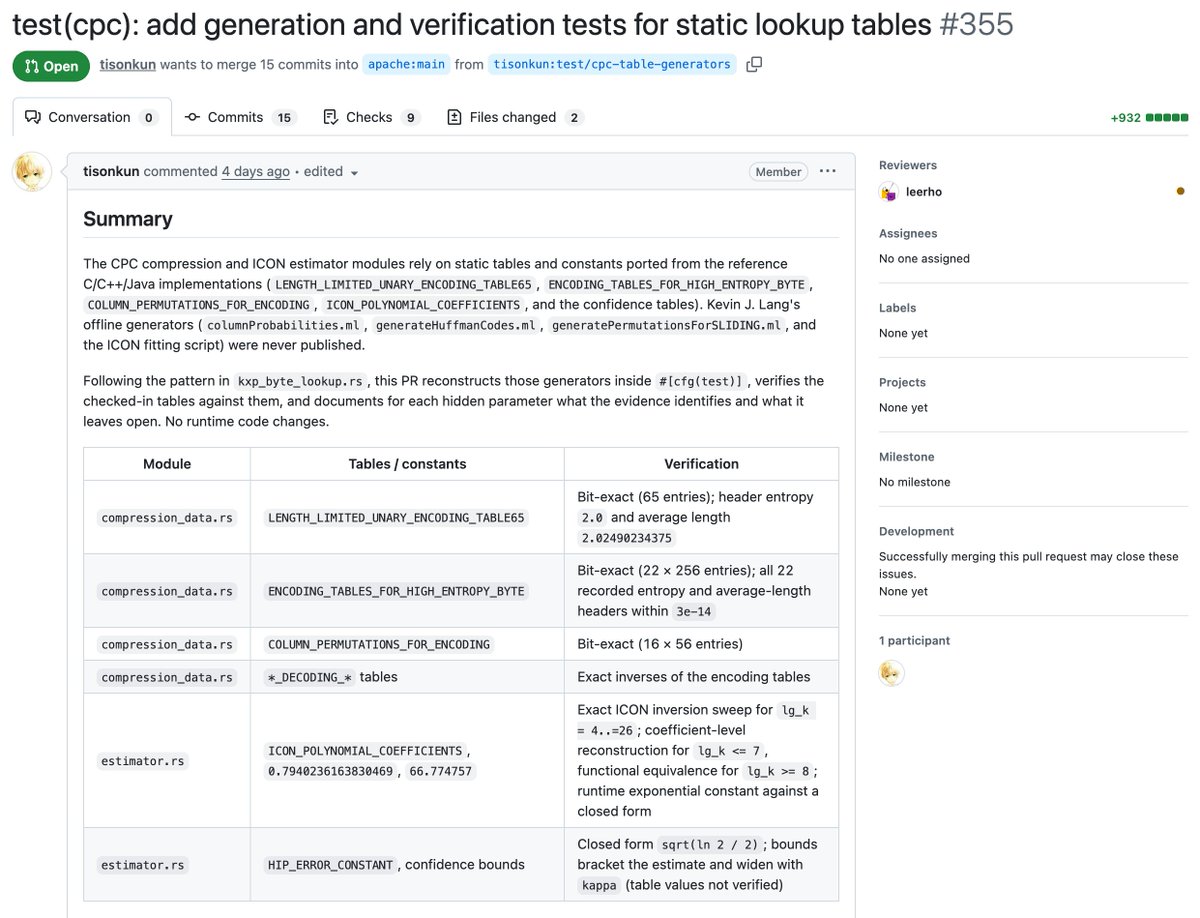
https://github.com/apache/datasketches-rust/pull/355
以下是收敛之后的完整推导报告,按「表」逐个拆解其中的数学结构,并保留了几处最有启发性的歧路与反例。为了不让正文过于枯燥,我将几个解析推导放在文末附录。同时,由于涉及 LLM AI 参与推导的内容,如果你发现了文中的纰漏,欢迎直接回复本文,或者到 datasketches-rust 仓库上提 PR 修正。
离散码字的盲区,与注释里的 20 位「指纹」
首先是 23 张 Huffman 编码表,具体定义在 compression_data.rs 模块中。
为什么 CPC 要存 23 张静态 Huffman 表?如果在运行时动态建树,序列化时就得把树结构一起写进字节流,小 Sketch 好不容易省下来的几十个字节会被表头吃光。位矩阵第 j 列被置为 1 的概率主要由已收集优惠券总数 C 与行数 K 的比值 C / K 决定,而有限 K 带来的修正只有 1 / K 量级,后面的模型辨识恰好要利用这一点点差别。因此程序可以离线按 C / K 预先算好一组分布和对应的最优编码表并硬编码进库里;到压缩和解压时,再调用 determine_pseudo_phase 函数直接从 Sketch 的 lg_k 和 num_coupons 这两个已有元数据推出该用哪张表,不需要额外存储表号。
前 22 张表用来编码滑动窗口内的字节,也就是从 0 到 255 共 256 个符号。给定窗口内 8 个相邻列各自的置 1 概率 q₀ 到 q₇ 并把各列视为独立,字节 b 的理论概率就是 8 个独立伯努利分布的连乘积:如果第 d 个比特为 1 就乘以概率 q_d 本身,为 0 则乘以 1 - q_d 即可。
上游运行时解码器用了一张长度为 2¹² = 4096 项的查找表,直接透露出一个硬约束:最大码长被限制在 12 位。用 Larmore 与 Hirschberg 在 1990 年提出的标准 Package-Merge 算法算出受限码长,按码长和符号值排序分配范式码字,再做一次比特反转以适配 CPC 的 LSB-first 比特流,就能把这 23 张表共 5,697 个码字分毫不差地复现出来。
接下来的问题是 columnProbabilities.ml 在计算第 j 列的置位概率时,到底用的是哪个概率模型?
-
有限 K 二项模型:取单次命中概率 p_j = 1 / (K · 2^j) 并在投掷 N 次后得出 q = 1 - (1 - p_j)^N 的表达式。
-
无限 K 泊松极限:当行维度 K → ∞ 且比值 N / K = λ 固定时,置 1 概率收敛为 q = 1 - exp(-λ / 2^j) 的极限形式。
如果只对比整数码字,很快就会撞上一个盲区:在 6 张中等密度表(对应数组下标 16 到 21 这六项)上,把参数 K 从 2¹⁶ 一直改到无穷大,生成出来的 256 个整数码字居然完全一样。原因在于 Huffman 码长是离散的阶梯函数,微小的概率变动根本改变不了节点合并顺序。
真正能当作连续「指纹」来锁定参数的,是 generateHuffmanCodes.ml 在每张表上方打印的两行 20 位浮点数注释,比如第 16 张字节表也就是第 1 张中等密度表的注释:
// entropy:    2.1627885076675394949
// avg_length: 2.2704182849800043087; max_length = 12; num_symbols = 256
香农熵 H = -∑ P(b) · log₂ P(b) 和平均码长 ∑ P(b) · L_b 都是概率分布的连续函数。我们固定 C / K 的密度点,把 K 从 2²⁸ 一路扫到无穷大,拿全部 22 张字节表的注释表头做校对。下表列出了这 6 张中等密度表上香农熵与平均码长的最大绝对误差:
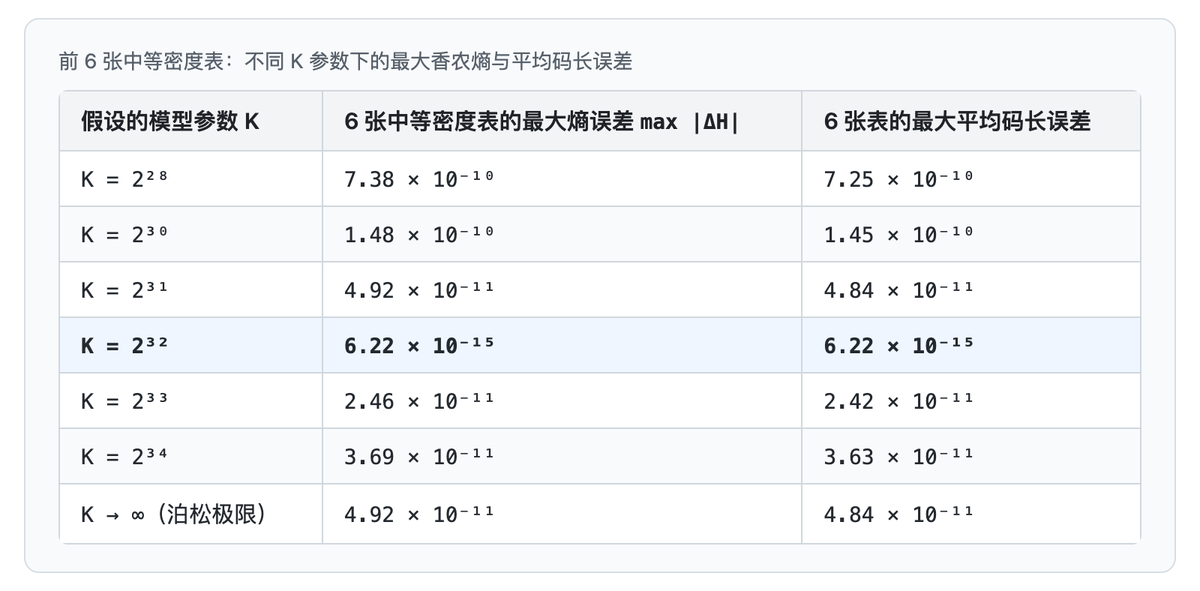
当 K 取值 2³² 时,误差骤降 4 个数量级,直接落进双精度浮点的舍入噪声底。
表里还有一个漂亮的对称:参数 K = 2³¹ 的误差与无穷大极限一模一样,而 K = 2³³ 的误差恰好是它的一半。原因是有限 K 相对于泊松极限的一阶偏差严格正比于 1 / K 这个比例因子,具体推导见文末附录中「有限 K 熵误差的一阶展开」一小节。当真值是 K₀ = 2³² 时,候选值 2³¹ 和无穷大在 1 / K 轴上距离真值正好都是 1 / 2³² 的步长,而 2³³ 到真值的距离只有一半。恰好,上游 ICON 估计器注释里写明的行数上限也是 2³² 个槽位。
稳态表:一个看似合理、其实不成立的「左边界截断」
在接下来的 16 张稳态表上,也就是相位 phase = (2m + 1) / 32 与填充密度 C / K = B + phase 的区间里,曾出现过一个颇具迷惑性的误判。
从后面的列置换表可以确定稳态工作点的整数基准应当是 B = 6 才对。但如果把刚锁定的 K = 2³² 和 B = 6 直接代入这 16 张表,算出的香农熵会和注释表头在小数点后第 12 位差出 6.1 × 10⁻¹² 的残差。
最直观的猜测是「左边界截断效应」:当 C / K 在 6 附近时,矩阵最左边的第 1 列还没有完全填满,它仍然为 0 的概率正好是 5.3 × 10⁻¹² 左右,与残差几乎处于同一量级。如果沿用全局的 K = 2³² 不变,把工作点往深处推到 B = 32 处按 C / K = 32 + phase 计算,熵误差果然降到了 10⁻¹⁵ 量级。数值对上了,连数量级都恰好吻合,乍一看非常具有迷惑性。
但只要做两组消融实验,这个假说立刻就能被推翻:
-
保持 B = 6 原地不动,只把 K = 2³² 的二项模型换成 K → ∞ 的泊松极限,这 16 张稳态表的熵误差当场降到约 10⁻¹⁴ 的水平,直接回到双精度舍入噪声底;
-
保持 K = 2³² 不变,把基准 B 从 6 依次调整到 7 再到 8 时,最大熵误差分别是 6.1 × 10⁻¹² 到 3.1 × 10⁻¹² 再到 1.5 × 10⁻¹² 的序列,每把 B 往上加 1 个单位,误差几乎正好减半。
为什么会每次减半?只要基准 B 增加 1 个单位,滑动窗口就会向右平移一列,而二项模型相对泊松极限的修正项恰好遵循 1 / (2K · 2^j) ∝ 2^(-B) / K 的衰减规律。把基准推到 B = 32 时,消除的根本不是什么「左边界截断」,而是把窗口推到了第 29 列附近,让窗口内部的有限 K 修正项 2⁻²⁹ / 2³² = 2⁻⁶¹ 小到跌破双精度机器精度,无意间用有限 K 的深列模拟出了 K → ∞ 的泊松极限。
那左边界到底能产生多大影响?虽然程序确实先用全部 128 列的期望反解出参数 λ 再去算窗口概率,左边界会通过参数 λ 间接参与计算,但在定量上完全可以由平移恒等式锁定量级。对无穷列泊松期望总和 f(λ) 来说,把 λ 翻倍恰好让级数下标移位并多出首项 1 - exp(-λ) 的贡献;而换成实际求值的有限 128 列和 f₁₂₈(λ) = E[C] / K 时,由于求和上限止步于第 128 列,右端还会同步减去那一项截断尾差:
f₁₂₈(2λ) = f₁₂₈(λ) + (1 - exp(-λ)) - (1 - exp(-λ / 2¹²⁸))
也就是说,把基准 B 加 1 时,参数 λ 加倍且窗口右移一列,窗口内的分布几乎原样平移,破坏这种平移不变性的只有左右两端的截断边界项。在 C / K = 6 + 1/32 处对应的参数 λ 约为 51.93 左右,算下来左端边界项 exp(-λ) 约为 2.8 × 10⁻²³ 量级,对 λ 的相对影响只有约 2 × 10⁻²³ 左右,而右端截断项 1 - exp(-λ / 2¹²⁸) 更是只有约 1.53 × 10⁻³⁷ 的量级,都比 10⁻¹² 的残差小了十几个乃至二十几个数量级。所以残差确实来自有限的 K 参数,而不是左边界。
这里也带出了代码逆向里很重要的可辨识性边界。单看这 16 张稳态表,在测试使用的 3 × 10⁻¹⁴ 比较容差下,泊松模型在 B 等于 6 到 84 之间、以及 K = 2³² 的二项模型在 B 等于 14 到 84 之间都能同时把全部熵和平均码长表头对到容差以内。它们并非逐位相同,彼此之间仍有约 10⁻¹⁴ 的差别,只是在原有双精度运算和当前测试容差下区分不了;到了 B = 84 这一边界上,前面恒等式里的 128 列右端截断项其实已经指数放大到了约 4.61 × 10⁻¹⁴ 的量级,等到 B = 85 时第 7 张表的平均码长误差已达 3.11 × 10⁻¹⁴ 超过容差,再往右则 128 列的右边界会彻底主导误差,在 B = 100 时达到 7.4 × 10⁻¹⁰ 的水平。我们选择「基于 B = 6 的泊松极限」,是因为它和下一节的列置换表共享同一个工作点,不需要额外虚构一个 B = 32 出来,但现有数据本身确实无法排除另一类等价写法。
列置换表:相位 19/32 上的一次舍入
在稳态区间里,滑动窗口左侧的列几乎都已经被填成 1 了,右侧的列则几乎全是空白,因此窗口外剩下的 56 列只需记录偏离常规状态的异常位,也就是原论文所称的 surprising bit 概念(即窗口左侧仍为 0 的空位、或窗口右侧已置 1 的命中位),并对其编码列号差分。为了让编码更短,需要把最容易出现异常位的列排在最前面,这就是 generatePermutationsForSLIDING.ml 生成的 16 张 56 字节列置换表。
先明确表的索引结构:
-
设窗口偏移为 ω = floor(C / K - 2.375) 的整数部分,程序先把从 0 开始的物理列号 col 映射成规范化列号 canon 值,表达式为 (col + 56 - offset) % 64 这个取模偏移,把窗口右侧的列放到前面、把窗口左侧的 ω 列放到末尾;
-
再按异常位概率从大到小给 56 个规范化列排名次;
-
最终静态表里存的是映射 encode_perm[canon] = rank 的编码名次,而不是按概率排好序的列号序列。
从表的宏观结构就能直接读出工作点:前 6 张表里,也就是相位索引从 0 到 5 时,末尾有 3 个槽位代表窗口左侧的 3 列,它们的名次被穿插到了序列中间;到了后 10 张表里,这个数目跳变成了 4 个。由于偏移 ω 在相位 3/8 处从 B - 3 跳变到 B - 2 的位置,从 3 变成 4 就直接说明 B = 6 成立。拿程序逐张核对也是如此:依次代入 B = 5 到 6 再到 7 这三个候选值时,能够对上的表数依次只有 6 张以及 16 张和 10 张(总共 16 张表)。另外与字节表不同的是,只要把参数 K 从 2⁸ 一直拉到泊松极限,生成的 16 张列置换表全都是逐字节一模一样的,说明列置换表本身对参数 K 完全不敏感。
确定了工作点 B = 6 后,真正微妙的数值陷阱藏在 p₀ 也就是窗口左侧的位仍为 0 的概率计算上。如果图省事直接复用已经算好的置 1 概率 q 并写成 1.0 - q 来反算,那么无论设基准 B = 6 还是 B = 7 时,全部 16 张表里都能复现出整整 15 张,唯独在相位 19/32 那张表里有 4 个数对不上。这一相位里偏移 ω = 4 生效,几个关键槽位的情况如下:
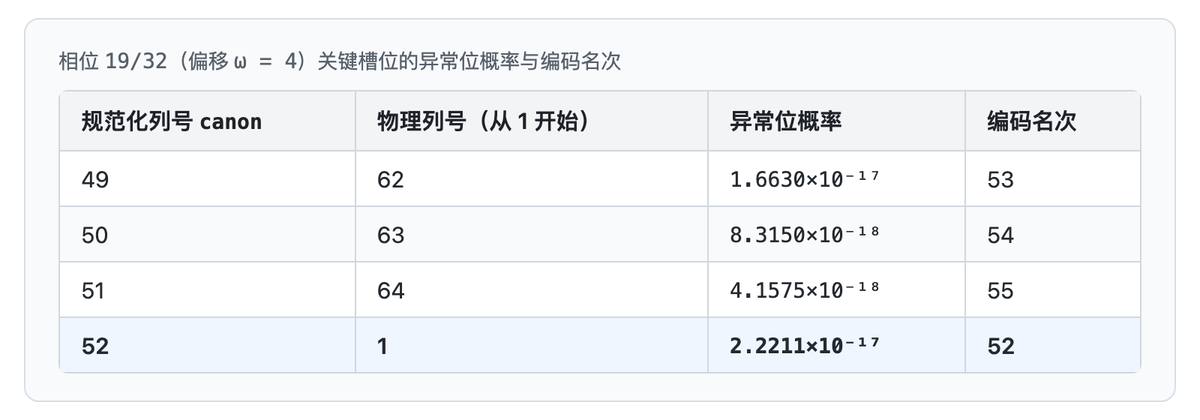
物理第 1 列的异常位概率 p₀ = exp(-λ / 2) ≈ 2.22 × 10⁻¹⁷ 其实比第 62 列的 1.66 × 10⁻¹⁷ 更大,所以它必须排在前面:按概率排序的规范化列号末尾应当是 48, 52, 49, 50, 51 这样的顺序,写进静态表里对应的切片 encode_perm[49..=52] 就是 [53, 54, 55, 52] 这四个名次。而用 1.0 - q 去算的话,会把槽位 52 一脚踢到最后,变成 [52, 53, 54, 55] 的错误名次。
问题出在浮点舍入上。数值 2.22 × 10⁻¹⁷ 本身完全可以用双精度浮点正常表示,不存在浮点下溢;真正的问题在于 q = 1 - p₀ 落在 1.0 附近,而 1.0 下方相邻浮点数的最小间距是 2⁻⁵³ 的步长。在默认的就近偶数舍入下,只要满足 p₀ ≤ 2⁻⁵⁴ ≈ 5.55 × 10⁻¹⁷ 这个条件,浮点值 q 就会被直接舍入成精确的 1.0 整数,再算 1.0 - q 就只剩下 0.0 这一种结果,也就是说 p₀ 的有效信息在第一步就已经彻底丢失,后面怎么做减法都无从恢复,这就是典型的灾难性抵消。
只要改成直接对指数求值,例如调用 Rust 的 (-lambda / 2^j).exp() 方法避开加减抵消,取 B = 6 就能把 16 张表全部分毫不差地复现出来。这一个点上的浮点比较同时排除了 B = 7 和 1.0 - q 两种写法;当然严格地说,我们只能肯定当年 Kevin 写的实现不是 1.0 - q 而已。
估算器里的 19 阶多项式与指数常数
接下来看 estimator.rs 里的 ICON 基数估计器。为了避免在运行时每次都用牛顿法反解全部 128 列的期望方程,作者 Kevin 当年设计了一个分段近似方案:
-
当 C 不超过 5.7K 这一阈值时,或者在 lg_k ≥ 14 时放缩到 5.6K 阈值内,使用提取了三次前导项的 19 阶多项式;
-
当填充数 C 跨过阈值变得更大时,直接切换到简洁的渐近指数公式。
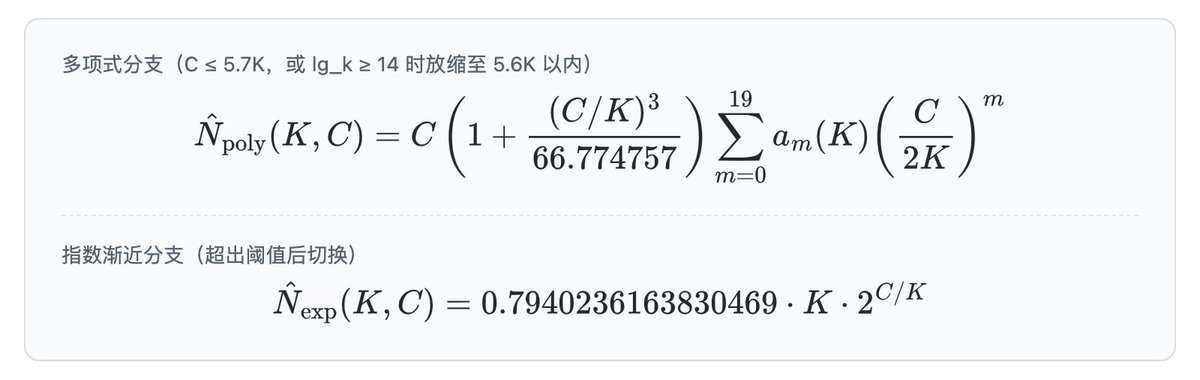
这个三次前导因子把目标函数比值稳在了 [0.89, 1.48] 之间,而不像 N / C 那样在 [0, 6] 区间膨胀超过 8 倍;变量缩放 x = C / (2K) 又把 [0, 6K] 压到 [0, 3] 区间,使 x¹⁹ 停在 3¹⁹ ≈ 1.16 × 10⁹ 而非 6¹⁹ ≈ 6.09 × 10¹⁴ 的量级。
多项式的拟合区间与可辨识边界
既然运行时早在 5.6K 或 5.7K 就切走了,当年离线拟合究竟是在哪个区间上做的?把代码里存好的 23 组多项式拿到阈值右侧继续求值,可以看到两个现象:
-
所有行在 C = 6K 以内都保持 5 × 10⁻⁷ 以内的相对误差,越过 6K 几个百分点后才会迅速发散;等到 6.25K 处时,每一行的误差都已经跳到 4 × 10⁻⁶ 至 1.3 × 10⁻⁴ 之间。
-
当 lg_k = 4 也就是 K = 16 时边界非常锋利:在区间 C = 2..96 上最大相对误差只有 8.7 × 10⁻⁸ 左右,出现在整数点 C = 95 上;到了 C = 96 处是 1.3 × 10⁻⁸ 的低谷,可刚迈出一步到 C = 97 就瞬间跳涨到了 2.2 × 10⁻⁶ 的量级。
-
但是在 K 较大的行里,一个整数步长只对应 C / K 的极小增量,误差曲线上看不出陡峭的「悬崖」:例如 lg_k = 8 时在 C = 6K + 1 处的误差还是 -6.6 × 10⁻⁸ 这样温和的数字,甚至比在 C = 6K 处还略小一点。
因此,「拟合区间的右端恰好截止在 6K 处」这个判断主要依靠下面的系数拟合实验,而不是单靠误差曲线的突变。至于为什么拟合区间要特意超出运行时阈值,「给高阶多项式留一段防端点振荡的缓冲带」是一个很自然的猜测,但上游并没有留下文字记录。
进一步重建系数时,大小规模之间出现了一条清晰的可辨识边界:
-
对于 lg_k <= 7 的较小规模,此时 6K 不超过 768 个整数点;在从 C = 1 到 6K 的每一个整数点上做无权重最小二乘,算出的 20 个系数与上游静态表的偏差只有 0.07% 到 1.4% 左右;只要把左端点 C = 1 去掉,或者把任一端点挪动 1 个单位,系数吻合度就会变差 4 到 59 倍。这有力支持了全整数网格的猜测,但还不能据此断定原作者就是这么做的,因为不同加权方式之间并不唯一,比如 lg_k = 4 时按相对误差加权拟合甚至略好一点,原始代码的数值实现细节也无从得知。
-
到了 lg_k >= 8 的高阶行,无论用全整数网格还是加密边界的子采样网格,算出的系数都和原表相差 14% 到 65% 之多,但函数值依然极度贴合,测试里运行时区间上的最大相对误差稳定控制在 3e-7 以内,跨过拼接点后也在 2.5e-6 与 1 / (80 * K) 取大值的紧凑边界内。从函数逼近反推高阶多项式系数本身就是一个极度病态的问题:未缩放的 19 阶单项式基在这些网格上的二范数条件数高达 10¹⁷ 量级,具体到 lg_k = 4 这行就达到 1.19 × 10¹⁷ 左右,哪怕按列归一化后也仍有约 10¹⁴ 的病态程度,导致函数值上完全看不出差别的两个拟合,对应的系数向量却可能差得很远。
指数分支背后的几个常数
指数公式里的常数以及上游测试代码里的误差容差,以前常被当成纯经验值。其实它们都可以从泊松模型推导出来,具体演算留在文末附录关于 Mellin 变换与拼接点偏差的两节中:
-
渐近常数里的主项部分:对无穷列泊松期望做 Mellin 变换并在 s = 0 的二阶极点处求留数,就能得到渐近展开式 E[C] / K = log₂ λ + γ / ln 2 - 1/2 + P(log₂ λ) + R(λ) 本身,其中 P 是一个周期为 1 的微小振荡项,余项 R(λ) = ∑_{r≥0} exp(-2^r · λ) 在指数分支生效的 λ ≥ 38.5 区间下按 exp(-λ) 指数衰减,严格小于 2 × 10⁻¹⁷ 的量级。忽略振荡与余项反解可得 λ ≈ D · 2^(C/K) 的主项近似,常数部分为闭合形式 D = √2 · exp(-γ) = 0.7940236163832829... 的数值,它与代码里的硬编码常数直到小数点后第 13 位才相差约 2.36 × 10⁻¹³ 的微小偏移。
-
百万分之一量级的周期波纹:上面提到的振荡项 P 来自虚轴上的一阶极点,它的一阶谐波会让估计值产生相对振幅 a = 2 |Γ(2πi / ln 2)| ≈ 1.0904 × 10⁻⁶ 的周期振荡,这正是大 K 条件下指数分支实测相对误差无法继续消除的下限。
-
上游测试里的分母系数:上游 Java 实现的 IconEstimatorTest 里写着 max(2e-6, 1.0 / (80 * k)) 这样一个误差上限。有限 K 效应会让泊松指数公式轻微高估基数,最大相对偏差 1 / (2Kλ) 发生在拼接点 C = 5.7K 也就是 λ ≈ 41.3 处,数值约为 1 / (82.6K) 左右。上游写的 1 / (80 * K) 正好覆盖了这个峰值并留出约 3% 的余量,至于当年是否就是按此取整拍板的,代码里没有留下说明。
常数最后几位数字的来历
至于主项 D 与代码硬编码常数之间 2.36 × 10⁻¹³ 的微小偏移,有一个很漂亮的数学准则可以精确解释到最后一个比特。如果当年选定系数 A 的目标,是让近似公式 A · K · 2^(C/K) 相对于精确反解的相对误差在一个周期上平均为零,那么按文末附录「周期平均相对误差与指数常数」的推导,系数应当满足:
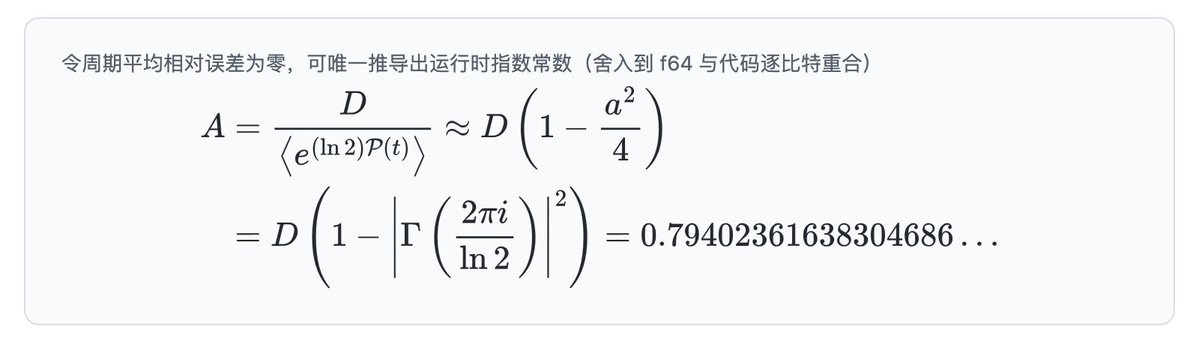
中间的约等号是零阶修正贝塞尔函数的二阶展开,截断余项只有约 5 × 10⁻²⁶ 的大小,远远低于双精度浮点的分辨率。把结果舍入到 f64 精度后,逐比特恰好就是代码里存着的 0.7940236163830469 这个数字。我们在测试里直接调用生产函数并算出这个闭式,结果与运行时常数完全重合;如果在完整周期上用精确估计器数值求一次调和平均,相差也只有 2 个 ULP 而已。不过还是要清醒地强调一句:它证明的是「这个数学准则能精确解释代码里的数字」,并不等同于证明 Kevin 当年真的编写了这条准则。
百万次蒙特卡罗重测与离散台阶效应
最后一块是 4 张置信区间表,即 ICON_{LOW,HIGH}_SIDE_DATA 和 HIP_{LOW,HIGH}_SIDE_DATA 这两对经验表。上游注释里写着,它们是在真实基数 N = 1000K 的设定下每行各跑约 10⁶ 次蒙特卡罗试验测出来的经验分位数:每个表项存放的是按 (10⁴ · √K · ε) / κ 缩放后的整数值,其中 ε 是估计值相对误差在正态分布尾分位点 Φ(-κ) 处的单侧尾分位数,最终四舍五入取整存进数组。
靠随机模拟测出来的表当然无法像代码那样逐位「生成」,只能通过独立重测来做统计学比对。这里要解决两个实际问题:这种百万次规模的蒙特卡罗重测究竟怎么在合理时间里跑完?如果今天在笔记本上重跑一遍,和 Kevin 当年的整数表到底会差多少?
如果傻乎乎地一次次模拟真实元素插入,在 lg_k = 14 也就是 K = 16384 时单次试验就要插入 1.6 × 10⁷ 个元素,跑完 10⁶ 次试验足足需要 1.6 × 10¹³ 次循环操作,单机根本跑不动。快速模拟器用的正是 Kevin 在论文附录 B 里介绍过的指数加速思路:优惠券矩阵的占用状态只需要用 64 个计数器 m_j 记录每一列还剩多少个空格子即可,同时额外维护 HIP 累加值和已处理元素数。需要注意一点,这里维护的 HIP 累加值不能由试验结束时的最终列计数逆推出来,它强依赖于发现新格子的历史先后顺序。举个最小反例,在 K = 16 时往第 1 和第 2 列各点亮一个新格子,先 1 后 2 得到的累加值是 2.0323 左右,而先 2 后 1 得到的则是 2.0159 左右,尽管结束后两者的各列计数完全一样。每来一个新元素,点亮新格子的总概率 p_hit 就是各列 m_j / (K · 2^j) 的总和,于是两次点亮之间空转的等待步数严格服从几何分布,可以用对数采样一步跳过;每跳到一次点亮时,把 HIP 累加器加上 1 / p_hit 的增量,再按正比于 m_j · 2^(-j) 的条件概率随机抽样本次落在哪一列。
这里还要补充一点实现边界:模拟器给物理第 64 列也就是下标 63 这一列赋予了显式权重 2⁻⁶⁴ 并靠初始 kxp = K 在这一列兜底吸收剩余的尾质量;而在实际的 sketch.rs 源码里,第 64 列会同时收拢所有前导零数不小于 63 的哈希,实际命中概率为 2⁻⁶³ 却在更新 kxp 时仍只扣除 2⁻⁶⁴ 的权重,并且窗口每移动 8 次还会重算一次 kxp 来消除浮点飘移。因此只有在第 64 列尚未被命中、且忽略 refresh_kxp 重算误差的范围内,两者才与理想过程严格一致。不过按理想哈希估算,整轮全部试验超过 4 × 10¹³ 次总插入中,第 64 列的期望总命中次数仅约 4.5 × 10⁻⁶ 次,实际运行几乎不可能触发,对本次统计比对没有实质影响。凭借这个跳步算法,每次试验的计算复杂度从 O(N) 降到了 O(C) 的优惠券数级别;在 N = 1000K 处总计只收大约 10K 张优惠券,操作数直接少了约两个数量级。
同时还要解决一个统计检验上的陷阱。因为同一批 10⁶ 次试验会一并算出某一行里的全部 6 个尾分位数,即高低两侧各自的 1 倍到 3 倍标准差水平,这 6 个数彼此存在相关性,如果直接把各格子的单格偏差平方相加再去套 χ² 卡方分布自由度是不严谨的。为此,我们保存了全量的原始试验输出 C 与 HIP / N 到磁盘上:第一遍 simA 在从 4 到 14 的全部 11 个 lg_k 上每行各跑 10⁶ 次,在 14 线程并发下总共只花了约 11 分钟;接着用真实的 CpcSketch 配合 MurmurHash3 哈希在 lg_k = 4..=7 上各跑 10⁶ 次作为实现对照,确保每个 lg_k 使用彼此独立的哈希流种子;最后用独立种子跑第二遍 simB 作为同模拟器零假设对照,覆盖 lg_k = 4..=12 这 9 行。在分析脚本里,我们同时用两种方法估计每行 6 个分位数之间的完整 6 × 6 协方差矩阵,分别是 2000 次非参数 Bootstrap 重采样,以及基于连续近似下分位数联合渐近正态性并结合 Siddiqui 阶统计量间隔估计尾部密度 f(Q(p)) 的解析公式。随后用马氏距离平方 T² 做联合卡方检验,整体跨行求和时以各行试验相互独立为前提。
先看两项基础对照,实验结果清晰稳定,第一对 simA 与 simB 之间没有检出整体差异;真实 CpcSketch 的实现对照则落在 p ≈ 0.05 ~ 0.08 的边缘区间,也就是说对比单轮 simA 在 5% 阈值附近、对比两轮均值则略高于阈值,且 24 个单格里没有任何一项偏离超过 3 倍标准误,尚不足以认定存在系统偏差。同时,两种协方差近似方法在全部比较上给出的结果都高度一致:
-
同一模拟器的零假设对照:把 simA 与 simB 在共有的 lg_k = 4..=12 这 54 个自由度上比较,其中 Bootstrap 协方差下总 T² 等于 62.58 对应 p = 0.198 的尾概率,解析渐近协方差下总 T² 等于 63.77 对应 p = 0.171 的尾概率,与两次独立百万次试验的联合起伏完全相符。
-
真实 CpcSketch 的实现对照:在 lg_k = 4..=7 的 24 个自由度上把真实实现与 simA 对比,其中 Bootstrap 协方差下总 T² 为 36.72 且 p = 0.047 而解析协方差下 T² 为 36.20 且 p = 0.052 左右;如果换作与 simA 和 simB 两轮的均值 mean(simA, simB) 对比,则两组协方差分别给出 T² = 34.65 与 p = 0.074 以及 T² = 33.96 与 p = 0.085 的结果。全部 24 个格子里没有偏离超过 3σ 的项,超过 2σ 的也仅 1 格,未见明显的系统性偏差。
在这个协方差校准框架下,重测结果与 Kevin 当年原表的比对明显分成两类:
-
如果看 ICON 静态表:第一遍 simA 在全部 66 个格子里,有 59 个格子与 Kevin 当年的整数一字不差,浮点数偏差全部落在 ±0.5 的四舍五入窗口之内;独立运行的 simB 在共有的 54 个格子里也有 51 个格子吻合,其中两次独立采样有 49 格完全重合。
-
如果看 HIP 静态表:在假定各行独立并用均匀噪声方差 1 / 12 近似整数舍入误差的前提下,按上游记录的试验次数计入原表自身的抽样协方差后,其中 Upstream 原表对比 simA 在全部 11 行共 66 个自由度上的总 T² 达到 103.97 对应 p = 1.99 × 10⁻³ 的整体信号,解析协方差下则是 T² = 102.27 与 p = 2.81 × 10⁻³ 的尾概率;在独立对照 Upstream 对比 simB 的 54 个自由度上总 T² 为 73.46 且 p = 0.040 而解析协方差下为 73.04 与 p = 0.043 左右;对比两轮均值 mean(simA, simB) 则是 T² = 87.29 与 p = 2.77 × 10⁻³ 以及 86.36 与 p = 3.39 × 10⁻³ 的接近值。综合来看,整体上确实存在小幅但可检出的不一致信号,主要贡献集中在 lg_k = 7 这行以及 lg_k = 9 和 lg_k = 11 这三行:它们在 simA 里的单行 p 值依次是 5.4 × 10⁻³ 到 0.014 再到 9.5 × 10⁻⁴ 的检验水平,不过按 11 行做 Holm 多重比较校正后,只有 lg_k = 11 以约 0.010 的校正后概率稳稳通过,至于 lg_k = 7 则落在约 0.054 的边缘,而 lg_k = 9 只剩约 0.13 的弱信号;而在完全独立的 simB 里,这三行的单行 p 值依次是 0.092 到 0.066 再到 0.167 左右。因此,我们有理由认为整体存在轻微差异,但各行证据强弱不一,尚不足以断言这三行都存在确定性的系统偏移。从绝对数值差距上看,全部 66 格里的最大绝对差只有 83.74 个表单位,出现在 lg_k = 9 低侧的 3 倍标准差那格,换算成公式里的误差因子 ε 相对变化不超过 1.49% 的幅度,代入非线性置信区间分母后的单侧区间宽度变化约为 1.61% 左右,对区间数值大小的影响很小,不过我们并未另行重测实际覆盖率是否受到细微影响。
为什么一组靠随机采样跑出来的 ICON 经验表,会在近九成的格子里连个位数都和 Kevin 当年的原表一模一样?原因在于 ICON 的估计值只依赖于整数优惠券总数 C 本身,因此它的取值只能落在一层层离散的「台阶」上;在百万次采样下,只要目标分位点没有恰好卡在两个整数 C 的跳变边界上触发样本插值(经逐点核对,本次全部 66 个目标分位点均未跨台阶插值),算出来的经验分位数就会稳稳落在单个整数 C 对应的台阶上。每当 C 增加 1 个单位,缩放后的表项就会跳上一层新台阶,指数区相邻台阶的精确间距与一阶近似如下:
Δ_atom(C) = (10⁴ · √K / κ) · (N_hat(C) / N) · (2^(1/K) - 1) ≈ (10⁴ · ln 2) / (√K · κ)
比如在 lg_k = 4 与 κ = 1 的格子里,相邻两个台阶足足相差约 1733 个单位。严格来说,这些台阶并非完全等宽,其精确间距还带有上式中的 N_hat(C) / N 比例因子和指数差分项。不过只要两次独立的蒙特卡罗实验在跨过目标分位数时恰好落在同一个整数 C 上,算出来的浮点数就会精确到每一位小数都完全相等,取整之后自然分毫不差。至于那剩下的 7 个不一致的格子,我逐格把双方对应的整数 C 都反解了出来:结果发现 Kevin 原表的这 7 个整数值同样稳稳落在台阶上,都在某个整数 C 对应表值的 ±0.5 以内,只不过和 simA 落在了不同的整数上,其中有 5 格只差了 1 个 C 的计数,相差 2 个和 3 个 C 的各有 1 格。以 lg_k = 7 高侧的 κ = 1 格为例,我们的分位数落在 C = 1329 处对应表值 6806.33 左右,而 Kevin 原表里的 7458 恰好对应相邻的 C = 1330 及其表值 7457.61 的取整结果。而相比之下,流式的 HIP 估计器虽然在有限 N 下严格来说也是离散分布,但其可取值密集了无数倍,因此不会出现这种跨年份重跑还连个位数都精确撞车的现象。
需要特别说明的是,这部分百万次蒙特卡罗模拟器和原始采样数据目前没有放进仓库的代码 PR 里,只是留在本地作为这次调研的独立实验记录。
证据的边界,与留给未来的 6 个问题
这轮调研整理出来的生成器、解析常数与测试加固,已经通过 PR-355 合入上游。
把这些推导写进上游测试时,有一个非常值得记录的工程教训:千万不要写出「自证循环」的弱测试。在早先一版测试实现里,渐近常数校验拿的是测试模块里自己另抄的一份私有常量去比对,而置信区间检验只检查了上下界能否夹住估计值本身。通过简单的变异实验立刻就能戳破这层保护:哪怕把生产函数的渐近常数篡改成 0.794024 这个粗糙近似数,或者把 4 张置信区间表全部 132 个元素统统清零,原有的单元测试依然能够全部通过。因此最终合入 PR 的测试做了两处加固:常数检验直接调用生产函数读取运行时常数去跟理论闭式比对,置信区间测试补上了「区间随 kappa 严格单调变宽」的契约检查并在注释里如实写明验证边界。截至目前,全部 23 张 Huffman 表与 16 张列置换表的逐位重建测试已完成完全的强检验,而经验分位数表则清楚地标出了单测不校验原表取值与真实覆盖率这一边界。
做这种历史遗留代码的逆向反推,最容易犯的错误就是「测试跑通了,就以为自己还原了原作者的想法」。事实上,证明一种方法能解释数据,与证明原作者实际使用了这种方法,是两回事。 因此我们在代码注释与这篇报告里刻意划清界线,把「已被观测数据唯一锁定的参数」与「存在观测等价类、现有证据无法区分的部分」区分开,将以下 6 个目前无法继续唯一的开放问题留给社区:
-
稳态字节表的原始写法:当年生成脚本究竟是直接写了泊松极限,还是用了有限 K = 2³² 的二项模型但把工作点推到了 B = 14 到 84 之间?在原有双精度运算和当前 3e-14 的测试容差下,两者无法区分。
-
Package-Merge 的平局规则:一张 65 符号表在 P(62) = P(63) + P(64) = 2⁻⁶³ 处发生过一次精确的权重平局,但叶子优先与合并包优先算出来的码长在全部 23 张表上完全一致,静态表里看不出原作者选了哪一种。
-
多项式三次项分母的来历:为什么前导三次修正项特意取 66.774757 这个特定分母常数,目前还没有找到解析推导或工程记录。
-
多项式拟合的具体采样配置:小规模 lg_k <= 7 的全整数网格得到了消融实验的有力支持,但权重和数值实现并未确定;到了 lg_k >= 8 的高阶行,具体选用了哪组采样网格则在 10¹⁷ 条件数下完全不可辨识。
-
渐近常数最后几位的生成准则:「周期平均相对误差为零」能够逐比特准确复现 0.7940236163830469 这串数字,但 Kevin 当年是否真的采用了这条优化准则,同样无从证实。
-
HIP 置信表的微小整体差异:在各行独立以及连续渐近近似的假设下,我们的百万次重测与 Kevin 原表在整体上存在可检出的轻微差异,主要贡献集中在 lg_k = 7 这行以及 lg_k = 9 和 lg_k = 11 这三行,但单行证据强弱不一,最大单格差 83.7 个表单位且误差因子变化不超过 1.49% 的幅度。现有数据还不足以区分历史采样波动、未知上游实验批次细节与极细微的实现差异;而要逐字复现当年的表格,还需要知道当时使用的具体随机数生成器与种子。
回头看今年年初移植 CpcSketch 时看到的那两行孤零零的 ocamlopt 注释,当时只觉得是一段无法再追溯的技术遗憾。这次先后对着小数点后第 12 位的浮点残差较真、跑消融实验证伪直觉假说、顺着复平面极点推留数、做百万次采样和全协方差校准,再到用变异测试和反例把边界一道道钉死,可以说 Kevin J. Lang 留在生产代码里却没有写进论文的那部分精巧设计,绝大多数已经被重新算了出来;而暂时算不出来的那小部分,至少我们也清清楚楚地知道了证据的边界在哪里。
附录:几个解析推导
有限 K 熵误差的一阶展开
在第 j 列上,设 x = 1 / (K · 2^j) ≪ 1 足够小,有限 K 二项模型对数生存概率的泰勒展开如下:
ln(1 - q_bin) = N · ln(1 - x) = -N · (x + x² / 2 + O(x³)) = -(N / (K · 2^j)) · (1 + 1 / (2K · 2^j) + O(K⁻²))
对比泊松极限的对数生存概率 ln(1 - q_poi) = -λ / 2^j 可知,有限 K 效应相当于在每一列的指数上乘了一个修正因子 1 + 1 / (2K · 2^j) 的小扰动。由于该因子随列号 j 按 2^(-j) 快速衰减,光靠调整全局的参数 λ 无法同时抵消 8 个窗口列上的偏差,残余的列概率扰动 δq_j = O(2^(-j) / K) 就会导致香农熵发生 ΔH = α / K + O(K⁻²) 这样随 1 / K 线性变化的偏移。
主项与周期波纹的 Mellin 变换推导
对无穷列期望和 f(λ) = ∑_{j≥1} (1 - exp(-λ / 2^j)) 做积分变换 f*(s) = ∫₀^∞ f(λ) · λ^(s-1) dλ 求 Mellin 变换。在收敛带 -1 < Re(s) < 0 内有基本积分恒等式 ∫₀^∞ (1 - exp(-x)) · x^(s-1) dx = -Γ(s) 成立。为了核对符号,可以代入实数 s = -1/2 来检验:此时被积函数处处为正,积分必须为正,而公式右边 -Γ(-1/2) = 2√π > 0 也恰好为正。由此直接得到变换表达式与对应的振荡展开:
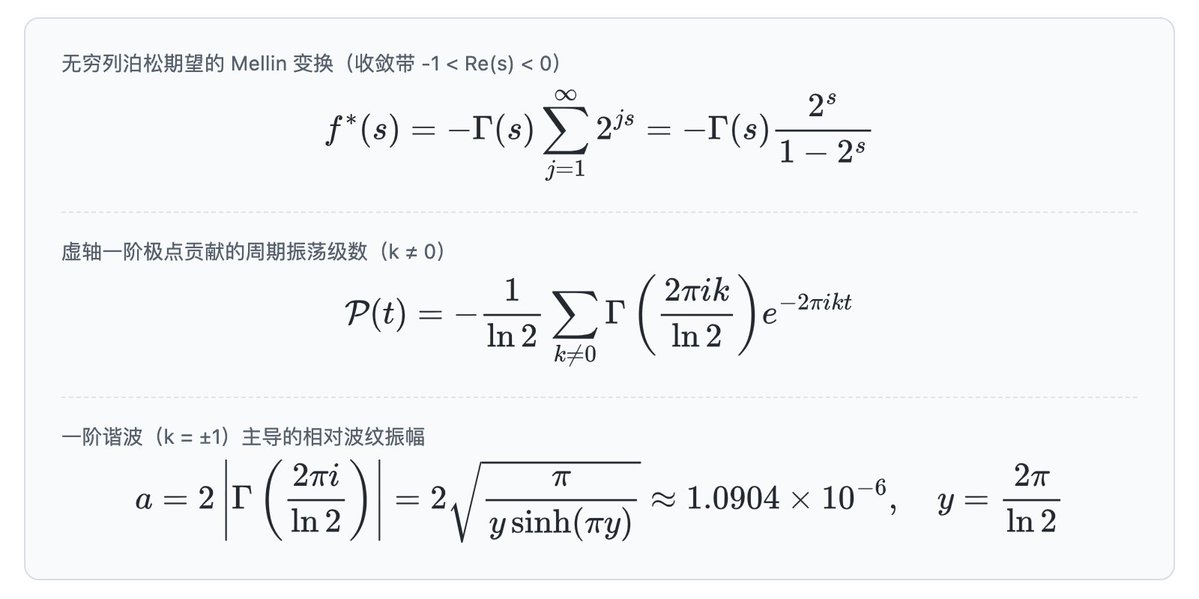
将逆变换的积分路径向右平移并跨过虚轴 Re(s) = 0 上的全部极点后,在 λ → ∞ 时便得到主展开 f(λ) = log₂ λ + γ / ln 2 - 1/2 + P(log₂ λ) + R(λ) 本身,其中的指数衰减余项 R(λ) = ∑_{r≥0} exp(-2^r · λ) 在指数分支对应的 λ ≥ 38.5 范围里不超过 2 × 10⁻¹⁷ 的误差量级:
-
位于原点 s = 0 处的二阶极点:把 Γ(s) = 1/s - γ + O(s) 与 2^s / (1 - 2^s) = -1 / (s · ln 2) - 1/2 + O(s) 相乘展开,留数给出主项 log₂ λ + γ / ln 2 - 1/2 的对数增长行为。令其等于密度 C/K,即可反解出 λ ≈ √2 · exp(-γ) · 2^(C/K) 的指数估算式。
-
位于虚轴 s_k = 2πik / ln 2 处的一阶极点:对于非零整数 k ≠ 0 的全部极点共同贡献了一个周期为 1 的微小振荡级数,且由一阶谐波即 k = ±1 项完全主导。换算成参数 λ 的相对振幅,也就是把振荡振幅乘以 ln 2 后,直接得出上方卡片给出的波纹振幅 a ≈ 1.0904 × 10⁻⁶ 的精确表达。
周期平均相对误差与指数常数
忽略指数余项 R(λ) 的贡献,由渐近关系 C / K ≈ log₂ λ + γ / ln 2 - 1/2 + P(t) 以及记号 t = log₂ λ 整理即可把精确反解写成 λ ≈ D · 2^(C/K) · exp(-(ln 2) · P(t)) 的形式,于是指数近似式 A · 2^(C/K) 对应的相对比值误差就是 (A / D) · exp((ln 2) · P(t)) - 1 本身。要求该相对误差在一个周期上的平均值为零,系数 A 必须取为 D / <exp((ln 2) · P(t))> 的调和平均。
由于 (ln 2) · P(t) 的一阶谐波可以写成 a · cos(2πt + φ) 的余弦波,它在一个周期上的均方值为 a² / 2 左右,积分后给出零阶修正贝塞尔函数 <exp((ln 2) · P)> ≈ I₀(a) = 1 + a²/4 + a⁴/64 + ... 的幂级数展开,从而自然得到近似式 A ≈ D · (1 - a² / 4) 这层关系。因为 a² / 4 ≈ 3 × 10⁻¹³ 极小,精确的一阶谐波比值 D / I₀(a) 与二阶展开 D · (1 - a² / 4) 之间仅仅相差约 5 × 10⁻²⁶ 的高阶项,更高次谐波的贡献就更加微不足道了,两者都远低于双精度浮点能分辨的边界。顺带一提,按横坐标 C / K 取平均与按 t 取平均得到的结果完全相等:因为微分关系 dC / K = (1 + P'(t)) dt 里的导数修正项在完整周期 [0, 1] 上的积分 ∫₀¹ exp((ln 2) · P(t)) · P'(t) dt = 0 恒为零,两套平均口径严丝合缝。
拼接点有限 K 偏差的估算
在有限 K 条件下,达到相同 C / K 所需的真实密度 λ 比无限 K 极限略低一点,所以基于泊松极限推出来的指数公式在拼接点 C = 5.7K 附近会出现轻微高估。把对应的 λ_splice ≈ 0.794 × 2^(5.7) ≈ 41.3 代入一阶修正估算,该处产生的最大相对高估偏差为:
ΔN / N ≈ 1 / (2 · λ_splice · K) ≈ 1 / (82.6 · K)
ICON 与 HIP 的渐近相对标准误
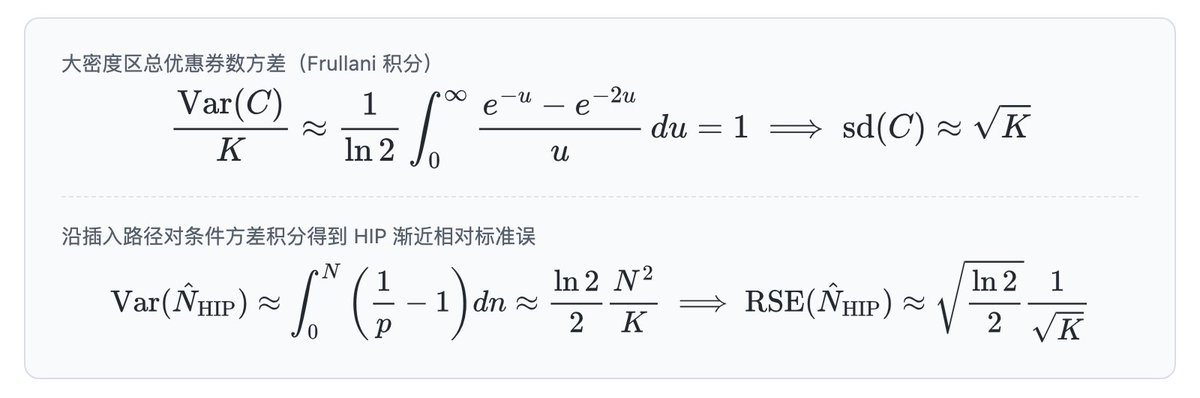
当 λ ≫ 1 时,泊松模型下矩阵的各个格子相互独立,总优惠券数的方差满足对全部列 j 求和 Var(C) ≈ K · ∑ exp(-λ / 2^j) · (1 - exp(-λ / 2^j)) 的形式。在一个单位周期上把离散求和转化为连续变量积分,立刻化为标准的 Frullani 积分:
-
如果使用 ICON 估计器:由大密度区的指数形式 N_ICON ∝ 2^(C/K) 结合一阶误差传播定律,可以直接算出渐近相对标准误 RSE(N_ICON) ≈ (ln 2 / K) · sd(C) = ln 2 / √K 的结果,正好对应源码里定义好的 ICON_ERROR_CONSTANT = ln 2 常数。
-
如果使用 HIP 估计器:当流式插入到达密度 λ = n / K 时,下一个新元素能点亮空白格子的总概率约为 p ≈ 1 / (λ · ln 2) 的水平。沿着整条历史插入路径 [0, N] 对条件方差 (1 / p - 1) 求积分,就得到了上面卡片第二条式子中的渐近相对标准误公式,其中算出来的常数 √((ln 2) / 2) 换算成浮点数就是源码里的 0.5887050112577373 这个数字。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


