
刚出单数据库一天连崩两次!Cloudflare 全家桶万字踩坑复盘
文章目录
大家好,今天是 2026 年 11 月 16 日,周一。
前两天刚跟大家报喜,手头的出海 SaaS 订阅站终于连出两单——第一单 12 刀来自 ChatGPT,第二单 29 刀来自谷歌搜索。昨天周日,我又顺手把折腾了好久的多 Agent 工作台 Shoal 开源了。
这几天不少朋友发消息恭喜完,紧跟着都会问我同一个问题:
“虾哥,你那几个出海站后端全放在 Cloudflare 上吗?看它家免费额度挺香的,到底稳不稳,有没有什么坑?”
说实话,这个问题真是问到我痛处上了。
今年 5 月刚开始搭新站的时候,我就选了 Cloudflare 全家桶。原因特实在,就是图省事,加上能白嫖。不用自己维护服务器打补丁,静态网页还不限流量,对个人站长非常友好。
网站没人访问的时候,确实岁月静好,本地怎么测怎么过。
结果这几天真实用户和付费订单刚一进来,短短三天,后台接二连三出状况:
-
第一位海外付费用户来网站打包导出高清大图,压缩包刚超过 24 MB 就一直报错,连着失败了 5 次。最后我赶紧发邮件道歉,又补送了 50 积分才把人家安抚好;
-
紧接着 11 月 14 号那天,数据库一天之内连崩了两次:第一次是凌晨四点多,把每天 500 万行的免费读取额度跑光了,网站直接罢工,干熬到早上 8 点刷新额度才恢复;结果白天刚让 AI 改完 45 个文件发上去,晚上九点多又把新一天的额度干爆了,逼得我半夜十点半掏钱升级套餐救火;
-
更难绷的是,事后拉出后台账单一查第二次崩库的原因,小丑竟是我自己——当时我在另一个终端窗口里做数据复盘,图省事直接连着线上数据库跑了几条统计查询,生生把额度给查没了 Orz。
半夜花 5 美金升完套餐把网站救回来之后,我干脆停下手头的新需求,拉着 AI 把所有站点的数据库、文件存储、后台任务、防火墙,还有那台 99 块钱一年的轻量小服务器从头到尾盘了一遍。
趁着刚踩完坑记忆还热乎,今天这篇文章我就聊两件事:先带大家摸清楚 Cloudflare 全家桶里这一堆服务到底是干嘛的;再把这几天栽过的跟头和排查清单整理出来,给大家做个参考。
一、Cloudflare 全家桶这堆服务,各自都是干嘛的?
第一次打开 Cloudflare 后台很容易看花眼:Pages、Workers、D1、R2、KV、Queues、Cron 一大串英文名,经常搞混它们各自的边界。
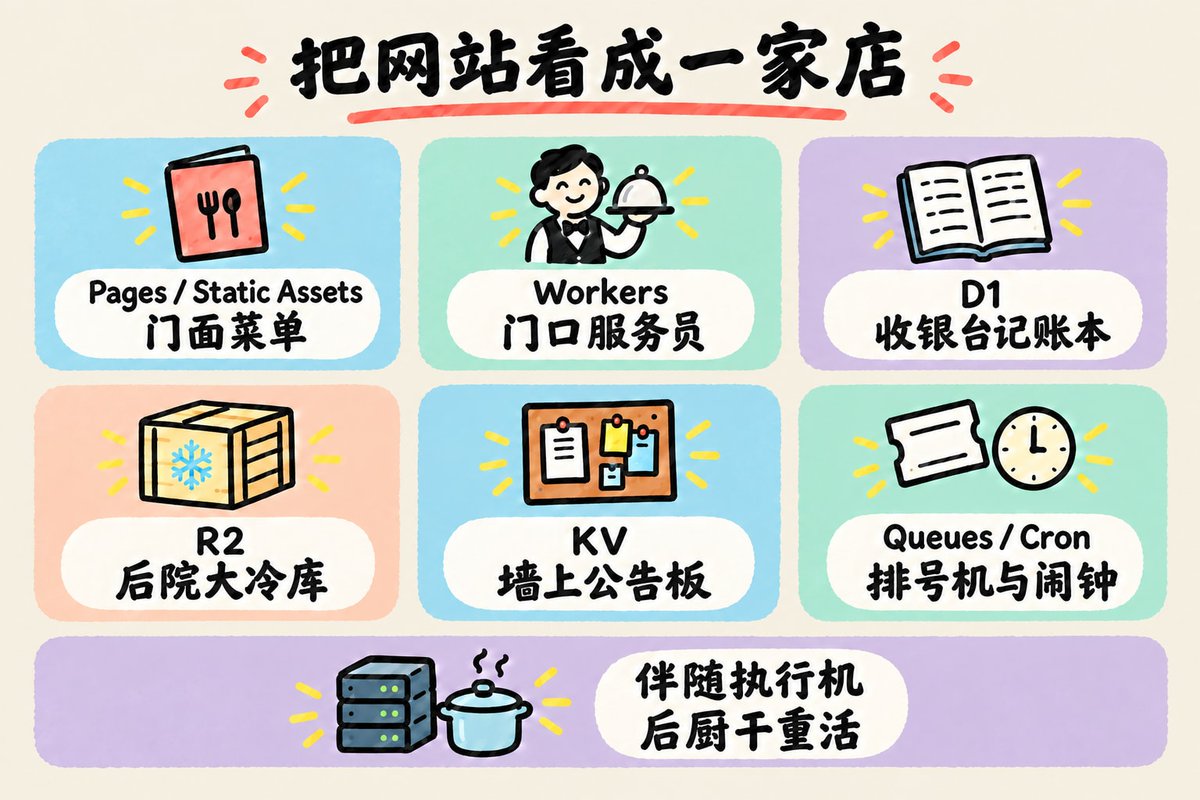
其实把整个网站对应成一家街角简餐店,这几块的分工一下就清楚了:
用户访问 ─▶ [Pages / Static Assets 门面菜单](纯静态网页:免费不限量)
               │ 登录 / 下单 / 调接口
               ▼
           [Workers 门口服务员](128 MB 共享内存|免费版每次干活限 10 毫秒)
               ├──▶ [D1 收银台记账本](轻量数据库|适合单点查改,最怕从头翻到尾)
               ├──▶ [R2 后院大冷库](存图片视频压缩包|免下载流量费)
               ├──▶ [KV 墙上公告板](读配置极快|改完同步全球最多慢 60 秒)
               └──▶ [Queues 传菜排号机 + Cron 定时闹钟](后台排队干慢活、按点巡检)
                         ▲
                         │ (主动上门领重活,干完把成品直接塞回 R2 冷库)
                         ▼
           [99 元/年 1.7 GB 小服务器](后厨苦力:抠图、打大压缩包、转发被限流的接口)
具体拆开来看,每一块的定位是这样的:
-
Pages / Static Assets 是店门口的菜单册:网页 HTML、样式表、前端脚本和小图标全放这儿,看多少次都不花钱,加载也快,但它只管展示静态内容,不干复杂逻辑。
-
Workers 是站在全球各地门口接单的服务员:不用提前开机预热,随叫随到。但他只适合干点传话、验身份、记笔账的轻活——免费版每次接单干活的 CPU 时间只有 10 毫秒,单实例一共也就 128 MB 内存。
-
D1 是收银台上的单线程记账本:本质上是一个云端单线程 SQLite 小数据库。查某笔订单、扣个用户积分特别稳;但因为同一时刻只有一个账房先生在翻本子,但凡有条慢查询逼着他把几万页账本从头翻到尾,后面排队的正常用户就全得干等着。
-
R2 是免过路费的后院大冷库:专门存用户上传的大图、生成的视频和打包好的 ZIP 压缩包。它最大的好处是免出站流量费,哪怕哪天海外用户猛下几百 G 的文件,也不用担心一觉醒来收到天价流量账单。
-
KV 是挂在各分店墙上的公告板:全店读一条公共配置特别快,但它不是实时同步的——你在亚洲刚把字擦掉重写,美洲分店可能要等最多 60 秒才能看到新内容。
-
Queues 和 Cron 是传菜排号机和定时闹钟:一个负责把生图、发邮件这种慢活排进后台慢慢消化;另一个负责按点醒过来检查超时任务、清理过期废料。
-
伴随执行机是我额外租的后厨苦力:一台趁活动花 99 块钱买一年、只有 1.7 GB 内存(还没开虚拟内存)的轻量 Linux 小服务器。之前我碰到过有的上游大模型接口看到 Cloudflare 的公共出口 IP 就直接报 1015 限流拒绝,再加上几十张大图抠图、打大压缩包根本塞不进 Workers 那 128 MB 内存里,这类重活就全让这台小机器主动领回去干。
摸清这几块的定位之后,有一条核心经验我想先放在最前面说:
Workers Paid 付费版每个月只要 5 美金,性价比确实很高;但你得先搞清楚,这 5 美金买到了什么,又有什么限制是花钱也改不了的。
这 5 美金能把单次干活的 CPU 时间上限从 10 毫秒放宽到默认 30 秒(最高能配到 5 分钟;间隔 1 小时及以上的定时任务最高能给到 15 分钟),D1 数据库额度也直接拉到每月 250 亿行读取、5,000 万行写入,撑起一个中小型出海站绰绰有余。
但下面这三条硬限制,哪怕升了 5 美金套餐也完全不变:
-
128 MB 共享内存上限不变:不管免费还是付费,单个运行实例的内存天花板都是 128 MB,而且同一节点同时进来的请求还得共用这 128 MB;
-
D1 单线程排队和单次调用最多 6 个并发连接的限制不变:慢查询照样会把数据库堵死。更要命的是,免费版超额了起码会报错停机提醒你,升了付费版如果不修慢查询,它不声不响就能把账单刷上去;
-
单条数据库查询最多拼 5 段 UNION ALL 的限制不变:超了照样直接报错罢工(错误码 7500),充钱也不好使。
因为我是一个人带着一堆 AI Agent 写代码,所以我在全局 Agent 规范里第一条就写死:绝对不准拿“花 5 美金升套餐”去掩盖慢查询、死循环和乱吃内存的代码毛病。 漏洞不补上,付费只是从“当场报错”变成“偷偷烧钱”。
二、D1 数据库:一天连崩两次 500 万行,第二次还是我自己查崩的
这三天里最折腾人的就是 D1 数据库。
用 D1 最容易踩的一个坑就是:页面上明明只查了前 20 条记录(LIMIT 20),为什么后台统计一下子扣掉了好几万行额度?
原因在于:D1 算读取额度,看的不是最后返回给你几行结果,而是数据库为了找这几行,在底下实际扫过了多少行数据。
假如一张表里有 6,000 条记录,你没建好目录(也就是数据库索引),哪怕你只是问一句“总共有多少条”,最后只拿到 1 个数字,D1 也会实打实记你读了 6,000 行。
写入额度的算法也一样:如果一张表建了 k 个二级索引,你每插入或修改 1 行改到索引列的数据,底下的目录也得跟着改一遍,实际消耗是 1 + k 行写入。所以索引也不是越多越好,瞎建七八个索引,写入额度跟着翻七八倍。
免费版每天给 500 万行读取、10 万行写入,每天北京时间早上 8 点(UTC 零点)刷新。一旦提前把额度跑光,所有要查数据库的接口就会直接报 code: 7500 罢工,只能干等到下一个北京时间早上 8 点刷新。
第一崩:10 分钟跑一次的清理任务,2 小时 14 分烧光 500 万行
11 月 13 号深夜,我给网站加了个自动回收软删除文件的定时任务,每 10 分钟检查一次有没有被用户删掉的文件需要清理。
本地测试只有几十条数据,跑得飞快。结果睡到 14 号凌晨 4 点 56 分,报警响了——才跑了 2 小时 14 分钟,一整天 500 万行的读取额度就被烧得一干二净。
早上爬起来查了查询计划(EXPLAIN QUERY PLAN)才看明白问题有多蠢:
-
当时媒体文件表里已经攒了 6,152 条历史记录,每次定时任务醒过来,不是先挑出那几条“真正标记了要删除”的文件去检查,而是傻乎乎把 6,152 条文件从头到尾挨个拿出来过一遍;
-
每拿一条文件,还要去另一张版本关联表里核对“还有没有地方在用它”;
-
偏偏那张关联表当初建目录时是按“版本号在前、文件 ID 在后”排的,现在只按文件 ID 反过来查,根本用不上目录,只能整张表硬翻!
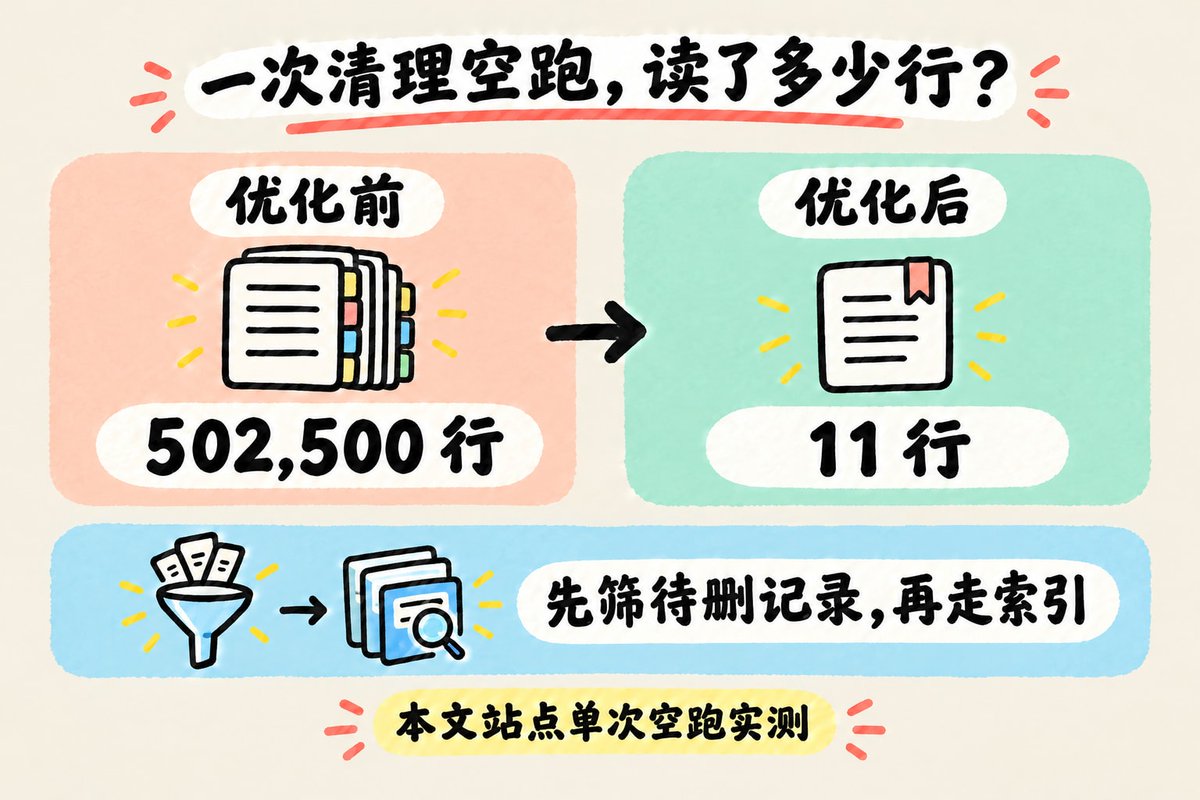
结果哪怕一个文件都没删成,光每 10 分钟空跑一趟,就要白白翻掉 502,500 行数据,十来趟下来直接把全站送走。
找到病根就好治了,改法就两步:
-
改写查询顺序,强制数据库每次先筛出真正标记了删除的那几条记录(没东西要删就直接收工),绝不准上来先翻整张主表;
-
把高频查询缺的 19 个索引目录一次性补齐,而且对软删除这类特殊状态只建局部索引,平时几乎不占额外维护开销。
改完上线一测:每 10 分钟空跑一次的读取量,直接从 502,500 行降到了 11 行,足足省了 45,681 倍。
第二崩:刚发完 45 个优化文件两小时又挂了,一查竟是我自己干的
按理说降了四万多倍,总该稳了吧?
结果 11 月 14 号白天我刚把这波涉及 45 个文件的优化推上线,才安稳了两个小时,晚上 9 点半到 10 点零七分,D1 居然又报 code: 7500 停摆了。
当时人都麻了。好在这回没靠肉眼瞎猜,直接调 Cloudflare 官方的统计接口(GraphQL),把精确到每一分钟的数据库消耗账单拉了出来。
一核对分钟级曲线,当场抓出两个原因:
-
原因一(自己坑自己):晚上 9 点整,我在另一个终端窗口里让 AI 帮我做网站数据复盘。结果图省事,直接敲命令(wrangler d1 execute --remote)连着线上生产库跑了两条大范围的注册转化统计查询。那两条临时统计根本没有专用索引,单跑一条就硬翻了 503,073 行,两条查询叠加重试连跑几遍,短短 5 分钟就把 408 万多行额度吸干了。
-
原因二(历史遗留漏水):之前有张临时文件表遗留了一批旧任务没清空重试时间,后台每分钟都在反复捞它们;再加上积分流水表的索引把区分度很低的状态字段排在了最前面,目录没起作用,导致发版前高峰期每分钟还在白白漏掉 5,084 到 11,421 行读取。
当时已经是晚上 10 点 29 分,前两天刚下单的海外付费用户可能随时在用网站,肯定不能干等到第二天早上 8 点。我先花了 5 美金升级到 Workers Paid,把线上服务秒级恢复过来。
但升完套餐绝不能就这么算了。
我连夜补了两条硬规矩写进脚本和 Agent 规范:第一,以后不管是我自己还是干活的 Agent,想看统计漏斗或者排查问题,严禁直接连线上生产库跑大范围统计查询,必须先跑封装好的快照命令(pnpm ops:d1-snapshot)把库拉回本地,在本地随便怎么查都不伤线上分毫;第二,补齐触发器和新索引,把遗留脏任务彻底清干净。
发完版等了 75 秒以上再拉后台分钟级账单核对:线上每分钟读取量直接从 5,084~11,421 行压到了 106~198 行,报错归零,这颗雷才算彻底排完。
顺手踩出来的 D1 五条隐藏限制
除了扫描行数,这几轮排查还撞上 5 个本地开发一切正常、一推上线就报错的 D1 限制,整理成表格方便大家对照:
| 隐藏限制 | 本地开发表现 | 线上 D1 真实限制(免费/付费通用) | 踩坑经历与改法 |
|---|---|---|---|
| UNION ALL 合并段数 | 最多允许拼 500 段 | 单条最多拼 5 段 | 发版检查脚本里一口气拼了 8 段状态查询,本地全过,上线直接报 7500;拆成两次 4 段查询才过 |
| ? 绑定参数个数 | 很宽松,传大数组不报错 | 单条最多 100 个 ? 参数 | 往 IN (?, ?...) 里塞上百个 ID 必挂;长列表改传 JSON 数组用 json_each 拆,两三个固定值就别乱用免得变慢 |
| LIKE 模糊匹配长度 | 几乎感觉不到限制 | 匹配词最长 50 字节 | 拿 90 个字符的防重单号做 LIKE 查询,线上直接报 pattern too complex;前缀改字符串区间比对,包含改用 instr |
| 同时查询通道数 | 本地单机没感觉 | 单次请求最多 6 个并发连接 | 一口气并发丢 10 条查询反而排队变慢;互不依赖的查询打包放进 db.batch() 一次发过去,快得多还只算 1 次请求 |
| 在线导出锁库 | 几秒导完没感觉 | 导出期间全库卡住不能读写 | 在线导出一个 60 MB 左右的库,整个库会卡死 40~55 秒;备份快照只挑低峰期跑,别频繁导 |
另外补充一点:SQLite 以后要是想改表字段的校验规则(CHECK 约束),没法一条命令直接改,只能按“建新表 → 搬数据 → 删旧表 → 改名”的步骤重建表,搬完一定记得检查原来的触发器和外键还在不在。
三、R2 存储与 KV 缓存:首单用户连挂 5 次的“本地模拟器坑”
说完数据库,再说说让我给第一位付费用户写道歉信的 R2 存储。
11 月 12 号晚上,网站刚收到第一笔 12 美金订阅。还没高兴几分钟,后台告警就响了:这位付费用户打包导出小压缩包(小于 24 MB)一切正常,可一导出超过 24 MB 的高清大图包,连着试了 5 次,5 次全报同一个错:EXECUTOR_OBJECT_HASH_MISMATCH。
当时我真懵了:后台打包分片上传到 R2 再给用户下载的这套代码,上线前我在本地模拟器(Miniflare)里跑过无数遍,每次都顺得很,怎么真用户一用就连环炸?
赶紧先发邮件道歉、补送 50 积分稳住用户,回头扒完日志才发现,这是个特别典型的“本地模拟器跟线上不一致”的坑(官方仓库也有人提过:cloudflare/workers-sdk#5936):
-
后台往 R2 分片上传成品大文件时,代码顺手把核对文件完整性用的附加信息(customMetadata)挂在了分片任务上;
-
在本地用模拟器跑测试的时候,调合并接口 complete() 返回的结果里,会原封不动把这份附加信息还给你;
-
可到了线上真实的 R2 环境,合并接口返回的附加信息居然是个空对象!
后面的校验代码拿不到比对信息,当场就误判文件损坏报错了。
顺着这段旧代码往下查,我还惊出一身冷汗:以前为了保险,合并完大压缩包之后,代码居然让 Worker 把刚拼好的整个大包(最大能到 200 MB)从 R2 重新读回内存里算一遍哈希值!且不说光算校验就要花 47 毫秒 CPU,万一同时有两个人导大包,128 MB 内存当场就得崩。
最后的改法很干脆:
-
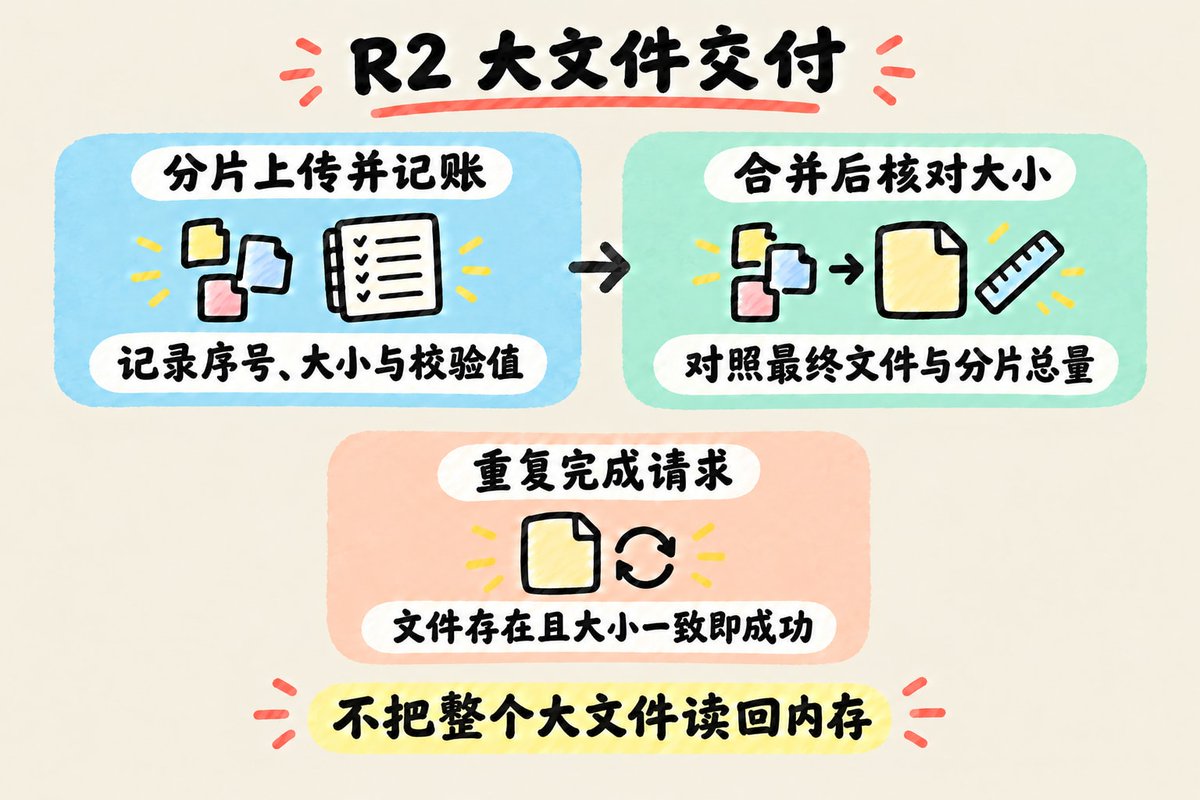
每传完一小片文件(注意除最后一片外,每片大小必须一致且不小于 5 MiB,我直接固定成 8 MiB),顺手把这一片的序号、字节大小和 sha256 校验值记进 D1 数据库;
-
最后合并完成时,不再把整个大文件读回内存,只向 R2 查一下最终文件的大小(head 请求),跟数据库里记的各片总和一对上就放行,耗时不到 1 毫秒;
-
加上重复提交保护:万一用户网络抖动多发了一次完成请求,只要看到目标文件已经在 R2 里且大小对得上,直接返回 200 成功,不抛 404 让人家白传几十兆。
两个很容易踩坑的 R2 与 KV 细节
第一,R2 自带的免费“自动清理规则”(Bucket Lifecycle)一定要开。
R2 免费版给 10 GB 存储、100 万次写入类操作和 1,000 万次读取类操作,而且删除文件和中止未完成分片完全免费。写代码时很容易习惯把删临时文件的逻辑放在 finally 收尾块里。
但在 Workers 上这招真靠不住——一旦请求超时被系统强杀(报错 1102),或者中间断连,进程当场停掉,finally 压根没机会跑。
R2 默认有条 7 天清理未完成分片的规则,建议直接收紧到 2 天;更重要的是,已经传完存进中转目录(比如 relay/、probes/、jobs/)的临时文件,R2 默认永远不会替你删,日积月累全在啃你的 10 GB 免费容量。直接在后台 Lifecycle 规则里按目录前缀设好过期天数(我设的是 relay/ 2 天、probes/ 7 天、jobs/ 30 天),官方免费自动清理,省心太多了。
第二,KV 和 R2 别用反了。
前阵子做 AI 视频工具站的时候,有个“电脑出二维码、手机扫码传照片、电脑每 2 秒查一次传好没有”的功能。
我最开始第一反应也是觉得小状态放 KV 读写快,其实千万别这么干!KV 的设计是全球慢慢同步,你手机刚写进去,电脑端跨机房去读,最长可能要等 60 秒才能刷出新内容;要是电脑端刚查过一次“还没传”,这个旧结果还会被缓存住好几十秒。再加上免费版每天总共只给 1,000 次 KV 写入,几个用户扫扫码就见底了。
这种短轮询和轻量状态,直接放 R2 反而稳得多。
R2 读写是强一致的,手机刚传完落盘,电脑下一秒去读就一定能拿到最新结果;需要防止两边同时修改撞车时,用 R2 自带的条件写入(etagDoesNotMatch)就能当轻量锁用,还没有一天 1,000 次写入的卡脖子限制。KV 老老实实拿来存几乎不改、全站到处读的公共配置就够了。
四、Workers 与 Queues 队列:10 毫秒超时、128 MB 共享内存与省钱巧招
聊完数据库和存储,再看负责跑接口逻辑的 Workers。
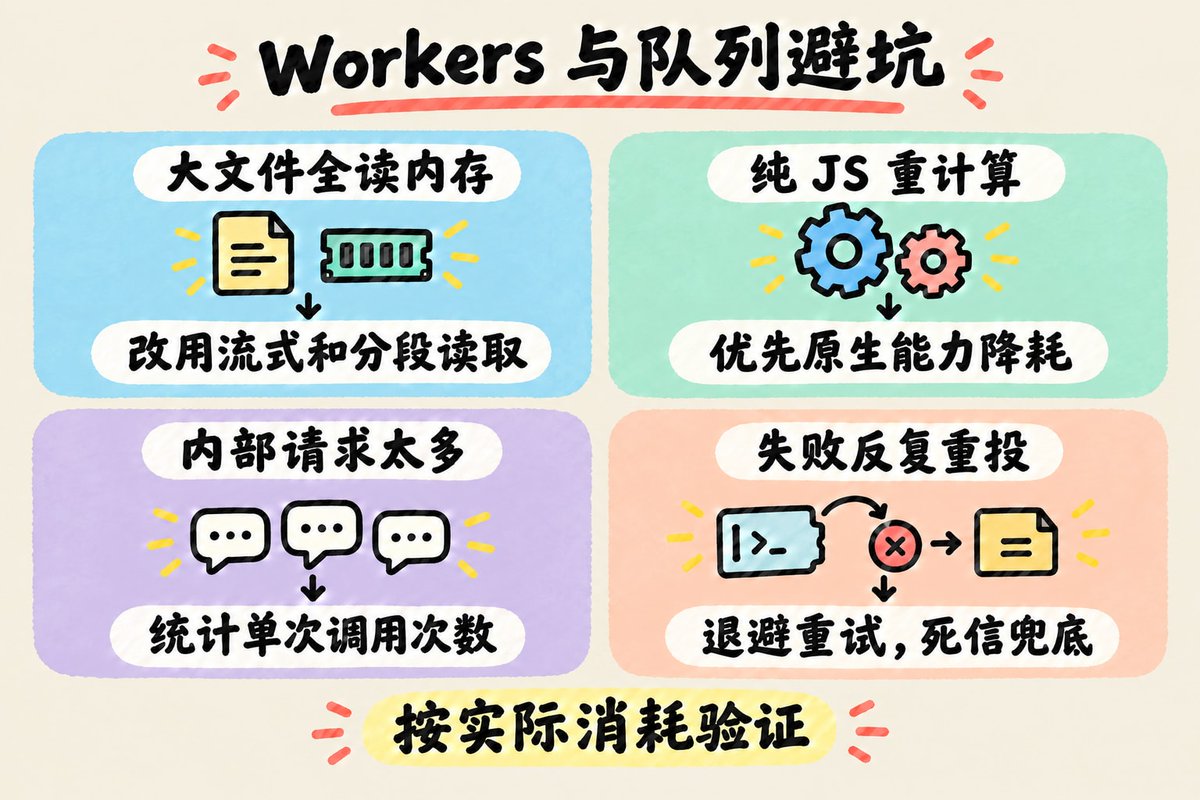
如果照搬平时写普通 Node.js 后端的习惯,上来直接调 .bytes() 或 .arrayBuffer() 把几十兆文件全读进内存,本地跑得好好的,一上线就会报 Error 1102 被强杀。
1. 10 毫秒 CPU 限制:十几行手写循环就能把大图干挂
以前我的上传代码 uploads.ts 里,有十几行手写的纯 JS 循环,用来给上传的图片算 CRC32 校验码。代码看着挺清爽,结果拿去线上真机一测耗时,人傻了:
-
算一张 1 MB 的普通 PNG 图片,要吃掉 31 毫秒 CPU;
-
算一张 16 MB 的大图,直接飙到 422 毫秒 CPU——免费版每次一共只给 10 毫秒,传大图必挂。
后来删掉手写循环,直接改调运行环境自带的底层 node:zlib 流式 crc32() 方法。同样一张 16 MB 的图,用户态 JS 耗时直接降到了 0 毫秒,整个过程跑完总共才 3.3 毫秒(稳稳留在 10 毫秒配额红线内)。
读取图片宽高或者压缩包目录也是同理:别把 50 MB 的文件全拉进内存,直接用分段读取(HTTP 或 R2 的 Range 请求),只读文件开头的 32 个字节或者末尾的 64 KB 就够了。
2. 128 MB 共享内存,和很容易超标的 50 次内部请求
这里有个特别容易忽略的机制:128 MB 内存不是每个用户请求单独享有的,而是同一个边缘节点上同时进来的请求共用的!
打个比方,假如同一秒钟刚好有 3 个用户上传或下载 50 MB 的文件,代码要是全读进内存,加起来 150 MB 直接超限,旁边第 4 个哪怕只是来刷一下首页的正常访客,也会跟着一起报错挂掉。
另外免费版还有一个隐蔽限制:每次处理一个外部请求,代码里查 D1 数据库、读写 R2 文件、调第三方接口的次数加起来最多 50 次(官方叫 Subrequests 子请求,共用同一个计数器)。
之前我的生图任务就栽在这上面:一次并发生成 4 张候选图,加上后面最长 240 秒的轮询等待,一趟跑下来内部不知不觉发了 56 到 89 次请求,直接撞上 50 次上限报错——最肉疼的是上游生图的钱已经扣了,最后保存结果那一步却因为次数超标丢掉了。
3. 两个不踩不知道的底层细节
-
别把套了 Proxy 外壳的对象塞进 db.batch():为了统计单次请求查了几回数据库,我之前给数据库实例包了一层 JS 的 Proxy 监控(meterD1Queries)。本地模拟测试全过,一上真机跑批量查询 db.batch() 当场报类型错误——因为线上底层引擎认死理,只收原装的查询对象(D1PreparedStatement),套了壳的一律拒收;而且内外层如果重复套壳还会把计数算漏。最后靠 WeakMap 在进批量接口前自动剥掉外壳、共享同一份计数器才解决。
-
Queues 队列千万别写“失败就隔 2 秒重来”:免费版队列每天总共只给 10,000 次操作额度(UTC 零点刷新)。注意一条正常消息从进队、读取到处理完删掉就要扣 3 次操作,算下来一天差不多够处理 3,333 条正常任务,失败重投一次还要多扣 2 到 3 次。之前有处消费者代码写成了“只要没拿到结果(madeProgress === false)就隔 2 秒丢回队列重试”,结果上游一抖,几分钟内任务自己跟自己死循环打转,瞬间把 1 万次额度刷空。队列重试一定要把等待间隔慢慢拉长(至少 30 秒起步往上翻倍),并且绑好死信队列(dead_letter_queue)兜底,别让重试超限或者超过默认 4 天保留期的失败任务悄悄丢单。
4. 被环境逼出来的两个纯 JS 省钱招
因为 Workers 里内存小、又装不了大型软件,我在做 AI 视频工具站的时候,反倒摸索出两个不用额外租转码服务器的省钱办法:
-
不用装 FFmpeg 也能给视频配背景音乐:以前总觉得合成音视频非得租台机器跑 Docker 和 FFmpeg。后来换了一个只有约 420 KB 的纯 JS 库 mediabunny,不用重新编码压缩视频画面,直接把原视频流和用户选的配乐打包混流导出,既省了服务器钱,画质还一点不损。
-
流式给导出视频补上 AI 合规标记:欧盟要求 AI 生成的视频带溯源信息,直接用纯字节拼接在 MP4 文件流末尾追加一小段合规元数据(XMP),顺着文件流过一遍就搞定,基本不占内存。
五、静态网页、防火墙与多环境:差点把送上门的 AI 流量拦在门外
前面几章折腾的是额度和稳定性,这一章要是不注意,掉的可是实打实的新用户和订单。
1. 巡检吓一跳:Cloudflare 默认开关差点拦住 AI 搜索爬虫
前面提过,我那个出海 SaaS 站,第 46 周新增的 171 个注册用户里,有 109 个来自 ChatGPT;连开张的第一笔 12 美金订单也是 ChatGPT 推过来的。
对现在的独立站来说,谷歌和各家 AI 搜索就是最核心的免费流量来源。
结果前两天我拿脚本挨个检查自己几个站对 AI 爬虫的访问情况时,后背直接凉了半截:
-
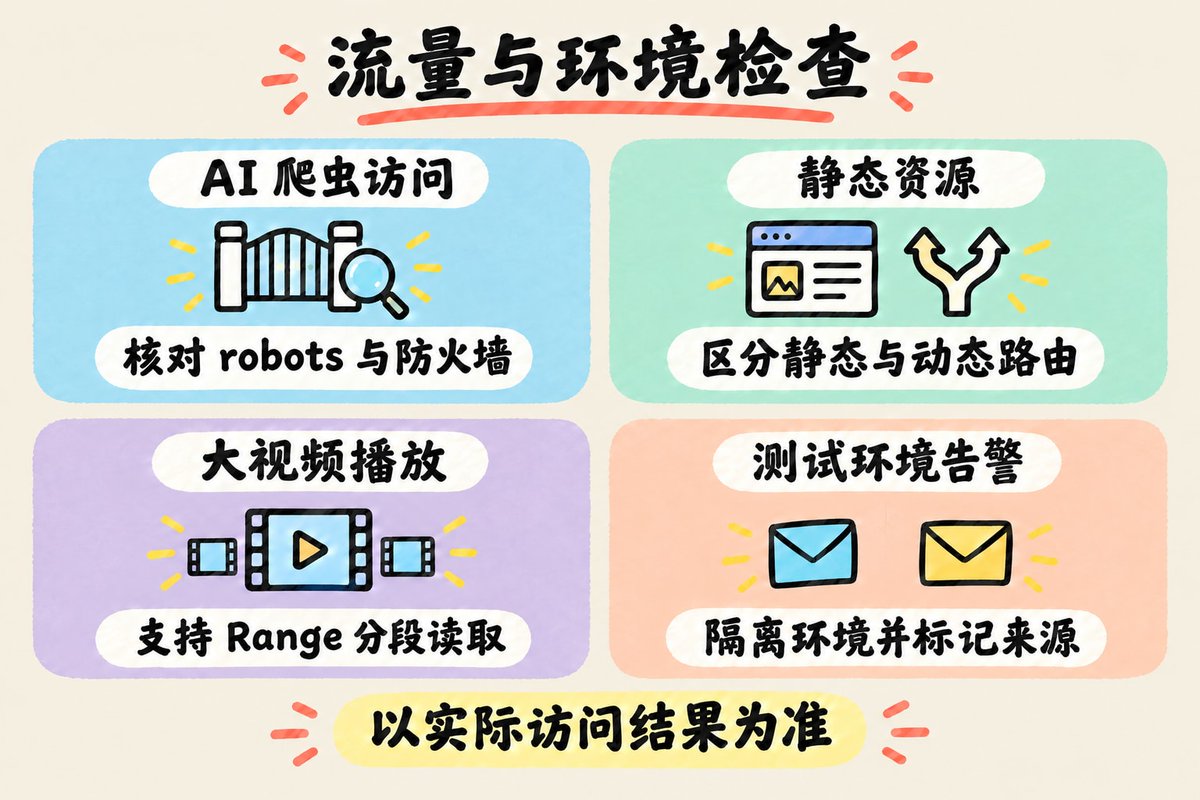
我压根没在代码里写过屏蔽规则,但 Cloudflare 后台有个默认开启的托管开关叫 Bot Preference Sync,暗地里自动往网站的 robots.txt 里塞了一段拦截规则,把 ChatGPT-User 和 Claude-User 给挡住了!
-
同时后台内置防机器人功能(SBFM)里的一条防 AI 训练策略(日志代号 BOBA-161),对着来抓网页的 PerplexityBot 直接返回了 403 禁止访问。
幸亏发现得及时。赶紧关掉那个自动同步开关,再去防火墙(WAF)自定义规则里给 PerplexityBot 和 OAI-SearchBot 加上放行白名单,亲眼看着返回状态码从 403 变回 200,心才放回肚子里。
如果你也在用 Cloudflare 托管出海站,不妨顺手去后台看一眼这两个开关,别辛辛苦苦写完内容没流量,最后发现是被默认规则拦在了门外。
2. 托管静态前端容易栽的 4 个小坑
用 Cloudflare Workers Static Assets 托管前端静态页面时,这四个细节也顺手理清了:
-
别乱开全局 run_worker_first:正常情况下,纯静态网页、JS 和图片免费不限量。但如果你在配置里设成了全局 run_worker_first: true,用户每加载一张图、一个脚本都会先走一遍 Worker 计次扣额度,白白吃掉每天 10 万次的免费请求额度;而且一旦扣光,静态文件会直接报 Error 1027 或 429 打不开,绝不会自动退回免费静态托管。记得保持默认 false,或者只指定 ["/api/*"] 这类动态接口走 Worker。
-
苹果 Safari 上大视频拖不动进度条:默认静态托管会忽略浏览器发来的分段读取请求(Range),不管你想看第几秒都直接把整个视频塞回来(返回 200 OK)。电脑浏览器还能凑合播,一到 iPhone 和 Mac 的 Safari 上,大演示视频经常卡在第一画面或者根本拖不动进度条。把大视频挪到支持分段返回(206 Partial Content)的 R2 + Worker 路由上就解决了。
-
网址尾斜杠 307 跳转与静态长缓存:如果写了自动加减网址末尾斜杠的跳转规则,记得把谷歌站长验证文件这类根目录 HTML 排除掉,不然验证直接吃 307 失败;带版本号指纹的 JS/CSS 记得在 public/_headers 里配上长期缓存。
-
登录注册防刷别再往 D1 数据库里记了:以前防别人恶意刷登录、刷验证码,习惯在 D1 建张限流表记次数。真碰上有人拿脚本狂刷接口,这张表分分钟把每天 10 万行的免费写入额度耗光。直接改成绑定 Workers 原生自带的免费限流器 RATE_LIMITER,在门口就把恶意请求拦掉,数据库 0 次写入。
3. 昨天周日刚闹的“测试环境告警乌龙”
顺带记录一个昨天(11 月 15 号周日)刚发生的乌龙,只要项目区分了测试环境和正式环境就很容易撞上。
为了给我的 staging 预发测试环境省额度、少刷无用日志,我把测试环境的定时任务从“每分钟跑一次(一天 1,440 次)”改成了“每小时只跑第 8 分和第 39 分两次”(8,39 * * * *)——一天只跑 48 次,一下子砍掉了 95% 以上的空跑,奇偶分钟的两套巡检逻辑也都能覆盖到。
结果前天(14 号)半夜刚修完线上崩库去睡觉,昨天早上睁眼一看手机,邮箱里又躺着好几封每个小时准点发来的异常告警邮件——而且因为邮件标题一模一样,Gmail 直接把它自动合并进了前一天晚上正式库故障的那串邮件里!我迷迷糊糊一看差点魂飞魄散,还以为正式环境又挂了。
爬起来查完日志真是哭笑不得:是我那个测试环境的定时任务按点醒来,扫到了测试库里 11 天前留下来的一条早就关机的本地测试机器记录,于是老老实实每个小时发邮件跟我汇报“有台机器失联了”。
当场改了两条硬规矩:所有发往外面的告警邮件和飞书群通知,一律只准 production 正式环境发送;测试环境就算调试发信,标题最前面也必须强制带上 [staging] 标记,再也不自己吓自己了。
六、99 元小服务器怎么配?什么时候才该花那 5 美金?
整套盘下来其实很明显:靠 Cloudflare 全家桶,确实能把前端页面、接口路由、轻量数据库、对象存储和定时任务搭得又快又省钱。
但只要你做的是带点重活的 AI 出海工具站,光靠 Cloudflare 往往还是不够。
原因很现实:一是碰到过上游大模型接口直接给 Cloudflare 公共出口 IP 返 1015 限流拦截;二是几十张高清大图批量打包、或者跑轻量 u2netp 模型给图片批处理抠背景,塞进 128 MB 内存、10 毫秒限制的 Workers 里根本跑不动。
所以我的方案是:额外配一台一年只要 99 块钱、1.7 GB 内存(且没开 Swap 虚拟内存)的轻量 Linux 小服务器专门干重活。
1. 1.7 GB 内存的小机器怎么跟 Cloudflare 配合才不死机?
安全连接的方式很简单:这台小服务器公网入站端口一个都不开,也不搞公网反向代理。 只在里面跑一个轻量常驻程序,主动定时去问 Cloudflare Worker“有没有重活要干”,领到活算完直接把成品传进 R2、回传一个完成凭证就完事。
因为 1.7 GB 内存连虚拟内存兜底都没有,稍微浪一点就会内存爆满死机。我在这台小机器上实测管用的防爆三招如下:
-
正式环境千万别带 tsx 直接跑源码:开发时图省事用 --import tsx 直接跑 TypeScript 很顺手,但在 1.7 GB 的小机器上,光这层工具常驻内存就要白吃掉差不多 180 MiB!改成提前打包成纯 JS 文件再用原生 Node 启动,实测服务空闲内存直接压到了 54.8 MiB;启动脚本里再加一道源码哈希核对,防止改了代码忘重新打包;
-
抠图模型改成常驻批处理:以前处理 64 张图片抠图,傻乎乎启动 64 次 Python 反复加载 u2netp ONNX 模型,又慢又吃内存。改成 --batch 常驻进程,模型只加载一次,逐张流式处理完顺手删掉中间临时文件;
-
处理大文件别转超长字符串,再给进程设好内存封顶:在 Node.js 里处理几十上百兆的图片视频时,别转成 Base64 长字符串去做拼接或正则替换,字符串编码会让内存瞬间膨胀出 6 倍左右的占用;老老实实用二进制 Buffer.concat 分段拼接,同时在 systemd 里用 MemoryMax 给干重活的进程和守卫进程设死内存上限——万一哪个任务真失控了,最多单任务温和退出,绝不会把整台小机器拖死。
2. 什么时候才该花那 5 美金?(免费版 → 付费版升级对照表)
回到开头大家最关心的问题:新站冷启动先用免费版挺香,到底出现什么信号时,才说明真到了该掏 5 美金升级 Workers Paid 的时候?
我把写进自己规范里的几条定量判断线整理成了下面这张表,按着对照就行:
| 核心指标 | 免费版日常安全线 | 出现这个信号,痛快花 5 美金升级 | 升付费版后给什么,及花钱也不变的限制 |
|---|---|---|---|
| D1 数据库读/写 | 日读低于 300 万行、日写低于 6.5 万行 | 连续 3 天真实业务日读超 300 万行,或日写超 6.5 万行 | 给到 250 亿行读/月、5,000 万行写/月;6 并发和 5 段 UNION ALL 上限不变 |
| D1 单库大小 | 小于 350 MB | 清掉无用垃圾数据后持续大于 350 MB(免费上限 500 MB) | 单库上限扩到 10 GB,历史恢复(Time Travel)延长到 30 天 |
| Workers 请求与耗时 | 日请求低于 7 万、单次 CPU 小于 8 毫秒 | 真实日请求超 7 万,或确实没法挪走的重接口实测 CPU 超 8 毫秒 | 给到 1,000 万请求/月和 30 秒~300 秒 CPU;128 MB 共享内存不变! |
| Queues 队列操作 | 正常业务低于 7,000 次操作/天 | 确认没有死循环重试后,有效操作量持续高于 7,000 次/天 | 提升到每月 100 万次操作 |
| R2 文件存储 | 低于 8.5 GB | 清掉未完成分片和临时文件后,长期有效文件超过 8.5 GB | 超出部分按 $0.015 / GB-月计费,依然免下载流量费 |
3. 现在的发版习惯:上线前先让 Agent 过三遍筛子
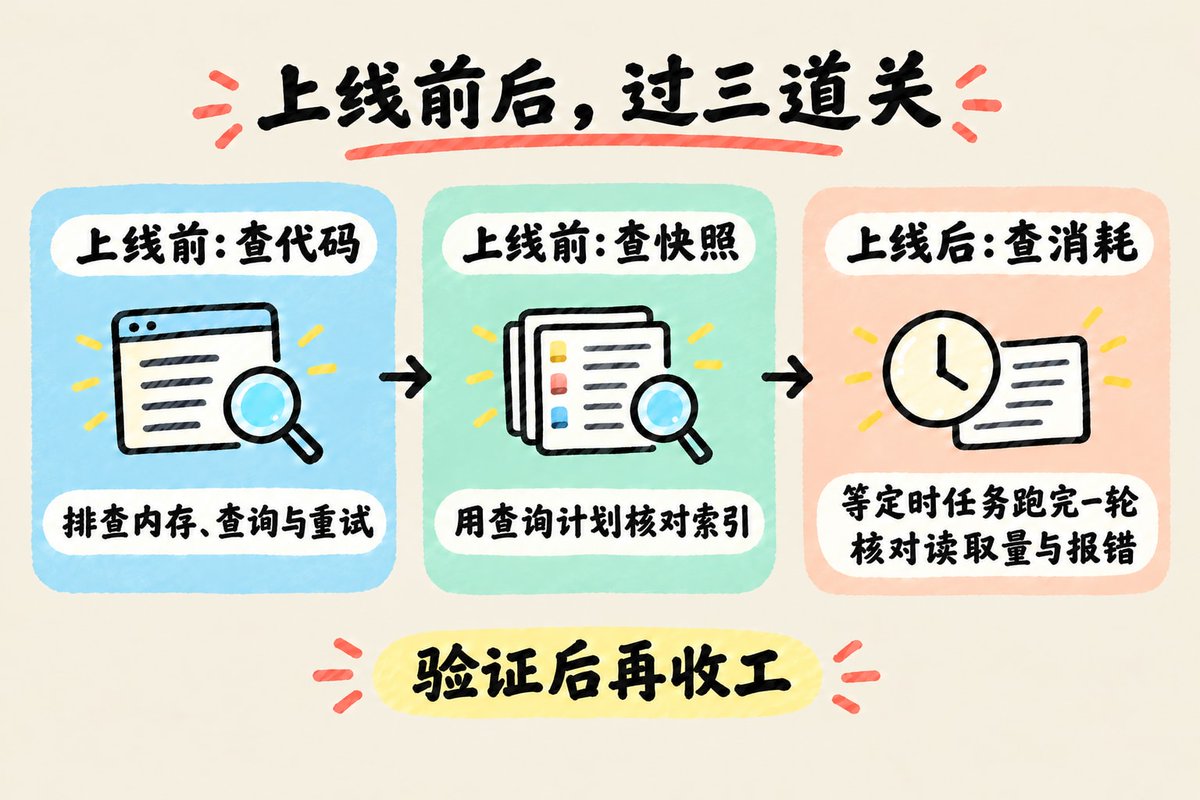
折腾完这一通,我把这次踩过的所有坑全写成了一份专门的检查 Skill,塞进了我的 AI Agent 工作流里。现在只要改到 Cloudflare 后端代码,发版前固定过三步:
-
第一步:扫一遍代码隐患——查有没有超过 5 段的 UNION ALL、有没有对大文件调 .bytes() 全读进内存、有没有把 Proxy 直接塞进 db.batch()、有没有失败隔 2 秒就重来的队列死循环、R2 桶的自动清理规则配齐没有;
-
第二步:拉本地快照查慢查询——想做数据统计或排查问题,先拉本地快照副本,把核心查询全过一遍本地 SQLite 的 EXPLAIN QUERY PLAN,但凡在主表和循环里看到整表硬翻(SCAN),没改成走索引目录(SEARCH)之前绝不上线;
-
第三步:发完版先等 75 秒以上看账单——代码推上去别急着关终端,等上 75 秒以上确保刚上线的定时任务至少完整跑完一轮,再调 Cloudflare GraphQL 接口看一眼最新一分钟的消耗:亲眼确认每分钟 rowsRead 稳稳落在百行级别、报错数是 0,这才算真正收工。
最后说几句
写完这篇长复盘,我也长舒了一口气。
以前总觉得用上免运维的云服务,就能当甩手掌柜,再也不用操心数据库索引、内存占用这些基本功了。
真摔过一跤才明白:省下来的服务器租金不会凭空消失,前期偷过的懒,早晚得在真实用户和流量进来那天连本带利补上。
好在现在才刚出头两单,盘子还小。趁早花几个小时睡眠和 5 美金月费把底子打结实,总比以后真来了大波流量再手忙脚乱强得多。
基建的坑填平了,明天继续干正事——老老实实挖词、上页面、搞流量!
好咯,今天就到这里啦,我们明天见。
我是浅水虾,记录出海建站路上的真实折腾,踩过的坑都写出来。觉得有用就点个赞、转给同样在折腾的朋友。


