
我们如何用好 Claude Code ?官方最佳实践分享
文章目录
Claude Code 最新的官方最佳实践分享来啦!!!
最近,我把 Claude Code 官方技术团队的 Lydia Hallie 在 AI Engineer Code Summit 上的这场分享认真看完了,发现很多人手里那套 Claude Code 用法,还停留在今年年初。
很多人问我,现在 Claude Code 到底该怎么配,用哪个模型,CLAUDE.md 要不要写那么长,auto mode 能不能开。
今天,我就把 Lydia 这 20 分钟讲的官方最佳使用实践,按整理成一篇文章,分享给大家。
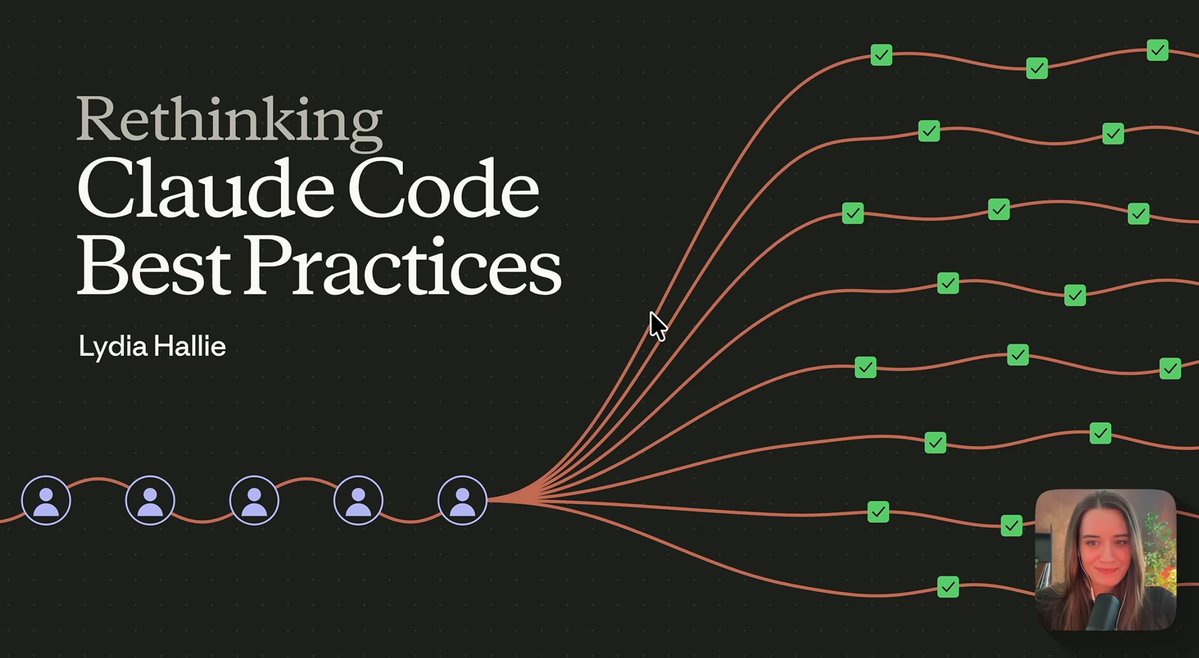
总结起来其实就几步:先换掉默认模型,再给 CLAUDE.md 瘦身,然后用 deny rule、沙箱和云端把安全兜住,设置多个验证点、hook 和 CI 把质量兜住,最后,还可以让一个会话去编排 Agent 其他会话。
大家好,我是 Kin,SpaceXSI 社区 Built 大使,致力于研究 AI、自媒体和企业 AI 培训及转型,裸辞创业一个多月后推特就突破了一万粉。
先交代一下背景。这场分享是前几天 11 月 12 日, AI Engineer Code Summit峰会上的一个演讲,分享者是 Lydia Hallie,Anthropic 技术团队成员,就职于 Claude Code 团队。
有个小插曲:她当天上午在现场遇到了技术故障,于是跑回家,对着自己的电脑重新录了一遍视频。我这篇内容,就是按她重录的视频整理的,视频链接我放在文末,大家看完文章后,也可以去看一遍视频。。
话不多说,我们直接发车!
先回忆一下:年初我们是怎么用 Claude Code 的
不知道你还记不记得,年初那会儿用的模型是 Opus 4.5。Lydia 说她当时挺喜欢它的,放在那个时间点确实很好用。
可跟今天比,它停得早,跑一小会儿就停下来等你。你得一直纠正它、提醒它,然后往 CLAUDE.md 里塞一堆重要提醒 IMPORTANT,再加一串串感叹号。
那时候也还没有 auto mode。要么每条命令手动点批准,要么开 dangerously skip permissions 裸崩硬冲。人基本被钉在循环里,一次也就照看几个会话窗口。
然后呢,到了现在,Anthropic 内部的会话已经变成这样:
-
多窗口:同时跑几十个会话
-
长程任务:一个会话连续跑好几个小时
-
自主验证:Claude 一边干活一边验证自己的结果
-
编排协作:有主 Agent 专门负责编排其他 Agent 会话
人从每一步都盯着的操作员,变成了管着几十个会话的经理。产出也跟着上去了。Anthropic 10 月发过一篇博客,公司内部的代码变更量,从 5 月大约每天 2,500 次,涨到 9 月每天超过 30,000 次。
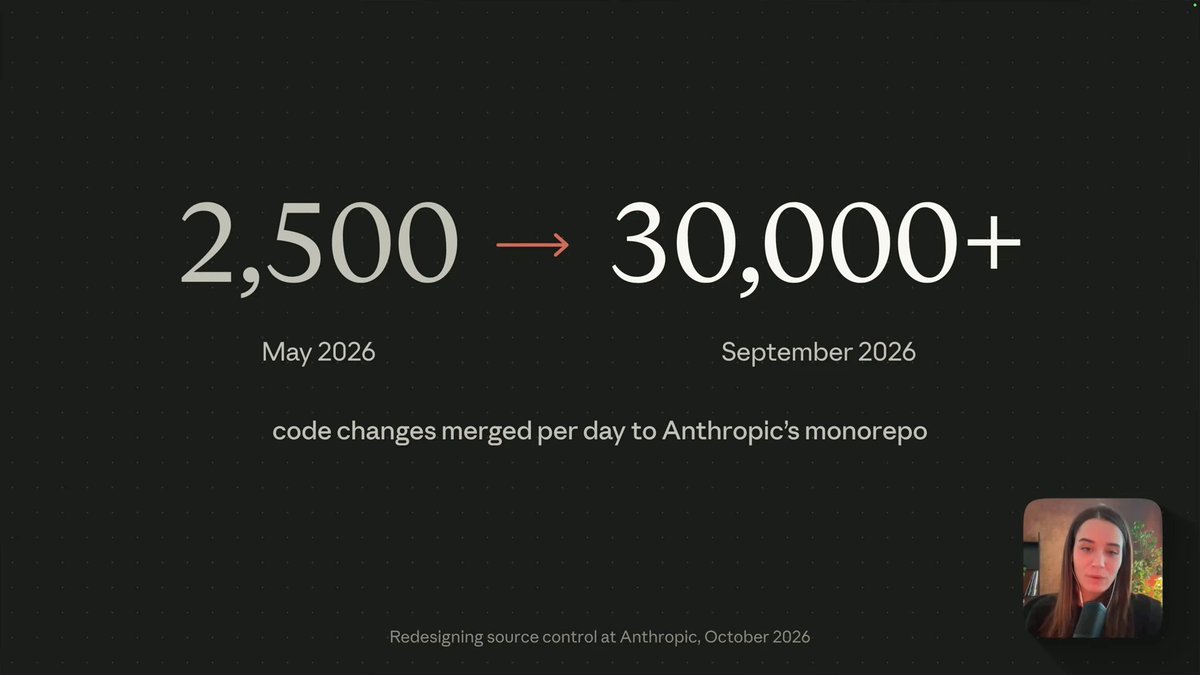
Anthropic 内部每日合入的代码变更:2026 年 5 月约 2,500 次,9 月超过 30,000 次。图为 Lydia 现场幻灯片,下同。
Lydia 把年初那套 Claude Code 最佳实践,迭代拆成了人要亲手干的五件事:掌舵、批准命令、说不(拦住危险操作)、检查输出、亲手开会话。
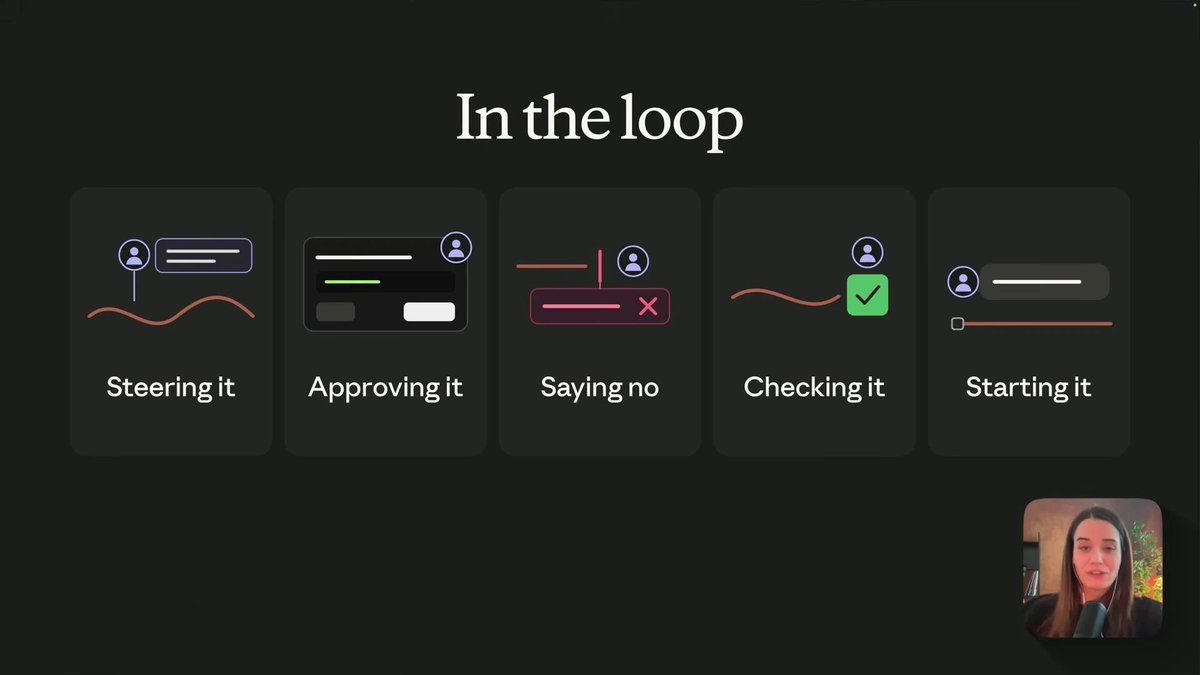
Lydia 把人在循环里的动作拆成五件:掌舵、批准、拦住危险操作、检查输出、亲手开会话。
她的思路是这样的:人每从一个环节里撤出来,就得有别的东西顶上去。能顶上去的有三样,模型、harness,还有会话运行的环境。
那问题就来了。人不在场,代码质量谁来保证?一个会话跑几个小时没人看,安全又谁来保证?一起来看看官方的最佳实践吧:
第一步:先把默认值换掉
这一步在干嘛:把模型和权限模式换成现在的默认设置。Lydia 说这一步不用多想,因为新会话本来就是这么配的。
模型从 Opus 4.5 换成 Opus 5.5。Opus 5.5 是 Lydia 自己日常用得最多的模型,它更懂你的意图,也更读得懂你的代码库,中途需要你去掰方向的次数少了很多。
她开场还提了一句,这周早些时候 Fable 5.2 也刚上线。这两个模型都很擅长长时间任务和理解代码库,Fable 尤其擅长验证自己的输出。
权限从手动批准换成 auto mode。Anthropic 从 8 月开始,就把 auto mode 设成了默认权限模式,你不用再一条一条点批准。
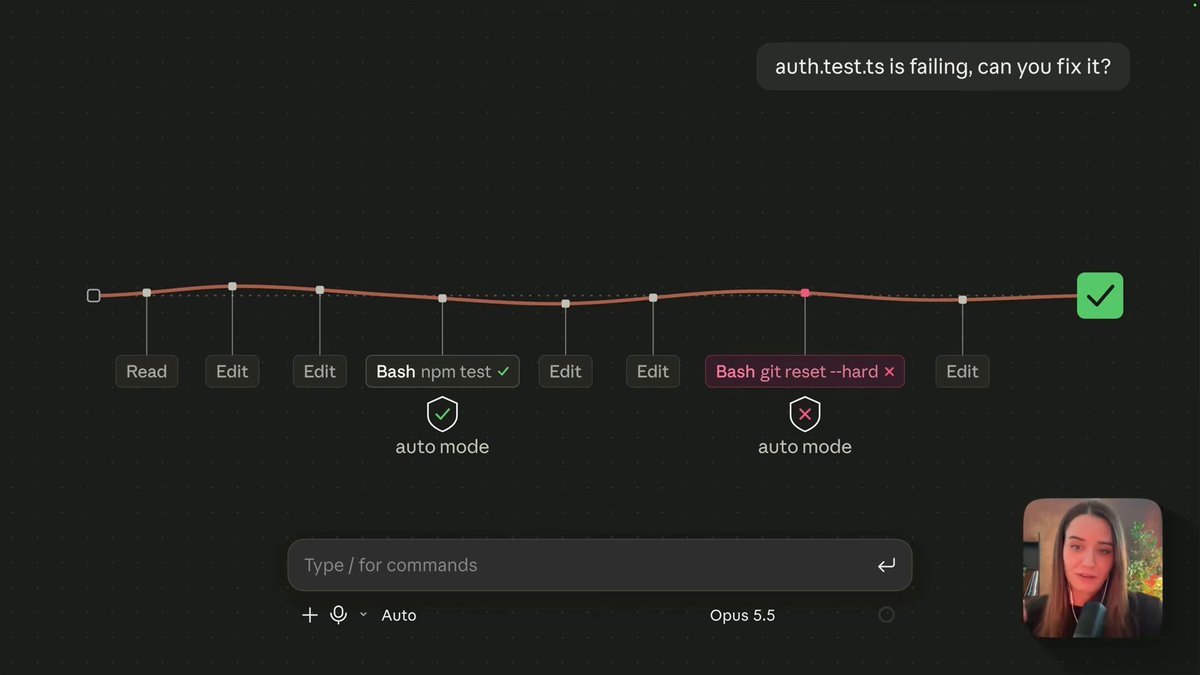
换成 auto mode 之后,测试这类命令可以由它放行,像 git reset --hard 这类操作会被拦住。
就这两下,掌舵交给了模型,批准交给了 auto mode,循环里大部分活已经没你什么事了。
不过 Lydia 紧接着说了一句我很认同的话:退出循环很容易,难的是确认你不在的时候也没问题。后面整场,其实都在回答这件事。
第二步:给 CLAUDE.md 瘦身,只留代码里看不出来的
这一步在干嘛:模型变聪明了,写给它的指令也得跟着改。
如果你照年初的最佳实践写过 CLAUDE.md,里面大概率还躺着 IMPORTANT、NEVER do this!!! 这类东西。
Lydia 说,对今天的模型来说,这些已经用不上了,反而会把模型带偏,工具调用变多,整体结果变差。
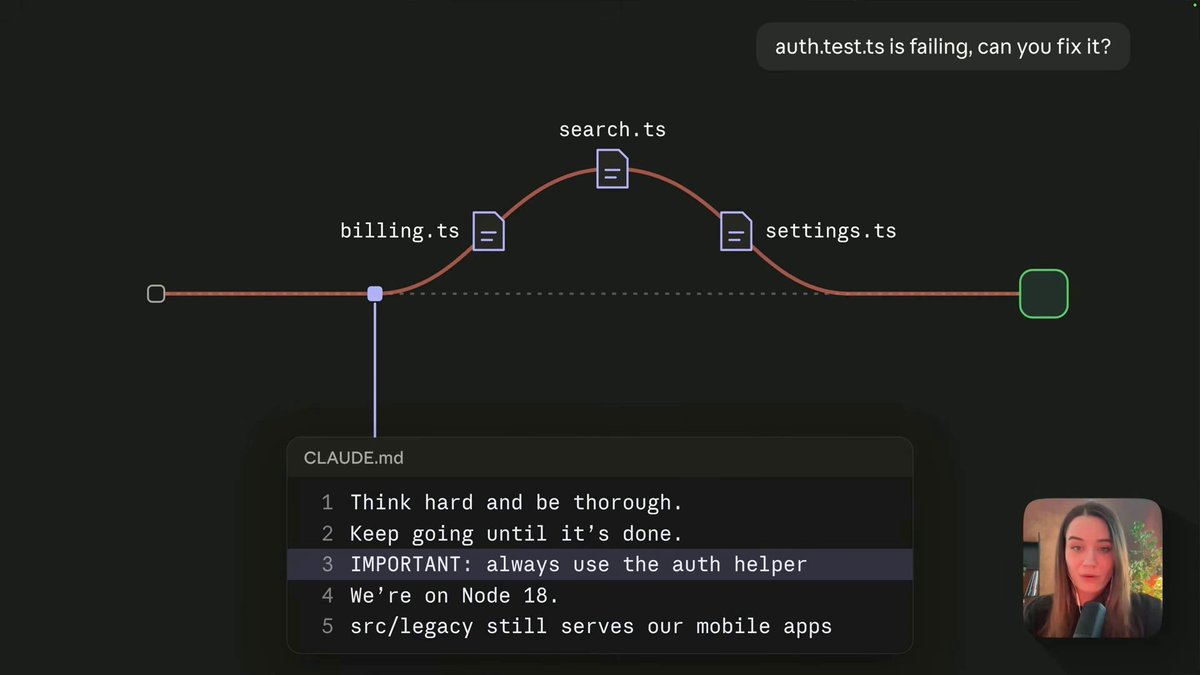
CLAUDE.md 里还写着「always use the auth helper」时,修一个失败的测试,模型可能绕去改 billing、search、settings。
那到底留什么、删什么?她给的判断标准很简单:这条信息,Claude 自己读代码能不能看出来?
看不出来的,留着。她举的例子是,某个服务还在用一个老数据源,可代码里并没有直接引用它,工程师翻仓库都可能漏掉。
看得出来的,删掉。比如用的什么技术栈、去哪个目录找东西,模型自己读得出来,用不着你写。
Claude Code 里还有个命令专门干这件事,叫 /doctor prompt-audit。它会按你选的模型去优化环境。打个比方,你现在用的是 Opus 5.5,跑一下这个命令,它会自动检查你的 CLAUDE.md 和 skills,把新模型已经用不上的内容找出来。
我的建议是,每次换模型都顺手跑一遍。给老模型写的那些大写和感叹号,放到新模型身上,很可能就成了噪音。
第三步:搞清楚 auto mode 会拦,也会漏
这一步在干嘛:弄明白 auto mode 到底怎么判断,以及它兜不住的地方在哪。
先说它怎么工作。除了在项目里读文件、改文件,几乎所有别的动作,auto mode 都会单独跑一个分类器(classifier)来判断。它确定安全的就放行,比如跑测试、装依赖;拿不准的就拦下来。
大多数时候这样刚刚好。可 Lydia 举了个特别真实的例子:你让 Claude 把改动发到 staging。你心里清楚,部署就是往另一个 deploy 仓库 push 一下,要是你自己在场,肯定直接点批准。
可 auto mode 默认只信任当前文件夹和当前仓库,deploy 仓库在范围外,push 就被拦了,你又被拉回键盘前。
她说默认值在多数情况下够用。如果你开了 auto mode 还老是要手动批准,第一个该去看的就是设置。auto mode 可以在你自己的设置里用大白话来配:
-
你信任哪些仓库、bucket、域名
-
哪些动作永远允许,哪些永远不做
你写的这段文字会直接发给分类器,由它来决定放行还是拒绝。
那配好了就万事大吉了吗?也没有。auto mode 是在跟模型合作,多数时候模型会照你说的做,可这算不上保证。
Anthropic 8 月发过一项研究,拿 auto mode 跟真人把关做了对比:
-
真人在循环里的时候,只有大约 14% 的人拦住了明显危险的命令
-
auto mode 拦住了 89%
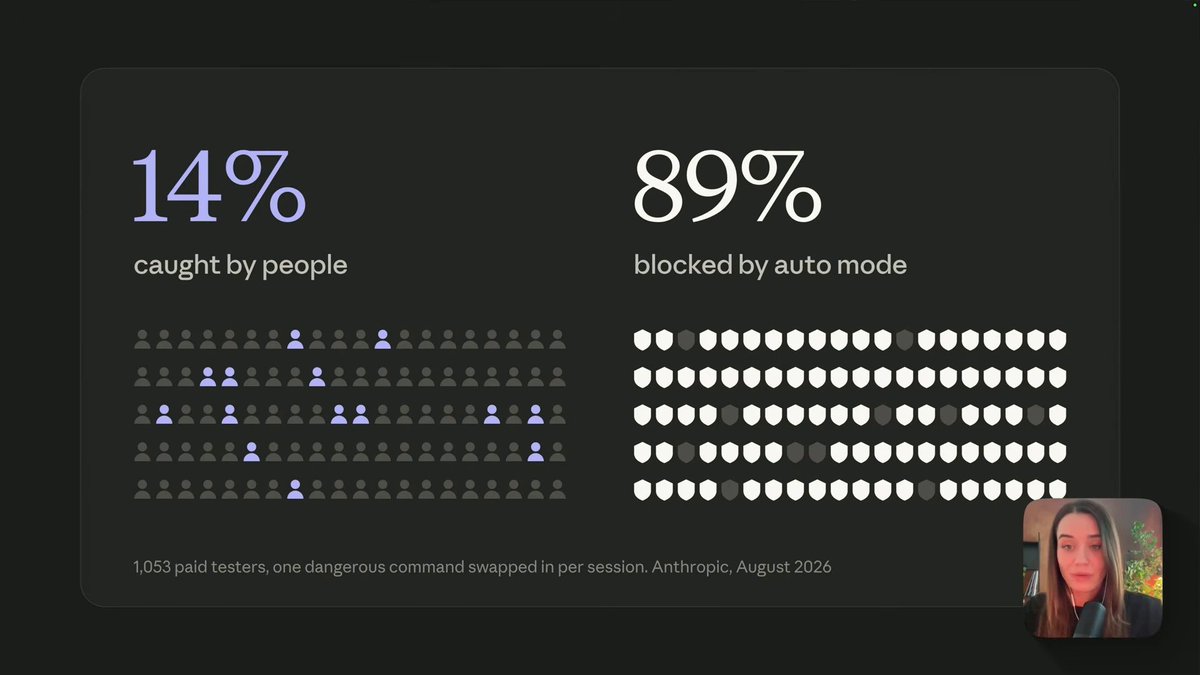
Anthropic 2026 年 8 月的研究:1,053 名付费测试者,每场会话混入一条危险命令。真人拦住约 14%,auto mode 拦住 89%。
它比人强太多了,可算下来,大约十条里还是有一条漏了过去。
第四步:绝对限制 AI 做的事,写成 deny rule
这一步在干嘛:把绝对不能发生的事,交给 harness 去强制执行。
为什么要单独写规则?原因很简单,想要保证,只能靠 harness 强制执行。年初那套最佳实践里,到今天还完全管用的就是这一块:权限。
你在项目里给某个工具调用写一条 deny rule,Claude Code 会先查这条规则,然后才轮到分类器。命中 deny rule 的调用,分类器根本看不到。所以想让 Claude 绝对不做某件事,deny rule 依然最稳。
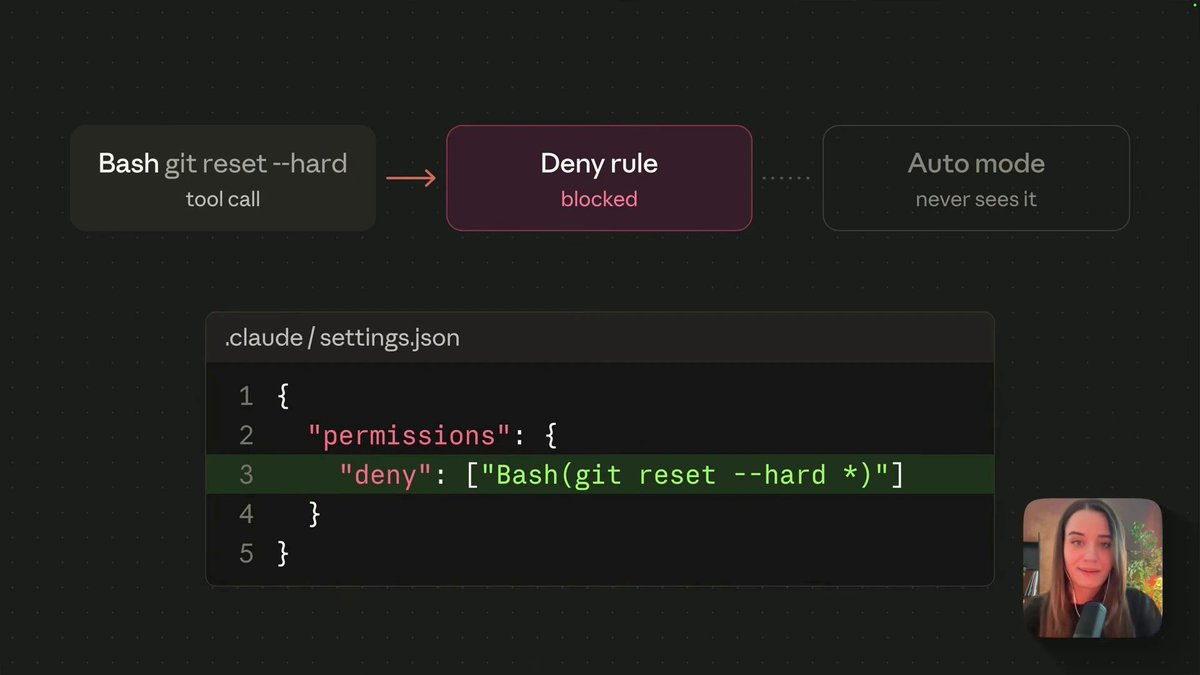
命中 deny rule 的调用会直接被拦住,auto mode 的分类器根本看不到。
那哪些写成规则,哪些交给模型自己判断?Lydia 的标准是问自己:Claude 错一次,我能不能撤回来?
能撤回的,交给模型。代码写错了,revert 一下就行。
撤不回的,写成规则。比如没 commit 的改动被扔掉了,那可能就是唯一的一份;再比如某个密钥被读了,值已经进了会话记录(transcript),想收回也来不及了。
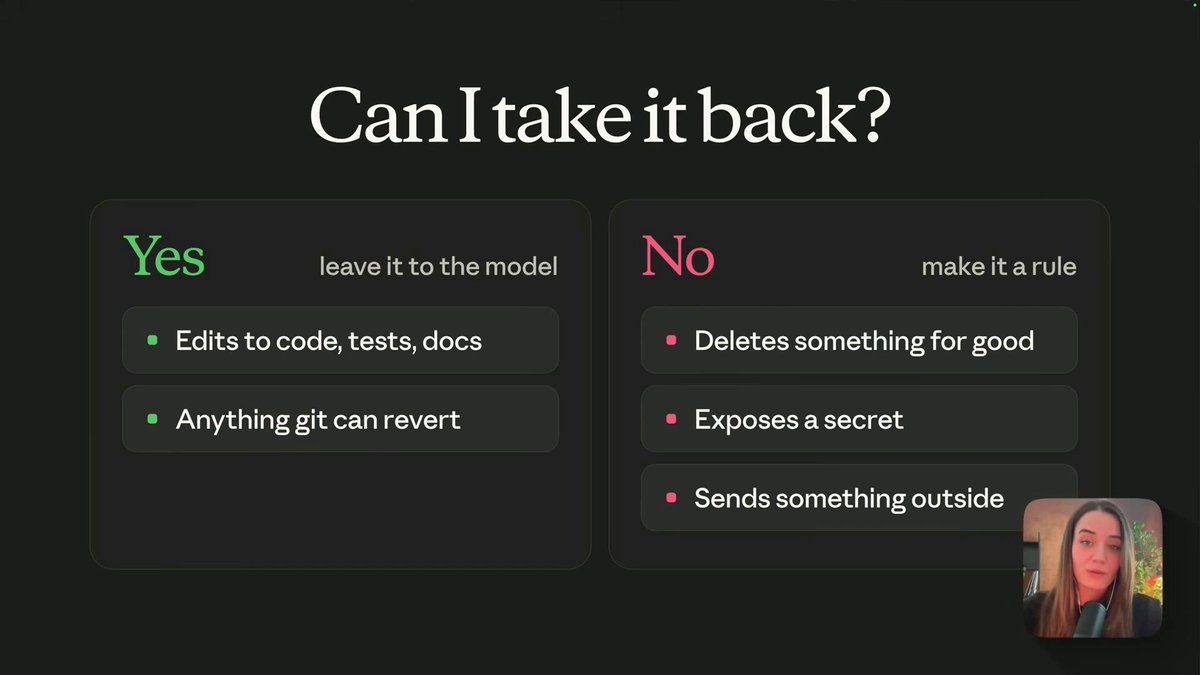
Lydia 的判断标准:错了能不能撤回来。能撤回的交给模型,撤不回的写成规则。
她举的例子是项目里的 .env。默认情况下,auto mode 觉得读它没什么问题,会直接放行。加上一条 deny rule 之后,就连 cat .env 这种直接点名这个文件的命令,也打不开它了。
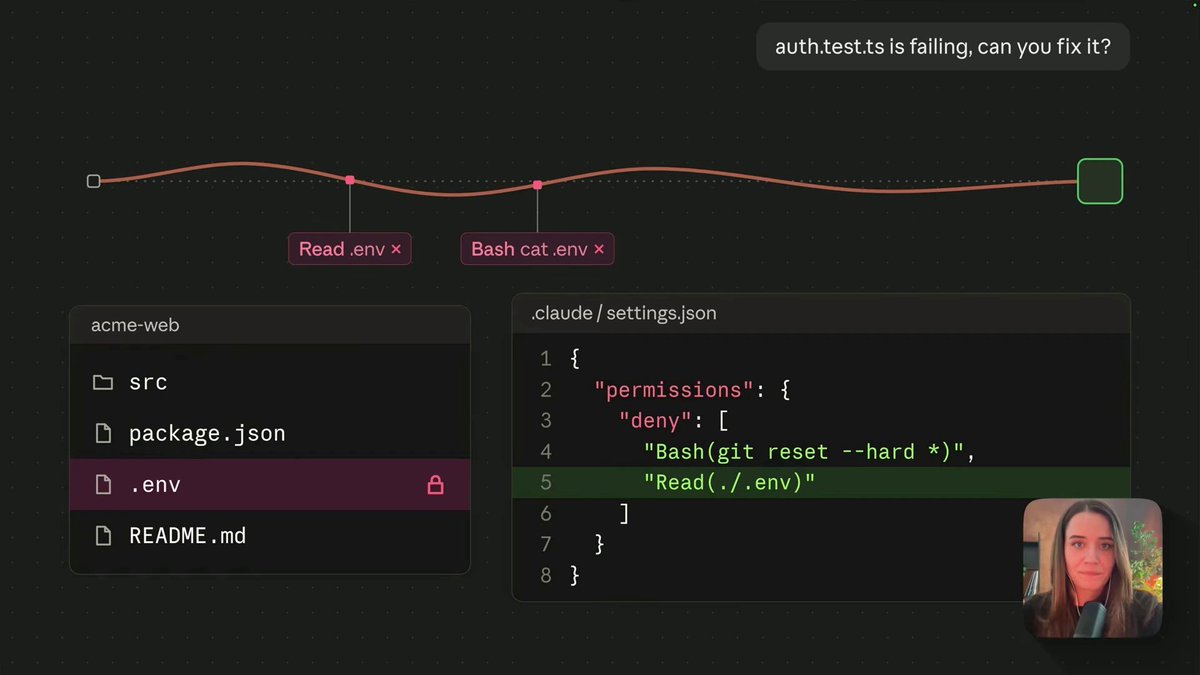
给 .env 加上 deny rule 之后,直接读文件,或者用 cat .env,都会被拦住。
第五步:测试跑起来以后,靠沙箱和云端兜底
这一步在干嘛:deny rule 管的是命令本身,这一步要管的是命令跑起来以后能碰到什么。
deny rule 能拦住命令里直接写了文件名的情况。麻烦在于,有些命令的副作用藏在运行过程里。
比如 npm test。这么普通的命令,auto mode 会放行,你在场也会放行。可它跑的是你没亲手写过的代码,可能是你的依赖,也可能是 Claude 顺手写来查东西的小脚本。
万一其中某一个被投毒了,它完全可以在运行时打开同一个 .env,或者你的 SSH 密钥,然后发到一个你从来没听说过的服务器上。
Lydia 这里说得挺扎心的:就算人还在场、每条都亲自批,我们也会点 allow。因为批准的那一刻,你看到的只是 npm test,没什么理由拒绝。
权限只决定一个工具调用能不能跑,管不了它跑起来以后能碰到什么。而 npm test 又不能拦,跑测试本来就是 Claude 自查的方式。所以要限制的,是它跑在什么样的环境里。
本地跑:开沙箱
开了本地 shell 沙箱以后,你可以控制一条命令能读哪些文件、能写哪些目录、能连哪些主机,这些由操作系统来强制执行。
而且这些限制会继承给它启动的所有子进程。测试再去拉起别的程序,一样受限。
解释下这里的区别:没有沙箱的时候,那条 deny rule 只在命令运行前由 Claude 查一次,而那时它只看得到 npm test 这几个字。开了沙箱,同一条规则会交给操作系统去执行,依赖真去打开 .env 的那一刻,操作系统直接拒绝。
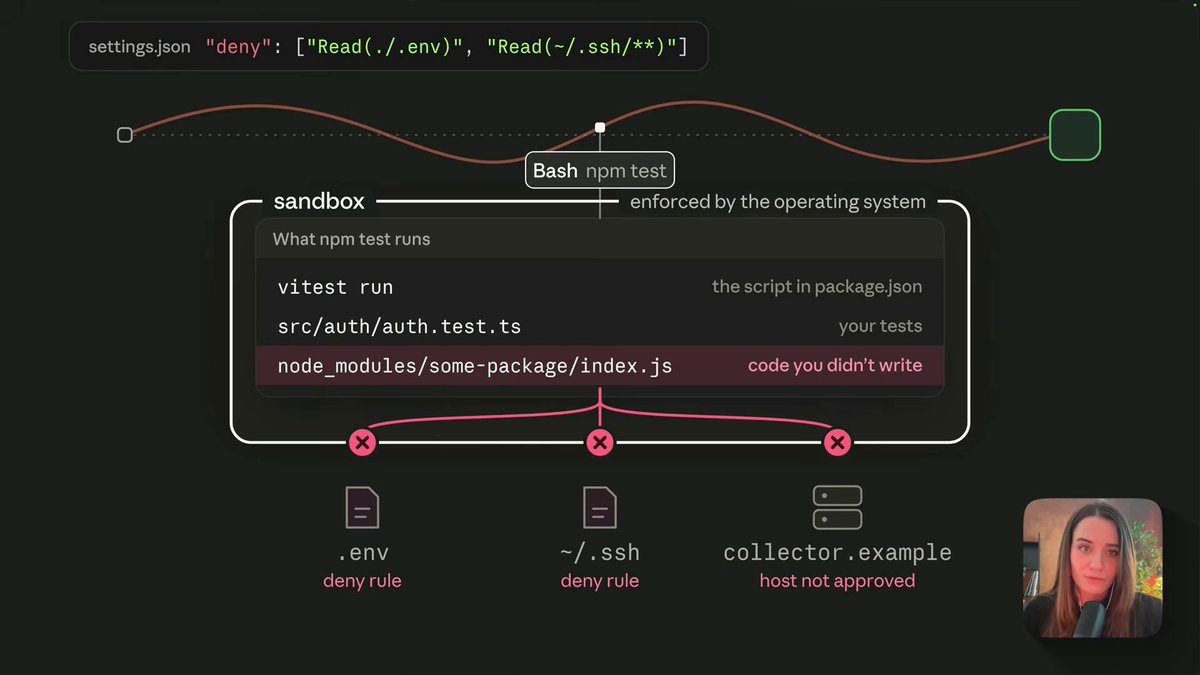
npm test 拉起的依赖如果想读 .env 或 SSH 密钥,会被沙箱挡住。
两条路径放一起对比一下:
-
cat .env 直接读:执行前就被 deny rule 拦下,分类器都看不到
-
npm test 里的依赖去读 .env:执行过程中,沙箱让操作系统拒绝
沙箱也有边界,Lydia 讲得很清楚。默认情况下,沙箱里的命令还是能读你机器上的大部分东西,你在乎 SSH 密钥的话,得再加一条规则;没批准过的主机,它连不上。
另外,沙箱只管 Claude 跑的 shell 命令和这些命令启动的进程。Claude 自己的文件、你的 MCP 服务器、你所有的 hook,都在沙箱外面。
最彻底的办法:放到云端上开发
那有没有更省心的办法?有,就是让整个会话跑在一台本来就没有这些东西的机器上,也就是云端会话(cloud session)。
它是一台独立的机器,拿到的是一份全新的仓库副本。你合上笔记本它照样跑,几个小时的长任务就适合放在这儿。
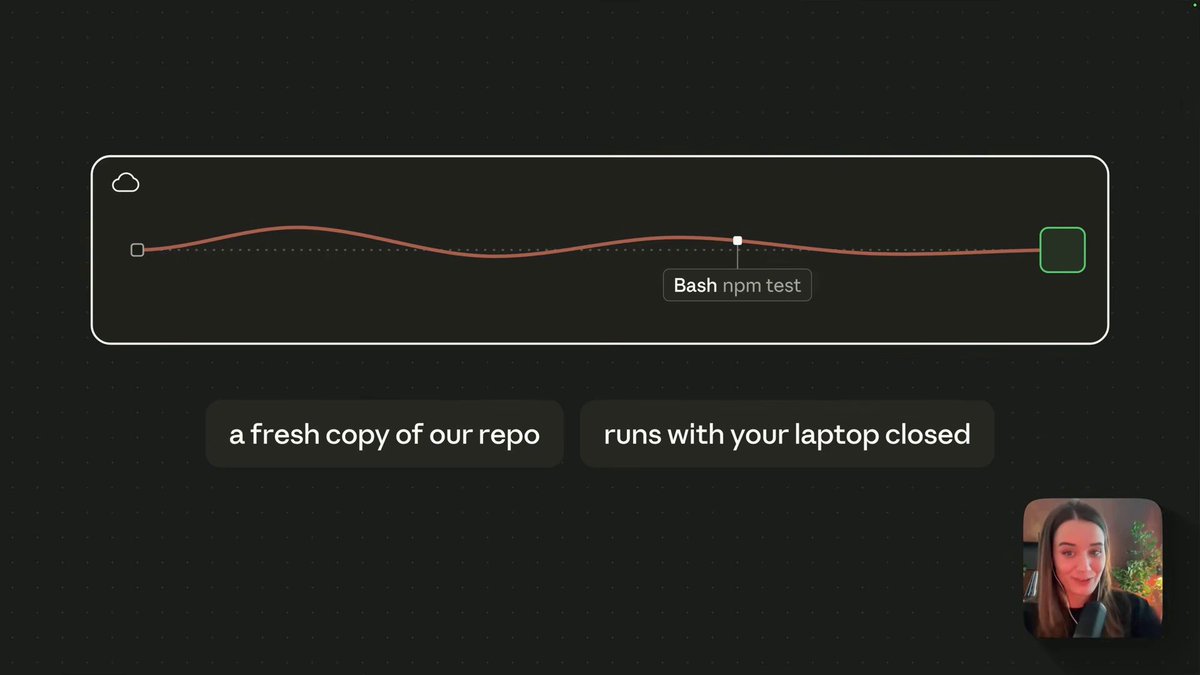
云端会话跑在一份全新的仓库副本上,合上笔记本它也能继续跑测试。
.env 不在 Git 里,SSH 密钥和 GitHub token 也不在,所以 checkout 下来的仓库里压根没有这些东西。
中途要是缺 API key,会话会直接告诉你「我缺一个 API key」。你把它加成 network secret,会话就能用了,而且 key 的值永远不会发给模型。
网络默认只通包管理源(package registries)和 GitHub 这类地方。要连别的主机,得你自己显式把域名加进环境里。
Lydia 特别提醒了一点:机器是一次性的,可从机器里出去的东西收不回来。push 出去的 commit、通过 connector 发出去的消息,机器销毁了它们也还在。
所以她在云端照样开着 auto mode,还会把项目的 deny rule commit 进仓库。这样每次全新 checkout,规则都会跟着过来,force push、commit 里夹带密钥这类事,照样拦得住。
安全兜住了,接下来要确认 Claude 干的活到底对不对。
以前人在循环里,每个改动都看过、批过,心里有底。现在 Claude 在后台一跑几个小时,你也不可能最后把每个文件都读一遍。
Lydia 举的例子是让 Claude 把登录(auth)迁到新 API。Claude 很清楚你要什么,可一路上还有一大堆小决定得它自己拍板。同样一个 prompt,可能跑出三种结果:
-
迁过去了,老 API 还留着
-
迁过去了,只对新登录生效
-
迁过去了,把所有人都登出了
三种看着都挺合理。一个新用户能登录成功,对那些已经登录的老用户来说几乎说明不了什么。
那怎么办?在路上设验证点,让 Claude 边干边验。
验证点就是任何能给出 pass 或 fail 的东西,测试、一次 build、一张截图都行,手上有什么用什么。
关键是挑那种能分清对错的检查。比如老会话必须保住,那就把「已登录用户不被踢掉」设成第一道检查。把所有人都登出的那个版本过不了这一关,只能回去换个办法。
然后你只需要审这些验证点。审几个挑好的检查,比到最后对着整个 diff 倒推每一个决定,要省事得多。
最简单的设置位置就是 prompt:写清楚做完是什么样子,让它把活拆成几个任务、每个任务有自己的测试,再让它把实际的输出拿给你看。
第七步:必须跑的检查交给 hook,记得退出码要是 2
prompt 只是请求,模型不一定照做。必须执行的检查,得交给 hook。
hook 是 Claude Code 在指定时机运行的脚本,什么时候跑、跑什么、查什么,都由你来定。Lydia 给了三个时机:
-
每次改完文件,跑一下 linter,Claude 立刻就能拿到这次改动的反馈。
-
每次想把任务标成完成,跑它改动部分的测试。动了 auth 代码,就得过 auth 测试。
-
想结束整个会话的时候,跑全量测试。别的地方挂了,它会发现还坏着,回去修到通过为止。
然后是整场最容易踩坑的一个细节,大家一定留意。大多数测试工具失败时返回的退出码是 1,可如果退出码是 1,Claude Code 照样会把任务标成完成。你得在 hook 脚本里把测试失败翻译成退出码 2,harness 才会挡住这次完成,让 Claude 继续修复。
第八步:多开会话,交给 CI 和编排者
一个会话能放心撒手了,接下来就是多开几个。
云端会话各有各的机器和 checkout,不会挤在同一个文件夹里,worktree 也不用你操心。
到这里,你还是自己开每个会话、自己审每个结果。Lydia 说这已经是很不错的状态了,开什么、什么时候算完,都还握在你手里。
再往前走一步,她认为最要紧的是 CI。
所有会话最后都会开 PR,CI 会对每个 PR 跑同一套检查,不管那个会话是怎么配的,也不管 Claude 路上自己跑过哪些测试。
打开 CI autofix 以后,检查挂了 Claude 能看到,会自己回去修。这样你的审查精力,就不用花在那些检查本来就能抓到的问题上。
有些 PR 还可以开 merge when ready,检查全过以后由 GitHub 自动合并,这类 PR 你就不用审了。不过这个选项默认是关的,开不开要看改动的风险有多大。
Anthropic 团队是这么做的:
-
每个 PR 先由 Claude 审一遍,负责审的会话和写代码的会话分开,带着全新的上下文
-
另外有一组 agent,专门复核它报出来的每个 bug
-
人审多少按风险定。文档、文案这种小改动,自动检查全绿就直接走,不需要人;普通的产品改动可能一个人审;高风险的改动可能要两个人
最后,Anthropic 内部已经越来越多这么干了:开会话这件事,你也可以不用自己做了。
Lydia 挺坦白的,说自己特别不擅长切换上下文,同时管一堆会话并不总是顺利。所以她改成让一个主会话来当编排者(orchestrator)。
这个能力在 Claude Code Projects 里已经能看到,她分享的时候还在 beta。流程大概是这样:
-
你告诉主会话要做什么。
-
编排者把活拆成任务,给每个任务开一个新会话,在 Projects 里叫 thread。
-
它追踪每个 thread 交回来的结果,并负责验证。
-
你从同时跟八个会话说话,变成只跟一个说话。
两个角色的模型可以分开选。她举的例子是主会话用 Fable。主会话自己不写代码,所以它要擅长决定做什么、判断交回来的东西行不行,没做完就打回去,一直到做完、全部通过为止。thread 用 Opus 5.5,这里要的是擅长把活实打实干完的模型。
还有一个好处:在 Projects 里,上下文管理是全自动的,什么时候 compact、什么时候 clear,都不用你操心。
写在最后
总结一下,你要亲手做的就是:换上 Opus 5.5 和 auto mode,删掉 CLAUDE.md 里模型自己看代码能得出来的东西,一定不能让 AI 做的事写成 deny rule,长任务放到云端,用验证点、hook 和 CI 把质量守住。剩下的,交给 Claude。
以前我们亲手干的事,几乎都交给了模型、harness 或者环境。人只负责开第一个会话,审核关键点和交付产物。
想看更多 Claude Code、Grok Bot、Muse 等诸多前沿 AI 实践和自媒体内容欢迎关注我的推特 @KinGao476942。
如果觉得有用,可以转发收藏评论,评论区一起多多交流!(BTW,Lydia 的声音非常好听,也推荐大家去 Youtube 再看一遍原视频)
视频链接
- 视频:https://www.youtube.com/watch?v=vlfCjWuv4es (2026-11-12)
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


