
2026硅谷AIE大会:Cline创始工程师,一条提示词让agent连跑17小时,Terminal-Bench从77.5%到88.8%
文章目录
结论先说:Cline 的创始工程师 Ara Khan,让一个 agent 自己去改 Cline 的 harness(套在模型外面的那层工具和流程),一条提示词、连续跑了 17 小时,Terminal-Bench 2.1 的成绩从 77.5% 涨到 88.8%,单次评测的花费从 79 美元降到 49.8 美元。 同样的活,今年 1 月要 4 个工程师干好几个星期;这一次,人做的事是隔几个小时看一眼。
11 月 11 日,AIE CODE 2026 第二天,他在直播里讲了这件事。台上他自报名字,转录里被写成 Era;他的 X 账号是 arafatkatze,全名 Ara Khan,也叫 Arafat。
三点:
-
起点是一点不甘心。 77.5% 已经是好成绩,但 Kimi K3 的发布论文写着能到 85% 甚至更高。他想知道,差的那几分是模型的上限,还是 Cline 没做到位。
-
这次是 agent 自己干的。 GPT 5.6 Sol 当主 agent,读失败记录、改 harness、重新跑评测;被测的 Kimi K3 在 89 个并行沙箱里答题。他把它放着,13 个小时后回来,分数已经爬上去了。
-
同一套办法,他拿去调了一块小硬件。 一块他买来送女朋友的小芯片,能看、能说、能听,就是反应太慢。他让 agent 连上去自己做实验,一夜之间把它调好了。
一、他为什么不满意 77.5%
Ara Khan 是 Cline 的创始工程师,2025 年 4 月加入,之前在 Sourcegraph 做 Amp Code。在 Cline,他管的是跑评测和调 harness:每有一个新模型发布,Cline 都要想办法把这个模型在自己的 harness 里用到极致。他在台上说,新模型发布时 Cline 的惯例就是「优化分数、把模型的潜力榨出来」。
这次的新模型是 Kimi K3。他在台上说,用 Cline 跑 Terminal-Bench 2.1,这类模型通常在 60% 到 70% 之间;Kimi K3 刚发布,Cline 跑出来是 77.5%,也就是 89 道题对了 69 道(模型经 OpenRouter 调用,用的是没改过的 Cline harness,这一轮花了 79 美元)。
他没有高兴太久。他去翻了模型的发布论文,论文说最高能到 85% 甚至更多。他的原话是:「所以我们没有拿到这个分数。」
要往上抬,先得有一把可靠的尺子。他在台上先对比了两种评测。单轮评测是问一句「猫有几个脚趾」,对一下答案;agent 的评测不一样,比如让它「帮我装好这个 MCP」,它要上网查配置、下载文件、改数据库、读写文件、跑一串命令,最后回一句「我做完了」,再用一批测试去核对它到底有没有做成。
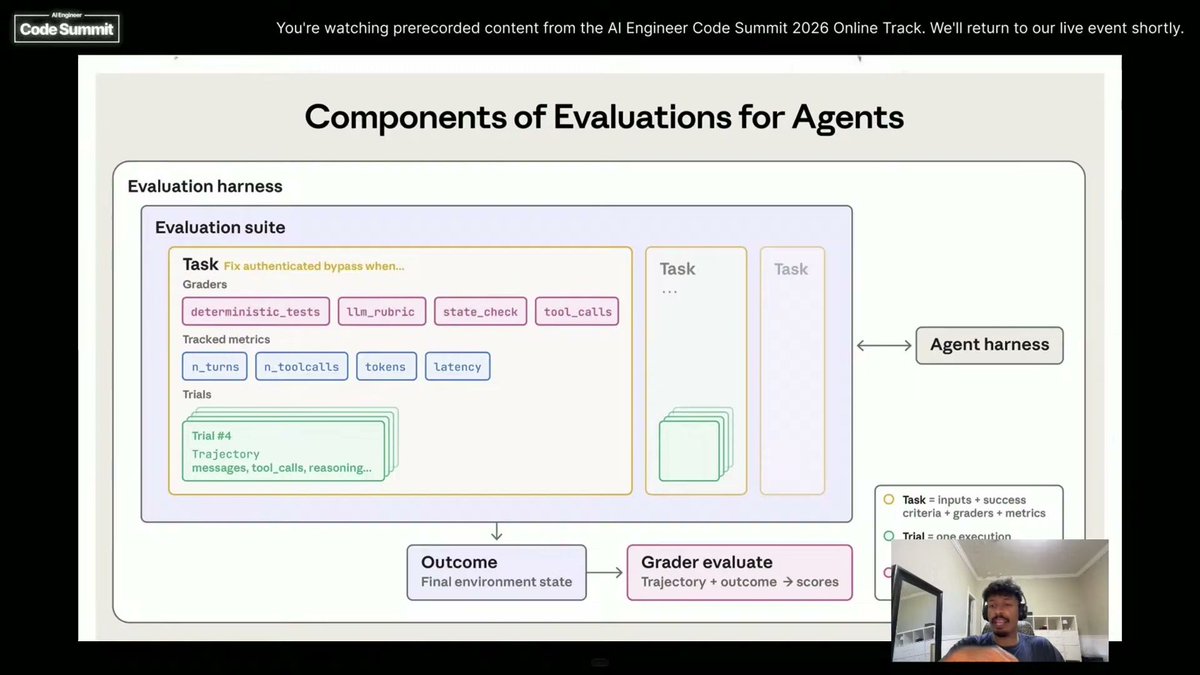
评测的组成:一道任务带着几类评分器(deterministic_tests、llm_rubric、state_check、tool_calls)和要跟踪的指标(n_turns、n_toolcalls、tokens、latency),每次执行留下一条轨迹。来源:AIE CODE 2026 直播
Cline 的跑法是这样搭的:Terminal-Bench 2.1 有 89 道题,就开 89 个并行的容器,每道题一个独立沙箱,互不干扰,各自做各自的,最后汇总出一个总分。评分另有独立的评分器,记每道题用了几轮、多少 token、多长时间、调了多少次工具,轨迹是什么样;还要查 agent 有没有作弊,比如去网上把答案搜出来。每道题 45 分钟的时间限制,到点就停。
Terminal-Bench:在终端里考 agent 的评测。来源:AIE CODE 2026 直播
二、以前这是个「苦力活」
怎么把 77.5% 往上抬?他在台上列了五步:
-
跑评测,拿到原始分数。
-
看所有失败,找共同点。他举的例子:读文件的工具在超大文件上崩掉;推理太慢,单题超时;agent 被带偏,完全跑题。
-
把失败分桶,这一类 10 个,那一类 20 个,另一类 30 个。
-
只改一处,把整套评测重跑一遍,再重复。
-
一轮轮下来,agent 自己找出毛病,自己变好。
他说这是 grunt work,苦力活。评测本身跑一遍就要一个小时,每轮只能验证一个小改动。
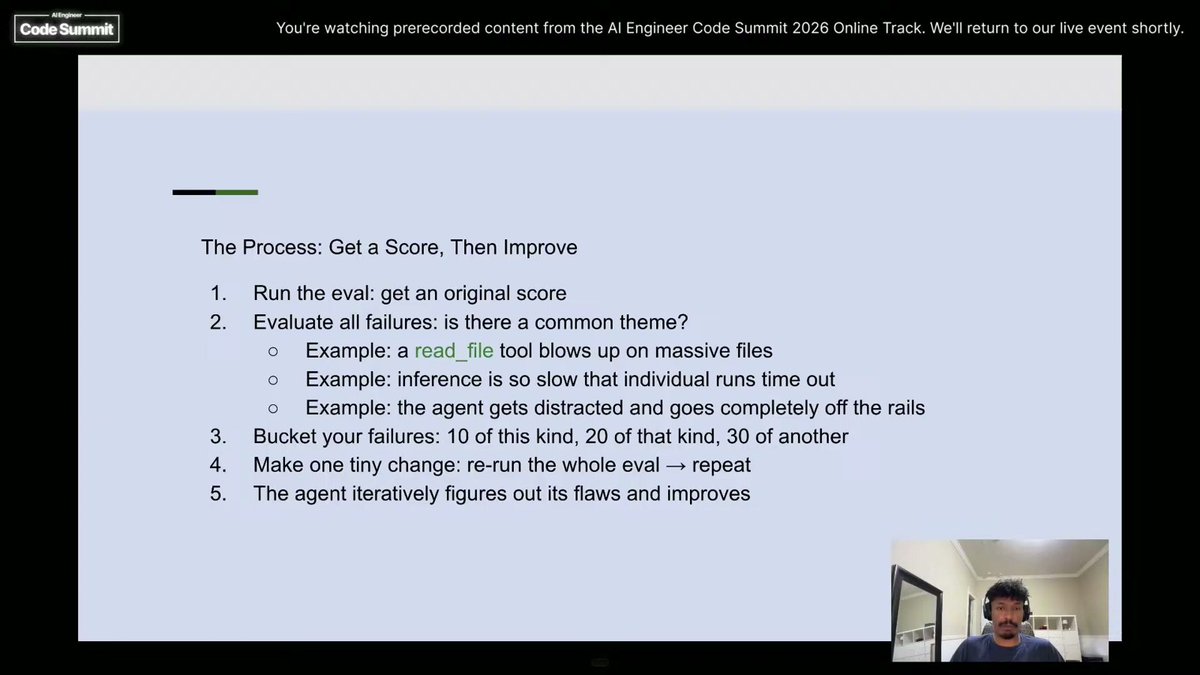
以前的做法:跑分、看失败、分桶、改一处、整套重跑。来源:AIE CODE 2026 直播
Cline 官方博客里写过它有多苦:今年 1 月,他们把 Opus 4.5 的 Terminal-Bench 成绩从 47% 提到 57%,是人对着模型的运行记录读了好几个星期,提假设、试修复,「看到眼睛出血」;2 月,4 个工程师合写了一份打法。
他在 X 上回顾过自己做这件事的三年:最早 agent 哪一步出错,他就写一个确定性测试,一个一个修;后来有了评测,89 道题并行,他让 agent 汇总几十道题的结果,自己再从上百条运行记录里找因果、提 PR。
然后他想到一个问题:这套流程我自己说得清清楚楚,为什么不让 agent 来做?他在台上说:「如果它们能改进 harness,就能改进很多别的东西。」
三、一条提示词,GPT 5.6 Sol 当主 agent
一个 agent 改进另一个 agent 用的 harness:GPT-5.6 Sol 主导,Kimi K3 跑题。来源:AIE CODE 2026 直播
提示词怎么来的。 他没有自己从头写。博客里写,他把自己平时爬坡的做法讲给 GPT-5.6,让它写成一份递归自我改进的提示词。第一稿就很完整,他们只补了两样:边界情况,和终点的定义。他在台上说这是一份「非常详细的提示词」。里面明令禁止三种作弊:不许改评分程序,不许按题目名称识别,不许把超时调长。另外要求 agent 一次只做一个实验,并且维护一份运行记录文件,记下试过什么、结果如何,免得重复劳动。
两个模型各管一头。 台上他说得很清楚:GPT 5.6 Sol 领头,是主 agent;Kimi K3 只负责跑评测,就是被测的那个。GPT 5.6 Sol 的活是:跑评测,看哪里失败,看哪里出了错,改 Cline 的 harness,再跑一遍,再试。
幻灯片上画的是一个两层循环:内层,Kimi K3 带着当前版本的 harness 在环境里一题一题做,得到反馈和得分,模型本身固定不动;外层,一个 meta agent 拿着这些「验证过的证据」,诊断问题、提出候选改动,改的对象是可编辑的 harness,包括提示词、工具、技能;改动要留痕、有版本,评估通过的才「晋升」,进入后面的任务。
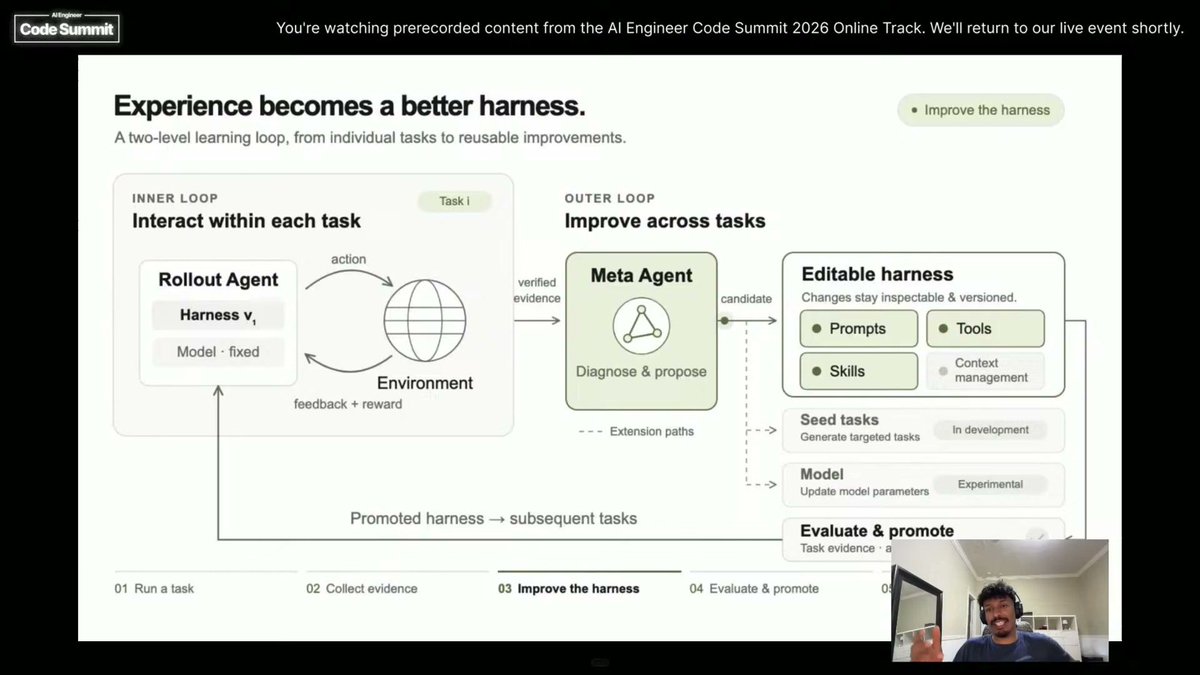
经验变成更好的 harness:内层 Rollout Agent 在环境里做题,外层 Meta Agent 诊断并提出改动,改动进入可编辑的 harness,评估后晋升。来源:AIE CODE 2026 直播
他还特意说了为什么不在做题的当场就改:他个人认为实时改很难,容易盯着眼前的某几道题过拟合;所以这个循环要在一批题上看,每个改动都得能说明,它对更广的一类问题也成立,而不只是让某道题过关。
放手。 他把它放到一台云上的虚拟机里,让它一直跑。他在台上特别提到,这事很容易跑偏:评测一遍要一个小时,读完反馈还得判断自己读得对不对,改动是不是真改进、不是作弊,然后再来一遍。博客说,人的参与基本就是每隔几小时看一眼,它停了就把它重新拉起来。
结果,这条循环跑了 17 个小时。他说,跑了一阵他离开,13 个小时后回来,harness 已经在很多方面变好了:没有人干预,agent 自己把爬坡的流程搭了起来。
四、这一夜,agent 找到了什么
台上他点了几样:循环检测(harness 在原地打转)、后台进程占着不放、文件索引的问题。他很坦率:「我说『我们』找到了,其实是 GPT 5.6 Sol 找到的。」
Cline 的博客把每个实验列得更细。下面每一条都是同一个模式:先在失败记录里看到一个症状,追到根因,改一处,再跑。
-
实验 0:推理强度被悄悄降级。 Cline 把 Kimi K3 的 max 推理强度静默地映射成了 high。agent 把映射修正了,但分数没有变化,因为 OpenRouter 那一端本来就把它映射到 K3 唯一支持的那一档,所以这一条没有算功劳。
-
实验 1:429。 基线里有 5 道题败在同一件事上:OpenRouter 回了一个 HTTP 429「请求太多」,Cline 没有重试,当场放弃。当时只有一家服务商在供 Kimi K3,容量紧。agent 的修法很朴素:加上重试,间隔指数级拉长。5 道题全部翻成通过。
-
实验 2:防循环的机制杀错了人。 有 2 道题,Cline 自己的循环检测把 agent 杀了:agent 在反复查一个长时间运行的后台任务,每次命令一模一样,检测器就判它在转圈。agent 去看了输出,发现输出其实在变,那是进展,不是循环,于是把检测改成看输出:命令重复但输出在变,就不算。这 2 道题翻成通过。
-
实验 3:7.6 秒的幽灵。 有一道题 7.6 秒就退出了,零 token、没有会话,哪里都看不出错在哪。agent 一路追下去:提示词里只要有以 @ 开头的片段,就会触发一次文件提及查找,这个查找挂在一个没人等待的异步线程上,进程在模型被调用之前就合法退出了。一行代码修好,让这个请求保持存活。
-
实验 4:自己杀自己。 有 2 道题,agent 用 pkill -f 清理进程,匹配的字符串碰巧也匹配到了自己 harness 的命令行,把自己结束了。修法是在工具指引里教它:启动进程时记下进程号,按进程号清理,别按名字乱杀。2 道题翻成通过。
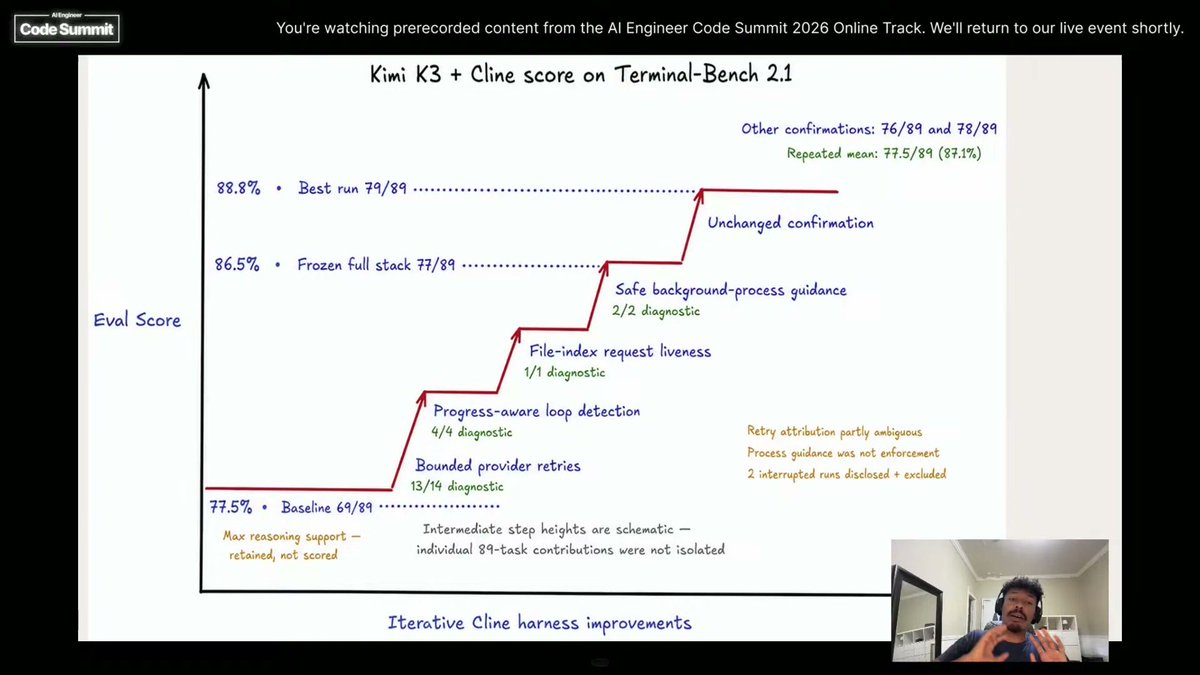
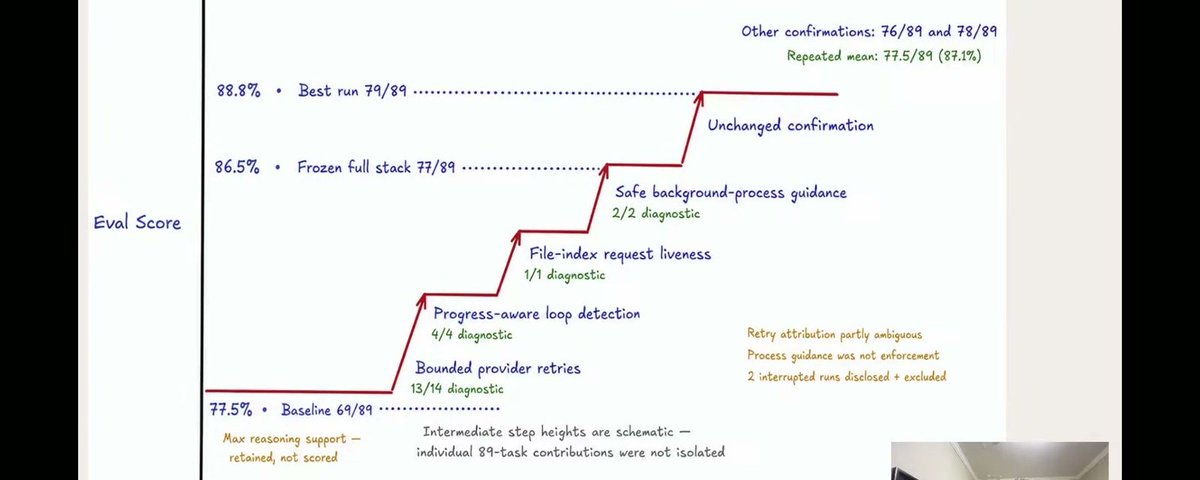
Kimi K3 + Cline 在 Terminal-Bench 2.1 上的爬坡图:从基线 69/89,依次是重试、带进展判断的循环检测、文件索引请求保活、安全的后台进程指引,到冻结的完整版本 77/89,再到最好一次 79/89。来源:AIE CODE 2026 直播
分数和花费怎么量的。 每个改动在博客里是单独做的诊断,最后合并成一个完整版本,冻结,再整套跑。第一轮合并版本拿到 77/89(86.5%),花 65 美元;再跑一次确认,79/89,88.8%,花 49.8 美元。基线是 69/89,花 79 美元。分数涨了,钱反而少了,因为不再有白白的重试和自杀。图上还标了另外两次确认是 76/89 和 78/89,重复几次的平均是 77.5/89(87.1%)。
图上作者自己也写了几条保留:台阶高度只是示意,没有把每个改动对 89 题的贡献单独分离;重试的归因部分含糊;后台进程那一条只是指引,不是强制。
这个 88.8%,比 Moonshot 官方报的 88.3% 还高一点。博客的说法是:用一个通用的 harness,第一次递归爬坡就追平了对方自己调出的成绩。
五、有没有作弊
分数一好,第一反应就是怀疑刷榜,Cline 自己也先怀疑过。博客里写的防线有三道:
-
提示词从一开始就禁止作弊:不许改评分程序,不许按题目名称识别,不许把超时调长。
-
agent 自己给每次评测做归因记录;确认评测中途,有两轮因为编排器被意外杀掉而作废,它们被剔除、重跑,图上也标明了「2 次被打断的运行已披露并排除」。
-
最后是人:整个 PR(#12465),他们逐行看完才合并。
博客也写了没成的部分:把推理强度调到最高那项,没有拿到因果上的功劳;pkill 的提示只是减少、没有根治;还有一些题,低分确实是模型本身的限制。
整场实验大约用了 10 亿 token,其中约 4 亿是编码 agent 自己用的,约 6 亿是反复跑评测用的,总共约 680 美元。博客里算的是另一笔账:几个星期的工程师时间,换成 17 小时的 agent。他们还提到,原本想用 Fable 5 做这个实验,它的安全过滤器一直把模型降级成 Opus-4.8,只好放弃,主 agent 才换成了 GPT 5.6 Sol。Cline 接下来的打算是,每个新模型发布,都先跑一次基线,再用这种递归爬坡的提示词跑一遍。
7 月底他在 X 上写了一段长话,里面有一句:只要把护栏定义对,模型自己能把整个流程摸清楚;他本来不确定行不行,「但它终于成了,我非常高兴」。他也留了余地:现在仍然需要人去指引模型走哪条路、给它合适的长时间运行环境。
六、一块送给女朋友的小芯片
这是整场里最有人味的一段。
他有一块小芯片,能看、有扬声器、有麦克风,里面自己带一个 agent。那是他买来送女朋友的礼物。他在台上说,设置的时候发现它很慢,响应延迟很高。
他的做法分几步:
-
接上电脑。 把芯片接到自己的电脑上,让编码 agent 直接在这块硬件上跑。
-
自动出题、自动量。 电脑对硬件说「做这个、做那个」,问它「你现在看到了什么」,量端到端的延迟,也就是从发出指令到硬件做出推理响应要多久。
-
逐个拆。 agent 把每一种延迟高、响应慢、算法不对的情况拆开,一个一个对应到原因。
-
搭递归循环。 固件、工具调用、用的推理模型、用的语音转文字模型,这四样都开放给 agent 去改。他给了 agent 一个 OpenRouter 的密钥,让它自己去换模型、试配置。
-
一夜。 跑了一整夜的自动实验,这块小硬件被调得很深。他用了「beautiful」这个词。
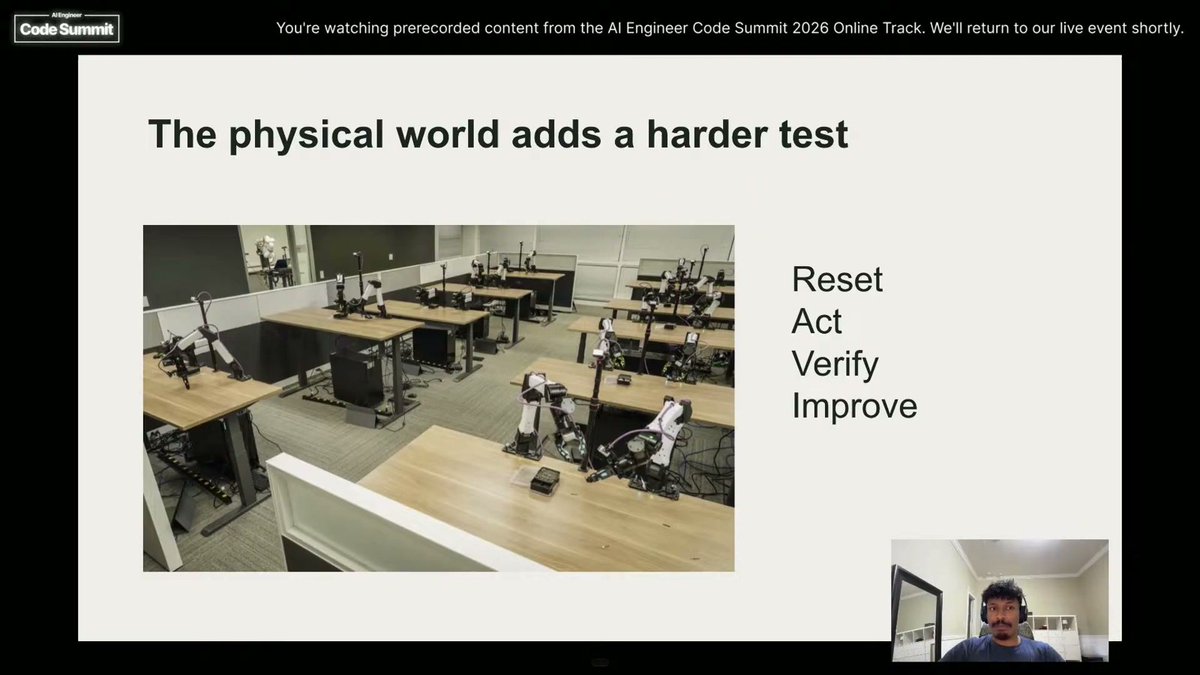
他讲到物理世界时的一页:Reset、Act、Verify、Improve,配的是一间摆满机械臂的实验室。来源:AIE CODE 2026 直播
他由此推出一句话:连硬件也可以是 RSI 循环的一部分。凡是有可验证循环的东西,都能被这样优化,不止软件。
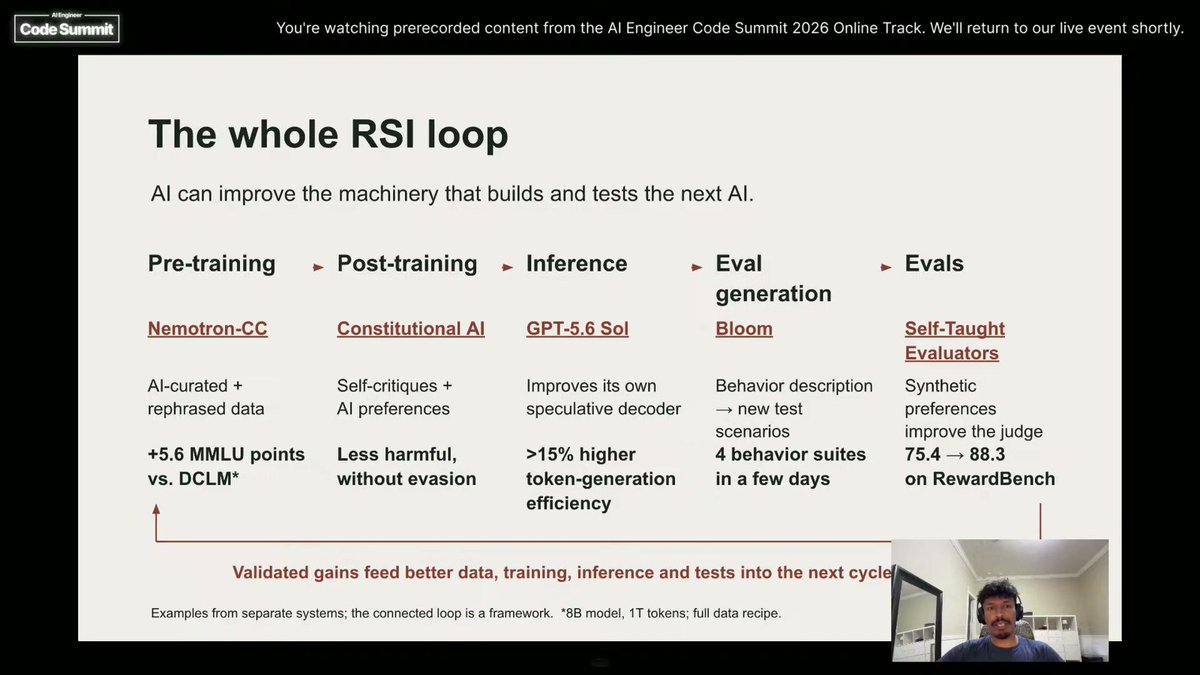
完整的自我改进循环:从预训练到评测,每一环都能被 AI 改进。来源:AIE CODE 2026 直播
七、他要台下的人怎么办
讲完这两个例子,他把话转到职业上,说了三个目标:看懂前沿实验室想做什么;想清楚模型进步这么快,自己的职业怎么办;以及「逃离永久底层」。他说这听起来像玩笑,但是确实有人在认真担心:如果全球的收入都流向少数做 GPU 的和做最好模型的公司,其他人怎么办?
他的建议是:「请,请,请靠近 RSI 循环。」 他说,现在很多人在做各行各业的 agent,建筑的、这个的、那个的,在他看来是「只见树木,不见森林」,而且那些东西离「下一次模型发布就被抹平」只差一步。他自己的感受是,整天对着 Claude 说「帮我做这个、帮我做那个」,未必是对一个人时间最有智力刺激的用法。
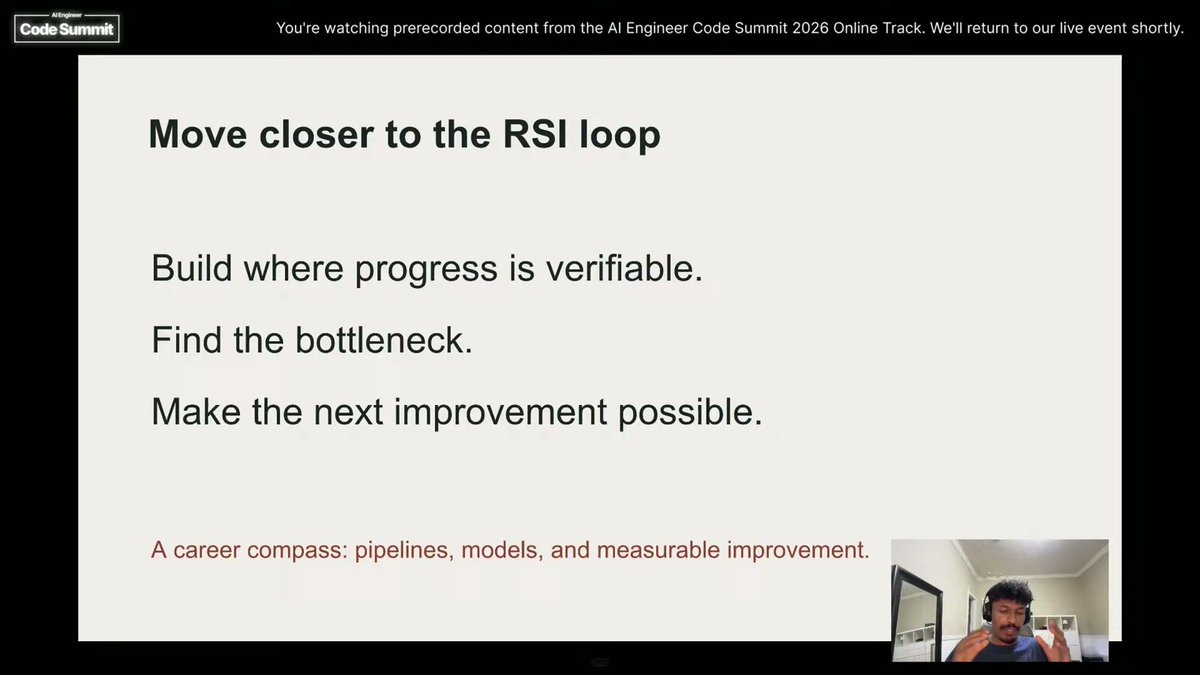
他给台下的建议:往能验证进步的地方靠。来源:AIE CODE 2026 直播
那往哪靠?他列的方向:推理、后训练、物理世界、端到端的管线、硬件、网络,也包括「建立一个社区」。他引了 Anthropic 一页幻灯片,大意是:你只剩一到五年可以在智力上有所贡献,做事要偏向有野心、有针对性、快速的合作;选能从规模里受益、又不会被下一个模型直接解决的问题。
他说,如果你是软件工程师,觉得自己每天的智力没有被用上,Claude 一次就把你的问题解完了,你变成了一个「肉体代理」,就值得停下来想一想:我真正有贡献、而且经得起时间的地方在哪里。
他的收尾很平:「我只是网上的一个人」,他的判断可能偏悲观也可能偏乐观,欢迎大家扫他的二维码来告诉他。
对读者的意思
他做的是同一件事,只是从「自己一遍遍爬坡」换成了「把爬坡的方法写下来,交给一个更强的模型」:四个人几个星期的活,变成一条提示词和 17 小时;换到芯片上,变成一夜。
对做 agent 产品的团队,这给了一个很具体的做法:先把你怎么做评测、怎么分类失败、怎么改的流程说清楚,说得清楚的部分,就是可以交出去的部分。 交出去之后,人留下来做三件事:定边界(禁止作弊)、定终点、最后逐行看 PR。
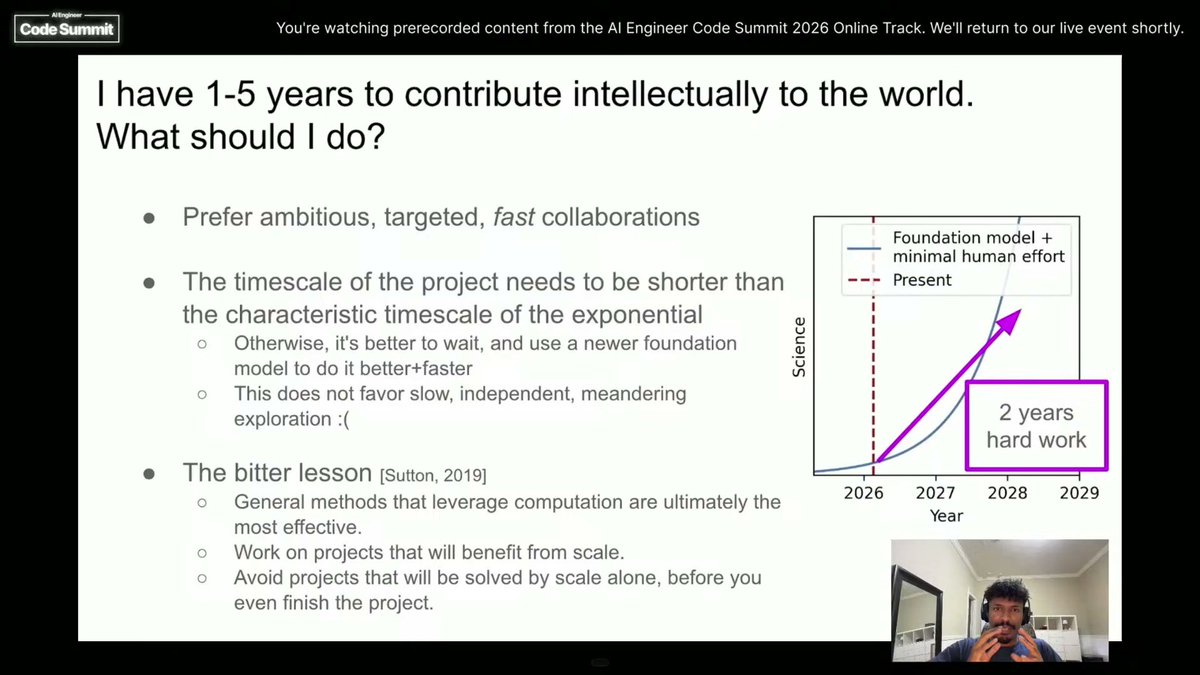
他给台下的问题:如果你只剩 1 到 5 年能做出贡献,该做什么。来源:AIE CODE 2026 直播
-
直播回放(从 3:59:46 开始):https://www.youtube.com/watch?v=ZZ19zhYnDKY&t=14386s
-
Cline 博客《Recursive Self Improvement for Coding Agents》:https://cline.bot/blog/recursive-self-improvement-for-coding-agents
-
他的 X 长帖(7 月 29 日):https://x.com/arafatkatze/status/2082705695963742497


