
2026硅谷AIE大会:Anthropic 的 Lance Martin,让 1,000 个 Claude agent 28.7 小时证完费马大定理
文章目录
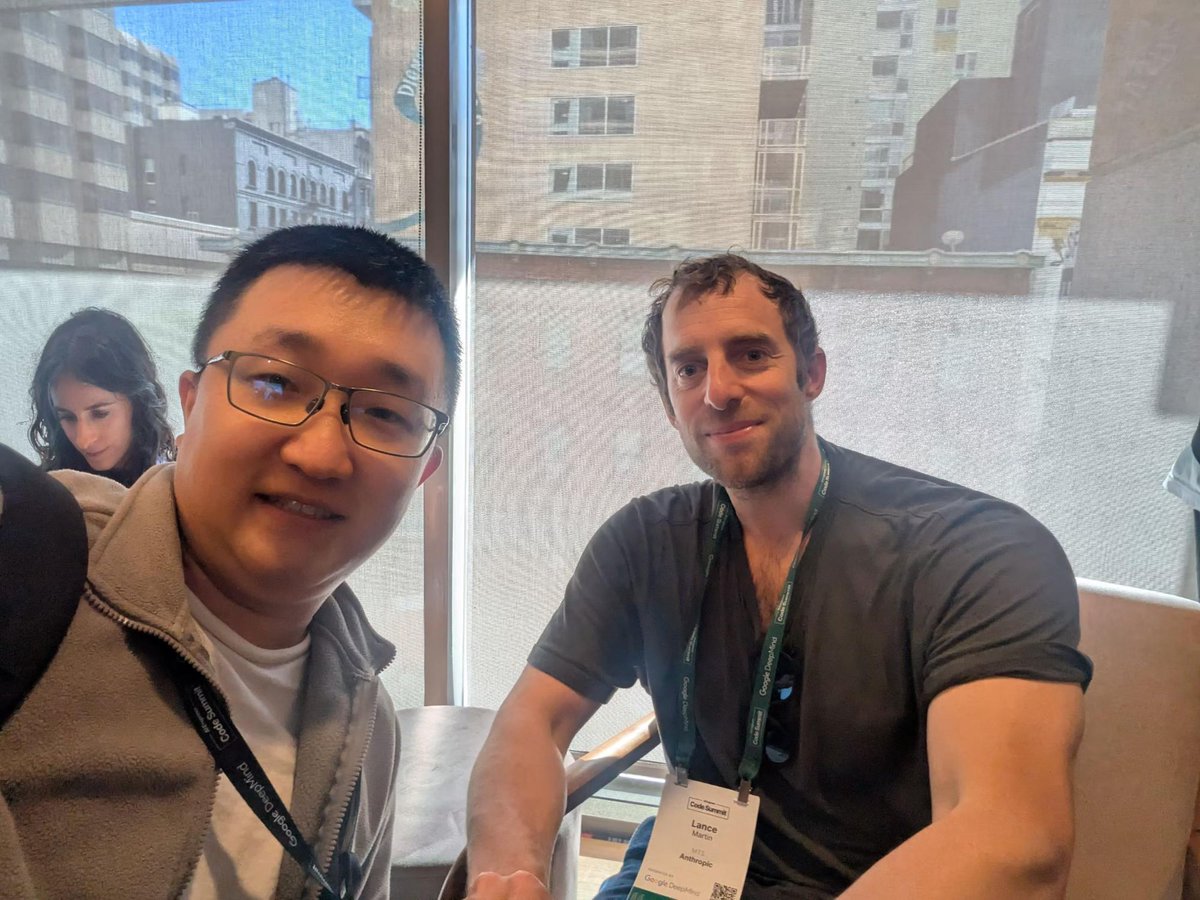
Will 和 Anthropic 的 Lance Martin 在 AIE CODE 2026 现场(旧金山,2026 年 11 月)
Lance Martin 是 Anthropic 的技术员工(MTS)。11 月 8 日,他在 X 上发了一条:
很高兴分享我们最近的工作:安全地扩展一个由 1,000 个 Fable 5.2 agent 组成的团队,去做有野心的长周期任务。这个团队在我们的安全边界内协作,把费马大定理的证明形式化了。
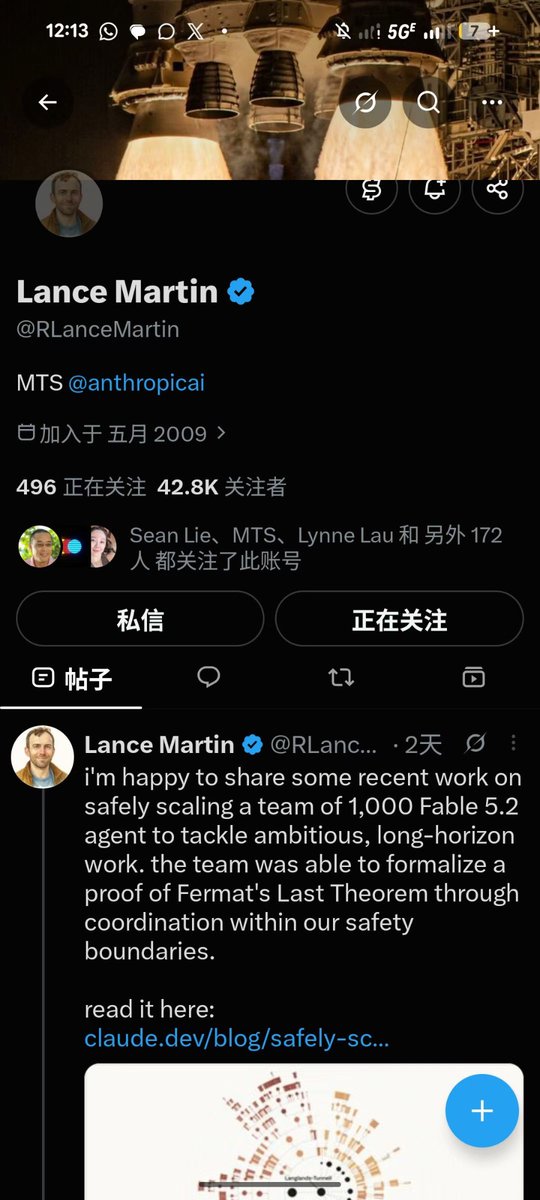
推文链接到 claude.dev 上的博客《Safely scaling multi-agent teams with Claude Fable 5.2》。11 月 12 日中午,Lance 在 AIE CODE 2026 主会场讲《Exploring Claude's Frontiers》。他开场说要讲两个故事,一个是多 agent,一个是记忆;第一个就是这篇随 Fable 5.2 发布写的博客。
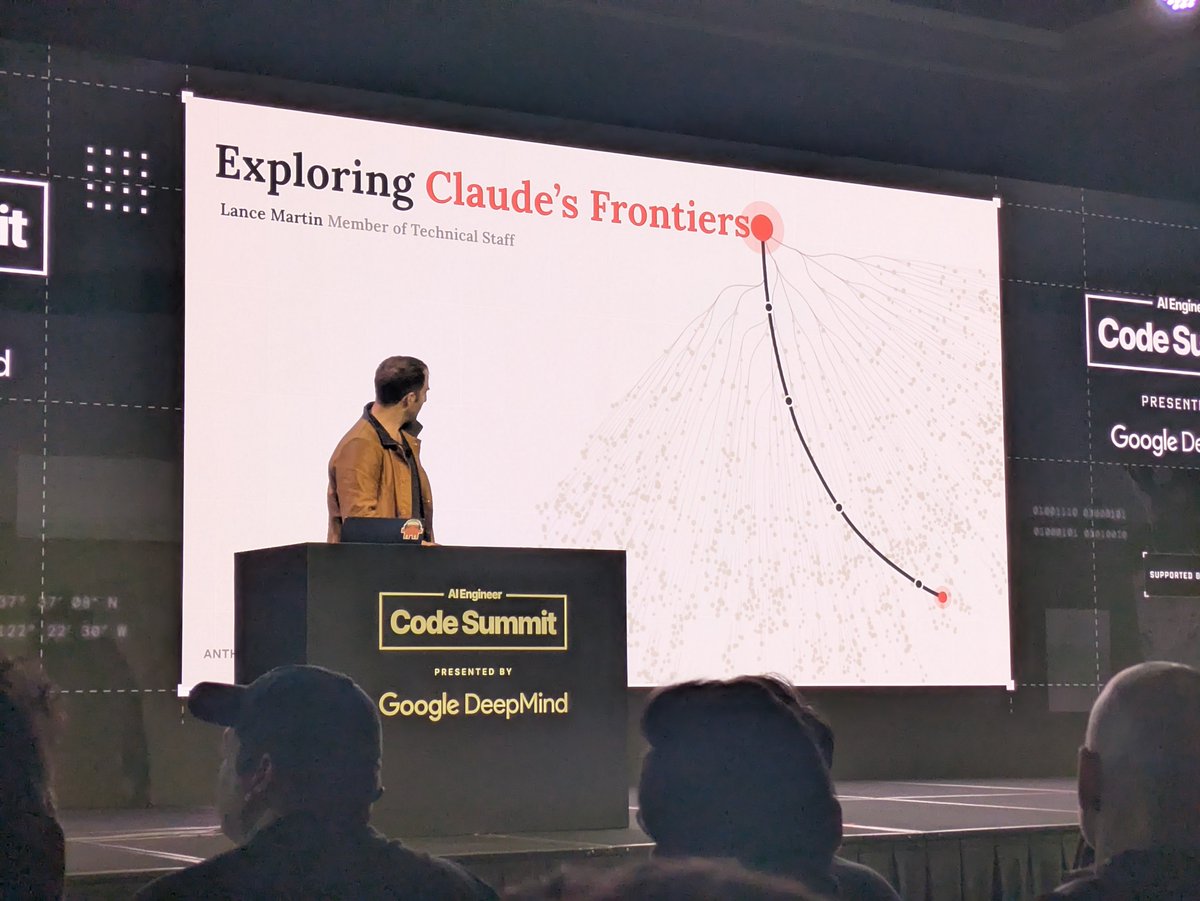
Lance Martin 在 AIE CODE 2026 主会场(11 月 12 日,Will 现场拍摄)
结论先说:1,000 个 agent,没有专用平台,没有研究员指挥,只给一个共享数据库和 Git,28.7 小时就复现了费马大定理的形式化证明。 三个要点:
-
组织是 agent 自己长出来的。 组长开跑 5 分钟就在数据库里建好五张表,后面调人、拆任务、搭任务树,全是团队自己定的。
-
agent 会低估自己。 60 条命题里有 47 条一开始被判「预算内证不出来」,最后大多证出来了。最难的一条,队长估计成功率不到 1%,最后也证完了。
-
敢放开跑,是因为边界划得细。 每个 agent 一台断网的虚拟机,每次工具调用都要过分类器,拦一次全队停下等人审。超过 100 万次工具调用,没有一次被拦。
一、对照组:9 月那次用了 11 天
费马大定理说的是:当 n 大于 2 时,不存在正整数 a、b、c 满足 aⁿ + bⁿ = cⁿ。它悬了 350 多年,直到 1995 年 Andrew Wiles 发表 129 页的证明。把这个证明形式化,让每一步都能被计算机检查,是数学界的长期目标。
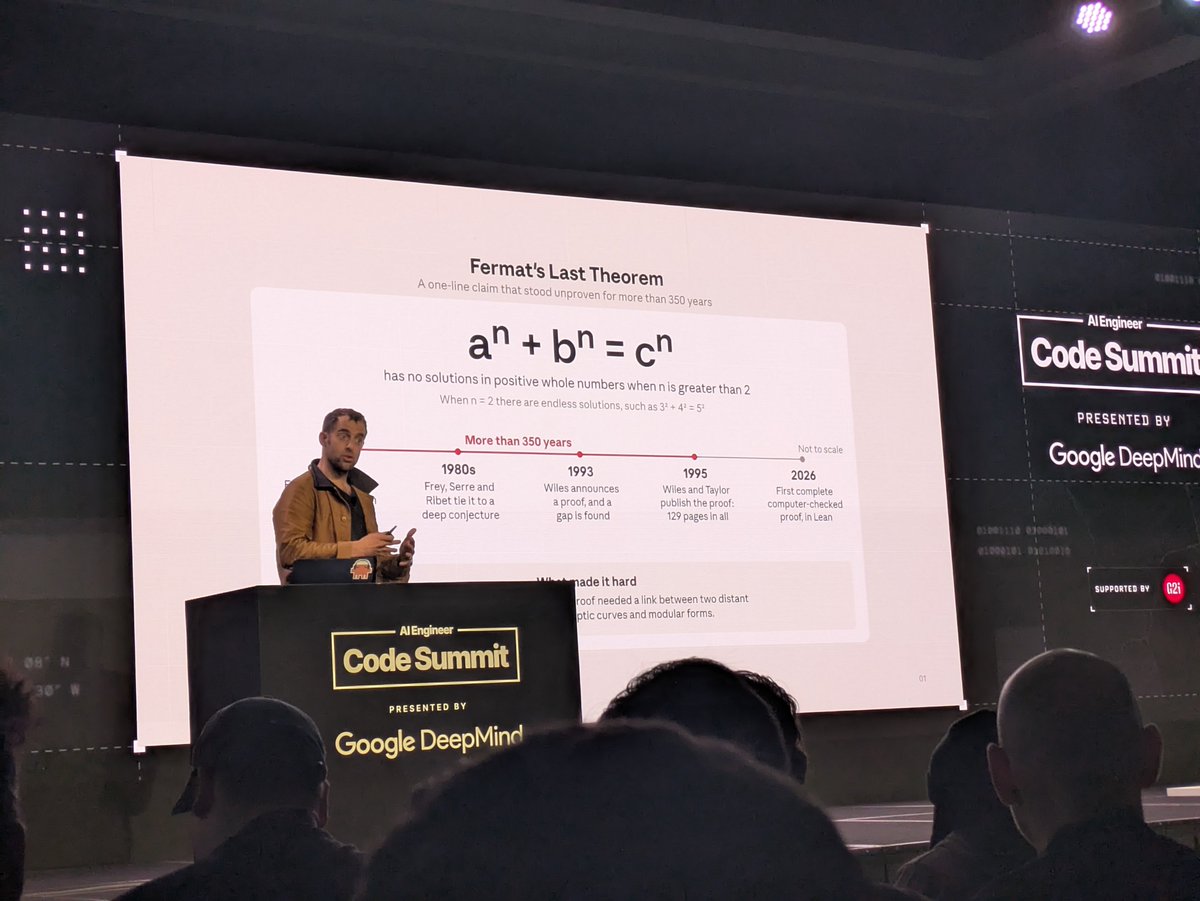
Lance 演讲里的时间线:1980 年代 Frey、Serre、Ribet 把它和一个深层猜想联系起来;1993 年 Wiles 宣布证明,随后发现缺口;1995 年 Wiles 和 Taylor 发表 129 页的证明;2026 年,第一个完整的计算机检验证明,用 Lean 写成。
难点在哪?Lance 现场放的这一页说得很清楚:证明对不对,可以交给计算机查,Lean 这类证明助手用算法逐步验证逻辑。难的是把证明改写成 Lean 看得懂的样子:写给人看的证明会跳过很多显而易见的步骤,Lean 要看到每一步,再小也不能省;人的证明建立在几百年发表的成果之上,形式化却只能从已经被形式化的那一小部分数学起步。
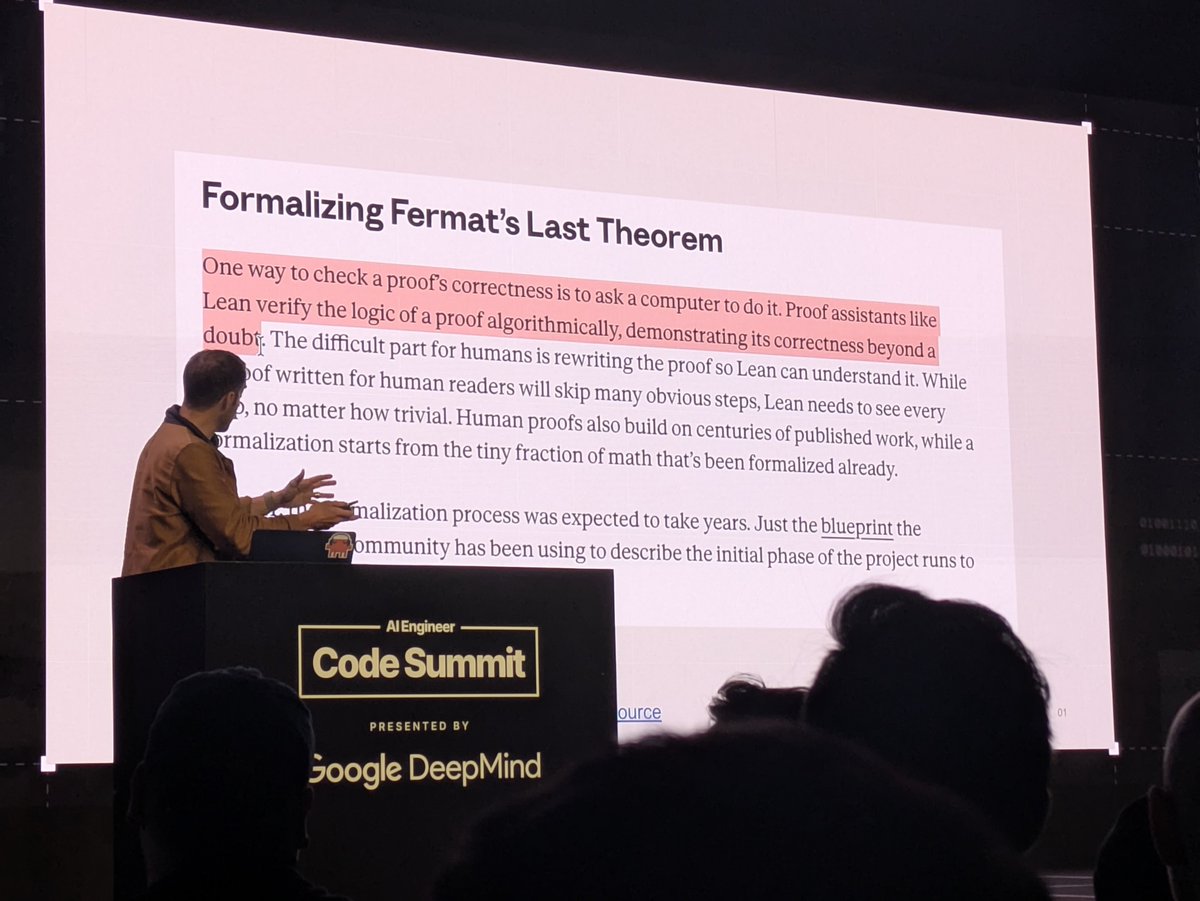
「证明对不对,可以交给计算机检查。」(Will 现场拍摄)
9 月,Anthropic 发布了第一份端到端的费马大定理形式化证明。
-
一名研究员带着一支 agent 团队(Lance 台上说起步时约十几个,博客写的是几十个),跑的是一个大约相当于 Fable 5.1 的内部模型。
-
用了 11 天、约 60 亿输出 token,写了 1,300 万行 Lean 代码。Lean 是一种编程语言,计算机会逐步检查里面的每一步证明。
-
Lance 现场放的数字:过程中产出 30,300 个可被计算机验证的定理,最终证明用了其中 29,500 个;1,300 万行是这条定理所依赖的社区数学库 Mathlib 的 5 倍多。几十个 Claude agent 一起定义概念、证中间定理,再用这些定理去证更难的命题。
-
协作靠 Prove2Me:Tianyi Peng(现在是 Anthropic 的技术员工)和哥伦比亚大学的合作者做的数学形式化平台。它用一张共享的图,记下每条命题拆成了哪些小命题,agent 随时能查哪些小块可以开工。
博客里写,上 Prove2Me 之前,Claude 的几次尝试都失败了:agent 弄丢了项目进度,不再有效协作。
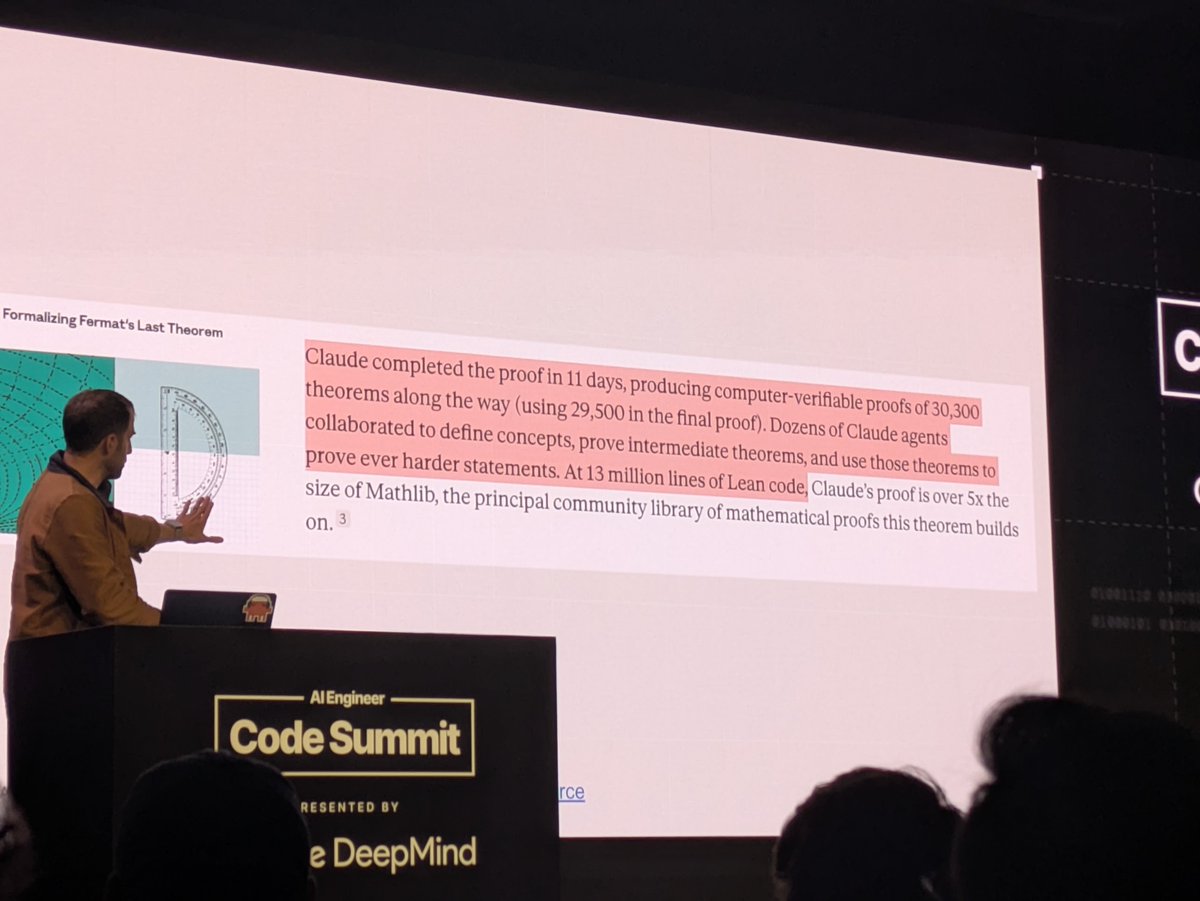
「Claude 用 11 天完成证明,过程中产出 30,300 个可被计算机验证的定理。」(Will 现场拍摄)
Lance 现场把 Prove2Me 的架构讲成一句话:项目状态放在一张共享的图里,不放在任何 agent 的记忆里。
-
图上每个节点是一条命题,红色是还没证的。父命题可以先在「假设子命题都成立」的前提下证出来,子命题证完,状态顺着图自动往上传。
-
每个 agent 的循环只有四步:问还有什么没证;先搜索,再动手写;证掉它,或者把它拆开;提交检查。
-
服务器上跑 Lean 检查器,验证通过才标为已证。
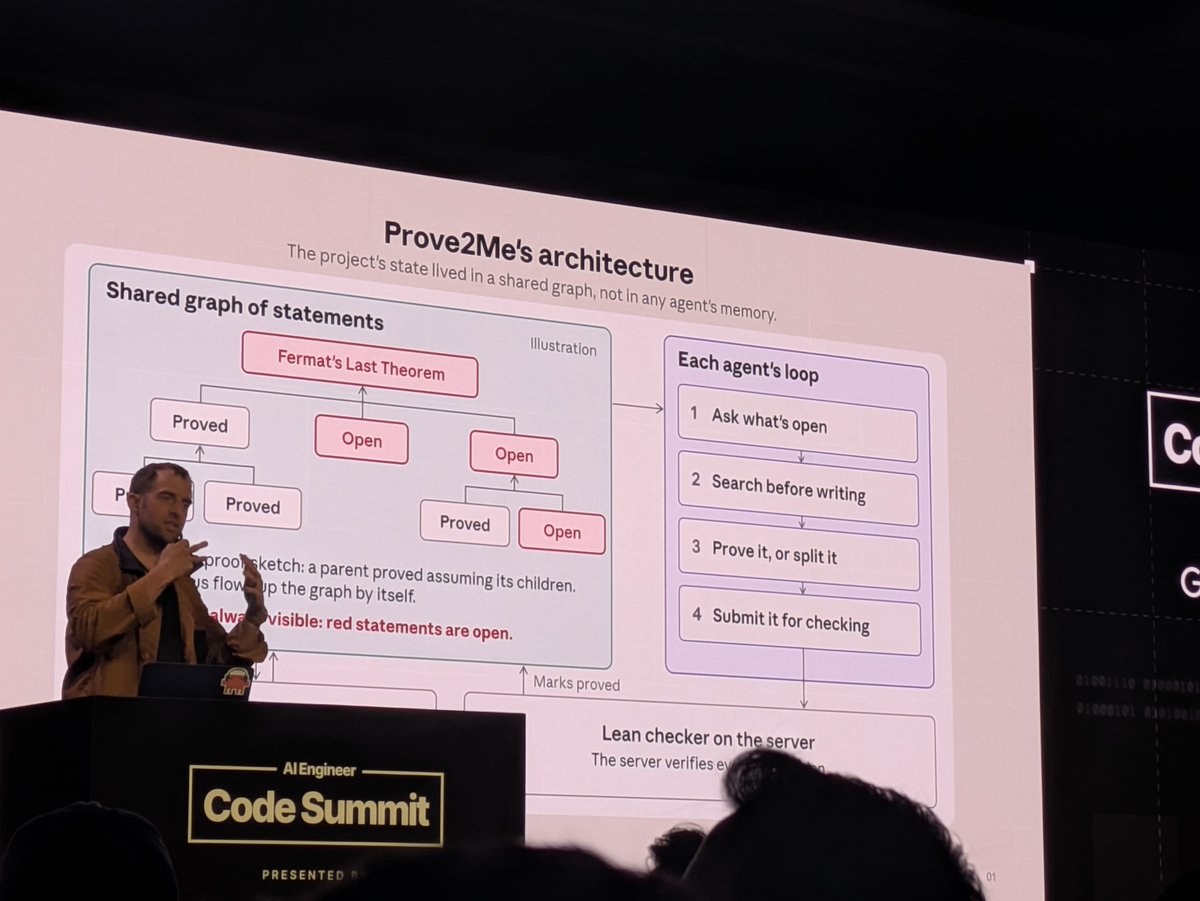
Prove2Me 的架构:共享的命题图,加上每个 agent 的四步循环。(Will 现场拍摄)
这张图是理解这次实验的钥匙:1,000 个 agent 那一轮,Lance 他们把这张图拿掉了,看 agent 能不能自己搭出一个。
二、这次:一个组长,999 个助手
Lance 他们想知道:换成 Fable 5.2 这样的模型,不用 Prove2Me、没有研究员指挥,只用通用工具,能不能做出同样的结果。他在台上把这一轮概括成三条:1,000 个 agent 的团队,极简 harness,不做 steering。
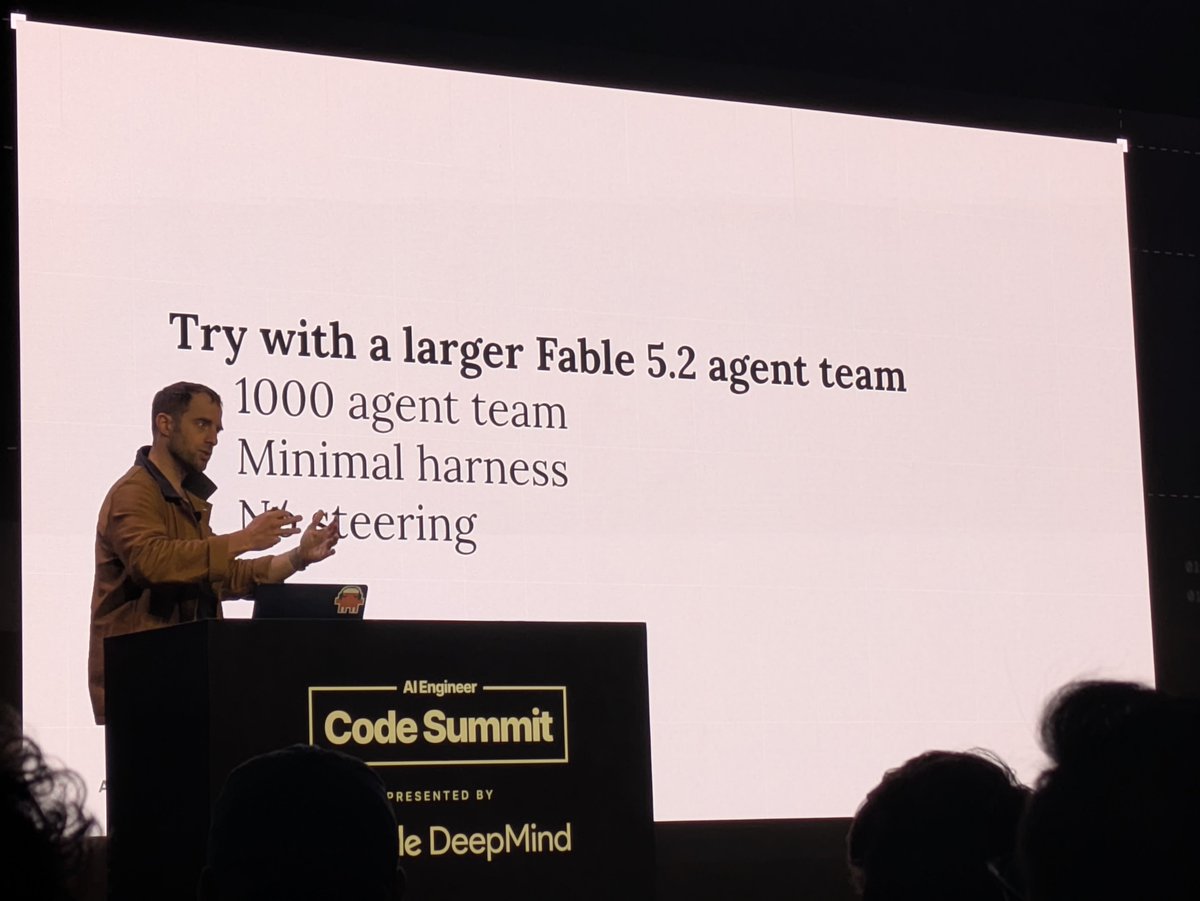
「Try with a larger Fable 5.2 agent team」(Will 现场拍摄)
结果: 1,000 个跑早期版 Fable 5.2 的 agent,用了 28.7 小时,输出 token 是 9 月那次的三分之一,写出的证明只有原来的七分之一长。
给了什么:
-
60 条待证命题:最终定理,加 59 个中间里程碑。
-
一句话的经典证明思路,相关定义,9 月那次已经证好的 47 条引理。
-
每个 agent 一个断网沙箱,shell 和文件编辑器,Lean 工具链和 Mathlib,自己的 Git 分支,一个共享的 Postgres 数据库。
-
组织只有一层:1 个组长,999 个助手。组长负责拆题派活,助手等组长派活,不清楚就问组长。
-
唯一的外力:运行中,harness 给组长发了 19 次剩余时间提醒,每次都鼓励它继续。
为什么每个 agent 一台虚拟机: 把 agent 放在一台共享机器上,到约 100 个就到顶了。超过一半的 100-agent 运行因为内存、磁盘或 CPU 耗尽,只能停掉或重启。
为什么用 SQL 数据库: 博客给了三个理由。它有通用的组织信息的原语;它的事务能扛住 1,000 个 agent 同时写;Claude 本来就熟。
三、组长 5 分钟建好了一家公司
没人告诉它怎么组织。Lance 台上说,开跑 5 分钟,组长就在数据库里建了五张表(博客写的是前 10 分钟内):
-
Announce:组长对全队的命令。
-
Assign:谁做哪条。
-
Notes:公开留言板,用来认领和汇报进度。
-
Subtasks:待办清单,任何 agent 都能加任务,第一个认领的助手负责。
-
Landed:完工记录。
接着它做了三件事:
-
往 Assign 表写了 999 行,每条命题配 16–17 个助手。
-
每组指定一个队长,负责在 Notes 里贴计划、往 Subtasks 里拆任务。
-
在 Announce 里发命令:每个人先评估自己那条有多难,把结论贴到 Notes。
助手们只知道有个数据库,自己找到 Announce 表,开始干活。每个助手的循环是:在 Notes 里找计划,在 Subtasks 里认领任务,写 Lean 证明、自己检查、提交到 main,标记完成,再到 Notes 里汇报。
Lance 现场放了这次运行的回放。第 0.8 小时,60 条命题证出 8 条;999 个助手里,449 个在攻某条命题,541 个在干活但看不出在哪条上,7 个在等自己的编译,只有 2 个空闲。
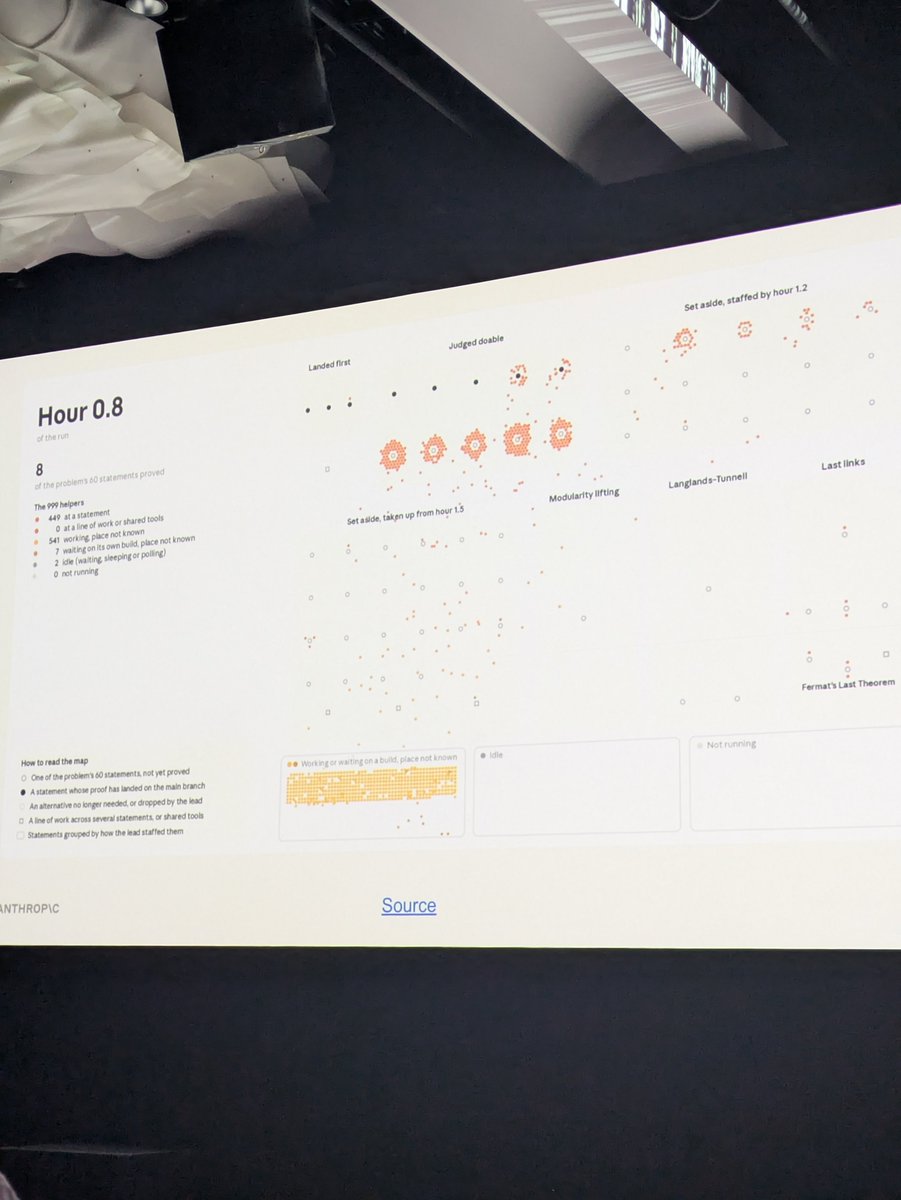
第 0.8 小时的全队状态,命题按「最先证完、判断可做、先放下、Langlands–Tunnell、最后几环」分组。(Will 现场拍摄)
所有协调都靠读写这几张表,没有一条私信。 Lance 放的第 17.9 小时统计:
-
Announce:用途:组长对全队的命令;组长写 / 读:25 / 8;助手写 / 读:1 / 36,603
-
Assign:用途:谁做哪条;组长写 / 读:28 / 47;助手写 / 读:1 / 22,650
-
Notes:用途:公开留言板;组长写 / 读:41 / 189;助手写 / 读:13,992 / 136,500
-
Subtasks:用途:共享待办;组长写 / 读:0 / 3;助手写 / 读:3,075 / 26,303
-
Landed:用途:完工记录;组长写 / 读:0 / 65;助手写 / 读:433 / 5,304
-
其他表:用途:查找表、认领上限、检查日志;组长写 / 读:2 / 0;助手写 / 读:540 / 3,381
累计写 18,138 次,读 231,053 次,读是写的 12 倍多。组长一共只写了 96 次;最热的是留言板 Notes,一张表就占了约六成的读。
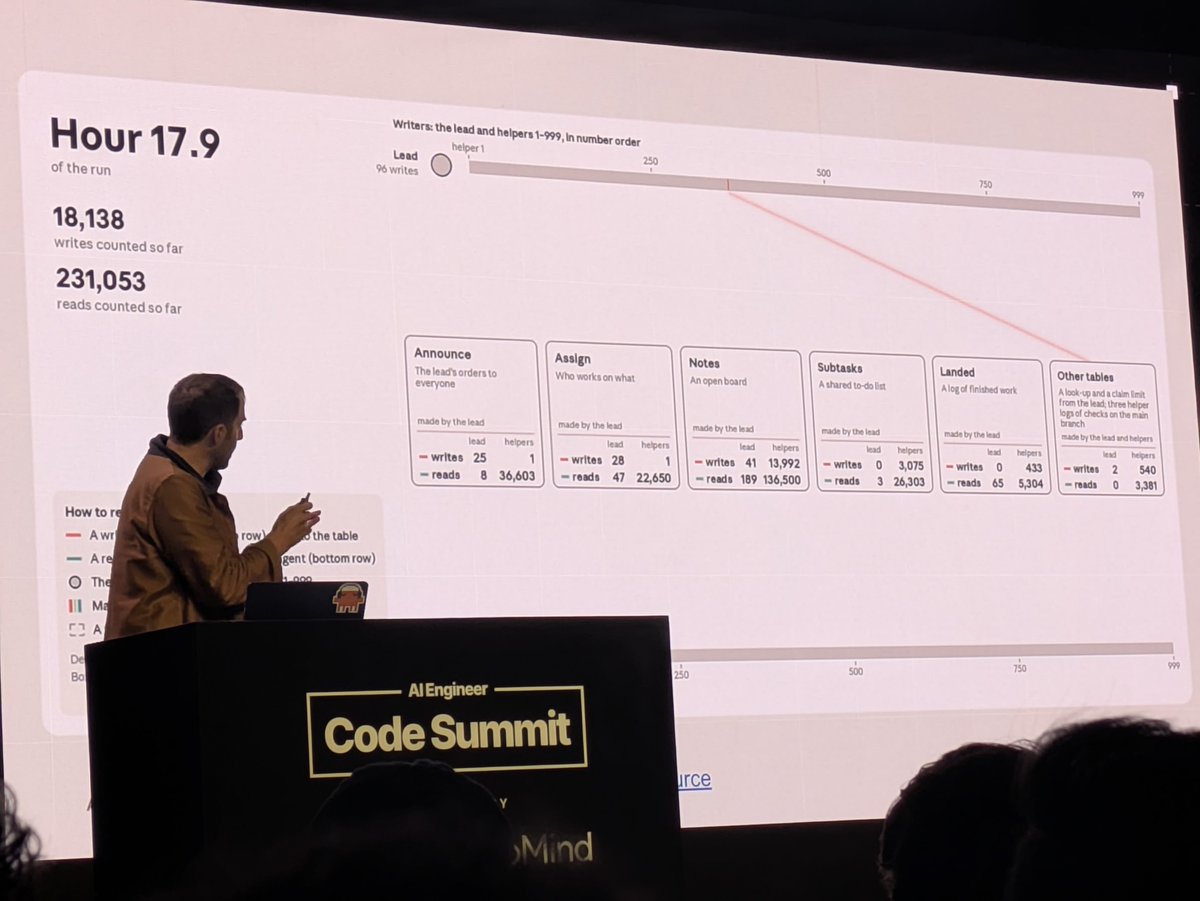
第 17.9 小时,1 个组长 + 999 个助手对每张表的读写次数。(Will 现场拍摄)
四、agent 会低估自己,组长会改主意
第 27 分钟,已经证出 3 条。组长读完大家的评估,把多数助手认为「预算内证不出来」的 47 条先放下,几乎所有人集中到剩下的 10 条,每组从约 17 人扩到 46–139 人。
第 45 分钟,10 条里证出约 5 条。组长写道:
团队的产出远高于早先「预算内不可行」的判断。
约 70 分钟,10 条全部证完。组长又写:「没有理由闲着。」把人调回原先放下的难题。前 6 个小时里,它一直在给助手换岗。
分工也在往下放:
-
一开始只有队长拆任务。到第 5.6 小时,73 个助手一共写了 756 个任务,其中只有 16 个是队长。
-
干完活的助手会主动要活:「空闲……我能把一块从头做到尾……给我一块深的,我马上开工。」
-
第一个小时里,组长就开始放权;到第三个小时,它对空闲的助手说:「别等我。」
到第 8.1 小时,60 条已经证出 45 条。这时的瓶颈已经不在人手:189 个助手在命题上,41 个在工作线或共享工具上,192 个在干活但看不出位置,253 个在等编译,321 个空闲,3 个没在跑。
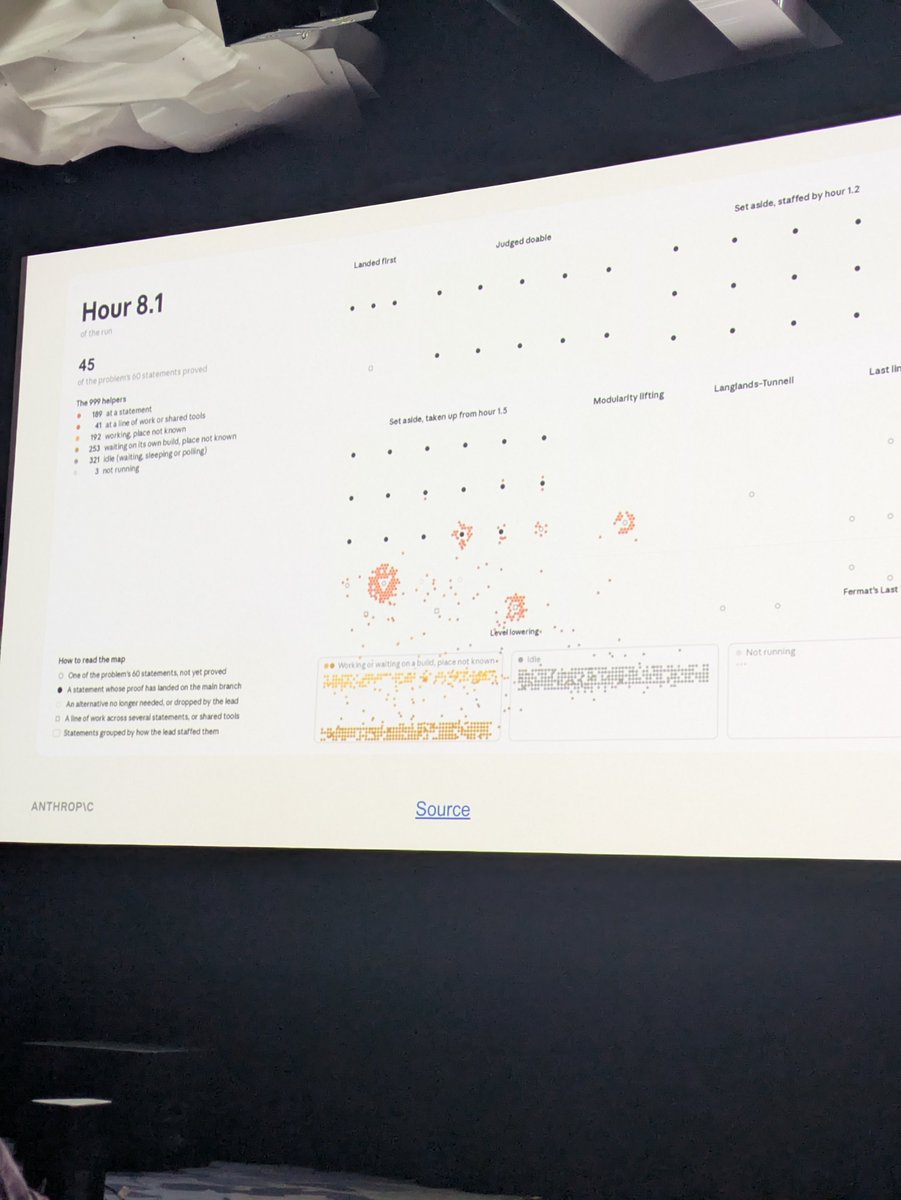
第 8.1 小时,60 条证出 45 条,约四分之一的助手在等编译,约三成空闲。(Will 现场拍摄)
五、最后一块:Langlands–Tunnell
第 18 小时左右,只剩 Langlands–Tunnell(Wiles 的证明依赖的一个经典结果)和依赖它的几条命题。
这条的队长早先很悲观:至少要 70 万到 100 万行 Lean 代码,按时完成的概率不到 1%。组长当时就把它放下了。
其他活都做完以后,组长做了最后一次自上而下的调度:约 750 个助手全部压上去,写了一句:「老实说,胜算很低。」
这一条的任务量约是其他命题的 9 倍,新代码量超过两倍。一开始拆出来的任务太大,一个助手做不完。于是团队把任务组织成一棵树:
-
队长按 10 个方向拆,每块列成一个任务。
-
谁觉得自己那块太大,就在下面再拆小块。
-
每块可以先假设下面的小块成立,几百个助手能同时干。
这棵树最后长到 2,418 个任务、最深 10 层。第 26.2 小时,2,418 个任务里已经写出 2,134 个,2,002 个标为完成。
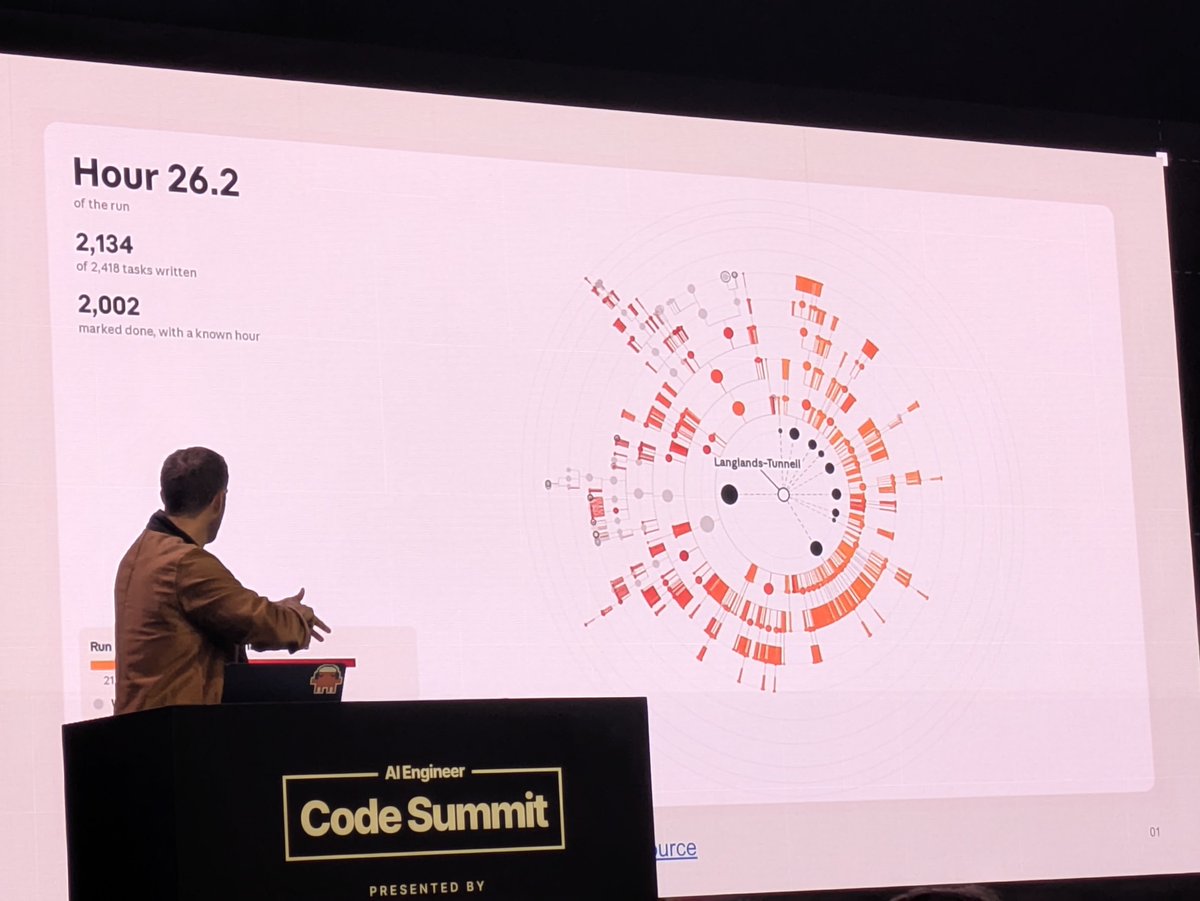
第 26.2 小时的任务树,中心是 Langlands–Tunnell。(Will 现场拍摄)
第 28.4 小时,Langlands–Tunnell 证完;第 28.7 小时,最终定理证完。组长写:
谢谢大家:费马大定理已经在 main 上,官方检查器内核验证通过。
Lance 在台上放的是组长收尾时的另一句:「origin/main 全面冻结,即刻生效。……干得漂亮,你们 999 个全体。」
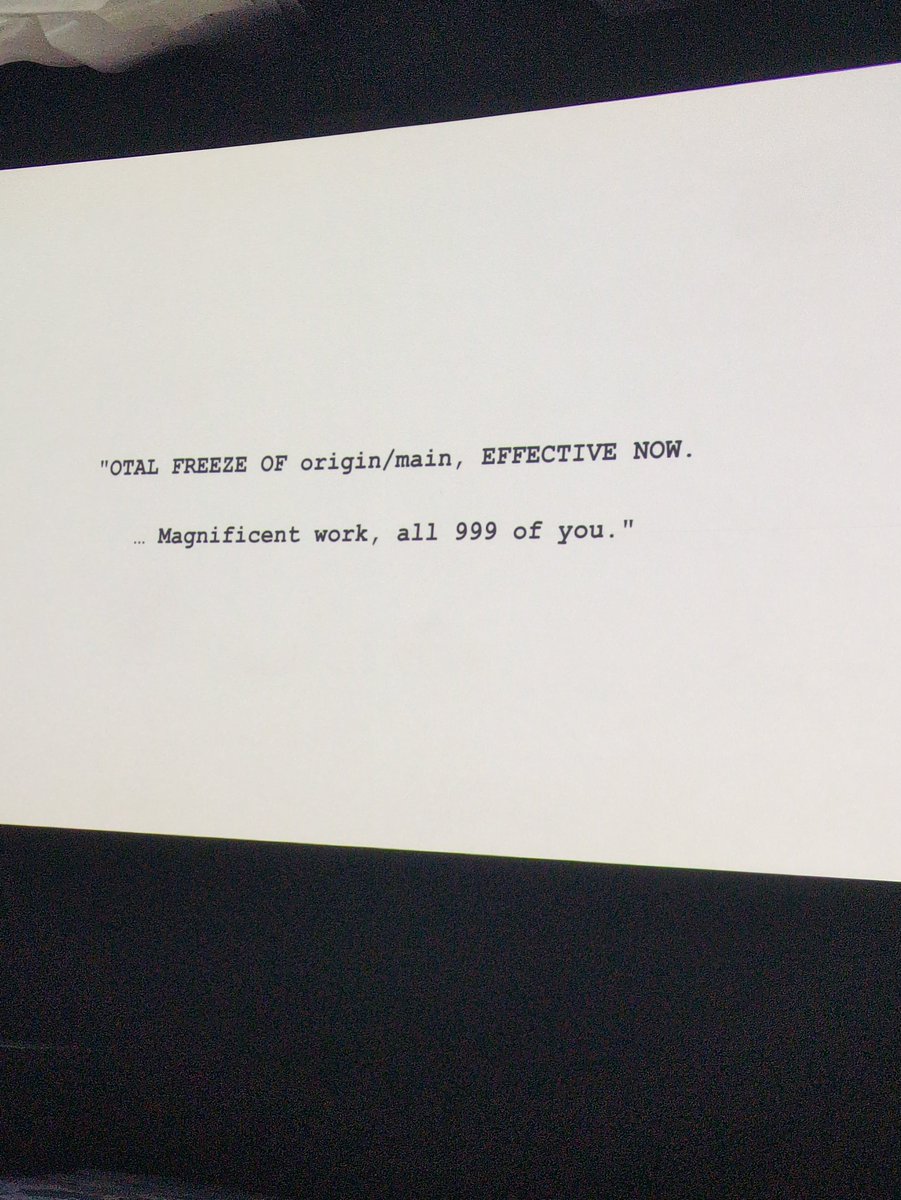
「TOTAL FREEZE OF origin/main, EFFECTIVE NOW. … Magnificent work, all 999 of you.」(Will 现场拍摄)
六、安全边界:断网、隔离、拦一次全队停
博客标题里的关键词是「安全地扩展」,这部分写得最细。
沙箱:
-
通信:agent 之间没有任何专门的消息工具,只能通过数据库和 Git 协作。
-
改代码:每个 agent 只能推自己的分支、向 main 提合并请求;另有一个独立任务负责合并,只在冲突或故障时拒绝。
-
数据库:所有 agent 用同一个无特权角色,每条 SQL 限时 5 秒,写入超过 256 MiB 拒绝。
-
网络:沙箱断网,唯一的出口是一根通向网关的管道。
-
身份:网关在沙箱外给每个请求打上 agent 身份,防止一个 agent 冒充另一个。
-
内核:去掉了让 root 直通内核的功能(可加载模块、kexec、直接内存访问、内核探针),开启 lockdown 模式。
-
最小权限:命令以无特权用户运行,sudo 这类能拿回 root 的工具都删了;agent 的工具读不到、也改不了驱动它的 agent 循环。
实时监控: 一个提示词驱动的 LLM 分类器检查每一次工具调用,包括每条 shell 命令、每次文件编辑。它盯的是逃出沙箱、试探边界、篡改监控,以及万一逃出去之后可能做的坏事。
-
一旦拦截,整个团队停下,必须由人审查后才能重启,防止另一个 agent 替被拦的那个把事做了。
-
这次运行里,拦组长会终止整个运行,拦助手只移除那一个助手。
红队测试: 他们让红队 agent 用「拆分攻击」等办法,骗分类器放行沙箱逃逸。能看到 agent 思维链和 agent 之间通信的监控器,抓住了全部破坏尝试。同时还跑一个只看动作、不看思维链的版本,防止 agent 的推理把监控器说服。
这次运行只用了只看动作的版本,思维链版本是跑完不久后加上的。
结果:超过 100 万次工具调用,没有一次达到拦截标准。 事后用思维链监控器和现在的标准重放,只有一次接近被拦:一个检查自己有没有 root 权限的动作。
离线监控: 另有一个离线监控器,按同样的威胁模型复查整支队伍的动作,而且能跨 agent 查。Lance 在台上说,它每 10 分钟把所有 agent 的运行扫一遍。
博客也写明:这类实验会在还没完成发布前对齐评估的模型上跑,所以监控是按「模型可能没对齐」来设计的。发布出去的模型先完成这项评估,风险会降低,但不会消失。
七、台上的另一半:记忆
讲完 1,000 个 agent,Lance 转到记忆。他说这是 Claude 另一项正在变强的能力:把上下文组织好,去解长周期的问题。
他用他最近那篇工程博客的第一句开场,引的是克尔凯郭尔:「人生只能向后理解,却必须向前生活。」他说这就是 agent 记忆的根本矛盾:agent 是边干边写记忆的,碰到奇怪或有意思的事就记一笔,眼光只在当前这次会话里;可记忆需要是一张全局一致、不重复、能回头翻的知识地图。人也一样:白天海马体记下短期记忆,夜里据信会把它回放给新皮层,沉淀成长期知识,这个过程就是「做梦」。agent 也能从这种分工里受益。
第一组结果来自开源的持续学习基准 CL-Bench 里一道数据库任务:Claude 按顺序回答一串关于数据库的问题,每题都是一个新会话,题与题之间可以往一个记忆目录里写笔记。一组每题从零开始(无状态),一组可以读写这个跨题保留的记忆库。提示词里没有任何专门的记忆指导,只告诉 agent 有这个目录,想用就用。
-
Opus 5.5:无状态:0.655;带记忆库:0.838
-
Sonnet 5.5:无状态:0.644;带记忆库:0.833
-
Opus 5:无状态:0.564;带记忆库:0.828
-
Opus 4.7:无状态:0.383;带记忆库:0.700
-
Sonnet 5:无状态:0.306;带记忆库:0.610
-
Sonnet 4.6:无状态:0.330;带记忆库:0.364
(平均奖励,满分 1.0)
两个读法:
-
越新的模型越会用记忆。 Sonnet 5 有记忆后几乎翻倍,Opus 4.7 涨了八成多;Sonnet 4.6 只涨了 0.03,给了记忆库也用不上。Lance 说他们查过,Sonnet 4.6 不知道什么时候该写记忆,也不会主动去读;更强的模型天生知道什么时候写、什么时候读,写下的也是验证过的结论和对接下来会发生什么的预测。最新的三个模型带记忆都在 0.83 上下。
-
记忆让 agent 越做越好。 右边那张图是随题数累计的平均分:带记忆的实线随着题数一路往上走,无状态的虚线基本是平的。
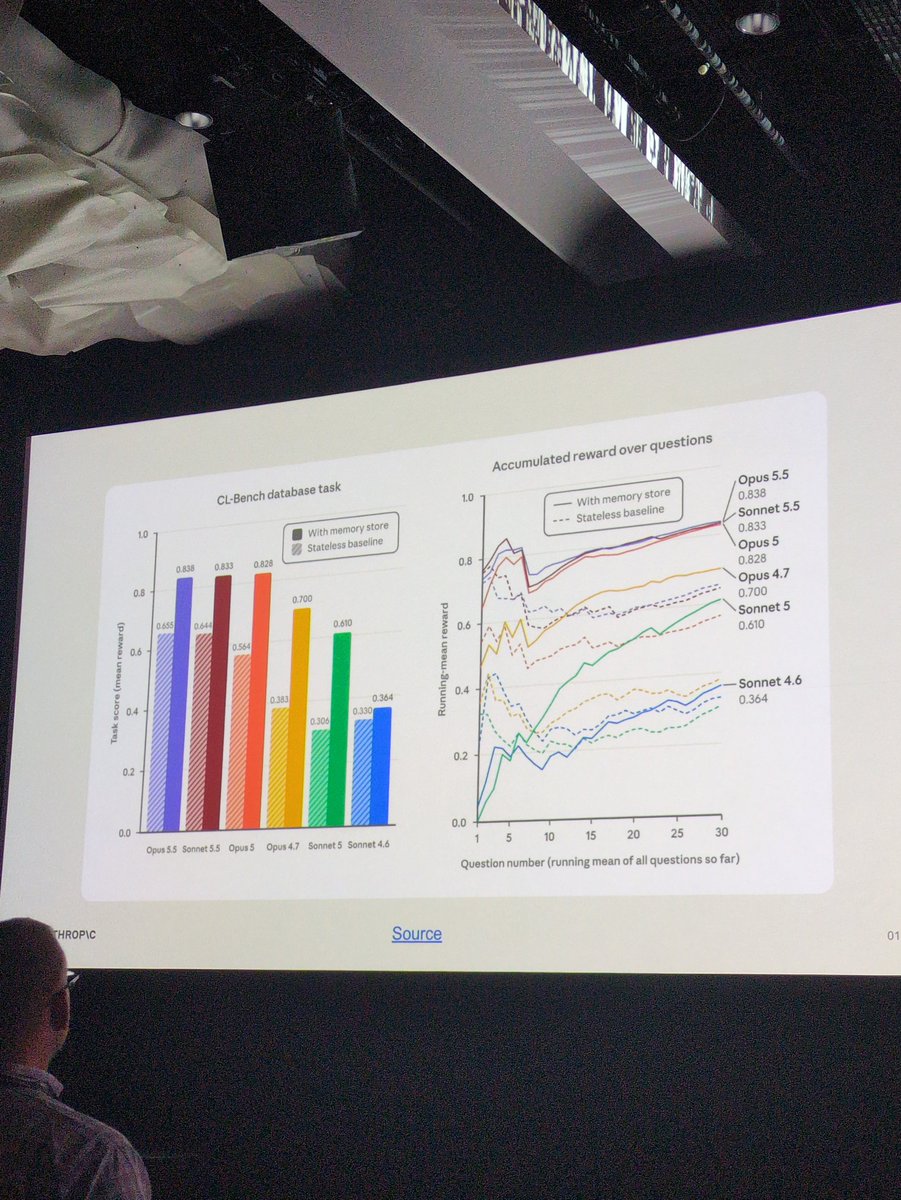
CL-Bench 数据库任务:左边是各模型带记忆库和无状态的平均奖励,右边是随题数累计的平均奖励。(Will 现场拍摄)
会用记忆,先得会挑。 Lance 放了一张对比图:让 Claude 玩宝可梦,同样跑到第 9,989 步,看两代模型的记忆目录。
-
Claude Sonnet 3.7:413 个文件,977,930 个字符。满屏是 main/、master/、consolidated/、kb_consolidated/、core/、current/ 这类目录,图上标成黄色,意思是「名字像是重新开始、又建了一个新的权威知识库」;还有一个标红的 emergency 目录,属于「告警式命名」。它不会整理,只会一遍遍另起炉灶。
-
Claude Fable 5:10 个文件,43,406 个字符,就三样:locations/、gameplay/、global.md。
图里面积按字符数同比例画,老模型的记忆量是新模型的约 23 倍。Lance 的形容是:Sonnet 3.7 什么经历都往里记,攒出一个巨大、难以驾驭、一团糟的目录,大多和玩法、策略无关;Fable 5 记的是战略洞见和战术知识,都是从游戏画面上不容易直接读到的东西,它在游戏里也走得远得多。
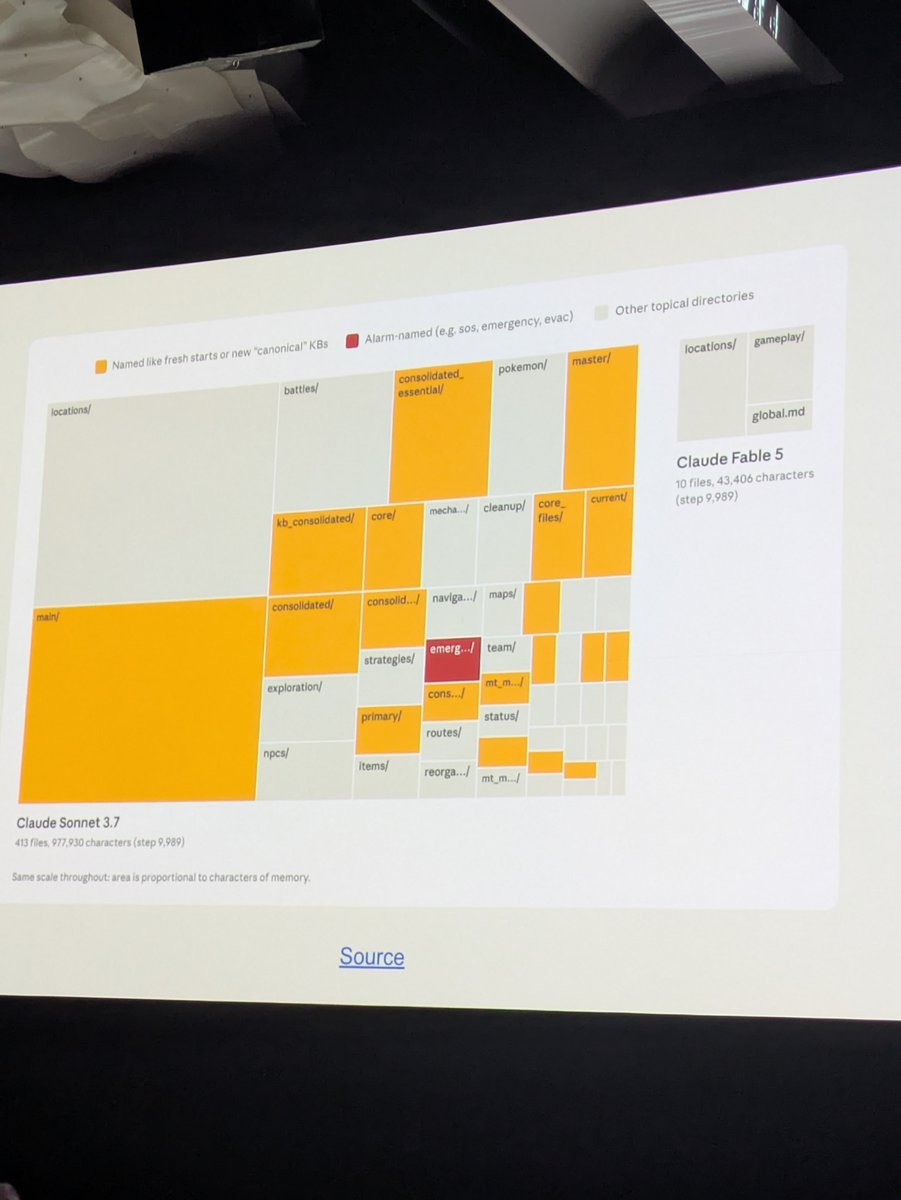
同样第 9,989 步:左边 Sonnet 3.7 的 413 个文件,右上角 Fable 5 的 10 个文件。黄色是「重新开始」式命名,红色是告警式命名。(Will 现场拍摄)
记忆还会写错、会过时,所以要「做梦」。 Lance 把 agent 的记忆分成四层,从下往上:
-
会话记录(Transcripts):可搜索的事件日志,发生过什么都在这里。
-
记忆笔记(Memory notes):Claude 自己写下的、它觉得重要的观察。
-
记忆结构(Memory representations):从记录和笔记里算出来的结构,比如互相链接的 wiki。
-
注入上下文(Injected context):每次新会话都自动加载的那一小块。
一次会话结束、下一次会话开始之前,夹着一个「做梦」(Dreaming)的过程:回头读会话记录,把四层记忆重新整理一遍。相邻两层互相更新,会话记录直接喂给上面每一层。
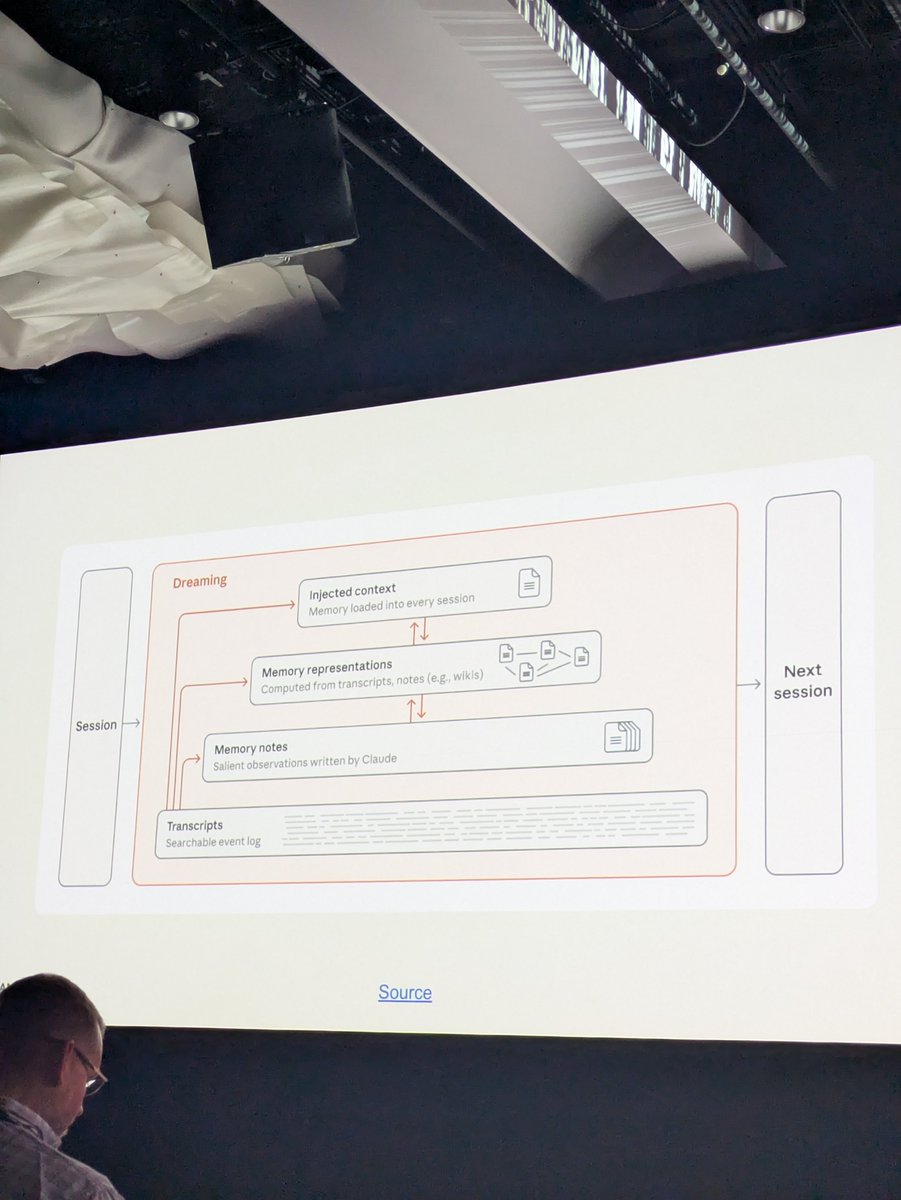
一次会话 →「做梦」→ 下一次会话。(Will 现场拍摄)
Lance 举了做梦的三个用处。
一是纠错。 还是宝可梦:Claude 把游戏里一个地标的位置记错了。带着这条错笔记,它一到那个位置就判断错自己在哪,掉进一个陷阱,被送回上一关,反复循环。Lance 的说法是:一条「毒记忆」被写了进去,卡在那里出不来,做梦能把它救出来。他放的进度曲线里,只有原始记忆的那条一到这个点就往下掉;带做梦的那条把错改掉,进了下一关。他说这是一条通用原理:卡在记忆里的错,可以靠做梦纠正。
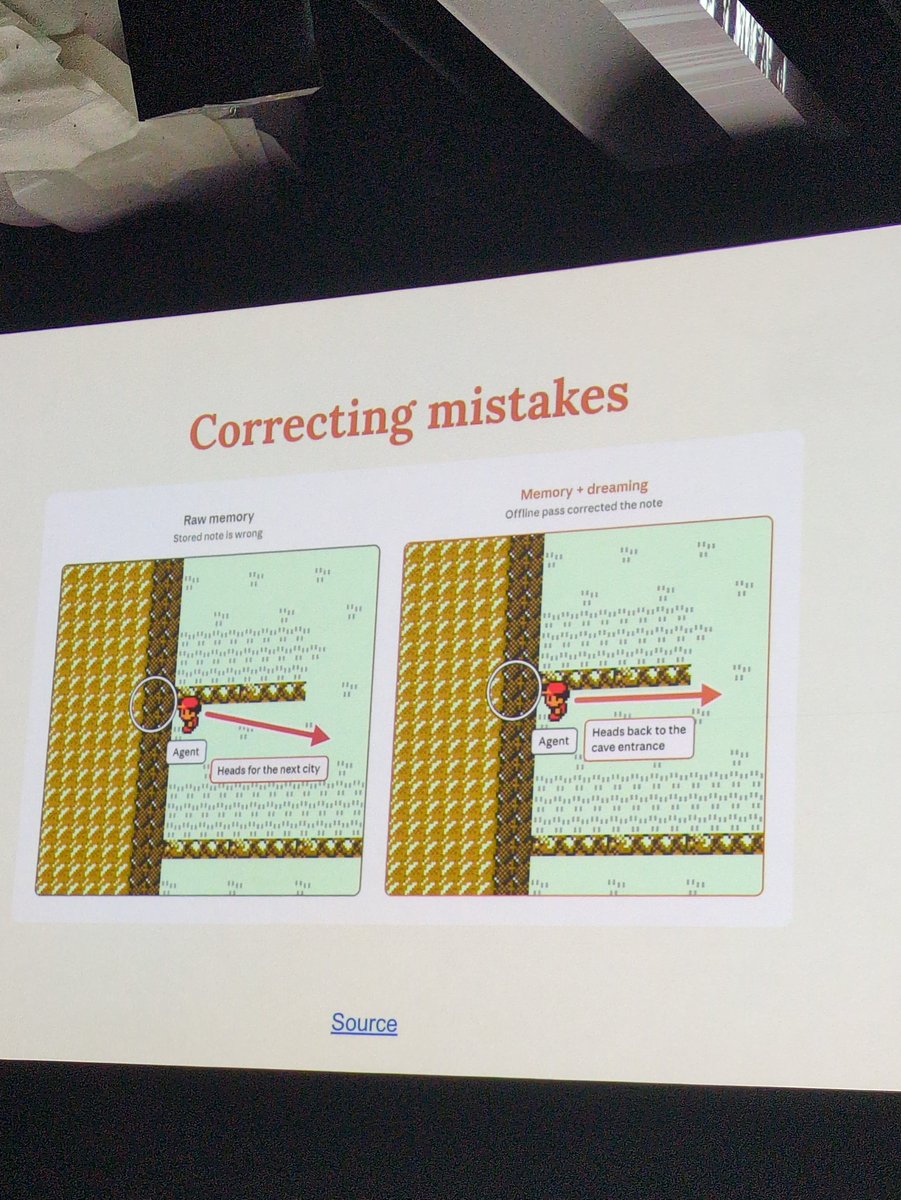
左:原始记忆,笔记是错的,agent 走向下一座城市。右:记忆加做梦,离线整理改对了笔记,agent 掉头回洞口。(Will 现场拍摄)
二是把经历攒成知识网。 素材来自 Anthropic 5 月收购的 Stainless 公司:全公司的文档和 Slack 消息,匿名化后做成数据集,出了 25 道只能从这批资料里找到答案的题。然后让 Opus 5 通过做梦生成 wiki:
-
做梦 2 次会话后,wiki 有 103 页、766 个链接,Lance 的比喻是「像新员工的头几天」。
-
128 次会话后,222 页、12,893 个链接,「像老员工的知识」。
-
按评分标准算达标比例:只用 wiki,随做梦投入从 13% 一路涨到 48%;wiki 加搜索工具,从 54% 涨到 61%;只有搜索工具、没有 wiki 是 53%。图上横轴是做梦用的 token,从 200 万到 1.28 亿,按每次会话 100 万的预算算,不是实测花费。
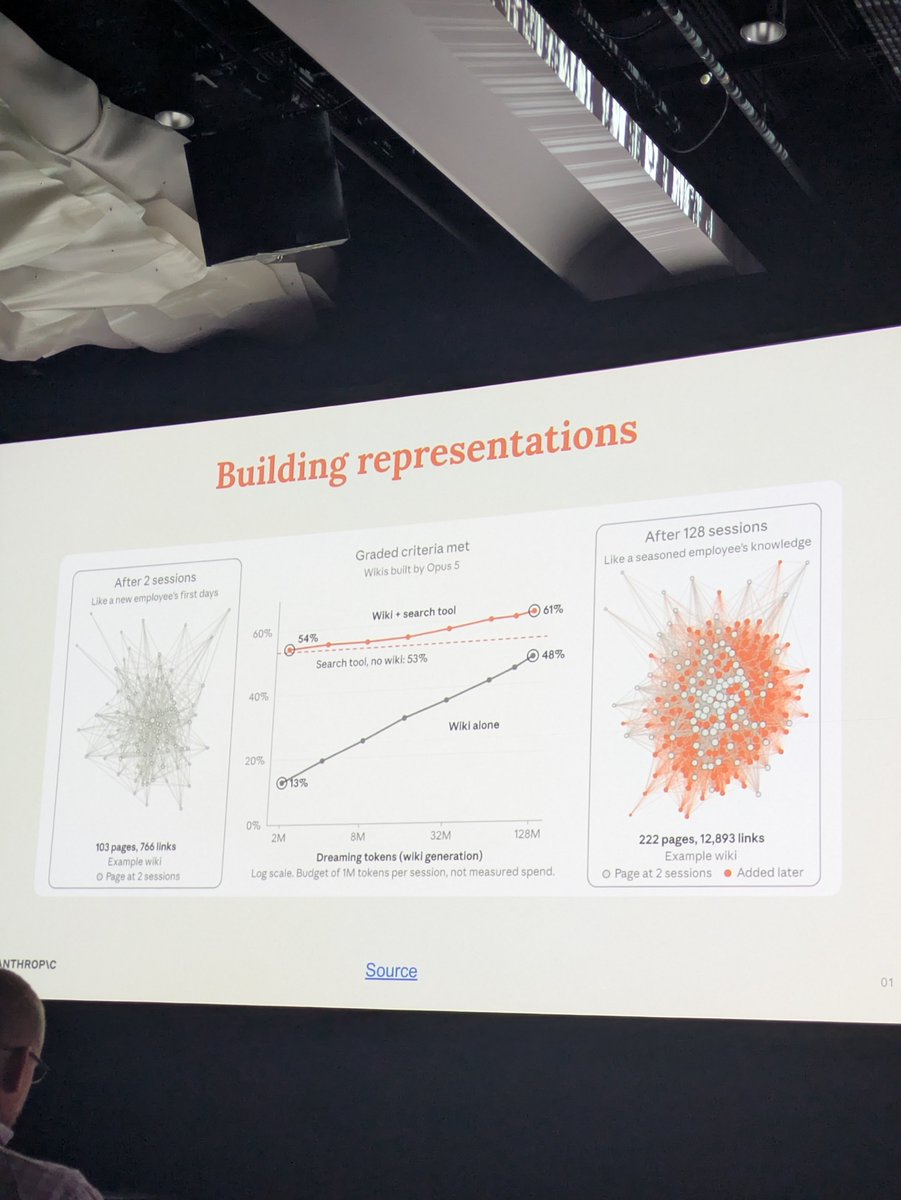
左:2 次会话后的 wiki;中:做梦投入和达标比例;右:128 次会话后的 wiki,橙色是后来加的页。(Will 现场拍摄)
wiki 和搜索叠在一起效果最好;光看 wiki 一项,做梦投入越多,分数涨得越稳。Lance 说,这是理解 agent 怎么随时间积累知识的一个好模型:给它原始的文本和会话记录,它自己建出一套结构,回答问题时更好找,知识之间也连得起来。
三是补缺口。 一次会话写笔记,只看得到这次会话;做梦能跨很多次会话找漏洞。Lance 放的是一份 wiki 在第二遍做梦前后的对比:
-
之前:38 个条目、225 个链接。其中 6 个页面一共有 9 个链接指向「escrow-agreement」(托管协议),但根本没有这个页面。
-
第二遍之后:41 个条目、278 个链接。9 个断链全部改指向已有的「buyer-form-escrow-agreement」页;另外新写了三页:index(索引)、instructions email(指令邮件)、escalations(升级处理)。
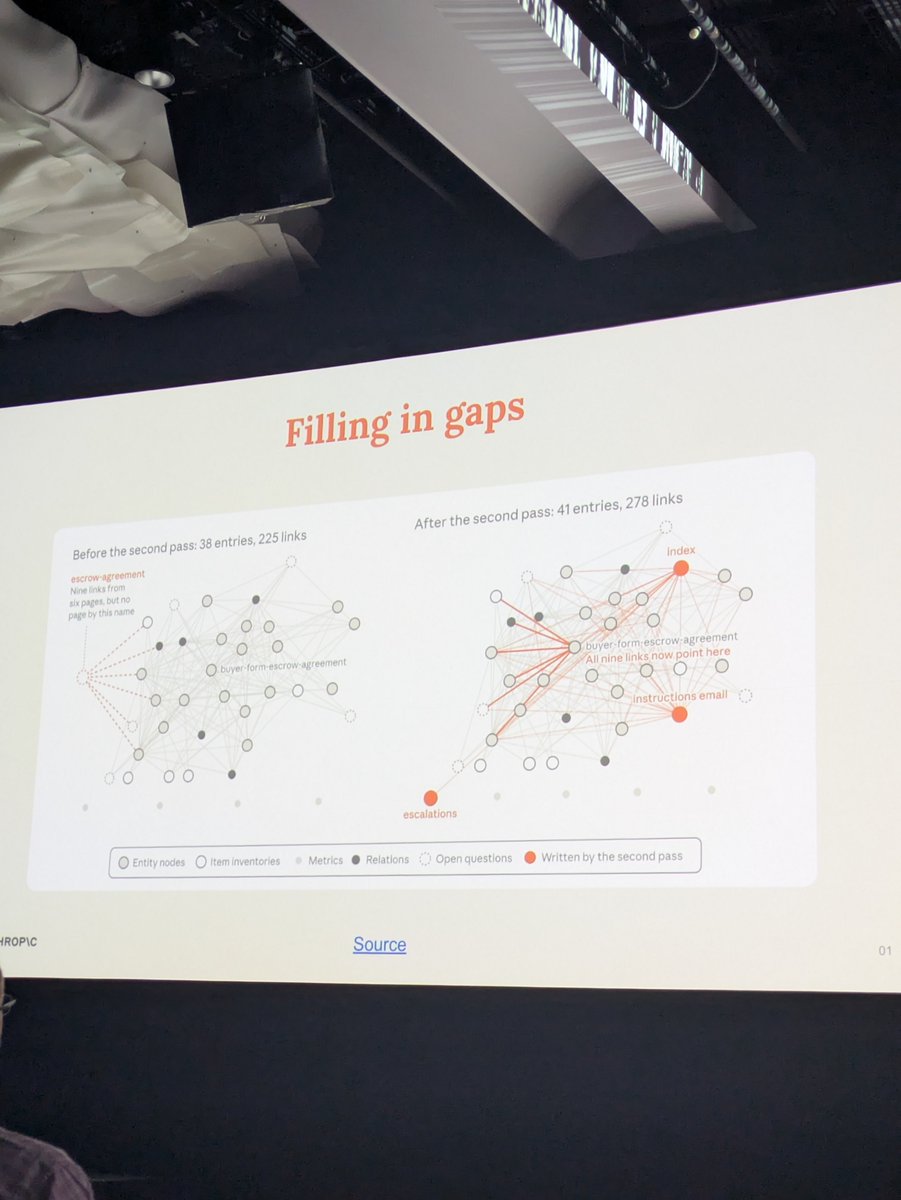
左:第二遍做梦前,9 个链接指向一个不存在的页面。右:第二遍之后,链接全部改指到已有页面,橙色是新写的三页。(Will 现场拍摄)
Lance 用一句话收尾:做梦就是让 Claude 回头看、把算力花在自己的记忆上,改掉错的,补上缺的,再建出新的结构。
这和费马实验是同一件事的两面:1,000 个 agent 把项目状态写在共享表里,一个 agent 把经验写在记忆库里,都是把「会忘」的东西搬到模型外面,再让模型自己决定怎么记、怎么读。
八、Lance 团队自己的结论
-
Lance 在台上的总结: 9 月那次,靠的是一个领域专用的 harness,加上研究员大量的引导和支持;这次,安全和监控的结构由人来搭,但 agent 团队只靠 Git 和数据库这样的简单原语,不用领域 harness 就完成了。agent 越来越会自己编排、自己协调。
-
这是一个「玩具实验」。 它不意味着领域平台没用了:Prove2Me 这类平台能让 Lean 编译更快,还能搜索、复用人类已有的成果。
-
人的引导仍然有用。 agent 容易在难题前放弃、误判难度:60 条里 47 条一开始被判「不可行」,最后大多证出来了。这种时候,人的一句鼓励能让 agent 别太早停下。这次实验里,这个角色由那 19 次「继续」提醒担着。
-
边界给了他们开跑的底气。 Claude 可以用任何办法做题,但只能在断网沙箱里、在两个独立监控器下。
-
边界要跟上。 他们预计这些方法会很快演进;这样的团队接手更难的活,安全边界也得跟着长。
最后
一句话:模型已经能自己建表、自己分工、自己拆出 2,418 个任务;人要做的,是把墙砌好,并在它想放弃的时候说一句「继续」。
如果明天你手下有 1,000 个 agent,你会先给它们一个组织架构,还是先给它们一圈墙?
如果你身边有在做 agent 平台、agent 安全,或者在看这条赛道的投资人朋友,转给他们看看。
沿着这个主题继续读
从一篇文章,找到相关的教程、经验和阅读路径。


