
一般の機械学習とクオンツの機械学習、6つの違い
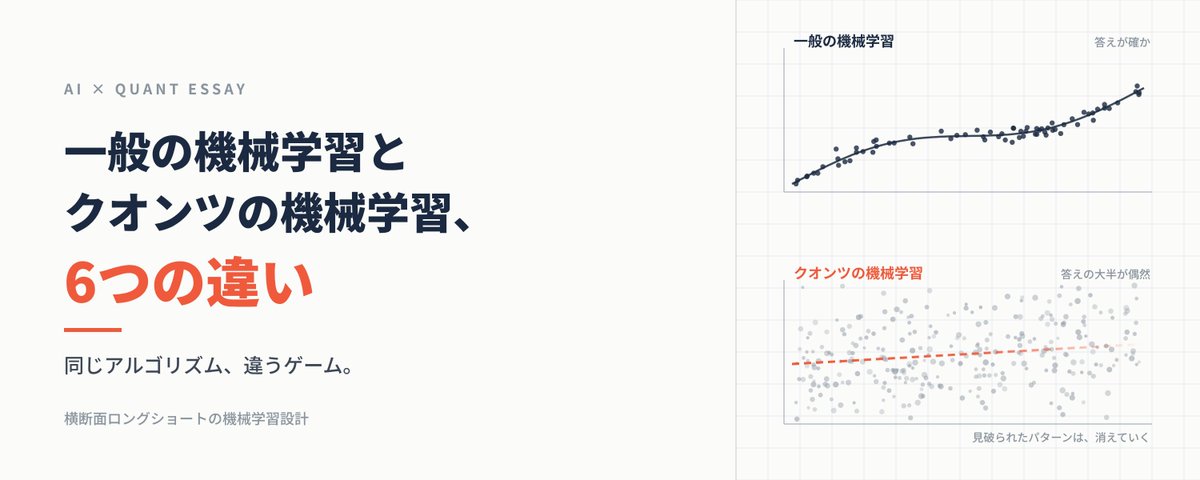
一般の機械学習とクオンツの機械学習、6つの違い
勾配ブースティングもニューラルネットも、画像認識で使うものと相場で使うものは基本同じ。ただ、一般の機械学習の「常識」をそのまま相場に持ち込むと、たいてい失敗すると思います。僕もたくさん失敗しました。
要は道具は同じでも、ゲームが違うからです。その違いは六つありますが、根っこは一つ、データの性質にあると考えています。
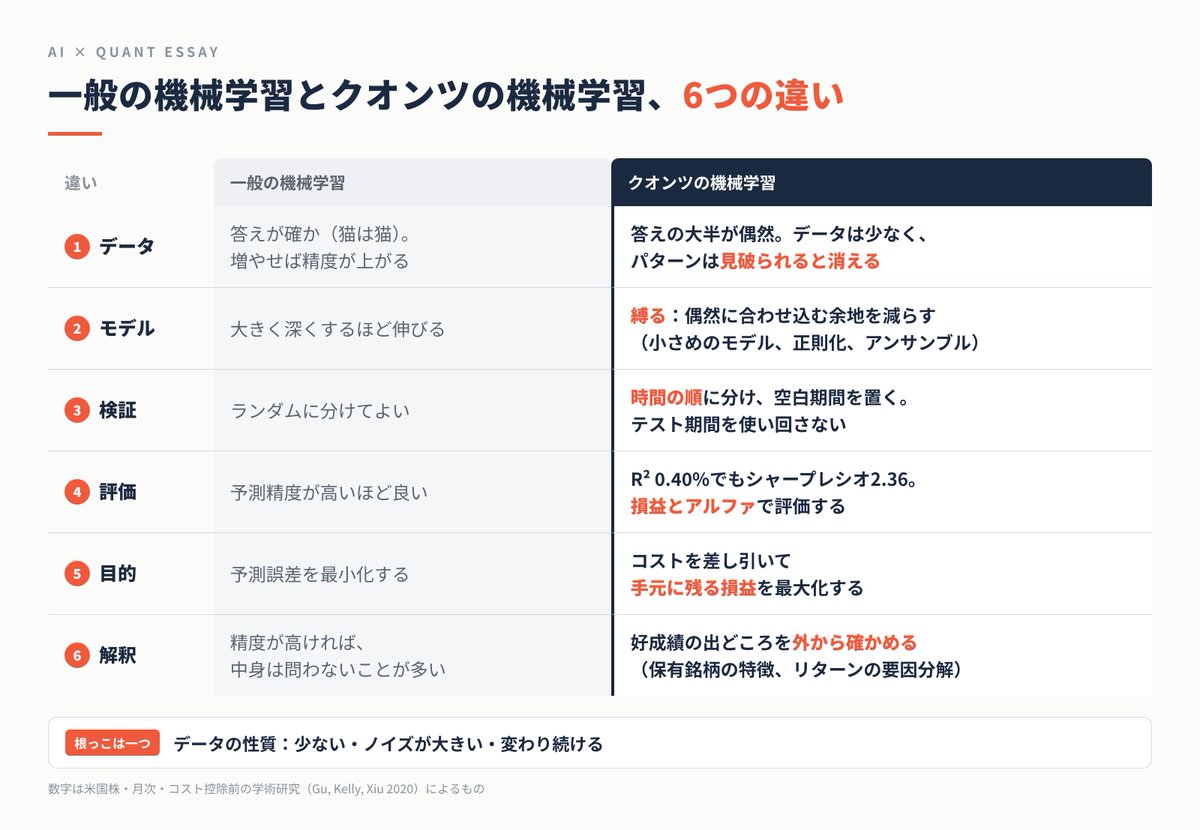
■違い1:データ ― 量よりも「答えの確かさ」が違う
一般:画像に「猫」というラベルが付いていれば、その答えは確かです。データを増やせば、精度は上がっていきます。 クオンツ:来月のリターンという「答え」そのものが、大半は偶然の値動きき。しかも市場全体の月次データは、60年分でも数百点しかありません。
さらに決定的な違いがあります。猫は、見破られても猫のままです。ところが相場のパターンは知れ渡ると、それを取りに行く参加者によって消えていいきます。データを集めているあいだにも、答えの性質が変わっていく。
これらの違いは、すべてこの「少ない・ノイズが大きい・変わる」から生まれます。
■違い2:モデル ― 大きくするか、縛るか
一般:データが十分にあれば、モデルを大きく深くするほど伸びる傾向にあります。 クオンツ:自由なモデルほど、偶然の値動きまで「パターン」として覚えてしまいます。
米国株の代表的な研究では、920個の特徴量をそのまま線形回帰に入れると、予測精度(R²)は−3.46%でした。毎月「来月のリターンは0%」と言い続けるだけの予測にすら負けたのです。最も成績の良かったニューラルネットは、小さな3層に何重もの制約をかけたもので、層を増やしても成績はそんなに伸びていないのです。
クオンツの機械学習は、モデルを「縛る」こと、つまり偶然に合わせ込む余地を減らすことから始まります。
■違い3:検証 ― ランダムに分けるか、時間で分けるか
一般:データが互いに独立なら、ランダムに訓練用とテスト用に分けても問題ありません。 クオンツ:時系列の順序性を考えずにランダムに分けると、未来の情報が訓練に紛れ込みます。
たとえば特徴量に、金利や市場全体の変動の大きさといった「その月に全銘柄で共通の値」が入っているとします。ランダムに分けると、テスト用の銘柄と同じ月の別の銘柄が、訓練データに入ります。するとモデルは、その共通の値を目印に「この月は相場全体が下がった」と覚えてしまう。成績は良く見えるのですが、それは予測力ではなく、カンニングとなってしまう。
だから、データは時間の順に分け、訓練と検証の間に空白期間を置きます。そして、テスト期間を何度も使い回さないこと。設計を何十通りも試して一番良いものを選べば、それ自体が過学習になります。縛るべきは、モデルだけでなく分析者自身でもあります。
■違い4:評価 ― 精度か、損益か
一般:予測精度が高いほど、良いモデルです。 クオンツ:予測精度では、モデルの価値をほとんど測れない。
先ほどの研究で、最も良いニューラルネットのR²はわずか0.40%でした。それでも、予測で銘柄を並べたロングショートのシャープレシオは2.36(等ウェイト、コスト控除前)に達しました。1銘柄の値動きはほとんど当たらなくても、何千銘柄の「並び順」を少しだけ正しくできれば、数の力で利益になるからです。
逆に言えば、R²が高く見えるモデルはまず疑うべき。比較相手を「過去の平均リターン」にするだけで、R²は約3ポイント高く出ます。評価は、シャープレシオや、既知のファクターで説明できない部分(アルファ)といった経済的な指標で行うのが一般的
■違い5:目的 ― 予測誤差か、手元に残る損益か
一般:予測誤差を最小化することが、そのまま目的なりやすい。 クオンツ:予測は途中経過として考える。最終的に決めるのは、「どの銘柄をどれだけ買い、どれだけ売るか」です。
予測誤差の最小化を目的にすると、モデルは最も予測しやすいパターンを探しに行きます。そして競争の激しい市場で予測しやすいまま残っているのは、取引コストが高くて誰も取りに行かないパターンです。実際、先ほどのシャープレシオ2.36は、時価総額加重にすると1.20に半減しました。しかもポートフォリオは、毎月ほぼ丸ごと入れ替わっていました。
だから問いそのもの(モデルに求めるもの)を、「コストを差し引いて、手元に残る損益を最大化せよ」に変える必要があると思います。
■違い6:解釈 ― ブラックボックスを許すか
一般:テストでの精度が高ければ、中身が分からなくても使えることが多いでしょう。 クオンツ:バックテストの好成績がどこから来たのかを確かめずに使うのは、きわめて危険、本番で失敗することが多いです。
好成績の正体が、実はモメンタムのような既知の戦略だったり、取引しにくい小型株だったりすることがあるからです。モデルはブラックボックスであることが多いので中身は読めなくても、外から確かめることは可能。一番手軽なのは、モデルが買っている銘柄と売っている銘柄の、時価総額や出来高を眺めること。次に、戦略のリターンを既知のファクターで分解し、本当に新しい部分がどれだけ残るかを見ることが大切です。
■クオンツの機械学習で重要なこと
以下に重要なことをまとめます。
-
データの性質から出発する。少なく、ノイズが大きく、変わり続けるデータだという前提に立つ。
-
モデルを縛る。偶然に合わせ込む余地を減らし、必ず単純な線形モデルの成績と比べる。
-
時間の順序を守る。テスト期間を使い回さず、自分自身の「都合のよい読み方」も縛る。
-
精度ではなく、損益で評価する。等ウェイトだけでなく、時価総額加重とコスト控除後の成績を並べる。
-
問いを損益に置き換え、答えを外から確かめる。保有銘柄の特徴と、リターンの要因分解を見る。
機械学習は、答えを出す機械ではなく、与えられた問い(目的関数)に忠実に最適化すると考えていいと思う。道具が同じでも、何を問い、どう縛り、どう確かめるかで、相場でのゲームはまったく違うものになります。その設計こそが、クオンツの肝だと考えています。
(文中の数字は、米国株・月次・コスト控除前の学術研究によるものです)
詳しくはQiitaにまとめました。
【記事名:予測モデルを作るだけでは、戦略にならない ― 横断面ロングショートの機械学習設計】


